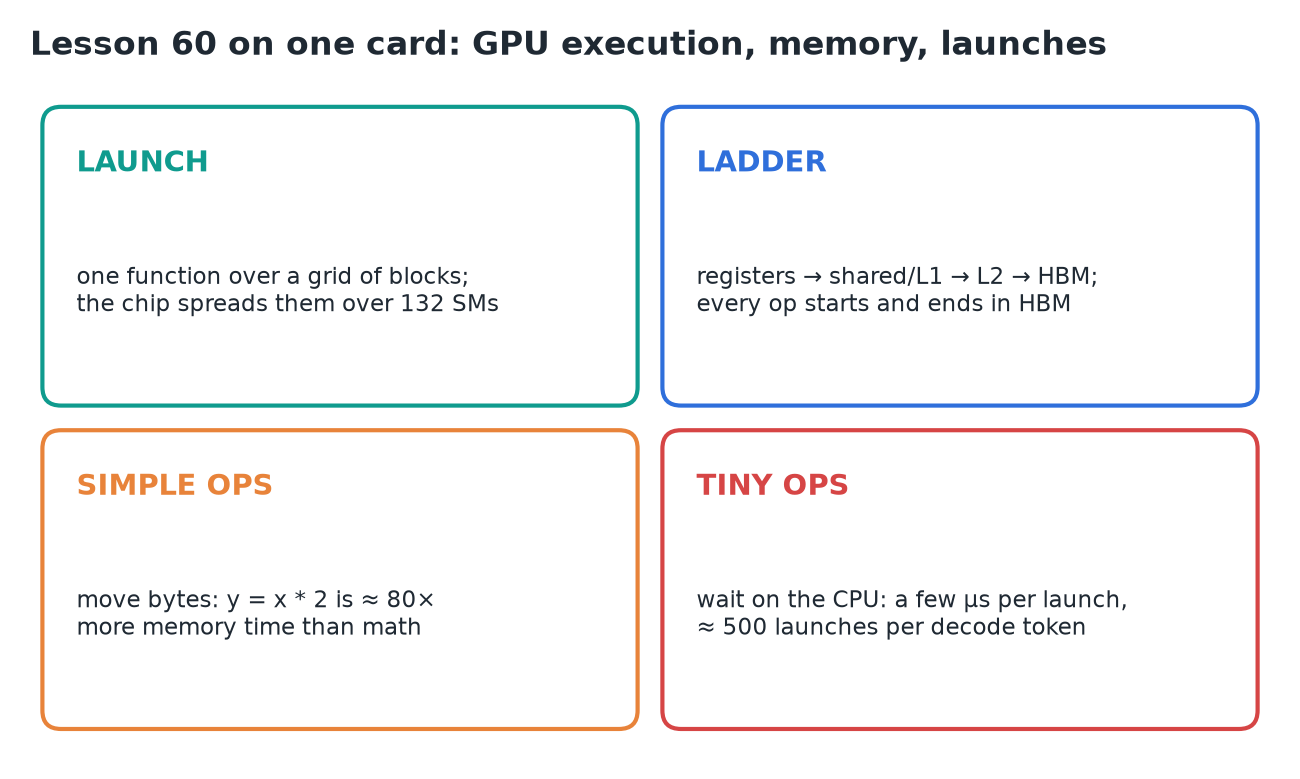
60 · Thực thi trên GPU, phân cấp bộ nhớ và launch kernel
Nguồn: fanout.sh / inference-eng / 12-06 · ~7 phút
Ghi chú
Ngay cả y = x * 2 trên H100 cũng trả ba khoản chi phí riêng biệt: CPU phải launch một kernel, GPU phải rải công việc lên 132 SM, và các con số phải di chuyển từ HBM tới các core rồi quay lại. Bất kỳ khoản nào cũng có thể là thứ làm model chậm. Op đơn giản dành thời gian chuyển byte; op tí hon dành thời gian chờ CPU. Điều đó cho mỗi mili giây ba cái giỏ: compute, memory, overhead.
1. Ba khoản chi phí sau một dòng code
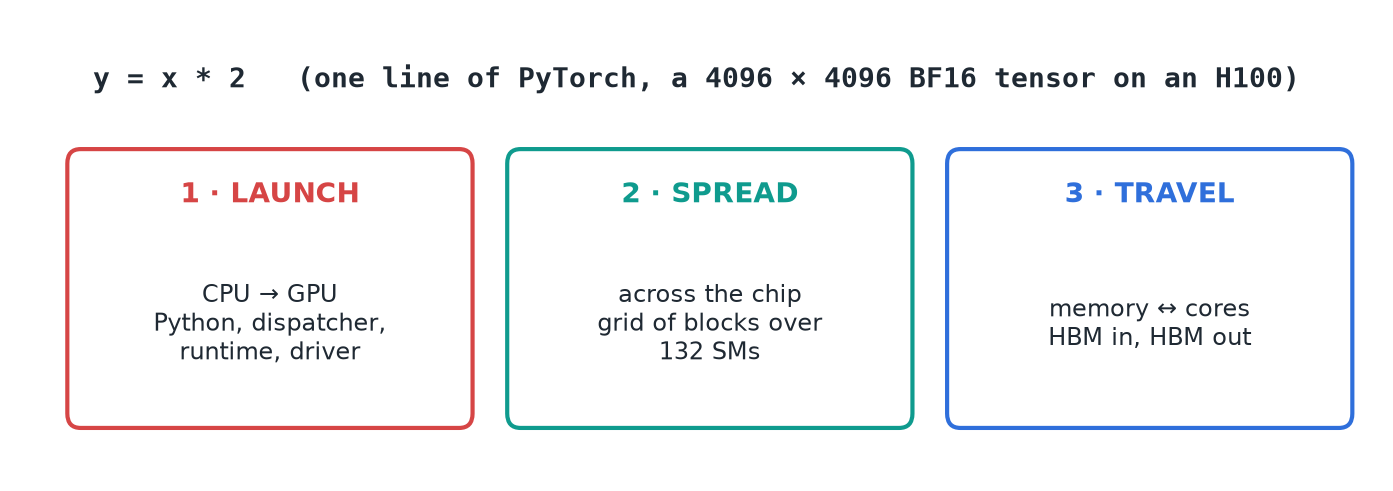 Mỗi bước đều có thể là nút thắt.
- Launch: CPU bảo GPU chạy một kernel.
- Rải: GPU phân phối công việc ra khắp chip.
- Di chuyển: đầu vào đi từ bộ nhớ tới các core, đầu ra quay về.
2. Công việc được rải lên chip thế nào
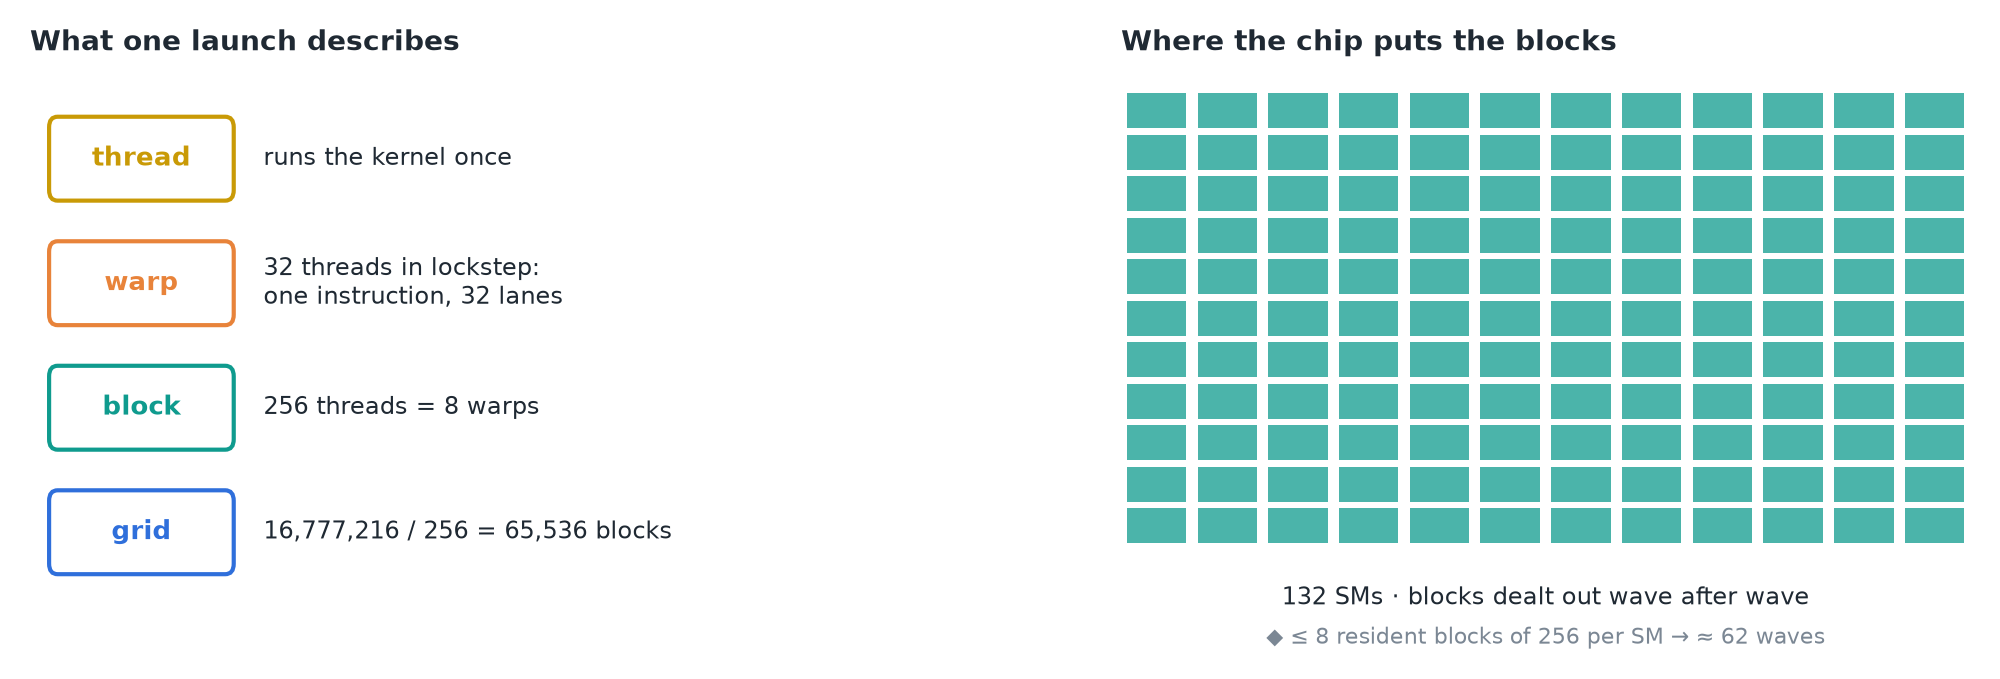 Lần launch nói làm gì và bao nhiêu; chip nói làm ở đâu.
- Một H100 không phải một bộ xử lý lớn duy nhất: nó gồm 132 streaming multiprocessor (SM) xếp như những viên gạch.
- Một kernel là một hàm mà GPU chạy nhiều lần cùng lúc, mỗi thread một lần.
- Warp: 32 thread chạy đồng bộ (lockstep) (một lệnh, 32 làn). Warp được gói vào block; mọi block của một lần launch tạo thành grid.
- Ví dụ: x là 4096 × 4096 = 16.777.216 số. Với 256 thread mỗi block, grid có 65.536 block.
- Phần cứng chia block cho các SM hết đợt này tới đợt khác cho tới khi xong hết.
- ◆ Một SM giữ tối đa 2.048 thread thường trú, nên cùng lúc ≤ 8 block 256 thread: 132 × 8 = 1.056 block mỗi đợt, ≈ 62 đợt.
3. Bậc thang bộ nhớ
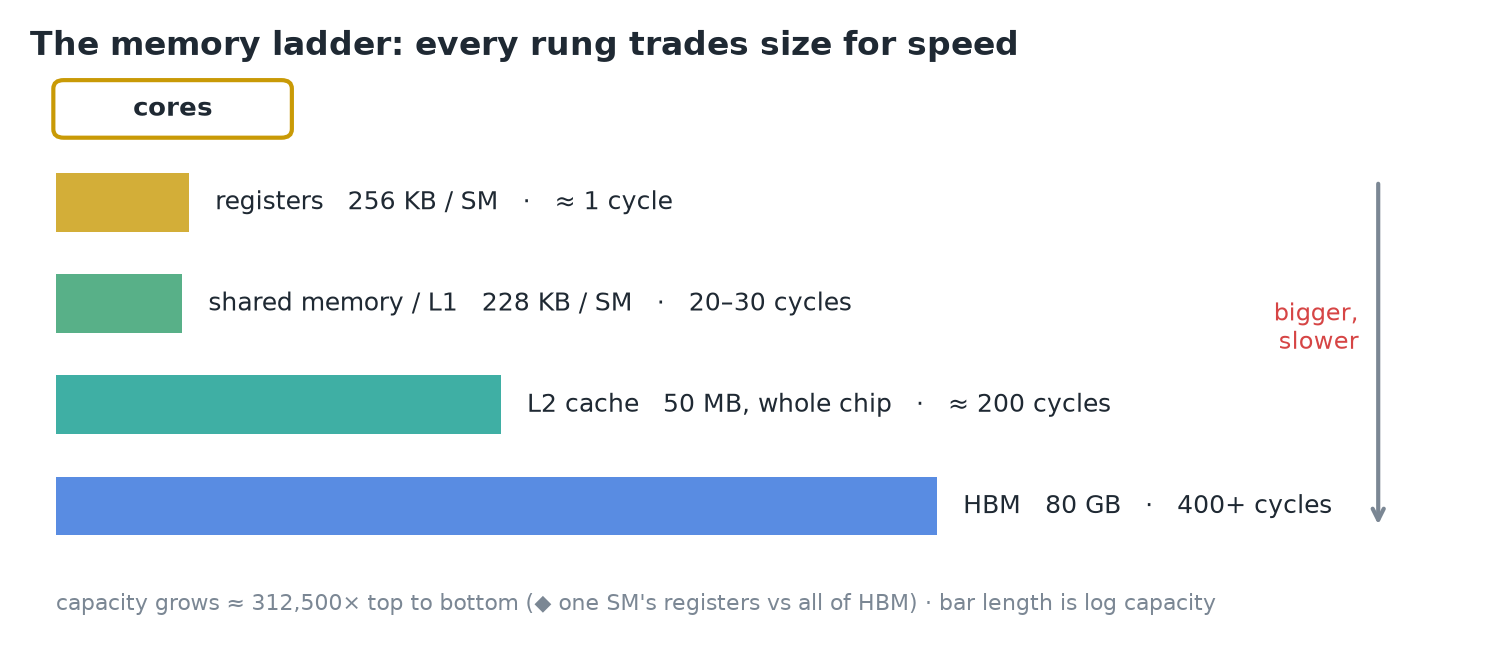 Mỗi bậc đổi kích thước lấy tốc độ.
| Bậc | Kích thước | Latency |
|---|---|---|
| register | 256 KB mỗi SM | ≈ 1 chu kỳ |
| shared memory / L1 | tới 228 KB mỗi SM | 20–30 chu kỳ |
| L2 cache | 50 MB, toàn chip | ≈ 200 chu kỳ |
| HBM | 80 GB (con số nvidia-smi hiển thị) | 400+ chu kỳ |
- Từ trên xuống dưới, dung lượng tăng ≈ 300.000 lần. ◆ Đó là 256 KB register của một SM so với cả 80 GB HBM (312.500 lần); register của cả chip (132 × 256 KB ≈ 34 MB) chỉ nhỏ hơn HBM ≈ 2.400 lần.
Quan trọng
Một op PyTorch thông thường bắt đầu với đầu vào nằm trong HBM và kết thúc với đầu ra nằm trong HBM. Không có gì ở lại trên chip giữa các phép toán.
4. Định giá dòng code
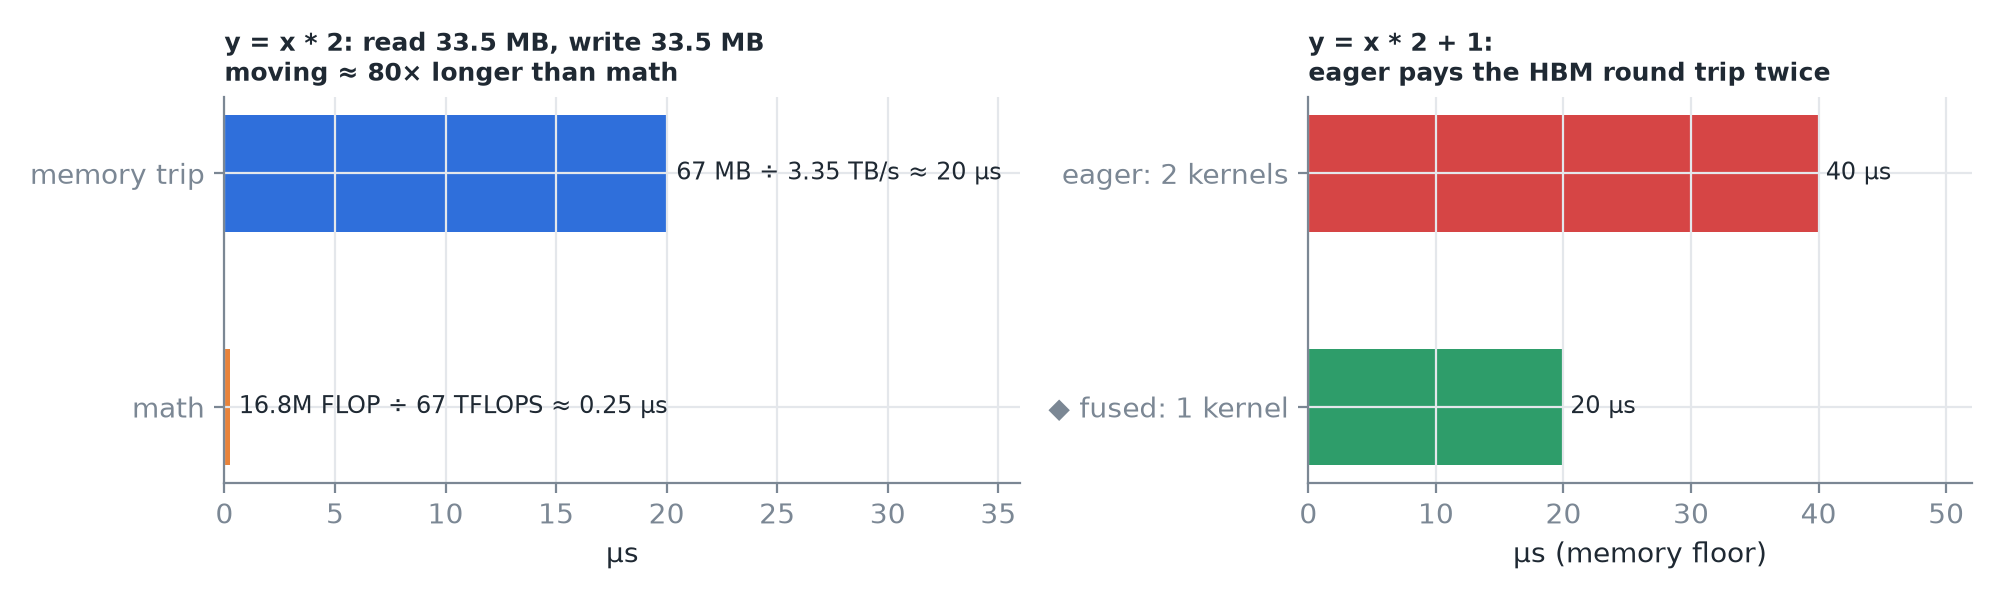 Byte, không phải phép tính, quyết định thời gian.
- Đọc x (16,8 triệu × 2 byte ở BF16 = 33,5 MB), ghi y (33,5 MB): 67 MB lưu lượng.
- Phép tính ở mức 67 TFLOPS tính toán thông thường (không dùng tensor core) của H100: một phần tư micro giây.
- Di chuyển lâu hơn tính toán ≈ 80 lần. Các core phần lớn ngồi chờ byte: memory-bound.
y = x * 2 + 1trong PyTorch eager là hai kernel, nên nó trả chi phí đi về HBM hai lần (◆ ≈ 40 µs so với ≈ 20 µs nếu gộp thành một).
5. Overhead launch
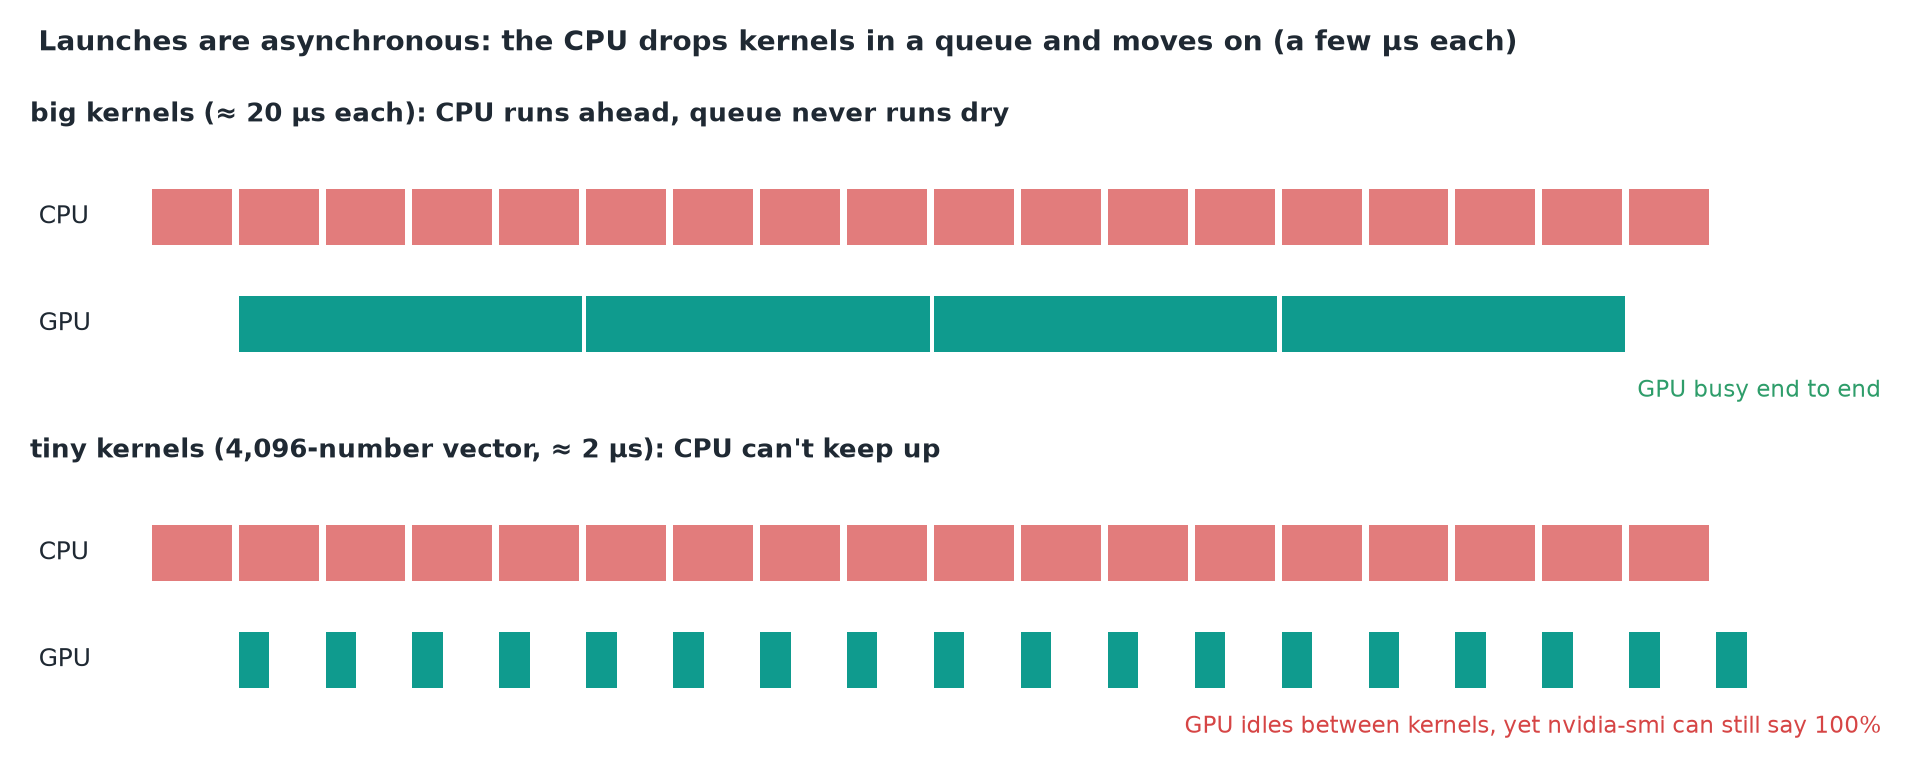 Cùng tốc độ launch của CPU, timeline GPU rất khác nhau.
- Một lần launch đi qua Python → dispatcher C++ của PyTorch → CUDA runtime → driver → GPU. Đó là vài µs mỗi lần launch, như nhau với kernel khổng lồ hay tí hon.
- Launch là bất đồng bộ: CPU thả kernel vào hàng đợi rồi đi tiếp, nên nó có thể chạy trước GPU.
- Kernel lớn (phép nhân 20 µs): CPU luôn đi trước và hàng đợi không bao giờ cạn.
- Kernel tí hon (một vector 4.096 số, ≈ 2 µs): CPU không theo kịp. GPU xong từng kernel rồi ngồi không chờ lần launch tiếp theo.
Cảnh báo
nvidia-smi vẫn có thể hiện utilization 100% ở đây. Nó chỉ có nghĩa là có kernel nào đó đang chạy trong lúc lấy mẫu, không phải chip đang bận.
6. Một bước decode
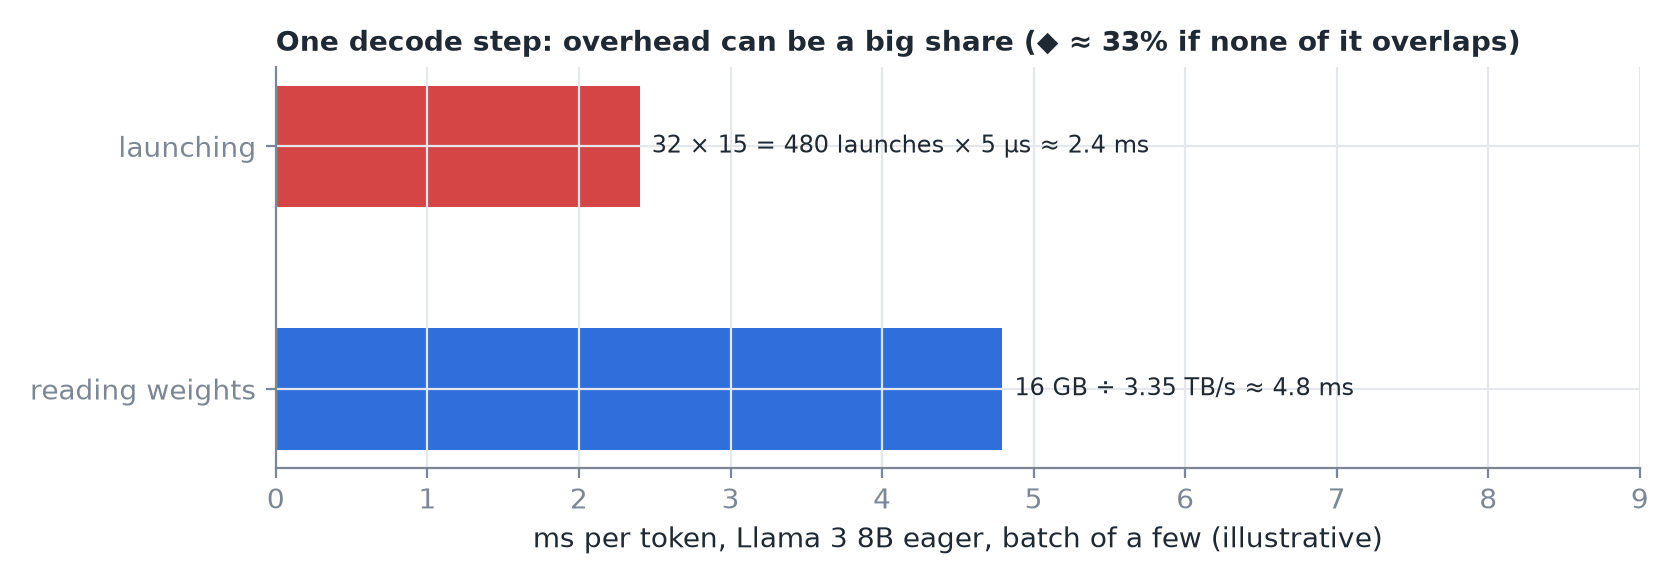 Số của bài mang tính minh hoạ; hình dạng là thật.
- Sinh một token chạy mọi layer trên một nhúm vector: rất nhiều kernel nhỏ.
- Llama 3 8B: 32 layer × ≈ 15 kernel ở eager mode thuần ≈ 500 lần launch mỗi token.
- Với ≈ 5 µs mỗi lần, riêng launch đã ≈ 2,5 ms (480 × 5 = 2,4 ms).
- Đọc 16 GB trọng số ở 3,35 TB/s là ≈ 4,8 ms.
- Vì vậy một phần lớn của mỗi token có thể là overhead, không phải phép tính cũng không phải bộ nhớ. ◆ Nếu không có phần nào chồng lấp, ≈ 33% của bước.
7. Ba cái giỏ, mỗi giỏ một cách sửa
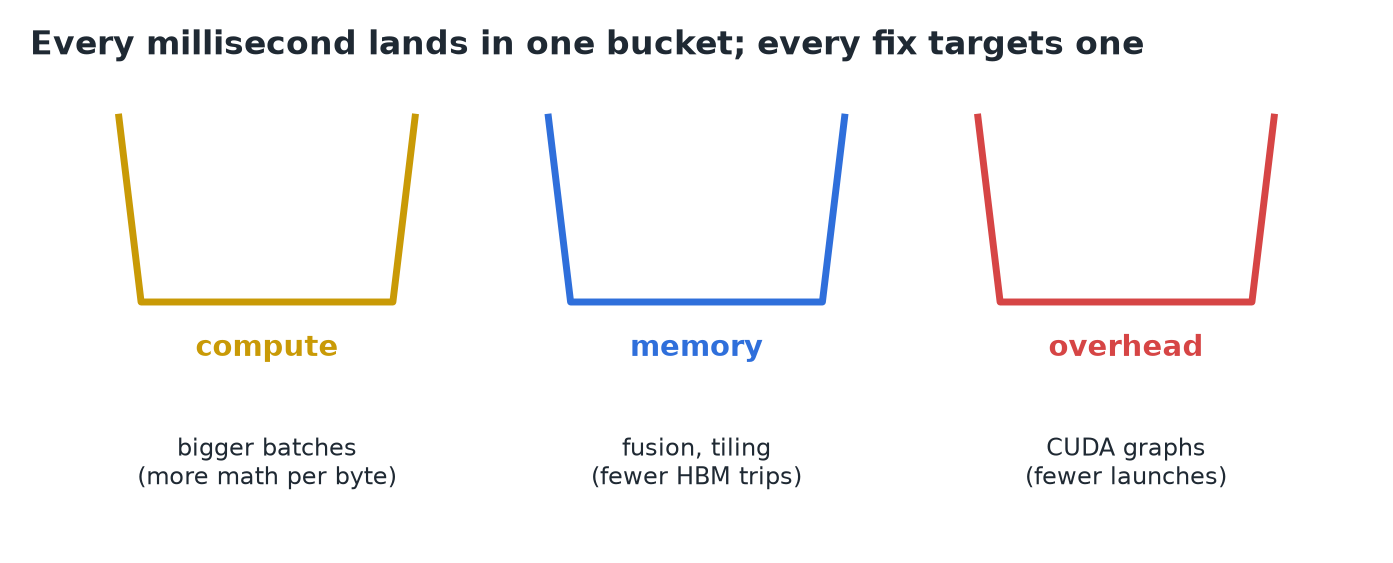
- Compute: batch lớn hơn cho phép tính có nhiều việc hơn trên mỗi byte.
- Memory: fusion và tiling cắt bớt các chuyến đi về HBM.
- Overhead: CUDA graph cắt bớt số lần launch.
8. Tóm tắt