20 · TTFT, TPOT, ITL, E2E và throughput
Nguồn: fanout.sh / inference-eng / 04-01 · ~6 phút
Ghi chú
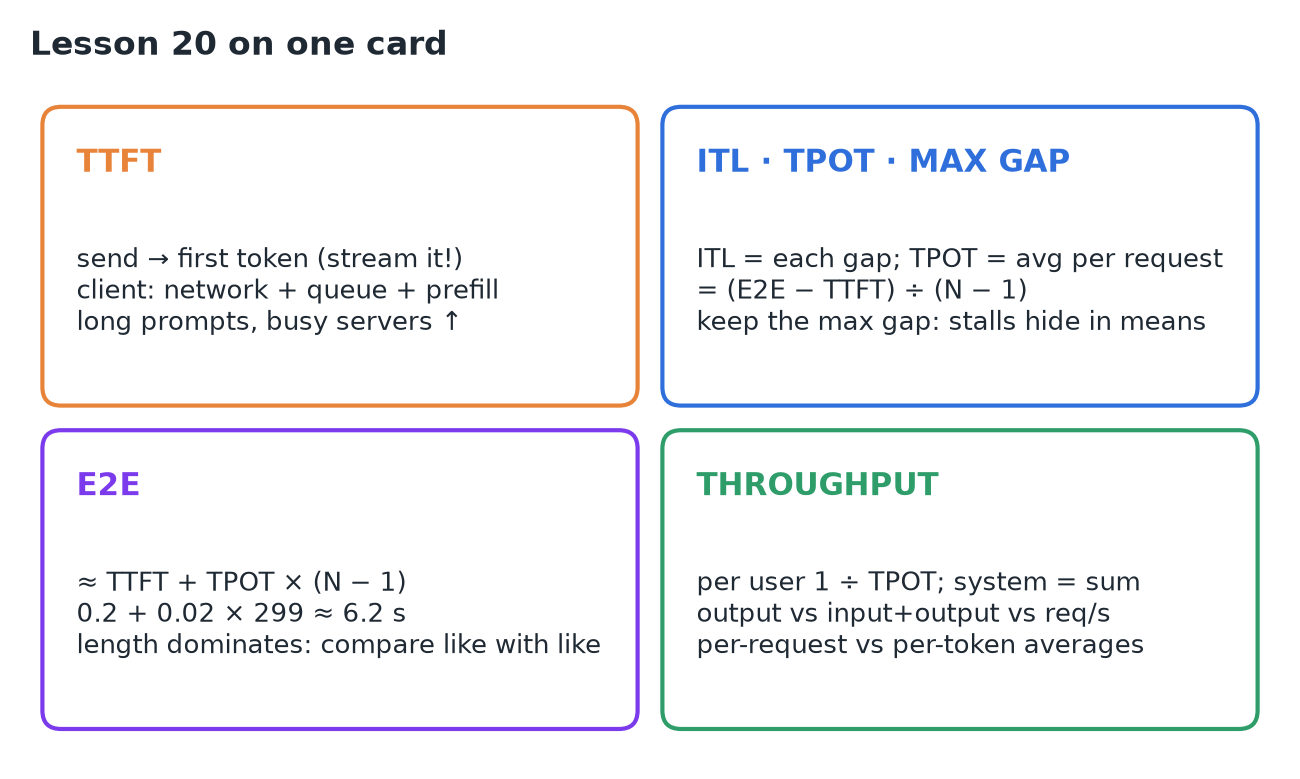
Mọi con số serving đều đo một đoạn trong dòng thời gian của một request. TTFT: gửi → token đầu tiên (mạng + hàng đợi + prefill); phải stream mới thấy được. ITL: từng khoảng cách giữa các token. TPOT: khoảng cách trung bình của một request = (E2E − TTFT) ÷ (N − 1); 20 ms = 50 tok/s. Giữ cả khoảng cách lớn nhất, vì một lần khựng 500 ms gần như không làm trung bình nhúc nhích. E2E ≈ TTFT + TPOT × (N − 1): 0,2 + 0,02 × 299 ≈ 6,2 s, bị chi phối bởi độ dài đầu ra. Bẫy lấy trung bình: theo request là 30 ms, theo token là 10,4 ms trên cùng dữ liệu. Throughput: mỗi người dùng 1 ÷ TPOT (40 tok/s); hệ thống = tổng (64 × 40 = 2.560 token đầu ra/s). Hãy kiểm tra con số tiêu đề đếm cái gì, đồng hồ bắt đầu từ đâu, và bạn đang bấm giờ token hay message.
1. Một request, một dòng thời gian
Người dùng bấm gửi, chờ, thấy chữ đầu tiên, rồi đọc từng chữ được stream tới cho tới khi câu trả lời xong.
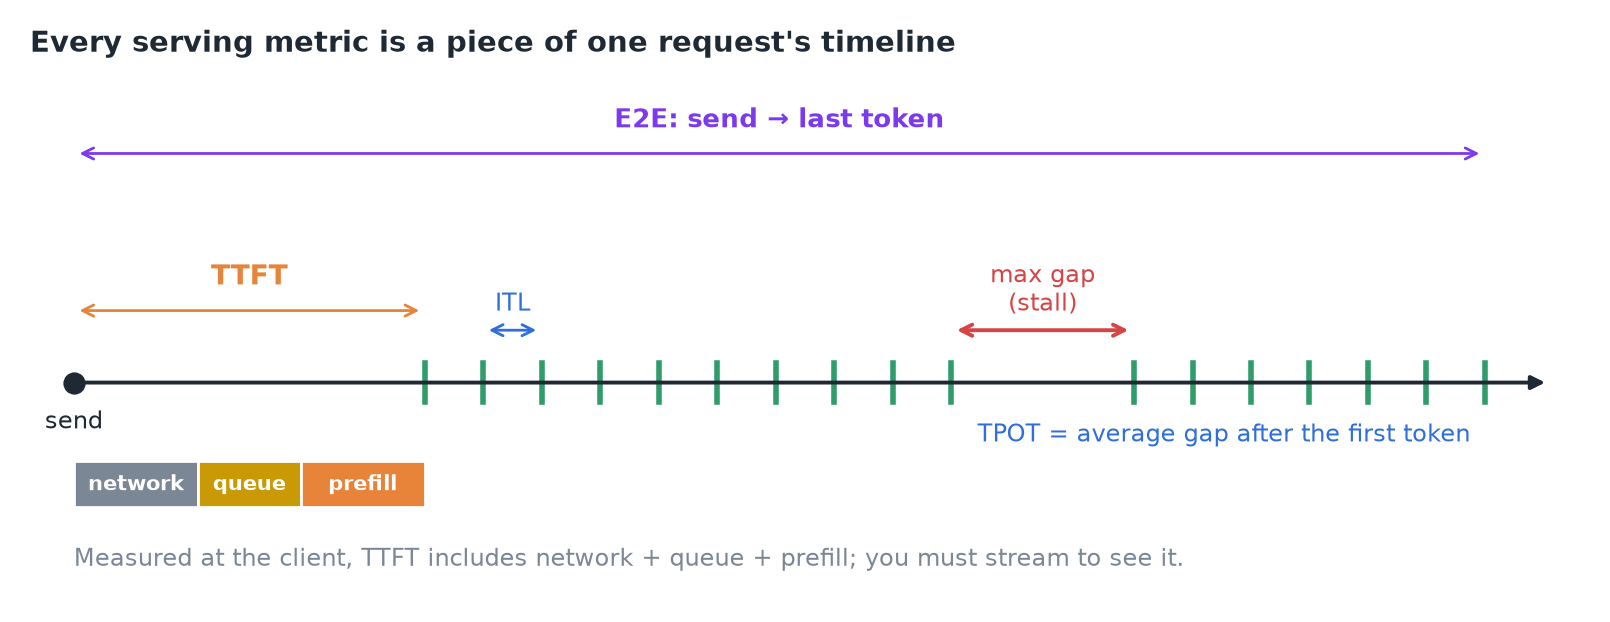 TTFT phủ phần chờ. Sau đó, mỗi khoảng cách là một inter-token latency (ITL); trung bình của chúng trong request là TPOT; khoảng lớn nhất là lần khựng. E2E trải dài toàn bộ.
2. TTFT: phần chờ
Time to first token tính từ lúc gửi request tới lúc token đầu tiên đến. Đo ở phía client thì nó gồm thời gian mạng, thời gian trong hàng đợi của server, và prefill cả prompt. Nó quyết định ứng dụng có cảm giác nhanh nhạy hay không.
- Bạn phải stream mới đo được: không stream thì token đầu tiên đến cùng lúc với token cuối.
- Prompt dài (prefill nhiều hơn) và server bận (hàng đợi dài hơn) đều đẩy nó lên.
3. ITL và TPOT: nhịp độ
Mỗi khoảng cách riêng lẻ giữa các token là một inter-token latency. Lấy trung bình chúng trong một request là được time per output token của request đó:
Token đầu tiên bị loại ra vì phần chờ của nó đã nằm trong TTFT. TPOT quyết định tốc độ đọc: 20 ms mỗi token = 50 token/s, nhanh hơn tốc độ đọc của bất kỳ ai.
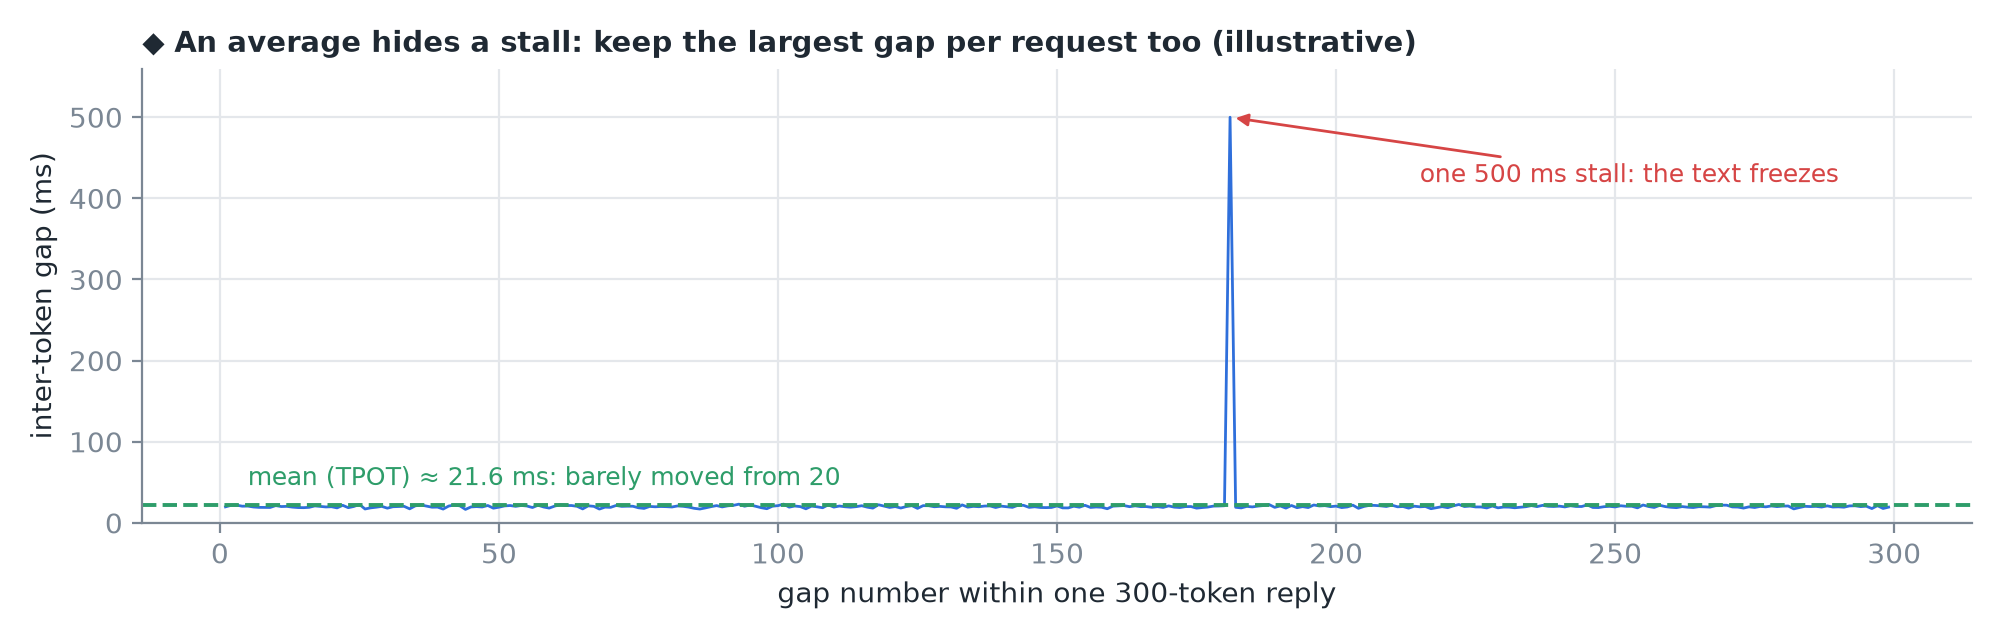 ◆ 298 khoảng 20 ms cộng một khoảng 500 ms: trung bình chỉ nhích lên (298 × 20 + 500) ÷ 299 ≈ 21,6 ms, trong khi người dùng đã thấy chữ đứng hình nửa giây.
Quan trọng
Trung bình che giấu những lần khựng. Hãy giữ thêm khoảng cách lớn nhất của mỗi request.
4. E2E: toàn bộ request
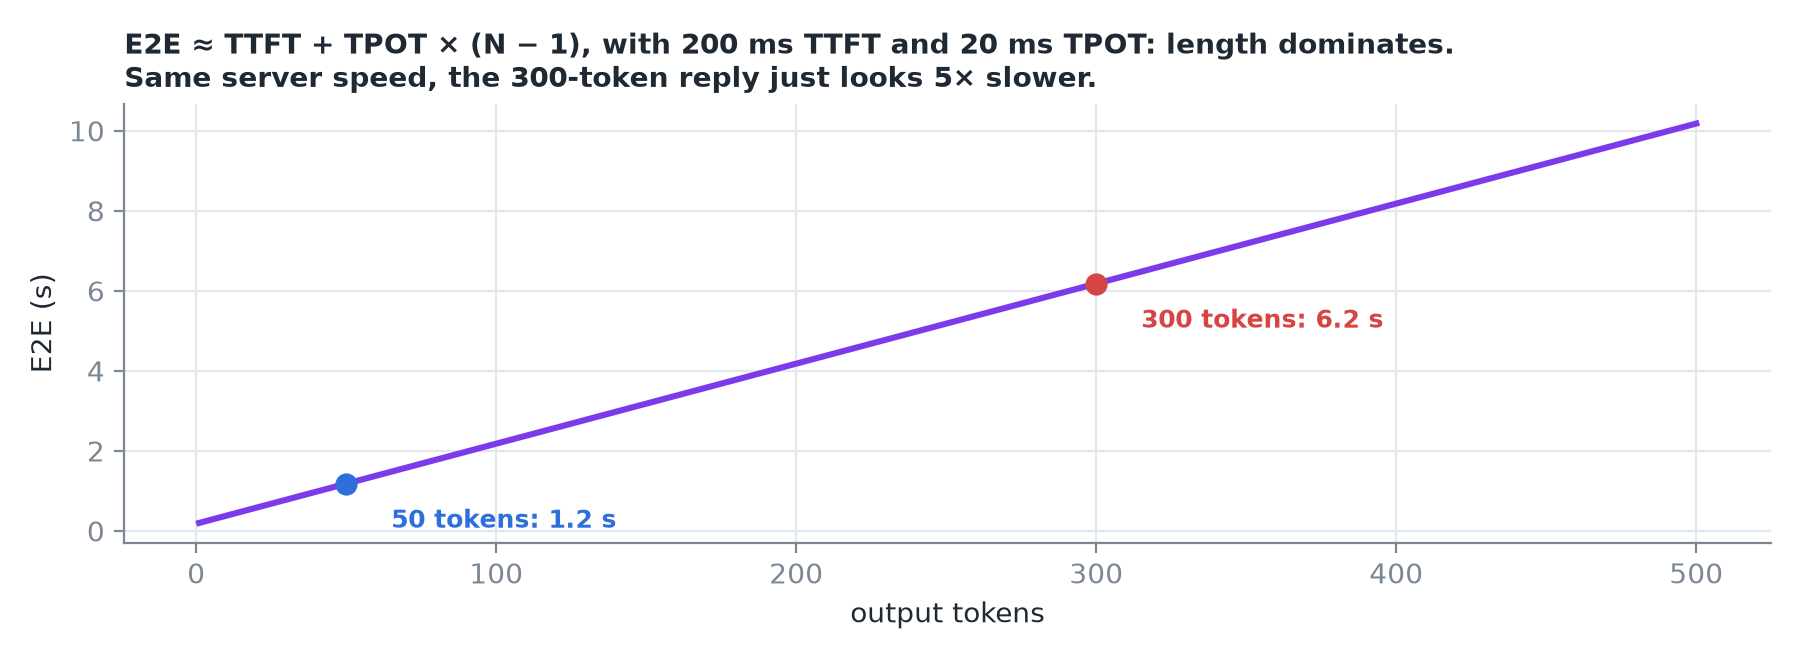 200 ms chờ chỉ là sai số làm tròn so với 299 khoảng cách: độ dài câu trả lời chiếm ưu thế.
Thận trọng
Chỉ nhìn E2E dễ bị lừa: một request "chậm hơn" có thể chỉ vì nó viết câu trả lời dài hơn. Chỉ so E2E giữa các request có độ dài tương tự, hoặc so TTFT và TPOT thay vào đó.
5. Bẫy lấy trung bình
Request A viết 10 token, mỗi khoảng 50 ms; request B viết 1.000 token, mỗi khoảng 10 ms.
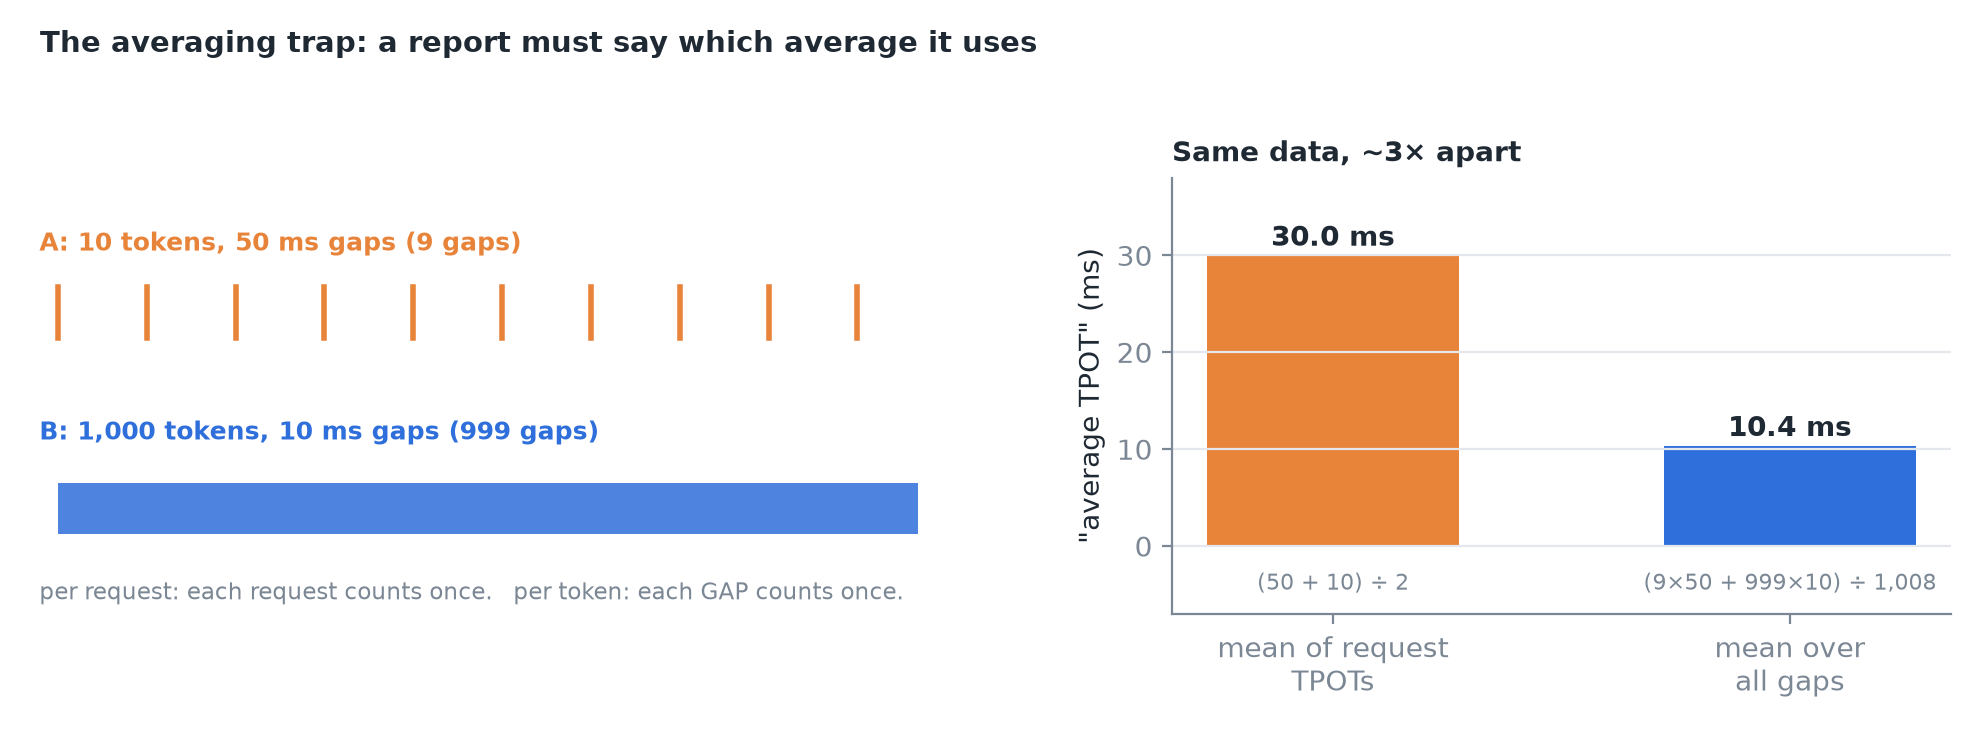 Theo request: (50 + 10) ÷ 2 = 30 ms. Theo token: 999 khoảng nhanh của B nhấn chìm 9 khoảng của A, ra ≈ 10,4 ms.
Không cách nào sai. Cách đầu coi mỗi request ngang nhau, cách sau coi mỗi token ngang nhau. Báo cáo phải nói rõ dùng cách nào, nếu không hai công cụ sẽ cãi nhau trên cùng một lần chạy.
6. Throughput: công việc mỗi giây
- Một người dùng: nghịch đảo của TPOT. 25 ms mỗi token → 40 token/s.
- Hệ thống: cộng mọi luồng lại. 64 người dùng × 40 = 2.560 token đầu ra/s.
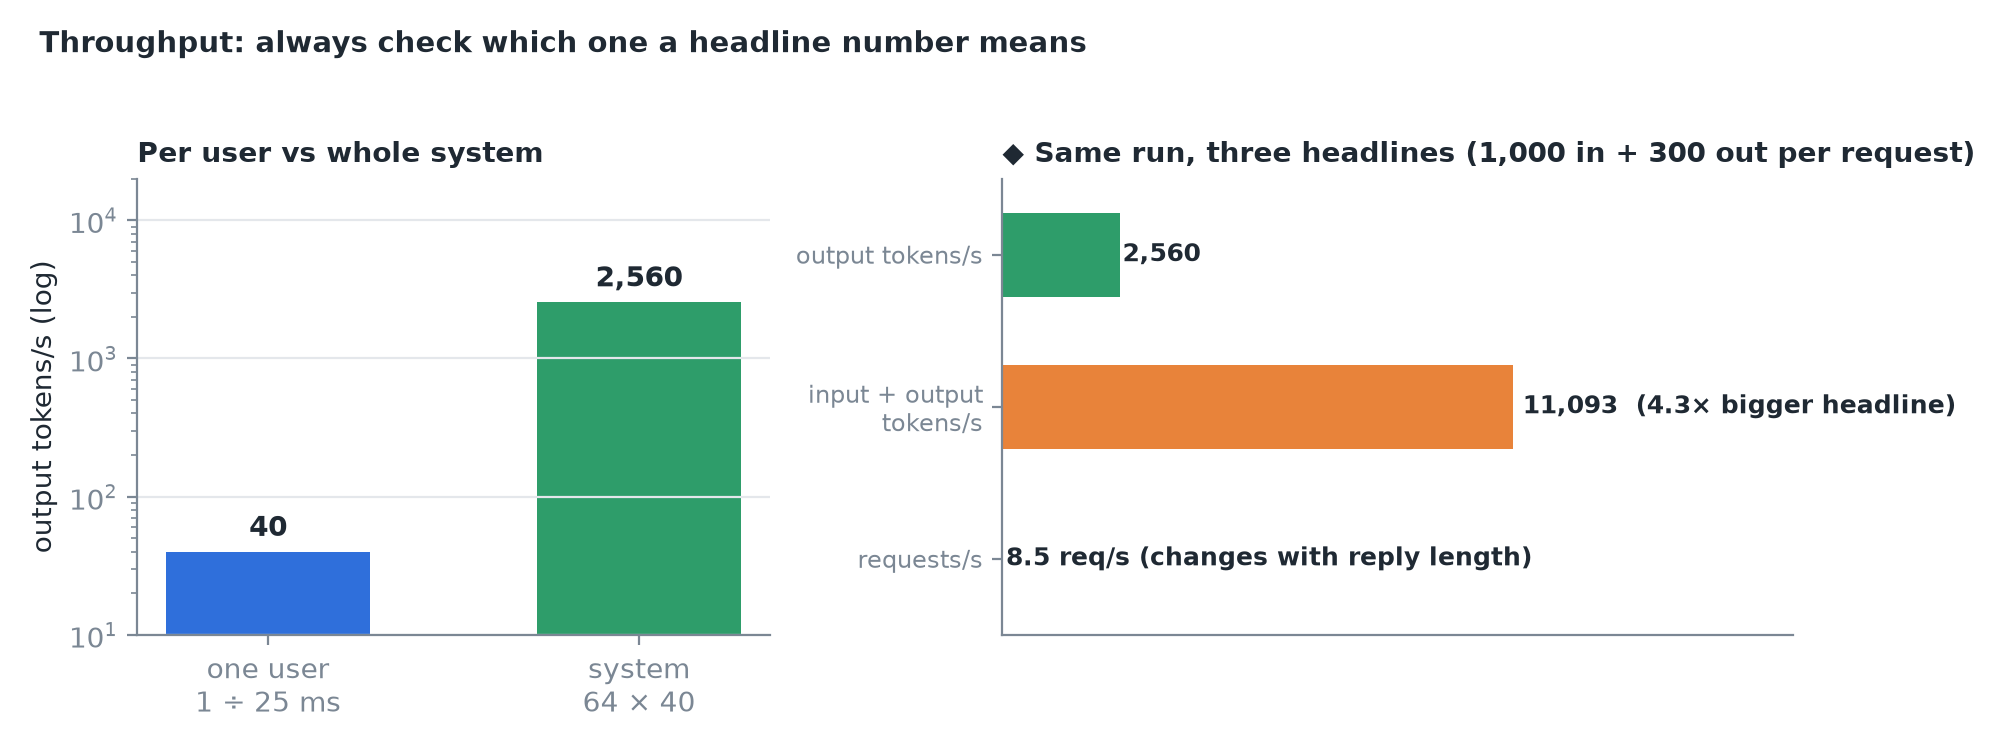 Phải: ◆ prompt 1.000 token mang tính minh hoạ. Đếm cả token đầu vào làm thổi phồng con số tiêu đề (prefill nhai prompt rất nhanh); request/s phụ thuộc vào độ dài câu trả lời.
Mẹo
Luôn kiểm tra con số tiêu đề nói về throughput nào. Và đánh đổi của decode vẫn đúng: thêm người dùng đồng thời làm tăng throughput hệ thống nhưng TPOT của từng người tệ đi một chút.
7. Đồng hồ bắt đầu từ đâu, và chuyện gom token
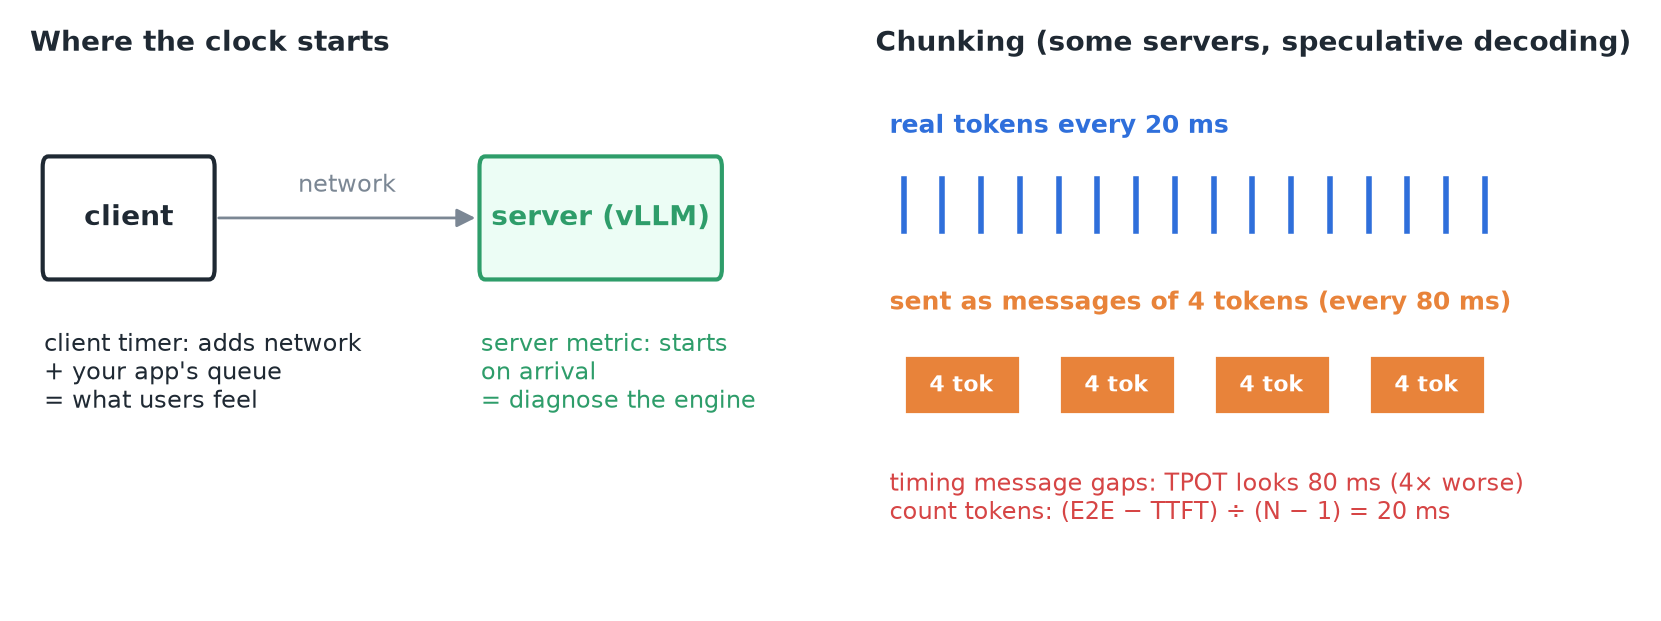
- Bộ đếm ở client: gồm cả mạng và mọi hàng đợi bên trong ứng dụng của bạn. Dùng nó để mô tả những gì người dùng cảm nhận.
- Metric ở server (ví dụ các metric vLLM xuất ra): bắt đầu khi request tới server. Dùng nó để chẩn đoán engine.
- Gom token (chunking): một số server, và speculative decoding, gửi nhiều token trong một message mạng. Bấm giờ khoảng cách giữa các message thì TPOT trông tệ hơn nhiều lần (4 token mỗi message → 4×). Công thức an toàn đếm token chứ không đếm message: (E2E − TTFT) ÷ (N − 1).
8. Tóm tắt