48 · Prompt dùng chung, context RAG và tái sử dụng qua nhiều lượt
Nguồn: fanout.sh / inference-eng / 10-06 · ~8 phút
Ghi chú
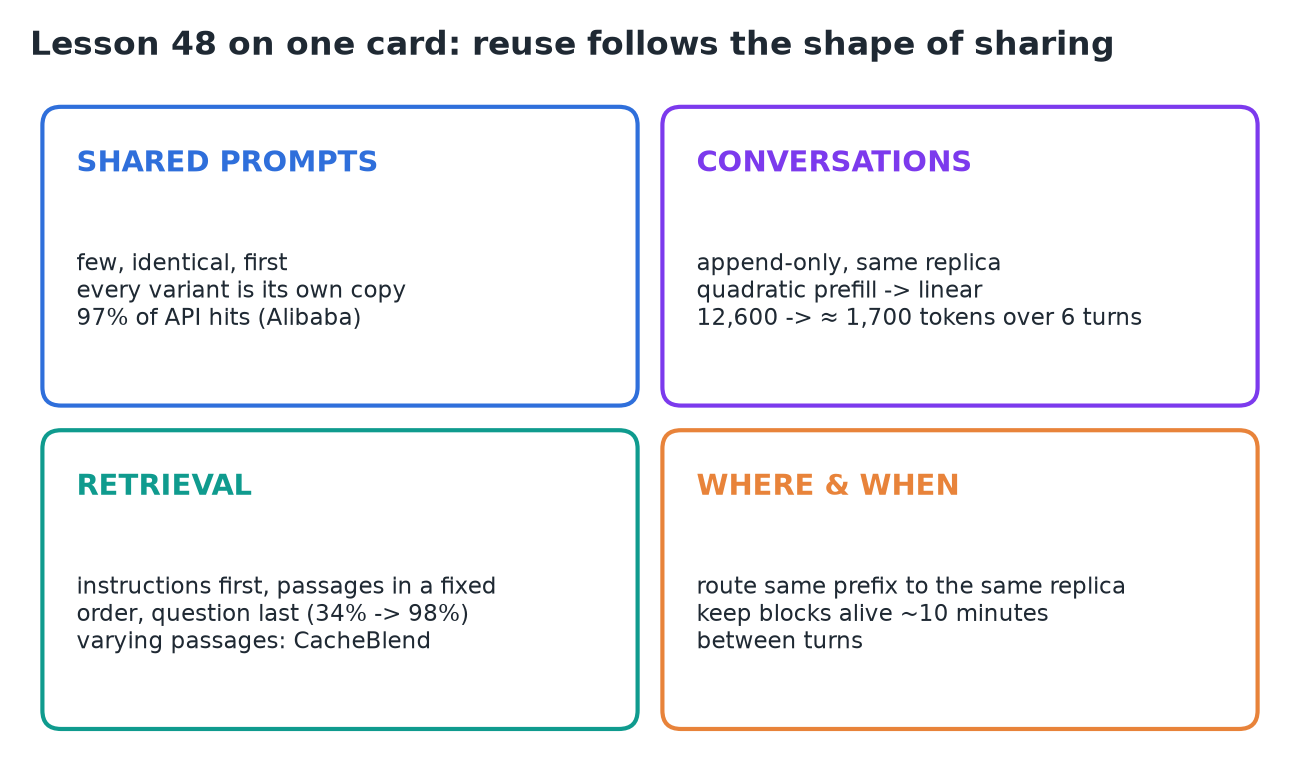
Việc tái sử dụng prefix cache đi theo hình dạng của cách các request chia sẻ văn bản. Prompt dùng chung (nhiều người dùng, một phần mở đầu) là thắng lợi lớn nhất: 97% số hit trong trace API của Alibaba, miễn là prompt giữ giống hệt từng byte. Cuộc hội thoại gửi lại mọi thứ ở mỗi lượt; tái sử dụng biến prefill bậc hai thành bậc nhất (12.600 → ≈ 1.700 token qua 6 lượt) nếu lịch sử giữ chỉ nối thêm (append-only) trên cùng một replica. Retrieval chống lại prefix caching vì các đoạn văn dùng lại được nằm ở giữa: sắp xếp chúng theo thứ tự cố định (34% → 98% được dùng lại), và khi chúng thay đổi, trộn cache bằng CacheBlend.
1. Ba hình dạng chia sẻ
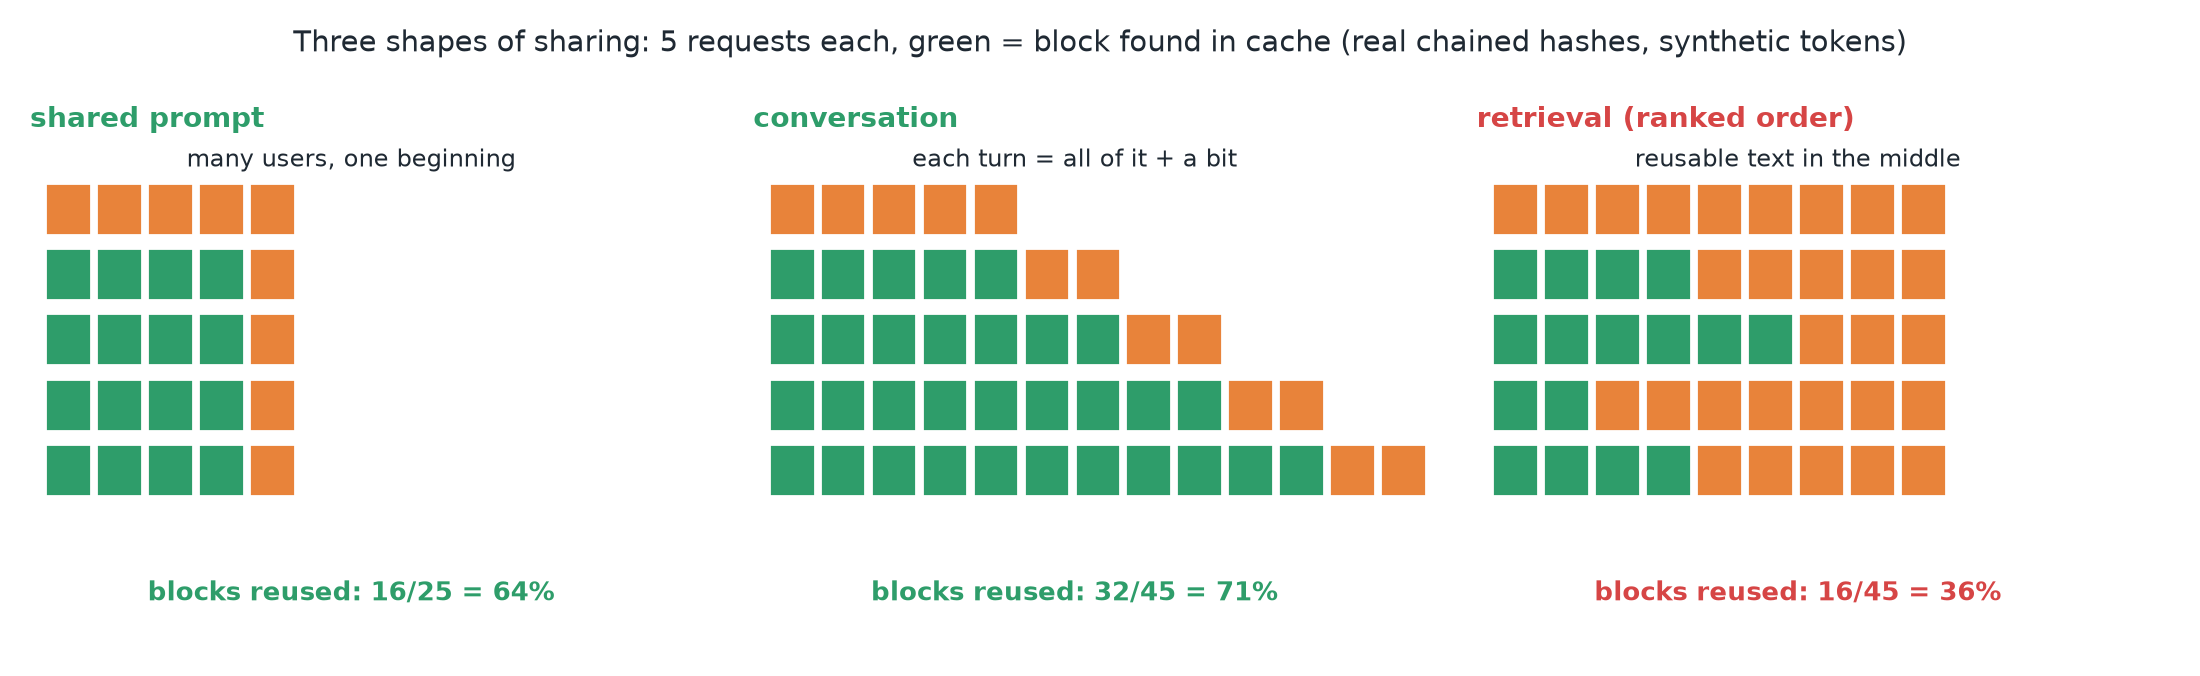 ◆ Phát lại đồ chơi cho từng hình dạng; điều bài học muốn nói là kết luận, không phải phần trăm chính xác.
- Prompt dùng chung: nhiều người dùng khác nhau, một phần mở đầu giống hệt.
- Cuộc hội thoại: mỗi lượt lặp lại toàn bộ cuộc hội thoại tới giờ và thêm một chút vào cuối.
- Retrieval: văn bản dùng lại được (tài liệu) nằm ở giữa và thay đổi theo từng truy vấn.
- Hai cái đầu hợp với prefix caching một cách tự nhiên. Cái thứ ba chống lại nó.
2. Hình dạng 1: prompt dùng chung
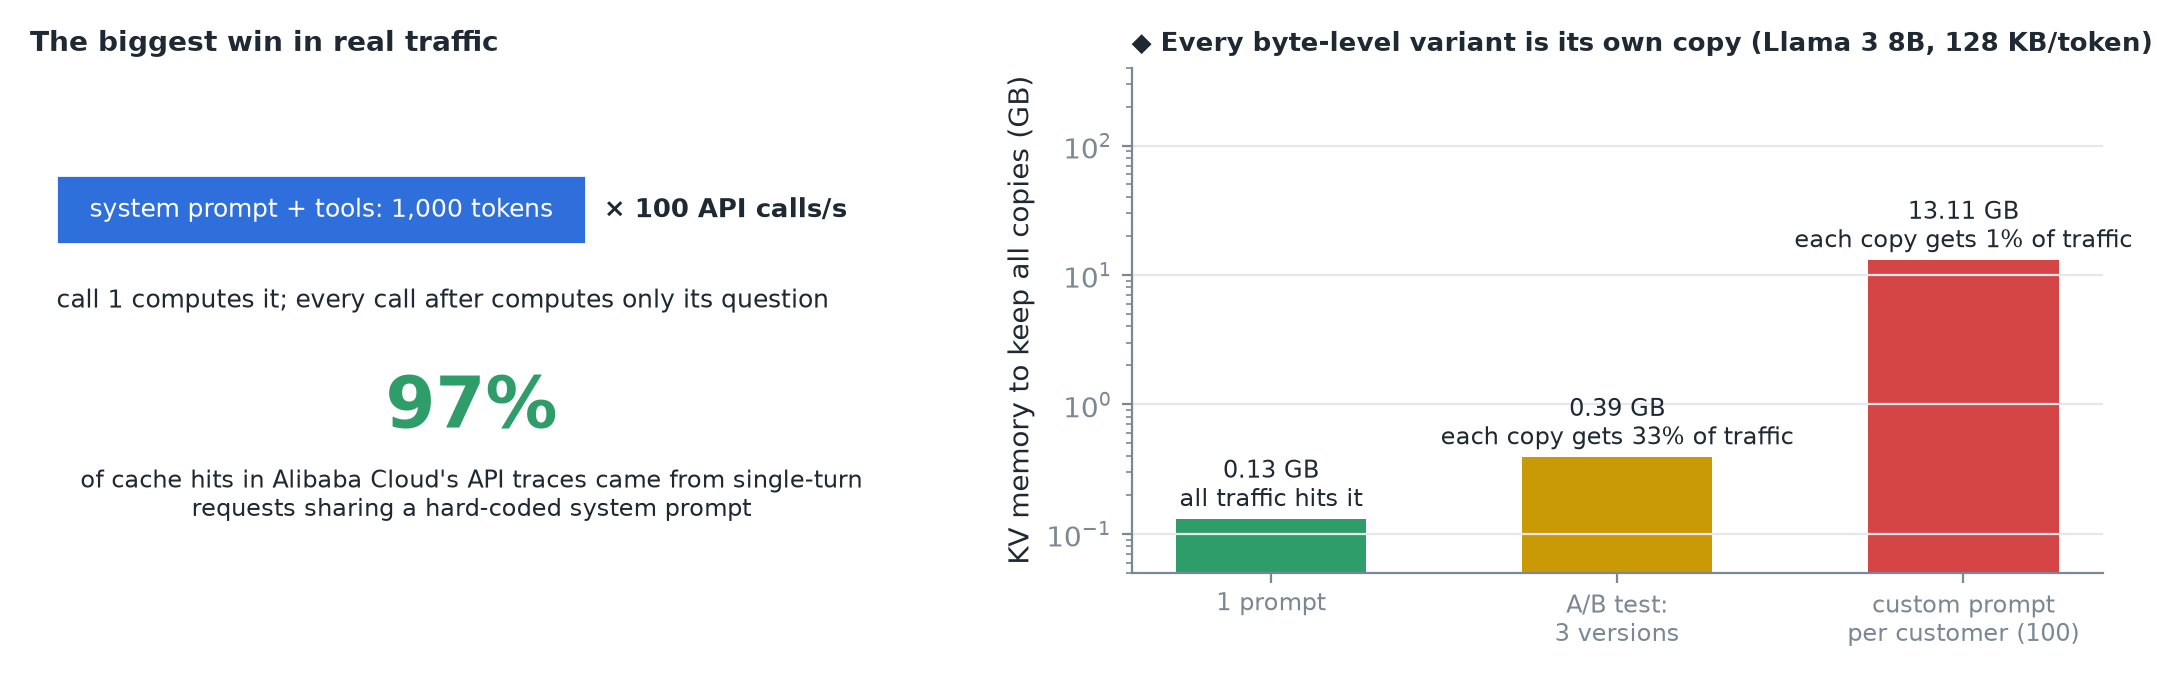 Trái: ví dụ của bài. Phải ◆: bộ nhớ KV cho mỗi bản sao, với 32 layer × 8 KV head × 128 chiều × 2 (K, V) × 2 byte = 128 KB mỗi token.
- Một system prompt 1.000 token kèm tool, được gọi 100 lần mỗi giây: lần gọi đầu tính nó, mọi lần sau chỉ tính câu hỏi riêng.
- Đó là thắng lợi lớn nhất trong lưu lượng thật: trong trace API của Alibaba Cloud, 97% tổng số cache hit đến từ request một lượt dùng chung một system prompt viết cứng.
- Prompt phải giống hệt nhau, từng byte một. Một A/B test với 3 phiên bản giữ 3 bản sao, mỗi bản một phần ba lưu lượng. Prompt tuỳ biến cho từng khách hàng chia cây thành mỗi khách hàng một nhánh.
Quan trọng
Giữ prompt dùng chung ít, ổn định, và nằm ngay đầu.
3. Hình dạng 2: cuộc hội thoại
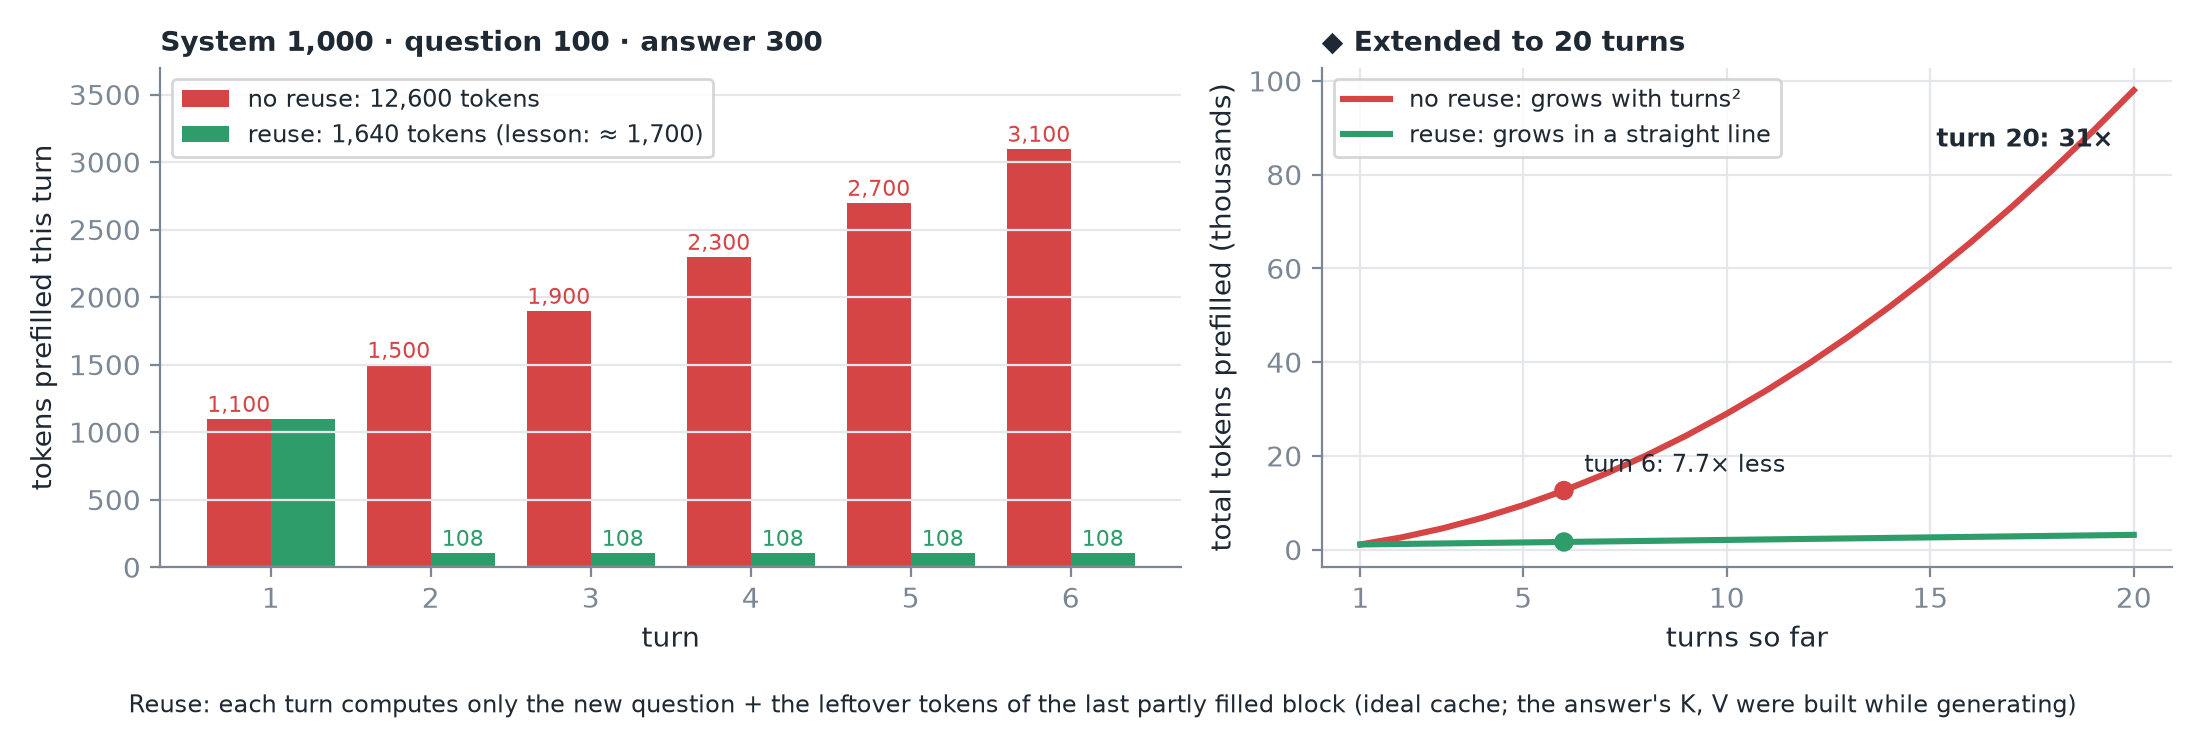 Cache lý tưởng. ◆ Phép tính theo block của tôi ra 1.640 token; bài làm tròn thành ≈ 1.700.
Mỗi lượt gửi lại system prompt, mọi câu hỏi, mọi câu trả lời, và message mới. Với system prompt 1.000 token, câu hỏi 100 và câu trả lời 300:
- Không tái sử dụng, prefill tăng theo bình phương số lượt.
- Có tái sử dụng, lượt 2 thấy toàn bộ lượt 1 đã được cache, kể cả câu trả lời model vừa viết: K và V của nó đã được tính trong lúc sinh.
- Mỗi lượt mới chỉ tính message mới cộng vài token còn sót từ block đầy một phần cuối cùng: tổng ≈ 1.700 token, ít hơn ≈ 7 lần, tăng theo đường thẳng.
Mẹo
◆ Phần sót đến từ đâu: sau lượt n, cuộc hội thoại dài 1.000 + 400n token, luôn để lại 8 token trong một block chưa đầy. Vì vậy mỗi lượt tốn 100 + 8 = 108 token, và sáu lượt tốn 1.100 + 5 × 108 = 1.640. Tới lượt 20, khoảng chênh là 31 lần.
4. Hội thoại làm vỡ cache thế nào
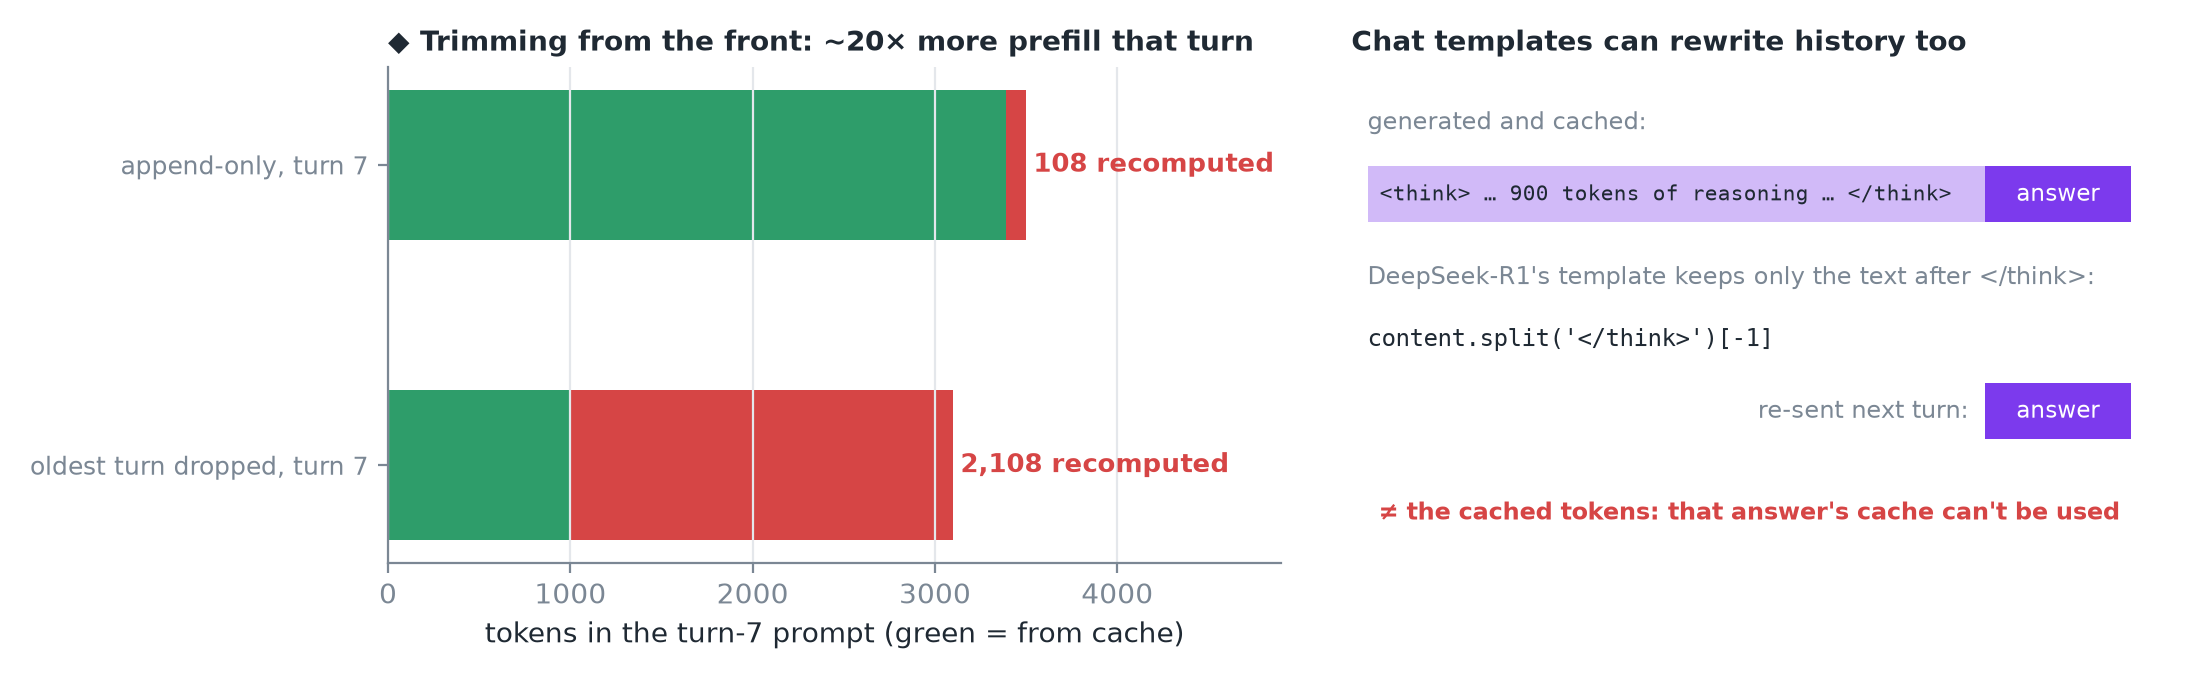 Trái ◆: cuộc hội thoại của bài ở lượt 7, với 62 block đầy của system prompt vẫn nằm trong cache sau khi cắt.
- Cắt từ phía đầu là tệ nhất: bỏ message cũ nhất làm thay đổi những token đầu tiên sau system prompt, nên cả cuộc hội thoại bị tính lại.
- Tóm tắt hoặc sửa các lượt trước cũng vậy, tính từ chỗ sửa trở đi.
- Chat template cũng có thể gây ra chuyện này: template của DeepSeek-R1 bỏ phần thinking khỏi các câu trả lời trước khi dựng lại lịch sử, nên văn bản gửi lại không còn khớp với những gì model đã sinh, và cache của câu trả lời đó không dùng được. Ổn nếu bạn đã lường trước; bất ngờ nếu không.
Mẹo
◆ Template của R1 chỉ làm mất cache của câu trả lời mới nhất, không phải toàn bộ lịch sử. Các câu trả lời cũ hơn đã được gửi ở dạng bị cắt từ lượt trước, nên chúng được cache theo dạng đó. Mỗi lượt tính lại phần văn bản hiển thị của câu trả lời mới nhất cộng câu hỏi mới.
Quan trọng
Giữ lịch sử chỉ nối thêm lâu nhất có thể. Khi buộc phải rút ngắn, hãy cắt theo cách giữ nguyên phần đầu. ◆ Ví dụ, thỉnh thoảng cắt một khúc lớn thay vì mỗi lượt cắt một message, để chỉ phải trả giá tính lại một lần.
5. Hình dạng 3: retrieval, trường hợp khó
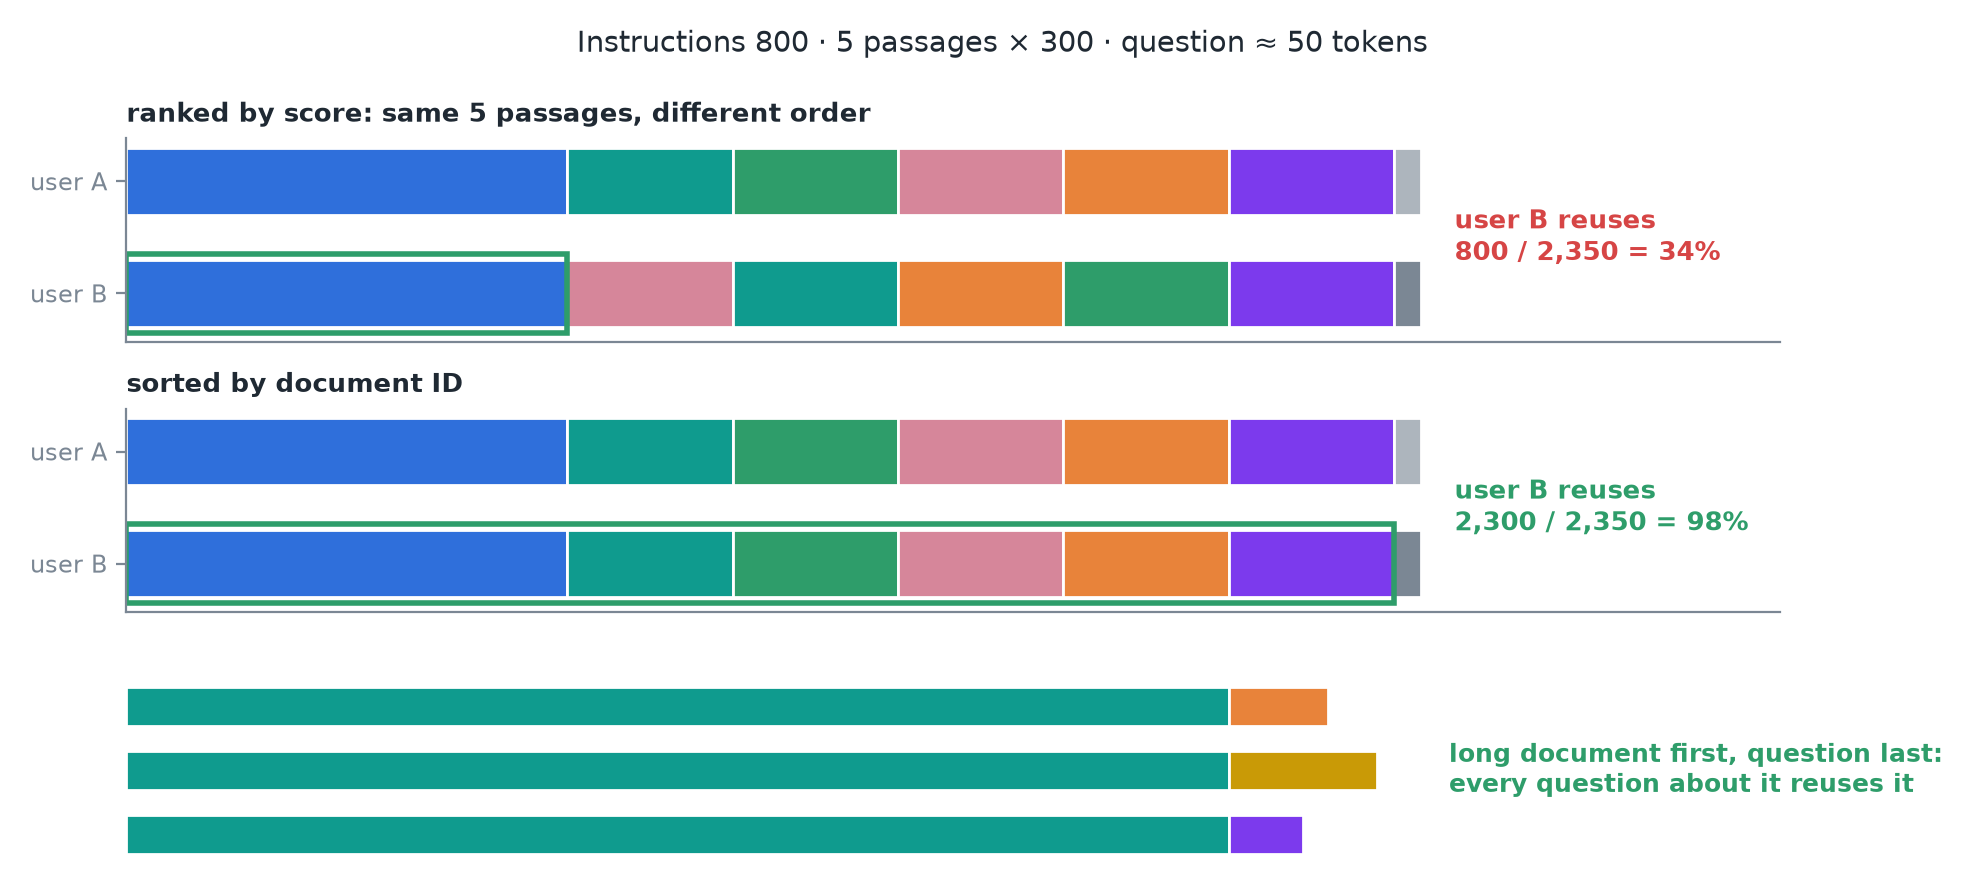 Câu hỏi ≈ 50 token được suy ra từ con số 34% của bài.
- Prompt: 800 token hướng dẫn, 5 đoạn × 300, rồi câu hỏi.
- Hai người dùng nhận cùng năm đoạn văn nhưng thứ hạng khác nhau. So khớp chạy từ đầu: hướng dẫn khớp, rồi đoạn 1 so với đoạn 3, và dừng. Chỉ ≈ 34% được dùng lại.
- Sắp xếp các đoạn theo thứ tự cố định (theo document ID, không theo điểm) là gần như cả prompt thẳng hàng: ≈ 98% được dùng lại.
- Cùng ý tưởng cho hỏi đáp tài liệu dài: tài liệu trước, câu hỏi sau cùng, và mọi câu hỏi về tài liệu đó đều dùng lại được nó.
6. Vượt ra ngoài prefix: CacheBlend
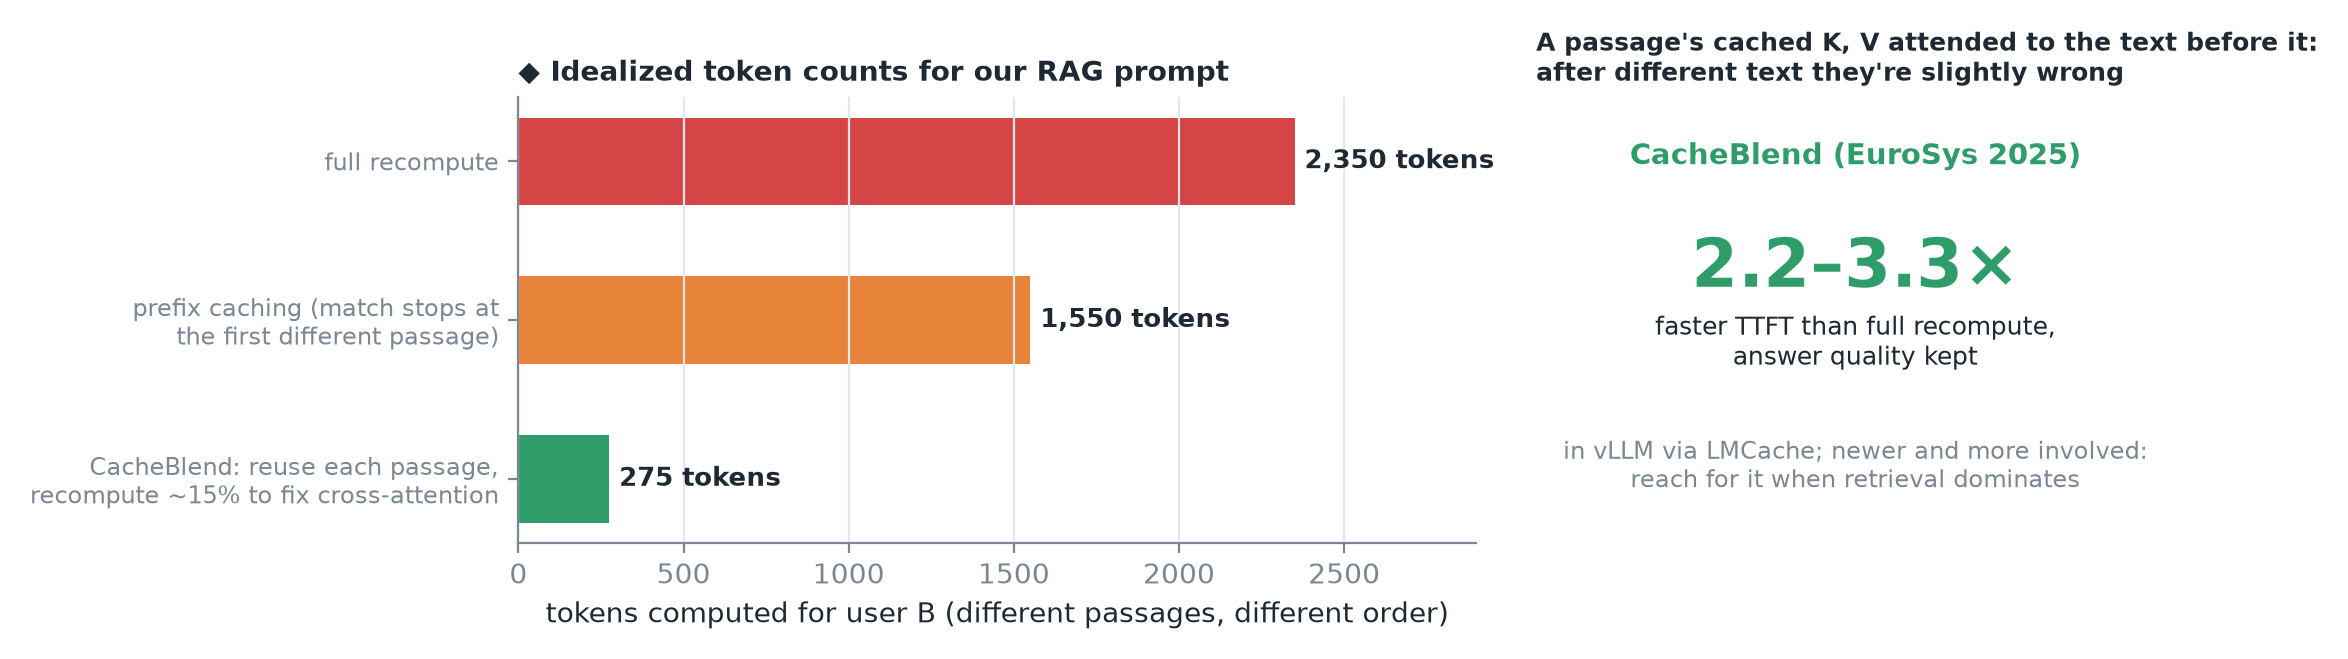 ◆ Số token là cách lý tưởng hoá của tôi cho prompt RAG của bài; 15% là cấu hình ví dụ của LMCache.
- Thường thì hai truy vấn lấy về tập đoạn văn khác nhau. Một đoạn xuất hiện sau văn bản khác hoàn toàn không dùng lại được bằng prefix caching.
- Vì sao: K và V đã cache của một đoạn được tính trong lúc attend vào văn bản phía trước nó. Sau văn bản khác, chúng hơi sai.
- CacheBlend (EuroSys 2025) vẫn dùng lại cache của từng đoạn và tính lại một phần nhỏ token (≈ 15% trong ví dụ của LMCache) để sửa phần cross-attention: TTFT nhanh hơn 2,2–3,3 lần so với tính lại toàn bộ, mà không giảm chất lượng câu trả lời.
- Có trong vLLM thông qua LMCache. Mới hơn và phức tạp hơn prefix caching: hãy dùng nó khi retrieval chiếm phần lớn prompt của bạn.
7. Ở đâu, và khi nào
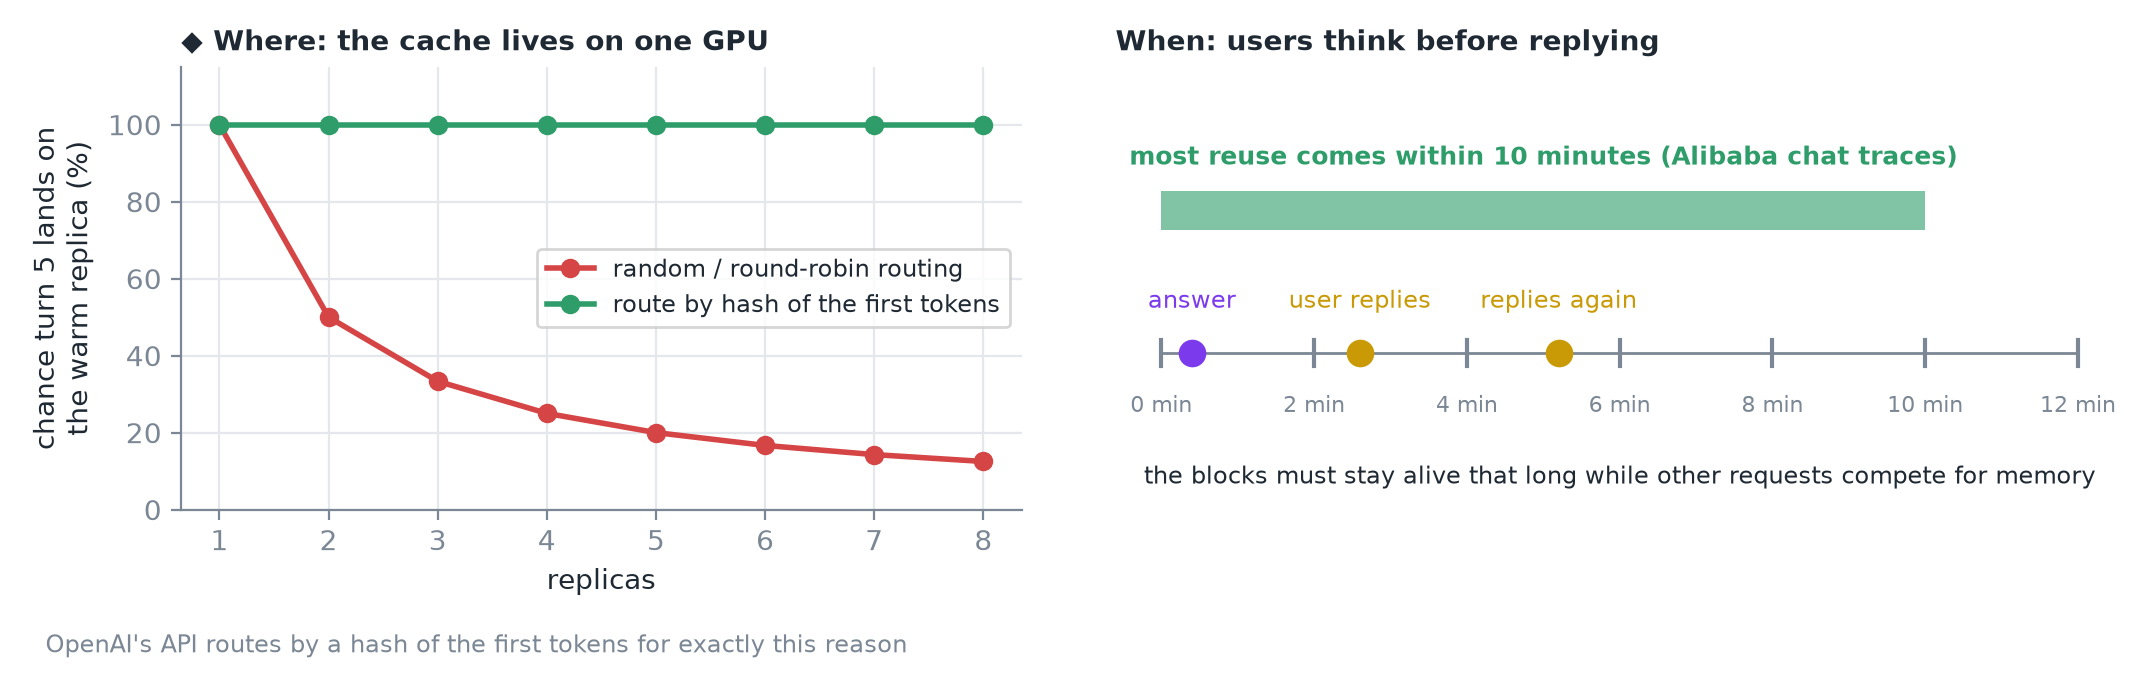 Trái ◆: với định tuyến ngẫu nhiên, lượt 5 tìm thấy cache của nó với xác suất 1/N.
- Ở đâu: cache nằm trên một GPU. Nếu lượt 5 rơi vào replica khác, nó bắt đầu lạnh. Định tuyến các request chung prefix tới cùng một nơi; API của OpenAI định tuyến theo hash của các token đầu chính vì lý do này.
- Khi nào: người dùng suy nghĩ trước khi trả lời. Trong lưu lượng chat của Alibaba, phần lớn việc dùng lại xảy ra trong vòng 10 phút, nên cache phải giữ các block đó sống lâu như vậy trong khi các request khác tranh bộ nhớ.
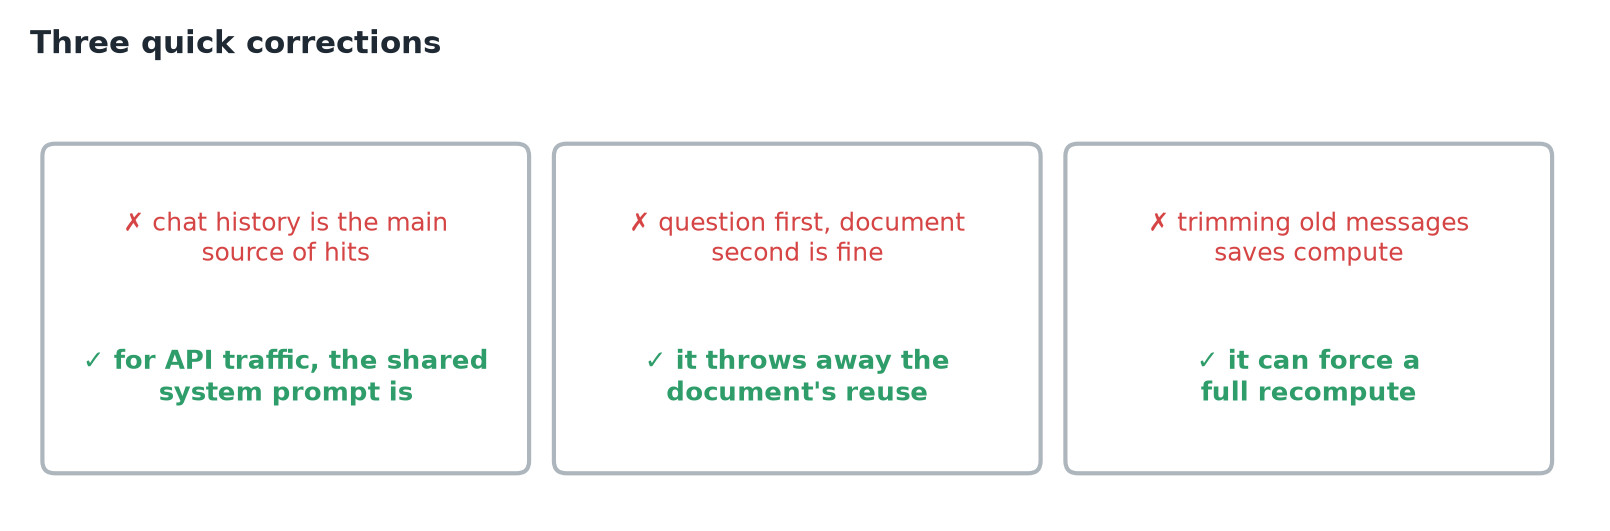 Ba điều cần chỉnh lại của bài.
8. Tóm tắt