58 · Nsight Compute
Nguồn: fanout.sh / inference-eng / 12-04 · ~7 phút (bài dạng văn bản)
Ghi chú
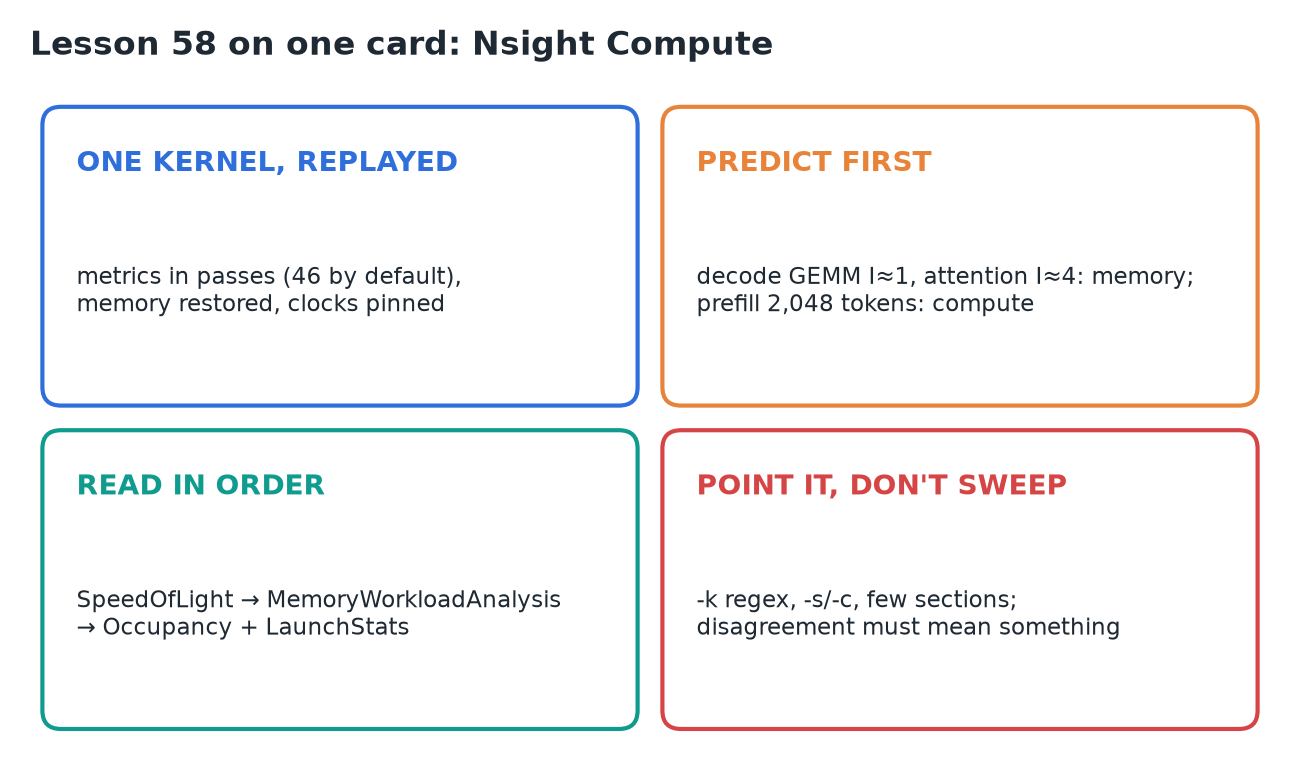
Một khi một profiler rẻ hơn đã gọi tên kernel chiếm thời gian, Nsight Compute (ncu) đọc một lần launch của kernel đó thật kỹ lưỡng, đo so với các mức tối đa của chính cỗ máy. Nó đạt được độ sâu đó bằng cách phát lại lần launch một lần cho mỗi nhóm metric (46 lượt cho bộ mặc định), với bộ nhớ được khôi phục và xung nhịp được ghim, nên wall-clock time là sản phẩm phụ giả tạo và chỉ giá trị metric là có nghĩa. Phương pháp là dự đoán giới hạn trước bằng roofline, rồi đọc báo cáo theo thứ tự: Speed Of Light, memory workload, occupancy. Hãy chĩa nó vào một nghi phạm; đừng bao giờ dùng nó để quét cả một server.
1. Phát lại và cái giá của nó
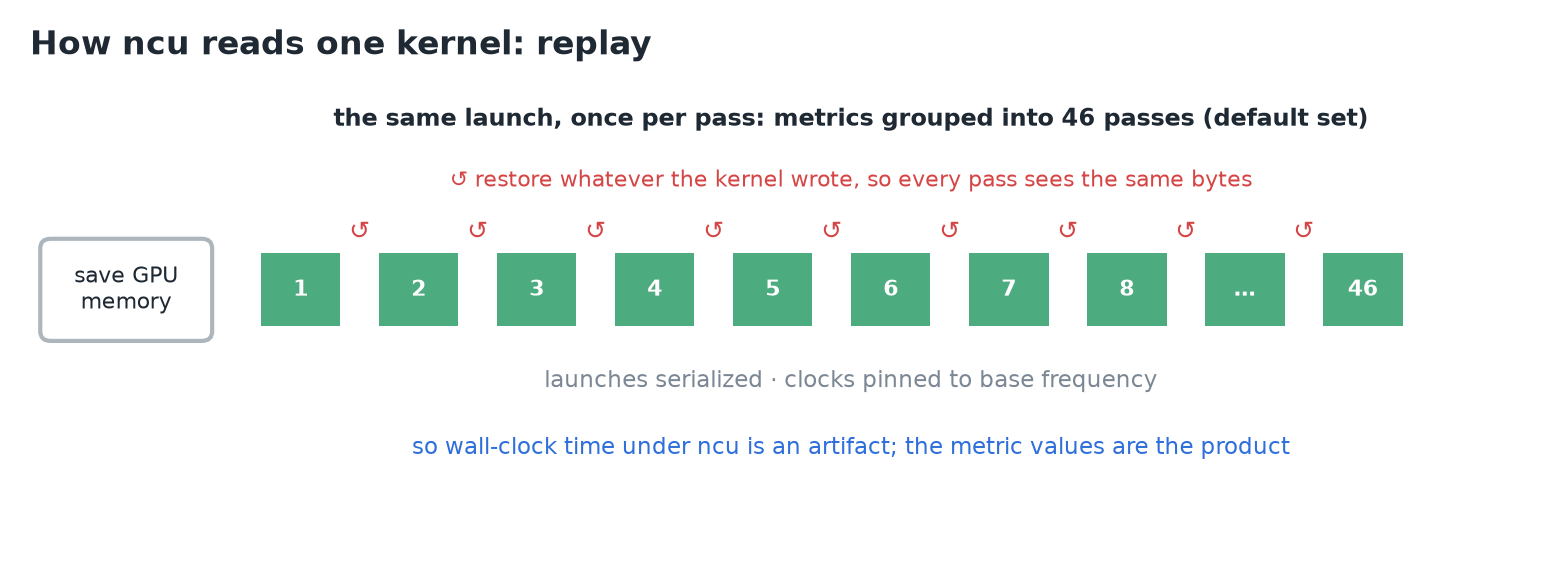 Một lần launch, nhiều lượt, lượt nào cũng trên cùng những byte đó.
- GPU không thu thập được mọi counter cùng lúc (counter phần cứng có hạn; một số metric cần vá lệnh). Vì vậy
ncugom các metric được yêu cầu thành các lượt (pass) và phát lại cùng lần launch đó một lần cho mỗi lượt. - Trước lượt đầu, nó lưu lại toàn bộ bộ nhớ GPU mà kernel có thể chạm tới; giữa các lượt, nó khôi phục những gì kernel đã ghi.
- Nó tuần tự hoá các lần launch kernel và cố ghim xung nhịp ở tần số cơ bản, để các lượt khớp nhau và kết quả không phụ thuộc vào việc kernel chạy ở đâu trong ứng dụng.
- Quickstart của NVIDIA: một ứng dụng cộng vector với hai kernel (4.471 block × 256 thread, cho 1.144.477 phần tử); mỗi kernel chạy 46 lần với bộ metric mặc định.
Cảnh báo
Một lần chạy dưới ncu bị tuần tự hoá, phát lại và ghim xung nhịp. Thời gian trôi qua của nó không nói gì về latency dịch vụ của bạn; giá trị metric mới là sản phẩm.
2. Dự đoán báo cáo trước khi nó in ra
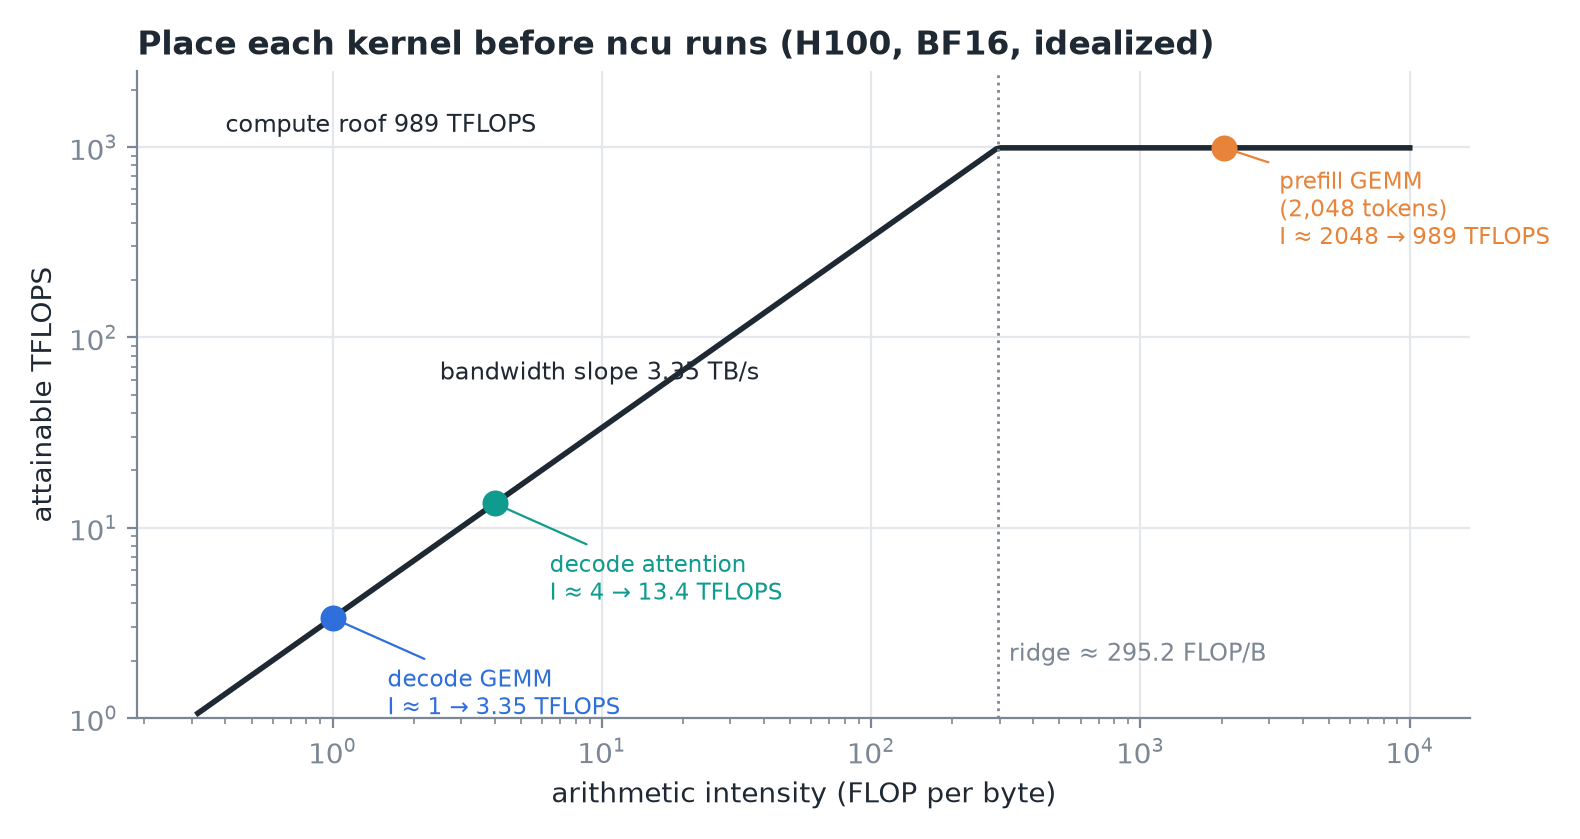 Ba kernel inference đặt lên roofline của H100 chỉ từ phép đếm.
- GEMM của decode (trọng số × vài token): intensity ≈ 1 FLOP/byte. Ở băng thông đầy đủ đó là 3,35 TFLOPS, khoảng ⅓ của 1% trần tính toán. Một GEMM decode tốt dính chặt vào phía bộ nhớ với phần tính toán gần như rảnh.
- GEMM của prefill ở 2.048 token: intensity ≈ độ dài prompt, điểm cắt ở ≈ 295 token, nên nó nằm qua điểm gãy ≈ 7 lần. Trần tính toán ràng buộc và bộ nhớ không còn là câu chuyện chính.
- Attention của decode: đọc K/V đã cache. Mỗi giá trị cache 2 byte tốn 2 FLOP cho mỗi query head dùng nó, và với GQA 4 query head dùng chung mỗi lần đọc: ≈ 4 FLOP mỗi byte. Cao hơn intensity của luồng trọng số, nhưng vẫn thiếu ≈ 74 lần mới tới điểm gãy, nên vẫn memory-bound.
- Nếu báo cáo khớp, đó là xác nhận. Nếu không khớp, hoặc phép đo sai (bộ lọc tên khớp nhầm kernel, lần launch đầu còn lạnh) hoặc nó đang dạy bạn điều gì đó: lưu lượng bạn tưởng đến từ HBM lại đang được phục vụ từ một chỗ gần hơn.
3. Speed Of Light
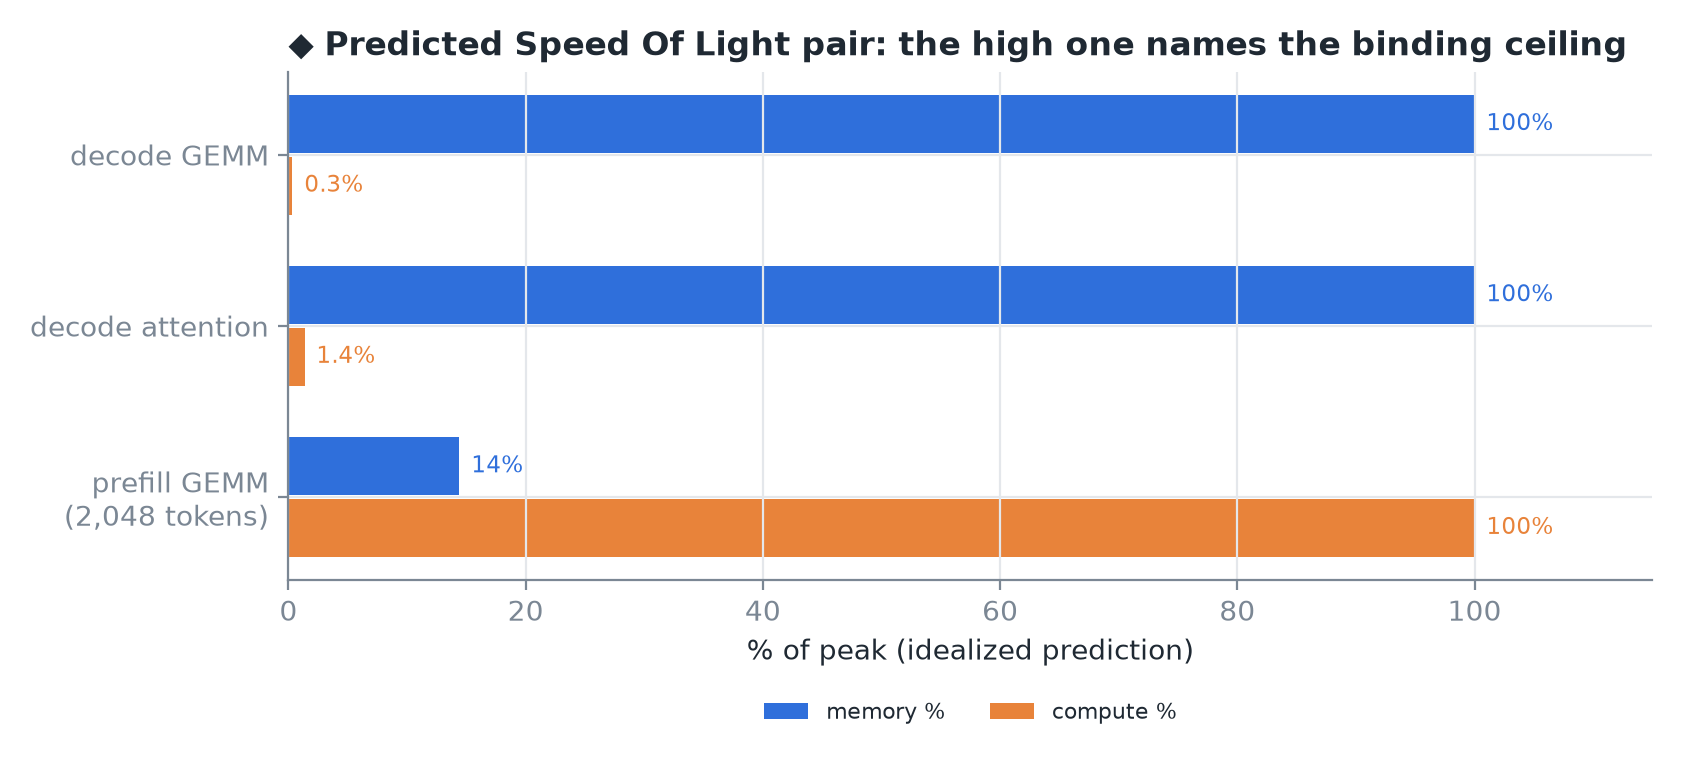 ◆ Dự đoán lý tưởng hoá của tôi cho hai tỷ lệ phần trăm của mỗi kernel.
- Mục đầu tiên cần đọc:
SpeedOfLight("GPU Speed Of Light Throughput"). Hai con số chính: compute % và memory %, mỗi cái là mức sử dụng đạt được so với mức tối đa lý thuyết. - Cái nào cao thì đó là trần đang ràng buộc. Đó là phép chia roofline, nhưng đã được đo.
- Tên metric gồm phần gốc cộng một hậu tố, ví dụ compute là
sm__throughput.avg.pct_of_peak_sustained_elapsed. SpeedOfLight_RooflineChartvẽ cùng roofline đó (log FLOP/s theo log intensity, đường băng thông dốc, đỉnh phẳng, một điểm gãy) với kernel là một điểm đo được.- Quy tắc đọc của tài liệu: một điểm nằm trên đường băng thông, dưới điểm gãy chỉ tăng FLOP/s được nếu intensity của nó cũng tăng.
4. Phân tích memory workload
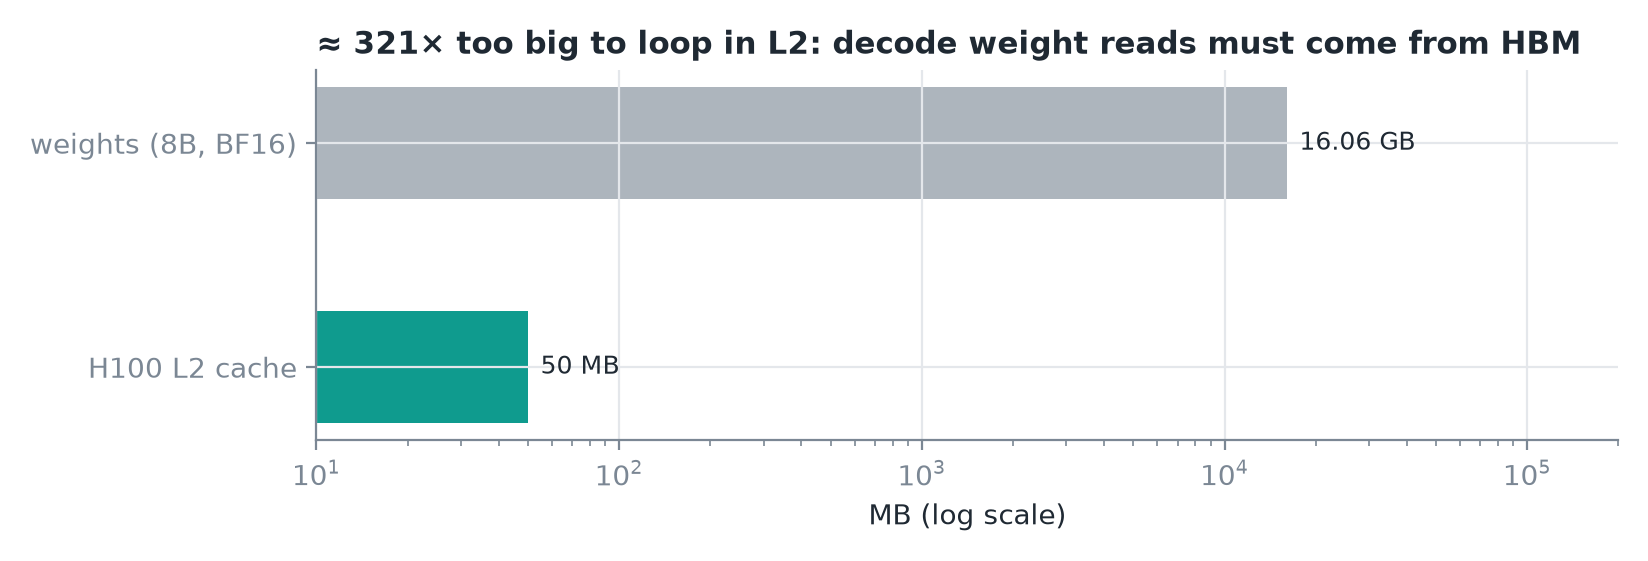 Trọng số quá lớn để cache giúp được decode.
- Khi memory % cao,
MemoryWorkloadAnalysischo biết áp lực nằm ở đâu: các đơn vị bị giữ bận, băng thông giữa chúng cạn kiệt, hay tốc độ phát lệnh bộ nhớ đã chạm giới hạn. - Hai con số quan trọng nhất với kernel dạng decode:
- throughput bộ nhớ thiết bị đạt được (byte/s), đọc so với 3,35 TB/s;
- L2 hit rate: tỷ lệ sector được yêu cầu phục vụ từ L2 mà không phải ra HBM.
- Kỳ vọng: 16,06 GB trọng số so với L2 50 MB, ≈ 321 lần, nên trọng số không thể quay vòng trong cache; mỗi bước decode stream chúng từ HBM. KV cache cũng stream theo cách đó.
- Một kernel bạn tưởng là stream mà lại có hit rate cao là trường hợp không khớp: một số byte bạn đã đếm chưa bao giờ rời cache, nên hãy tính lại giới hạn trước khi tin báo cáo.
5. Occupancy và thống kê launch
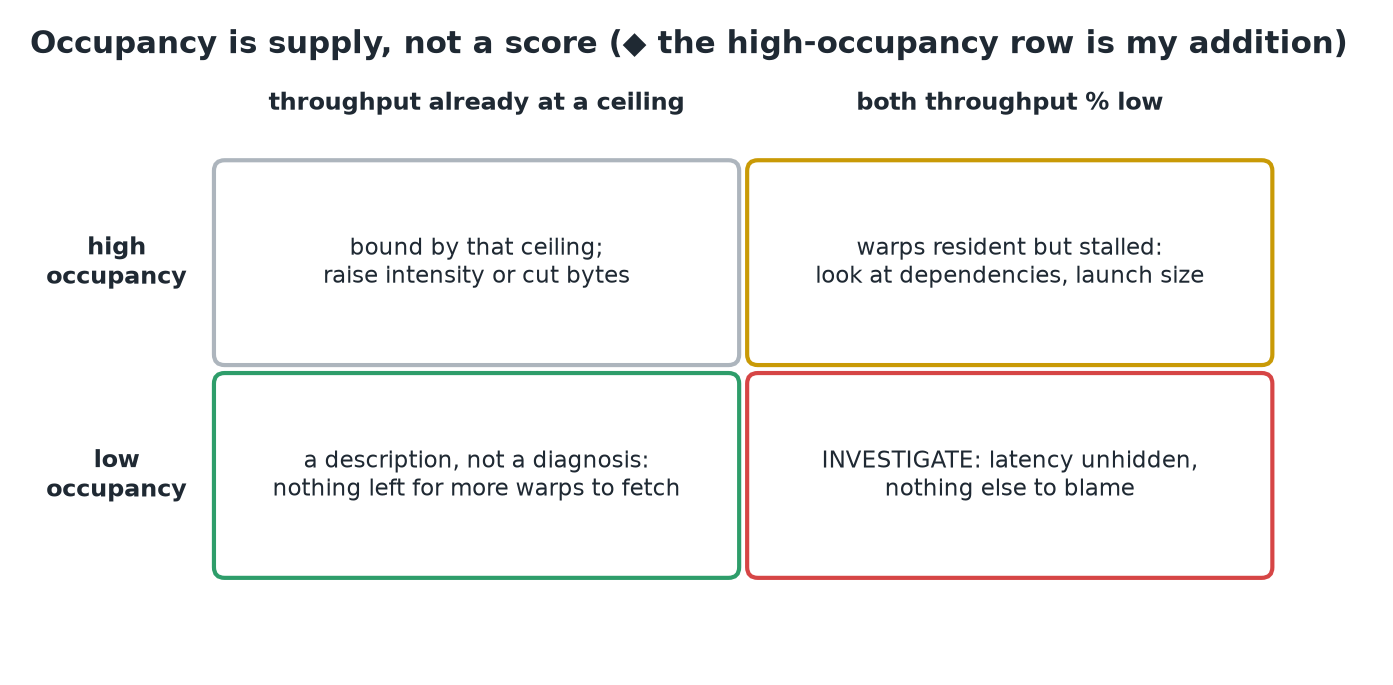 Đọc occupancy cạnh cặp Speed Of Light, đừng bao giờ đọc riêng.
- Occupancy hỏi mỗi SM có giữ đủ warp thường trú để che giấu latency không. Mục
Occupancybáo nó hai lần: lý thuyết (từ ngân sách của lần launch) và đạt được (từ lúc thực thi). Khoảng chênh lớn nghĩa là workload mất cân bằng nặng. LaunchStatsin cấu hình: grid, block, tài nguyên yêu cầu.- Các metric giới hạn biến con số thành nguyên nhân, mỗi ngân sách một metric:
launch__occupancy_limit_registerslaunch__occupancy_limit_shared_memlaunch__occupancy_limit_warpslaunch__occupancy_limit_blocks
- Lượt đọc kết thúc ở thứ mà tác giả kernel có thể hành động: số register mỗi thread, shared memory mỗi block, kích thước block.
Thận trọng
Occupancy thấp không kết tội một kernel. Nếu throughput bộ nhớ đã ở mức trần, thêm warp cũng không có gì để lấy, nên occupancy thấp chỉ là mô tả, không phải chẩn đoán. Hãy điều tra khi occupancy thấp và cả hai tỷ lệ throughput cũng thấp: latency không được che giấu mà không có gì khác để đổ lỗi.
6. Dòng lệnh
ncu --section SpeedOfLight \
    --section MemoryWorkloadAnalysis \
    --section Occupancy --section LaunchStats \
    -k regex:"gemm" -s 2048 -c 1 \
-o decode-gemm python decode_step.py| Cờ | Ý nghĩa |
|---|---|
-k regex:"gemm" | lọc kernel theo tên (đặt trong ngoặc kép cho shell). Dùng tên mà các công cụ rẻ hơn đã cho bạn thấy: kernel của thư viện toán nhanh không phải lúc nào cũng chứa "gemm" |
-s 2048 -c 1 | bỏ qua 2.048 lần launch khớp, rồi thu 1 |
--section … | chọn câu hỏi theo định danh (mặc định: bộ cơ bản) |
-o decode-gemm | ghi decode-gemm.ncu-rep; mở lại bằng ncu --import hoặc UI |
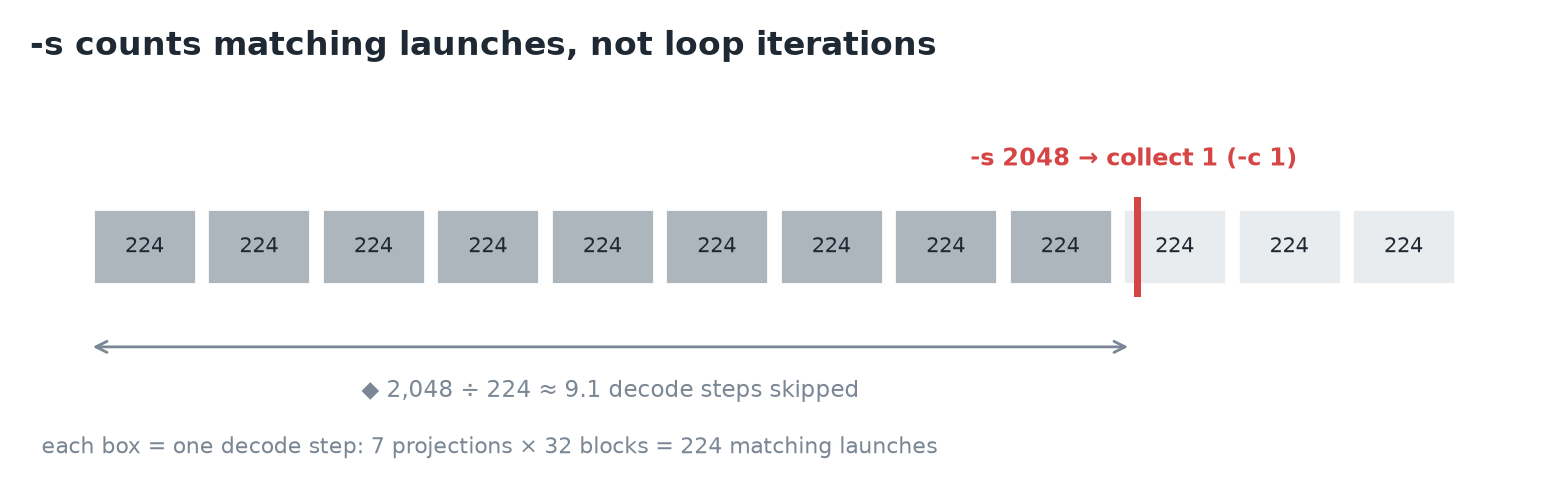 ◆
-s 2048 rơi vào chỗ nào trong lần chạy.
- Số lần bỏ qua đếm các lần launch khớp, không phải số vòng lặp. Một bước decode launch một GEMM khớp ít nhất một lần cho mỗi phép chiếu: 7 mỗi block × 32 block = 224 mỗi bước. Vì vậy một số bỏ qua đủ để vượt giai đoạn lạnh được tính bằng hàng nghìn; khi không chắc, hãy chạy một lượt đầu không lọc.
- Kỷ luật chi phí: mỗi mục thêm metric, nhiều metric hơn nghĩa là nhiều lượt hơn, và kernel đầu tiên được profile trong một context trả chi phí thiết lập một lần. Thu ít kernel và metric nhất mà câu hỏi cần.
Quan trọng
Chĩa ncu vào một kernel mà các công cụ rẻ hơn đã gọi tên. Quyết định hai tỷ lệ Speed Of Light nên là bao nhiêu trước khi nó in ra, để một sự không khớp có ý nghĩa.
7. Tóm tắt