26 · Quét độ dài prompt và đầu ra
Nguồn: fanout.sh / inference-eng / 05-04 · ~9 phút
Ghi chú
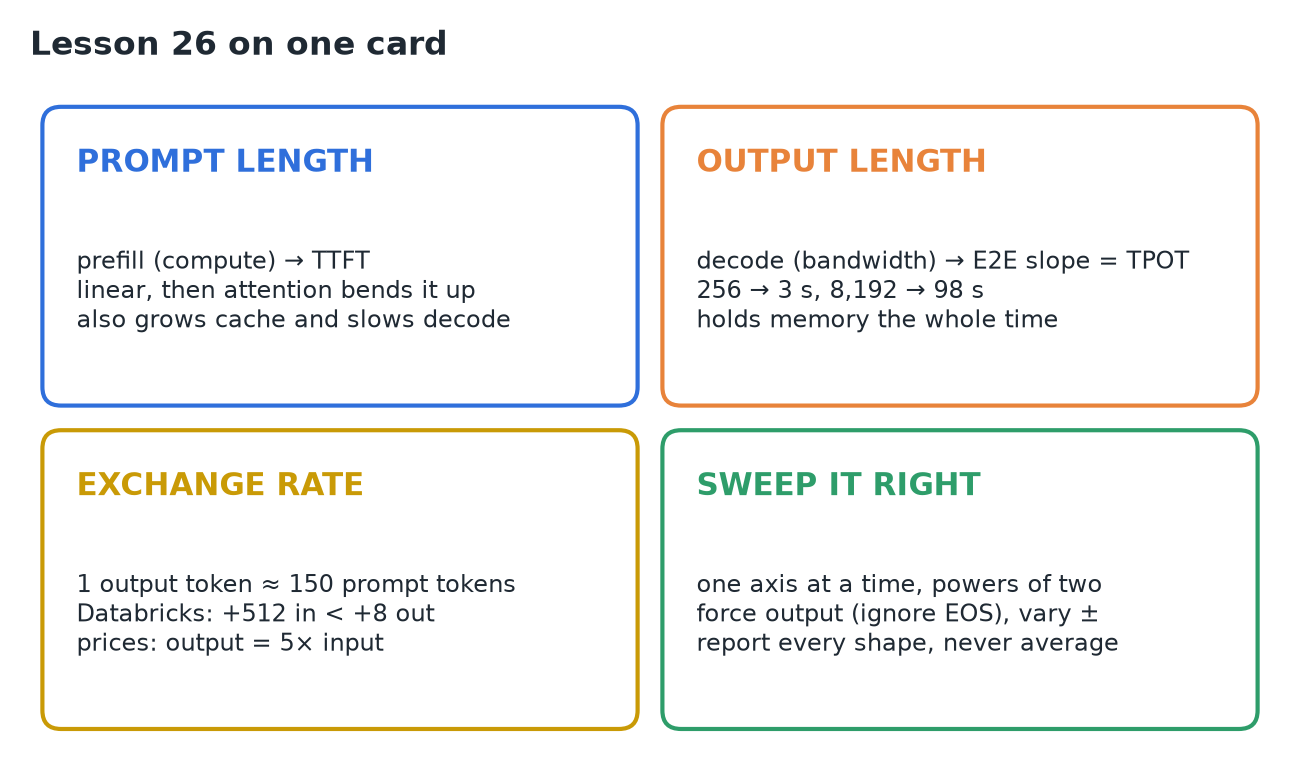
Shape của một request (độ dài prompt, độ dài đầu ra) quyết định mọi con số, nên hai team có thể đo được token/s rất khác nhau từ cùng một model và GPU. Độ dài prompt chi phối prefill compute-bound (TTFT), làm KV cache lớn lên, và làm chậm decode của mọi người chung batch. Độ dài đầu ra chi phối vòng decode bị giới hạn bởi băng thông và thời gian giữ bộ nhớ. Một token đầu ra tốn thời gian ngang ~150 token prompt; bảng giá thì tính gấp 5 lần. Cùng một H100 chứa được 225 người dùng chat nhưng chỉ 50 người dùng tóm tắt. Quét từng trục một, ép độ dài đầu ra, và báo cáo riêng từng shape: một server có cả một bản đồ token/s, không phải một con số.
1. Hai độ dài, hai cỗ máy
Prompt đi qua prefill: mọi token của nó trong một lượt song song, bị giới hạn bởi tính toán, quyết định time to first token. Đầu ra đến từ decode: mỗi bước một token, mỗi bước đọc toàn bộ model, bị giới hạn bởi băng thông bộ nhớ, quyết định phần còn lại của câu trả lời mất bao lâu.
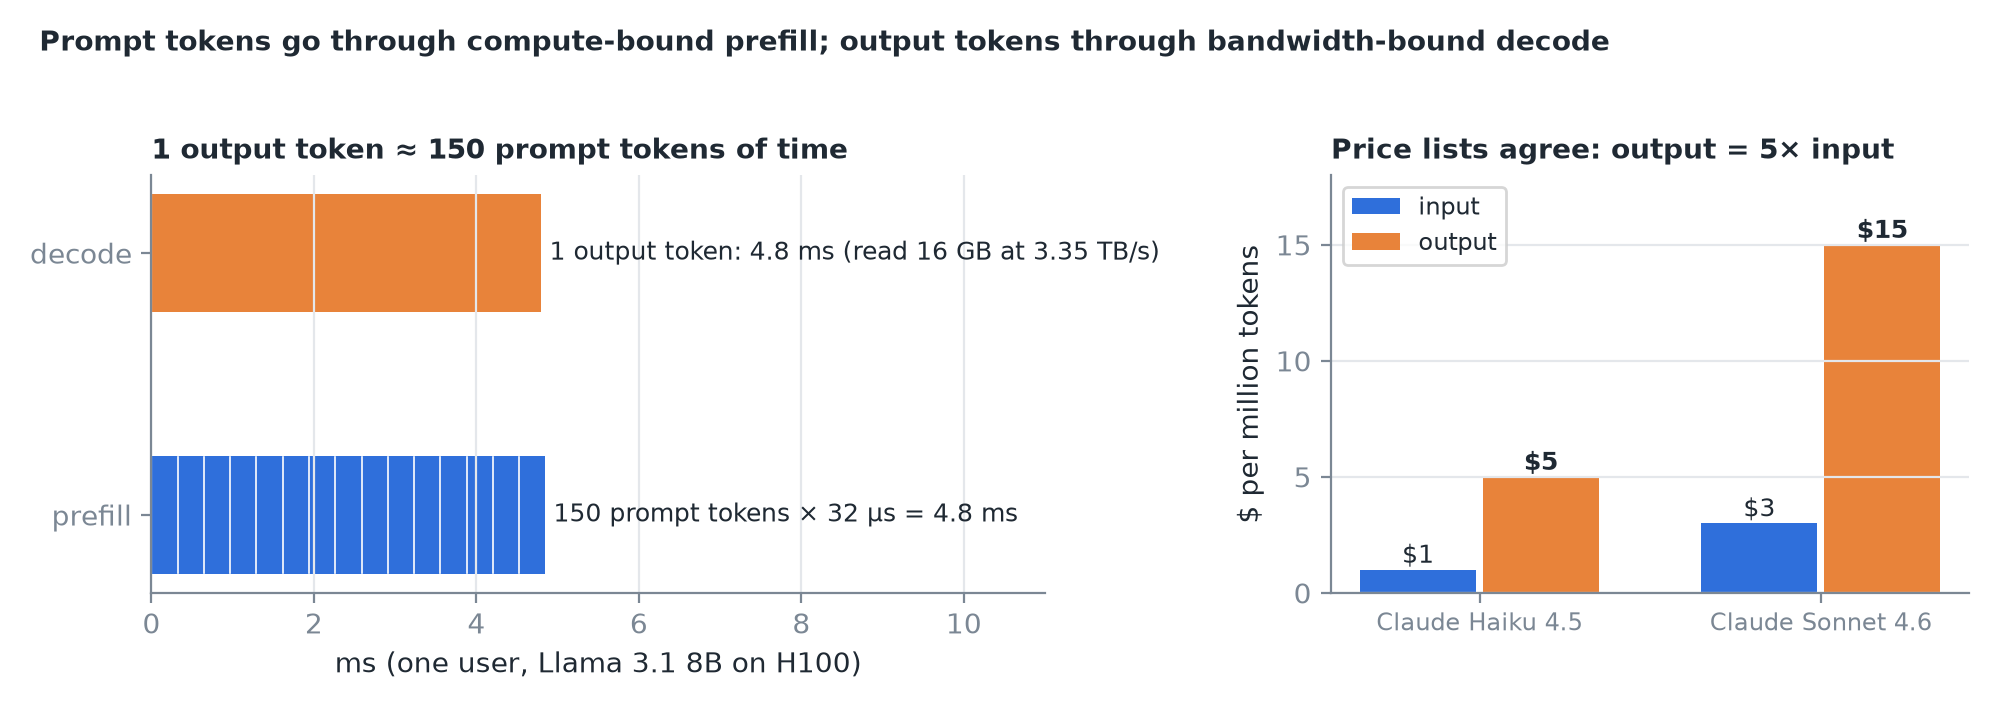 Một token prompt: 2 × 8 tỷ = 16 GFLOP ở một nửa của ~990 TFLOPS ≈ 32 µs (prompt 1.000 token ≈ 32 ms). Một token đầu ra với một người dùng: 16 GB ÷ 3,35 TB/s ≈ 4,8 ms. Databricks đo được điều tương tự: thêm 512 token prompt làm latency tăng ít hơn thêm 8 token đầu ra. Anthropic tính giá mỗi token đầu ra gấp 5 lần trên mọi model Claude hiện tại.
2. Quét prompt (đầu ra cố định 256)
Độ dài prompt 128, 512, 2k, 8k, 32k:
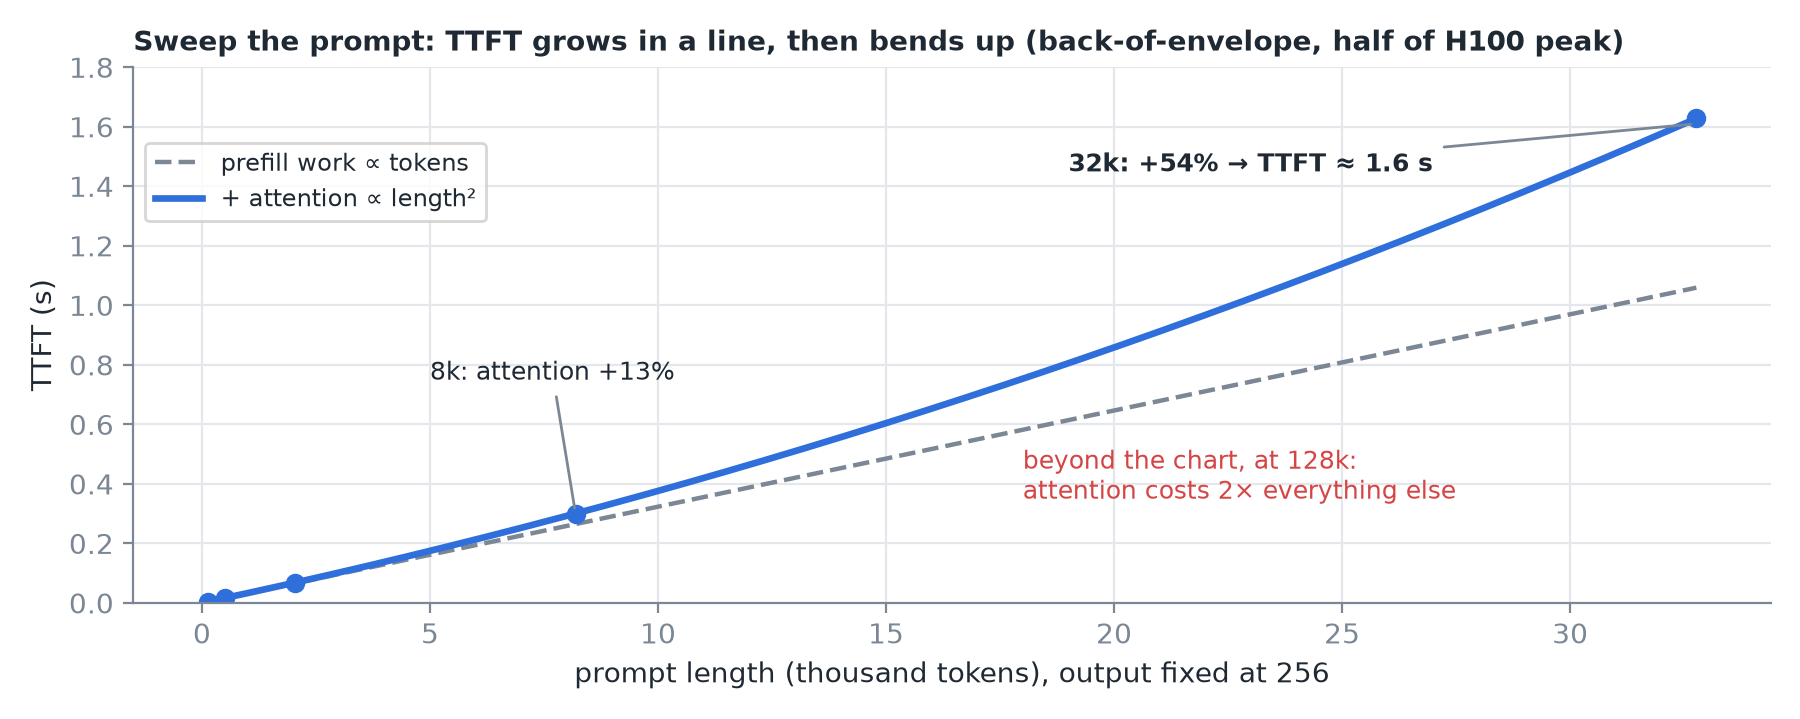 Ban đầu TTFT tăng theo đường thẳng (khối lượng prefill ∝ số token), rồi cong lên: attention so mỗi token với mọi token trước nó, tăng theo độ dài². Attention thêm ~13% ở 8k, ~54% ở 32k, và ở 128k tốn gấp đôi mọi thứ khác cộng lại.
Prompt cũng thay đổi decode. Mỗi bước decode đọc cache của mọi token trước đó:
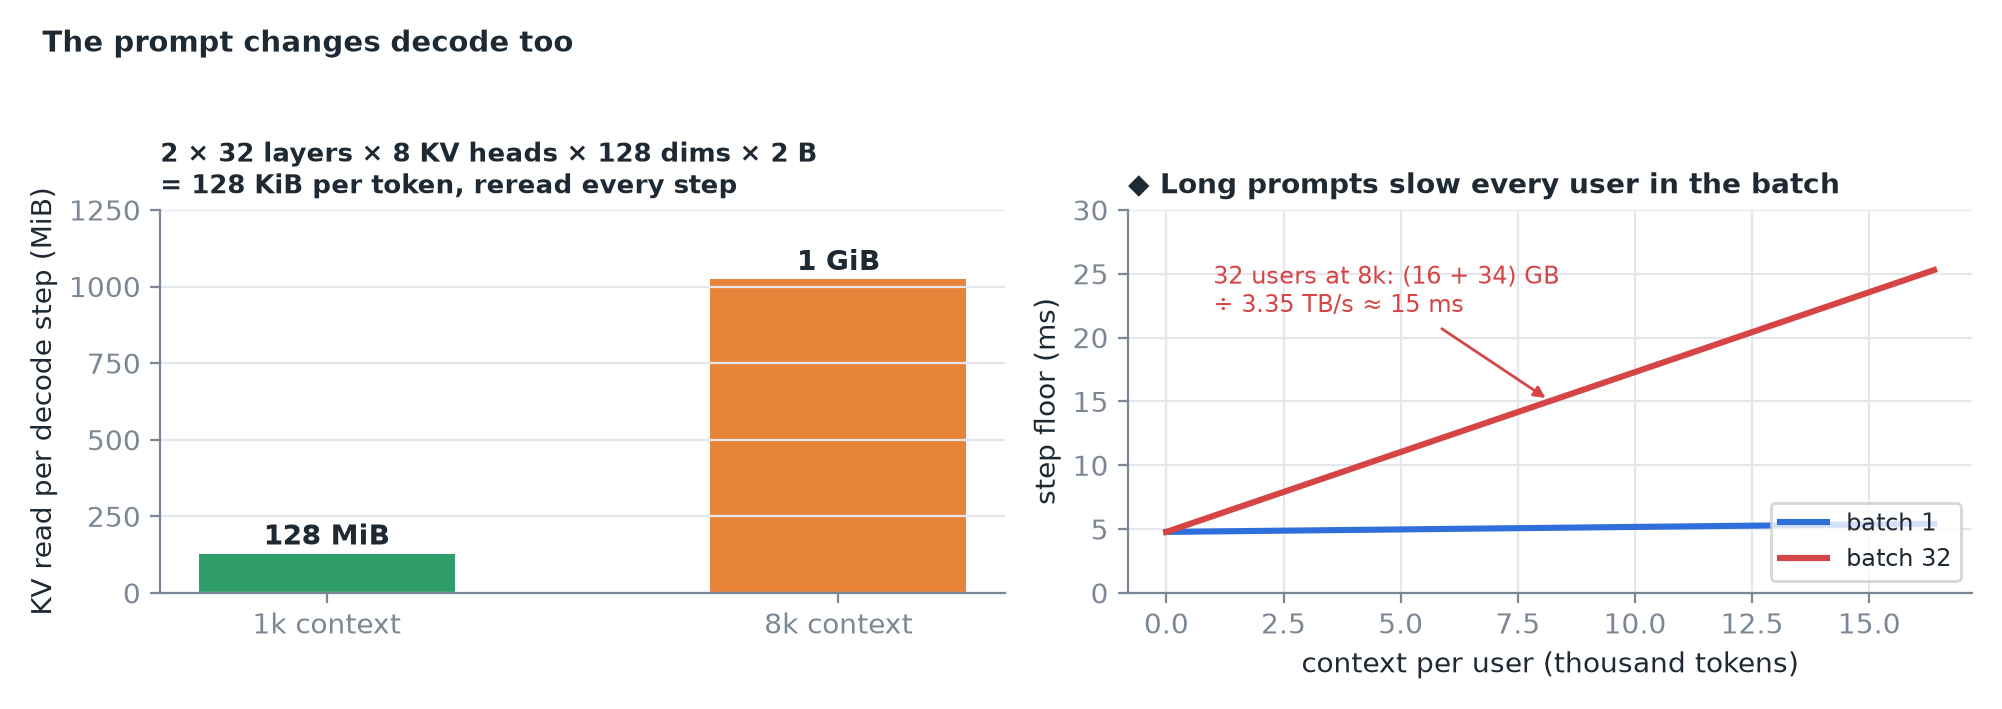 128 KiB mỗi token với model này: context 1k là 128 MiB, context 8k là trọn 1 GiB, đọc lại ở mọi bước. Prompt dài cũng làm chậm TPOT, cho mọi người chung batch.
3. Quét đầu ra (prompt cố định 1.000)
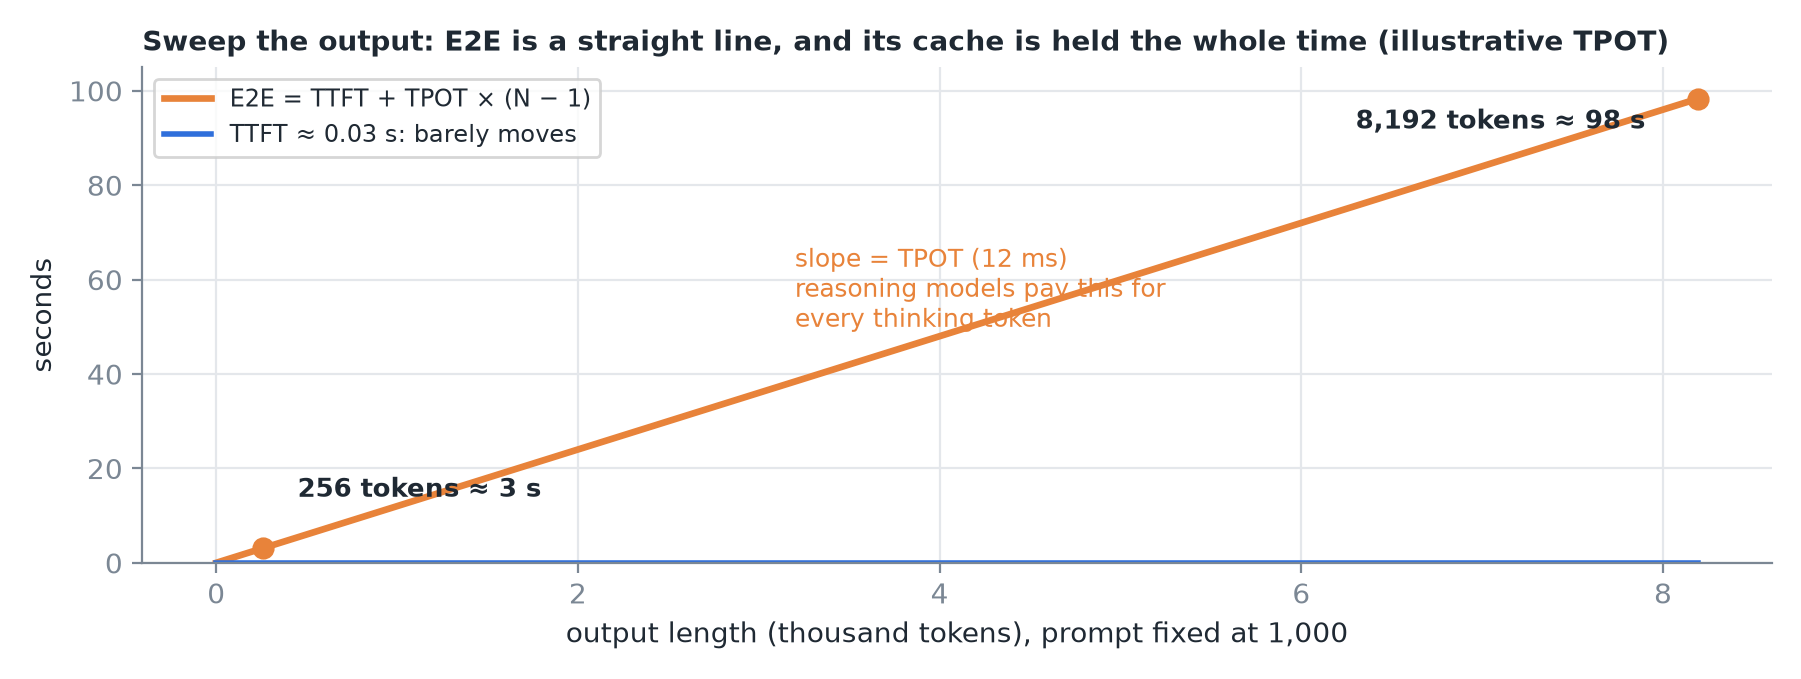 TTFT gần như không nhúc nhích; prefill không đổi. E2E = TTFT + TPOT × (N − 1) là đường thẳng với độ dốc TPOT: ở 12 ms mỗi token, 256 token ≈ 3 s và 8.192 ≈ 98 s.
- Đó là nơi các model suy luận (reasoning) sống: token suy nghĩ của chúng là token đầu ra, và mỗi token đều trả giá decode.
- Đầu ra dài giữ bộ nhớ lâu hơn: một request decode trong 90 s giữ cache của nó suốt 90 s, nên số request hoàn thành mỗi giây giảm kể cả khi token đầu ra/s trông vẫn ổn.
4. Shape quyết định chứa được bao nhiêu
Sau trọng số và overhead, H100 còn khoảng 450.000 token cache.
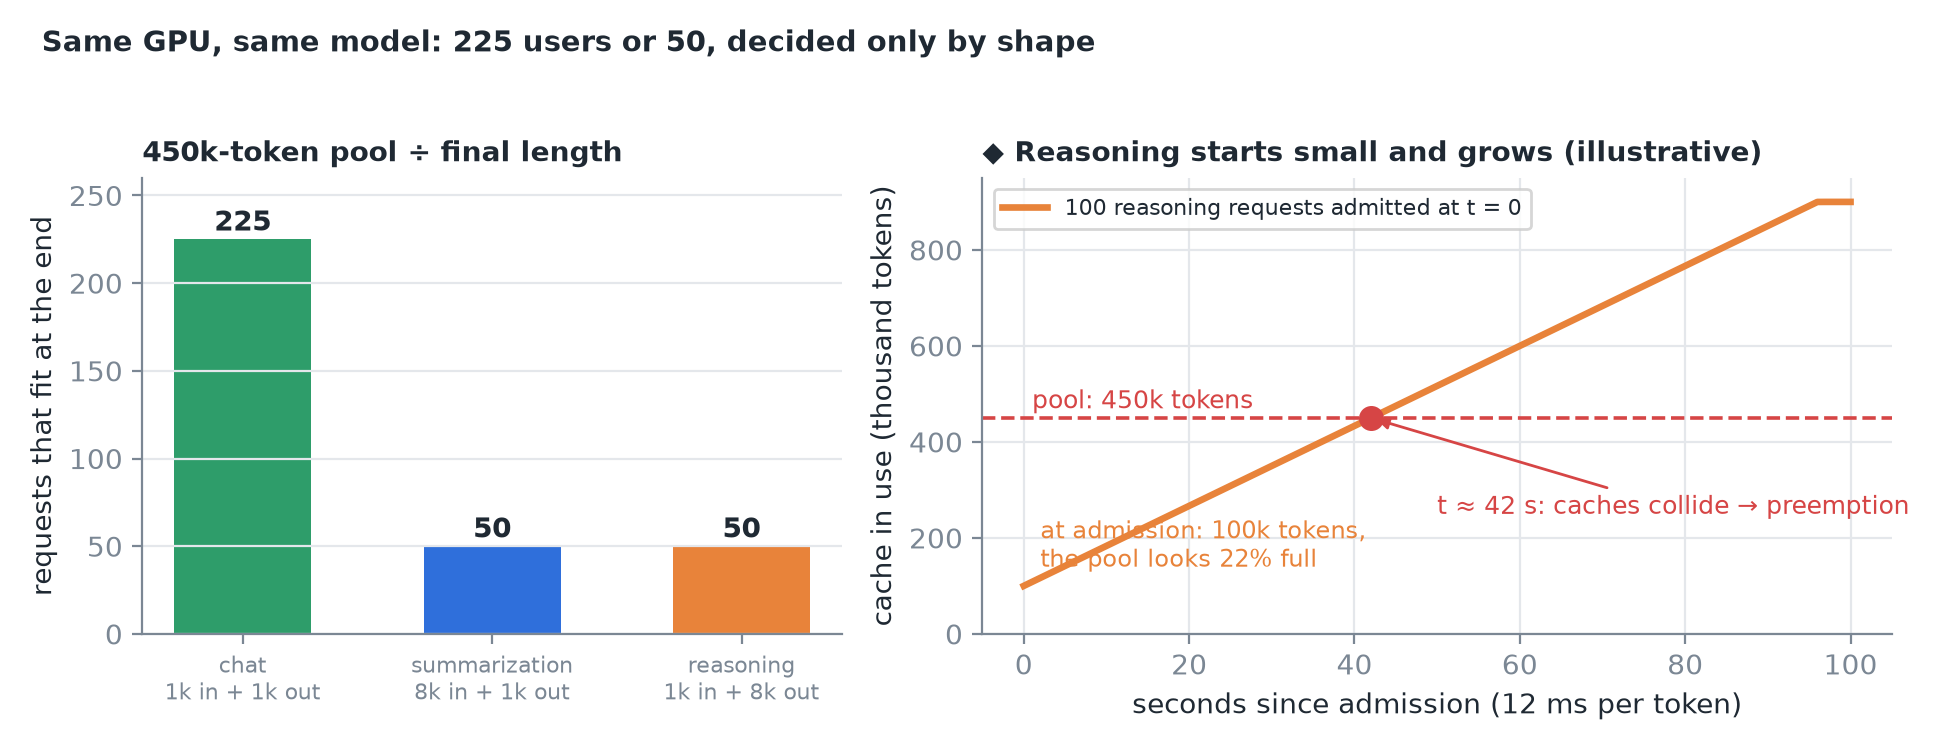 Chat (1k vào, 1k ra) kết thúc ở 2.000 token: chứa ~225. Tóm tắt (8k vào, 1k ra) kết thúc ở 9.000: chứa ~50. Suy luận (1k vào, 8k ra) cũng kết thúc ở 9.000 nhưng bắt đầu nhỏ, nên scheduler vui vẻ nhận rất nhiều, rồi về sau cache của chúng lớn lên chèn vào nhau: preemption.
5. Chạy lần quét
vllm bench serve \
  --dataset-name random \
  --random-input-len 8192 \
  --random-output-len 1024 \
  --random-range-ratio 0.1 \
  --ignore-eos \
--max-concurrency 32--random-range-ratiolàm mỗi request dao động một chút thay vì tất cả giống hệt nhau. Benchmark công khai của SemiAnalysis lấy mỗi prompt trong khoảng 80% tới 100% độ dài mục tiêu.--ignore-eoslà cờ hay bị quên: thiếu nó, model dừng khi nó tự thấy xong, và "8.000 token đầu ra" lặng lẽ thành ~300.- Thay đổi từng trục một, theo luỹ thừa của hai, và lặp mỗi shape ở vài mức concurrency.
- Ghi lại cho mỗi điểm: TTFT và TPOT (trung vị và phần đuôi), token vào và ra mỗi giây, mức dùng cache, số lần preemption.
- Đừng lấy trung bình các shape khác nhau thành một con số: các request dài trốn trong giá trị trung bình.
6. Bản đồ shape
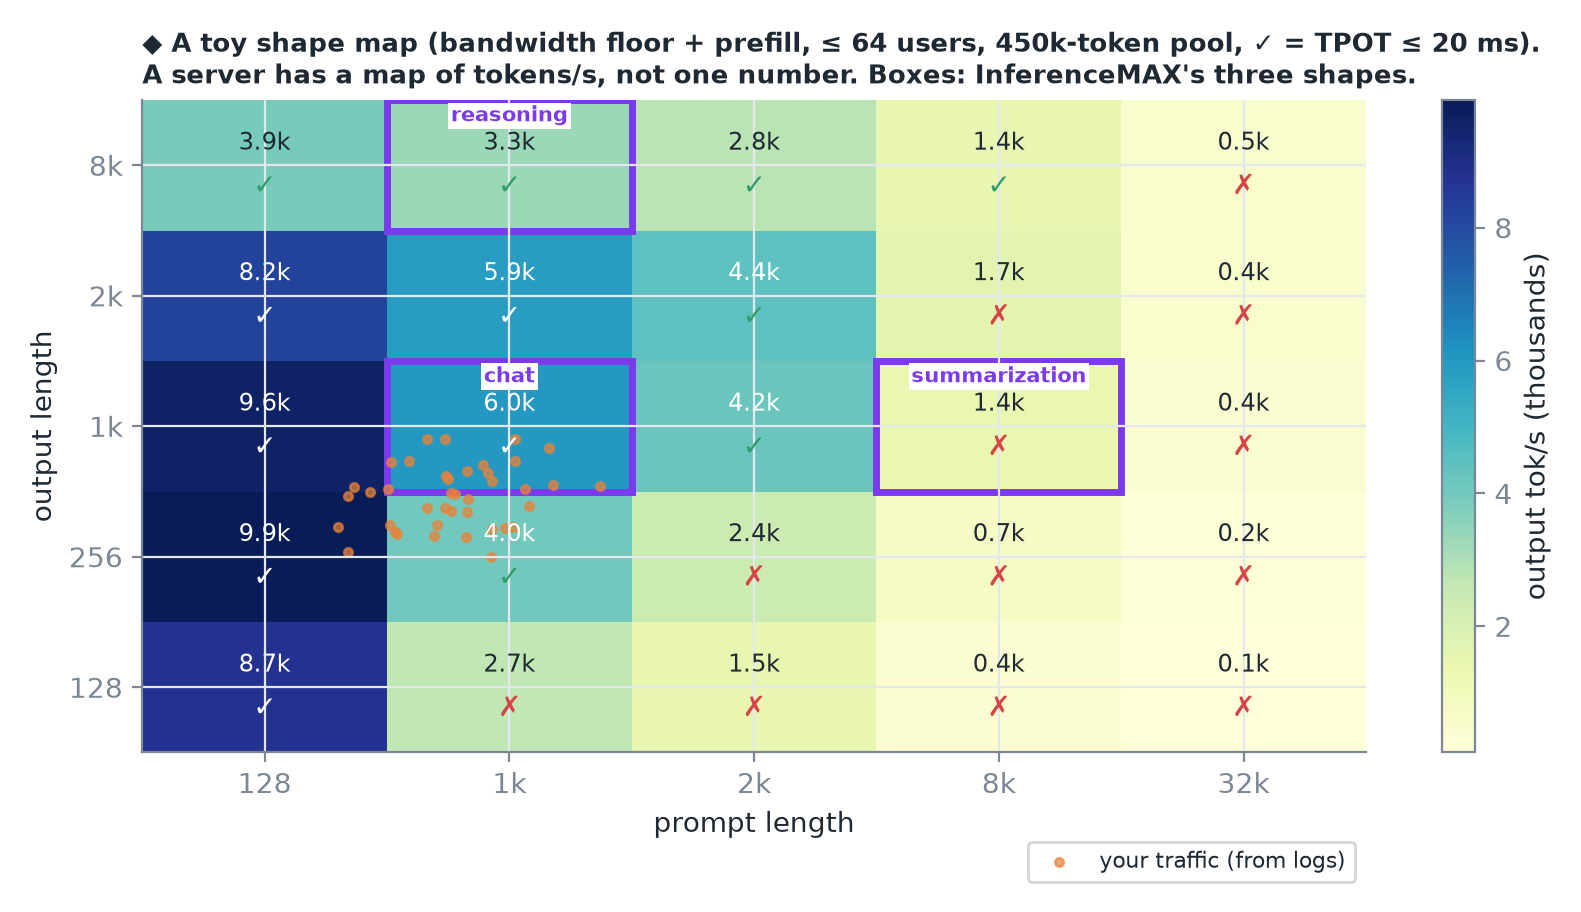 Prompt trên một trục, đầu ra trên trục kia; mỗi ô chứa những gì server làm được ở shape đó và có đạt mục tiêu latency hay không. Benchmark công khai (InferenceMAX) chọn ba ô: chat 1k/1k, suy luận 1k/8k, tóm tắt 8k/1k. Sau đó lấy độ dài thật từ log của bạn và tinh chỉnh cho đúng chỗ lưu lượng của bạn nằm: một cấu hình thắng ở chat có thể thua ở tóm tắt.
Thận trọng
Ba niềm tin nên bỏ. "Token prompt là miễn phí": rẻ hơn, nhưng chúng tốn TTFT, tính toán và cache. "Một server có một con số token/s": nó có cả một bản đồ. "max_tokens là độ dài đầu ra": nó chỉ là trần, trừ khi bạn ép model viết tiếp.
7. Tóm tắt