16 · Hiểu và đo pha decode
Nguồn: fanout.sh / inference-eng / 03-03 · ~6 phút
Ghi chú
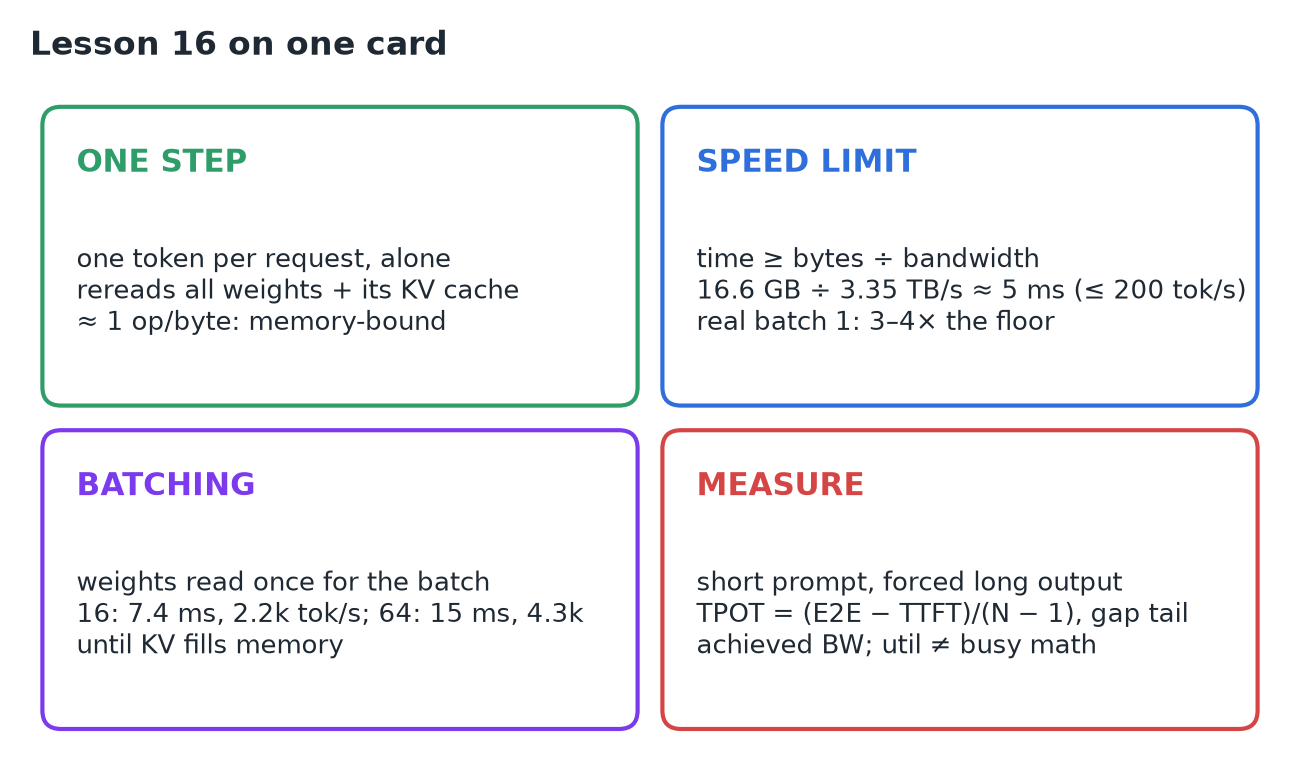
Prefill xử lý 2.000 token trong ~60 ms; sau đó decode tốn vài ms cho từng token một, nên tính theo token nó có thể đắt hơn ~100 lần. Mỗi bước decode đẩy token mới nhất qua cả 32 layer một mình (vector × ma trận) và phải đọc toàn bộ trọng số cộng toàn bộ KV cache của request này, làm ~1 phép tính mỗi byte: memory-bound. Vì vậy thời gian mỗi token ≥ số byte ÷ băng thông: ~16,6 GB ÷ 3,35 TB/s ≈ 5 ms (≤ ~200 token/s mỗi request), và hệ thống batch 1 thật rơi vào cao hơn mức sàn đó 3–4 lần. Batching chia sẻ lần đọc trọng số: batch 64 tốn 15 ms mỗi bước nhưng đạt >4.000 token/s, cho tới khi KV cache lấp đầy bộ nhớ. Đo bằng prompt ngắn, ép đầu ra dài, TPOT, phần đuôi của khoảng cách giữa các token, và quét theo concurrency.
1. Một bước decode
Token mới nhất đi qua cả 32 layer một mình. Ở mỗi layer nó gặp mọi ma trận trọng số, nhưng dưới dạng một vector nhân một ma trận, không phải một khối token. Trong attention, query của nó đọc key và value của mọi token trước từ cache. Một token được sinh ra, K và V của nó vào cache, và bước tiếp theo bắt đầu.
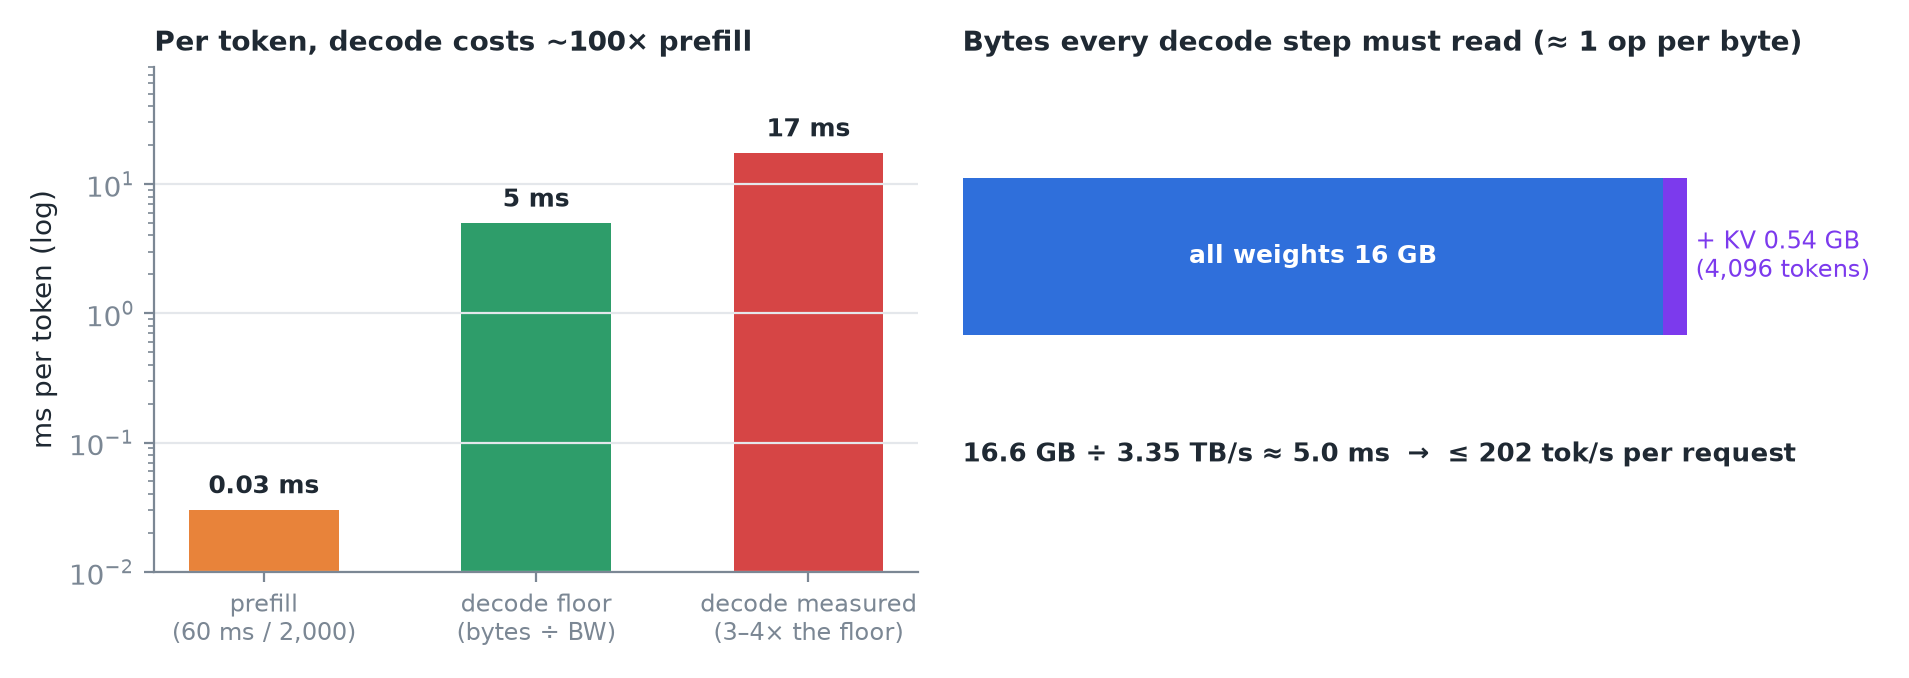 Mỗi bước đọc hai thứ: toàn bộ trọng số và toàn bộ KV cache của request này, với ~1 phép tính mỗi byte so với điểm gãy ~300 của H100.
Quan trọng
Decode bị giới hạn bởi bộ nhớ: GPU dành thời gian chờ byte, nên giới hạn tốc độ của nó là số byte đọc ÷ băng thông bộ nhớ.
2. Giới hạn tốc độ
- Trọng số Llama 3 8B ≈ 16 GB; một cuộc hội thoại 4.096 token thêm ≈ 0,5 GB KV cache.
- 16,6 GB ÷ 3,35 TB/s ≈ 5 ms mỗi token: một request không thể vượt quá ~200 token/s trên GPU này.
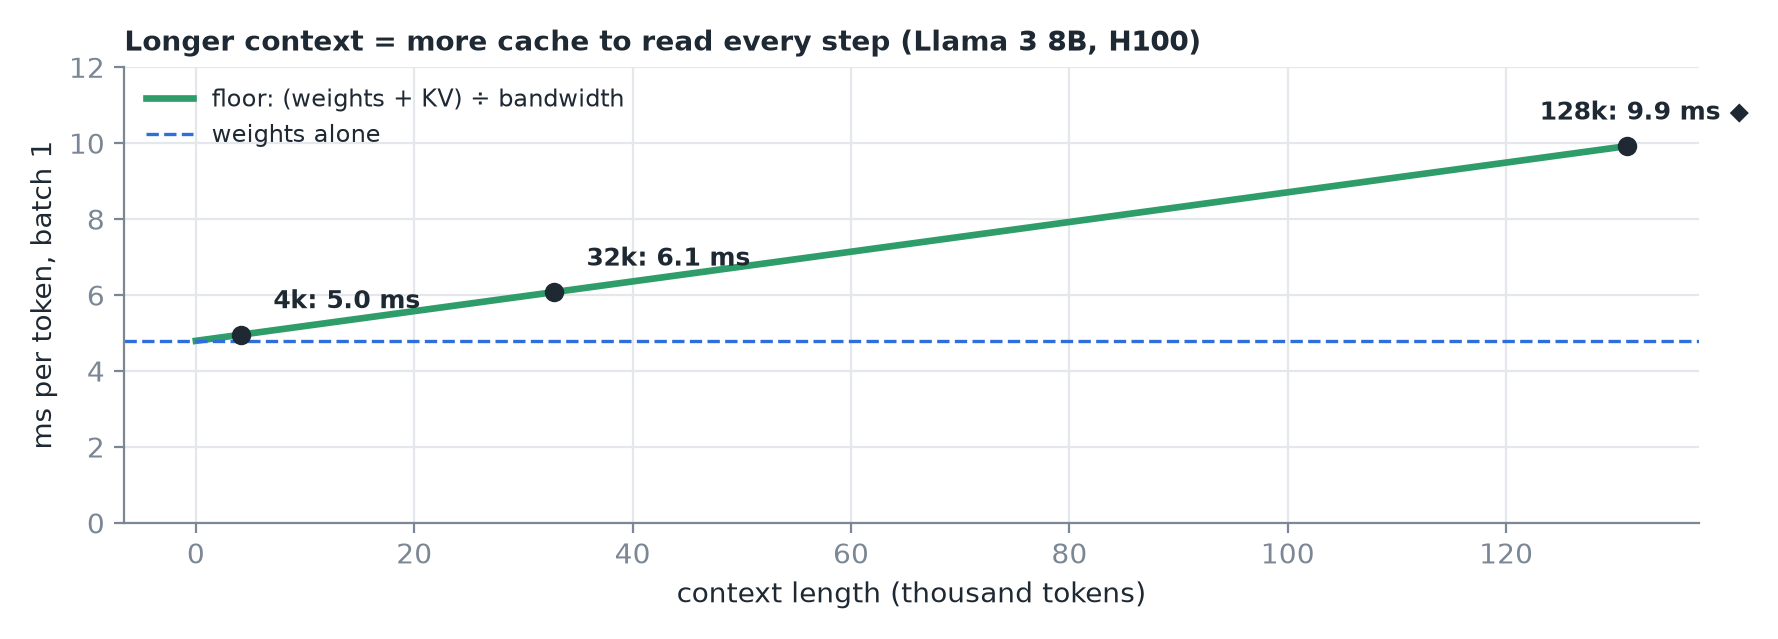
- Context dài hơn nghĩa là phải đọc nhiều cache hơn: ở 32k token mức sàn tăng lên ~6 ms.
Cảnh báo
Hệ thống thật nằm trên mức sàn. Một nghiên cứu gần đây đo decode batch 1 của các model 7–8B trên H100 chỉ đạt một phần tư tới một phần ba mức lý tưởng này: kernel nhỏ và chi phí launch ăn mất thời gian. Mức sàn cho bạn biết trần nằm ở đâu, không phải bạn đang ở đâu.
3. Batching: cách server đạt hàng nghìn token/s
Nếu 16 request decode cùng nhau, trọng số được đọc một lần cho cả 16. Mỗi request vẫn đọc KV cache riêng, nhưng lần đọc lớn 16 GB được chia sẻ.
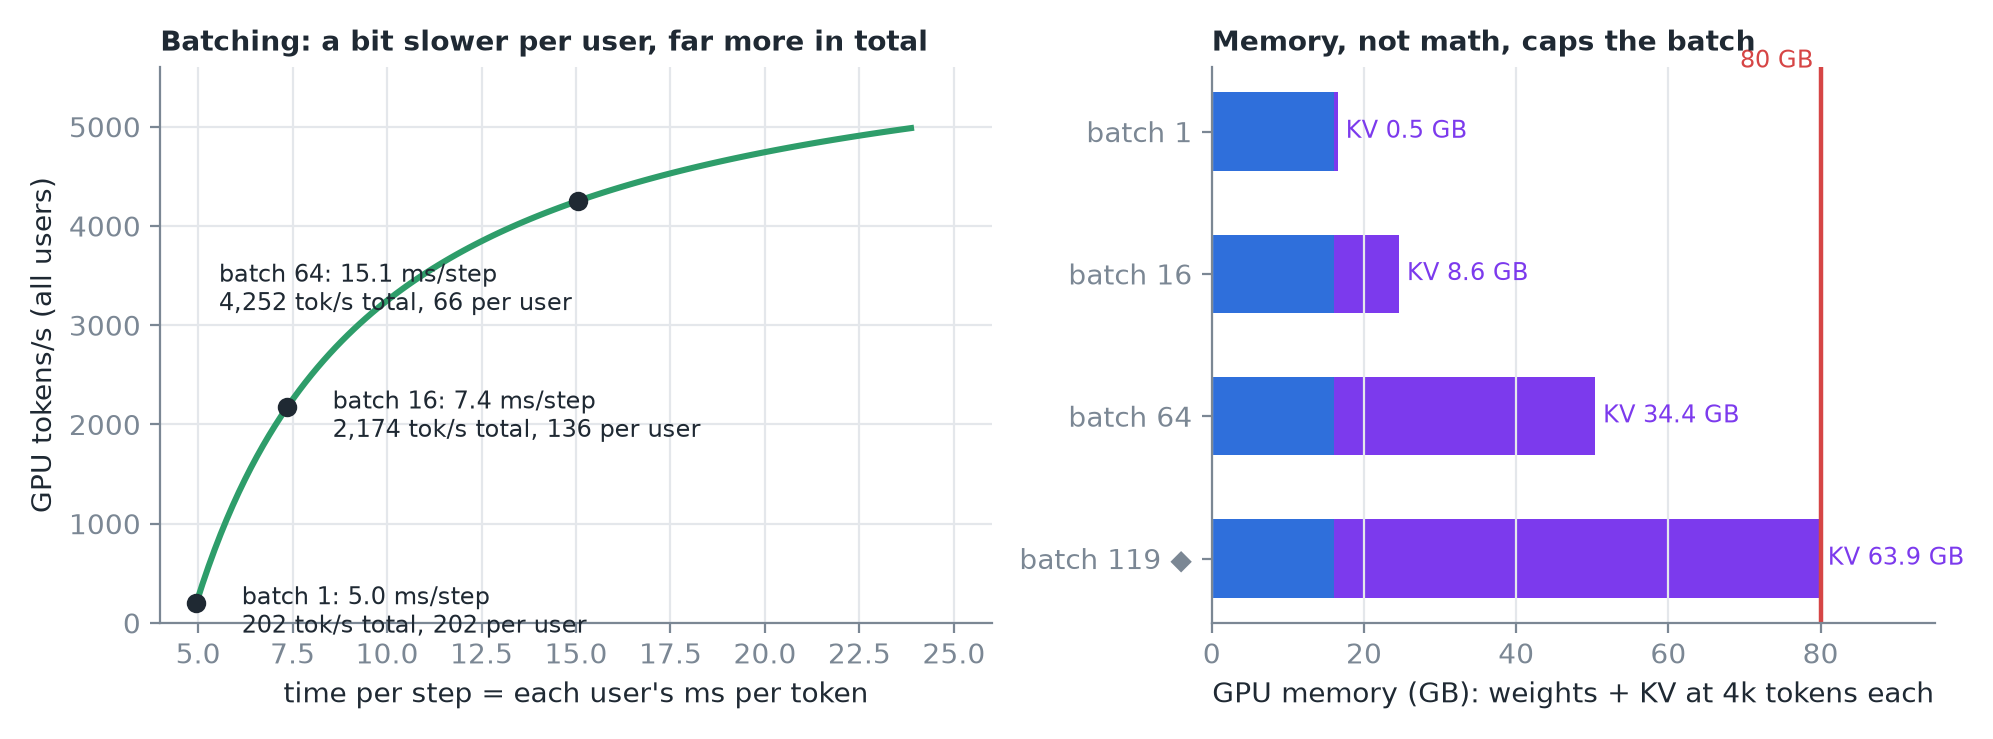 Trái: luồng của từng người dùng chậm đi một chút; GPU làm được nhiều hơn hẳn. Phải: mỗi request giữ KV cache trong bộ nhớ; 64 request × 4k token ≈ 34 GB, cộng thêm 16 GB trọng số. ◆ Ở 4k mỗi request, khoảng ~119 request vừa trong 80 GB (xem bài 02).
Mẹo
Đánh đổi trung tâm của decode là latency mỗi người dùng so với tổng throughput, và bộ nhớ, không phải phép tính, chặn trần kích thước batch.
4. Đo một cách trung thực
- Prompt ngắn, đầu ra dài (vài trăm token), để prefill gần như không ảnh hưởng.
- Ép độ dài (ví dụ bỏ qua token kết thúc văn bản) để mọi lần chạy sinh cùng số token.
- Ghi lại TTFT và thời gian end-to-end, rồi TPOT = (E2E − TTFT) ÷ (N_out − 1).
- Giữ lại từng khoảng cách giữa các token: phần đuôi của chúng lộ ra những lần khựng mà trung bình che mất.
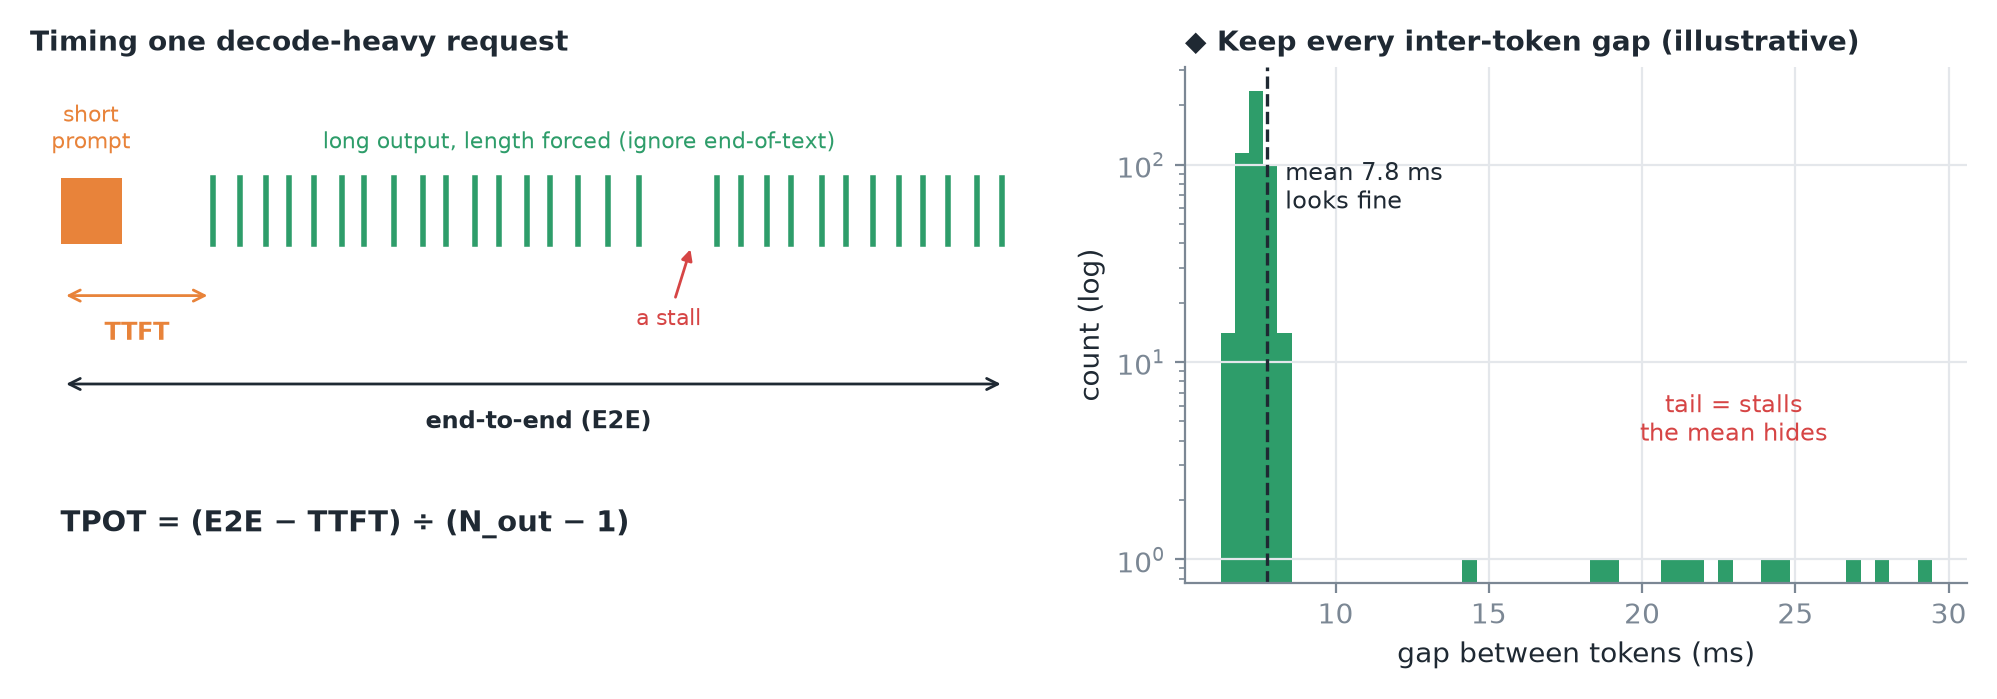
Sau đó quét concurrency (1, 2, 4, 8 … 64), vẽ throughput theo thời gian mỗi token, và quy đổi ra băng thông đạt được = số byte mỗi bước ÷ thời gian bước đo được, ví dụ 16,6 GB ÷ 12 ms ≈ 1,4 TB/s ≈ 41% đỉnh.
Thận trọng
GPU utilization có thể hiện ~100% trong lúc decode dù các đơn vị tính toán gần như rảnh. Nó chỉ có nghĩa là có kernel nào đó đang chạy (xem bài 09).
5. Mọi đòn bẩy về sau
Lượng tử hoá, nén cache và batching thông minh hơn đều chuyển ít byte hơn hoặc chia sẻ chúng tốt hơn.
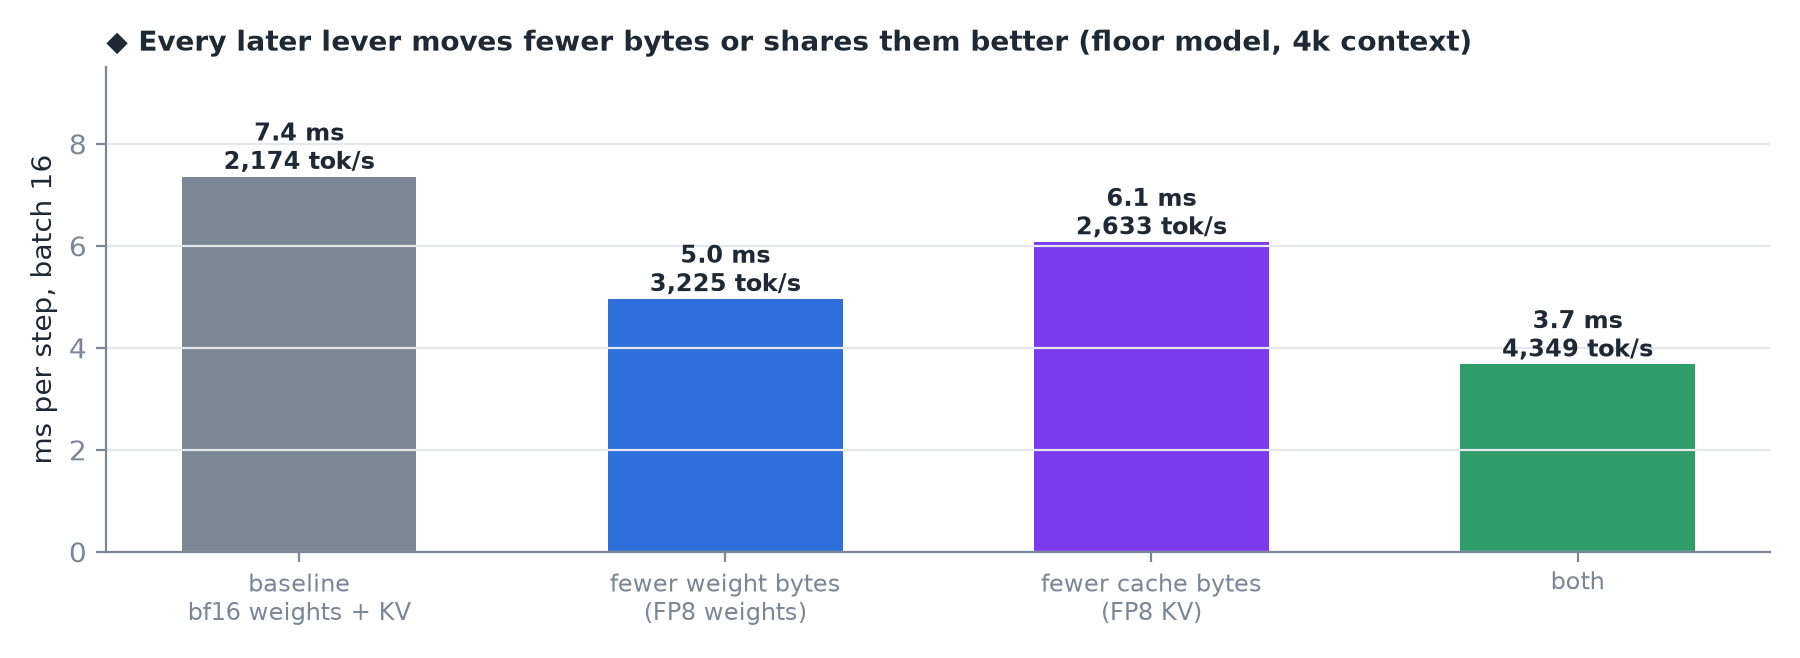 ◆ Tính theo mô hình mức sàn ở batch 16, context 4k: giảm một nửa byte trọng số giúp nhiều nhất ở đây; giảm một nửa byte cache quan trọng hơn khi batch hoặc context lớn lên.
6. Tóm tắt