38 · KV block, phân mảnh và block table
Nguồn: fanout.sh / inference-eng / 08-02 · ~5 phút
Ghi chú
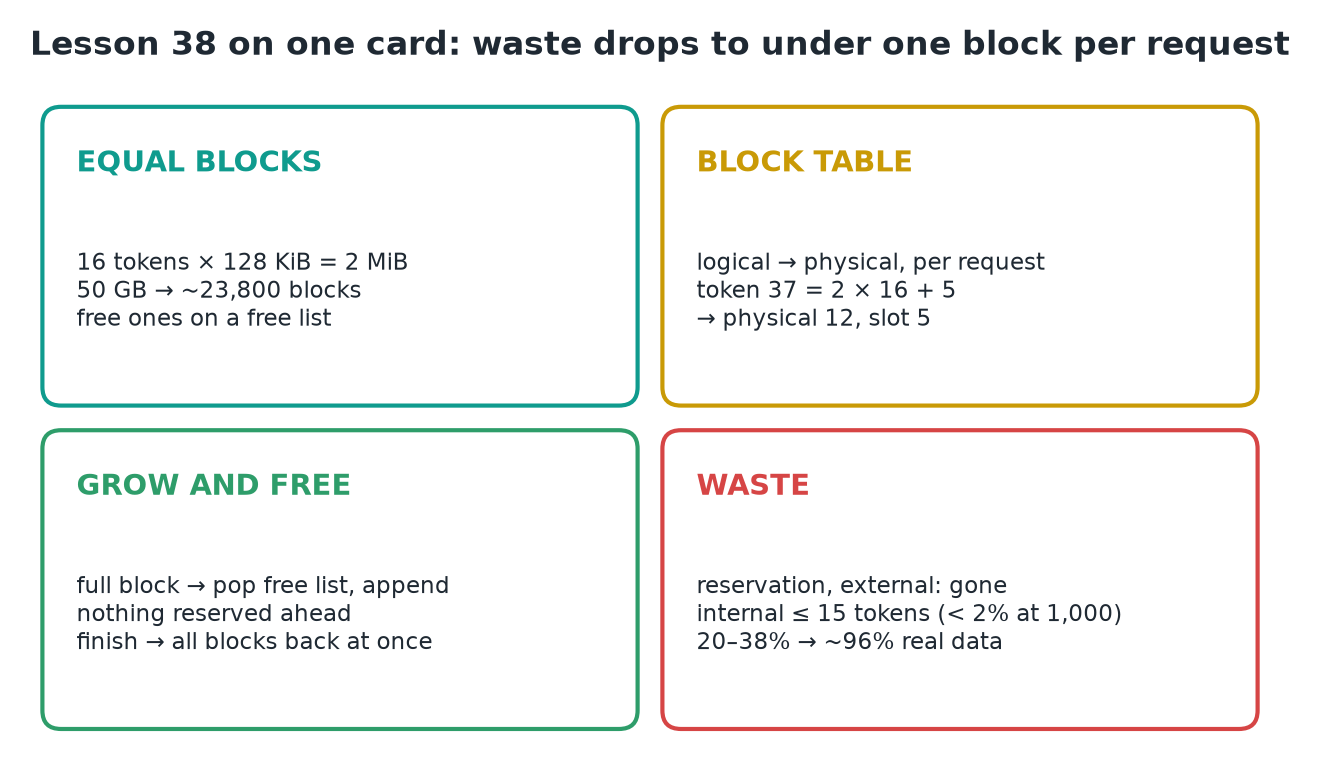
vLLM sửa slab liền mạch theo cách hệ điều hành đã sửa bộ nhớ từ hàng chục năm trước: phân trang (paging). Cắt pool KV thành các block bằng nhau 16 token (2 MiB mỗi block trên Llama 3.1 8B, nên 50 GB ≈ 23.800 block), cấp chúng ra từ một free list, và cho mỗi request một block table ánh xạ các block logic của nó sang block vật lý ở bất kỳ đâu trong pool. Tìm một token chỉ là một phép chia: 37 = 2 × 16 + 5 → block logic 2, slot 5. Block được cấp khi request lớn lên và trả lại ngay khi nó xong. Lãng phí do đặt trước và phân mảnh ngoài biến mất; lãng phí trong tối đa 15 token mỗi request, và paper vLLM đo được ~96% bộ nhớ KV chứa dữ liệu thật, tăng từ 20–38%.
1. Phân trang, áp dụng cho KV cache
Cho mỗi chương trình ảo giác về một không gian địa chỉ gọn gàng, liền mạch, nhưng lưu nó trong các trang nhỏ kích thước cố định rải rác ở bất kỳ đâu trong bộ nhớ vật lý.
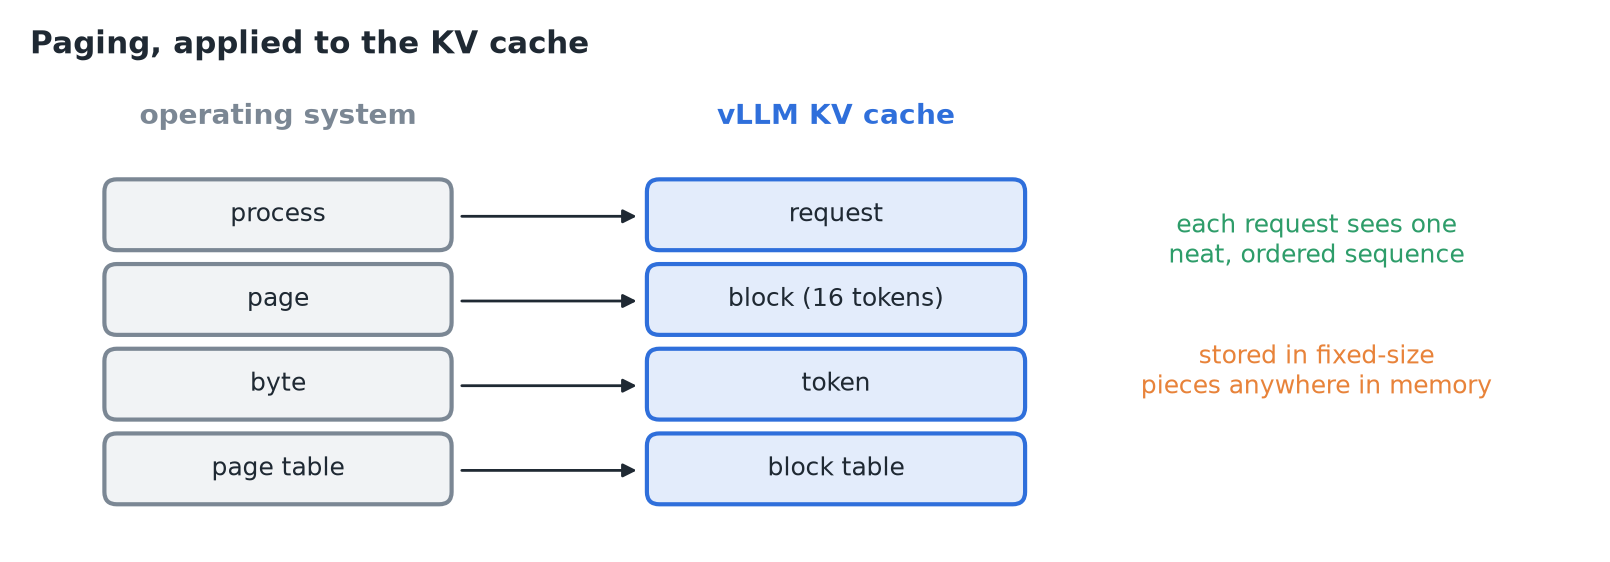 Request giống process, block giống page, token giống byte.
2. Block bằng nhau và một free list
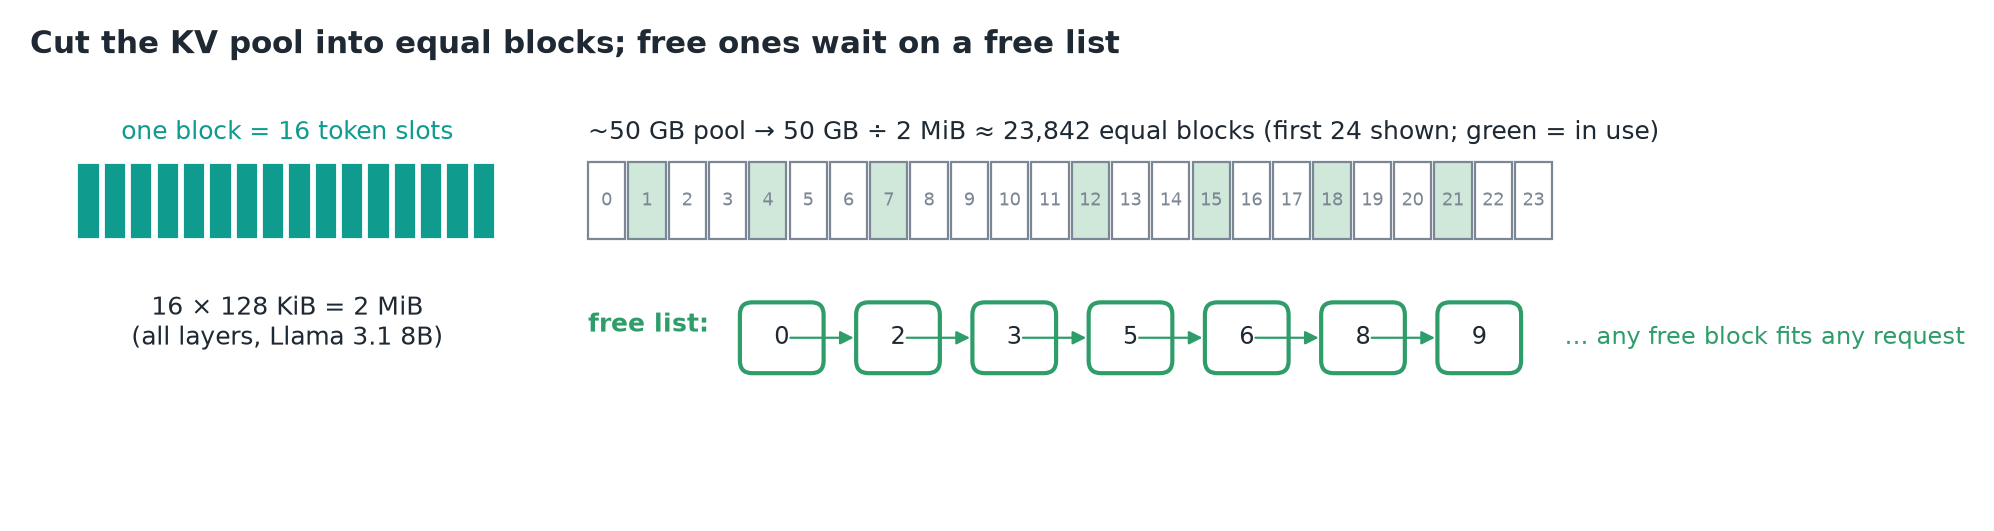 Block mặc định của vLLM chứa key và value của 16 token trên mọi layer. Mọi block cùng kích thước, và mọi block trống nằm trên free list, sẵn sàng để cấp ra.
3. Block table
Một request 60 token thấy chúng theo thứ tự trong block logic 0–3 (mỗi block 16, block cuối chỉ đầy 12). Về vật lý chúng nằm ở block 7, 1, 12 và 4; danh sách nhỏ đó là block table của request.
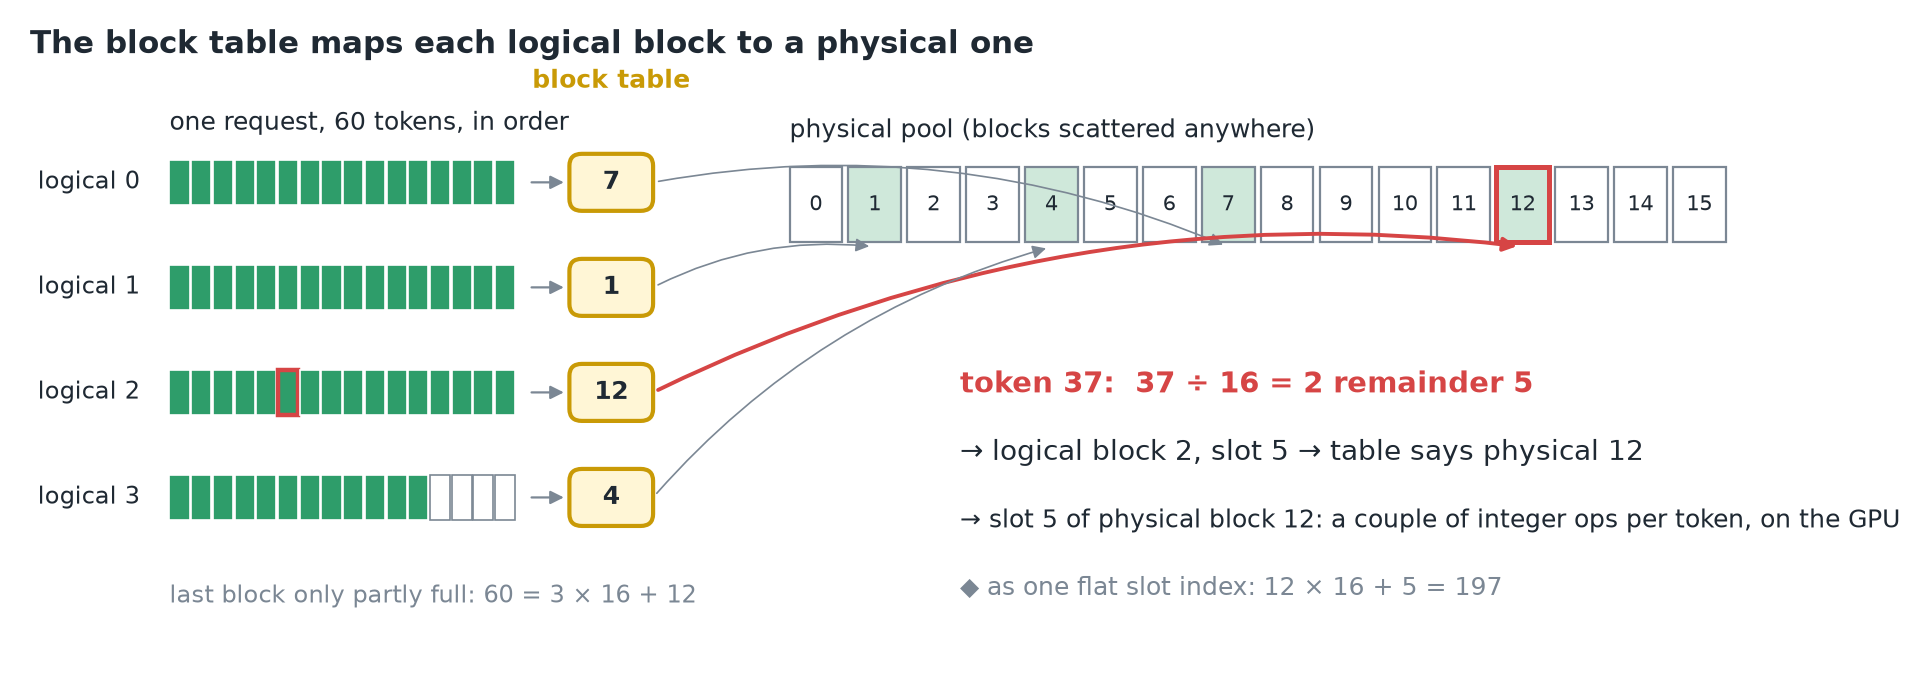 Để tìm bất kỳ token nào, chia vị trí của nó cho 16: thương chọn block logic, bảng cho ra block vật lý, số dư là slot. Vài phép toán số nguyên, làm cho mọi token trên GPU.
4. Lớn lên và giải phóng
- Mỗi token mới vào slot kế tiếp của block cuối. Khi block đó đầy, manager lấy một block khỏi free list và nối số hiệu của nó vào block table.
- Không có gì được đặt trước: một request chỉ giữ các block đã đầy cộng một block đầy một phần.
- Khi nó xong, mọi block của nó trở thẳng về free list; request kế tiếp dùng được chúng dù chúng nằm rải rác.
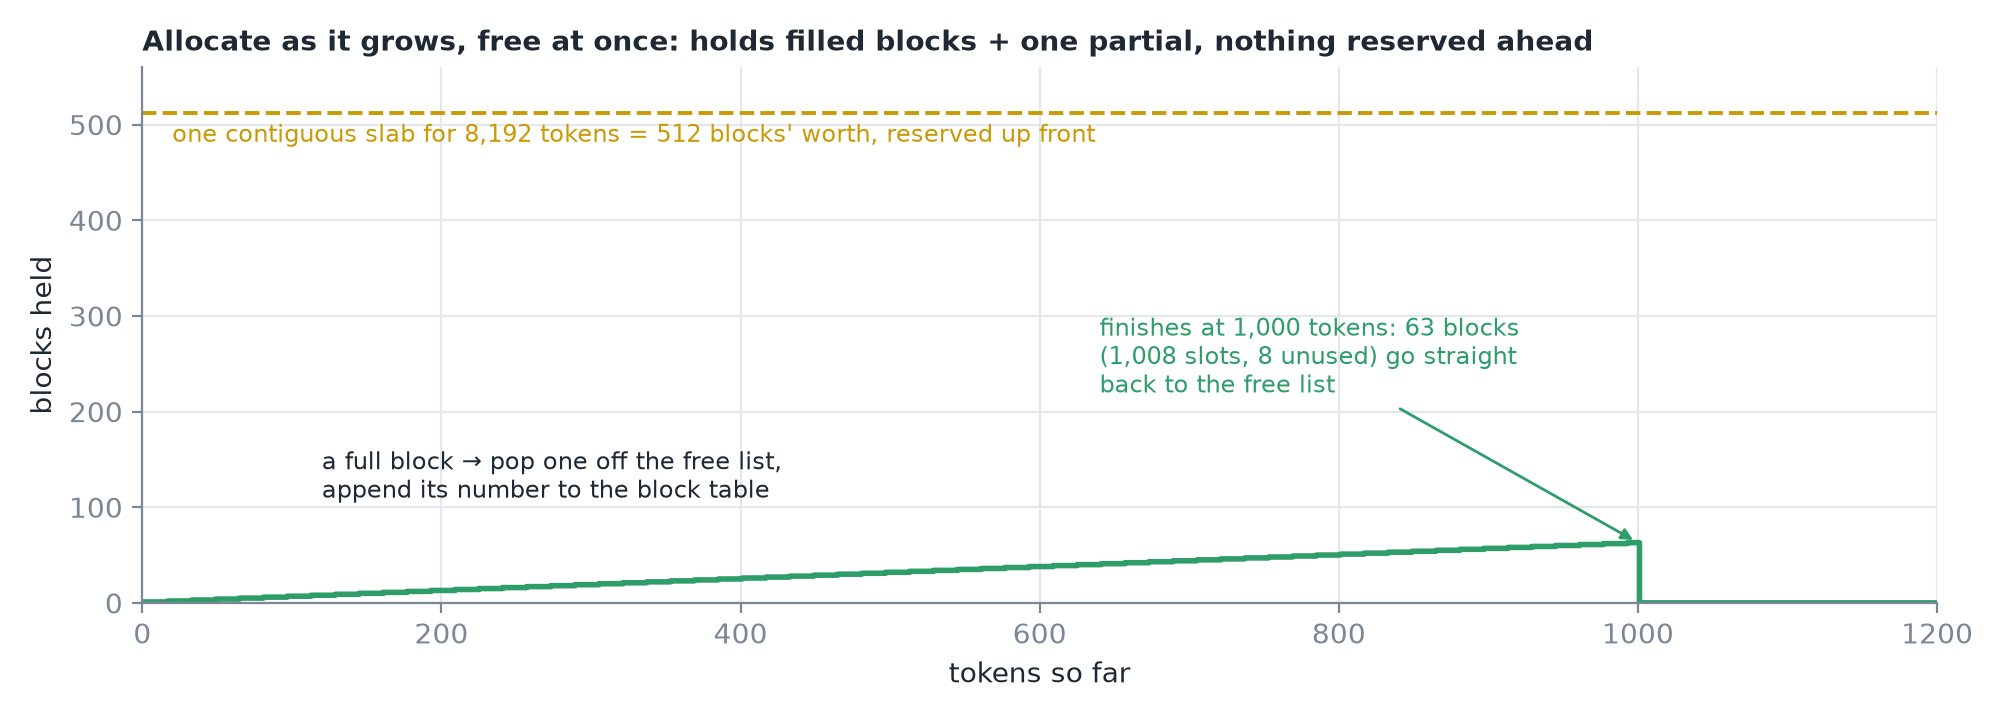 ◆ Một request lớn tới 1.000 token giữ tối đa 63 block (1.008 slot, 8 slot không dùng), so với 512 block tương đương một slab 8.192 token đặt trước từ đầu.
5. Ba kiểu lãng phí, nhìn lại
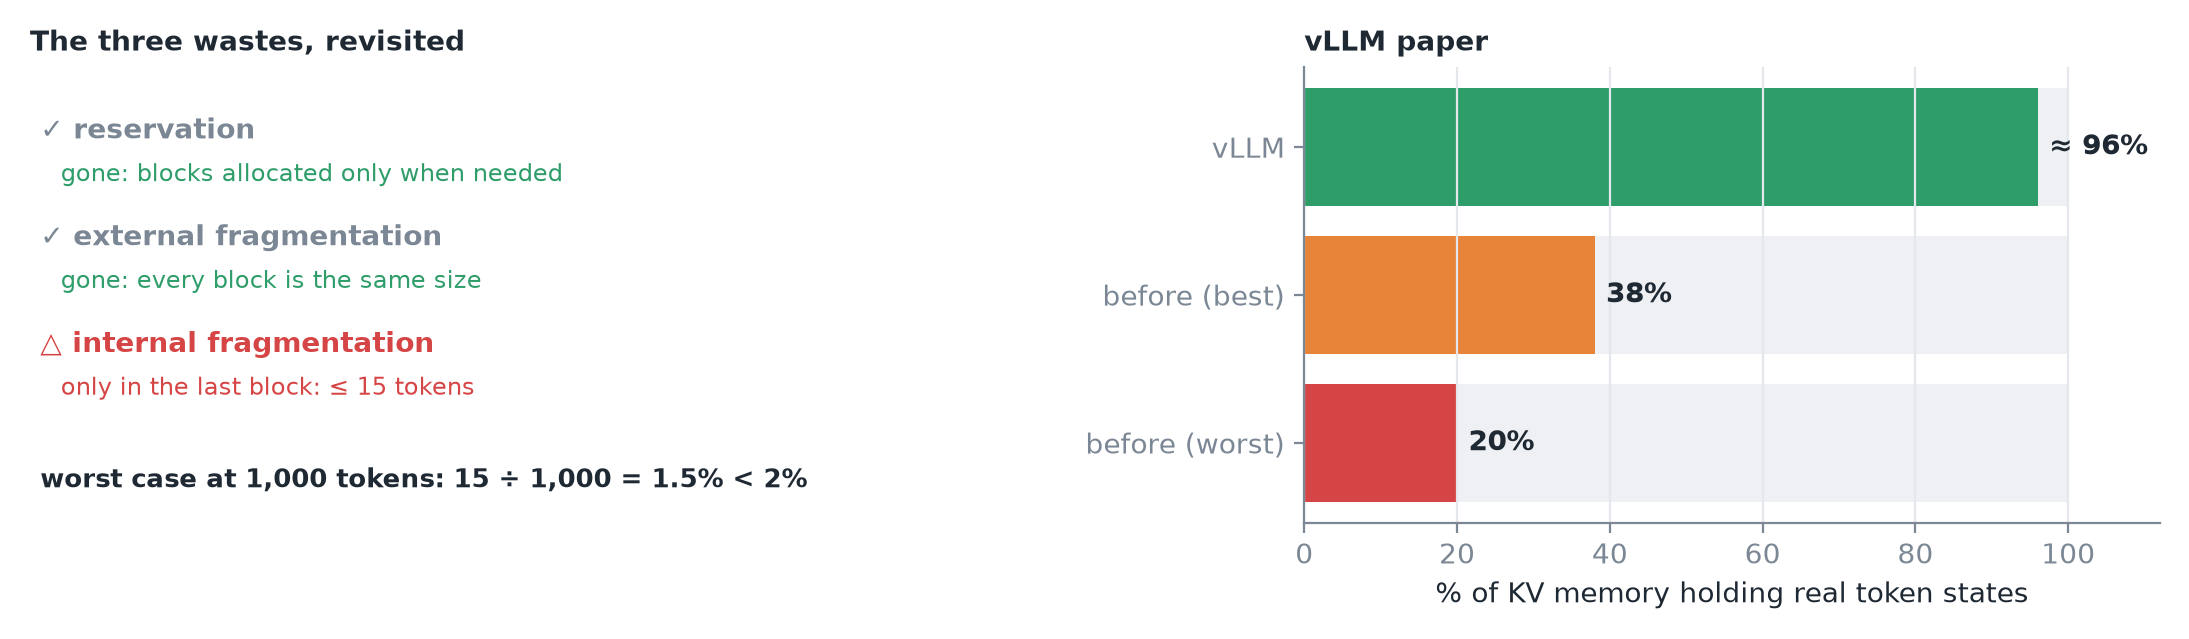 Đặt trước biến mất (block chỉ được cấp khi cần); phân mảnh ngoài biến mất (block trống nào cũng vừa với request nào); phân mảnh trong co lại chỉ còn các slot chưa dùng của block cuối.
Quan trọng
Paper vLLM đo được ~96% bộ nhớ KV chứa trạng thái token thật, tăng từ 20–38% với slab liền mạch.
6. Kích thước block là một đánh đổi
| Block nhỏ | Block lớn | |
|---|---|---|
| Lãng phí ở đuôi | Ít hơn | Nhiều hơn ở cuối mỗi request |
| Block table | Dài hơn | Ngắn hơn |
| Đọc bộ nhớ | Kém hiệu quả hơn | Hiệu quả hơn |
16 token đã chứng tỏ là một giá trị mặc định tốt.
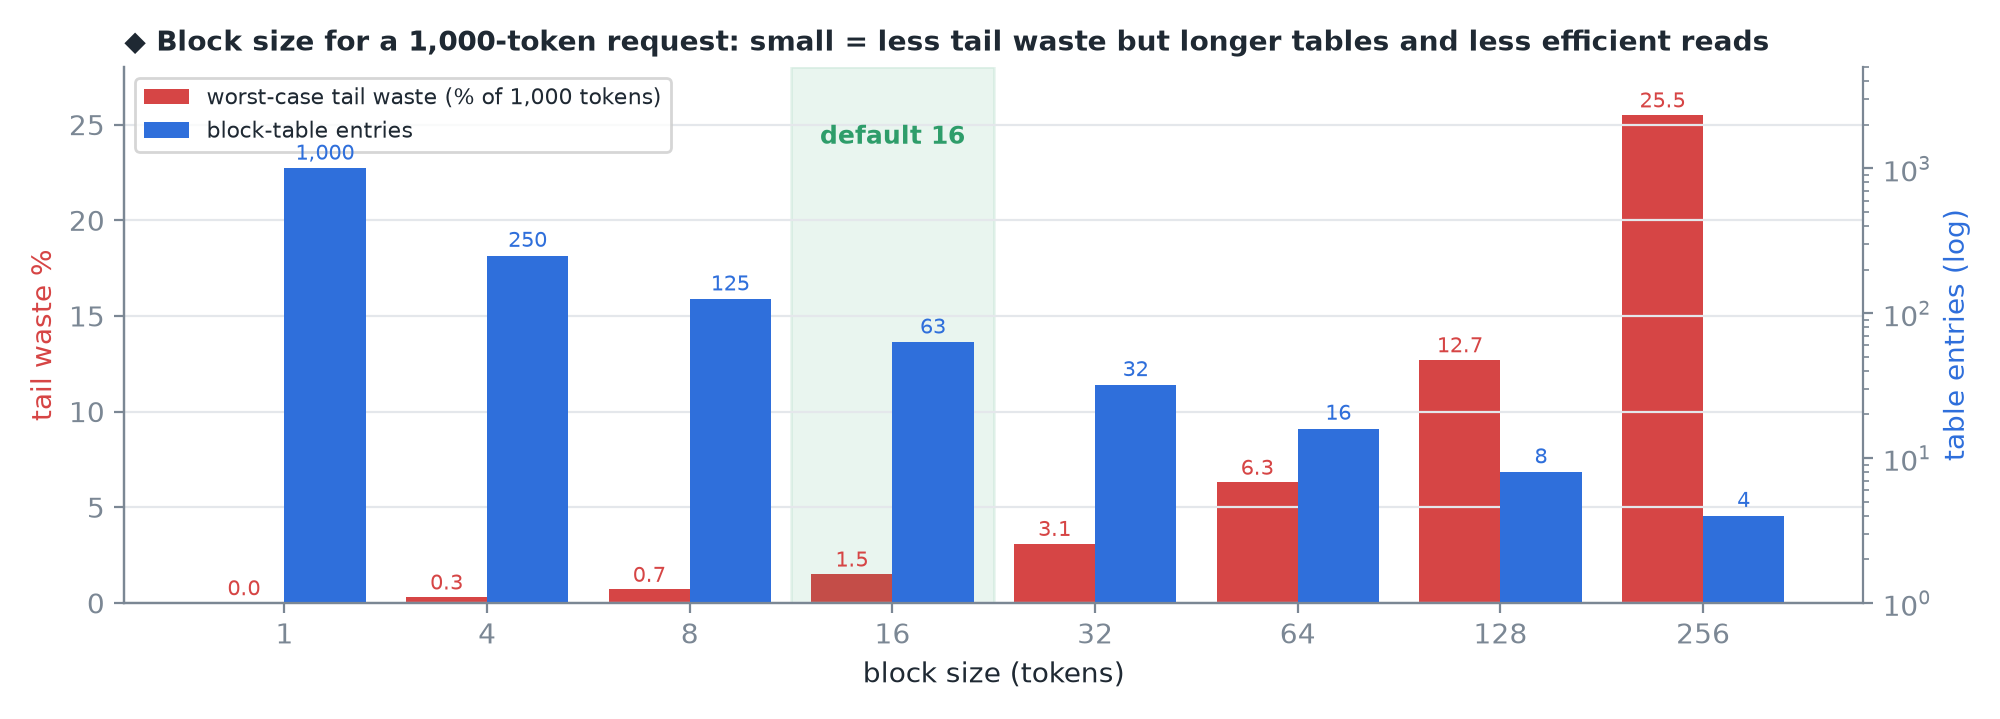 ◆ Lãng phí ở đuôi trong trường hợp xấu nhất là (block − 1) ÷ độ dài, và bảng cần độ dài ÷ block mục (làm tròn lên). Ở 16, một request 1.000 token lãng phí ≤ 1,5% với 63 mục.
7. Tóm tắt