53 · GEMM lượng tử hoá và overhead giải lượng tử
Nguồn: fanout.sh / inference-eng / 11-04 · ~5 phút
Ghi chú
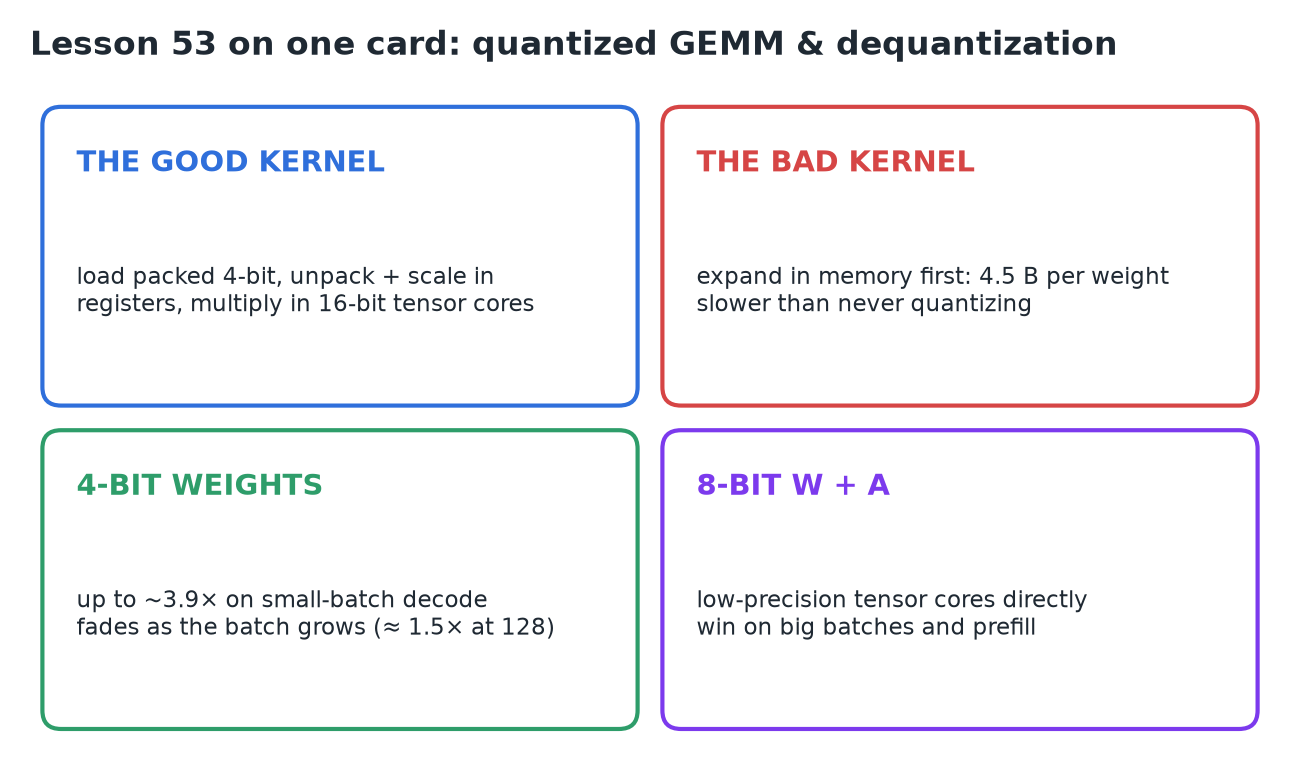
Một model 4-bit nhỏ hơn 4 lần, nhưng phép nhân ma trận của nó chỉ đôi khi nhanh hơn 4 lần: còn tuỳ GPU làm gì với các số 4-bit và bạn nhân bao nhiêu token cùng lúc. Phần lớn GPU không nhân trực tiếp được trọng số 4-bit với activation 16-bit, nên một kernel tốt giải nén và scale từng tile trong register rồi đưa vào tensor core 16-bit; trọng số đi qua bus bộ nhớ ở mức nửa byte. Nở chúng ra trong bộ nhớ trước tốn 4,5 byte mỗi trọng số, tệ hơn cả 16-bit thông thường. Kernel tốt (Marlin) giữ gần mức lý tưởng ≈ 3,9 lần tới batch 16–32, tụt xuống ≈ 1,5 lần ở 128 và hoà vốn ở prefill lớn. W8A8 bỏ qua bước giải nén và dùng tensor core 8-bit (≈ 2 lần phép tính), nên nó thắng ở batch lớn và prefill.
1. Bên trong một kernel 4-bit tốt
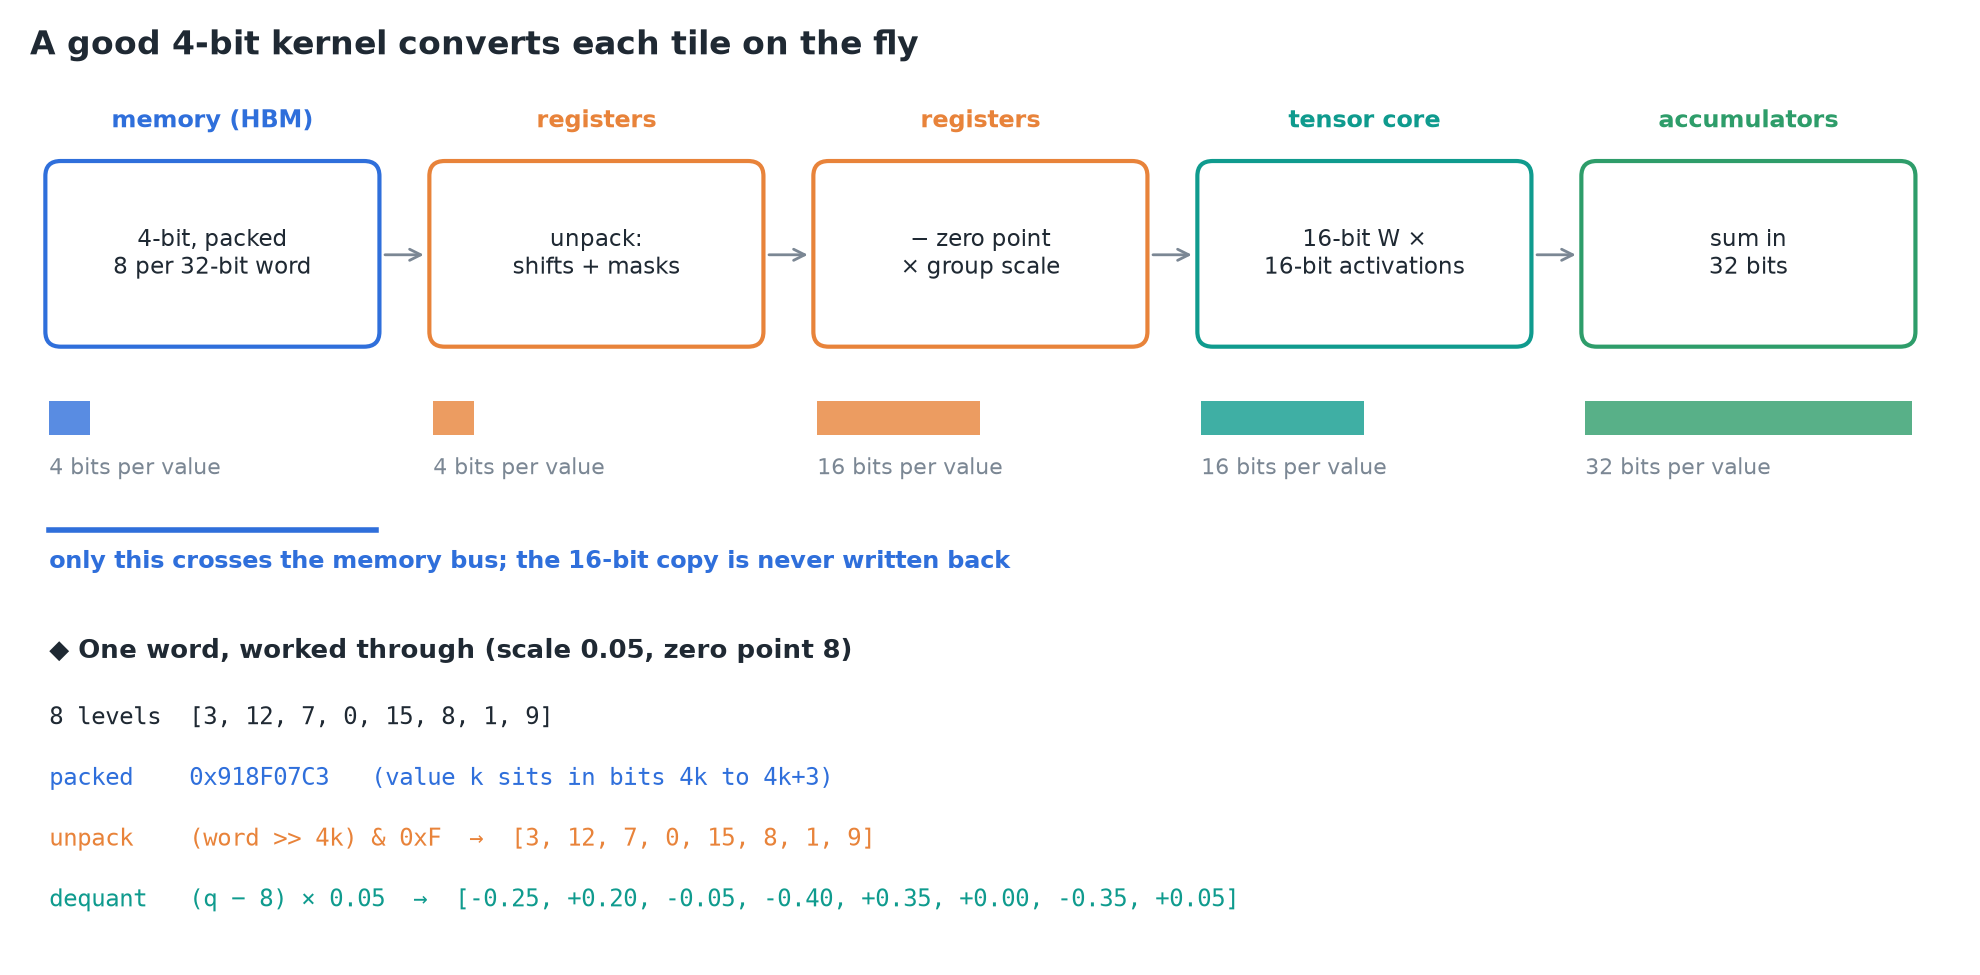 Các thanh cho thấy số bit mỗi giá trị ở từng giai đoạn. ◆ Từ (word) được tính ví dụ là của tôi.
- Phần lớn GPU không có lệnh tensor core cho 4-bit × 16-bit, nên kernel chuyển đổi trọng số ngay trong lúc chạy, từng tile một:
- Nạp một tile trọng số đã đóng gói: tám giá trị 4-bit trong mỗi word 32-bit.
- Trong register, giải nén chúng bằng vài phép dịch bit và mask.
- Trừ zero point và nhân với scale của nhóm: thành trọng số 16-bit.
- Đưa chúng vào tensor core cùng activation 16-bit.
- Cộng dồn các tích trong bộ tích luỹ 32-bit.
- Điểm mấu chốt: trọng số đi qua bus bộ nhớ ở 4 bit và không bao giờ được ghi ngược lại ở 16 bit.
2. Cách ngây thơ
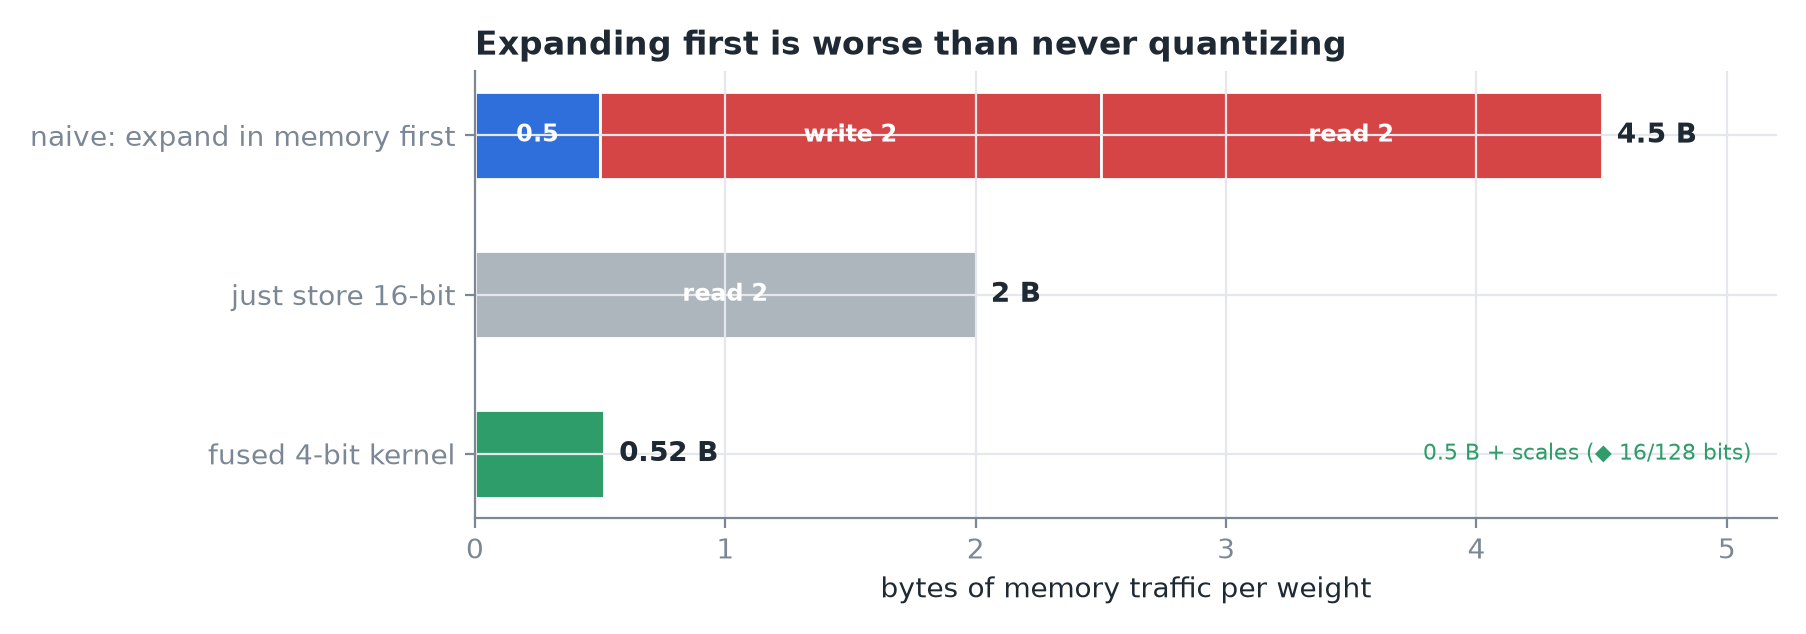 Lưu lượng bộ nhớ mỗi trọng số với từng cách.
- Nở cả ma trận ra 16 bit trong bộ nhớ trước nghĩa là đọc nửa byte, ghi hai byte, rồi đọc lại hai byte đó.
3. Nhanh hơn bao nhiêu: tuỳ batch
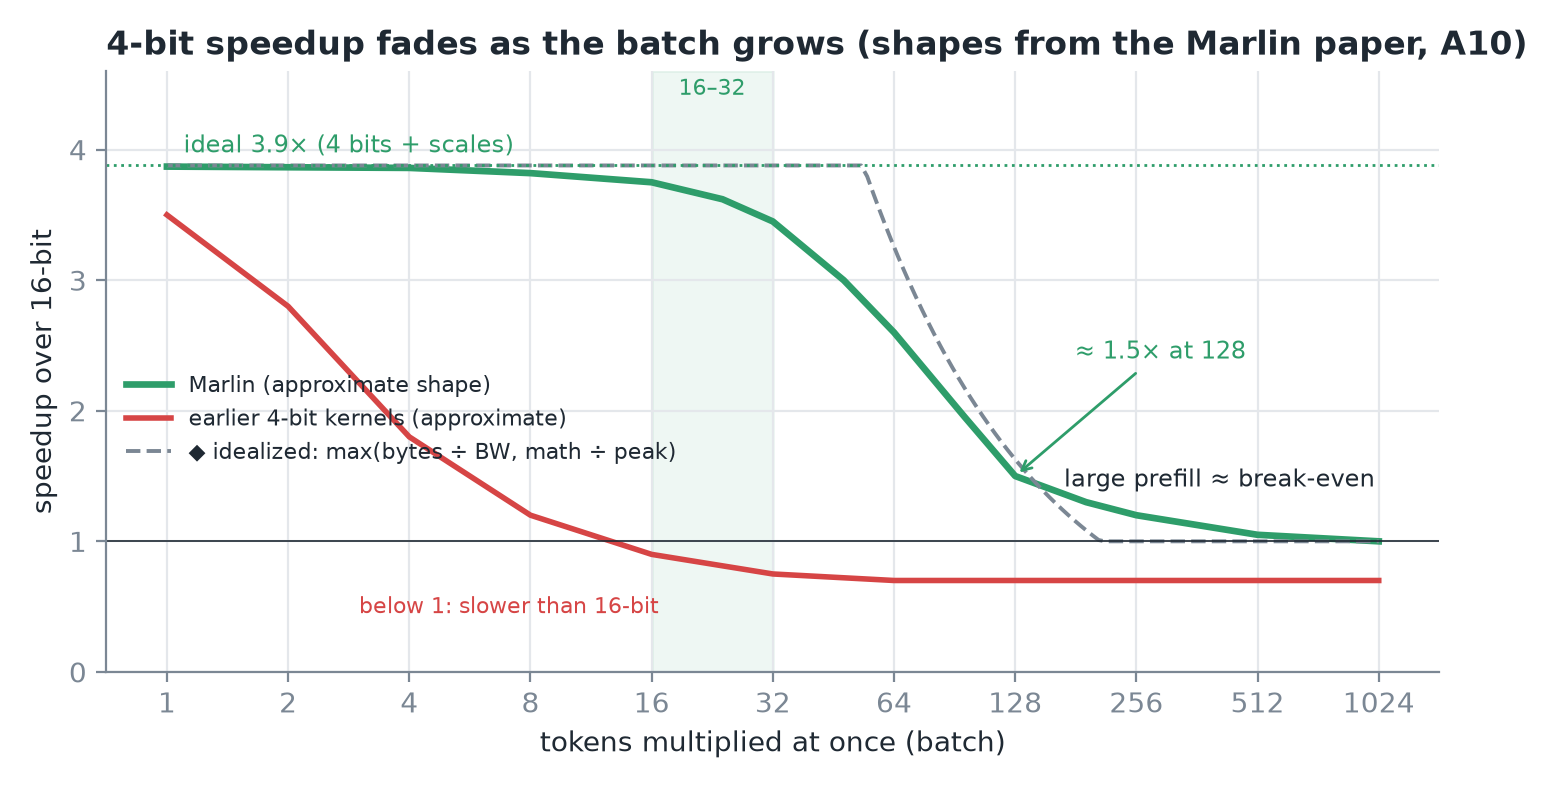 Hình dạng đường cong xấp xỉ theo paper Marlin (A10, layer lớn). ◆ Đường nét đứt là roofline không tính chi phí giải nén (A10: 125 TFLOPS, 600 GB/s).
- Batch 1: bị giới hạn bởi việc đọc trọng số, nên ít byte hơn 4 lần cho gần 4 lần; tính cả hệ số scale thì ≈ 3,9 lần lý tưởng.
- Khi batch lớn lên, mỗi trọng số được dùng cho nhiều phép nhân hơn. Một GPU hiện đại làm được 100–200 phép tính cho mỗi byte nó đọc, nên có chỗ để giấu việc giải nén và vài chục phép nhân sau mỗi lần nạp trọng số.
- Marlin giữ gần mức lý tưởng tới batch 16–32 token.
- Quá mức đó, phép tính là giới hạn: trọng số vẫn cần giải nén và scale, và tensor core vẫn nhân ở 16 bit. Tới batch 128, lợi ích còn ≈ 1,5 lần; với prefill lớn, xấp xỉ hoà vốn.
- Trước Marlin, phần lớn kernel 4-bit mất speedup khi batch vượt quá 1 hoặc 2. Trong vLLM, Marlin cho nhanh hơn tới ≈ 2,8 lần end-to-end.
Mẹo
◆ 100–200 phép tính mỗi byte đúng với GPU tầm A10/A100 (A10 ≈ 208 FLOP mỗi byte, A100 ≈ 156). H100 là ≈ 295 (989 TFLOPS ÷ 3,35 TB/s). Roofline đặt lợi ích 4-bit ở 1,6 lần tại 128, gần với 1,5 lần của Marlin. Khoảng chênh ở 32–64 là việc giải nén và các overhead khác mà roofline bỏ qua.
4. Trọng số và activation 8-bit hoạt động khác hẳn
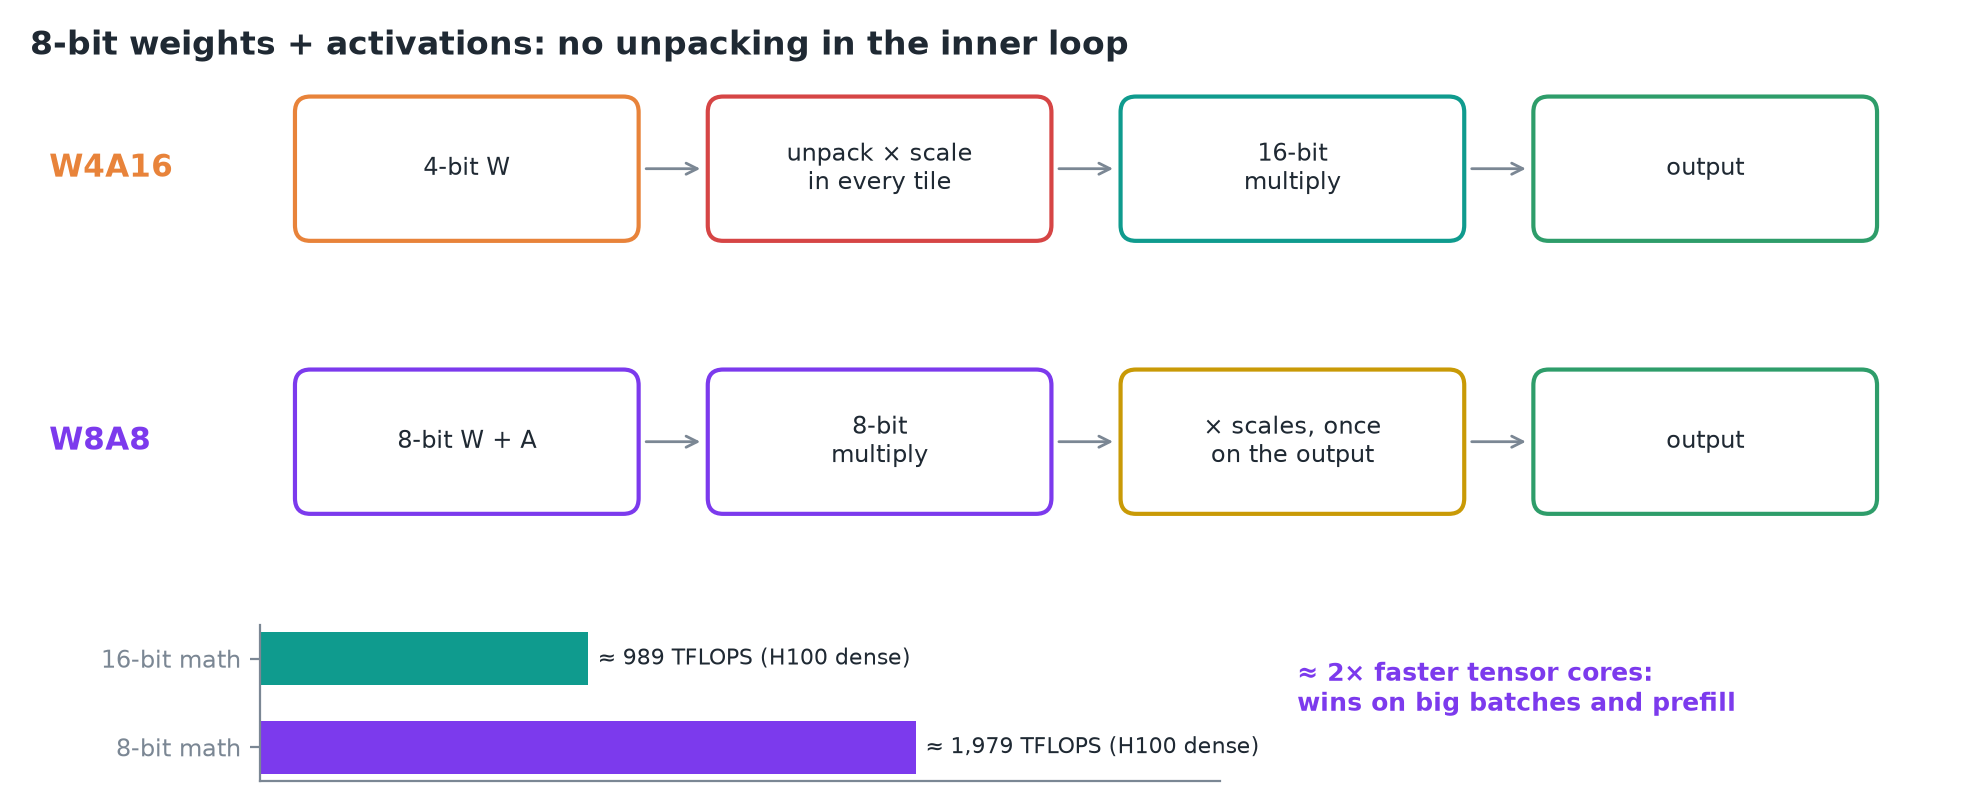 W4A16 chuyển đổi trong mọi tile; W8A8 scale một lần, ở cuối.
- Trên GPU có tensor core FP8 hoặc INT8, cả hai đầu vào đi thẳng vào tensor core ở 8 bit: không có giải nén trong vòng lặp trong.
- Scale được áp một lần, lên đầu ra đã hoàn thành.
- Tensor core chạy nhanh khoảng 2 lần ở 8 bit so với 16.
- Vì vậy W8A8 tăng tốc phần việc compute-bound, batch lớn và prefill, đúng chỗ 4-bit chỉ trọng số hết hơi.
Quan trọng
4-bit chỉ trọng số cho batch nhỏ và latency thấp; 8-bit trọng số + activation cho throughput cao. Lý do nằm ở kernel: 4-bit tiết kiệm byte, 8-bit W+A tiết kiệm phép tính.
5. Tóm tắt