56 · PyTorch profiler và memory snapshot
Nguồn: fanout.sh / inference-eng / 12-02 · ~7 phút (bài dạng văn bản)
Ghi chú
Mọi phép toán model thực hiện đều đi qua framework, nên framework có thể tự ghi sổ công việc của chính nó. Điều đó làm nó thành profiler rẻ nhất để dùng trước tiên. PyTorch giữ hai cuốn sổ: torch.profiler ghi thời gian đi đâu, theo từng phép toán; memory history ghi byte đi đâu, theo từng lần cấp phát, mỗi lần kèm stack đã gây ra nó. Cả hai chạy bên trong process của bạn với vài dòng thêm vào, cả hai đều làm méo thứ chúng đo, và không cái nào thấy được gì bên ngoài process.
1. Hai công cụ, hai câu hỏi
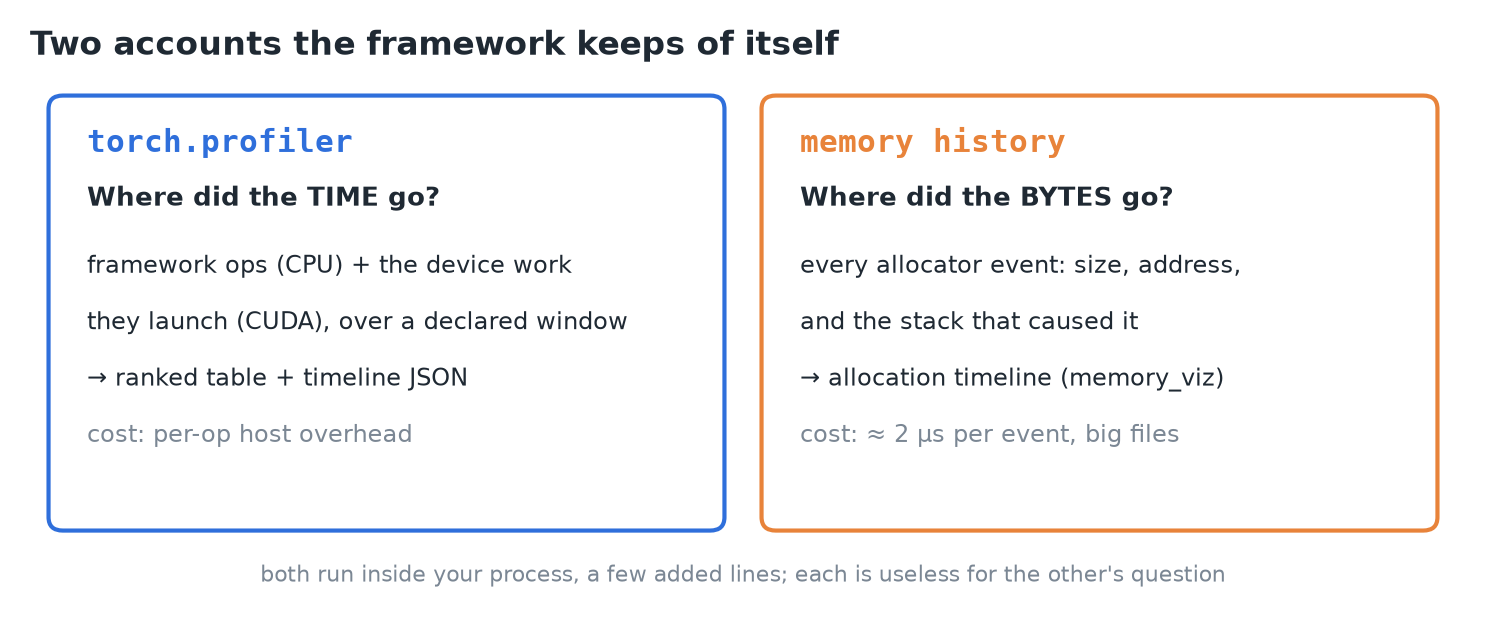 Mỗi cái trả lời một câu hỏi và vô dụng với câu hỏi của cái kia.
| Câu hỏi | Công cụ | Ghi lại | Đưa cho bạn |
|---|---|---|---|
| Thời gian đi đâu? | torch.profiler | op của framework và công việc trên thiết bị mà chúng launch, trong cửa sổ bạn khai báo | một bảng xếp hạng và một file timeline |
| Byte đi đâu? | history của torch.cuda.memory | mọi sự kiện của allocator, kèm stack | một timeline cấp phát bạn tua trong trình duyệt |
2. Profiler ghi lại gì
- Một context manager bao quanh code bạn đã có. Chọn activity:
ProfilerActivity.CPU(các phép toán của chính framework) vàProfilerActivity.CUDA(công việc trên thiết bị mà chúng launch). - Mỗi phép toán được ghi kèm thời lượng và vị trí trong cây lời gọi.
record_shapes=Truelưu shape đầu vào, nên cùng một matmul ở hai kích thước hiện thành hai hàng.with_stack=Truelưu file và dòng đã phát ra nó. Cả hai đều thêm overhead.record_function("decode_step")đặt tên cho vùng của riêng bạn: nó thành một hàng, với mọi thứ bên trong được tính dưới nó.
3. Cửa sổ ghi
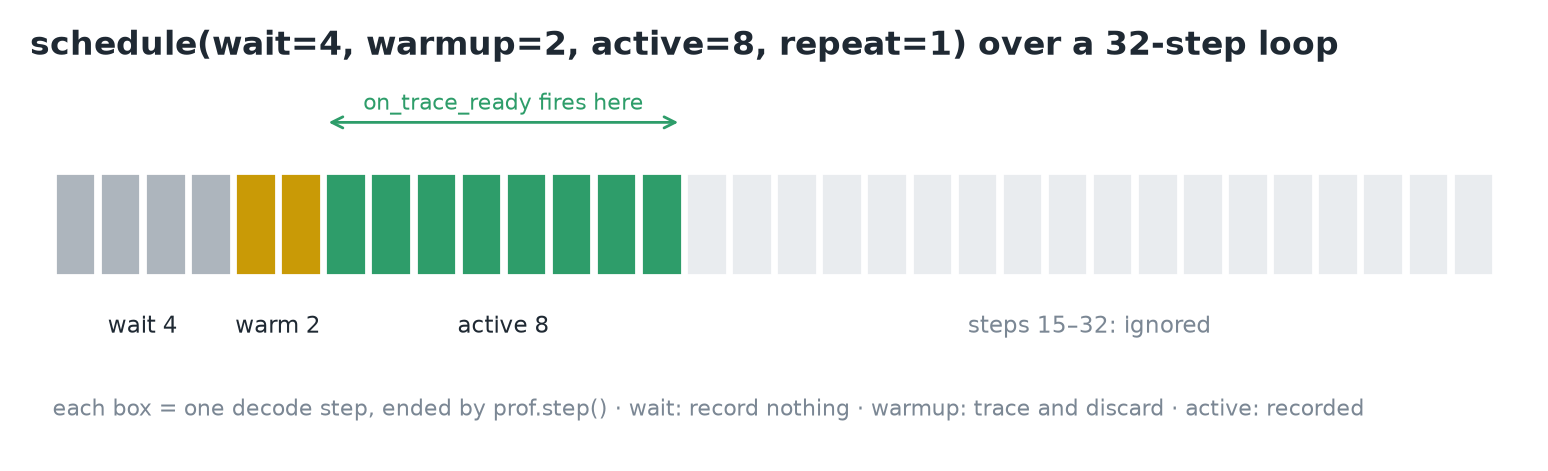 Lịch (schedule) cài kỷ luật warm-up ngay vào profiler.
- Các vòng lặp đầu còn lạnh, và một cửa sổ được chọn sau khi đã nhìn thấy các con số là một cửa sổ được khớp theo chúng. Vì vậy hãy khai báo nó từ trước bằng một schedule.
schedule(wait=4, warmup=2, active=8, repeat=1): bỏ qua 4 bước, trace 2 bước rồi bỏ đi, ghi 8, dừng.prof.step()ở cuối vòng lặp đánh dấu ranh giới mỗi bước. Khi pha active kết thúc, profiler gọion_trace_readyvới kết quả.
def on_ready(prof):
    print(prof.key_averages().table(
        sort_by="self_cuda_time_total", row_limit=12))
    prof.export_chrome_trace("decode-steady.json")

with profile(
    activities=[ProfilerActivity.CPU, ProfilerActivity.CUDA],
    schedule=schedule(wait=4, warmup=2, active=8, repeat=1),
    on_trace_ready=on_ready,
) as prof:
    for _ in range(32):
        with record_function("decode_step"):
            with torch.inference_mode():
                logits = model(input_ids=seq).logits
            next_id = logits[0, -1].argmax()
            seq = torch.cat([seq, next_id.view(1, 1)], dim=1)
prof.step()- Vòng decode không dừng sớm khi gặp end-of-sequence: một schedule hứa hẹn số bước, và một lệnh break ở bước 9 sẽ để cửa sổ không được lấp đầy.
- Trong 32 bước, 6 bước để vượt qua giai đoạn lạnh, 8 bước được ghi, phần còn lại bị bỏ qua: một cửa sổ trạng thái ổn định ngay từ thiết kế, không phải nhờ loại trừ về sau.
4. Đọc bảng
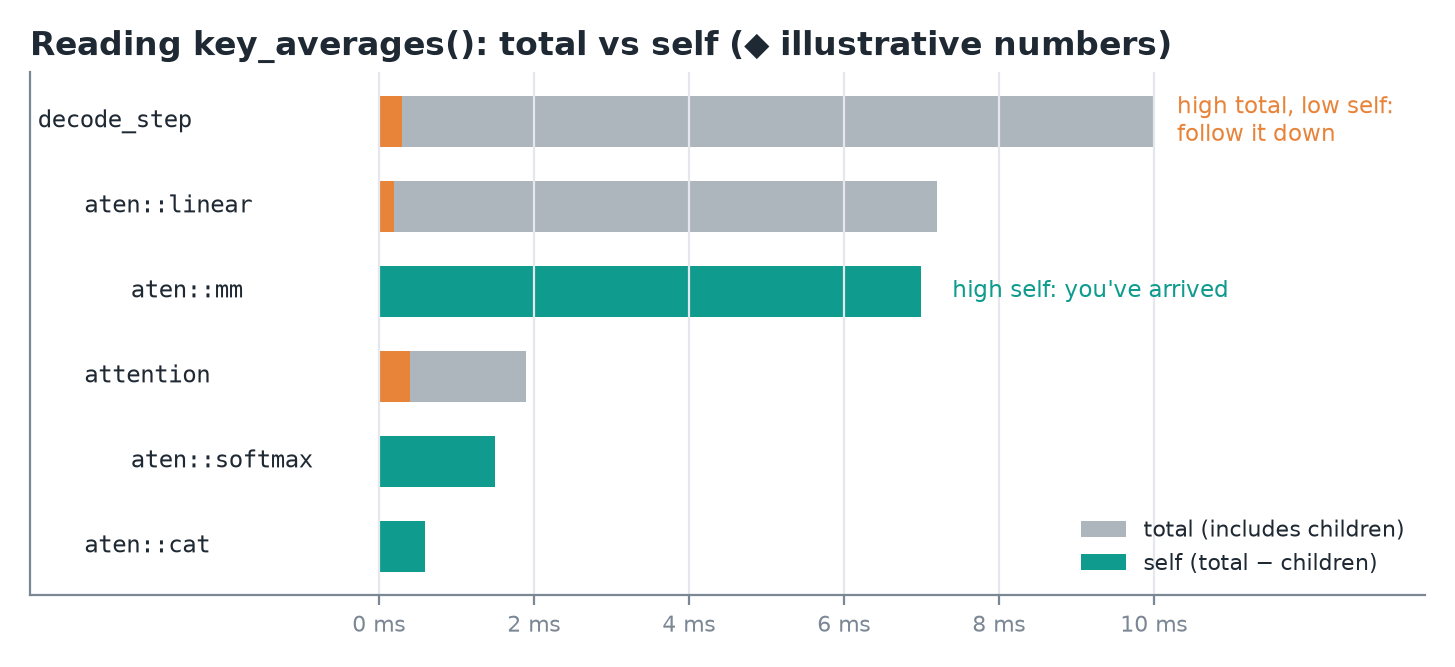 ◆ Số bịa ra để minh hoạ cách đọc total và self time trong một cây lời gọi.
key_averages()gom các phép toán theo tên và lấy trung bình;table()xếp hạng chúng theo cột bạn sắp xếp.- Thời gian total gồm mọi thứ một phép toán gọi; thời gian self là total trừ phần của các con.
- Total cao, self thấp: chi phí nằm bên dưới. Đi theo nó xuống cây.
- Self cao: bạn đã tới nơi.
- Self CPU tính giá phần việc riêng của framework trong một op; Self CUDA tính giá công việc trên thiết bị được ghi dưới nó. Sắp theo
self_cuda_time_totalthường là câu hỏi đầu tiên đúng đắn cho inference. # of Callstự nó là một chẩn đoán: một op rẻ được gọi hàng nghìn lần là vấn đề khác với một op đắt được gọi một lần.- Đây là nơi một tối ưu trở nên kiểm chứng được: operator mà thay đổi nhắm tới có một hàng, và hàng đó hoặc rẻ đi hoặc không.
5. Timeline
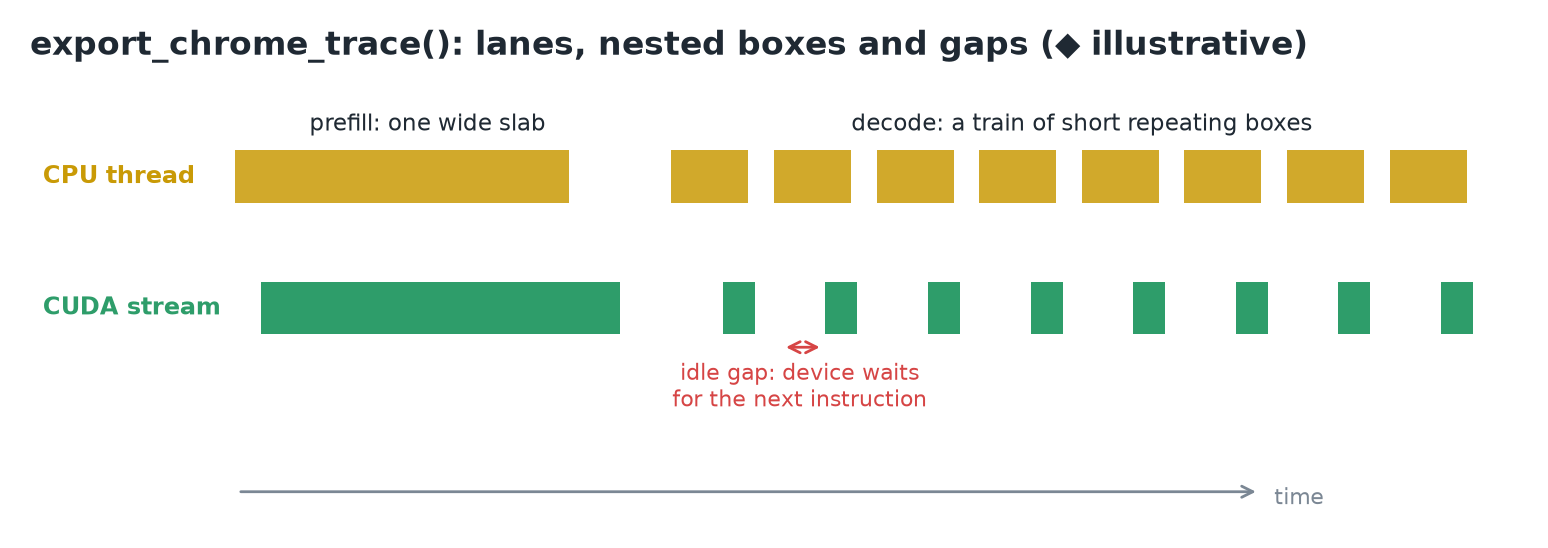 ◆ Trace minh hoạ: một khối prefill, rồi một đoàn bước decode với những khoảng nghỉ.
- Bảng lấy trung bình làm mất thứ tự.
export_chrome_trace()ghi cùng cửa sổ đó thành JSON chochrome://tracing. - Thời gian chạy từ trái sang phải; mỗi làn là một thread hoặc một stream của thiết bị; một hộp là một phép toán, và các hộp lồng nhau (nhãn
decode_stepcủa bạn bao lấy các op của model). - Điều quan trọng là quan hệ giữa các làn: một op CPU và công việc thiết bị nó tạo ra là hai hộp riêng ở hai thời điểm riêng.
- Làn xen kẽ giữa có việc và khoảng trống nghĩa là thiết bị ngồi không chờ lệnh tiếp theo.
- Ở mức thô nhất, trace của quá trình sinh là một khối prefill rộng theo sau là một đoàn hộp decode ngắn, lặp lại.
6. Memory snapshot
torch.cuda.memory._record_memory_history()bật log sự kiện của allocator: mọi lần cấp phát và giải phóng kèm kích thước, địa chỉ và stack._dump_snapshot()ghi nó ra file.- Dấu gạch dưới ở đầu nghĩa là interface không được hứa là ổn định, nhưng đó là công cụ có tài liệu.
torch.cuda.memory._record_memory_history(max_entries=200_000)
model.generate(input_ids, max_new_tokens=64)
model.generate(input_ids, max_new_tokens=64)
torch.cuda.memory._dump_snapshot("decode.pickle")
torch.cuda.memory._record_memory_history(enabled=None)- Mở file ở pytorch.org/memory_viz (kéo thả, không cần cài gì).
- Active memory timeline: mỗi lần cấp phát còn sống là một dải màu, thời gian sang phải, chiều cao là byte. Di chuột lên một dải để xem stack đã cấp phát nó.
- Allocator state: mỗi segment xin từ thiết bị và cách nó được chia thành các block.
- Log là một ring buffer gồm
max_entriessự kiện; sự kiện cũ nhất bị ghi đè trước.
7. Đọc đường cong cấp phát
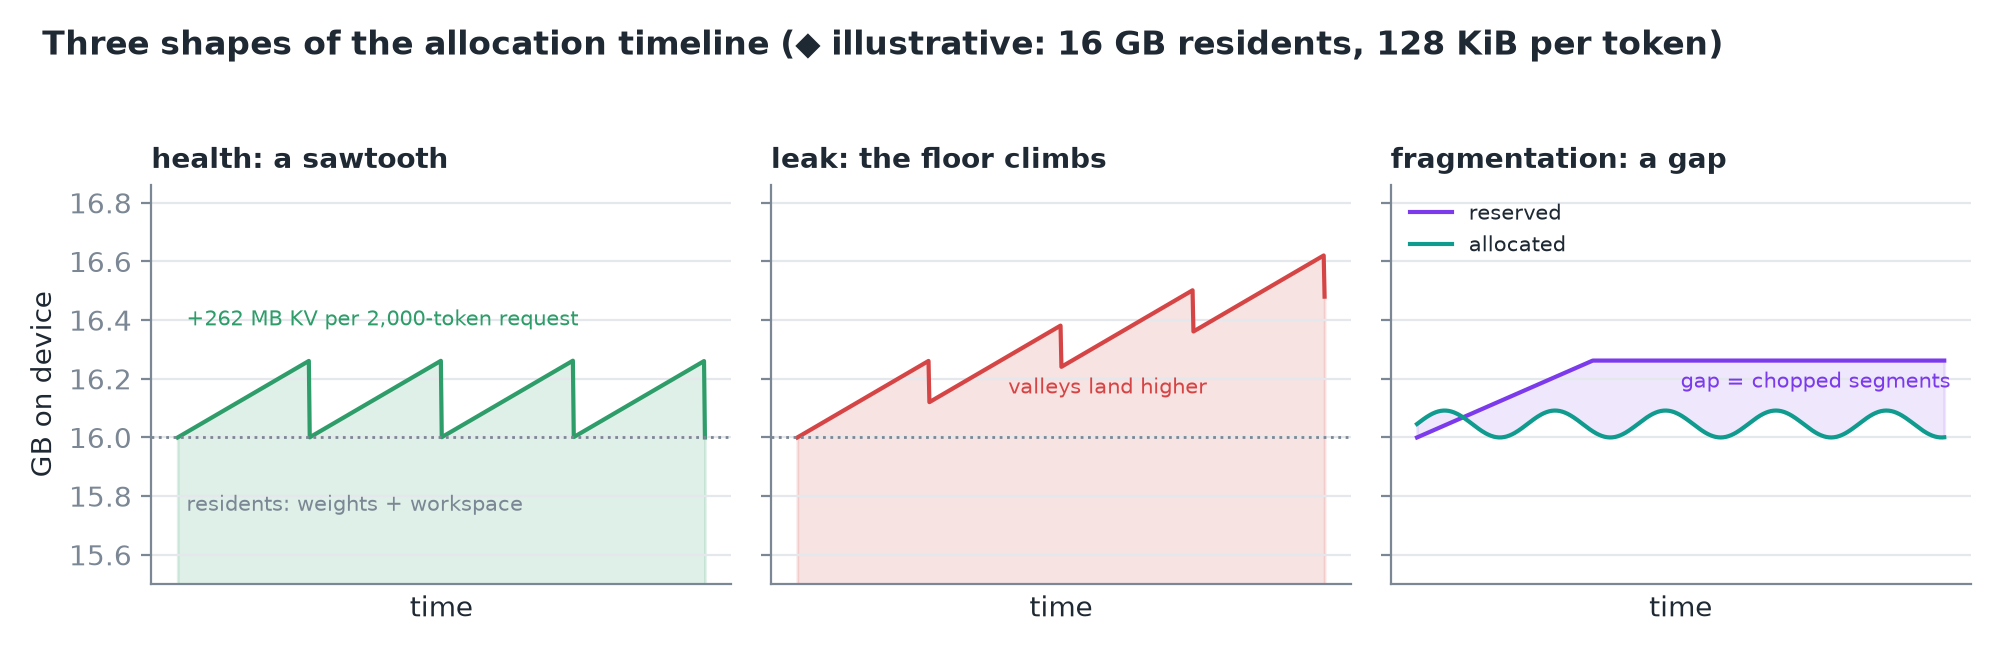 Cùng một timeline, ba chẩn đoán. ◆ Số liệu minh hoạ: 16 GB phần thường trú, request 2.000 token.
- Khoẻ mạnh là hình răng cưa. Mức nền là phần thường trú (trọng số và workspace không bao giờ giải phóng). Mỗi request leo lên khi KV cache của nó lớn dần, 131.072 byte mỗi token, rồi rơi xuống khi nó xong.
- Rò rỉ là mức nền leo dần. Có thứ gì đó trong mỗi chu kỳ không bao giờ được giải phóng, nên mỗi đáy lại cao hơn. Stack trace của dải còn tồn tại chỉ ra dòng đang giữ tham chiếu.
- Phân mảnh là một khoảng hở. Allocator giữ các segment và dùng lại block bên trong chúng, nên allocated (tensor của bạn) và reserved (allocator đang giữ) khác nhau. Nhiều lần cấp phát nhỏ với vòng đời khác nhau băm vụn các segment: reserved vẫn cao trong khi allocated giảm, và một request lớn có thể thất bại vì các block trống nằm rải rác. Chế độ xem segment cho thấy sự băm vụn đó.
- Một sự kiện out-of-memory cũng nằm trong log, kèm kích thước được yêu cầu và lượng thiết bị vẫn còn báo trống.
Mẹo
◆ Với 131.072 byte mỗi token, một request 2.000 token thêm ≈ 262 MB vào đường cong: đó là chiều cao của mỗi răng cưa.
8. Công cụ tốn gì
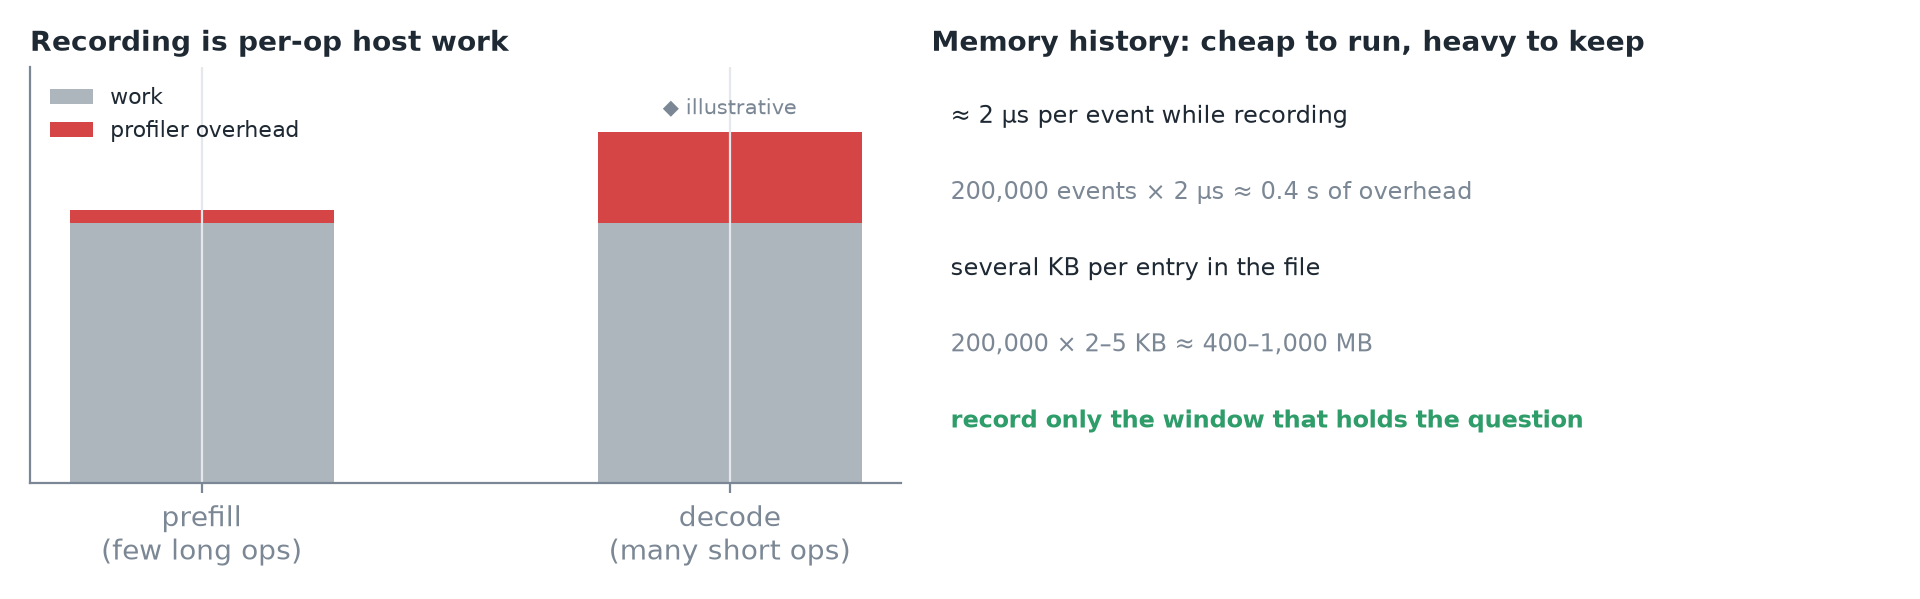 Trái: tỷ lệ overhead minh hoạ. Phải: chi phí của memory history.
- Ghi shape và trace stack thêm overhead, và giữ bản ghi shape có thể làm tensor sống lâu hơn so với chương trình không trace.
- Sự méo mó không đồng đều: ghi chép là việc của host trên mỗi phép toán, nên decode (nhiều op ngắn) bị phóng đại nhiều hơn prefill (vài op dài). Lần đầu dùng CUDA profiling còn có một chi phí một lần, mà warm-up hấp thụ.
- Memory history rẻ khi chạy, ≈ 2 µs mỗi sự kiện, nhưng file nặng vài KB mỗi mục: một buffer đầy 200.000 mục nặng hàng trăm megabyte. Hãy ghi cửa sổ chứa câu hỏi, không phải cả process.
Cảnh báo
Một lần chạy có profile là một chương trình khác với chương trình bạn ship. So có profile với có profile, đừng bao giờ so có profile với một baseline không profile.
9. Giới hạn của cuốn sổ
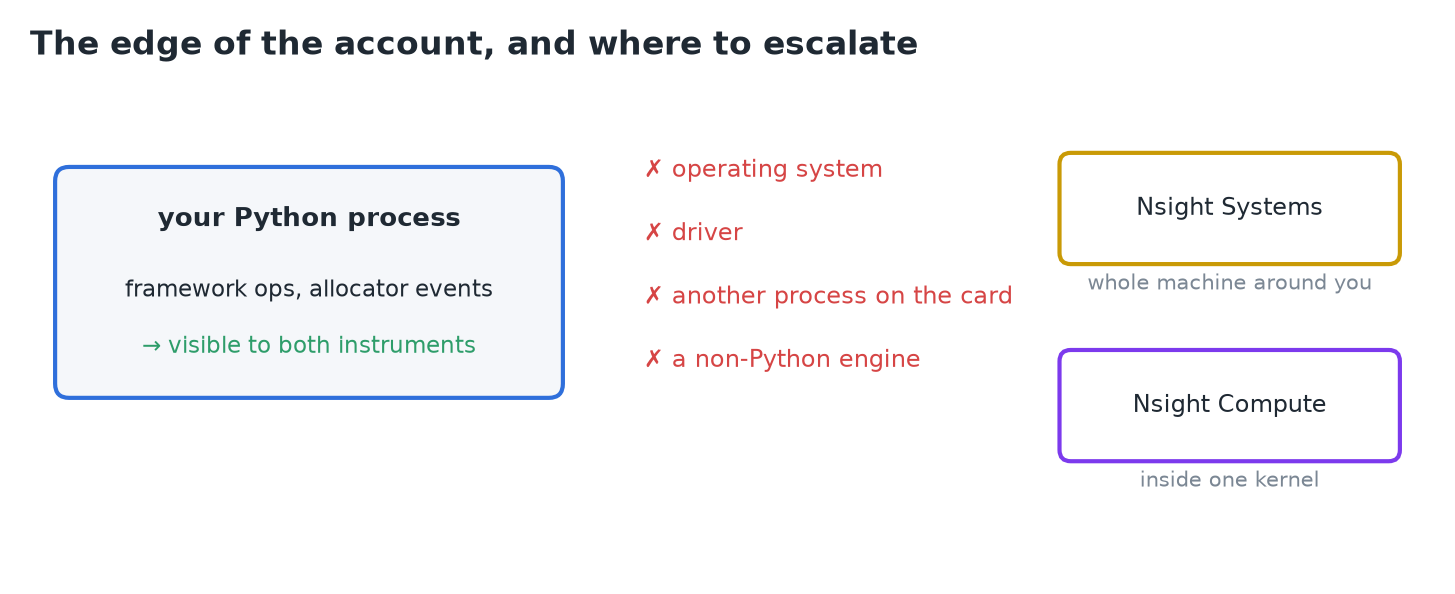 Cả hai công cụ chỉ thấy những gì một framework trong một process đã ghi lại.
- Vô hình với cả hai: hệ điều hành, driver, một process khác dùng chung card, và một engine không phải là chương trình Python này.
- Muốn biết cả máy đang làm gì quanh process của bạn, hãy nâng lên Nsight Systems. Muốn biết điều gì xảy ra bên trong một kernel đắt đỏ, dùng Nsight Compute.
- Trước đó, hãy dùng hai công cụ này trước: câu hỏi về thời gian nhận được một bảng xếp hạng và một timeline với khoảng sáu dòng; câu hỏi về byte nhận được mọi lần cấp phát kèm stack với hai lời gọi.
Quan trọng
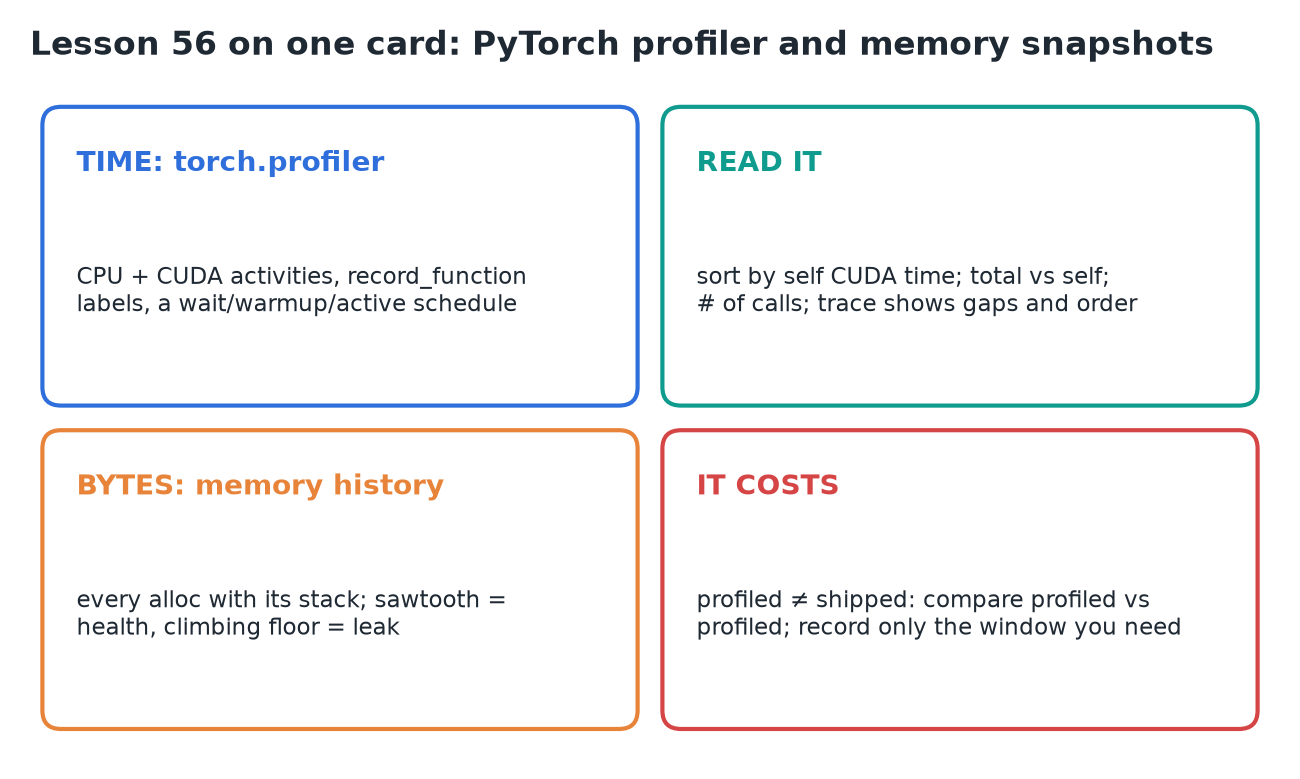
Profiler cho thời gian, memory history cho byte. Khai báo cửa sổ, đọc self so với total, và coi mọi con số có profile là phép đo của lần chạy có profile.
10. Tóm tắt