14 · Vì sao sinh tự hồi quy phải tính lại nhiều lần
Nguồn: fanout.sh / inference-eng / 03-01 · ~6 phút
Ghi chú
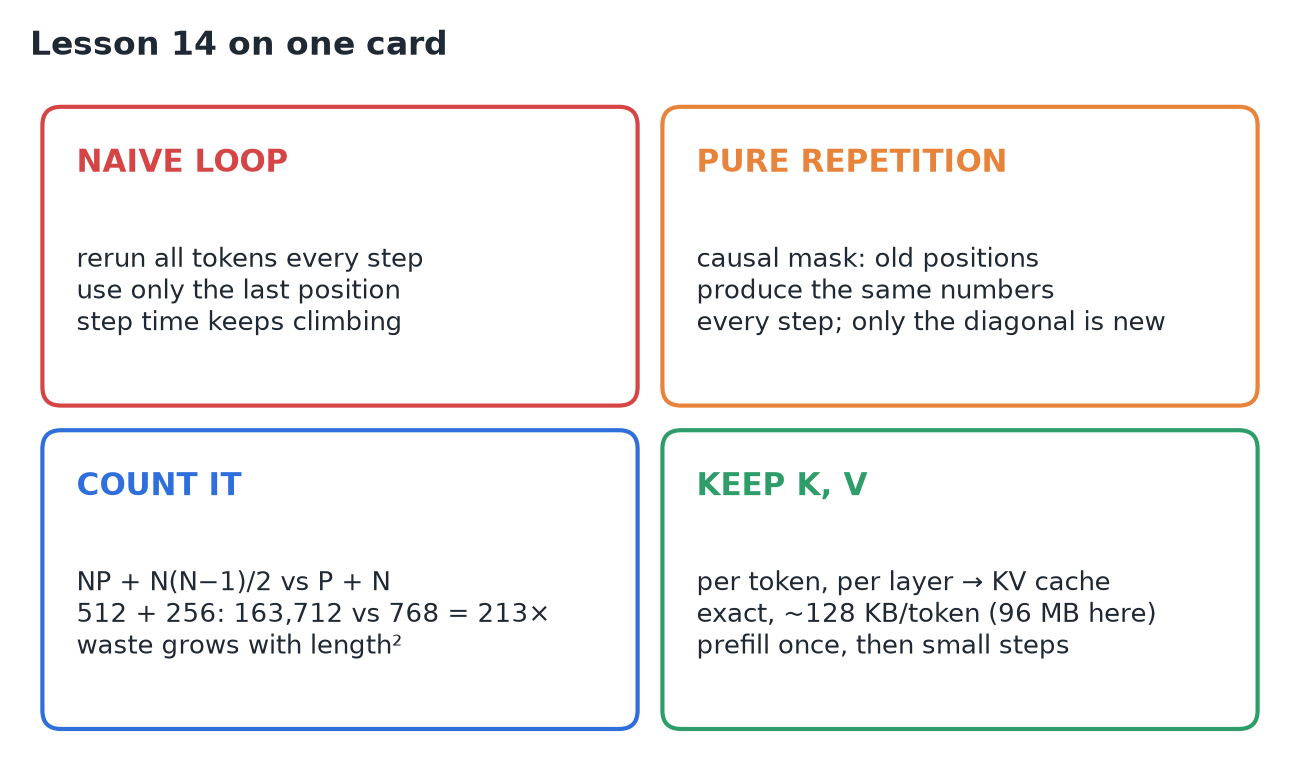
Một prompt 512 token cộng câu trả lời 256 token là 768 token văn bản, nhưng vòng lặp sinh hiển nhiên lại đẩy 163.712 token qua model: gấp 213 lần. Vòng lặp chạy lại cả chuỗi ở mỗi bước nhưng chỉ dùng logits ở vị trí cuối. Vì có causal mask, mọi vị trí cũ cho ra đúng những con số y hệt ở mỗi bước, nên phần lãng phí hoàn toàn là lặp lại, và nó tăng theo bình phương độ dài. Token mới nhất chỉ cần key và value của mọi token cũ, ở mọi layer. Lưu chúng lại (KV cache) thì mỗi token chỉ đi qua model một lần. Cache là chính xác tuyệt đối, và tốn ~128 KB mỗi token (≈ 96 MB ở đây).
1. Vòng lặp hiển nhiên
Chạy model trên mọi token tới giờ, lấy logits ở vị trí cuối, chọn một token, nối vào, lặp lại.
while not done:
    logits = model(tokens)          # chạy đầy đủ trên mọi thứ tới giờ
    nxt = sample(logits[-1])        # chỉ dùng vị trí cuối
    tokens.append(nxt)
Vẽ khối lượng công việc thành lưới: hàng là bước, cột là vị trí. Bước 1 phủ prompt, bước 2 phủ prompt cộng một token, và cứ thế. Các hàng lớn dần thành một cầu thang.
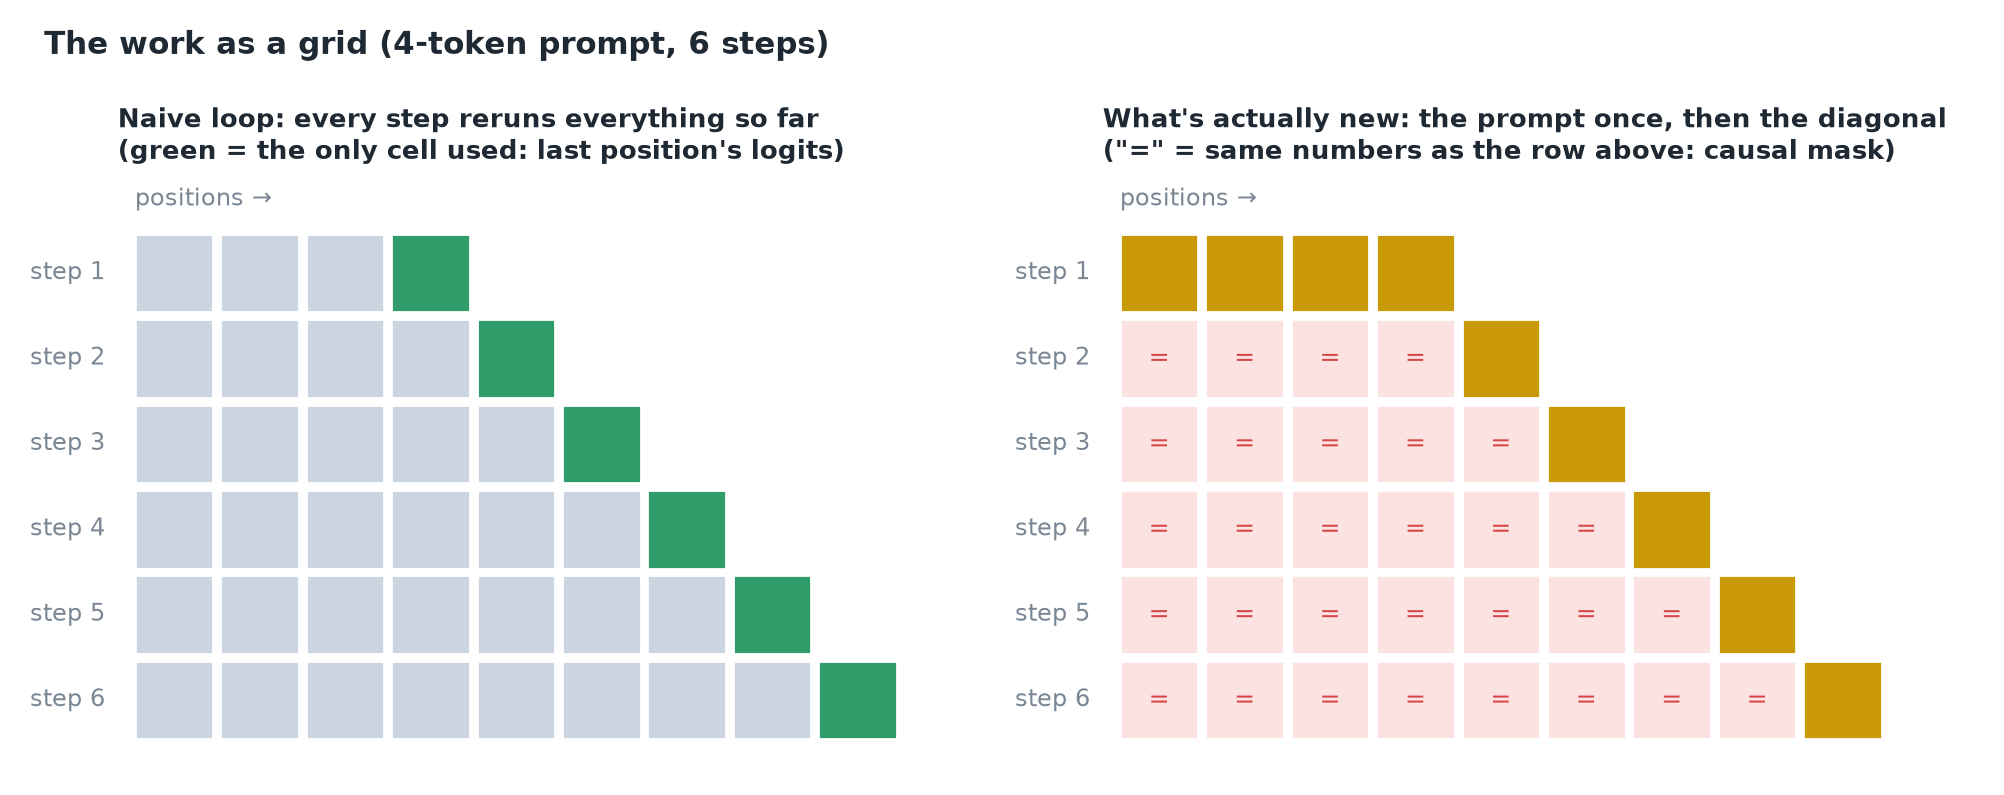 Trái: mỗi bước chỉ dùng ô cuối của nó; phần còn lại được tính rồi vứt đi. Phải: chỉ đường chéo là thực sự mới.
2. Phần bị vứt đi chính là phần đã làm
Nhớ lại causal mask: một token chỉ thấy chính nó và các token trước. Nên mọi thứ model tính ở vị trí 5, ở mọi layer, chỉ phụ thuộc vào token 1–5. Thêm token 6 không thể làm nó thay đổi.
Quan trọng
Cột 5 chứa những con số y hệt nhau ở bước 1, bước 2 và mọi bước sau, và mọi cột cũ khác cũng vậy. Chỉ một ô mỗi hàng là mới: đường chéo, nơi token mới nhất đi vào. Mọi thứ bên trái nó là tính lại.
3. Đếm thử
Với prompt P token và câu trả lời N token, vòng lặp ngây thơ xử lý P, rồi P + 1, rồi P + 2, … Tổng là NP + N(N − 1)/2. Khối lượng thực sự cần chỉ là P + N: mỗi token một lần.
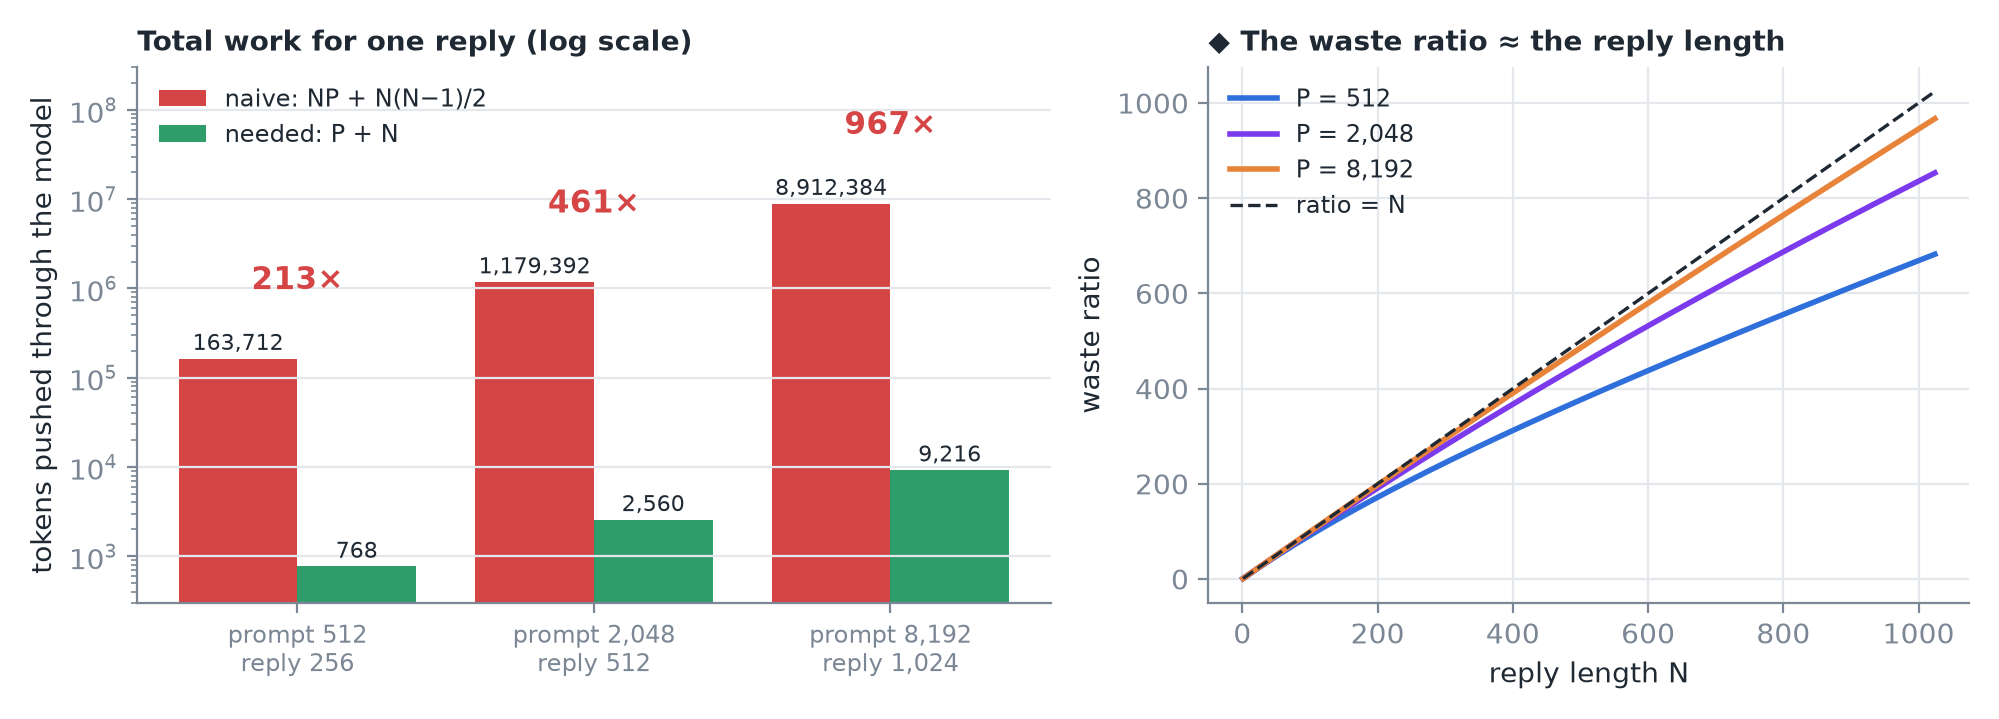 Video làm tròn trường hợp giữa và phải thành "2.000 + 500" và "8.000 + 1.000"; con số 461× và "gần 1.000×" của nó đến từ 2.048 + 512 và 8.192 + 1.024. Phải (◆): tỷ số nằm hơi dưới N và tiến gần N khi prompt dài ra.
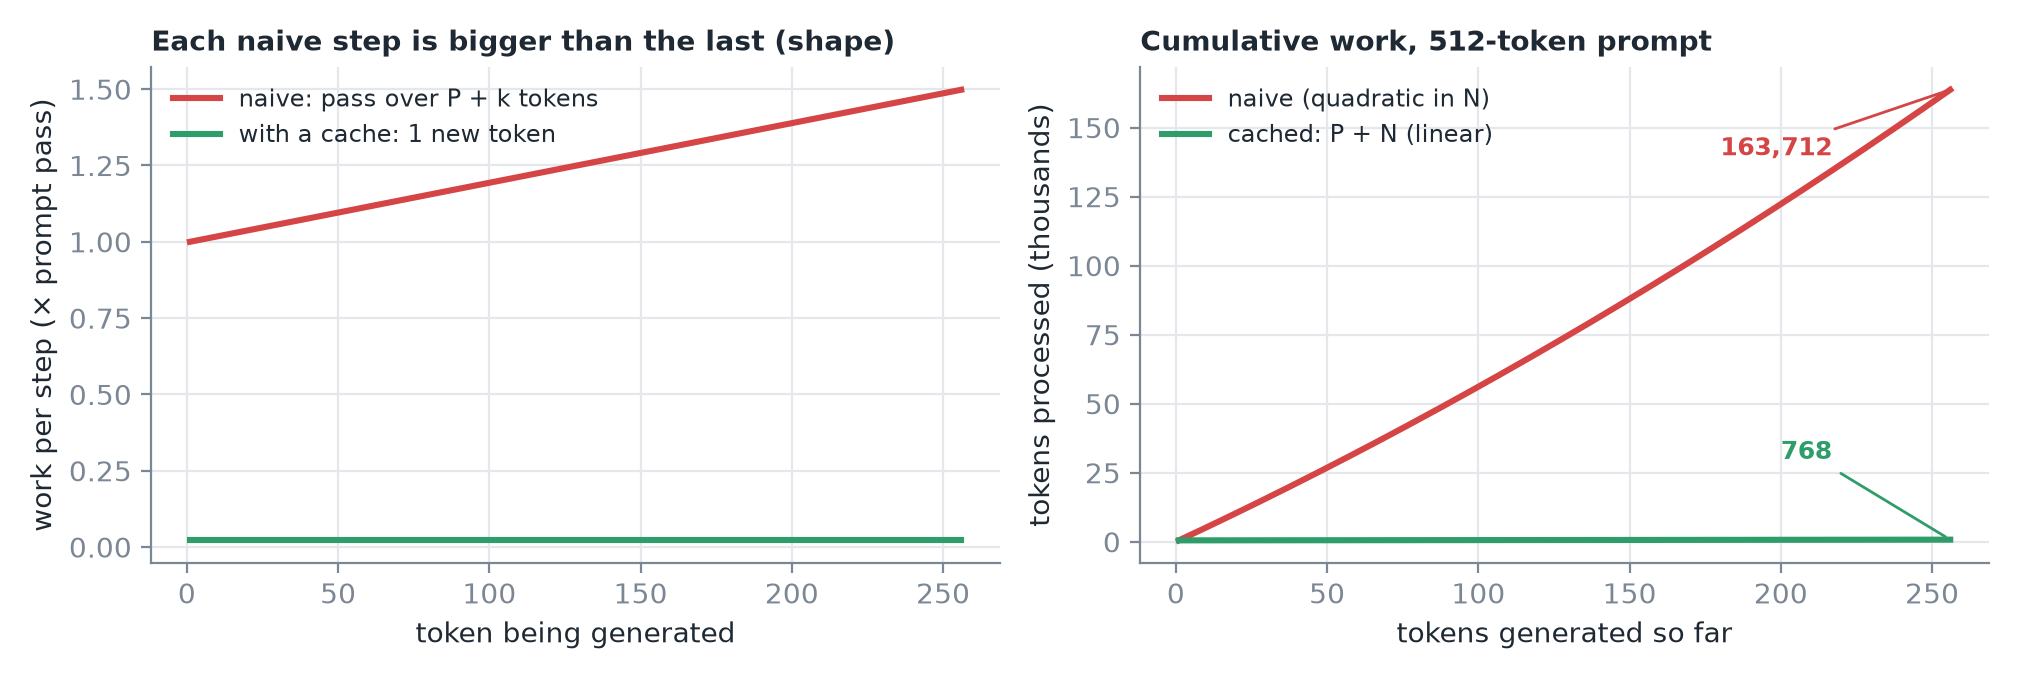
Bạn cũng cảm nhận nó qua latency: mỗi bước ngây thơ là một lượt lớn hơn lượt trước, nên thời gian mỗi token cứ tăng mãi khi câu trả lời dài ra.
4. Token mới nhất thực sự cần gì
Lần theo token mới qua một layer. Nó cần query, key và value của riêng nó (từ hidden state của nó), rồi so query của nó với key của mọi token trước và trộn các value của chúng.
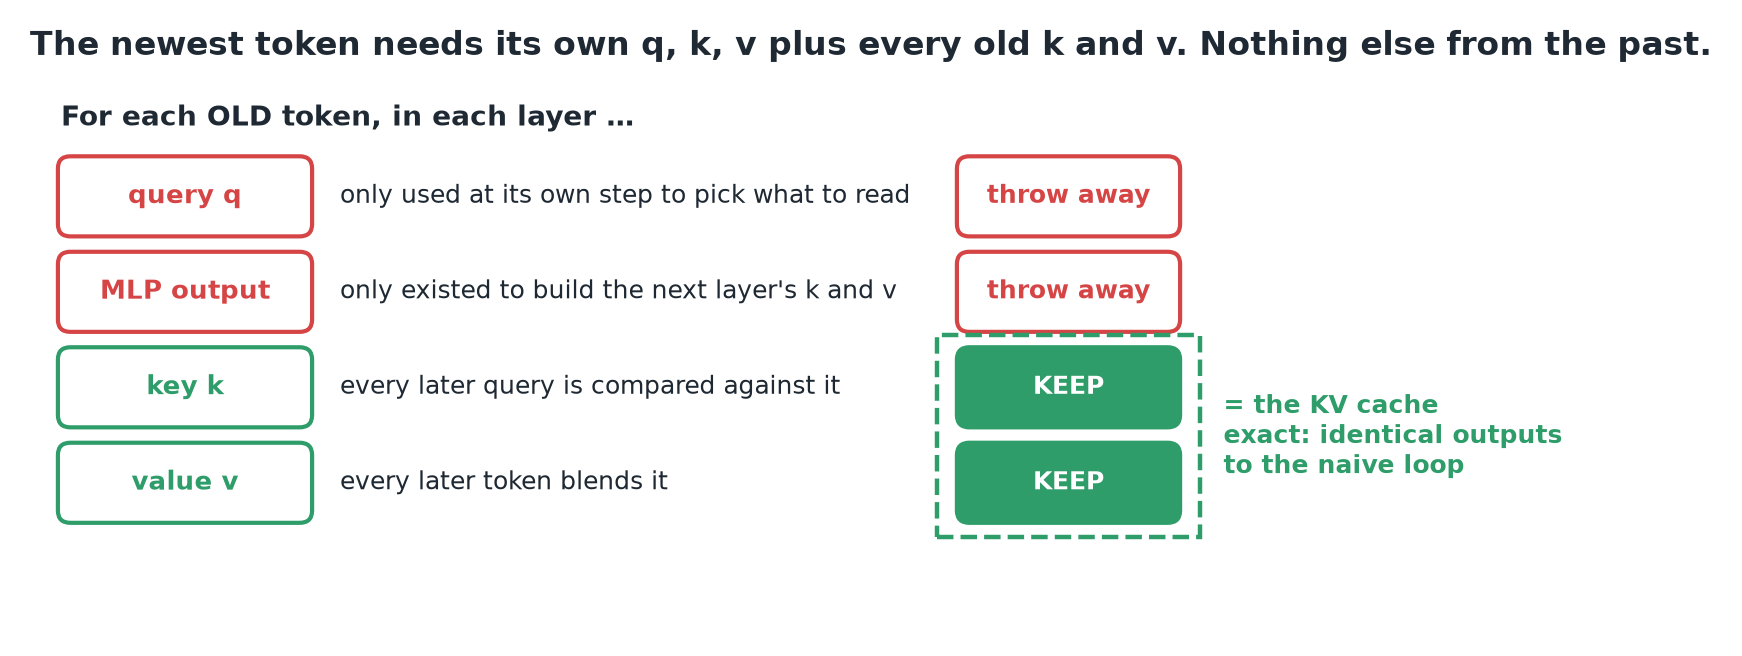 Query cũ và đầu ra MLP cũ chỉ tồn tại để tạo ra key và value của các token cũ ở layer phía trên.
Lưu key và value ở mọi layer của từng token cũ, và token mới có đủ mọi thứ nó cần. Khi đó mỗi token đi qua model một lần, thêm K và V của nó vào kho, và không bao giờ bị tính lại. Kho đó là KV cache.
Mẹo
Cache là chính xác tuyệt đối: đầu ra giống hệt vòng lặp ngây thơ. Cái giá phải trả là bộ nhớ.
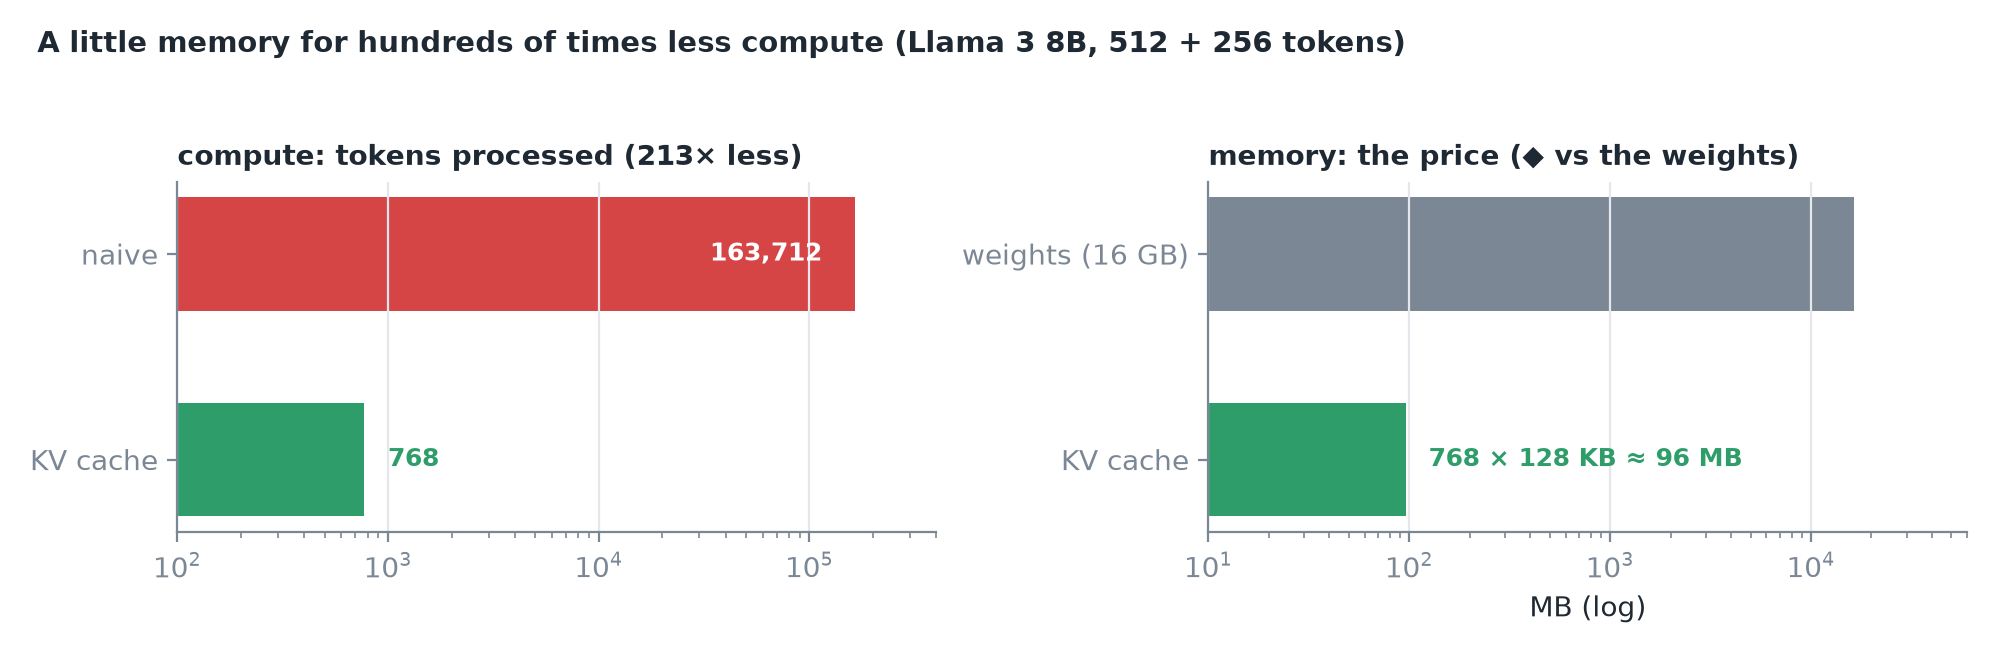 ~128 KB mỗi token với Llama 3 8B (tính ở bài 05). 768 token × 128 KB ≈ 96 MB.
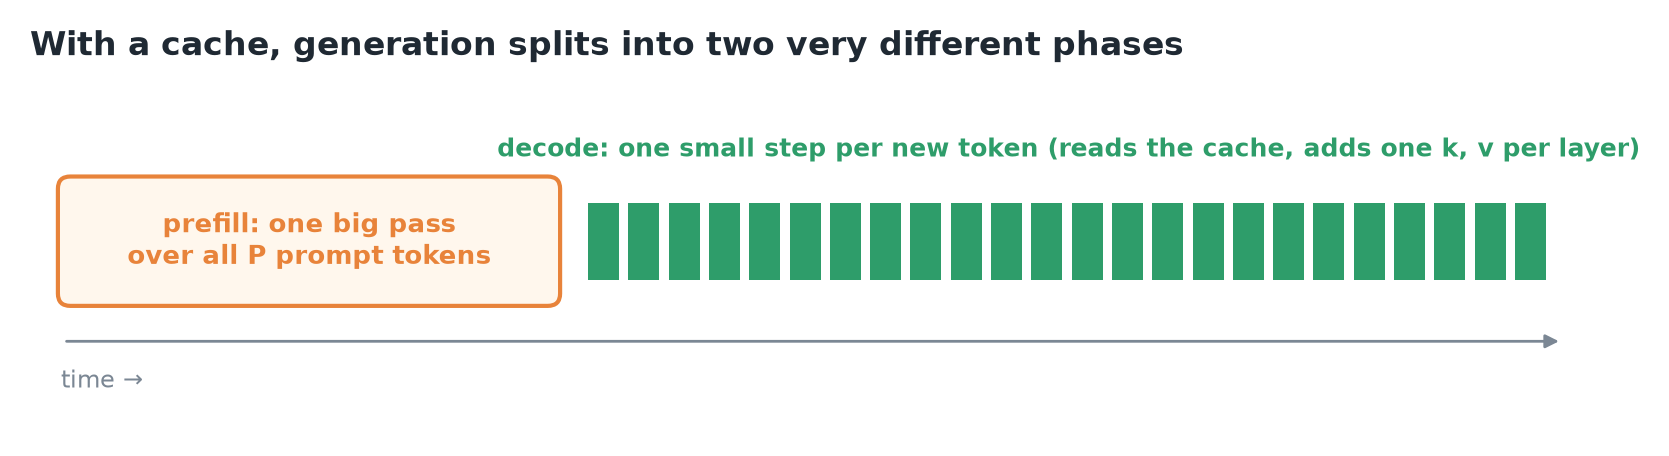
Khi có cache, quá trình sinh tách thành hai pha rất khác nhau:
5. Tóm tắt