02 · Inference Stack: từ model tới GPU tới production
Nguồn: fanout.sh / inference-eng / in-03 · ~9 phút
Ghi chú
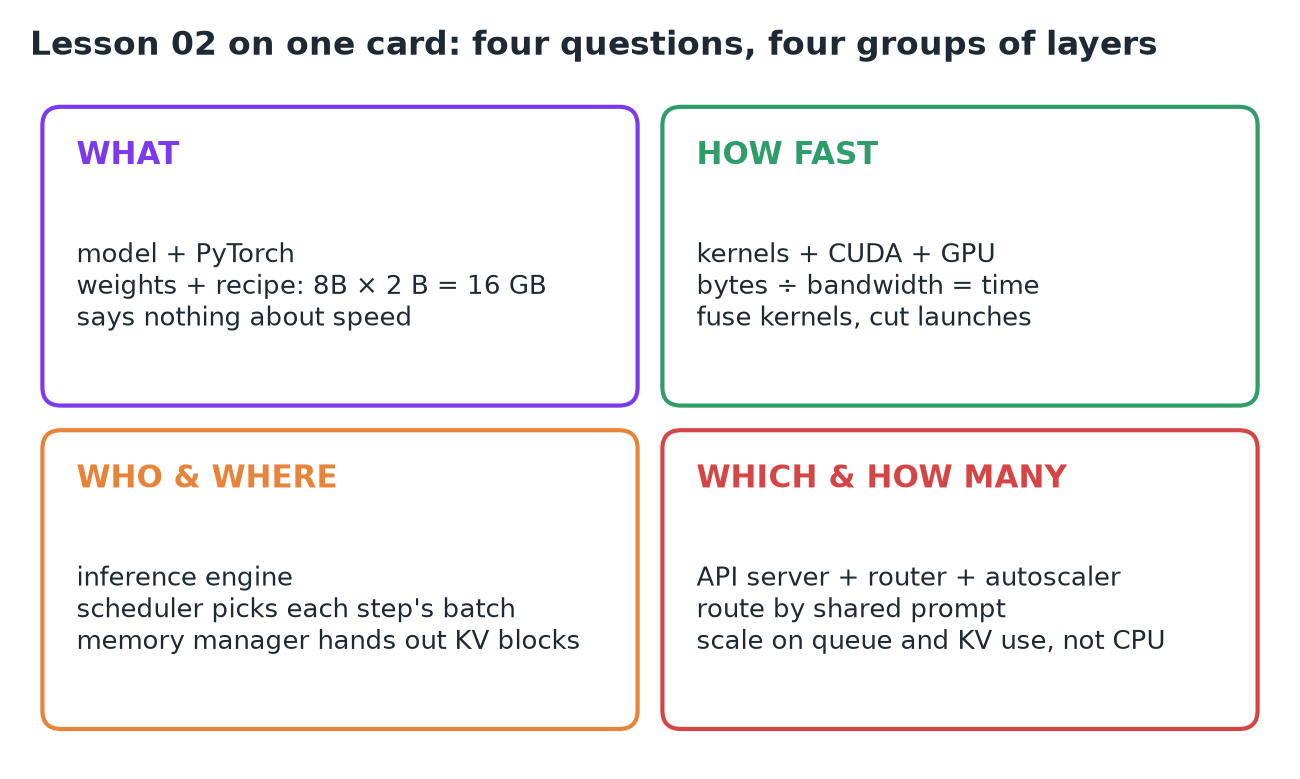
Từ lúc bấm Enter tới khi thấy chữ đầu tiên (~0,5 giây), một request đi qua khoảng 8 tầng phần mềm và phần cứng. Mỗi tầng tồn tại để trả lời một câu hỏi mà các tầng khác không trả lời được. Model nói tính cái gì; kernel và GPU quyết định nhanh tới đâu; engine quyết định ai được chạy ở mỗi bước và bộ nhớ của họ nằm ở đâu; server và fleet quyết định replica nào, và bao nhiêu replica. Phần còn lại của khoá học leo dần lên tấm bản đồ này.
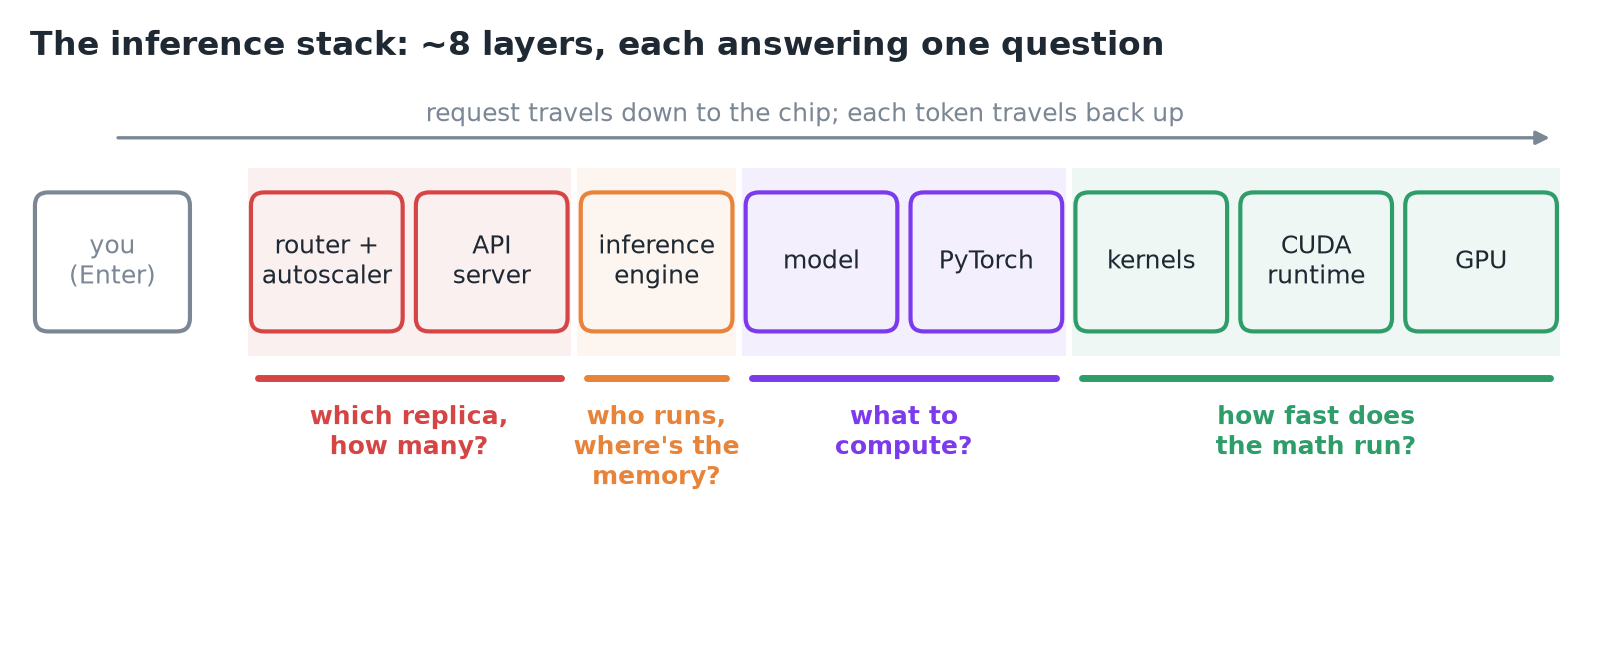 Stack từ người dùng xuống tới silicon, gom nhóm theo câu hỏi mà mỗi nhóm tầng trả lời.
1. Model: một file nói tính cái gì, không bao giờ nói tính thế nào
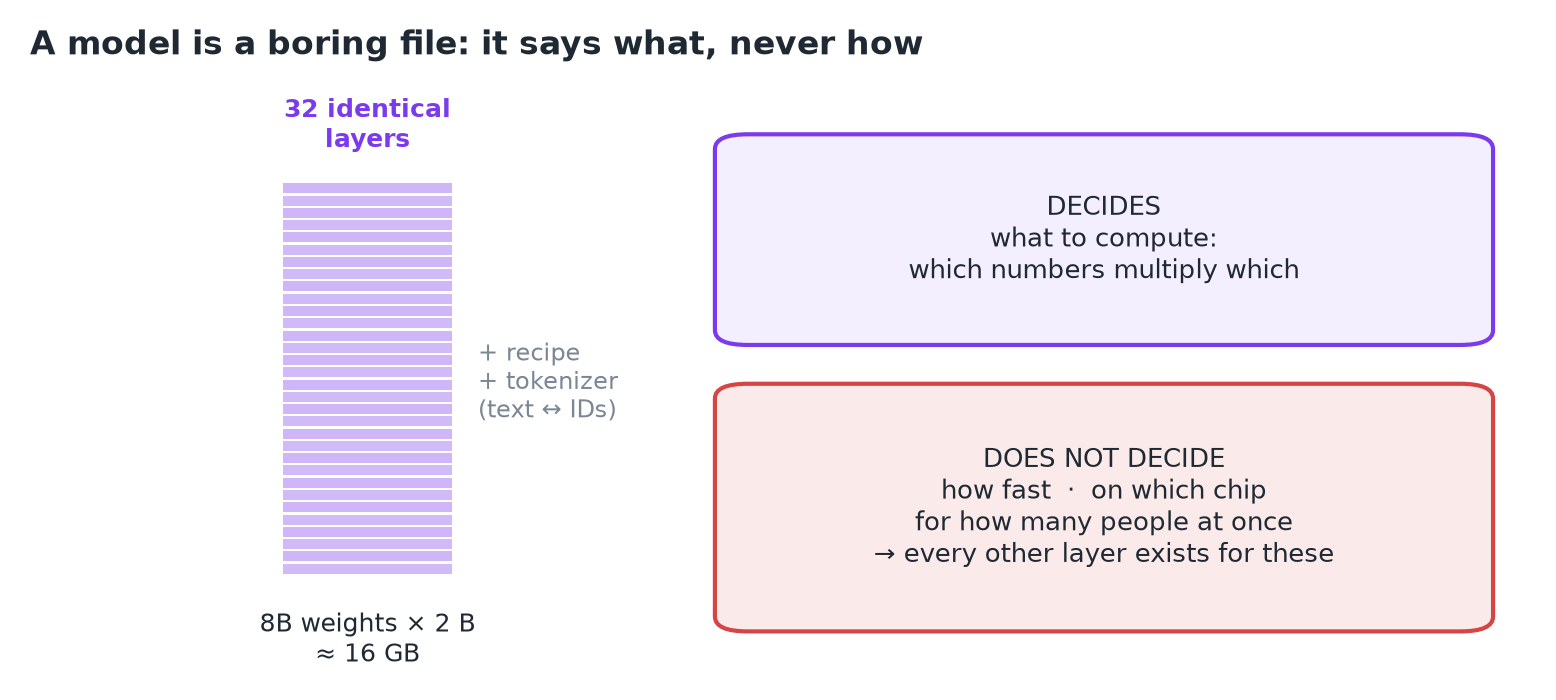 Llama 3.1 8B: 8 tỷ trọng số trong 32 layer giống hệt nhau, cộng một công thức và một tokenizer.
- Trên đĩa, model gồm trọng số (một file chứa các con số) cộng một công thức ngắn để kết hợp chúng.
- Llama 3.1 8B: ~8 tỷ trọng số, 32 layer giống hệt nhau, mỗi số 2 byte ở 16-bit, nên ~16 GB.
- Bên cạnh là một tokenizer, chuyển văn bản thành ID số nguyên và ngược lại.
Quan trọng
Model không nói gì về tốc độ, chạy trên chip nào, hay phục vụ bao nhiêu người dùng cùng lúc. Mọi tầng còn lại tồn tại để trả lời những câu hỏi đó.
2. GPU: phép tính phải chờ bộ nhớ
- Một H100 có hai phần quan trọng: 132 streaming multiprocessor (hàng nghìn đơn vị số học) và 80 GB HBM nằm ngay sát chip.
- 16 GB trọng số phải nằm trong HBM, và mỗi token mới đọc mọi trọng số một lần:
Quan trọng
Phép chia này, byte ÷ băng thông = thời gian, là con số hữu ích nhất trong inference. Không phần mềm nào phía trên chip vượt qua được nó với một luồng duy nhất; các đơn vị số học phần lớn thời gian ngồi chờ bộ nhớ.
3. Framework, kernel, CUDA: dịch toán học cho chip
| Tầng | Vai trò | Ví dụ |
|---|---|---|
| Framework | Biểu diễn model thành các phép toán tensor (matmul, norm, attention) | PyTorch |
| Kernel | Các chương trình GPU nhỏ, mỗi cái được chạy trên hàng nghìn thread | cuBLAS (matmul), FlashAttention |
| CUDA runtime + driver | Giao kernel cho phần cứng | CUDA |
Cùng một phép toán có thể chạy với tốc độ rất khác nhau tuỳ kernel:
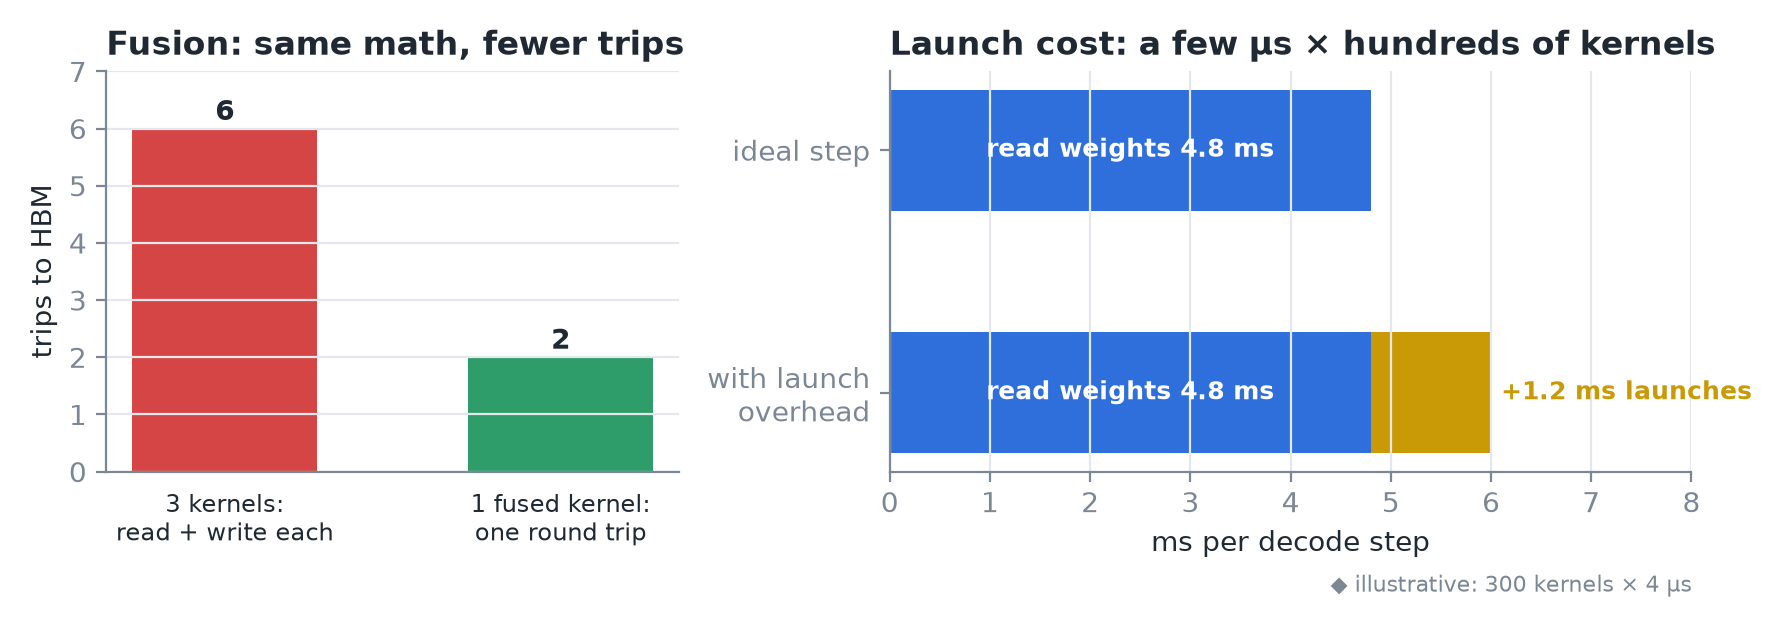 Trái: gộp ba kernel làm giảm số lần đi ra bộ nhớ. Phải: chi phí launch từng kernel cộng dồn qua hàng trăm kernel cho mỗi token.
- Fusion: ba kernel riêng biệt, mỗi cái đọc từ bộ nhớ rồi ghi ngược lại; một kernel đã gộp chỉ đi một vòng.
- Chi phí launch: mỗi lần launch tốn vài µs thời gian CPU, lặp lại qua hàng trăm kernel cho mỗi token.
- Tầng này trả lời: đúng phép toán này chạy nhanh tới đâu trên đúng con chip này?
4. Inference engine: ai được chạy, và bộ nhớ của họ nằm ở đâu
Các engine như vLLM, SGLang và TensorRT-LLM biến một model thành một dịch vụ. Chúng xoay quanh một mẹo: nếu 64 người dùng mỗi người cần một token, đọc trọng số một lần và phục vụ cả 64 trong cùng một bước. Bước đó chỉ chậm đi một chút, nhưng làm được gấp 64 lần việc.
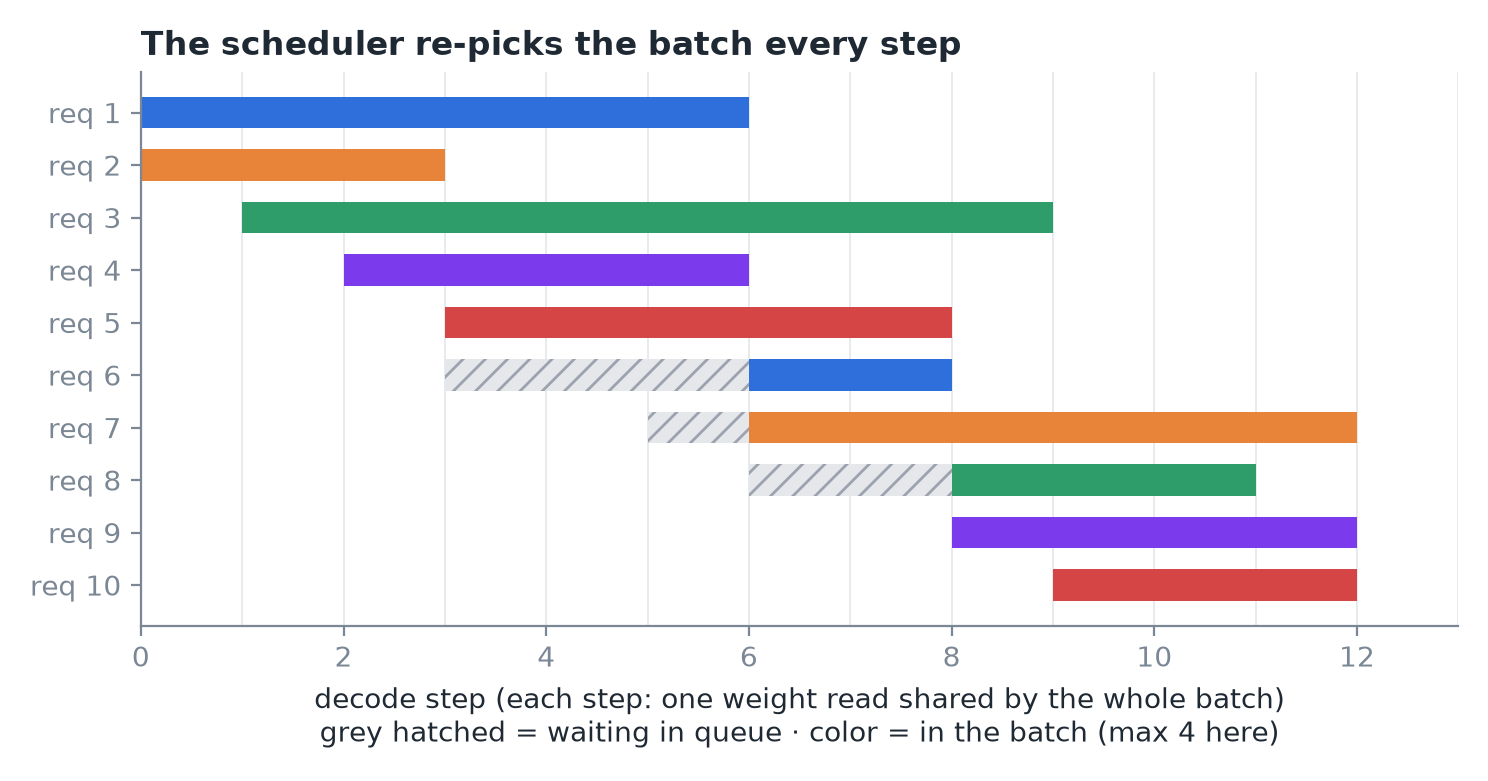 Request chờ trong hàng đợi và vào batch ở ranh giới giữa các bước; scheduler quyết định lại batch ở mỗi bước.
- Việc 1, scheduler: ở từng bước một, quyết định request nào được vào batch.
- Việc 2, bộ quản lý bộ nhớ: mỗi request mang theo một KV cache (key và value của mọi token nó đã thấy), khoảng 128 KB mỗi token với Llama 8B. Vài nghìn token × vài chục request là cache đã tranh HBM với trọng số, nên engine cấp phát và thu hồi cache theo các block nhỏ.
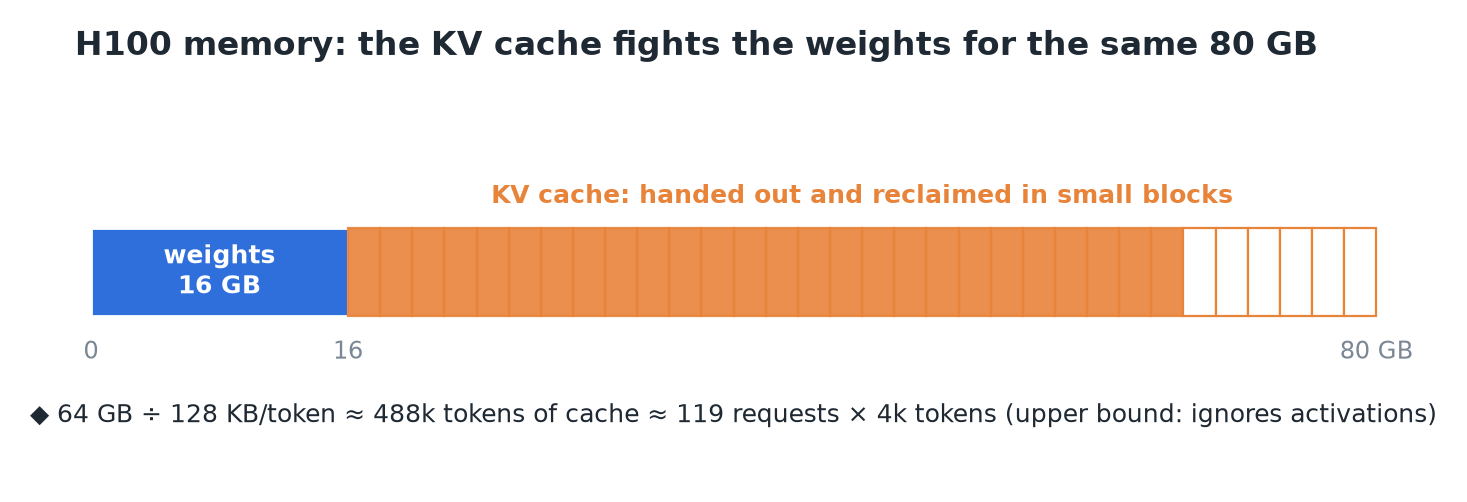 Sau 16 GB trọng số, 64 GB HBM còn lại là ngân sách cho KV cache.
5. Server và fleet: replica nào, và bao nhiêu
- Replica = một engine trên một GPU, đứng trước là một API server nói định dạng HTTP của OpenAI, chạy tokenizer và stream token trả về.
- Router: một load balancer thông thường chia đều request. Một router hiểu inference (inference-aware) gửi request có chung một system prompt dài tới replica đã cache sẵn nó, biến hàng trăm ms prefill lặp lại thành gần như bằng không.
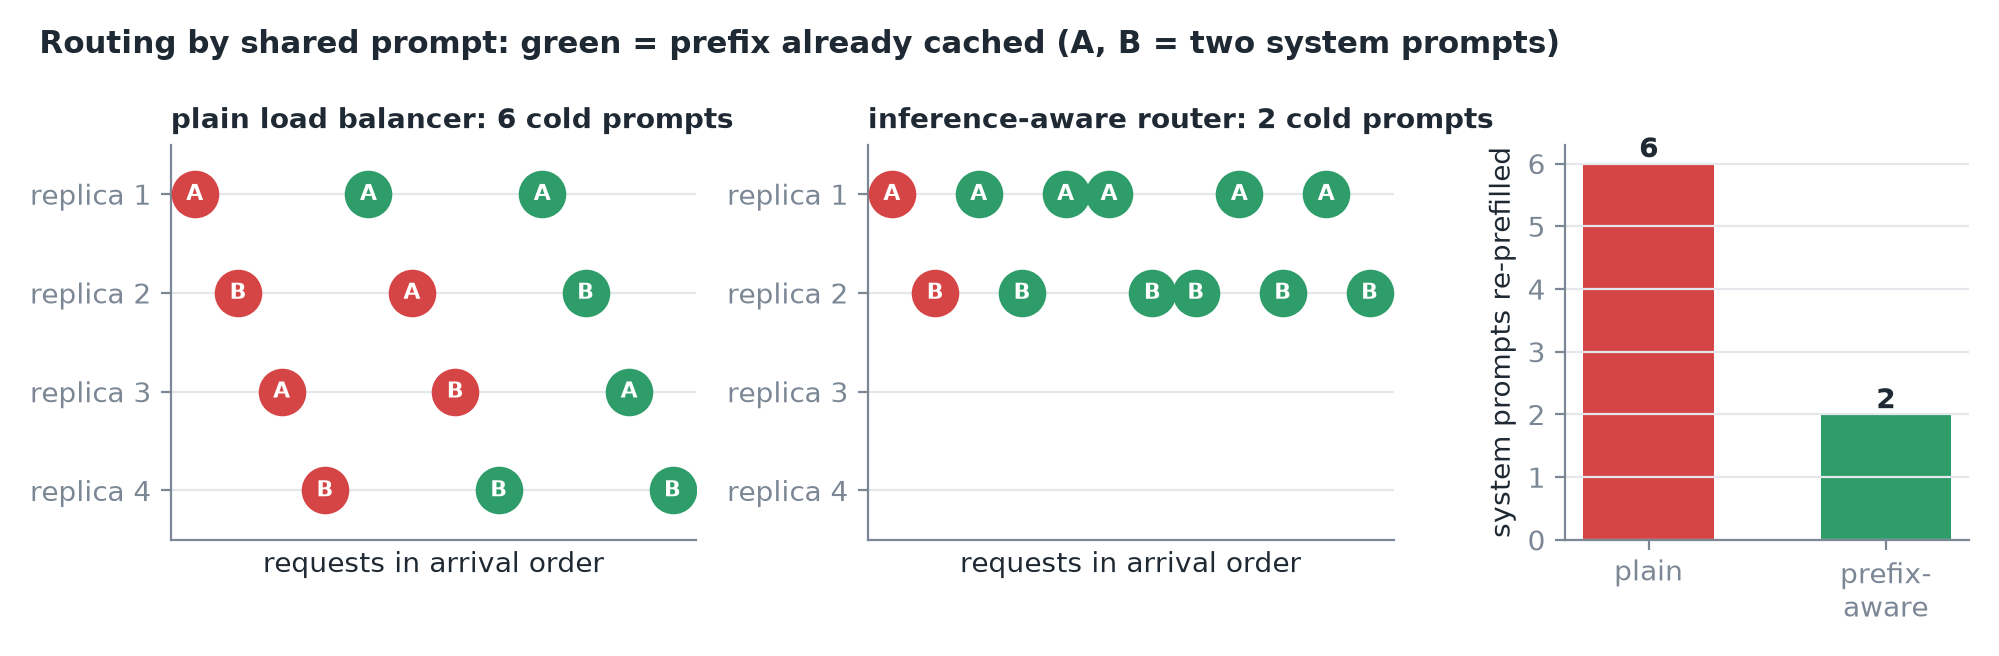 Cùng 12 request, hai system prompt dùng chung: định tuyến theo prefix tránh phải prefill lại những prompt đã có trong cache.
- Autoscaler: thêm hoặc bớt replica. Nó theo dõi độ dài hàng đợi và mức dùng KV cache, không phải tải CPU, vì CPU gần như rảnh. Scale up chậm: phải nạp xong 16 GB trọng số thì replica mới phục vụ được ai.
- Metric và tracing ở mọi tầng cho biết tầng nào đang có vấn đề.
- Engine tối ưu một replica; tầng fleet là mọi thứ giữa các replica.
6. Một request, đi xuống rồi đi lên
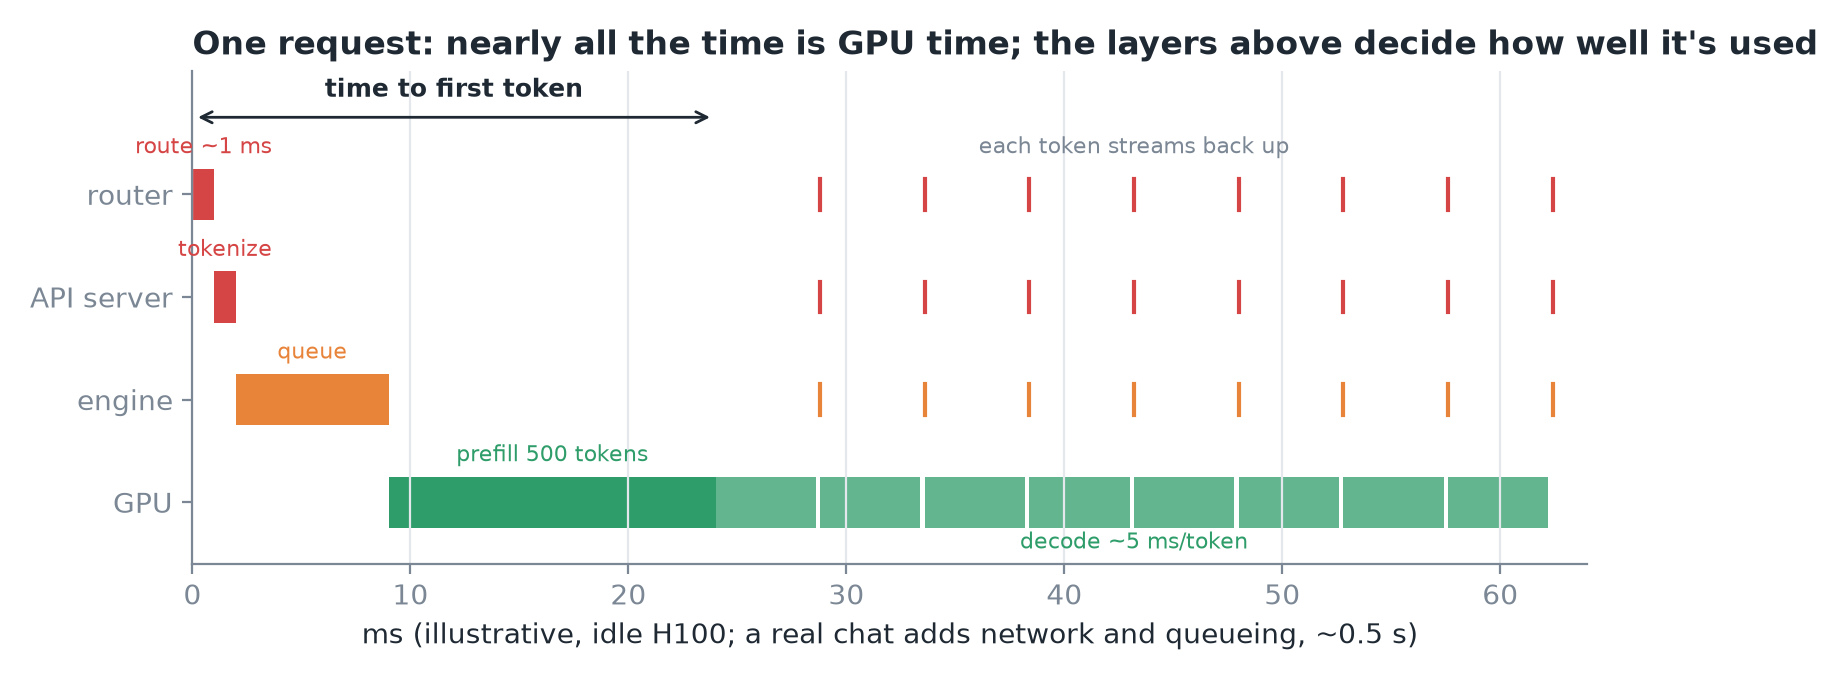 Định tuyến (~1 ms), tokenize, xếp hàng, prefill, rồi decode ~5 ms mỗi token, từng token được stream ngược lên qua stack.
- Router chọn replica trong khoảng 1 ms.
- API server biến văn bản thành ~500 token ID.
- Scheduler đưa request vào hàng đợi; tới bước kế tiếp thì nó vào batch.
- Prefill: cả 500 token prompt đi qua model cùng lúc, lấp đầy KV cache; token đầu tiên xuất hiện (time to first token).
- Decode: mỗi bước một token, ~5 ms mỗi token, từng token leo ngược qua engine, server và router lên màn hình.
Quan trọng
Gần như toàn bộ thời gian nằm trên GPU, nhưng các tầng phía trên quyết định thời gian GPU đó được dùng hiệu quả tới đâu.
7. Tóm tắt