04 · Toán cho bộ nhớ, throughput và speedup
Nguồn: fanout.sh / inference-eng / 00-01 · ~8 phút
Ghi chú
Gần như mọi con số trong inference là một lượng (16 GB), một tốc độ (3,35 TB/s) hoặc một tỷ số (1,25×). Cẩn thận với đơn vị và nắm một đẳng thức, thời gian = lượng ÷ tốc độ, là bạn trả lời được ba câu hỏi trước khi chạm vào phần cứng: model có vừa không, nhanh nhất có thể chạy tới đâu, và một speedup được quảng cáo thực sự đáng bao nhiêu.
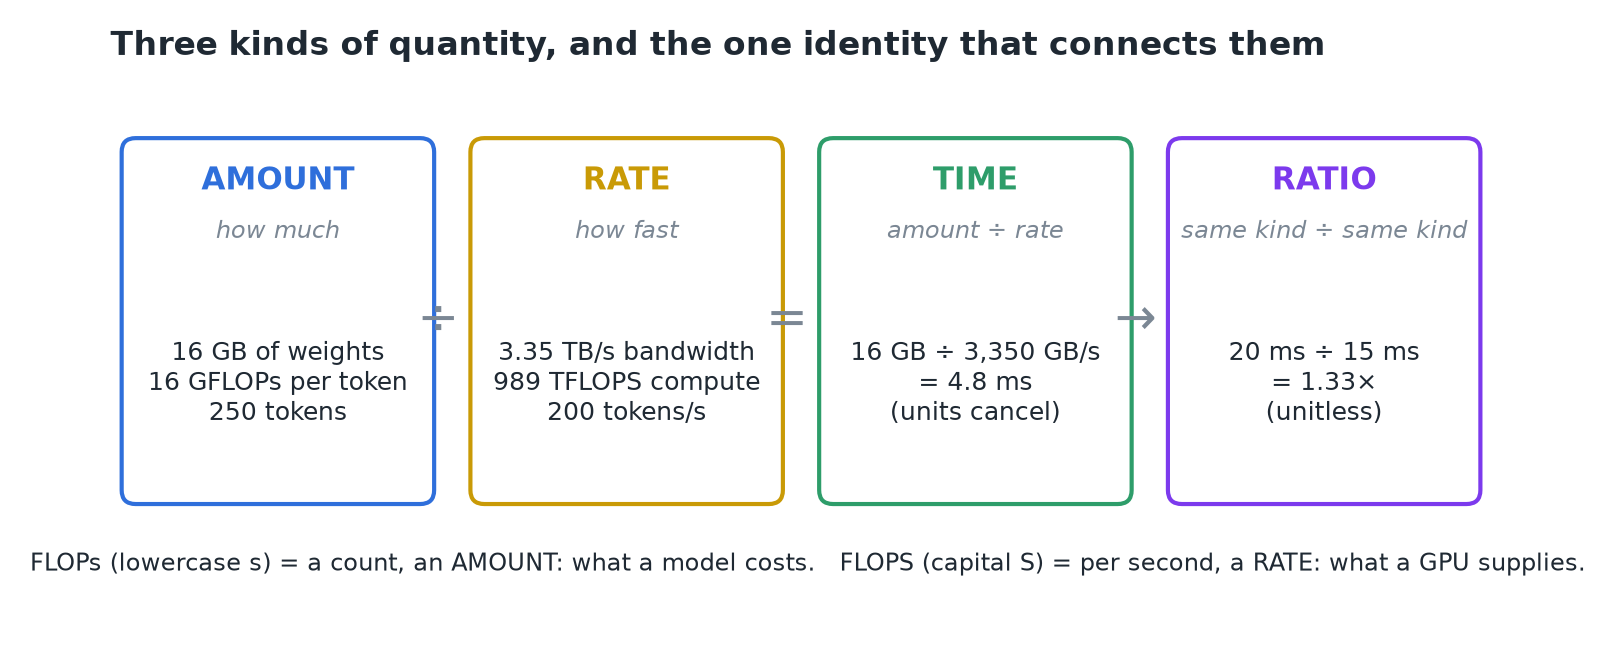 Lượng chia tốc độ ra thời gian; thời gian chia thời gian ra tỷ số không đơn vị.
1. Lượng: có vừa không?
- Mỗi tham số được lưu ở một độ chính xác (precision) nào đó: FP32 = 4 byte, BF16 = 2, FP8 = 1, INT4 = 0,5.
- Bộ nhớ trọng số = số tham số × số byte mỗi tham số. Llama 3.1 8B có 8,03 tỷ tham số:
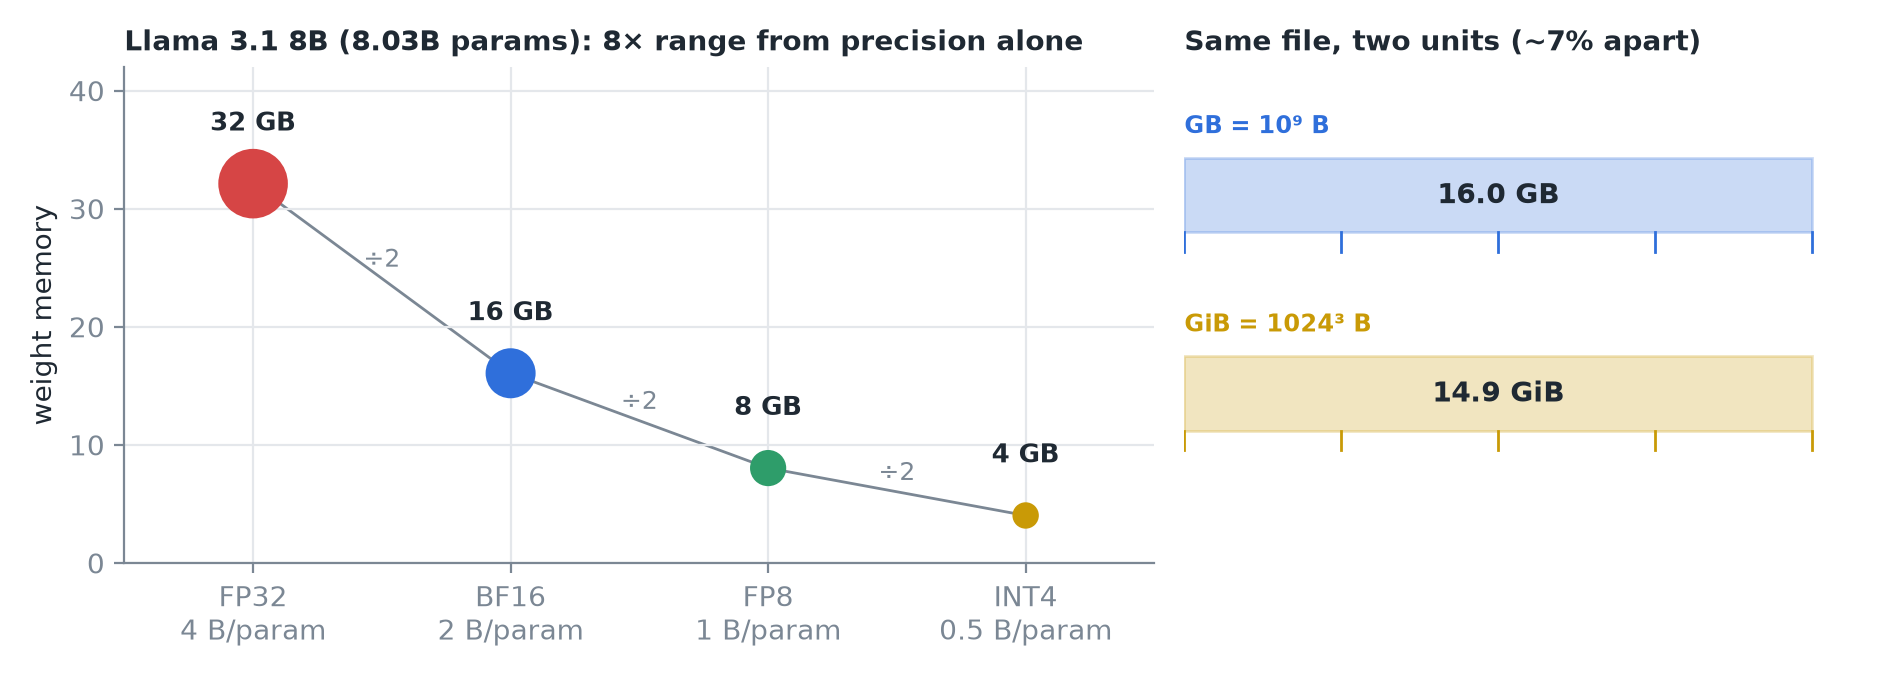 Trái: mỗi lần giảm một nửa độ chính xác là bộ nhớ giảm một nửa, tổng cộng chênh nhau 8 lần. Phải: một file 16 GB hiển thị là 14,9 GiB.
Cảnh báo
GB và GiB: một GB là 10⁹ byte; một GiB là 1024³, lớn hơn khoảng 7%. Một file 16 GB hiển thị là 14,9 GiB. Kiểm tra đơn vị trước khi nghi ngờ phép tính.
2. Tốc độ: nhanh nhất có thể chạy tới đâu?
Ba tốc độ làm phần lớn công việc: băng thông bộ nhớ (byte/s), khả năng tính toán (FLOPS) và tốc độ sinh (token/s).
- FLOPs (s thường) là một số đếm: lượng mà một model tiêu tốn. FLOPS (S hoa) là trên mỗi giây: tốc độ mà một GPU cung cấp.
- Sinh một token đọc toàn bộ 16 GB trọng số; một H100 chuyển được 3.350 GB/s. Đưa cả hai về GB thì GB triệt tiêu:
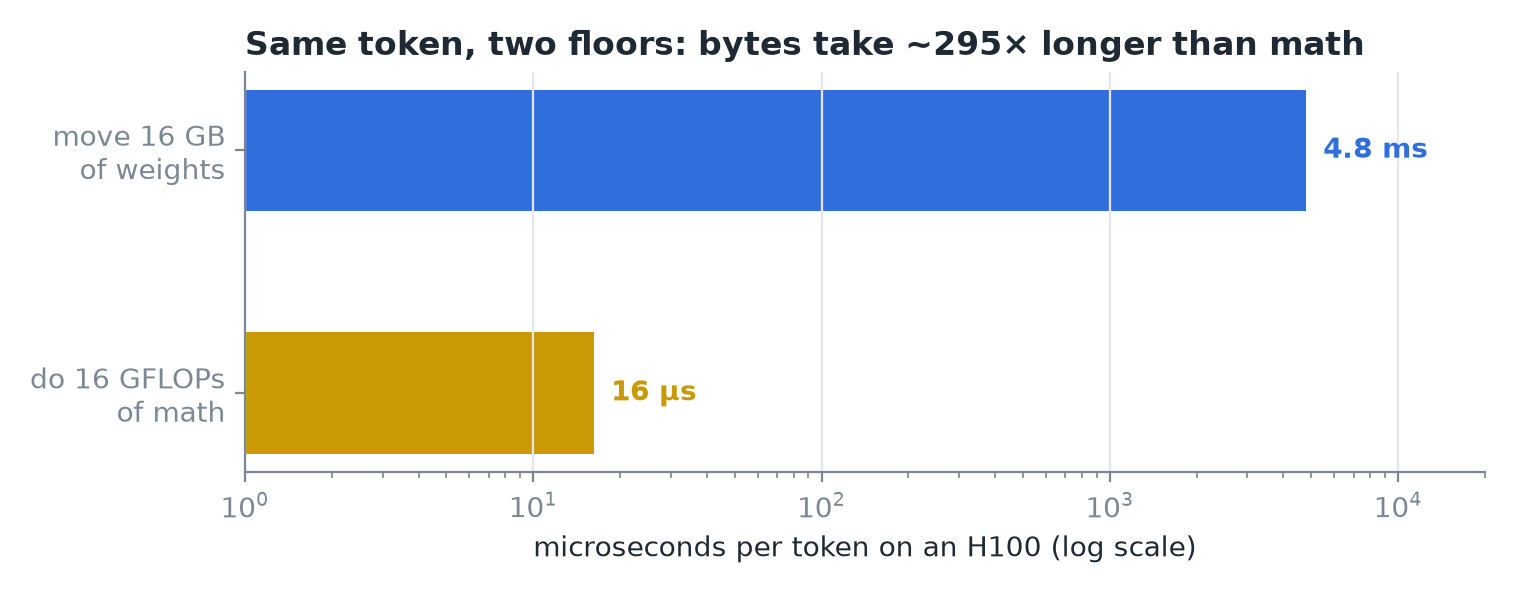 Chuyển byte lâu hơn làm phép tính ~300 lần. Sự mất cân bằng đó là thứ cả lĩnh vực xoay quanh.
Là mức sàn, không phải dự đoán
Số trong datasheet là đỉnh mà hệ thống thật không bao giờ duy trì được, nên các thời gian này là mức sàn.
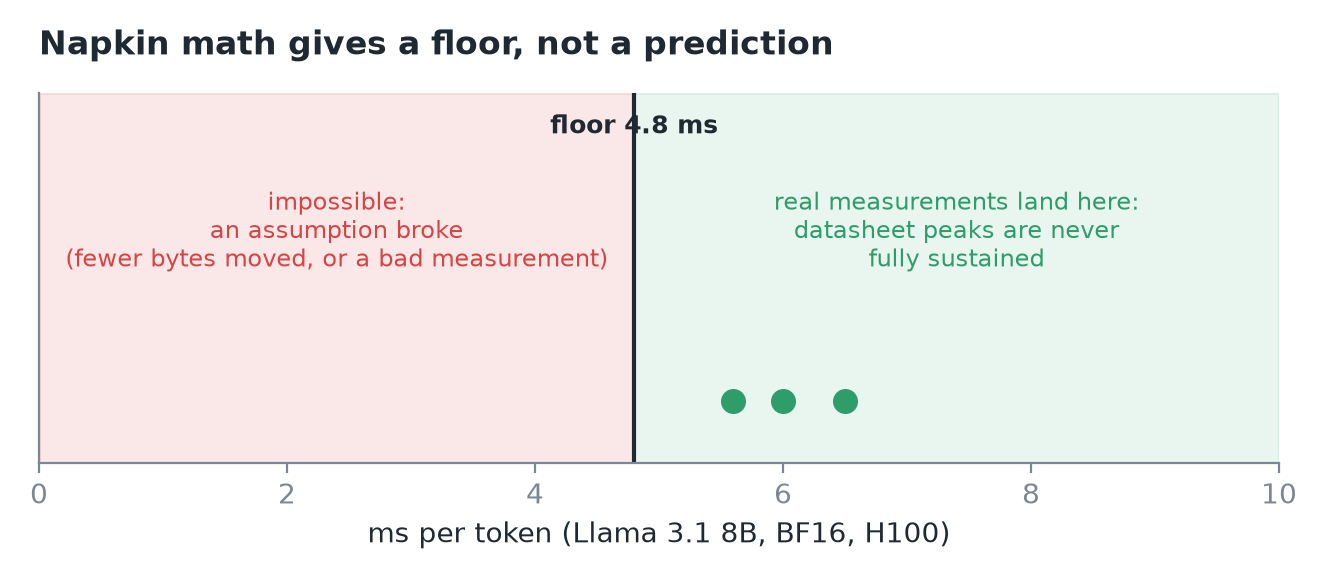 Số đo thật nằm trên mức sàn. Nằm dưới nghĩa là có một giả định bị sai.
Phóng to lên: 70B trên một H100 80 GB
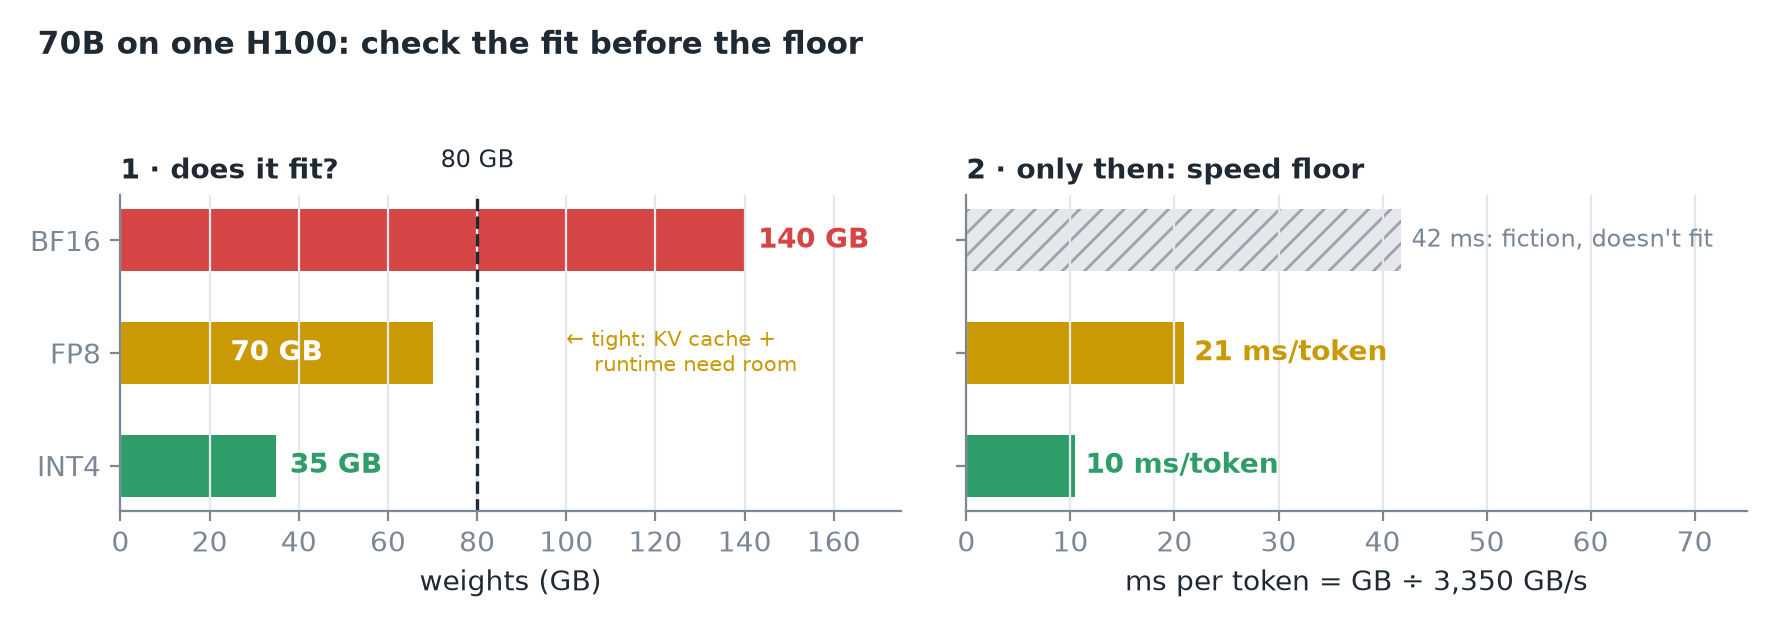 BF16 không vừa, nên mức sàn của nó vô nghĩa. FP8 vừa sát ở ~21 ms/token; INT4 vừa ở ~10 ms/token.
Quan trọng
"Vừa" nghĩa là trọng số vừa; model đang chạy còn cần trạng thái riêng cho từng request ngày càng lớn (KV cache) và chi phí runtime, nên FP8 là sát chứ không thoải mái. Và kiểm tra độ vừa trước mức sàn: mức sàn tốc độ của một model không vừa chỉ là chuyện hư cấu.
3. Latency so với throughput
| Latency | Throughput | |
|---|---|---|
| Đơn vị | Thời gian mỗi sự kiện (ms/token) | Số sự kiện mỗi giây (token/s) |
| Tốt hơn khi | Nhỏ hơn | Lớn hơn |
| Một luồng | 5 ms/token | = 200 token/s (nghịch đảo của nhau) |
Khi các request dùng chung phần cứng, hai đại lượng này tách rời nhau: batching có thể nâng tổng token/s lên một bậc độ lớn trong khi từng luồng không nhanh hơn, mà còn chậm đi một chút khi tải cao.
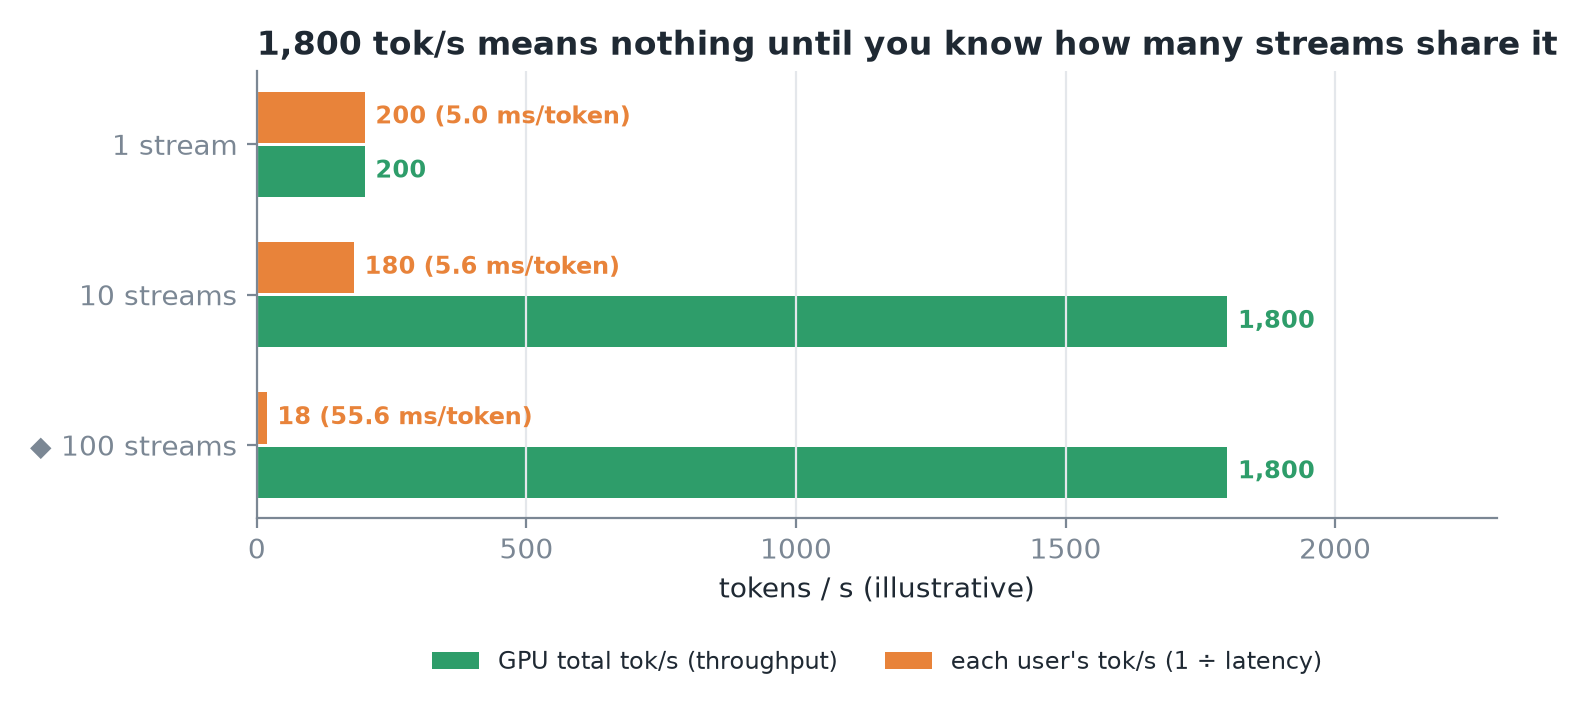 Cùng 1.800 tok/s có thể là 180 tok/s mỗi người dùng hoặc 18; con số tổng không nói lên gì nếu thiếu số luồng.
4. Speedup
Speedup là tỷ số giữa hai thời gian: trước ÷ sau. 20 ms → 15 ms là 1,33×.
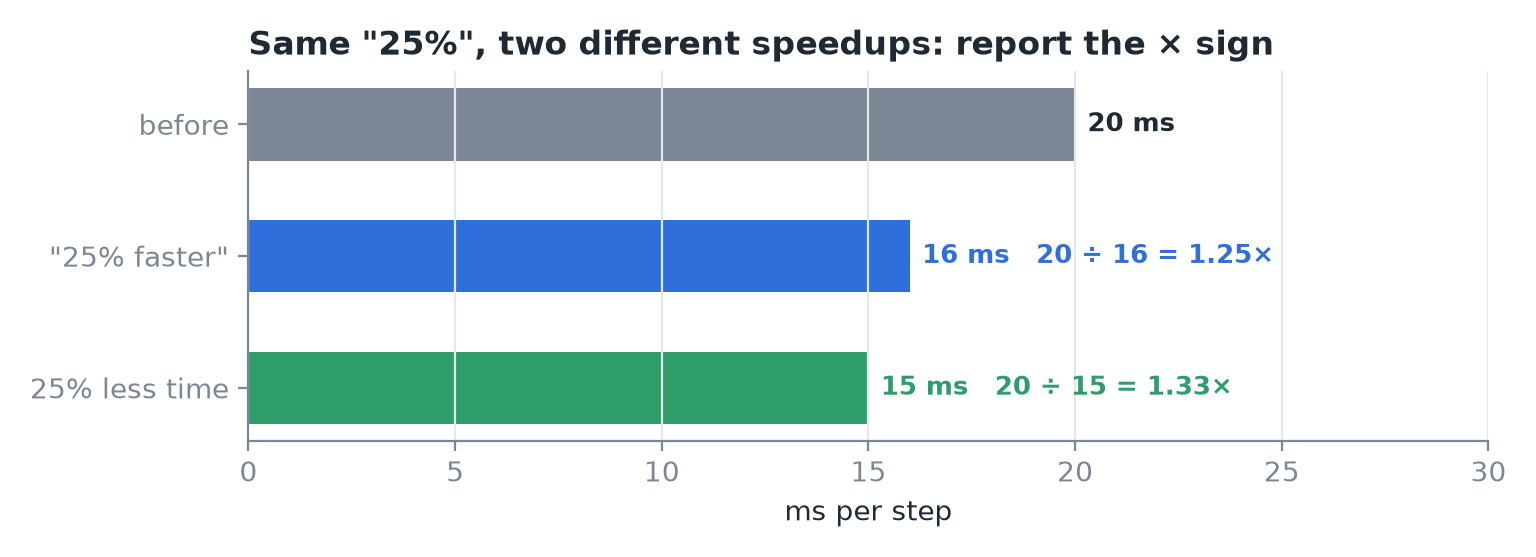 "Nhanh hơn 25%" thường nghĩa là 1,25×, nhưng "ít thời gian hơn 25%" là 1,33×. Hãy báo bằng dấu ×; khi gặp phần trăm thì hỏi đó là loại nào.
Các speedup kết hợp theo cách cộng dồn thời gian, không phải cộng phần trăm. Nếu một phép toán chiếm 30% một bước và nhanh lên 3 lần, 30 thành 10 và bước đó còn 80% thời gian cũ: tổng cộng chỉ 1,25×. Tổng quát (định luật Amdahl), nếu một phần p của thời gian nhanh lên s lần:
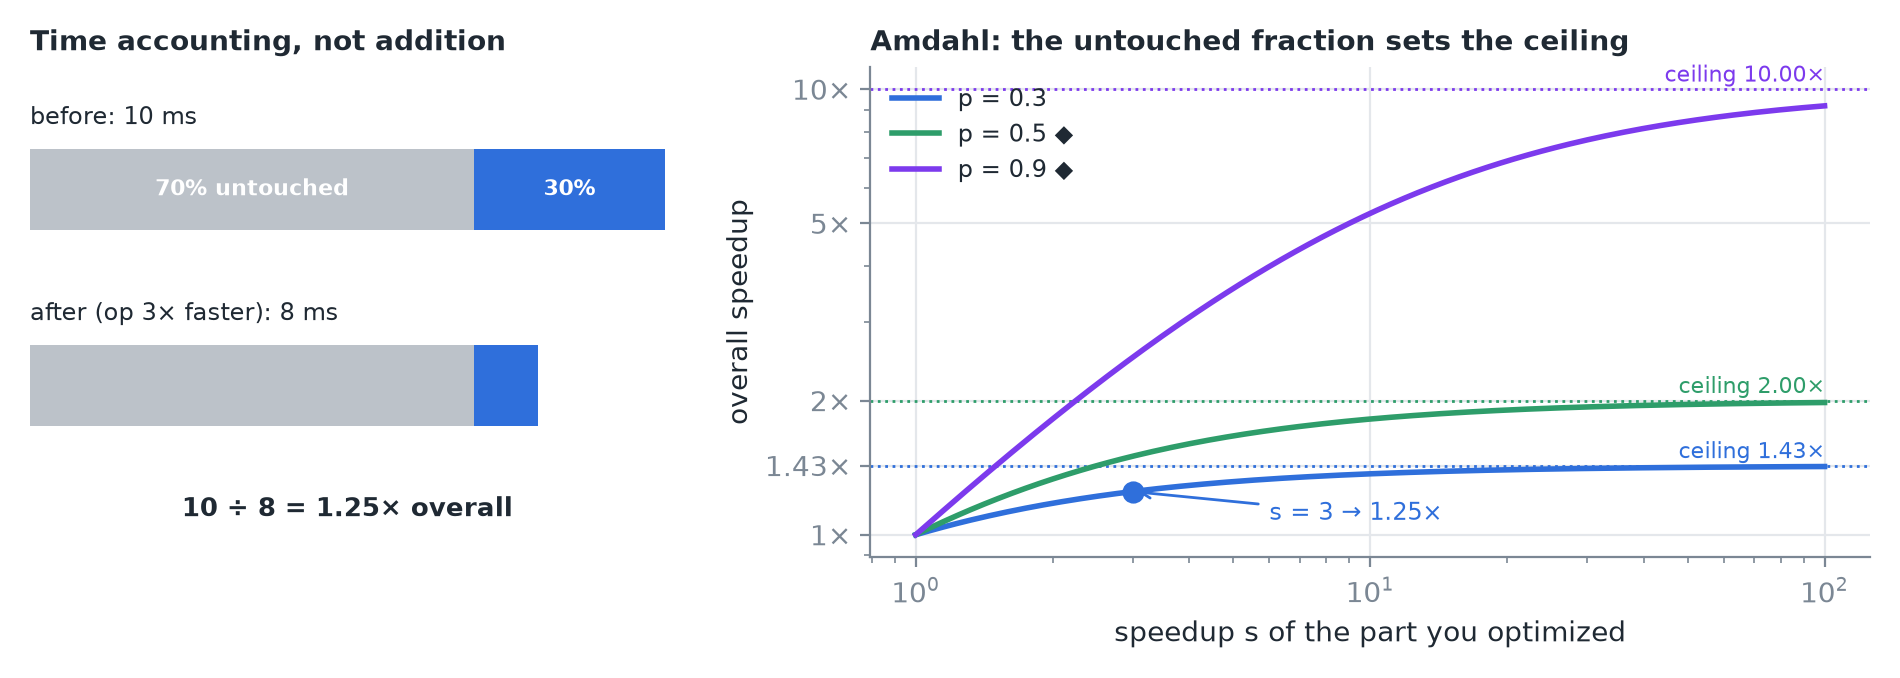 Trái: ví dụ 30%/70%. Phải: phần được tối ưu có nhanh tới đâu thì phần không đụng tới vẫn chặn trần lợi ích tổng.
Quan trọng
Trước khi đánh giá một tối ưu nào, hãy hỏi nó chạm vào bao nhiêu phần của thời gian.
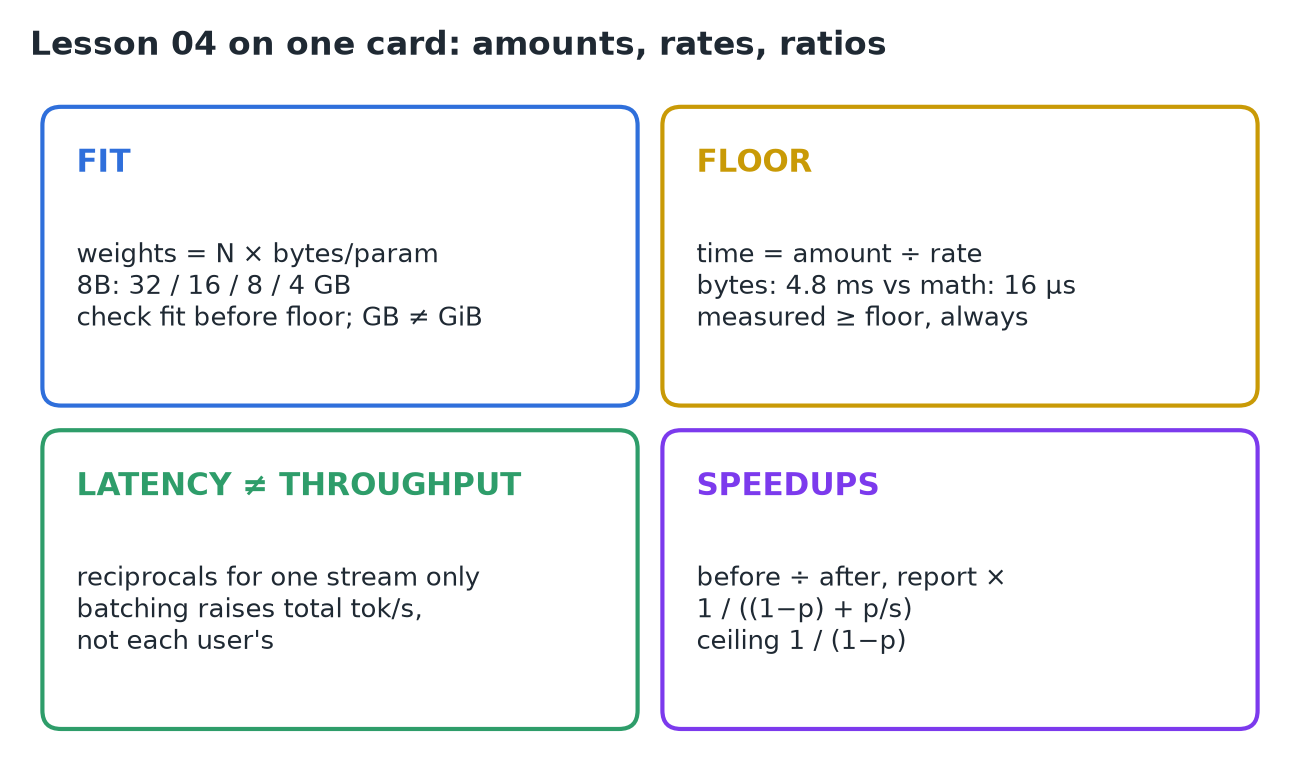
5. Tóm tắt