50 · Độ chính xác, bộ nhớ và hỗ trợ phần cứng
Nguồn: fanout.sh / inference-eng / 11-01 · ~5 phút
Ghi chú
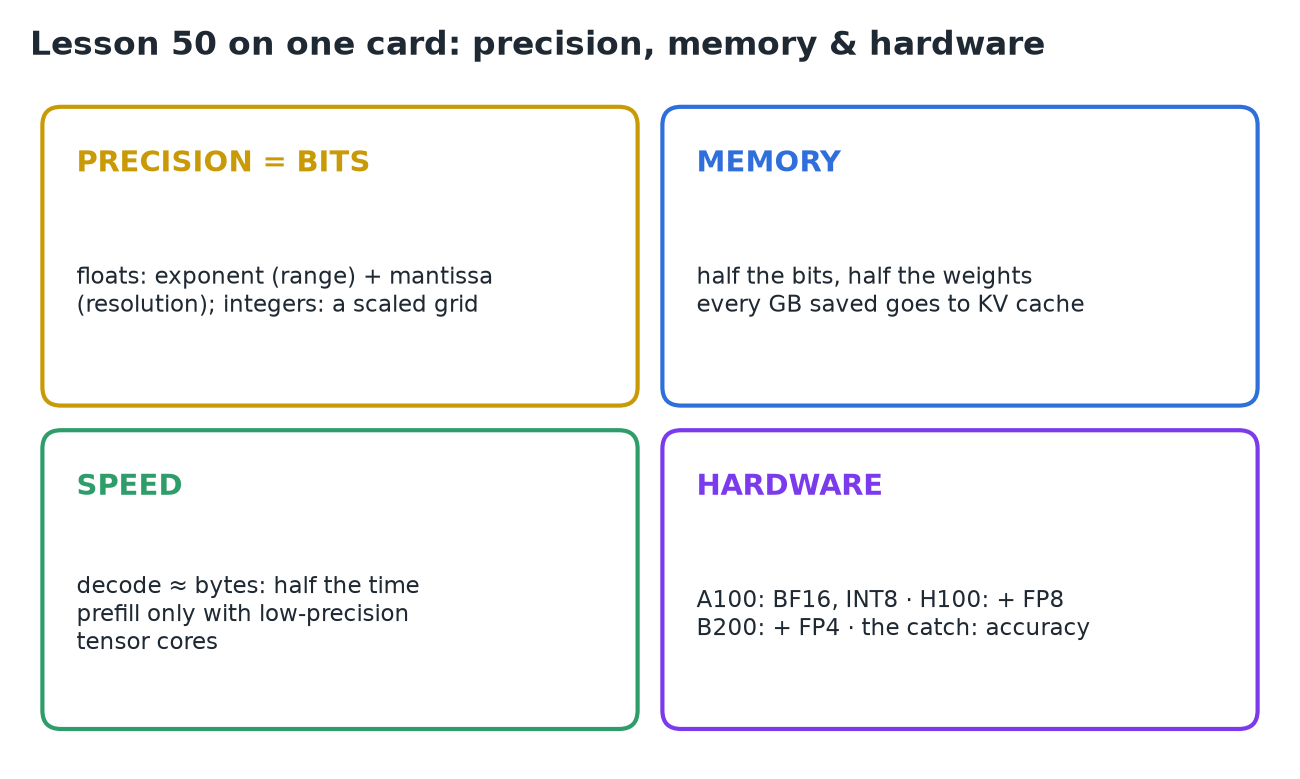
Độ chính xác là số bit cho mỗi con số: số thực dấu phẩy động chia bit thành exponent (phạm vi) và mantissa (độ phân giải); số nguyên là một lưới đều nhân với một hệ số scale. Bộ nhớ trọng số là số tham số × số byte, nên Llama 3.1 8B đi từ 16 → 8 → ~4 GB và một model 70B giảm từ hai GPU xuống một. Decode stream trọng số, nên mức sàn của nó giảm một nửa theo số bit (4,8 → 2,4 → 1,2 ms); prefill là phép tính, và chỉ nhanh lên khi tensor core tính bằng định dạng đó, điều này phụ thuộc vào thế hệ GPU. Cái giá là độ chính xác của kết quả.
1. Độ chính xác là gì
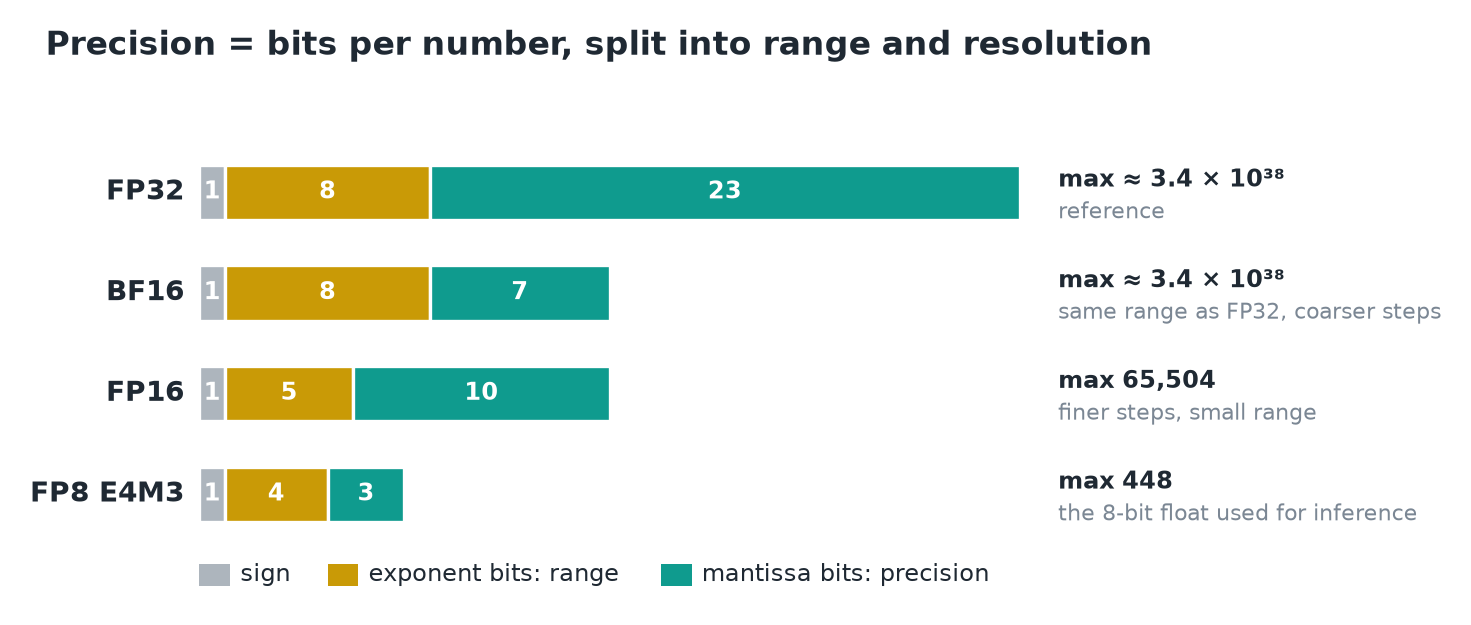 Cùng 1 bit dấu; các định dạng khác nhau ở cách chia phần còn lại.
- Bit exponent quyết định một số có thể lớn hay nhỏ tới đâu: phạm vi của nó. Bit mantissa quyết định nó được phân giải mịn tới đâu: độ chính xác của nó.
- BF16 (8 + 7): cùng phạm vi với FP32, chỉ là bước thô hơn.
- FP16 (5 + 10): mịn hơn, nhưng tối đa chỉ 65.504.
- FP8 E4M3 (4 + 3): số thực 8-bit dùng cho inference; giá trị lớn nhất 448.
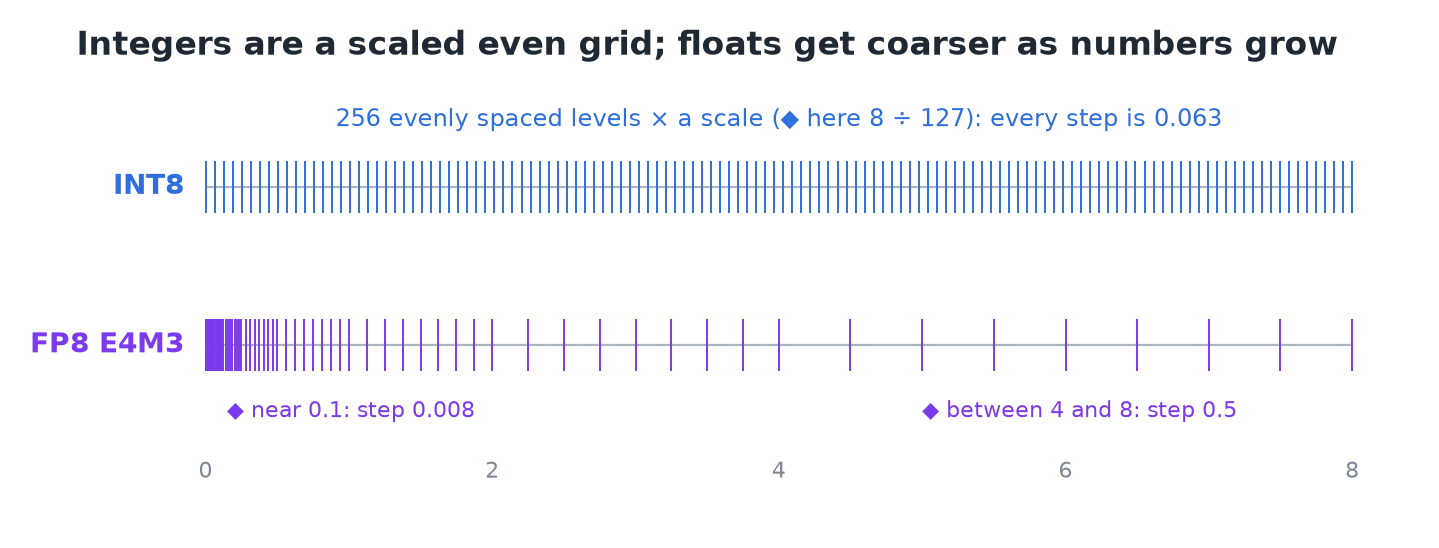 ◆ Các giá trị E4M3 thật trong khoảng 0 tới 8, so với INT8 được scale để mức lớn nhất là 8.
- INT8 chỉ là 256 mức cách đều nhau, cộng một hệ số scale kéo giãn chúng phủ lên những con số bạn thực sự có.
- ◆ Số thực dấu phẩy động có hình dạng ngược lại: mịn gần 0 và thô với giá trị lớn (bước của E4M3 là 0,008 gần 0,1, nhưng là 0,5 trong khoảng 4 tới 8).
2. Bộ nhớ
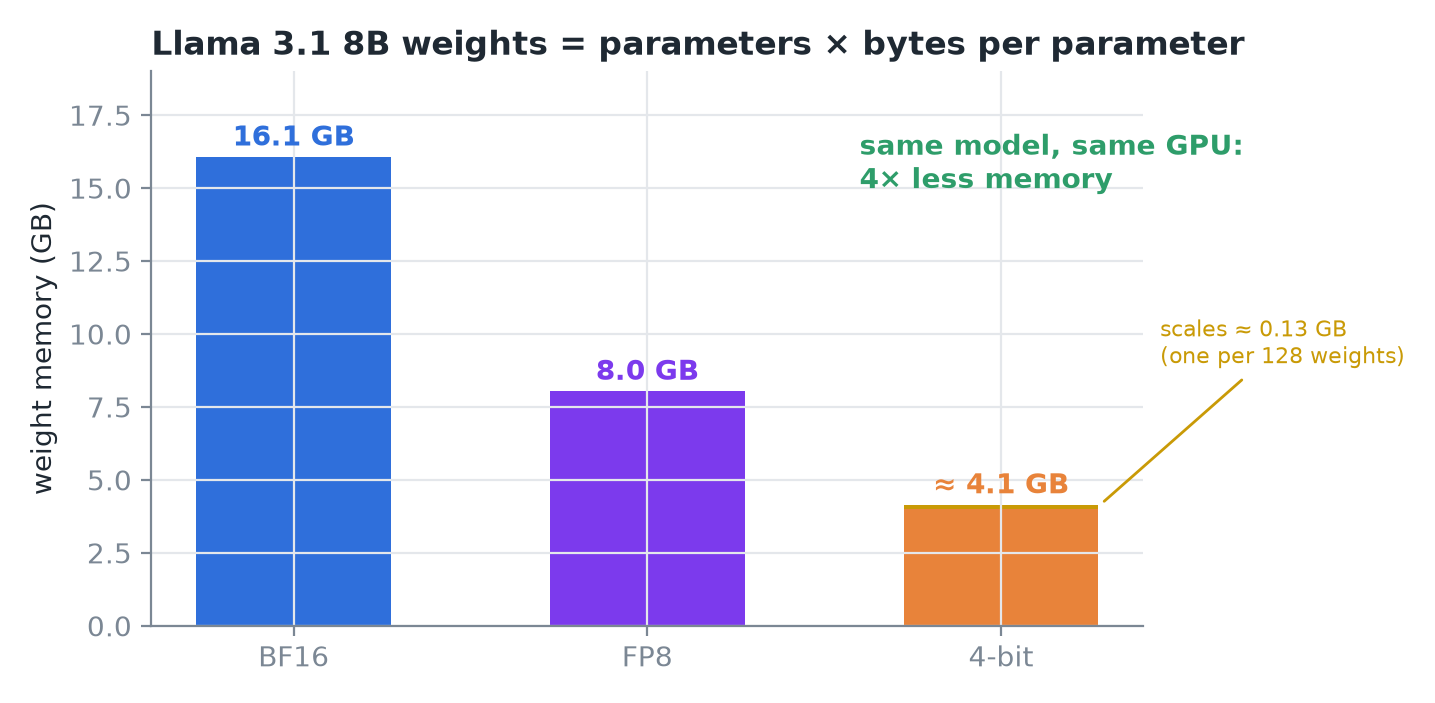 ◆ Overhead của scale giả định một scale 16-bit cho mỗi 128 trọng số.
- Llama 3.1 8B: 16,1 GB ở BF16, 8,0 GB ở FP8, ≈ 4,1 GB ở 4 bit khi tính cả hệ số scale.
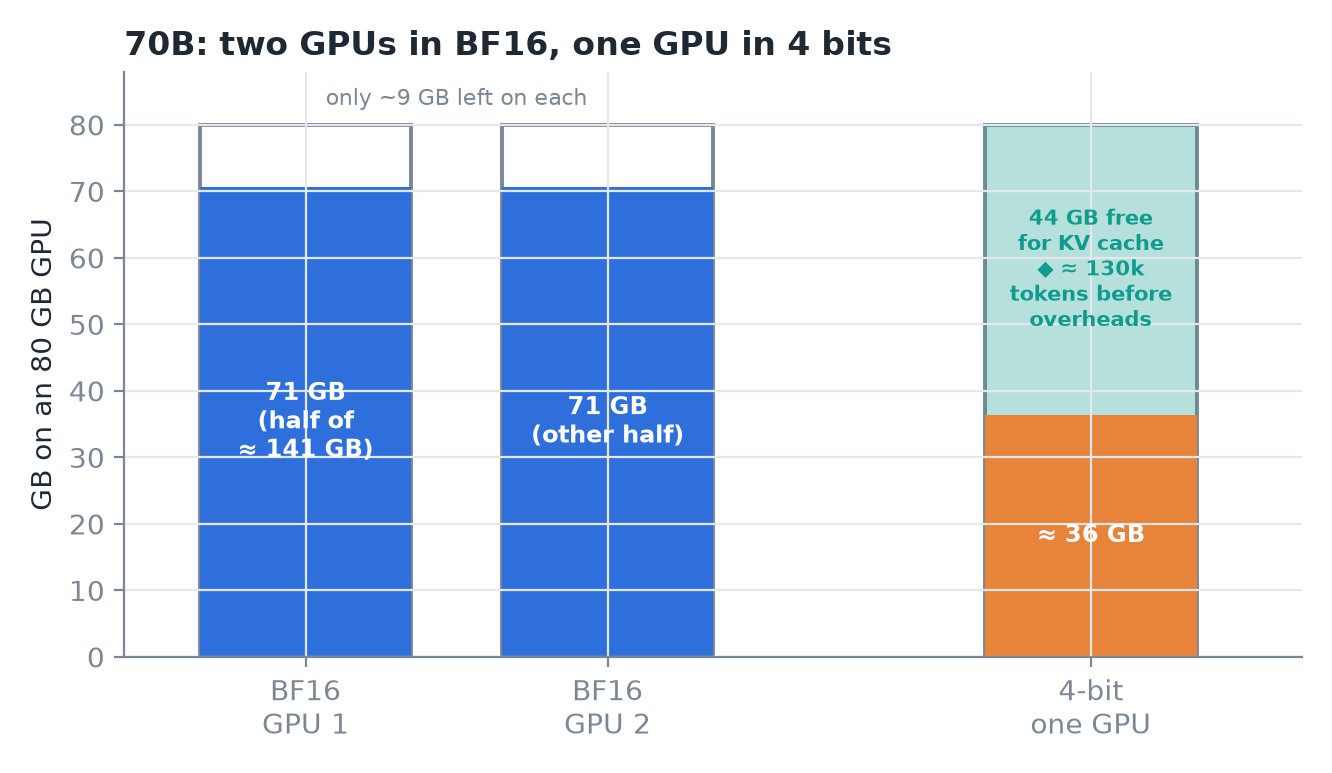 ◆ Cách chia đều và số token là phép tính của tôi, với 320 KiB KV mỗi token cho Llama 3 70B.
- Hiệu ứng lớn hơn với model lớn: 70B cần ≈ 141 GB ở BF16, nên hai GPU 80 GB. Ở 4 bit thì ≈ 36 GB và vừa một GPU, còn dư chỗ cho KV cache.
- Mỗi gigabyte tiết kiệm từ trọng số đều chuyển sang KV cache, nghĩa là nhiều request chạy cùng lúc hơn.
3. Tốc độ
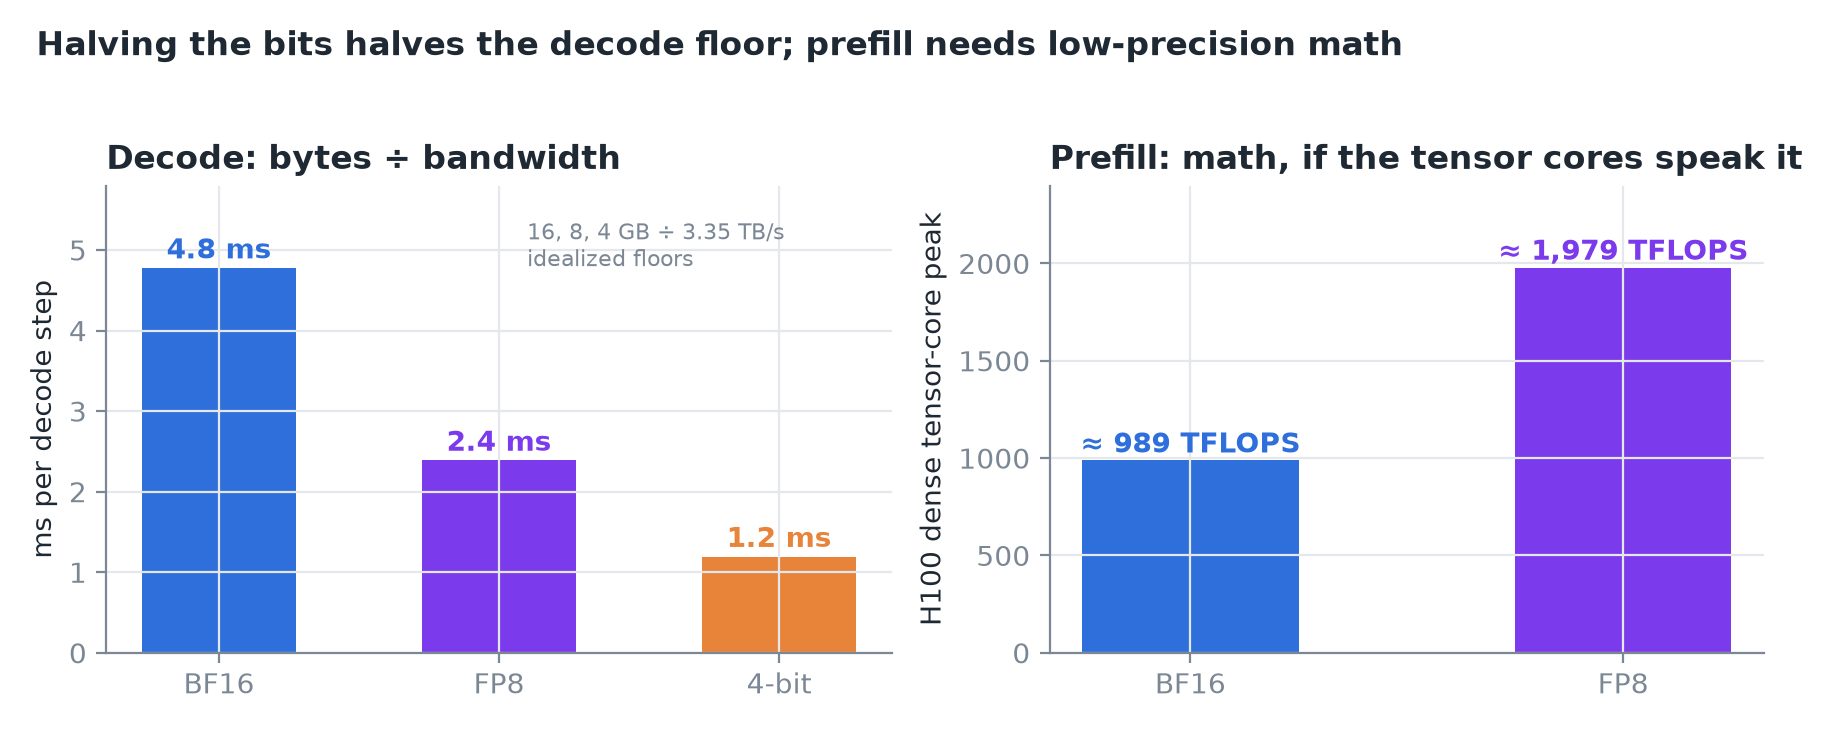 Mức sàn decode từ số byte ÷ băng thông; prefill từ đỉnh tensor core dense của H100.
- Decode bị giới hạn bởi băng thông bộ nhớ: mỗi bước stream toàn bộ trọng số, nên thời gian bước gần như đi theo số byte. Mức sàn lý tưởng hoá, nhưng chiều hướng là thật.
- Prefill bị giới hạn bởi phép tính. Riêng trọng số nhỏ hơn không làm phép tính nhanh hơn: prefill chỉ nhanh lên nếu tensor core nhân ở độ chính xác thấp hơn.
- Trên H100, phép tính FP8 chạy nhanh khoảng 2 lần BF16: ≈ 1.979 so với 989 TFLOPS dense.
4. GPU nào tính được định dạng nào
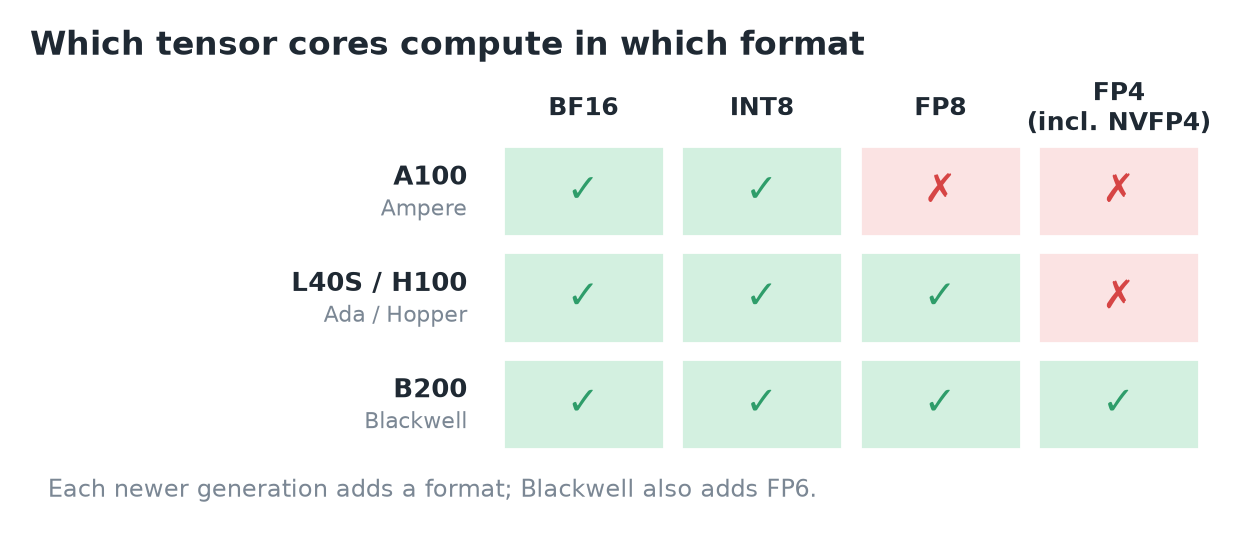 Hỗ trợ của tensor core theo thế hệ, như liệt kê trong bài.
- A100 (Ampere): BF16 và INT8, không có FP8.
- L40S (Ada) và H100 (Hopper): thêm FP8.
- B200 (Blackwell): thêm số thực 6-bit và 4-bit, bao gồm NVFP4 của NVIDIA.
5. Hai cách dùng độ chính xác thấp
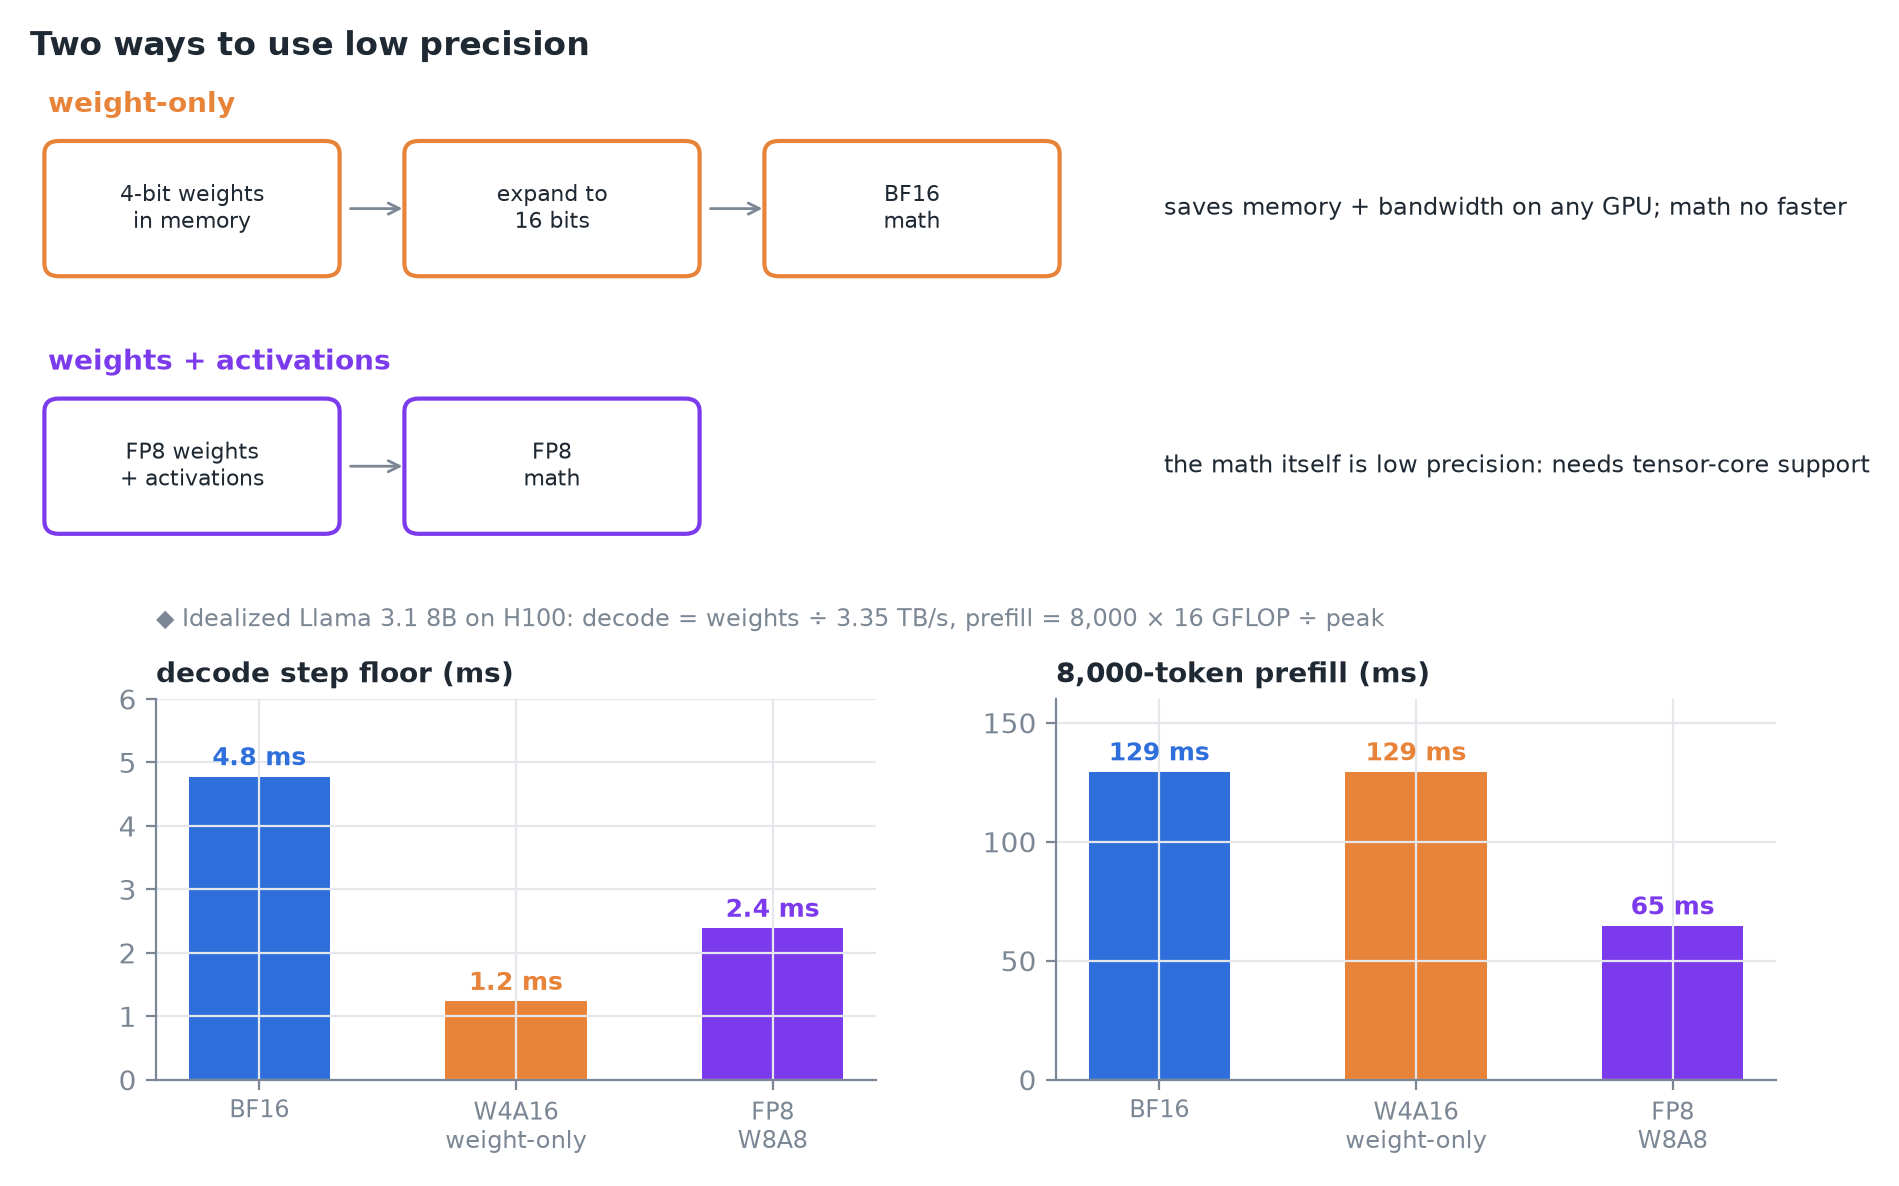 ◆ Các thanh là một mô hình lý tưởng hoá; kernel weight-only thật còn phải trả giá cho việc nở trọng số ra.
| Chỉ trọng số (weight-only) | Trọng số + activation | |
|---|---|---|
| Điều gì xảy ra | lưu nhỏ, nở ra 16 bit ngay trước phép tính | bản thân phép tính chạy ở độ chính xác thấp |
| Tiết kiệm | bộ nhớ và băng thông | bộ nhớ, băng thông và phép tính |
| Chạy trên | mọi GPU | chỉ nơi tensor core hỗ trợ định dạng đó |
| Tăng tốc | decode | decode và prefill |
Mẹo
◆ Weight-only giúp nhiều nhất khi decode bị giới hạn bởi việc đọc trọng số. Ở batch lớn, decode gần với giới hạn tính toán hơn, và việc nở trọng số thêm việc, nên lợi ích weight-only co lại.
6. Tóm tắt