39 · PagedAttention
Nguồn: fanout.sh / inference-eng / 08-03 · ~4,5 phút
Ghi chú
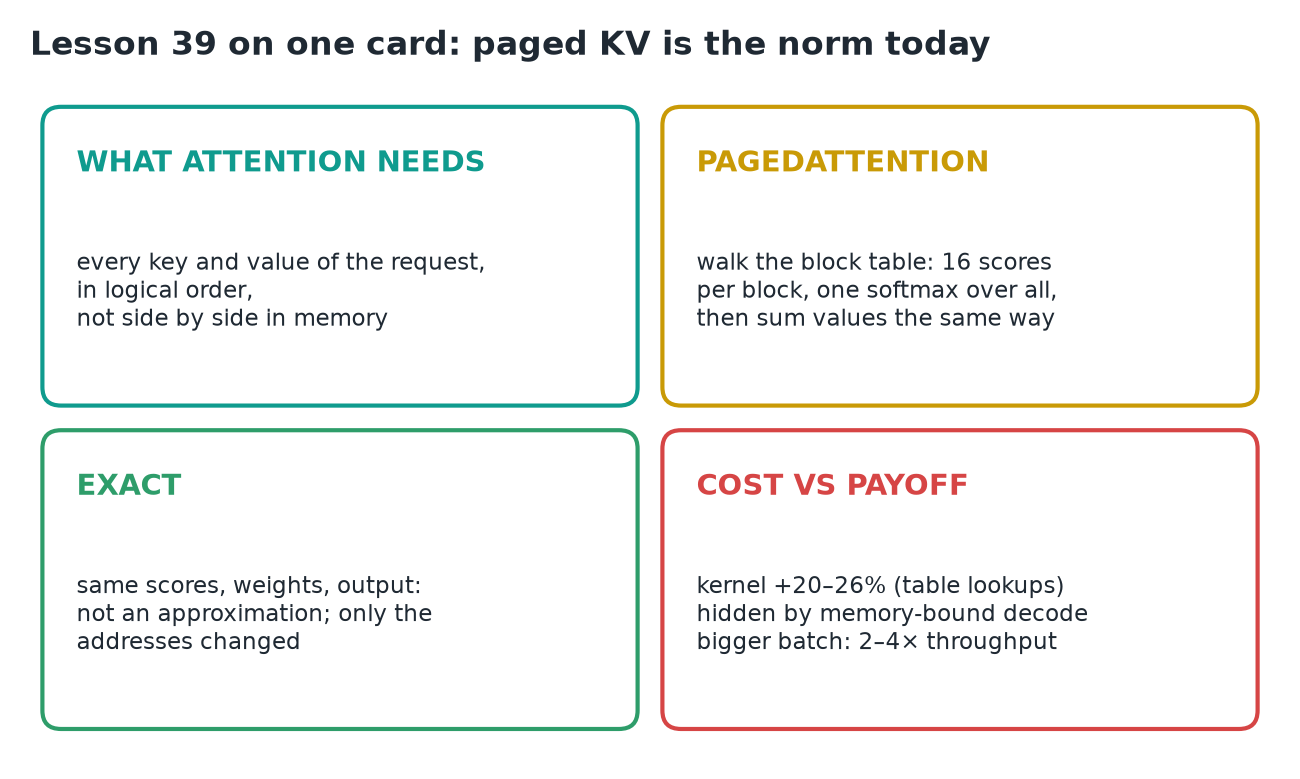
Attention là layer duy nhất đọc KV cache, và các kernel kinh điển muốn key và value của một request nằm cạnh nhau. Nhưng attention chỉ cần chúng theo thứ tự logic, không bao giờ cần chúng nằm sát nhau về vật lý. PagedAttention đọc chúng thẳng qua block table: tính điểm cho từng block 16 key, áp một softmax trên mọi điểm, rồi cộng các value theo từng block. Kết quả giống hệt attention thông thường, không phải xấp xỉ. Kernel chạy chậm hơn ~20–26% so với kernel liền mạch, nhưng decode bị giới hạn bởi bộ nhớ và attention chỉ là một phần của bước, trong khi lãng phí gần như bằng không giúp chứa thêm rất nhiều request: throughput 2–4 lần ở cùng latency. Ngày nay FlashAttention và FlashInfer nhận block table trực tiếp.
1. Attention cần gì
Với một token decode mới: query của nó được so với key của mọi token trước (tích vô hướng → mỗi token một điểm), một softmax biến điểm thành trọng số có tổng bằng 1, và đầu ra là tổng có trọng số của mọi vector value.
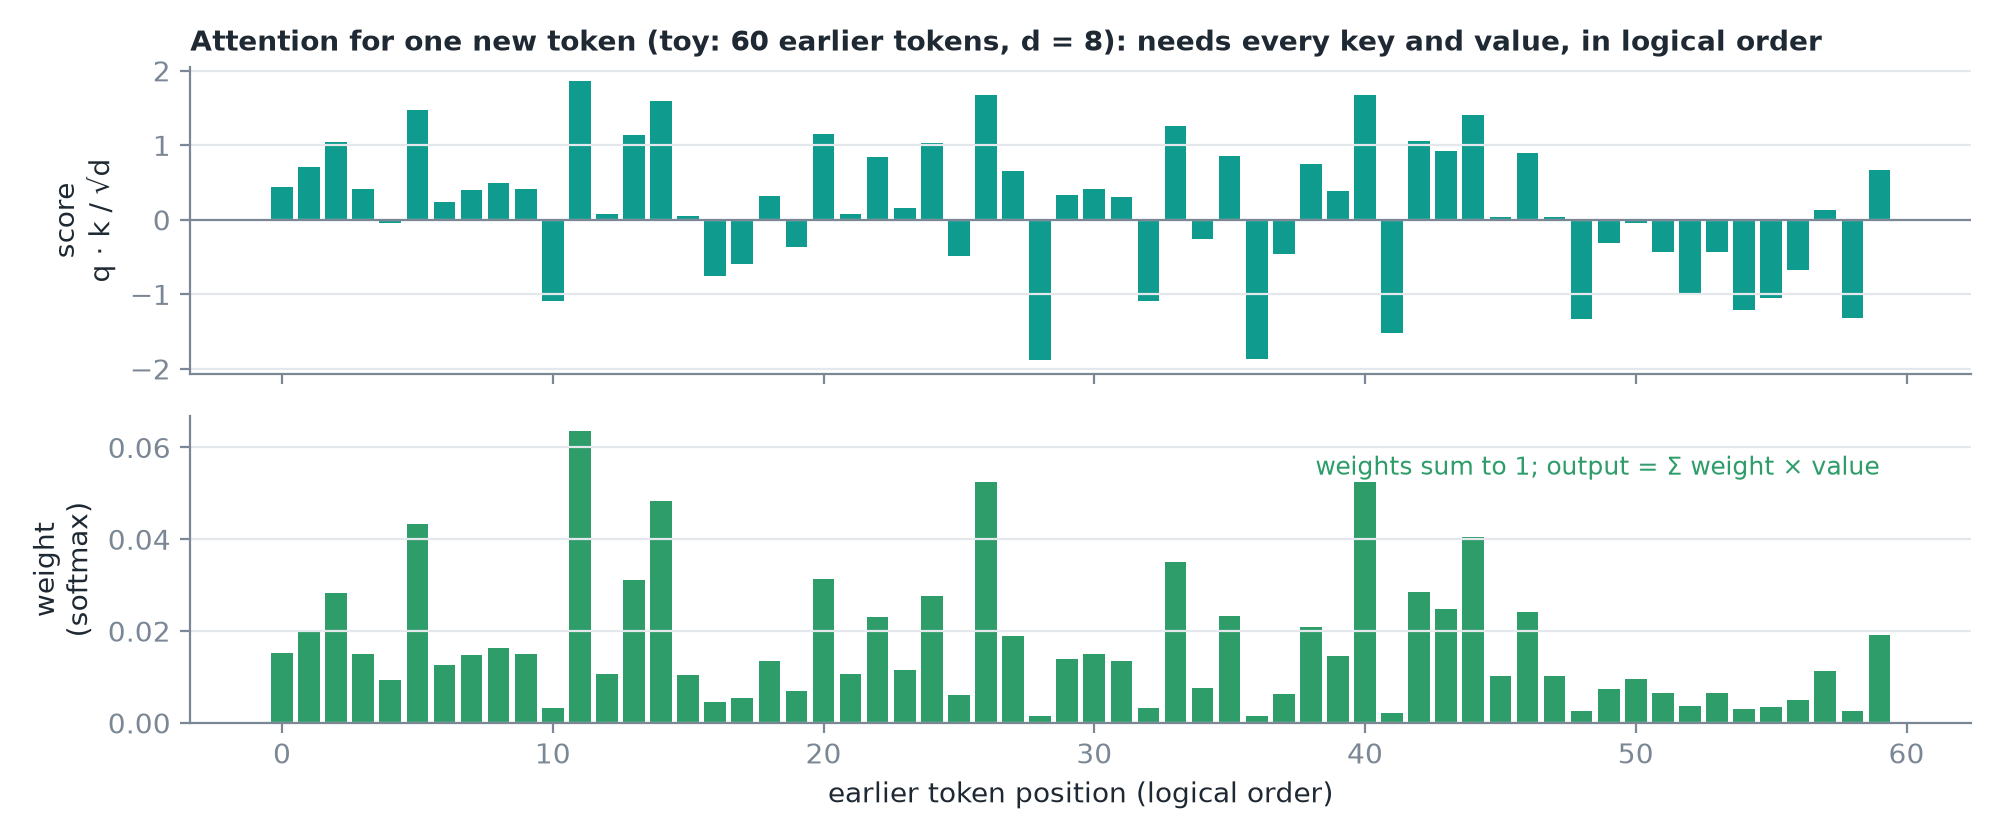 Nó cần mọi key và value của request này, từng token theo thứ tự logic. Nó không bao giờ cần chúng nằm cạnh nhau về vật lý.
2. Phiên bản phân trang
Với request 60 token có block table 7, 1, 12, 4:
- Duyệt các block logic theo thứ tự. Logic 0 → vật lý 7: nạp 16 key một lần, tính 16 điểm. Rồi vật lý 1 (thêm 16), 12, và 4 (12 token cuối).
- Có đủ 60 điểm, áp một softmax trên tất cả.
- Duyệt lại các block theo cùng cách để cộng các value có trọng số.
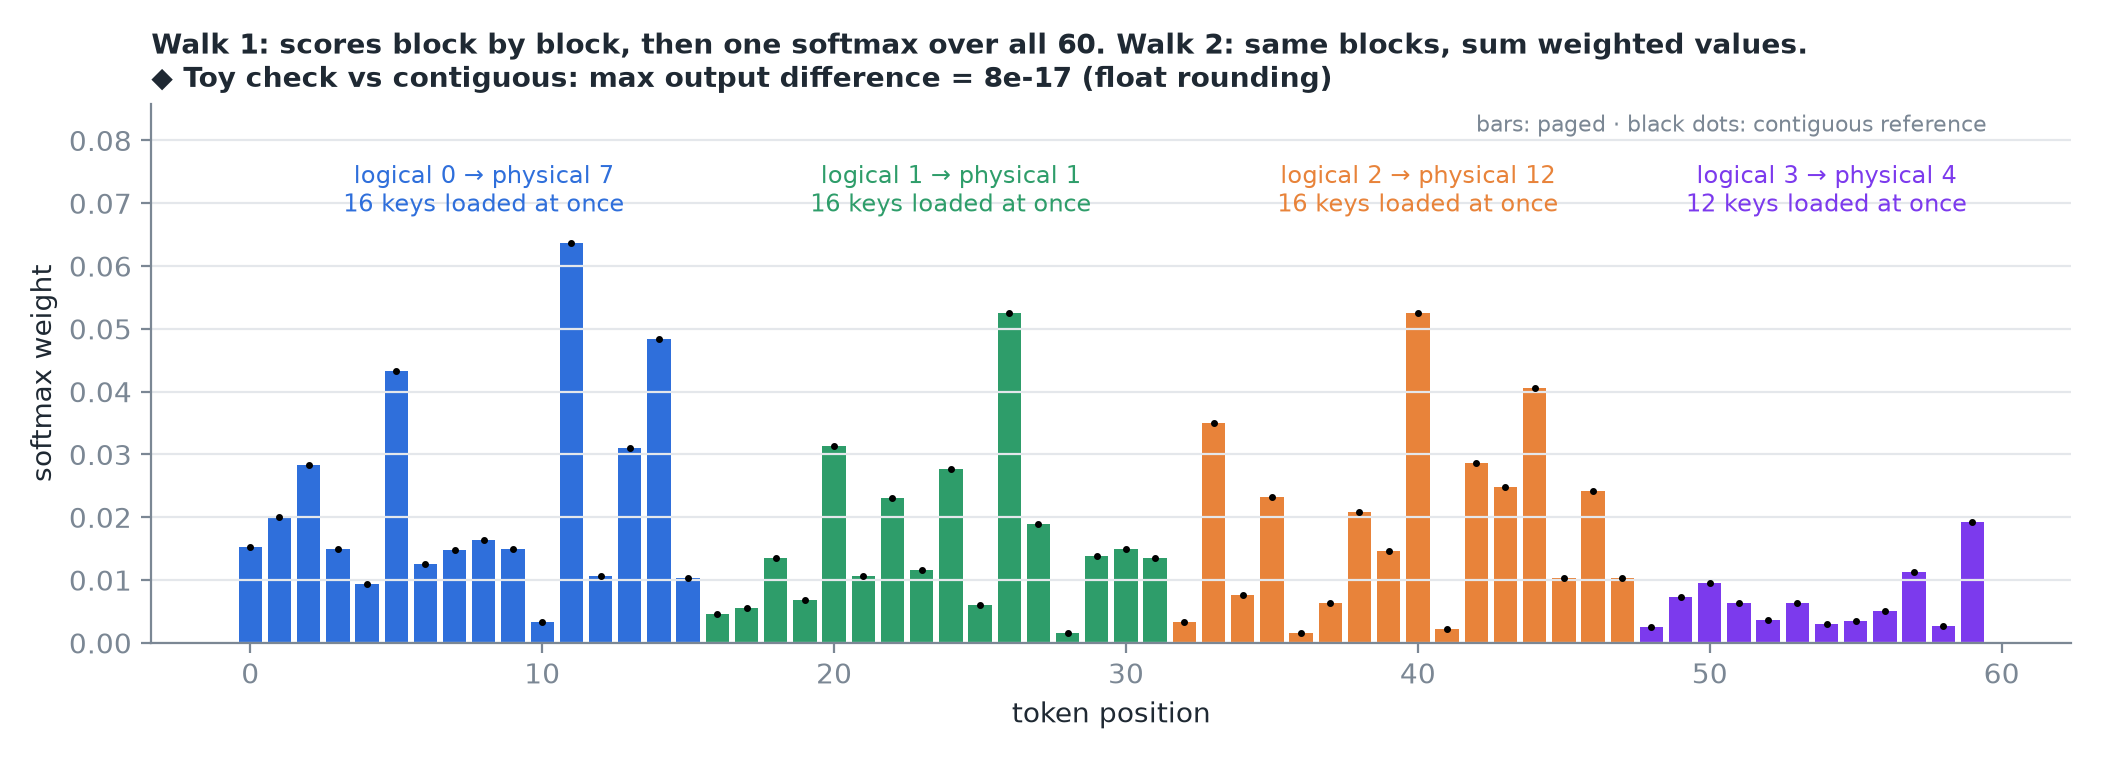 Cùng điểm, cùng trọng số, cùng đầu ra: chỉ có địa chỉ đọc là thay đổi. ◆ Bài kiểm tra đồ chơi tính cả hai phiên bản bằng numpy; chúng khớp nhau tới sai số làm tròn số thực.
Quan trọng
PagedAttention không phải xấp xỉ. Nó là attention thông thường với thêm một bước gián tiếp qua block table.
3. Trên GPU
- Mỗi (query, head) có nhóm thread riêng; bên trong, các warp khác nhau nhận các block khác nhau cùng lúc.
- Trong một block, 16 key nằm cạnh nhau, nên các thread kề nhau đọc vùng nhớ kề nhau trong một lượt quét. Bước nhảy rải rác chỉ xảy ra ở ranh giới block, 16 token một lần.
- Sau đó các warp gộp kết quả từng phần của chúng, điểm lớn nhất và tổng các luỹ thừa, thành một softmax.
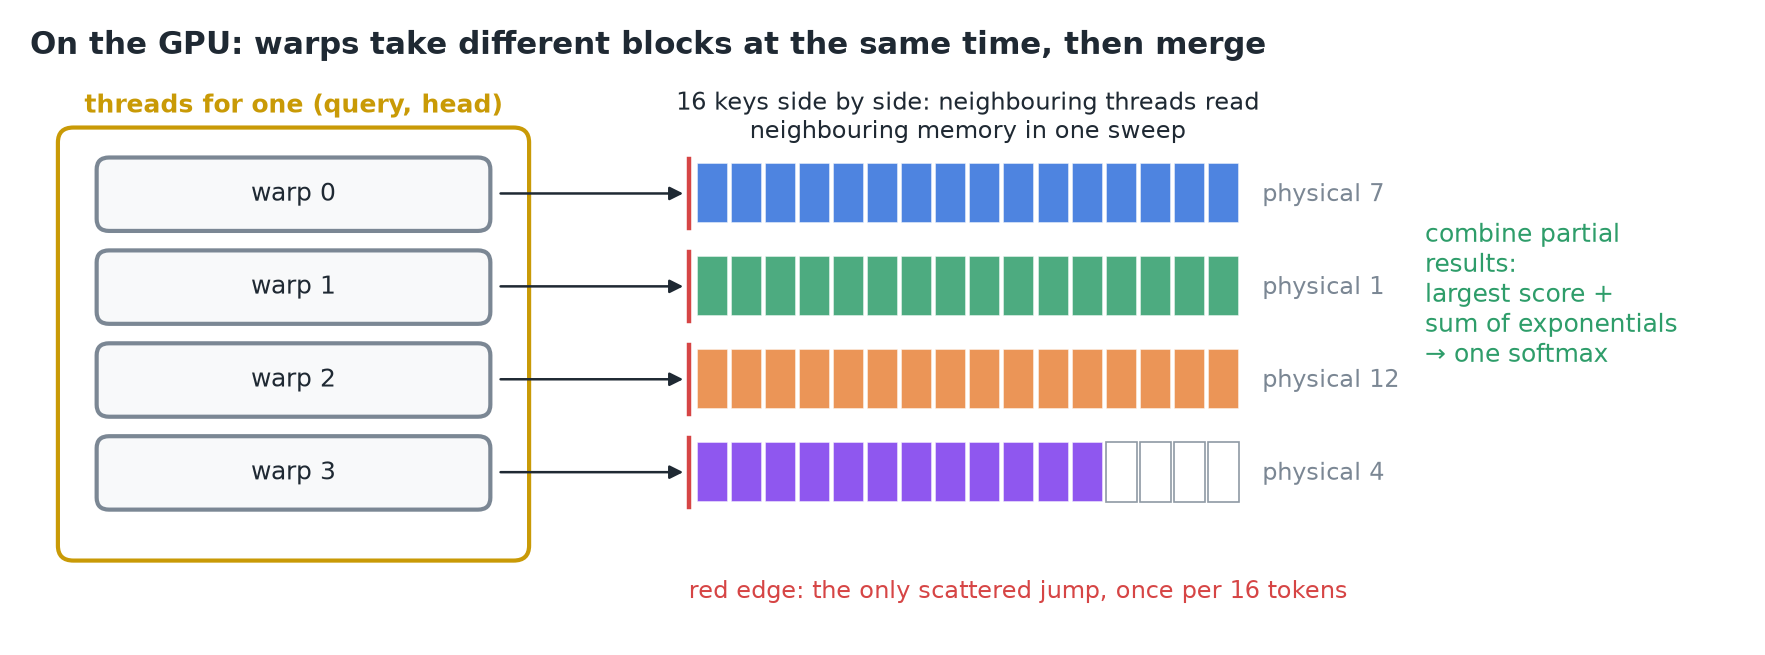 Đọc gộp (coalesced) bên trong mỗi block; mỗi block một bước gián tiếp.
◆ Gộp hai kết quả từng phần (điểm lớn nhất m và tổng luỹ thừa l từ mỗi warp):
4. Có miễn phí không? Không, nhưng đáng
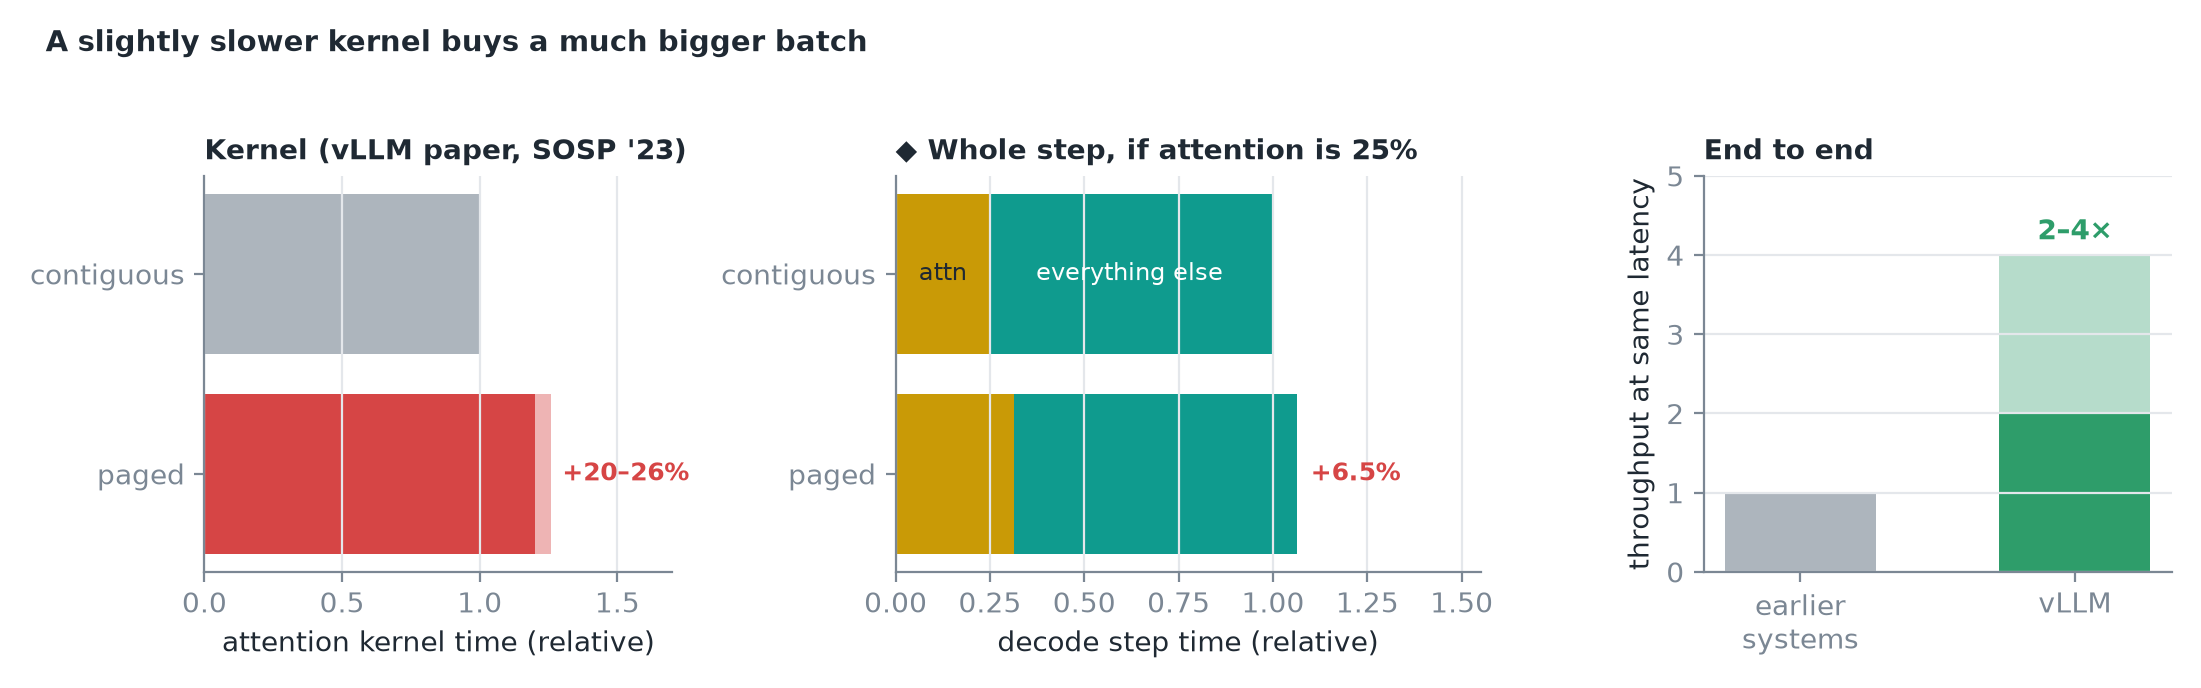 Trái: mỗi block cần một lần tra bảng và chút sổ sách, nên kernel chạy chậm hơn ~20–26% trong paper gốc. Giữa: ◆ nếu attention chiếm một phần tư bước decode, đó là ~6,5% trên cả bước. Phải: tính end-to-end, vLLM phục vụ throughput gấp 2–4 lần các hệ thống trước ở cùng latency.
- Attention chỉ là một phần của bước, và decode bị giới hạn bởi lưu lượng bộ nhớ, vốn che đi phần lớn công việc thêm khi batch lớn.
- Lãng phí gần bằng không cho phép rất nhiều request hơn vừa trong bộ nhớ cùng lúc: một kernel hơi chậm hơn đổi lấy một batch lớn hơn nhiều.
- KV phân trang giờ là chuẩn: FlashAttention và FlashInfer đều nhận block table trực tiếp.
5. Tóm tắt