27 · Tìm ranh giới bão hoà, vỡ SLO và OOM
Nguồn: fanout.sh / inference-eng / 05-05 · ~6 phút
Ghi chú
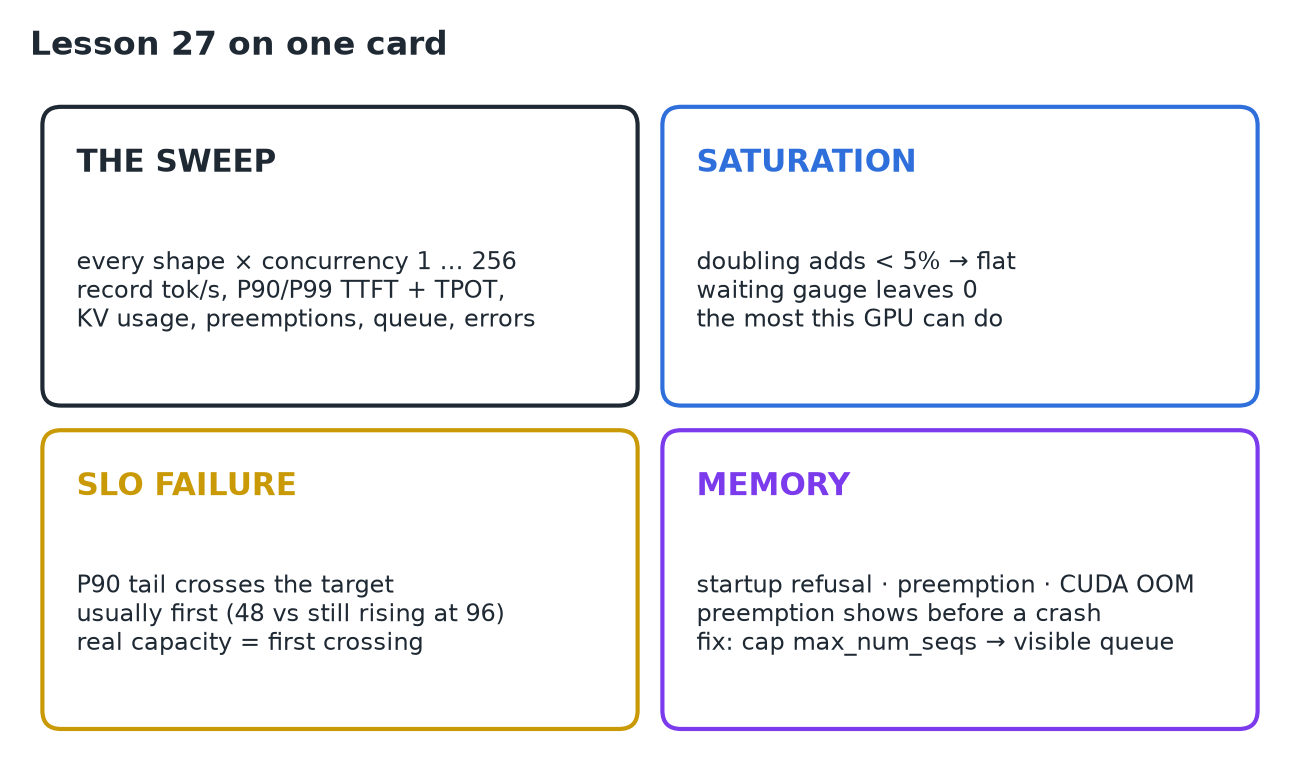
Mỗi GPU serve một model đều có một vùng vận hành (operating envelope): vùng nó chạy nhanh, đúng và ổn định. Ra ngoài vùng đó, nó vỡ trước ba bức tường khác nhau: bão hoà (throughput ngừng tăng), vỡ SLO (phần đuôi vượt mục tiêu) và bộ nhớ (từ chối khởi động, preemption, CUDA OOM). Bức tường SLO thường đến trước, nên năng lực thật là lần vượt SLO đầu tiên, không phải vùng throughput đi ngang. Bức tường bộ nhớ hiện ra dưới dạng preemption trước khi hiện ra thành crash; hãy giới hạn max_num_seqs để request dư chờ trong một hàng đợi nhìn thấy được.
1. Thí nghiệm
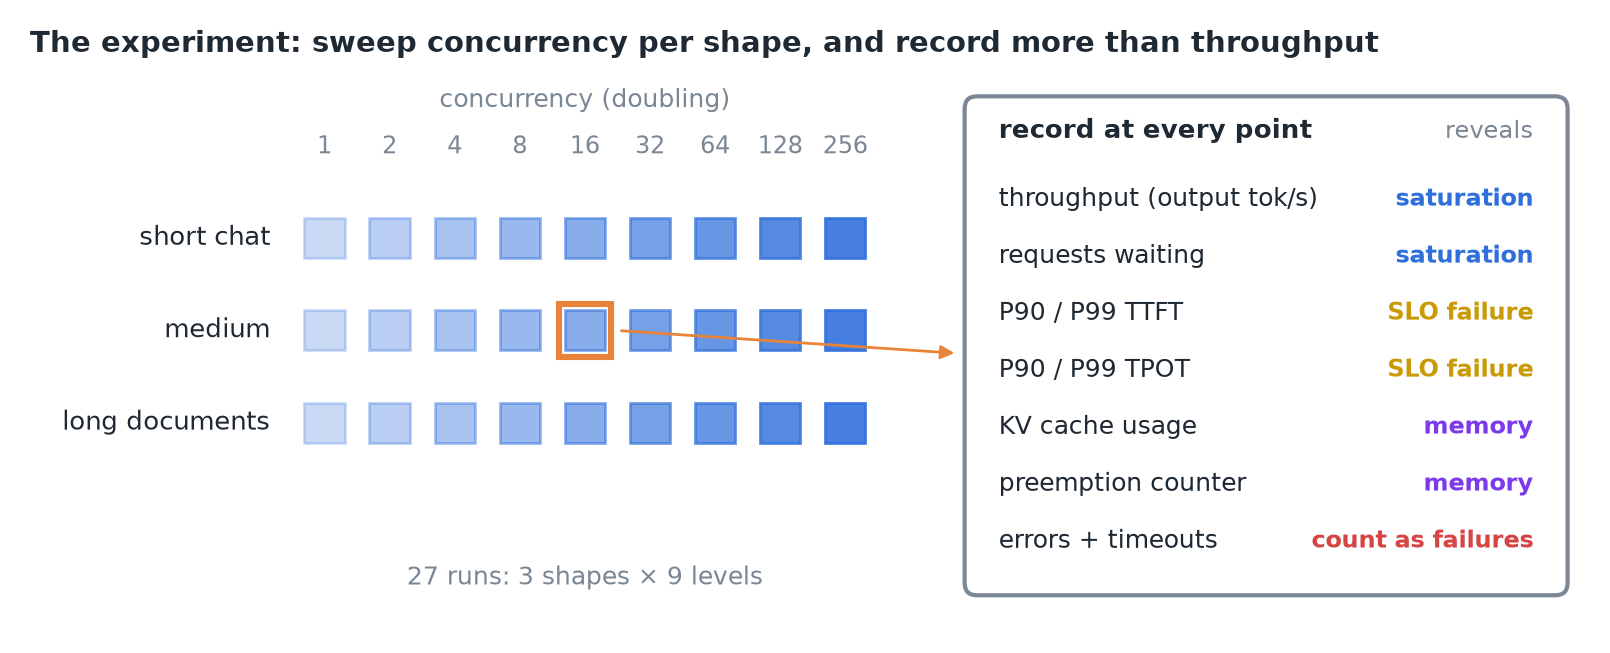 Chọn vài shape khớp với lưu lượng của bạn (chat ngắn, trung bình, tài liệu dài) và quét concurrency 1, 2, 4, … lên tới vài trăm cho mỗi shape. Ở mỗi điểm ghi lại throughput, P90 và P99 của TTFT và TPOT, ba tín hiệu của engine (mức dùng KV cache, bộ đếm preemption, số request đang chờ), và lỗi cùng timeout tính là thất bại. Ngần ấy cột là đủ để tìm ra mọi bức tường.
2. Bức tường 1: bão hoà
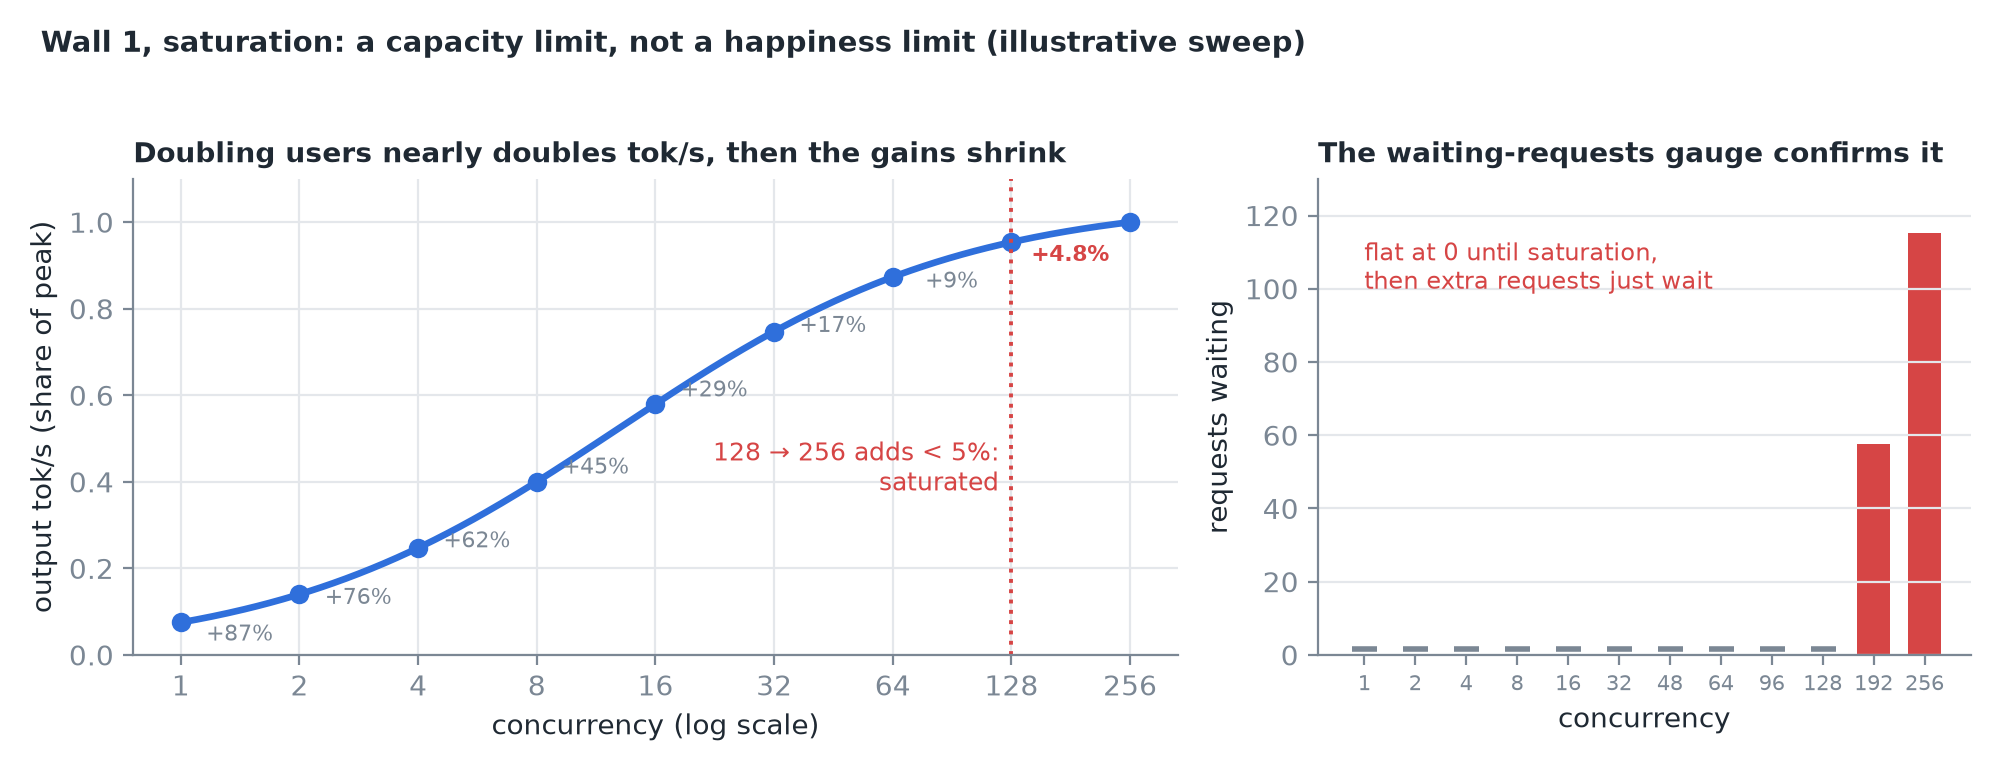 Lúc đầu, nhân đôi người dùng gần như nhân đôi token/s; sau đó phần lợi co lại và đường cong đi ngang.
- Quy tắc: khi nhân đôi concurrency chỉ thêm dưới ~5%, bạn đã bão hoà.
- Qua mức đó, request thêm vào không được phục vụ nhanh hơn, chúng phải chờ: gauge số request đang chờ, vốn nằm phẳng ở 0, bắt đầu leo lên.
- Bão hoà là một giới hạn năng lực: mức tối đa GPU này làm được, không phải người dùng có hài lòng hay không.
3. Bức tường 2: vỡ SLO
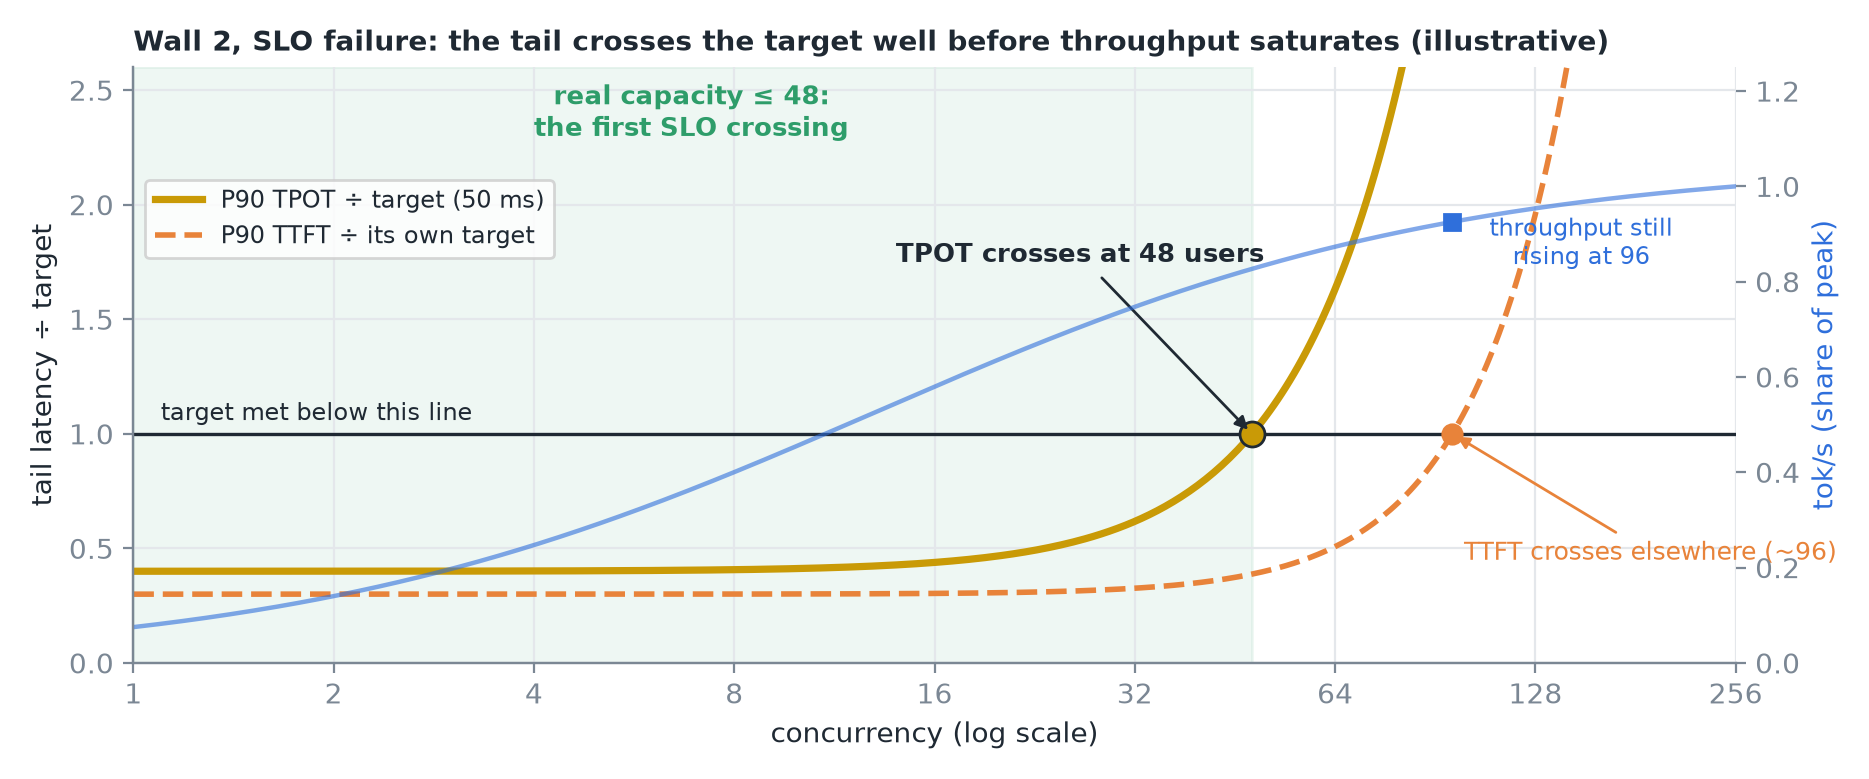 P90 TPOT tăng chậm, cong lên và vượt mục tiêu 50 ms ở khoảng 48 người dùng. TTFT có thể vượt ở chỗ khác. Throughput vẫn đang leo ở 96.
Quan trọng
SLO thường vỡ sớm hơn nhiều so với lúc throughput bão hoà. Năng lực thật của bạn là cái nhỏ hơn trong hai: lần vượt SLO đầu tiên, không phải vùng đi ngang.
4. Bức tường 3: bộ nhớ, ba gương mặt
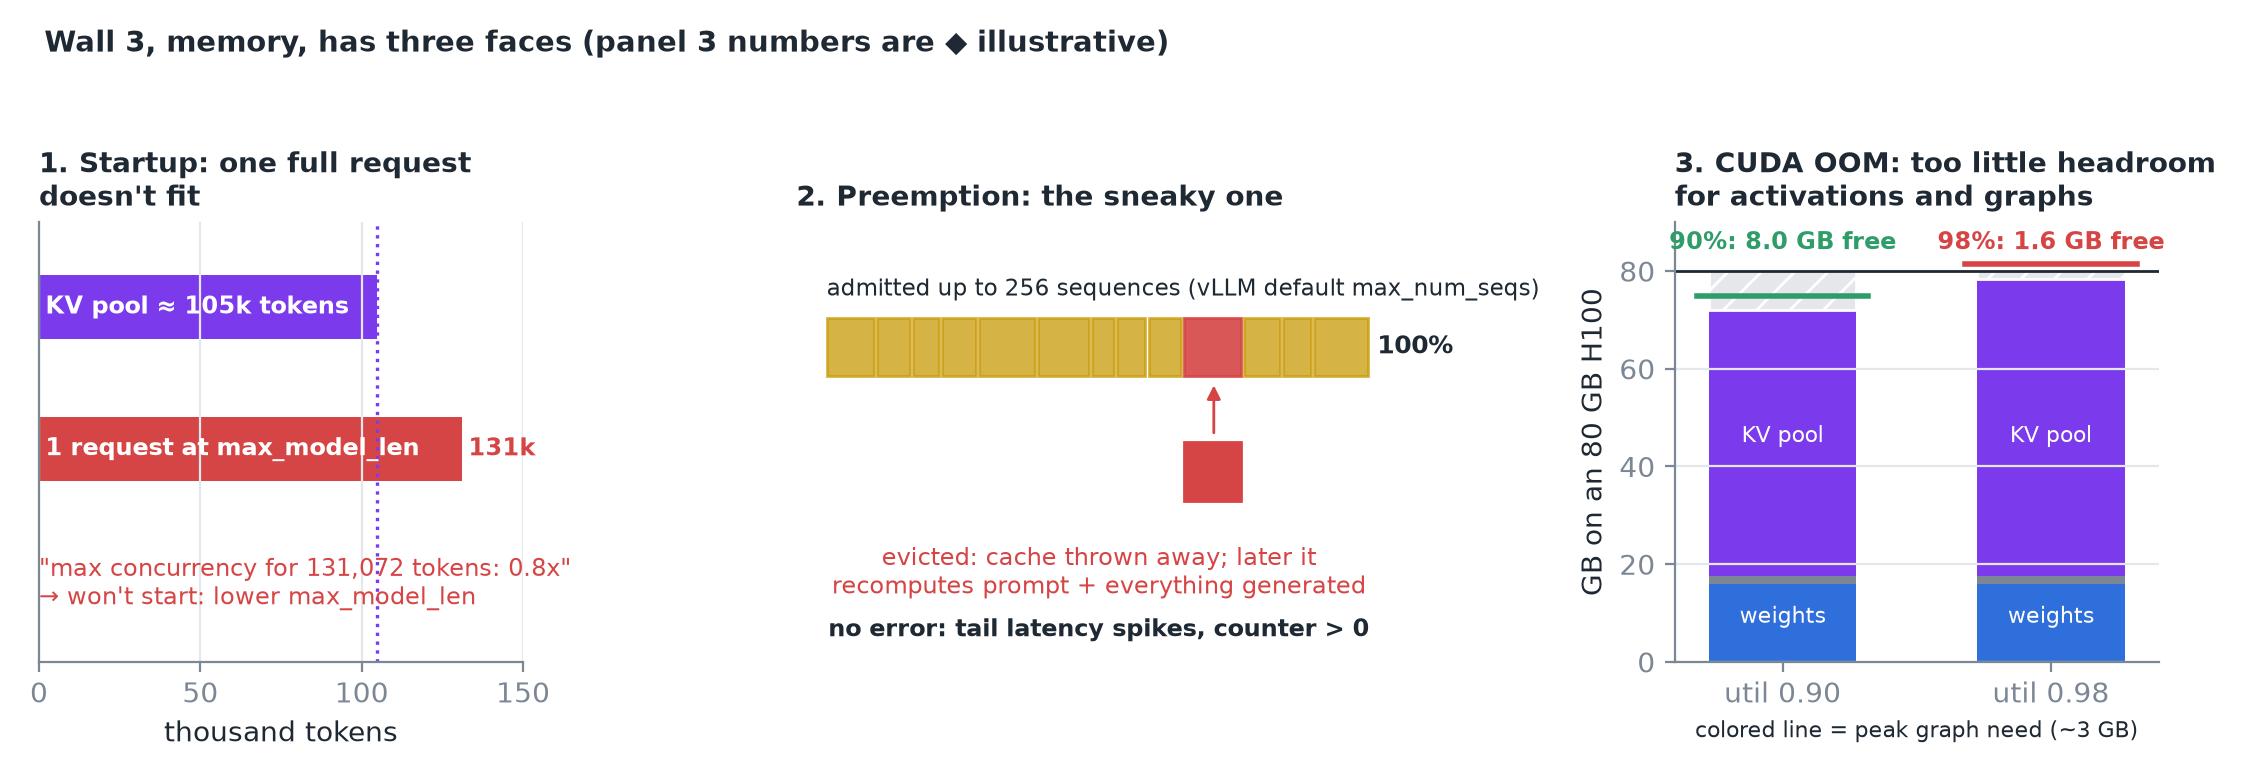 Khởi động: nếu trọng số cộng một request độ dài tối đa không vừa, engine từ chối khởi động hoặc báo rằng chứa được ít hơn một request. Preemption: engine nhận nhiều request vì cache của chúng bắt đầu nhỏ; khi cache chạm 100%, nó đuổi một request ra. CUDA OOM: crash thật, thường do chừa quá ít khoảng dự phòng cho activation và graph.
- Preemption là gương mặt khó nhận ra nhất. vLLM mặc định nhận tới 256 sequence (
max_num_seqs). Khi các câu trả lời dài ra, cache đầy dần; ở 100% nó đuổi một request đang chạy, mặc định là vứt bỏ cache của nó rồi sau đó tính lại prompt cộng mọi thứ đã sinh tới giờ. - Request đó khựng lại, và phần tính lại cướp thời gian của mọi người. Không có lỗi nào: chỉ có latency phần đuôi tăng vọt và một bộ đếm preemption lẽ ra phải nằm yên ở 0.
- Cách sửa: giới hạn
max_num_seqsở mức cache thực sự chịu được, để request dư chờ trong một hàng đợi nhìn thấy được thay vì quay cuồng (thrashing).
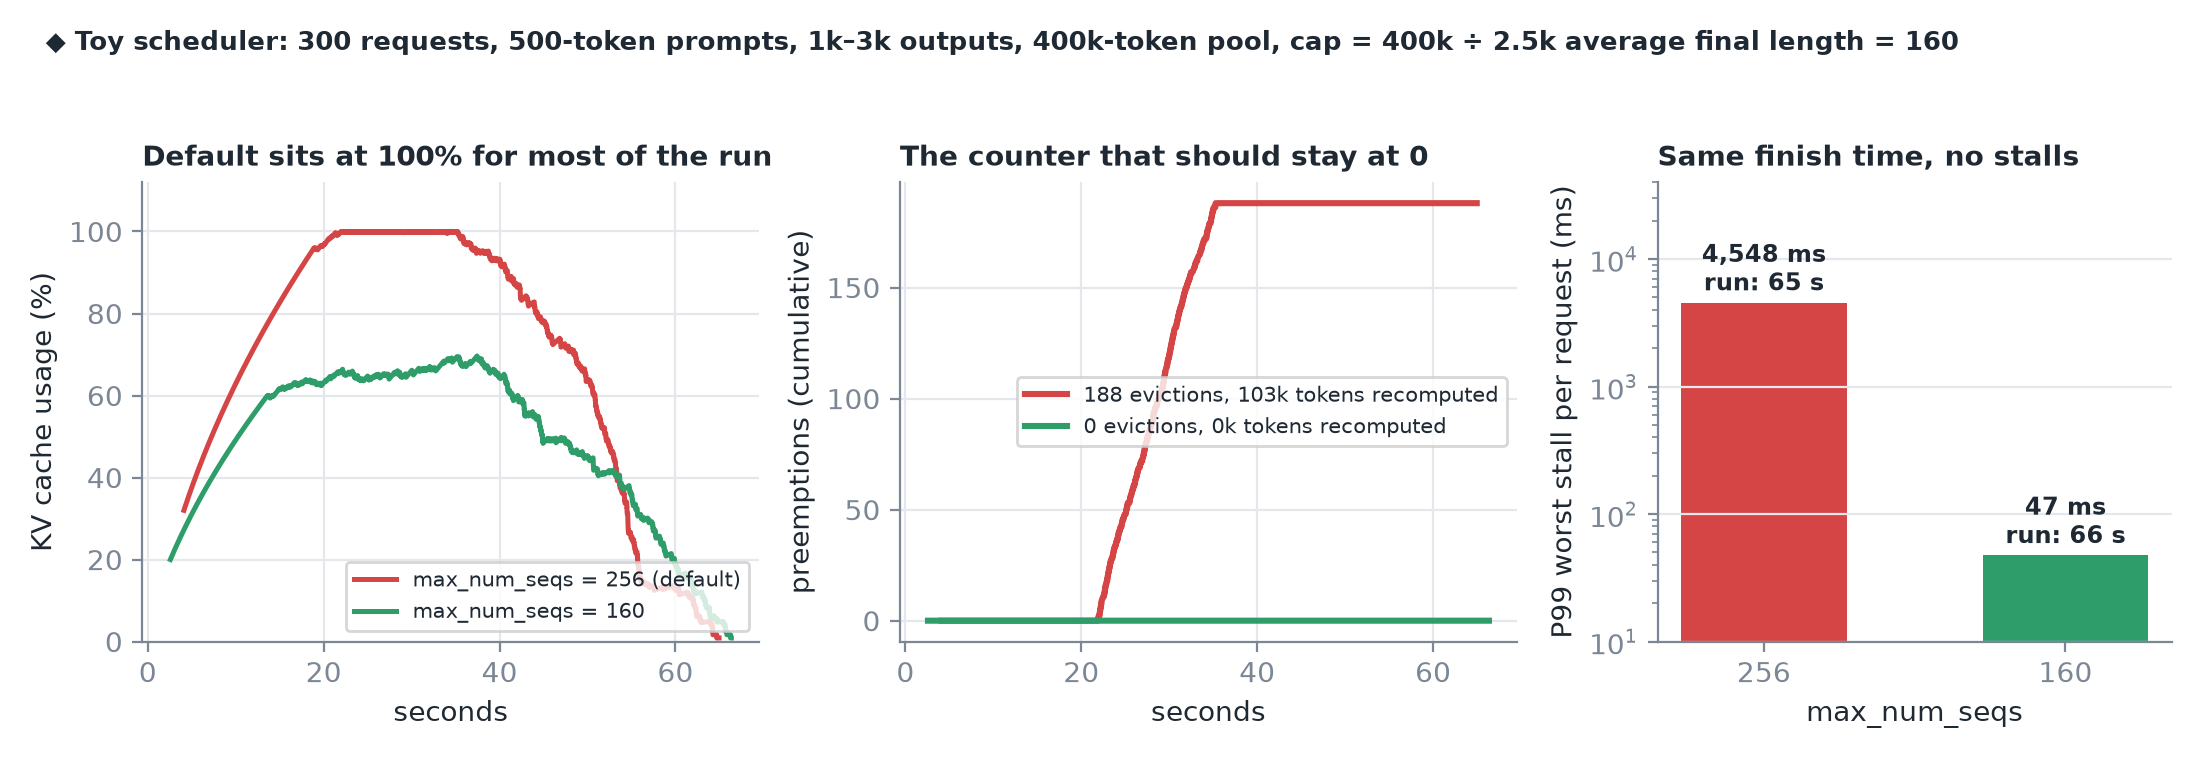 ◆ Một scheduler đồ chơi: với giới hạn mặc định, cache nằm ở 100%, 188 lần đuổi phải tính lại 103 nghìn token và lần khựng tệ nhất ở P99 là 4,5 s. Giới hạn ở 160 thì xong trong cùng thời gian, không có lần đuổi nào và lần khựng tệ nhất chỉ 47 ms.
5. Vùng vận hành
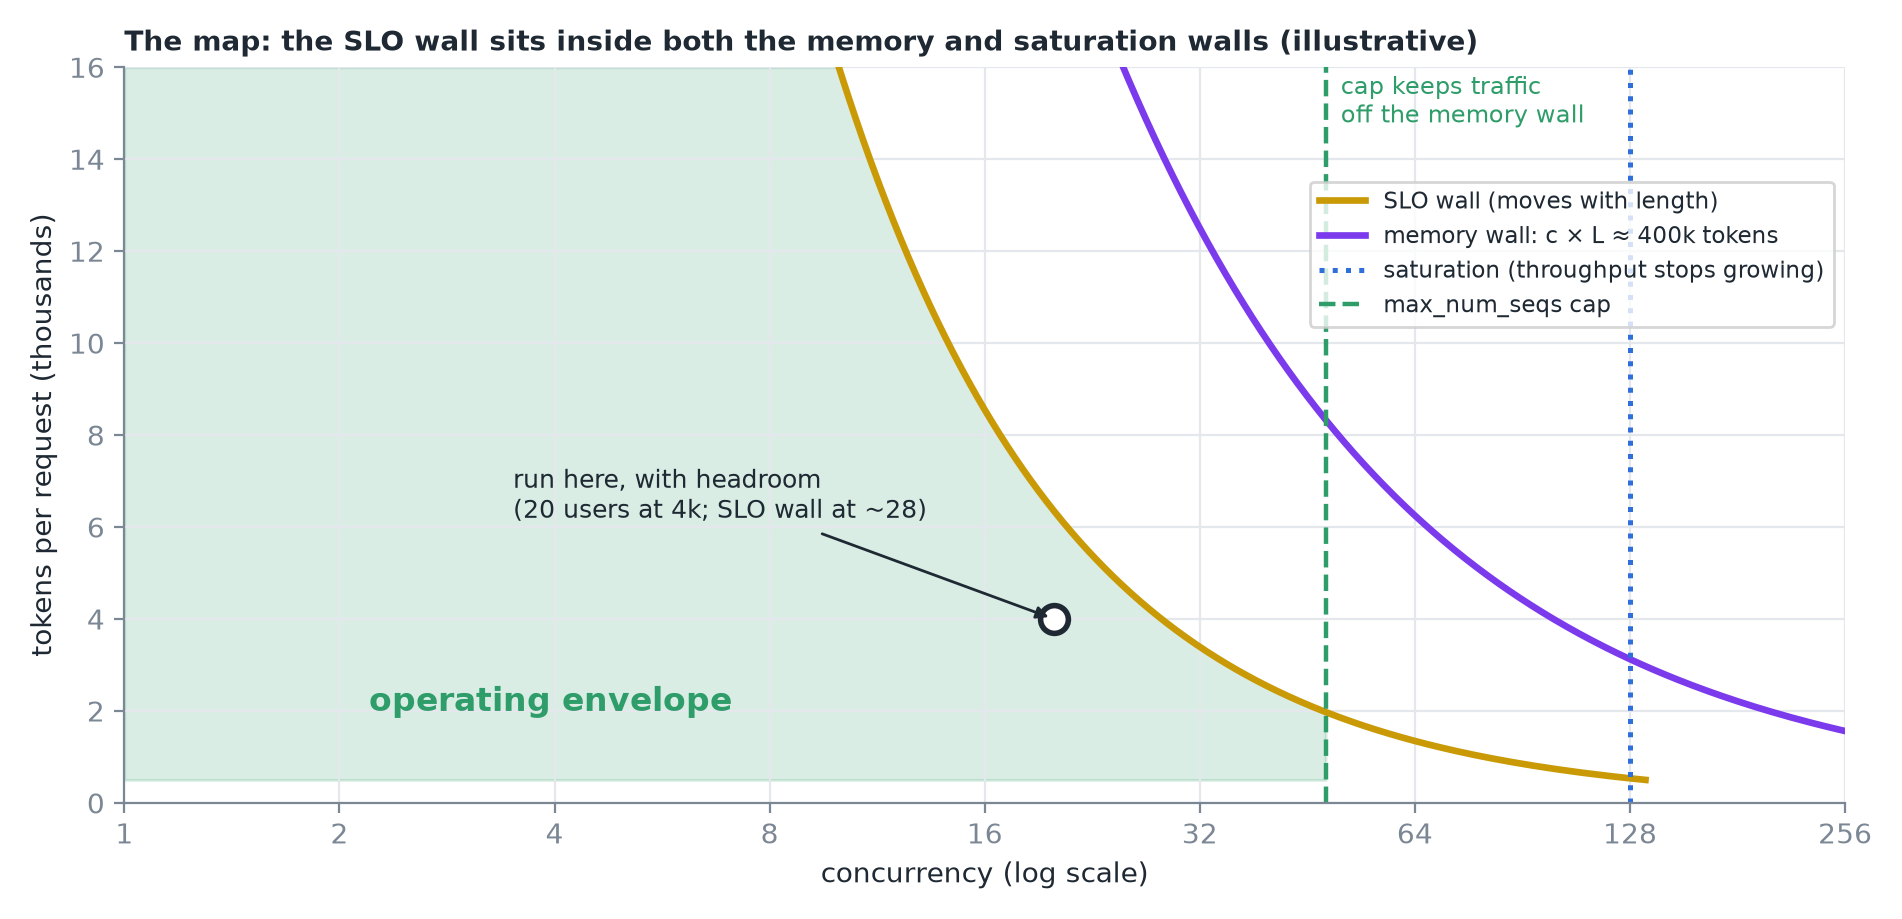 Concurrency theo chiều ngang, số token mỗi request theo chiều dọc. Bức tường bộ nhớ là một đường cong: concurrency × độ dài không thể vượt quá cache, ở đây ~400 nghìn token. Bão hoà là nơi throughput ngừng tăng. Bức tường SLO dịch chuyển theo độ dài và nằm bên trong cả hai. Chạy bên trong vùng xanh với khoảng dự phòng cho các đợt dồn, và đặt giới hạn concurrency để lưu lượng không thể lạc qua bức tường bộ nhớ.
| Bức tường | Tín hiệu để lộ nó | Ý nghĩa |
|---|---|---|
| Bão hoà | Nhân đôi chỉ thêm < 5%; gauge số request chờ rời khỏi 0 | Mức tối đa GPU này làm được |
| Vỡ SLO | P90/P99 TTFT hoặc TPOT vượt mục tiêu | Năng lực thật (thường đến trước) |
| Bộ nhớ | Từ chối khởi động; bộ đếm preemption > 0; CUDA OOM | Cache hoặc khoảng dự phòng quá nhỏ |
6. Tóm tắt