17 · Tự xây một KV cache
Nguồn: fanout.sh / inference-eng / 03-04 · ~7 phút
Ghi chú
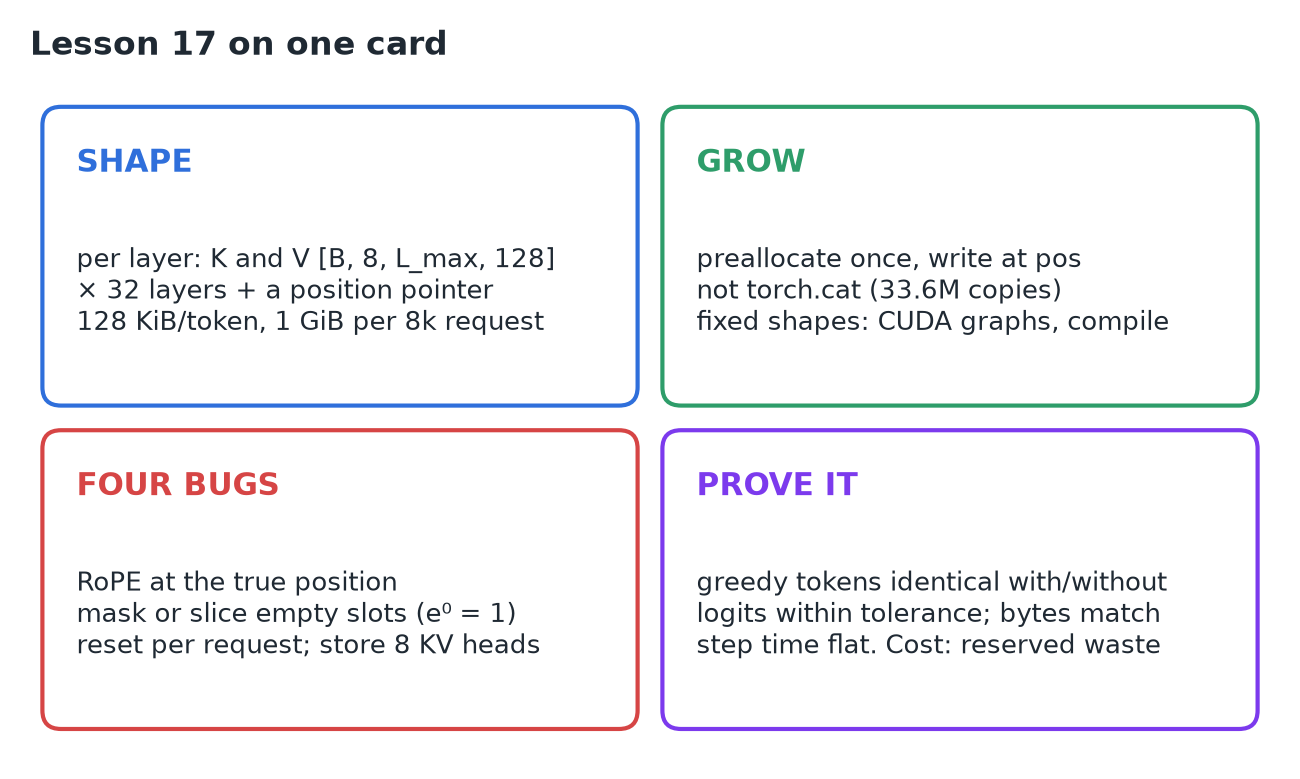
Một KV cache là một tensor key và một tensor value cho mỗi layer, với shape [batch, 8 KV head, độ dài tối đa, 128] ở Llama 3 8B, cộng một con trỏ cho biết đã lấp bao nhiêu slot: 128 KiB mỗi token, nên đặt trước 8.192 token là đúng 1 GiB mỗi request. Cấp phát trước (preallocate) buffer và ghi K/V mới tại chỗ (nối tensor thì mỗi bước phải chép lại mọi thứ: 33,6 triệu lượt chép token cho 8k token). Prefill ghi slot 0 … P−1 trong một lần; mỗi bước decode ghi tại con trỏ, chỉ đọc slot 0 … con trỏ, rồi tăng con trỏ lên. Bốn lỗi kinh điển: sai vị trí RoPE, đọc phải slot trống, quên reset, chép KV head. Chứng minh nó đúng bằng các token greedy giống hệt nhau, số byte khớp và thời gian mỗi bước phẳng. Chi phí ẩn: bộ nhớ đã đặt trước nhưng không dùng tới.
1. Ta lưu gì
Ở mọi layer, attention sinh ra một key và một value cho mỗi token, mỗi KV head. Vì vậy mỗi layer có hai tensor:
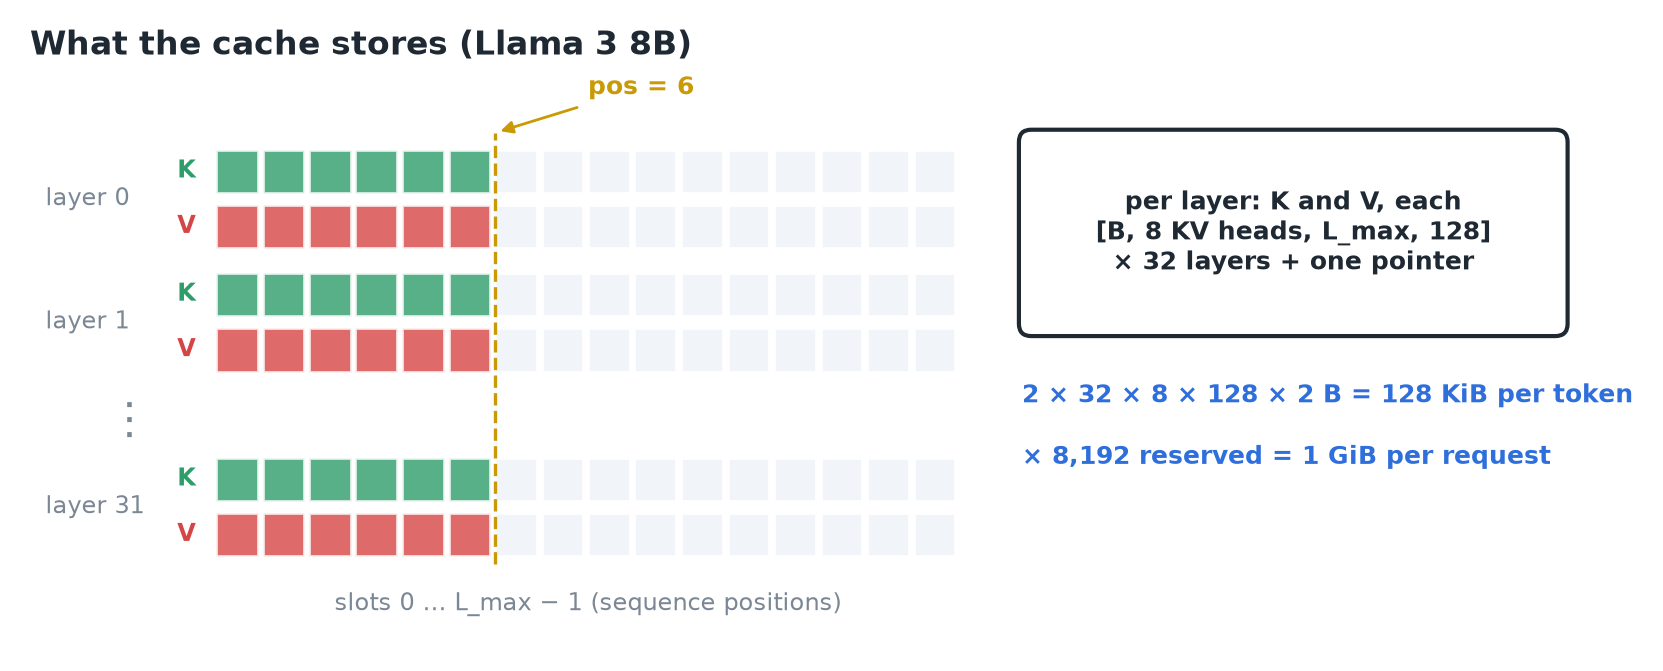 32 layer × (K, V), mỗi cái [B, 8, L_max, 128], cộng một mảnh nhỏ nhưng thiết yếu: con trỏ vị trí.
Kích thước mỗi token chính là 128 KiB của bài 05 (2 × 32 × 8 × 128 × 2 byte). Đặt trước 8.192 token thì cache của một request là đúng 1 GiB.
2. Cache lớn lên thế nào
# ngây thơ: mỗi bước một tensor hoàn toàn mới, chép lại mọi thứ
k = torch.cat([k, k_new], dim=2)
# tốt hơn: cấp phát một lần, ghi vào slot trống kế tiếp
k_cache = torch.empty(B, 8, L_max, 128)
k_cache[:, :, pos] = k_new
pos += 1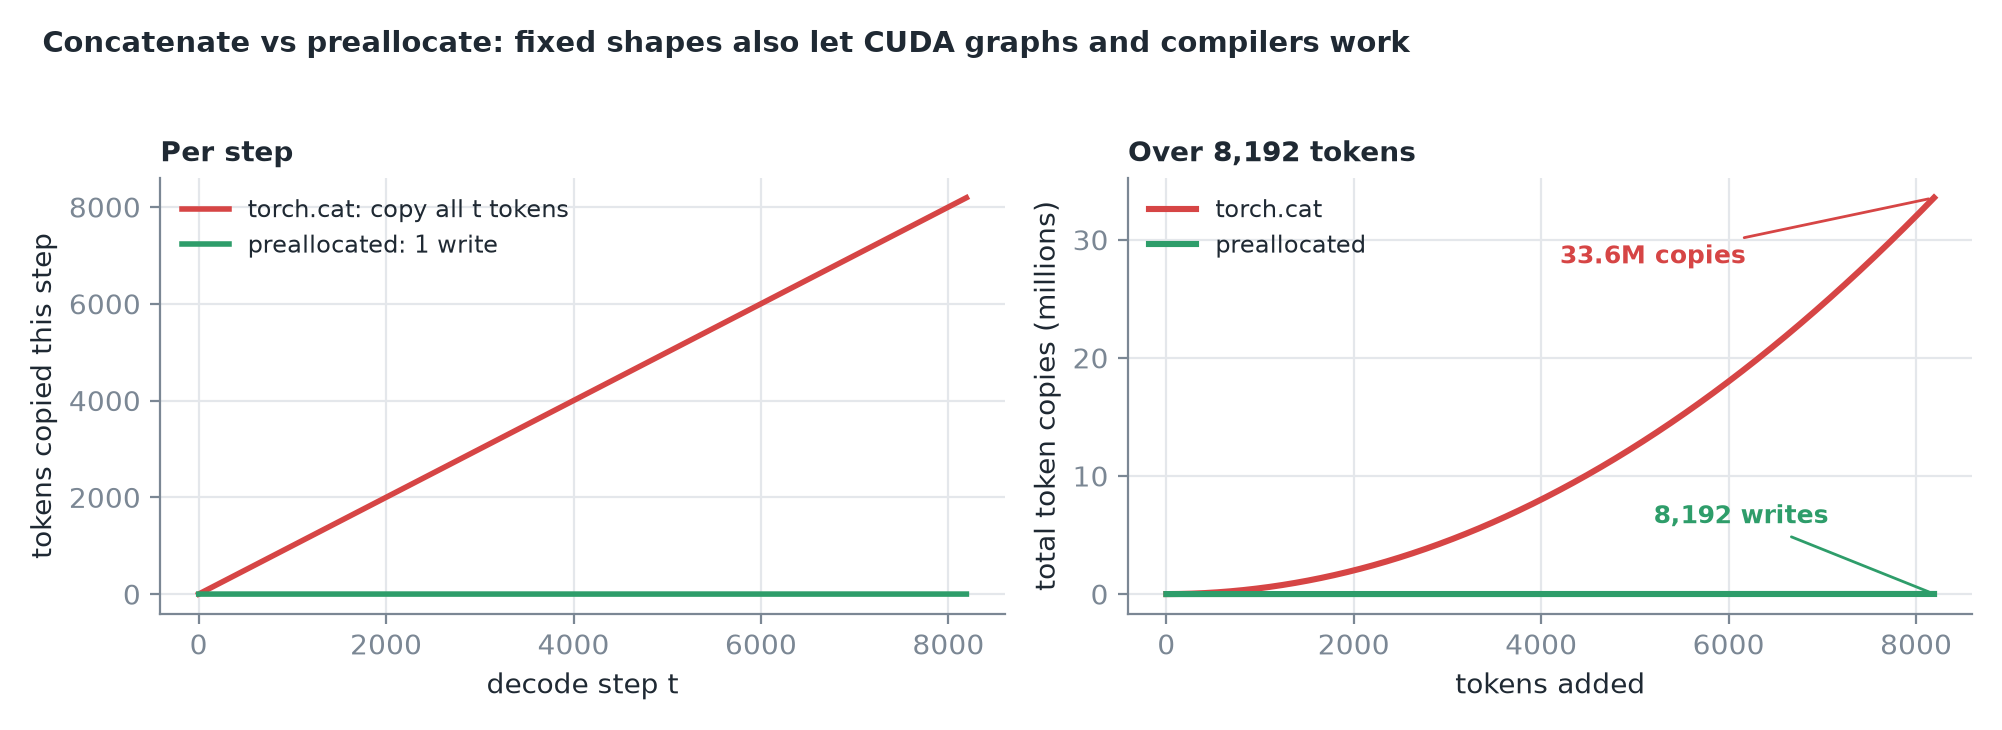 Nối tensor: hơn 33 triệu lượt chép token chỉ để thêm 8.192 token. Cấp phát trước: mỗi bước một lần ghi nhỏ, bất kể độ dài.
Mẹo
Với cấp phát trước, shape của tensor không bao giờ đổi, đúng thứ mà CUDA graph và trình biên dịch cần. Code production (ví dụ torchtune) dùng một buffer cố định cộng một bộ đếm vị trí.
3. Prefill ghi, decode nối thêm
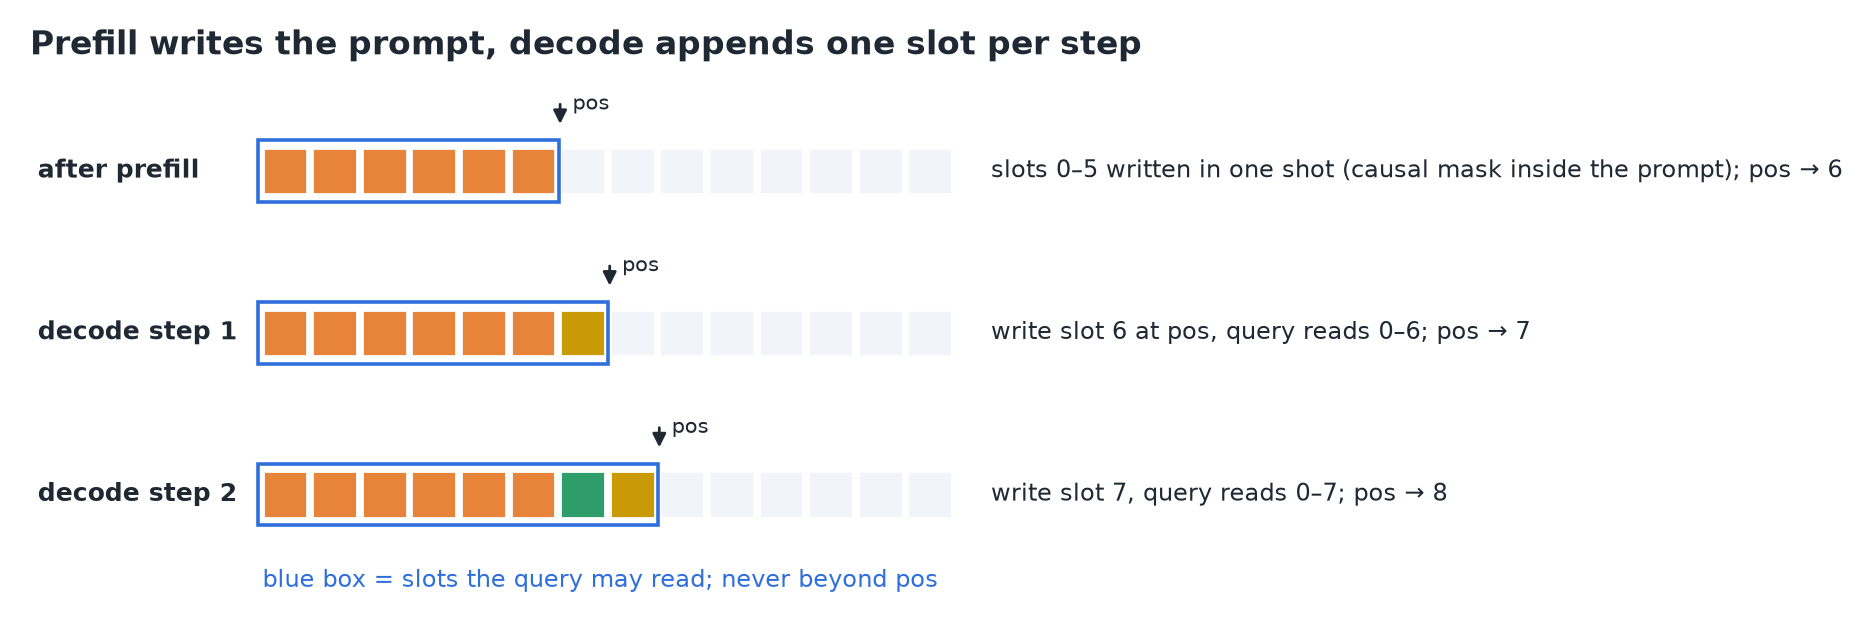
- Prefill: cả prompt đến cùng lúc; K/V của nó vào slot 0 … P−1 trong một lần, ở mọi layer. Bên trong prompt, attention vẫn dùng causal mask. Con trỏ nhảy tới cuối prompt.
- Decode: mỗi bước ghi K/V của token mới tại con trỏ, query của nó đọc slot 0 … con trỏ và không gì xa hơn, rồi con trỏ tiến thêm một.
4. Bốn lỗi gần như ai cũng mắc
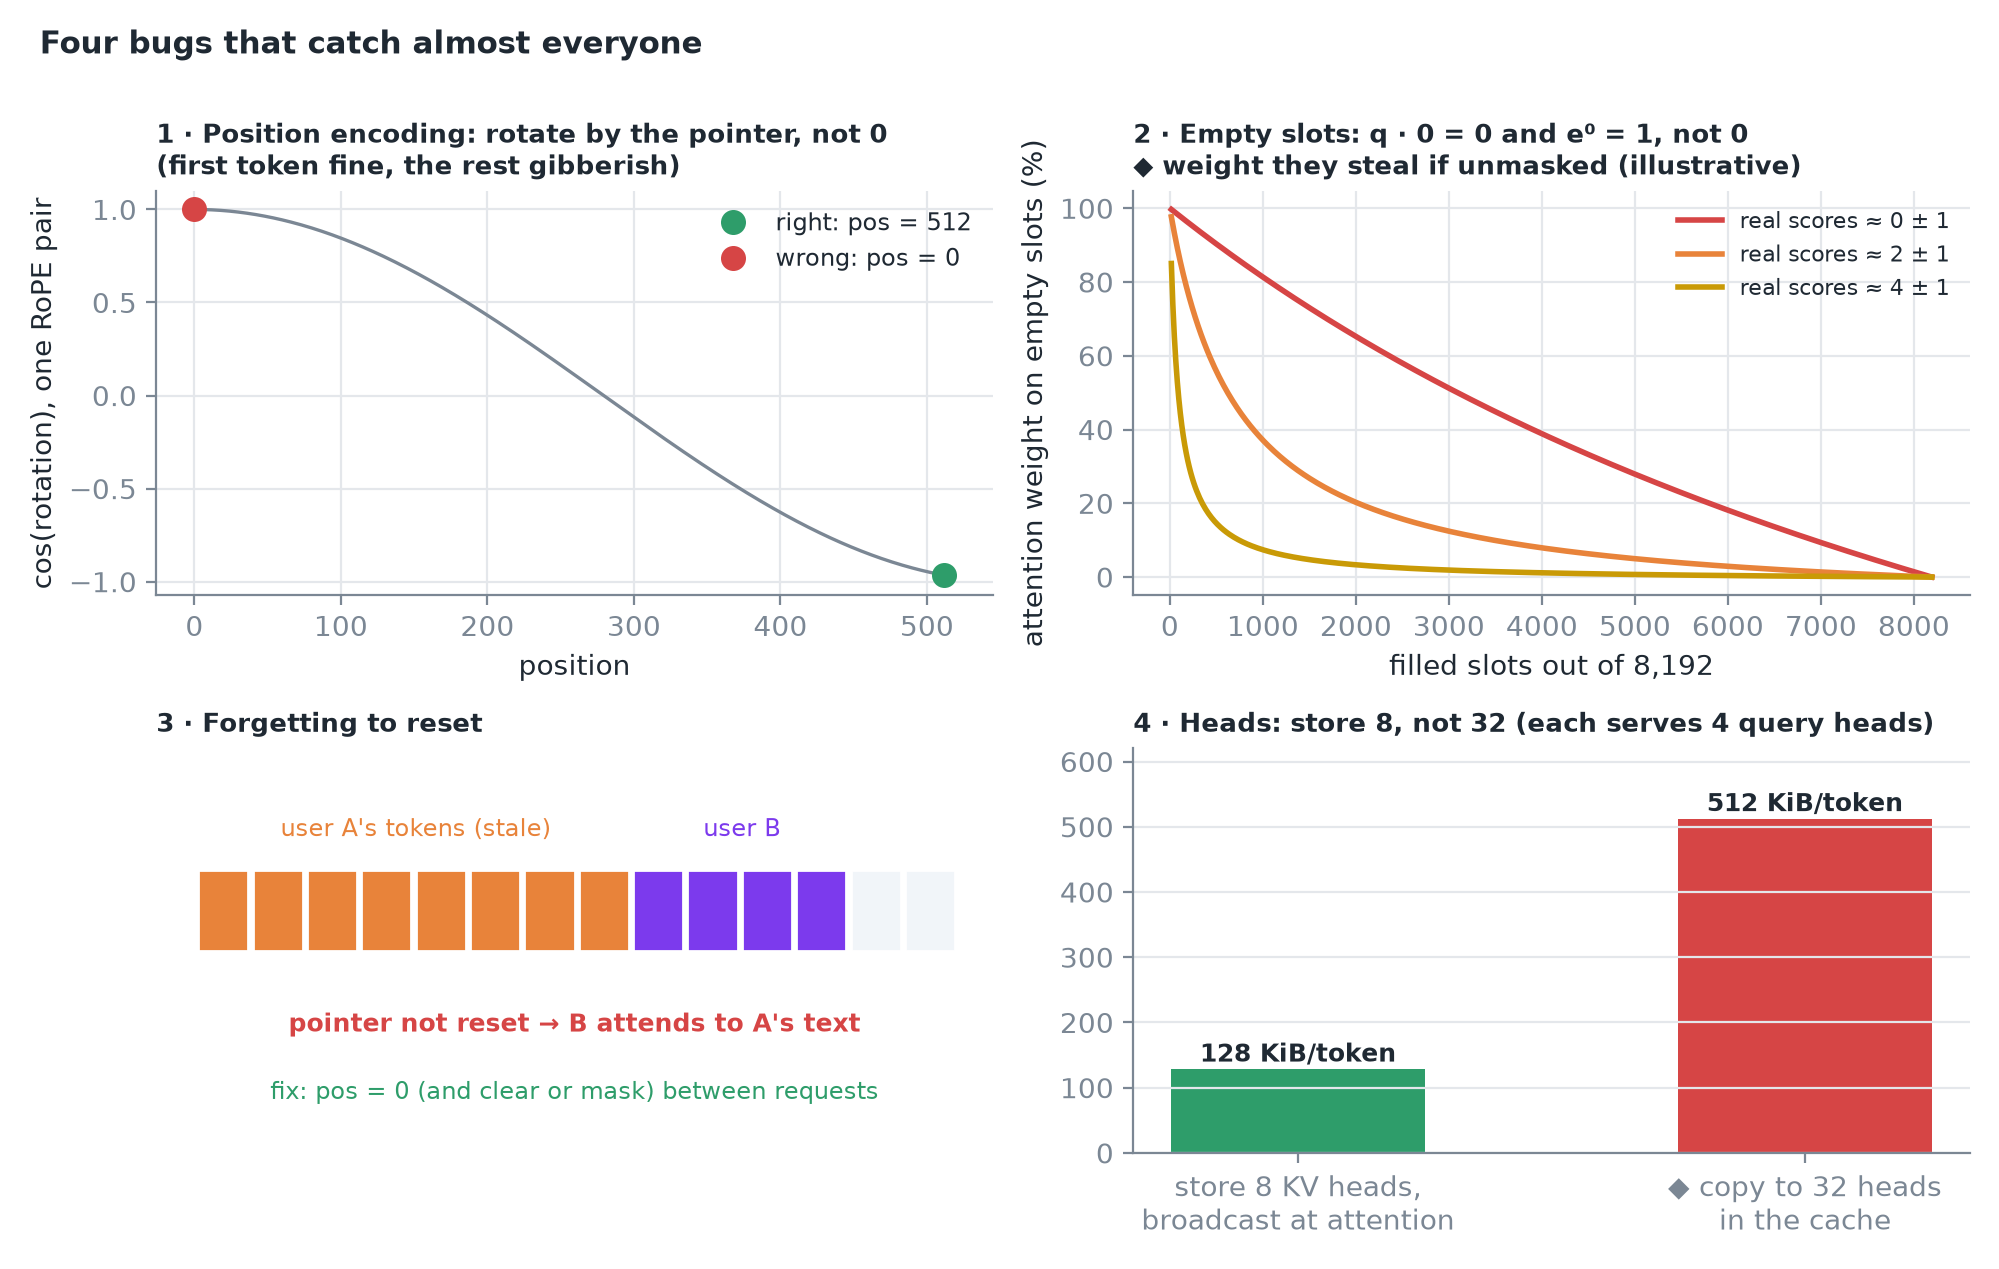
- Mã hoá vị trí. Llama xoay mỗi query và key một góc xác định bởi vị trí của token (RoPE). Khi decode bạn chỉ đưa vào một token, nên dễ gọi nó là vị trí 0, nhưng thật ra nó là vị trí 512 (hoặc con trỏ đang ở đâu thì ở đó). Sai chỗ này thì token đầu tiên ổn, sau đó là chữ vô nghĩa.
- Đọc phải slot trống. Buffer cấp phát trước toàn số 0. Key bằng 0 cho điểm 0, mà e⁰ = 1, không phải 0, nên các slot chưa lấp lặng lẽ giành mất trọng số attention. Luôn cắt (slice) hoặc mask về đúng độ dài đã lấp.
- Quên reset. Nếu con trỏ không được xoá giữa các request, prompt của người dùng tiếp theo sẽ attend vào văn bản của người dùng trước.
- Head. Llama chỉ lưu 8 KV head, mỗi cái được 4 query head dùng chung. Broadcast chúng lúc tính attention; đừng chép chúng vào cache.
5. Chứng minh nó chạy đúng
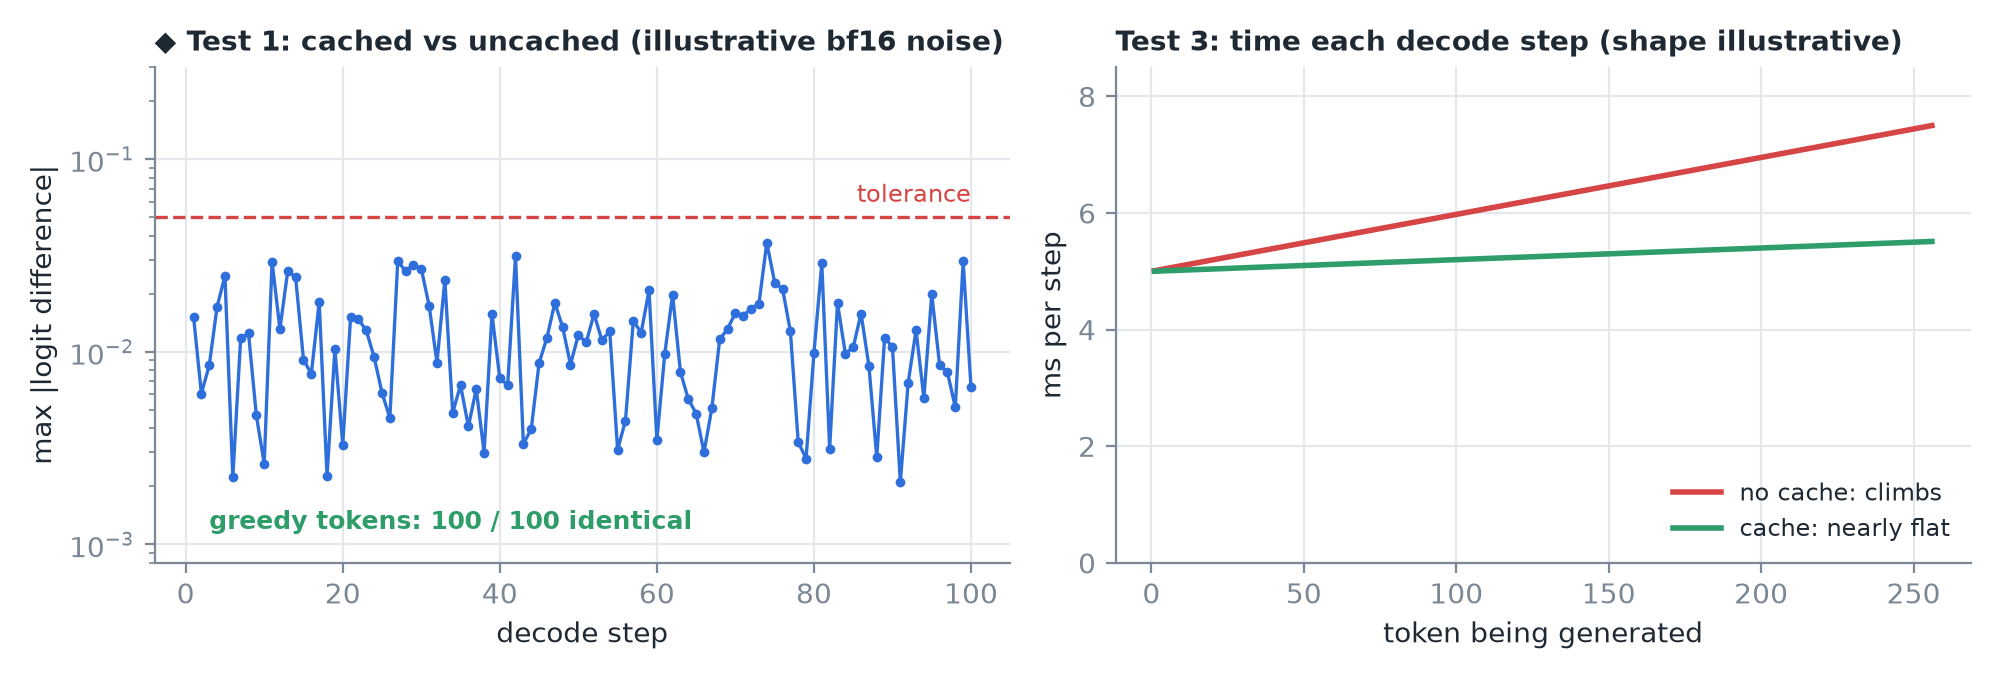
- Tính đúng: sinh 100 token greedy có và không có cache; hai chuỗi token phải khớp tuyệt đối. Cache thay đổi cách ta tính, không thay đổi cái ta tính. Logits sẽ không giống nhau từng bit ở 16-bit, nhưng phải khớp trong một sai số nhỏ.
- Bộ nhớ: số byte cấp phát phải bằng 2 × số layer × số KV head × head dim × độ dài × số byte mỗi số.
- Tốc độ: bấm giờ từng bước decode: phẳng khi có cache, tăng dần khi không có.
6. Chi phí ẩn của việc cấp phát trước
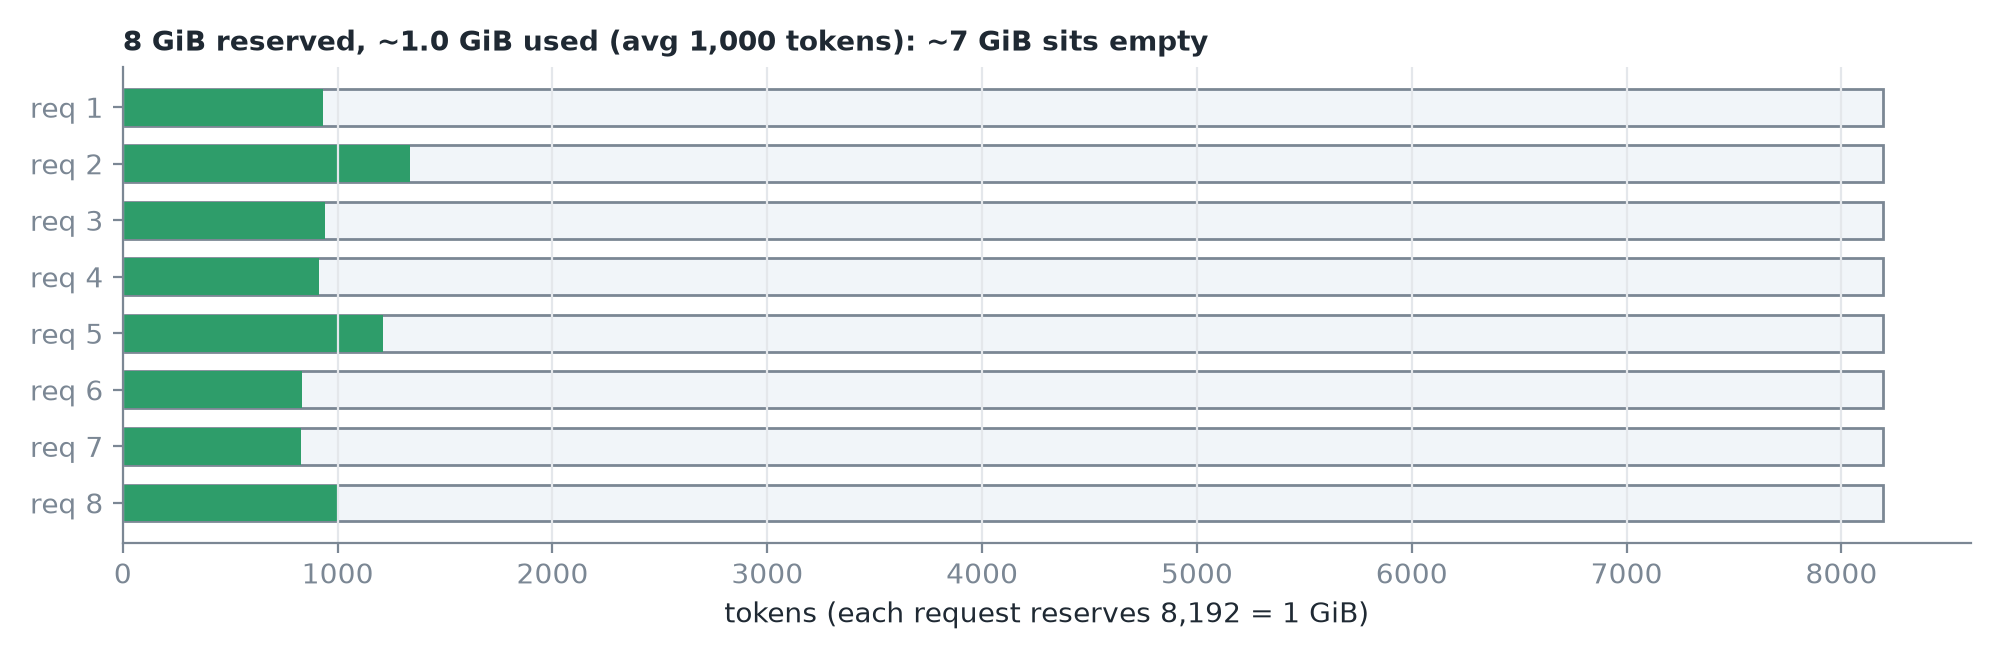 Tám request mỗi cái đặt trước 8.192 token là giữ 8 GiB. Nếu trung bình chúng chỉ dùng 1.000 token, khoảng 7 GiB nằm trống, làm giới hạn số request vừa trên GPU. Bộ nhớ phân trang (paged memory) giải quyết chuyện này.
7. Tóm tắt