19 · Tính bộ nhớ KV, giới hạn context và concurrency
Nguồn: fanout.sh / inference-eng / 03-06 · ~6 phút
Ghi chú
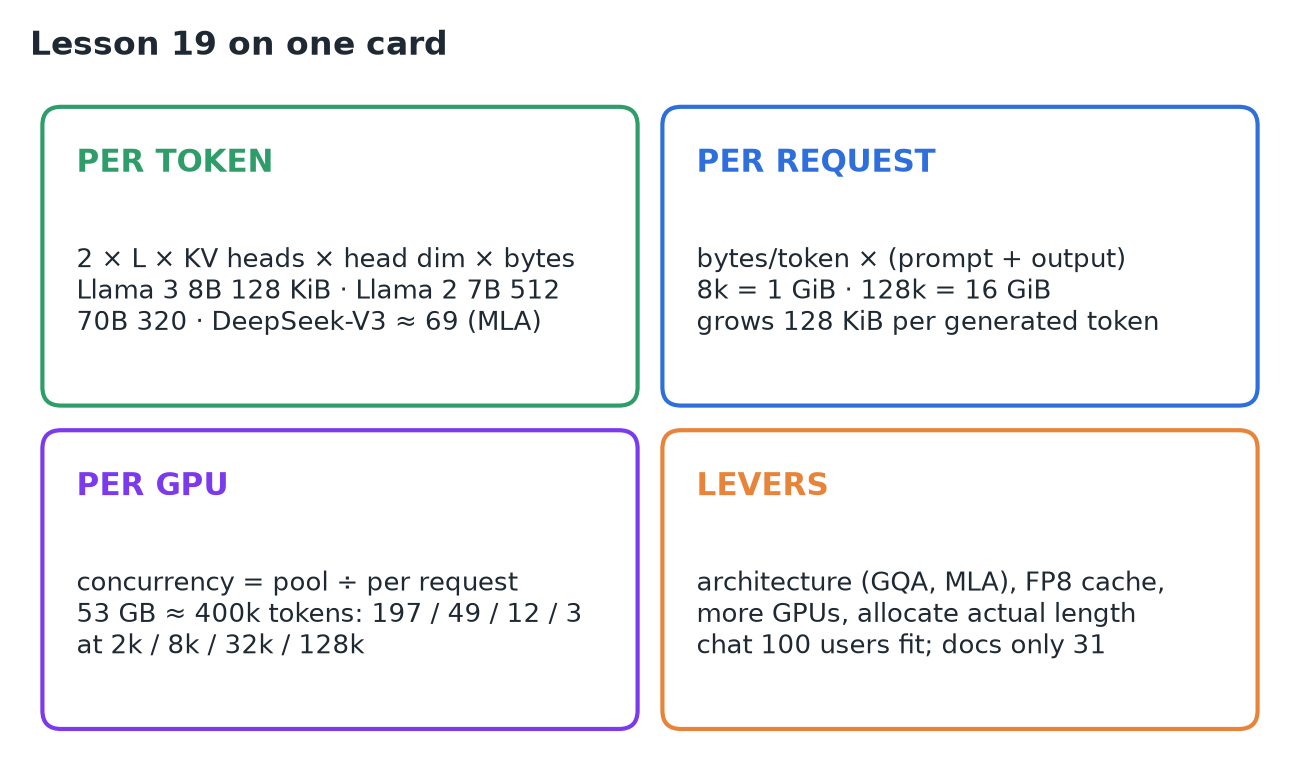
Hai câu hỏi quyết định một deployment hứa hẹn được gì: một cuộc hội thoại dài được bao nhiêu, và bao nhiêu cuộc chạy cùng lúc được? Cả hai đến từ cùng một pool KV và một phép chia. Mỗi token: 2 × số layer × số KV head × head dim × số byte (Llama 3 8B: 128 KiB). Mỗi request: con số đó × (prompt + đầu ra) (8k = 1 GiB, 128k = 16 GiB). Mỗi GPU: pool ÷ mỗi request: ~53 GB ≈ 400 nghìn token chứa được 197 request ở 2k, 49 ở 8k, 12 ở 32k, 3 ở 128k. Context và concurrency đánh đổi một đổi một. Cùng một model phục vụ 100 người dùng chat nhưng chỉ 31 người dùng tài liệu trên một H100: workload quyết định hoá đơn. Các đòn bẩy: kiến trúc (GQA, MLA), cache FP8, thêm GPU, và cấp phát theo độ dài thực tế thay vì độ dài tối đa.
1. Mỗi token: kiến trúc quyết định
Ở mỗi layer, cache lưu một vector key và một vector value cho mỗi KV head, nên số byte mỗi token = 2 × số layer × số KV head × head dim × số byte mỗi số.
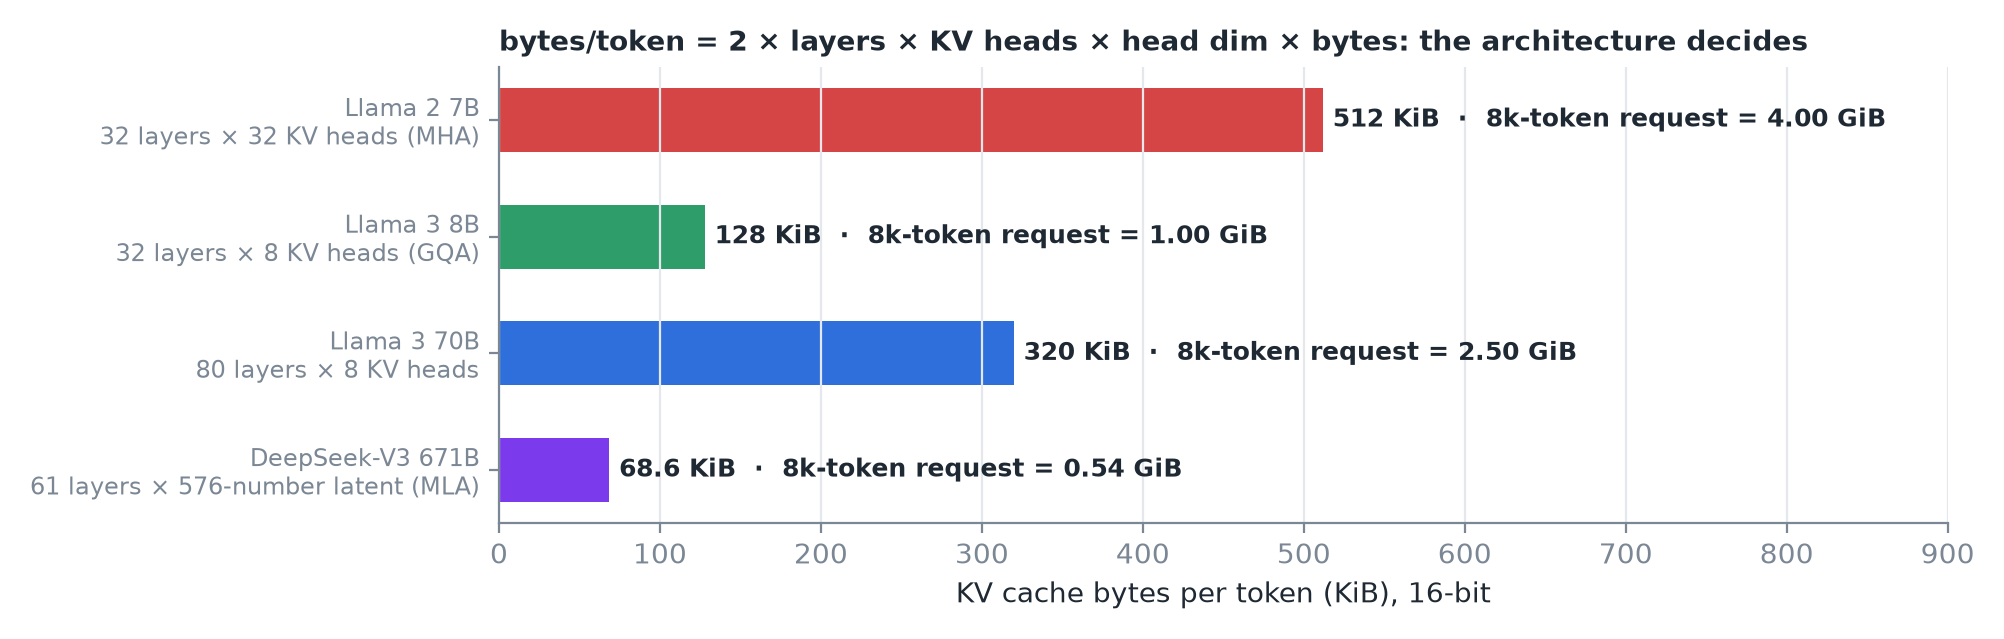 Llama 2 7B cho mỗi head K/V riêng (32 head). Llama 3 8B cho 32 query head dùng chung 8 KV head: chỉ bằng một phần tư. 70B có 80 layer. DeepSeek-V3 nén K/V thành một vector latent nhỏ mỗi layer: ~69 KiB/token cho một model 671B.
2. Mỗi request: mọi thứ nó đã thấy
Cache của một request chứa cả prompt cộng mọi token đã sinh tới giờ, nên bộ nhớ mỗi request = số byte mỗi token × tổng độ dài.
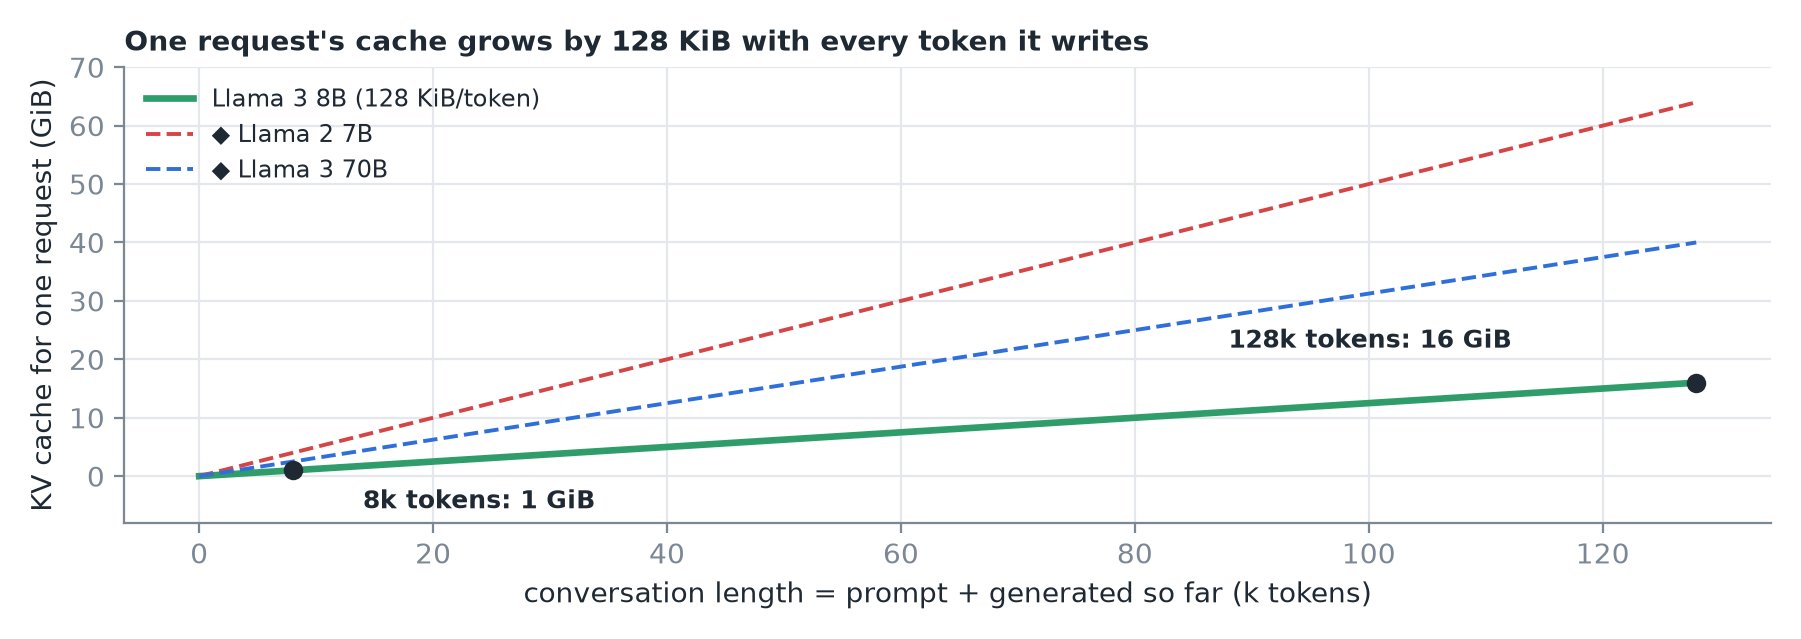 Llama 3 8B: một cuộc hội thoại 8k giữ 1 GiB; một cuộc 128k giữ 16 GiB, tất cả cho một người dùng.
3. Mỗi GPU: một phép chia
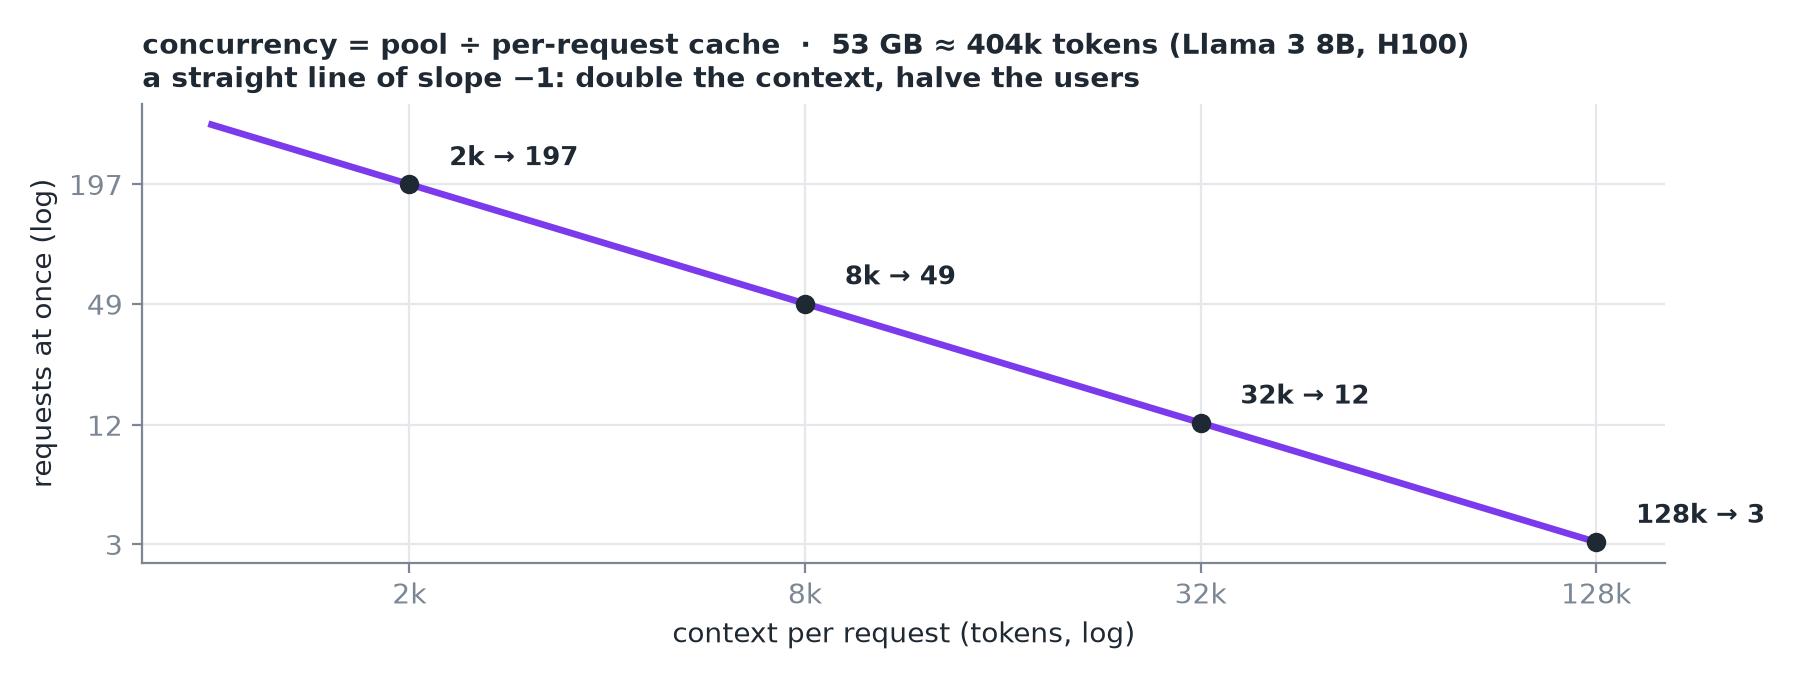
Engine tìm được ~53 GB cache trên một H100 (bài 18), khoảng 400 nghìn token. Chia pool cho độ dài của mỗi request:
Quan trọng
Độ dài context và concurrency đánh đổi trực tiếp: nhân đôi cái này thì cái kia giảm một nửa. Một context window khổng lồ đắt đỏ vì mỗi người dùng lấp đầy nó chiếm chỗ của rất nhiều người khác.
4. Lên kế hoạch hai dịch vụ thật trên một H100
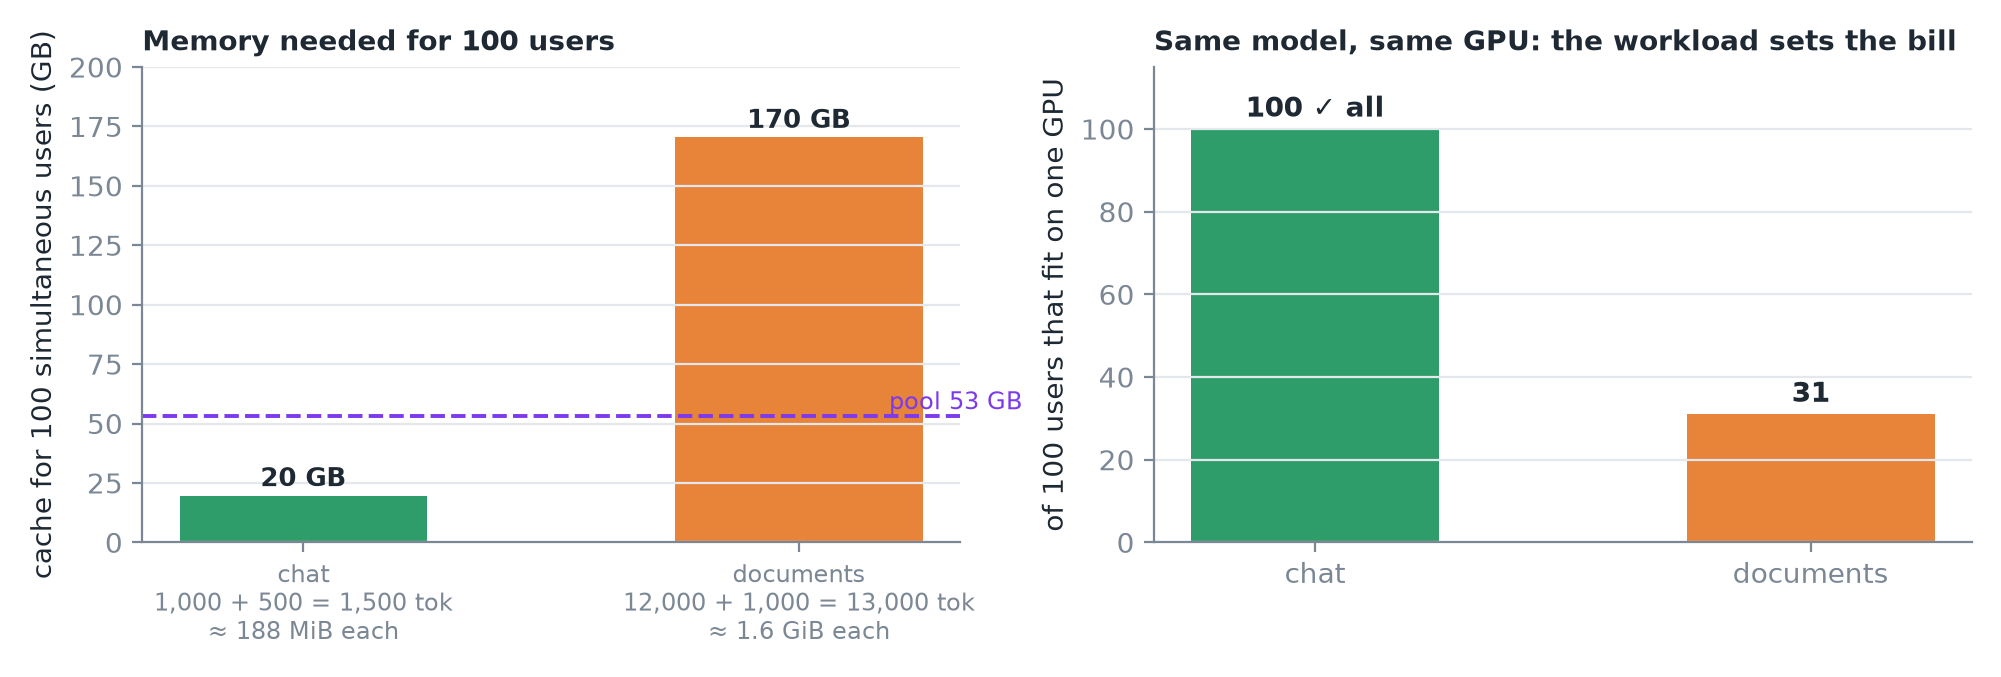 Chat: 1.500 token ≈ 190 MB mỗi người; 100 người dùng ≈ 20 GB, vừa thoải mái. Tài liệu (retrieval QA): 13.000 token ≈ 1,6 GiB mỗi người; 100 người dùng cần ≈ 170 GB, và pool chỉ chứa được ~31.
Mẹo
Cùng model, cùng GPU: workload, không phải model, quyết định hoá đơn phần cứng.
5. Điều gì dịch chuyển đường cong
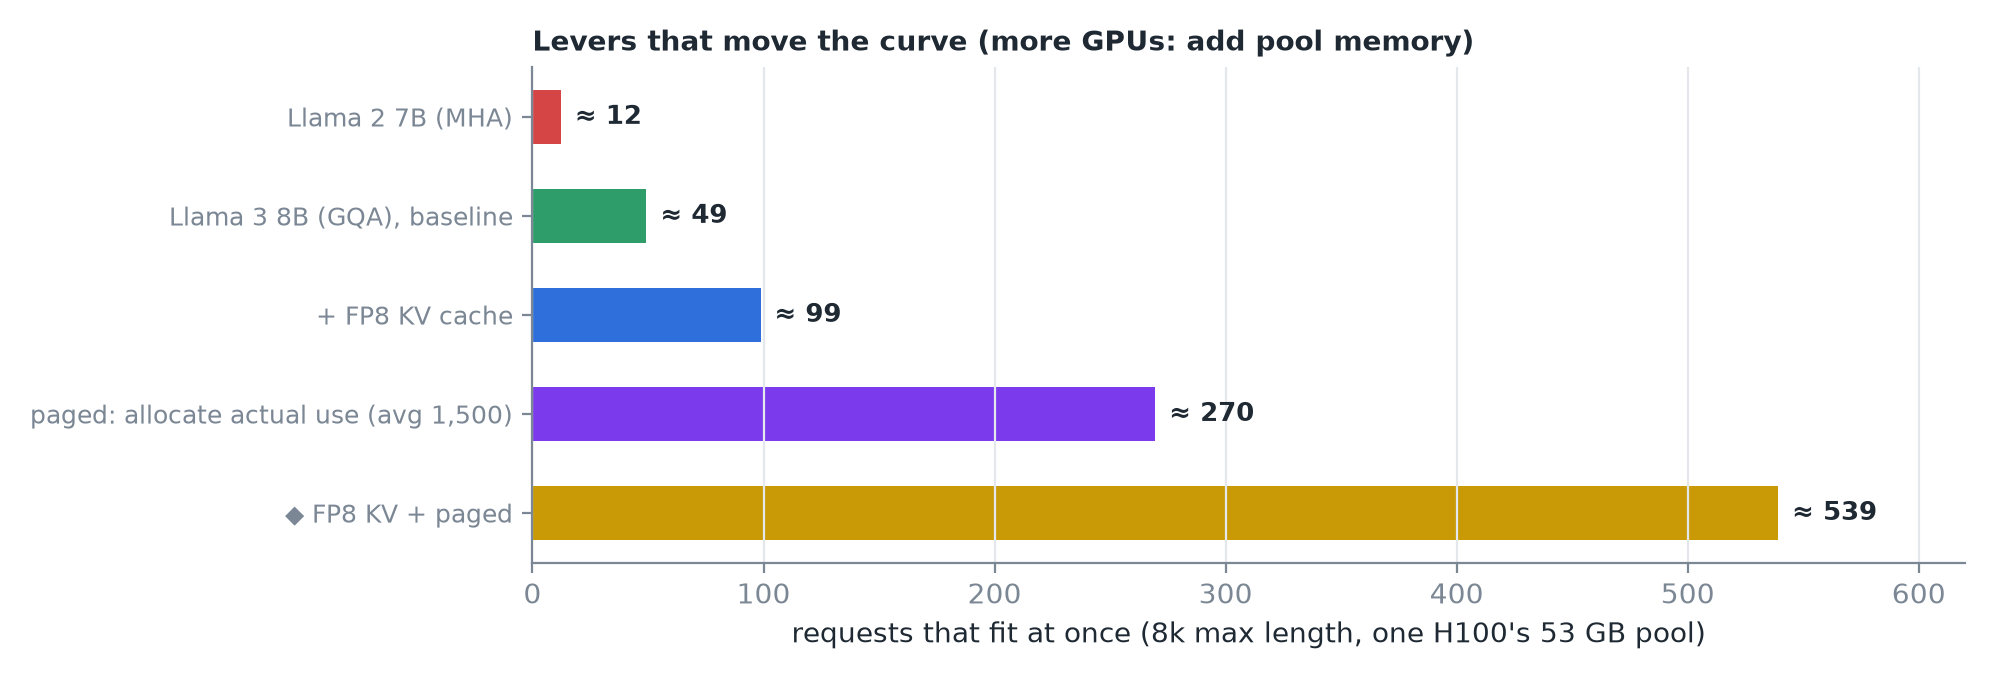
- Model: ở 8k mỗi request, Llama 2 7B chứa được ~12 request; Llama 3 8B chứa 49, phần lớn nhờ grouped-query attention.
- Độ chính xác của cache: lưu K/V ở 8-bit thay vì 16 thì pool tăng gấp đôi lên ~800 nghìn token, đổi lại một chút rủi ro về chất lượng.
- Thêm GPU: thêm bộ nhớ cho pool.
- Cấp phát: đừng đặt trước độ dài tối đa cho mọi request nữa. Cuộc hội thoại thật hiếm khi chạm giới hạn: với trung bình 1.500 token, cấp bộ nhớ khi token thực sự đến chứa được ~270 request. Đó là ý tưởng đằng sau bộ nhớ KV phân trang (paged KV memory).
Các engine như vLLM in con số này lúc khởi động dưới dạng concurrency tối đa cho một độ dài request nhất định; giờ bạn có thể kiểm tra nó bằng tay.
6. Tóm tắt