35 · Ngân sách token, max sequences và max batched tokens
Nguồn: fanout.sh / inference-eng / 07-04 · ~5,5 phút
Ghi chú
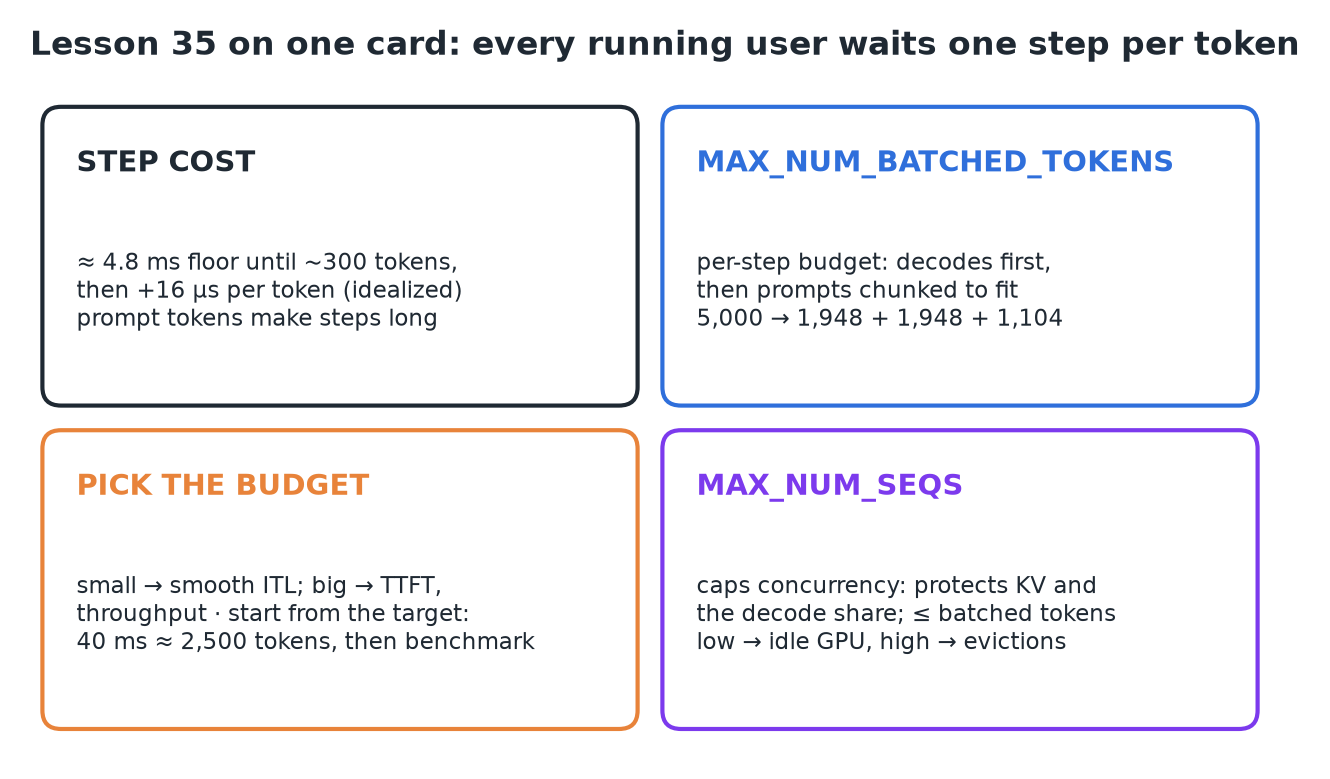
Mỗi người dùng đang giữa câu trả lời nhận một token mỗi bước, nên nếu một bước chạy lâu, tất cả đều phải chờ. Độ dài một bước do số token nó xử lý quyết định: phẳng ở mức đọc trọng số ~4,8 ms cho tới ~300 token, rồi tăng lên (lý tưởng hoá: 512 → 8 ms, 2.048 → 33 ms, 8.192 → ~130 ms). Token decode gần như miễn phí; token prompt làm bước dài ra. max_num_batched_tokens giới hạn mỗi bước: decode trước, rồi prompt được chia chunk cho vừa. Ngân sách nhỏ ưu tiên decode mượt (ITL); ngân sách lớn ưu tiên TTFT và throughput. max_num_seqs giới hạn concurrency, bảo vệ bộ nhớ KV và phần ngân sách dành cho decode. Một request chỉ được chạy sau khi qua ba cửa: một slot sequence trống, còn chỗ trong ngân sách, và còn bộ nhớ KV trống.
1. Một bước tốn bao nhiêu
Llama 3.1 8B trên H100: mỗi bước đọc toàn bộ 16 GB trọng số một lần (~4,8 ms), và mỗi token thêm ~16 GFLOP phép tính.
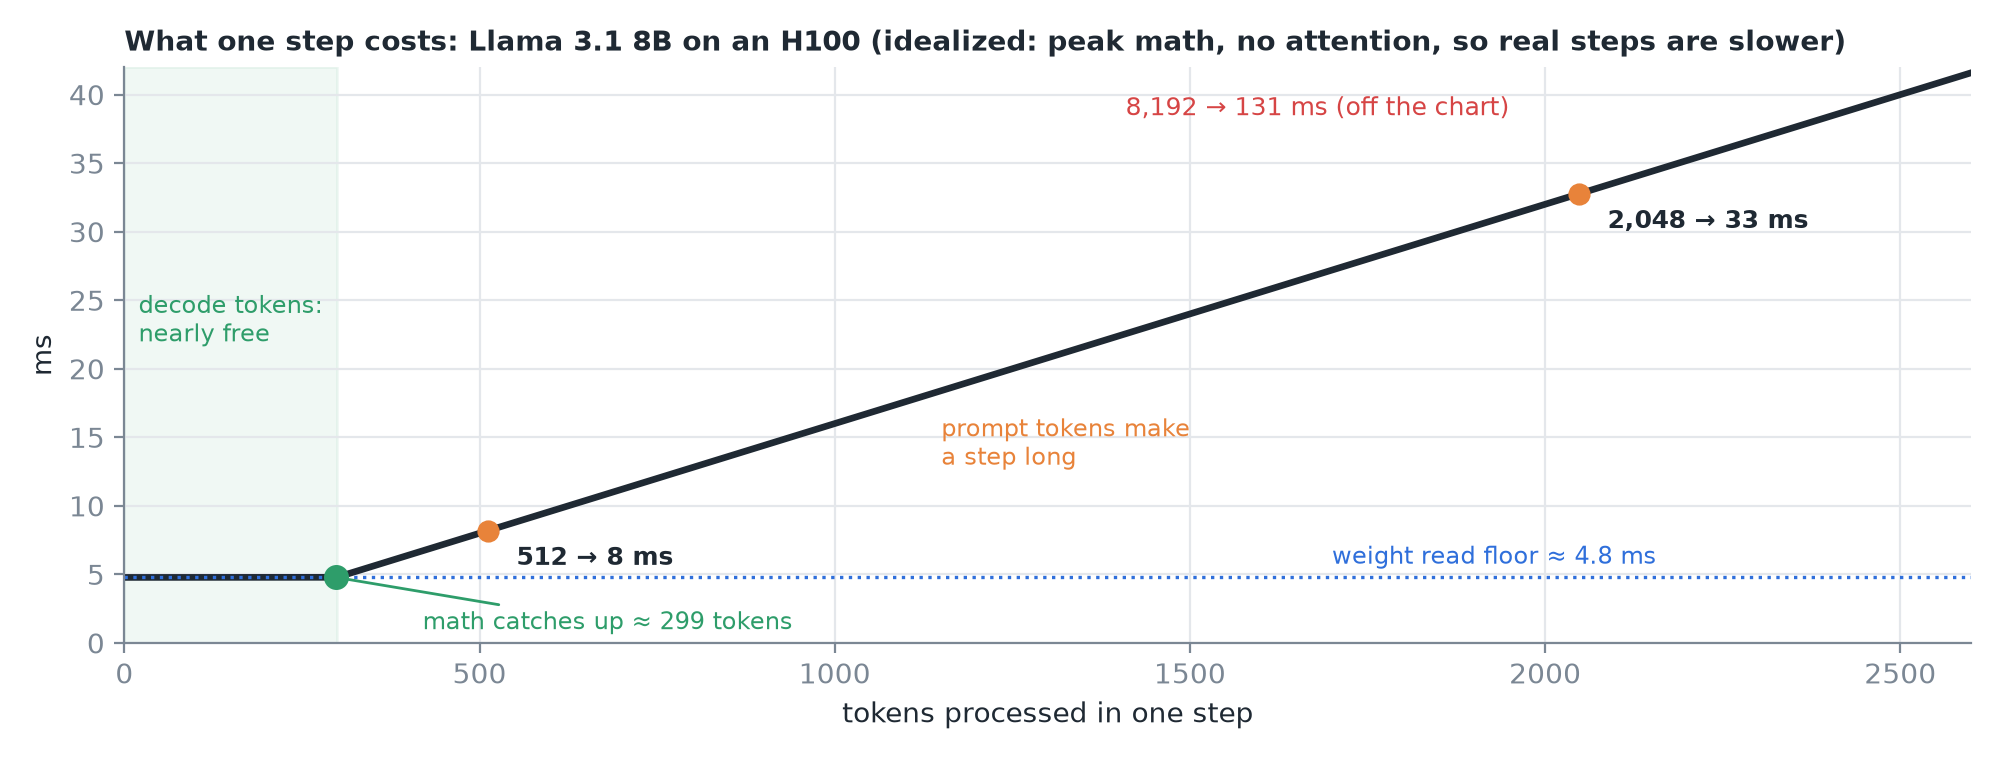 Với vài token, phép tính ẩn bên trong lần đọc trọng số, nên bước phẳng; nó đuổi kịp ở ~300 token và mỗi token sau đó thêm thời gian. Lý tưởng hoá (tính toán ở mức đỉnh, bỏ qua attention), nên bước thật chậm hơn; điều quan trọng là hình dạng.
2. max_num_batched_tokens: một ngân sách được lấp theo thứ tự cố định
Ngân sách 2.048, 100 request đang decode: chúng đi trước (mỗi cái một token, dùng 100), còn lại 1.948 cho prompt. Một prompt 5.000 token không vừa, nên nó được chia chunk:
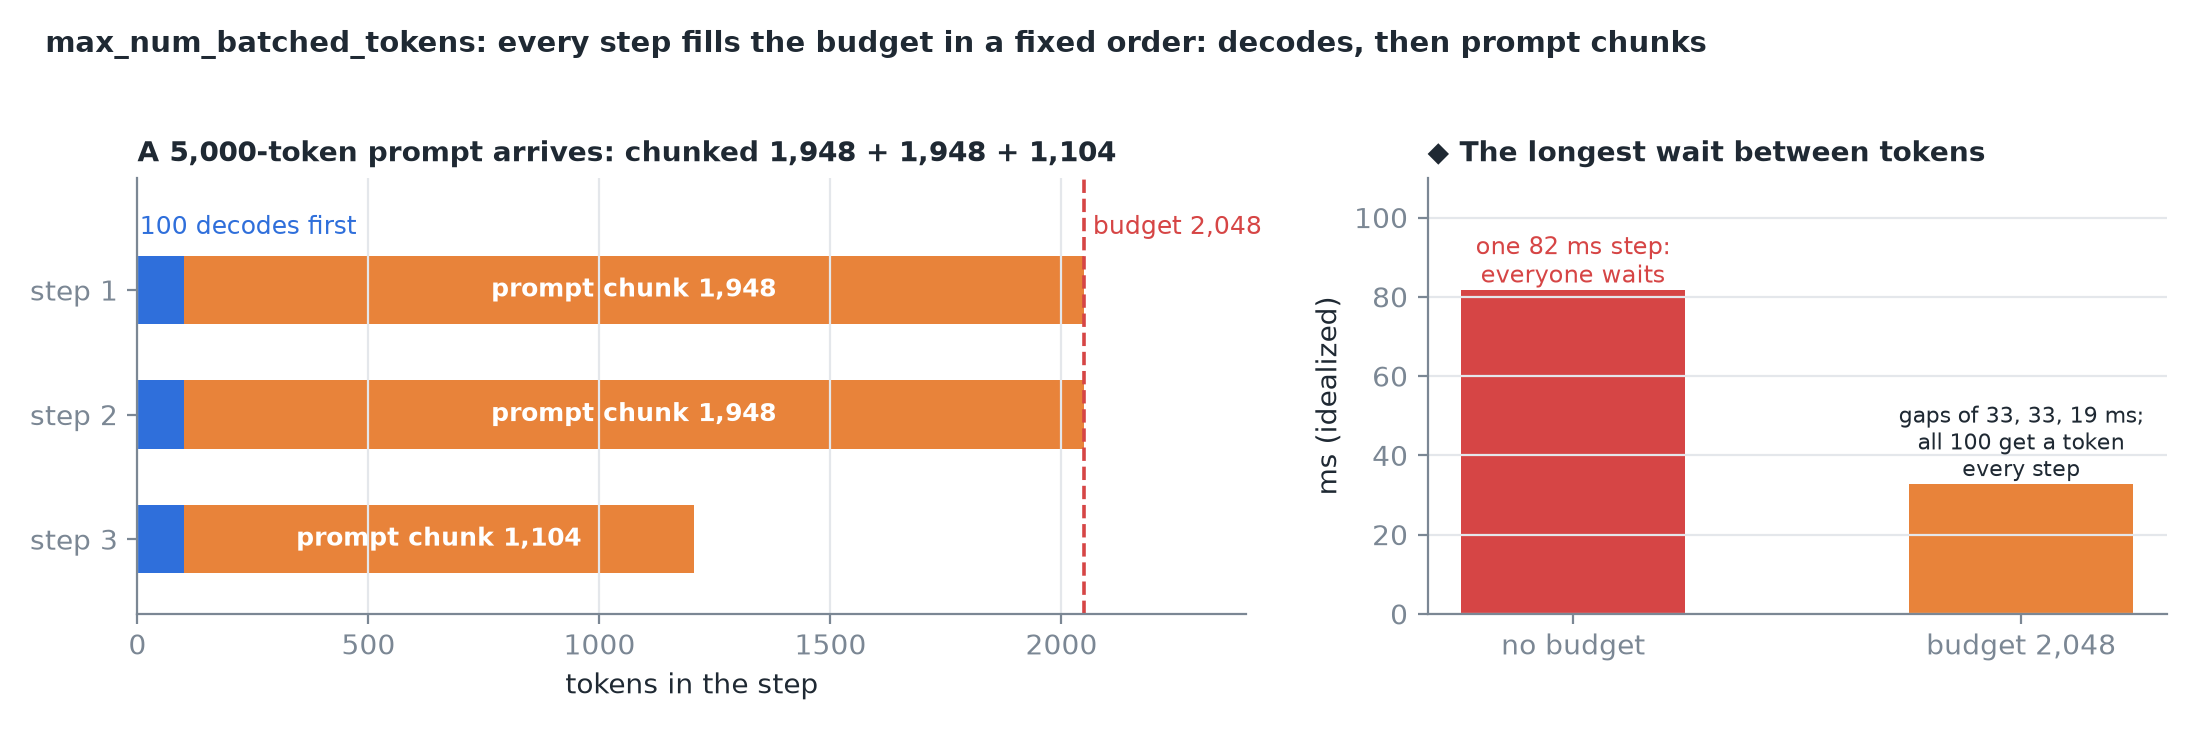 Trong lúc đó cả 100 request decode đều nhận được một token ở mỗi bước. ◆ Phải: khoảng cách dài nhất giữa các token, lý tưởng hoá, khi có và không có ngân sách.
3. Ngân sách nên lớn bao nhiêu?
| Ngân sách nhỏ | Ngân sách lớn | |
|---|---|---|
| Mỗi bước | Ngắn | Dài khi mang một chunk prompt lớn |
| Người dùng đang decode | Dòng chữ đều: inter-token latency thấp | Chờ lâu hơn ở các bước nặng prompt |
| Prompt dài | Trải ra nhiều bước: token đầu tiên đến muộn hơn | Xong trong ít bước hơn: TTFT và throughput tốt hơn |
Hướng dẫn tinh chỉnh của vLLM cũng nói vậy: giá trị nhỏ như 2.048 cho inter-token latency tốt hơn, giá trị lớn cho time to first token tốt hơn.
Bắt đầu từ mục tiêu latency của bạn. Nếu bạn muốn ít nhất 40 ms có một token, hãy tìm kích thước bước nằm dưới 40 ms trên phần cứng của bạn: 40 ms ÷ 16 µs ≈ 2.500 token trong mô hình lý tưởng hoá. Đó gần như là ngân sách của bạn; xác nhận bằng benchmark.
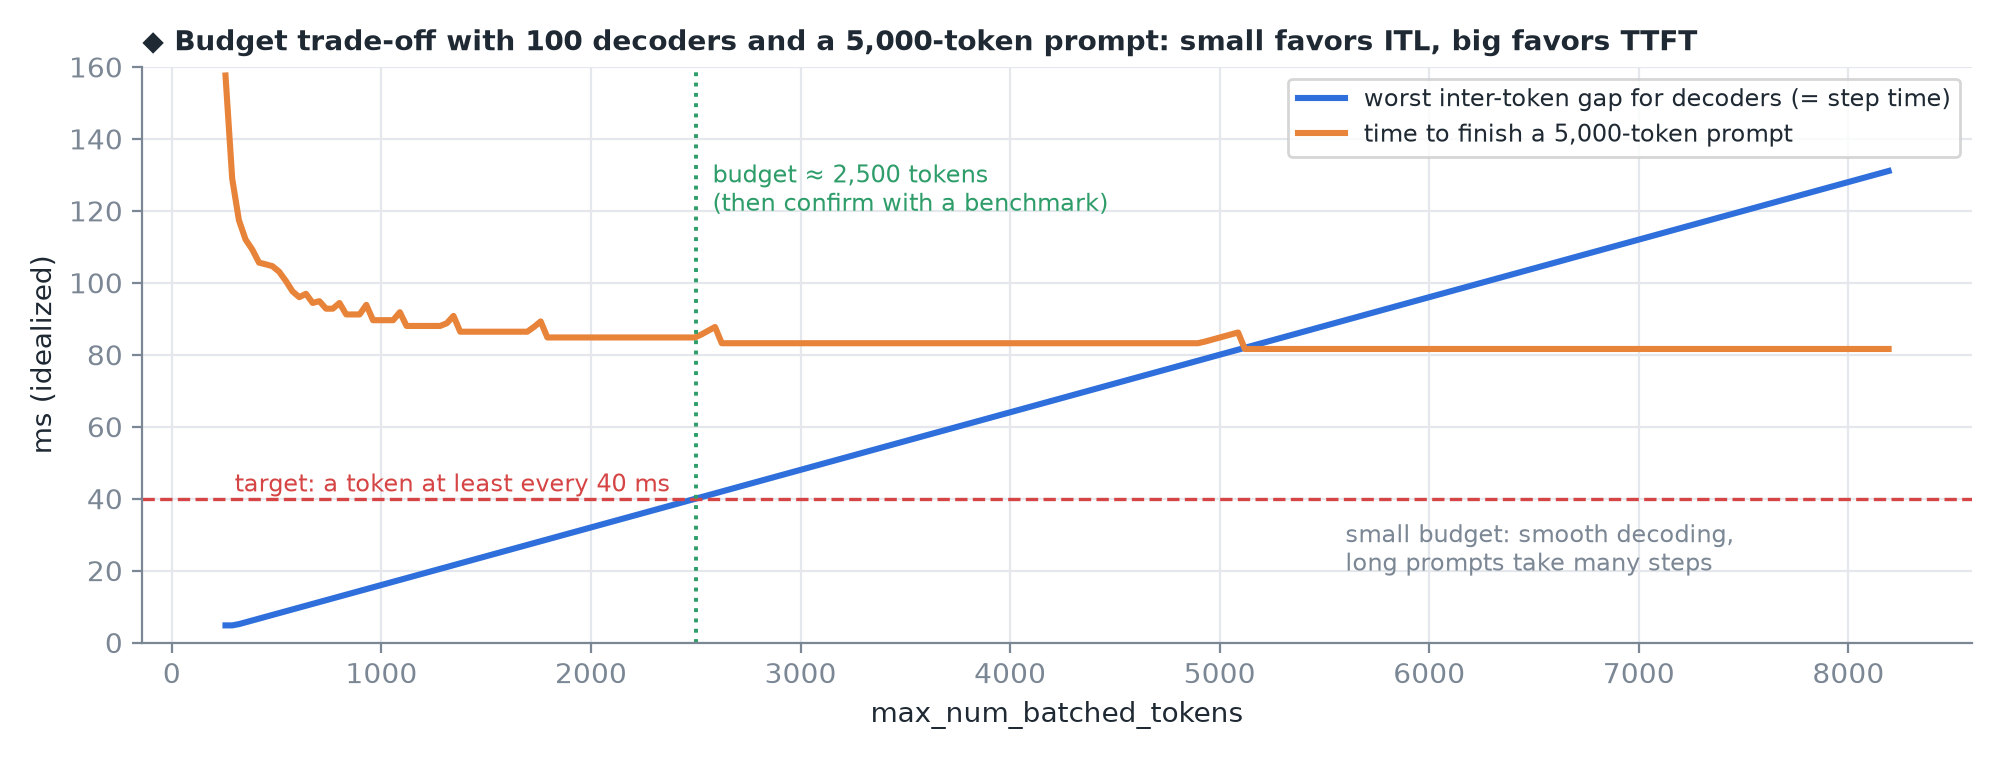 ◆ Lần quét lý tưởng hoá. Trong mô hình này tổng phép tính của prompt không đổi dù chia thế nào, nên TTFT giảm dốc tới ~1.000 token rồi đi ngang; bước thật có thêm overhead mỗi bước và attention phải đọc lại các chunk trước, nên trong thực tế ngân sách lớn hơn vẫn tiếp tục giúp TTFT.
4. max_num_seqs: giới hạn số request đang chạy
- Mỗi request đang chạy giữ một KV cache lớn dần theo từng token; quá nhiều cùng lúc thì hết bộ nhớ giữa chừng, và engine phải đuổi (evict) ai đó.
- Mỗi request đang chạy còn tiêu một token ngân sách mỗi bước, nên
max_num_seqs≤max_num_batched_tokens, nếu không riêng decode đã có thể tràn ngân sách.
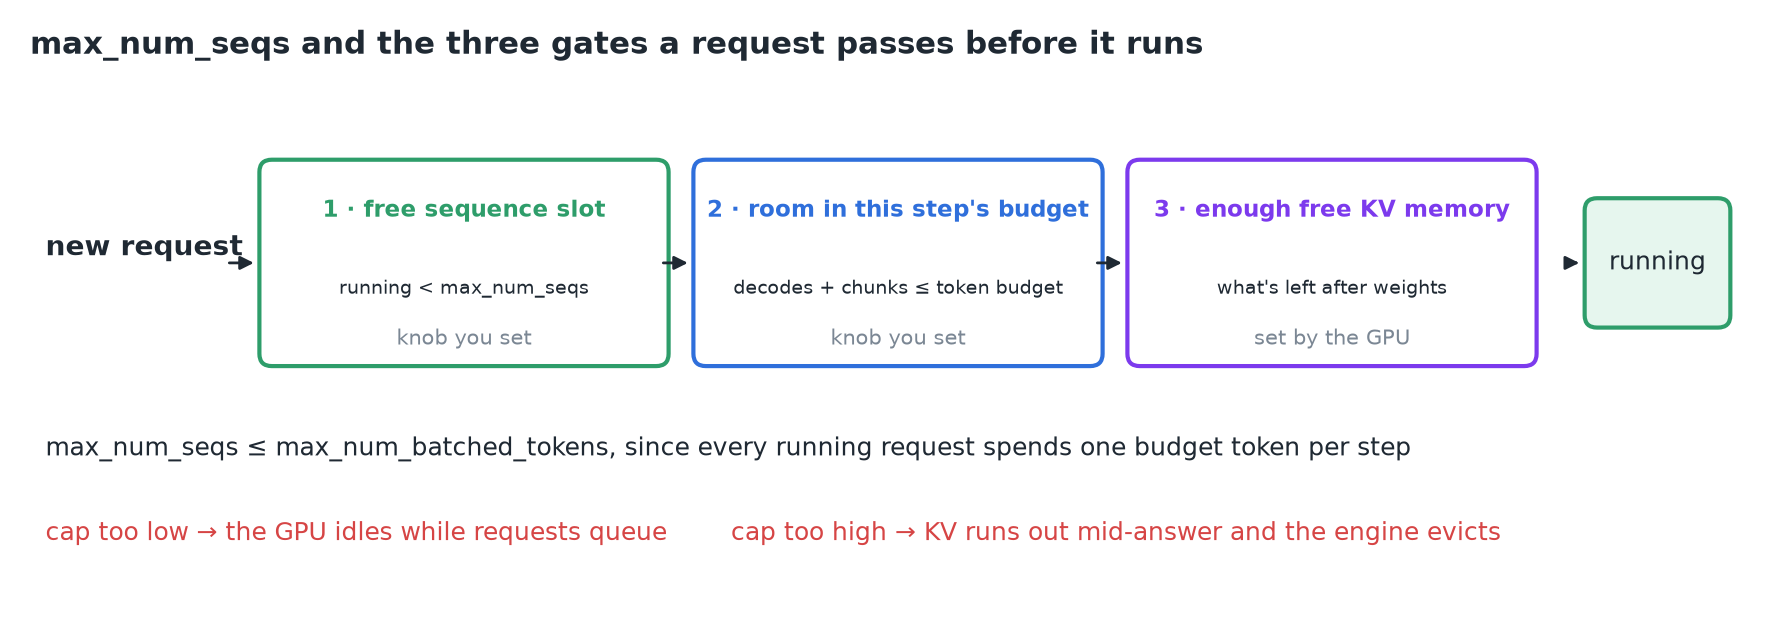 Một request mới cần một slot sequence trống, còn chỗ trong ngân sách token của bước này, và đủ bộ nhớ KV trống. Hai cái đầu là núm bạn đặt; cái thứ ba đến từ phần bộ nhớ GPU còn lại sau trọng số.
Cảnh báo
Đặt giới hạn quá thấp → GPU ngồi không trong khi request xếp hàng. Quá cao → hết bộ nhớ KV và bắt đầu phải đuổi request.
5. Tóm tắt