30 · Đọc metric của engine và trạng thái request
Nguồn: fanout.sh / inference-eng / 06-04 · bài dạng văn bản (không có video), ~8 phút
Ghi chú
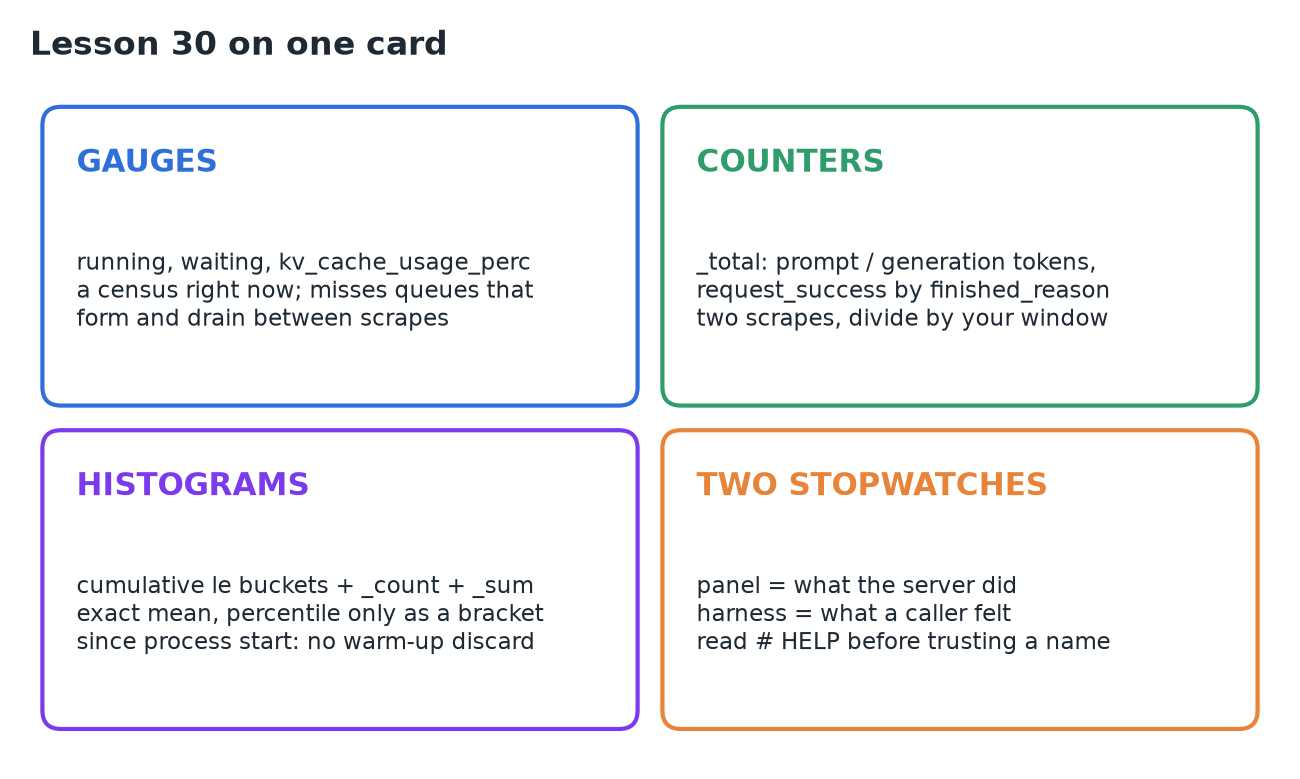
Trong lúc trả lời request, engine tự ghi sổ về chúng trên /metrics, theo định dạng văn bản của Prometheus. Có ba loại số: gauge (đang chạy, đang chờ, mức lấp KV cache: một cuộc điều tra dân số ngay lúc này), counter (_total: token và request đã xong, chỉ có nghĩa dưới dạng hiệu giữa hai lần scrape) và histogram (các bucket cộng dồn cộng _count và _sum: trung bình chính xác, nhưng percentile chỉ là một khoảng). Bảng metric cho biết server đã làm gì; một harness phía client cho biết người gọi cảm nhận gì. Giữ cả hai: một request có nhiều hơn một khoảng thời gian đúng.
1. Bảng metric và định dạng của nó
curl http://<server>/metrics trả về văn bản thuần. Mỗi dòng là một comment hoặc một sample:
# HELP vllm:num_requests_running Number of requests in model execution batches.
# TYPE vllm:num_requests_running gauge
vllm:num_requests_running{engine="0",model_name="NousResearch/Meta-Llama-3.1-8B"} 0.0
# HELPmang một câu tài liệu;# TYPEkhai báo loại số; một sample gồm tên, label trong ngoặc nhọn, và giá trị.- Hai label đi kèm mọi series của engine,
enginevàmodel_name, nên một process serve hai model vẫn giữ số liệu tách biệt. Tiền tốvllm:tách các họ metric của engine khỏi của Python runtime và web framework, vốn cùng xuất trên endpoint này. - Snapshot trong bài dài 526 dòng dưới 60 khai báo
# TYPE. ◆ Server vLLM 0.29 của tôi: 623 dòng, 86 khai báo, 66 cái làvllm:.
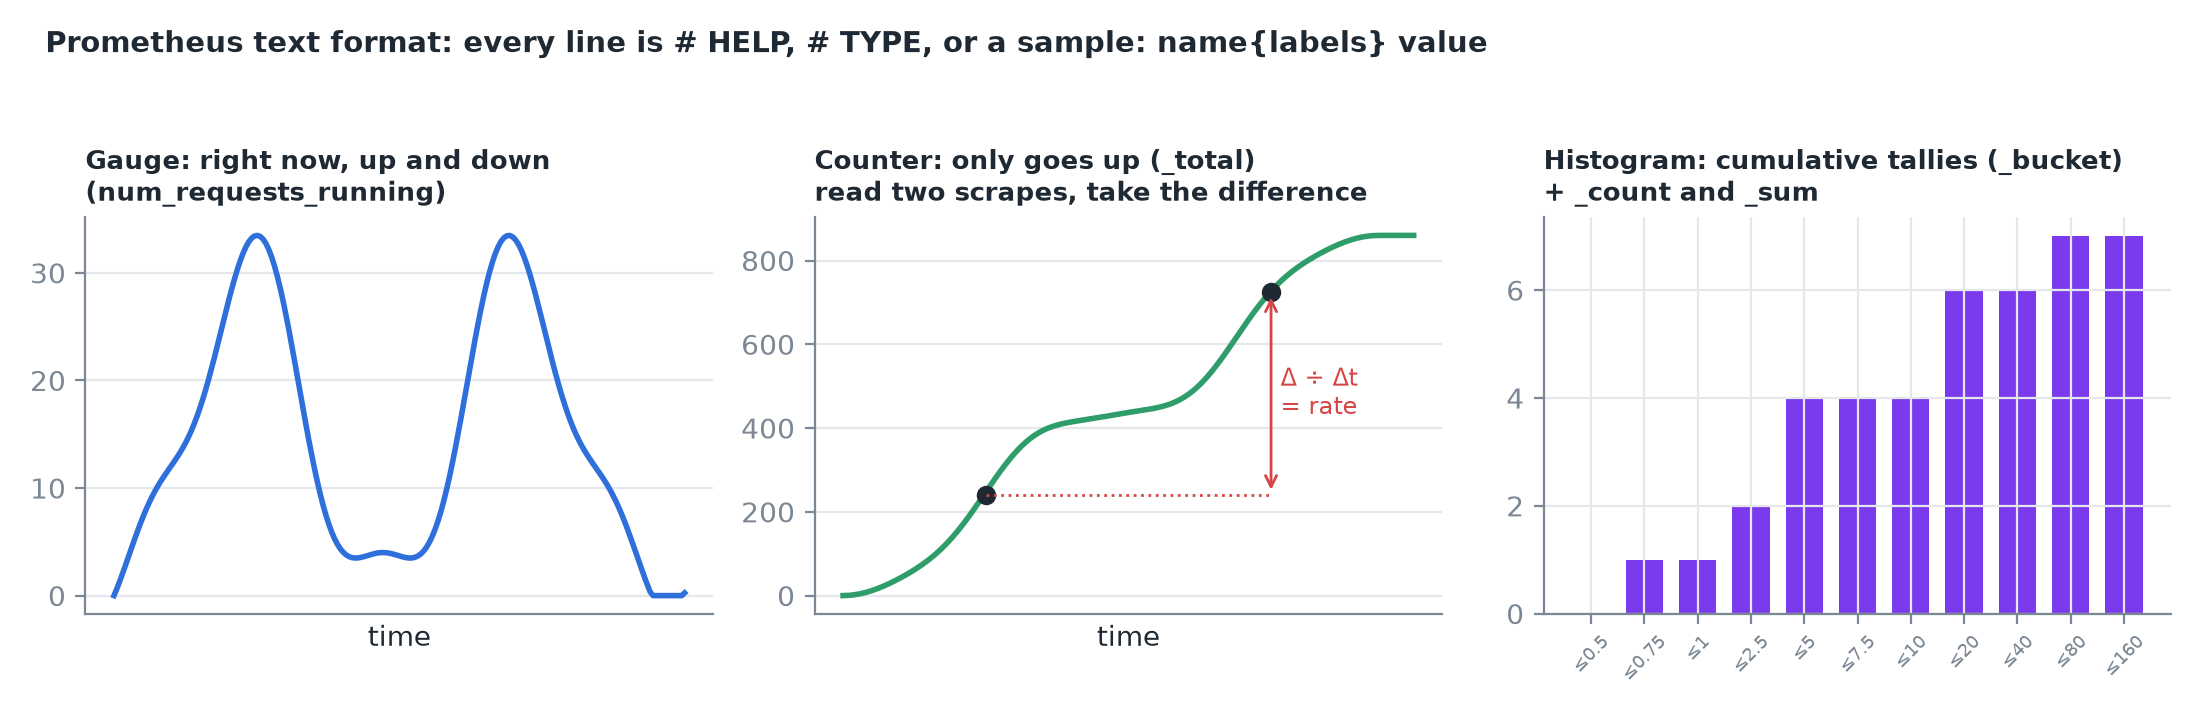 Gauge đi cả hai chiều và được đọc là "ngay lúc này"; counter chỉ tăng và được đọc dưới dạng hiệu số; histogram giữ số đếm cộng dồn cho từng ngưỡng.
2. Gauge: đang chạy, đang chờ, mức lấp cache
| Gauge | Tài liệu |
|---|---|
vllm:num_requests_running | "Number of requests in model execution batches" |
vllm:num_requests_waiting | "Number of requests waiting to be processed" |
vllm:kv_cache_usage_perc | "KV-cache usage. 1 means 100 percent usage" (là tỷ lệ, không phải phần trăm) |
- Khi có tải (mang tính đại diện, card 80 GB): 36 người gọi → running 30, waiting 6. Server báo hàng đợi trực tiếp, thay vì bạn phải suy ra từ việc token đầu tiên đến ngày càng muộn. Số running lớn hơn một nghĩa là nhiều request dùng chung một lần thực thi model.
- Mức dùng KV là mức lấp so với phần engine đặt trước lúc khởi động, không phải bộ nhớ trống của thiết bị. Bản thân cấu hình xuất hiện dưới dạng label trên một gauge thông tin luôn có giá trị 1.0 (đó là cách định dạng này công bố những dữ kiện không phải là số).
- Với
--gpu-memory-utilizationở mặc định 0.9, H100 đại diện đặt trước 393.216 token:
Sáu người gọi đang xếp hàng không thêm gì: request chưa chạy thì chưa có cache. (Trên một máy CPU nhỏ, server trong bài đặt trước 16.384 token: 2 GiB với 131.072 byte mỗi token.)
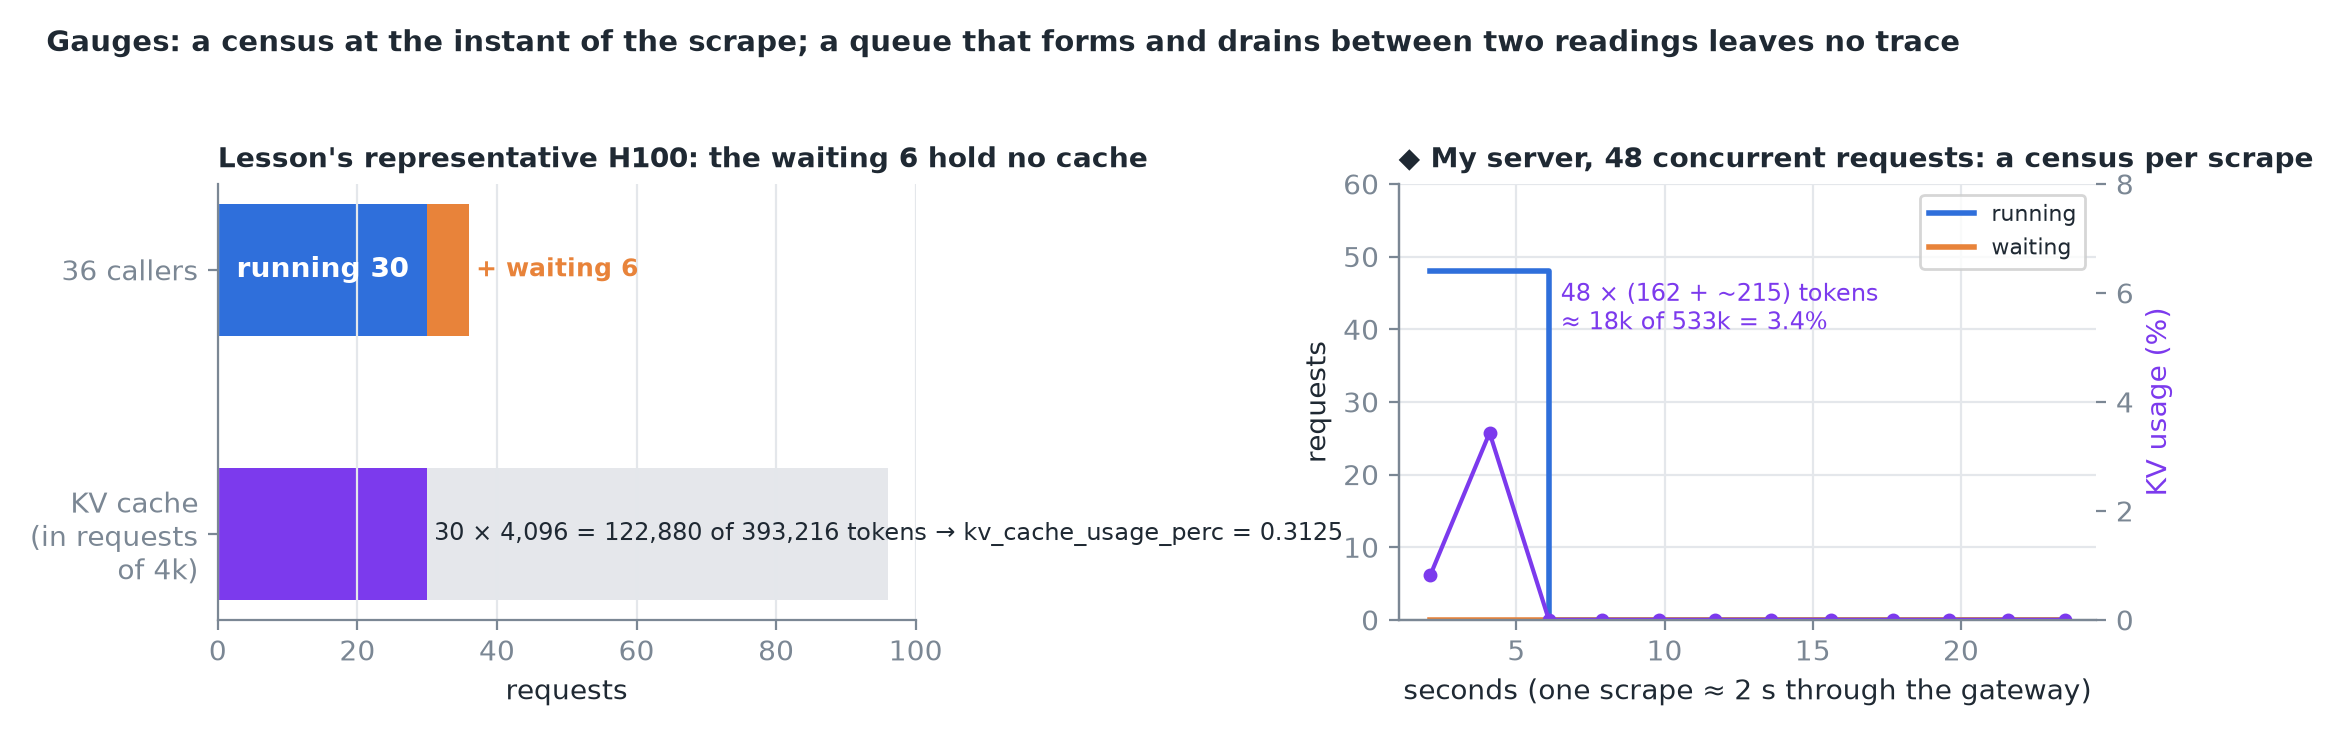 ◆ Phải: server của tôi với 48 request đồng thời. 48 × (162 prompt + ~215 đã sinh) ≈ 18 nghìn token trên phần đặt trước 533 nghìn token đọc ra 3,4%, khớp với gauge.
Cảnh báo
Gauge là cuộc điều tra tại đúng khoảnh khắc scrape. Một hàng đợi hình thành rồi tan đi giữa hai lần đọc không để lại dấu vết, nên gauge đọc 0 không phải bằng chứng là không ai phải chờ.
3. Counter và mẫu số của chúng
Counter chỉ tăng trong suốt vòng đời process (hậu tố _total), nên hiệu giữa hai lần đọc mới là thứ quan trọng.
| Counter | Đếm |
|---|---|
vllm:prompt_tokens_total | Token được đọc trong prefill |
vllm:generation_tokens_total | Token được sinh trong decode |
vllm:request_success_total{finished_reason=…} | Request đã xong, mỗi stop, length, abort một series |
- Server giữ cả hai mẫu số của một khẳng định về throughput, prompt và token sinh ra, mà không cần ai yêu cầu.
finished_reasonlà thứ không phép đo phía người gọi nào thấy được: trong bản ghi của bài, cả bốn request đều kết thúc bằnglength(chạmmax_tokens). Đó là nửa phía server của việc tính lỗi.- Bản ghi trong bài, thêm ba request giữa hai lần scrape: prompt 24 → 72 (+48), generation 44 → 140 (+96). Chia cho số giây giữa hai lần scrape là ra các dòng throughput mà benchmark in ra.
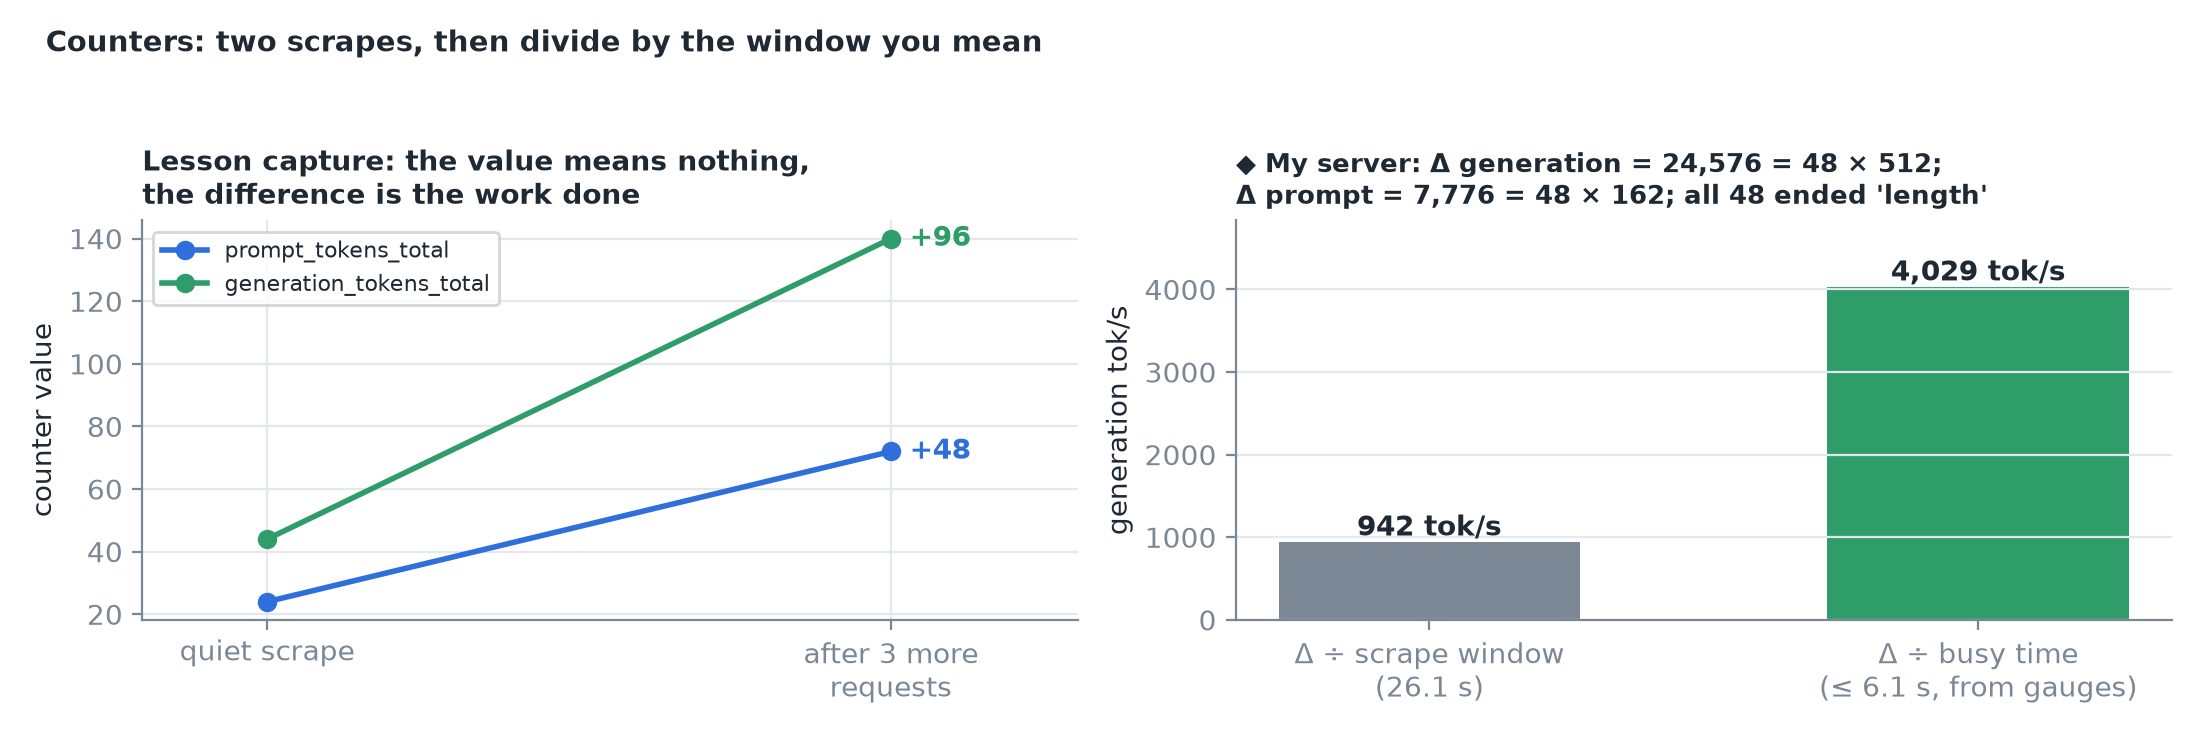 ◆ Phải: trên server của tôi, các hiệu số khớp chính xác (24.576 = 48 × 512 token sinh; 7.776 = 48 × 162 token prompt). Cùng hiệu số đó cho 942 tok/s trên cửa sổ scrape 26 s nhưng hơn 4.000 tok/s trên 6 s engine thực sự bận: cửa sổ bạn chia cho là một phần của khẳng định.
4. Histogram: số đếm thay cho dấu thời gian
vllm:time_to_first_token_seconds_bucket{le="0.75"} 1.0
vllm:time_to_first_token_seconds_bucket{le="2.5"}  2.0
vllm:time_to_first_token_seconds_bucket{le="5.0"}  4.0
vllm:time_to_first_token_seconds_bucket{le="20.0"} 6.0
vllm:time_to_first_token_seconds_bucket{le="80.0"} 7.0
vllm:time_to_first_token_seconds_bucket{le="+Inf"} 7.0
vllm:time_to_first_token_seconds_count 7.0
vllm:time_to_first_token_seconds_sum 91.898- Mỗi
_bucketđếm các quan sát nhỏ hơn hoặc bằnglecủa nó; số đếm là cộng dồn, nên+Infchứa tất cả. _sum ÷ _countlà trung bình, chính xác: 91,9 ÷ 7 = 13,1 s tới token đầu tiên trên một máy CPU phải đọc 16 GB trọng số từ bộ nhớ thường ở mỗi bước.- Hình dạng phân phối vẫn còn dù không giữ một dấu thời gian nào: một request dưới 0,75 s, ba cái trong khoảng 1 tới 5 s, hai cái trong khoảng 10 tới 20 s, một cái trong khoảng 40 tới 80 s.
- Percentile chỉ trả về được một khoảng: trung vị của 7 là quan sát thứ 4, nằm trong (2,5; 5,0] s với token đầu tiên. Với latency end-to-end, các bucket trong bài đặt nó vào (60; 120] s, trong khi
_sum ÷ _count= 501,2 ÷ 7 = 71,6 s là đại lượng tóm tắt chính xác duy nhất. - Các ngưỡng được cố định trong mã nguồn engine (0,001; 0,005; 0,01 … 2560). Vứt bỏ dấu thời gian là sự đánh đổi để server công bố latency mãi mãi với chi phí cố định.
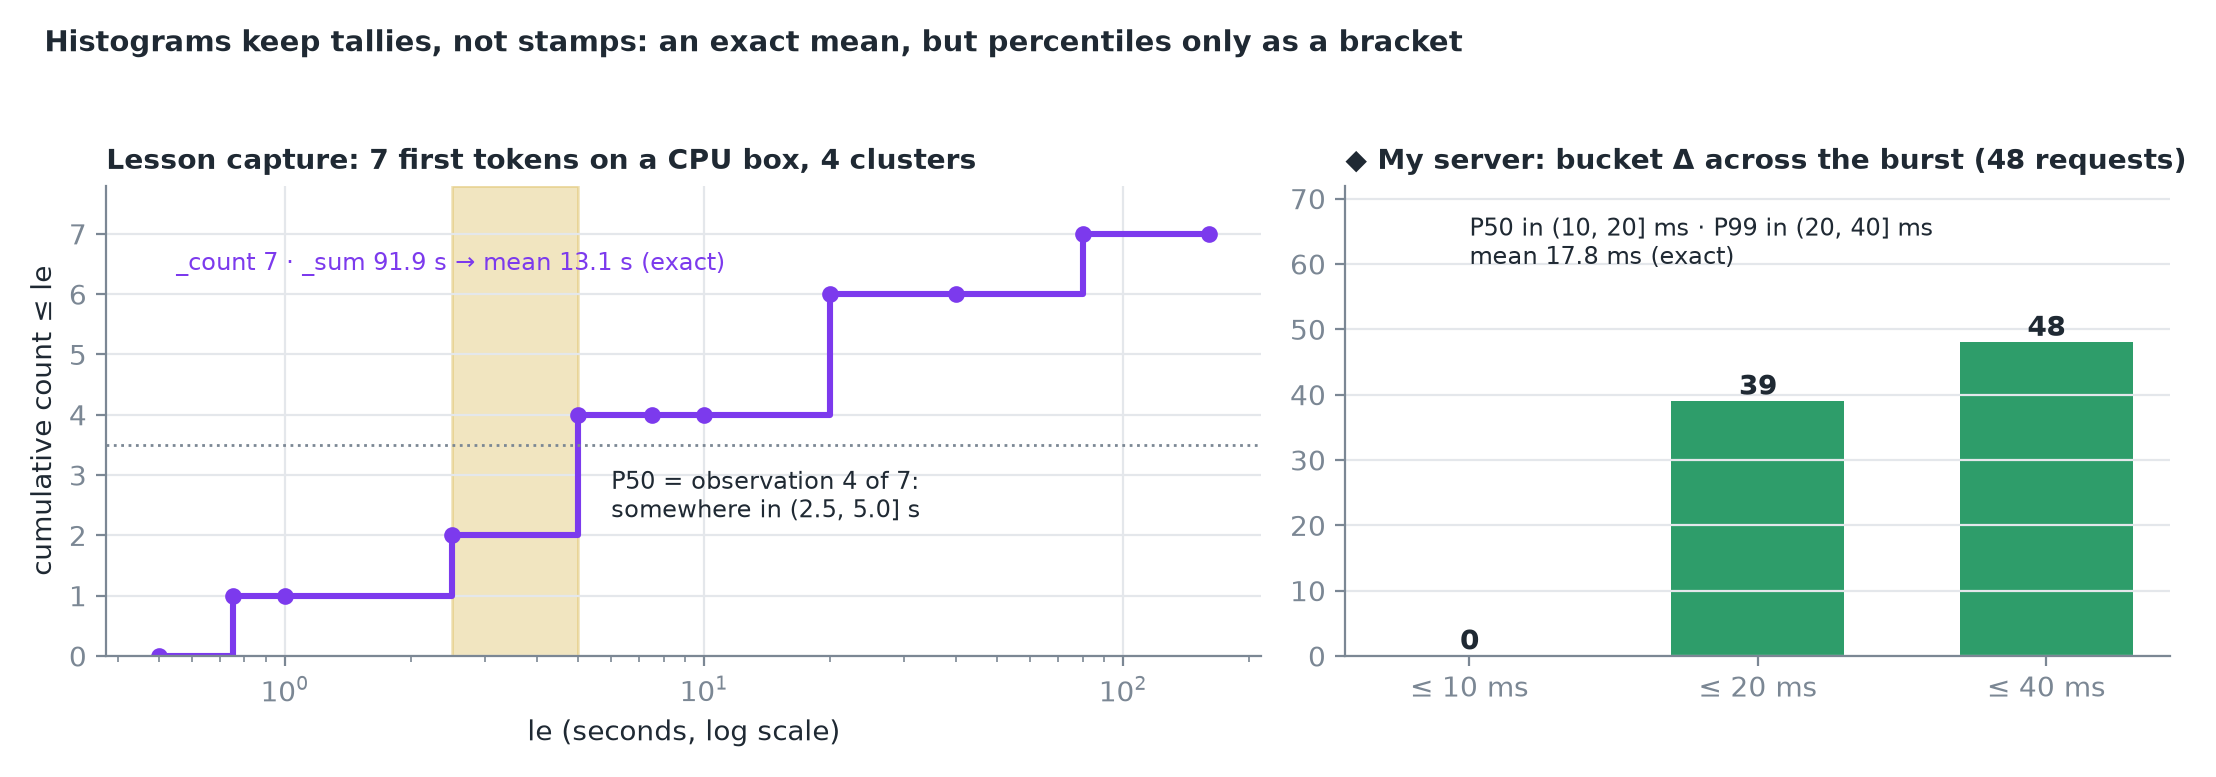 ◆ Phải: trừ các bucket của server tôi trước và sau một đợt 48 request khôi phục được phân phối riêng của cửa sổ đó: P50 trong (10; 20] ms, P99 trong (20; 40] ms, trung bình 17,8 ms.
Thận trọng
Histogram cộng dồn kể từ khi process khởi động, giống counter. Không có chuyện bỏ đi phần warm-up: request đầu tiên trong ngày nằm mãi trong _sum và mọi bucket. Hai lần scrape là cách quay lại: trừ bucket của snapshot này cho snapshot kia là phân phối theo cửa sổ trở về.
5. Một request, nhìn từ bên ngoài
Engine còn tường thuật theo một bộ hẹn giờ mười giây:
INFO … Engine 000: Avg prompt throughput: 0.6 tokens/s,
  Avg generation throughput: 0.1 tokens/s, Running: 1 reqs,
  Waiting: 0 reqs, GPU KV cache usage: 0.1%,
Prefix cache hit rate: 0.0%- Những nhịp đó là các gauge viết thành văn xuôi; chúng tụt xuống mức DEBUG khi mọi trường throughput bằng 0, nên engine rảnh thì im lặng.
- Trong dấu vết của một request, trường prompt throughput khác 0 đúng một lần (lượt prefill, dưới dạng tốc độ); sau đó là hàng phút
Running: 1 reqstrong lúc câu trả lời được stream về; rồiEngineCore waiting for workvà dòng access log của web framework.
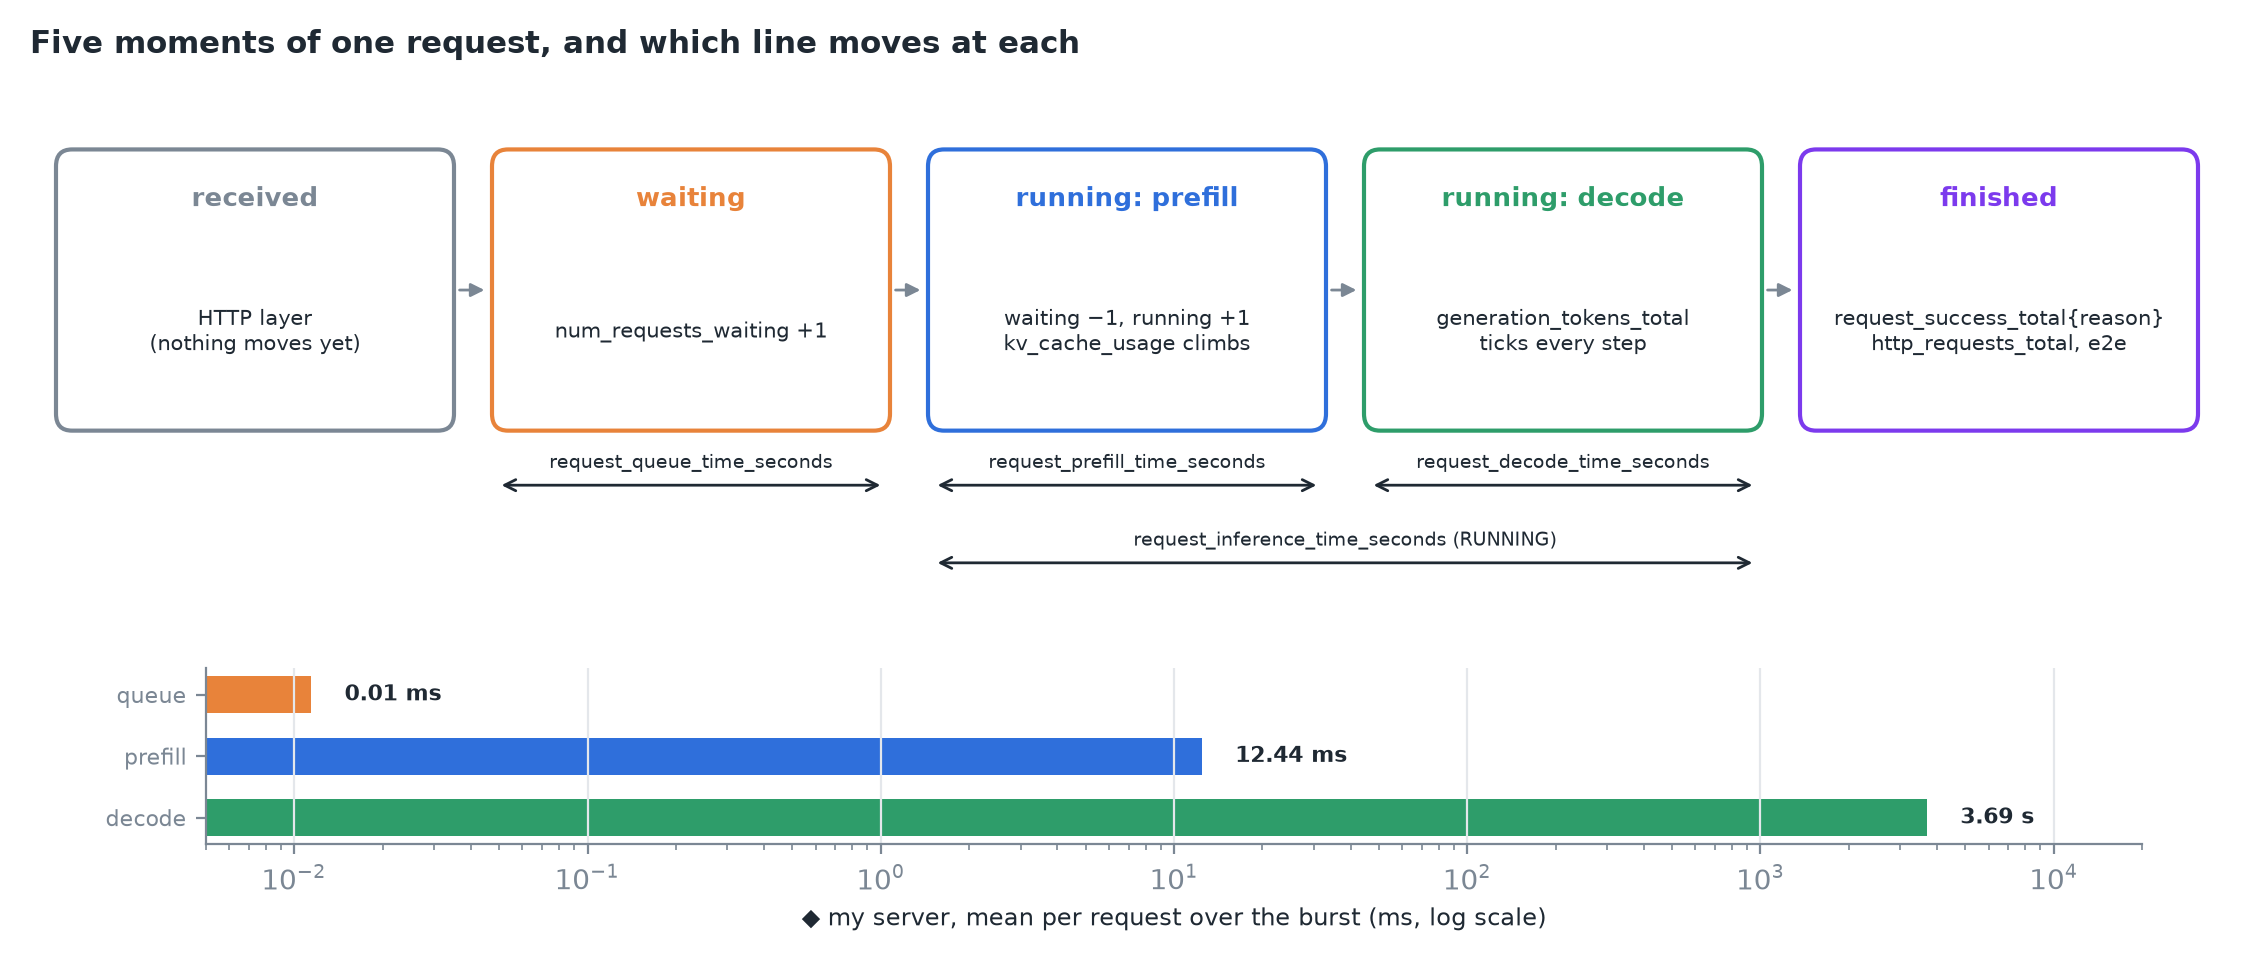 Nhận, chờ, chạy (prefill), chạy (decode), xong. Các gauge là cuộc điều tra các trạng thái ở giữa; histogram theo pha ghi lại mỗi trạng thái đã tốn bao nhiêu khi request kết thúc. ◆ Dưới: trung bình trên server của tôi qua đợt dồn: hàng đợi ≈ 0, prefill 12 ms, decode 3,7 s.
Không gì trên bảng metric theo dấu một request qua dải trạng thái đó; log thì có. Và bảng metric gọi tên các trạng thái mà không nói chúng nằm ở đâu: các bước chuyển thuộc về một thứ mà log chỉ nêu tên, EngineCore.
6. Hai đồng hồ bấm giờ trên cùng một request
| Harness phía client | Bảng metric của engine | |
|---|---|---|
| Đồng hồ bắt đầu | Trước khi mở kết nối | Khi request tới engine |
| Đồng hồ dừng | Khi một chunk tới code của bạn | Khi token rời engine core |
| Bao gồm | Thiết lập kết nối, truyền hai chiều, event loop của client | Chỉ thời gian của engine |
| Tập dữ liệu | Cửa sổ bạn khai báo, request bạn đã gửi | Mọi request từ lúc khởi động, của bất kỳ ai; bỏ sót request bị từ chối trước khi tới engine |
- Web framework giữ histogram thời lượng riêng: qua bảy lần hoàn thành trong bài,
http_request_duration_seconds_sum= 501,495 so với 501,214 của engine, nên 0,28 s ÷ 7 ≈ 40 ms mỗi request cho việc đóng khung và giao nhận bên trong process server. Một baseline loopback đo phần còn lại của đường đi vào khoảng 78 ms mỗi request. - Snapshot lúc yên tĩnh có 5 POST ở tầng HTTP so với 4 lần thành công của engine: request bị từ chối trước khi tới engine là vô hình với mọi dòng
vllm:.
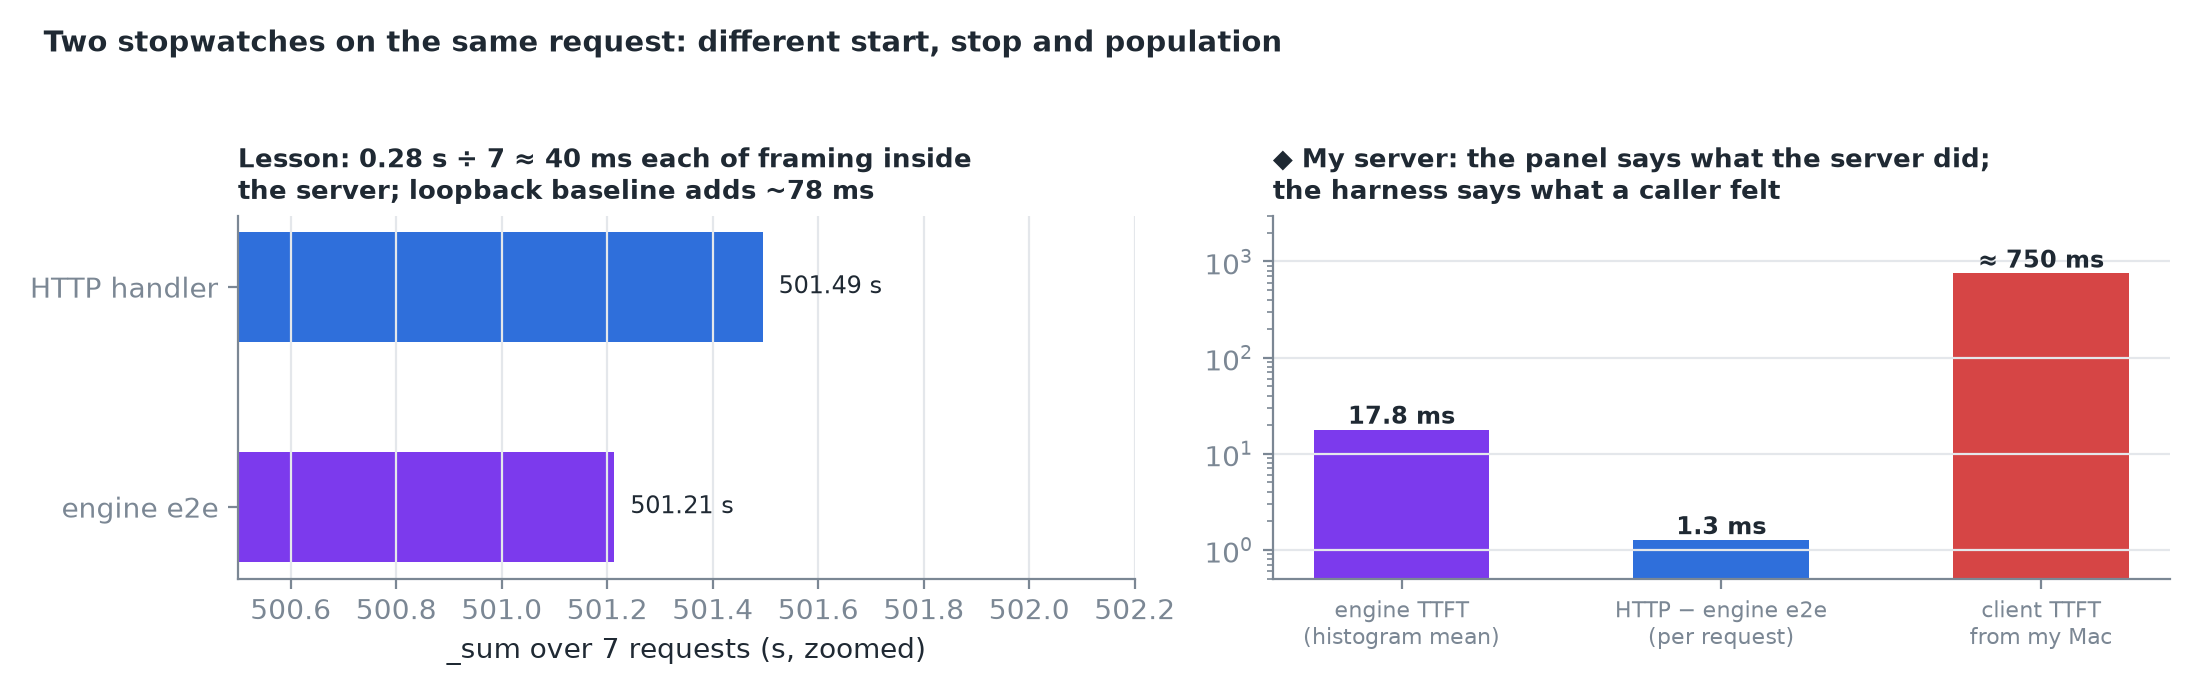 ◆ Phải: trên server của tôi, engine báo token đầu tiên 18 ms và 1,3 ms đóng khung HTTP mỗi request, trong khi một client trên máy Mac của tôi thấy khoảng 750 ms. Không bên nào sai; chúng trả lời những câu hỏi khác nhau.
Mẹo
Đọc # HELP trước khi tin một cái tên (các phiên bản đổi tên và deprecate metric), và lấy hai lần scrape trước khi trích dẫn một tốc độ.
7. Mỗi dòng trả lời câu hỏi gì
| Bạn muốn biết | Dòng cần đọc | Loại |
|---|---|---|
| Ngay lúc này có gì đang xếp hàng không? | vllm:num_requests_waiting | gauge |
| Bao nhiêu request dùng chung lần thực thi hiện tại? | vllm:num_requests_running | gauge |
| Bao nhiêu phần cache đã có chủ? | vllm:kv_cache_usage_perc | gauge |
| Bao nhiêu việc đã đi qua? | vllm:prompt_tokens_total, vllm:generation_tokens_total | counter |
| Request kết thúc thế nào, và bao nhiêu cái? | vllm:request_success_total theo finished_reason | counter |
| Người gọi chờ token đầu tiên bao lâu? | vllm:time_to_first_token_seconds | histogram |
| Thời gian của một request đi đâu? | vllm:request_queue_time_seconds, …_prefill_…, …_decode_… | histogram |
8. Tóm tắt