03 · Các cấp độ của Inference Engineering
Nguồn: fanout.sh / inference-eng / in-04 · ~9 phút
Ghi chú
"Inference engineering" bao gồm bốn công việc rất khác nhau, dễ hình dung nhất như một chiếc thang: user, operator, optimizer, engine builder. Mỗi cấp hỏi một câu hỏi riêng, và mỗi cấp sẽ dễ hơn khi bạn hiểu cấp bên dưới. Các cấp không phải chức danh hay thâm niên, và cao hơn không có nghĩa là tốt hơn: phần lớn tiền tiết kiệm được nằm ở ba cấp đầu. Kỹ năng then chốt là nhận ra một vấn đề thực sự thuộc cấp nào.
Hai kỹ sư cùng "làm inference": một người giảm một nửa hoá đơn model chỉ bằng cách chuyển một khối văn bản lên đầu prompt; người kia viết lại một kernel attention để được +11% token/s trên cùng GPU. Cùng một từ, hai công việc khác nhau.
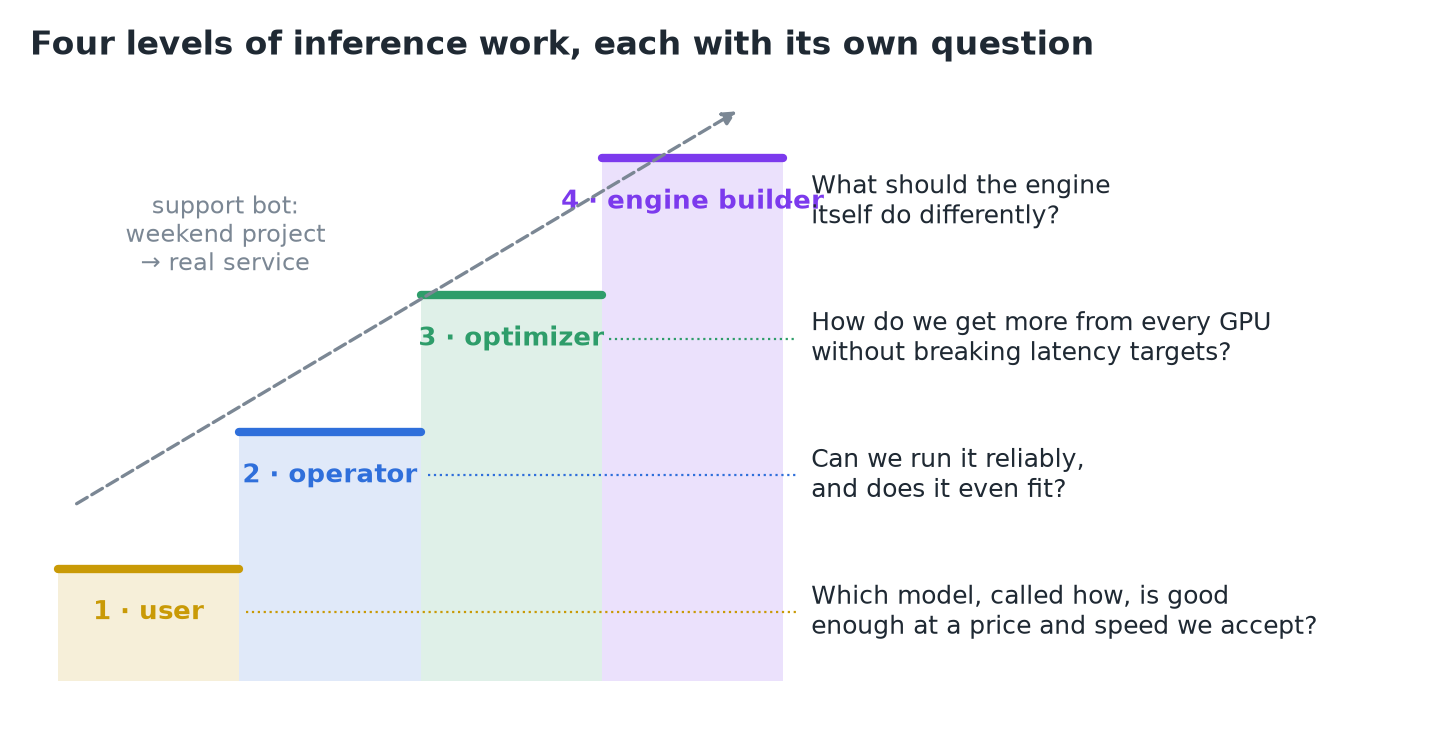 Ví dụ xuyên suốt, một bot hỗ trợ khách hàng, leo từ dự án cuối tuần lên thành dịch vụ thật.
1. Cấp 1, user: người khác chạy GPU
Bạn gọi một model được host sẵn qua API. Bạn không kiểm soát phần cứng, nhưng kiểm soát được model nào, độ dài prompt, bao nhiêu token đầu ra, và có stream hay không.
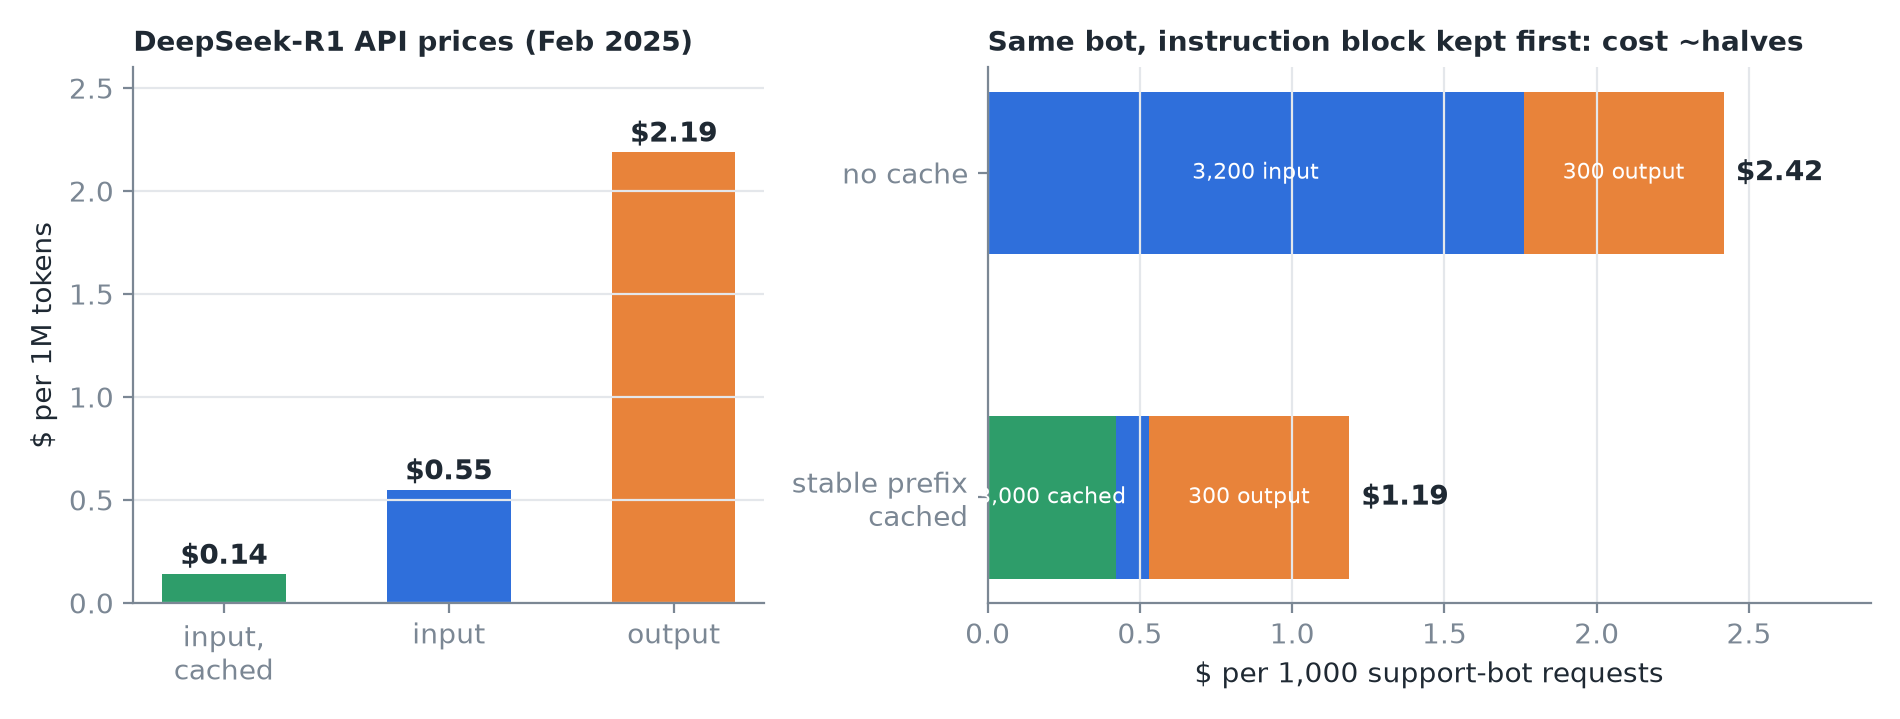 Trái: đầu ra đắt hơn đầu vào ~4 lần; đầu vào đã cache rẻ hơn ~4 lần so với chưa cache. Phải: chi phí của bot cho mỗi 1.000 request khi có và không có khối hướng dẫn được cache.
- Giá DeepSeek-R1 (tháng 2/2025): 0,55 USD/triệu token đầu vào, 2,19 USD/triệu token đầu ra (~4 lần, vì sinh token là phần chậm), 0,14 USD/triệu token đầu vào đã cache.
- Bot gửi một khối hướng dẫn 3.000 token + câu hỏi ~200 token, nhận về ~300 token. Giữ khối đó giống hệt nhau và nằm ngay đầu để trúng cache của nhà cung cấp:
Quan trọng
Mỗi 1.000 request, hoá đơn giảm gần một nửa mà không đụng tới GPU nào: chỉ cần biết engine của nhà cung cấp hoạt động bên dưới ra sao.
2. Cấp 2, operator: có vừa không, và có chạy ổn định không?
Công ty muốn chạy model riêng trên GPU riêng (vì chi phí, quyền riêng tư, quyền kiểm soát).
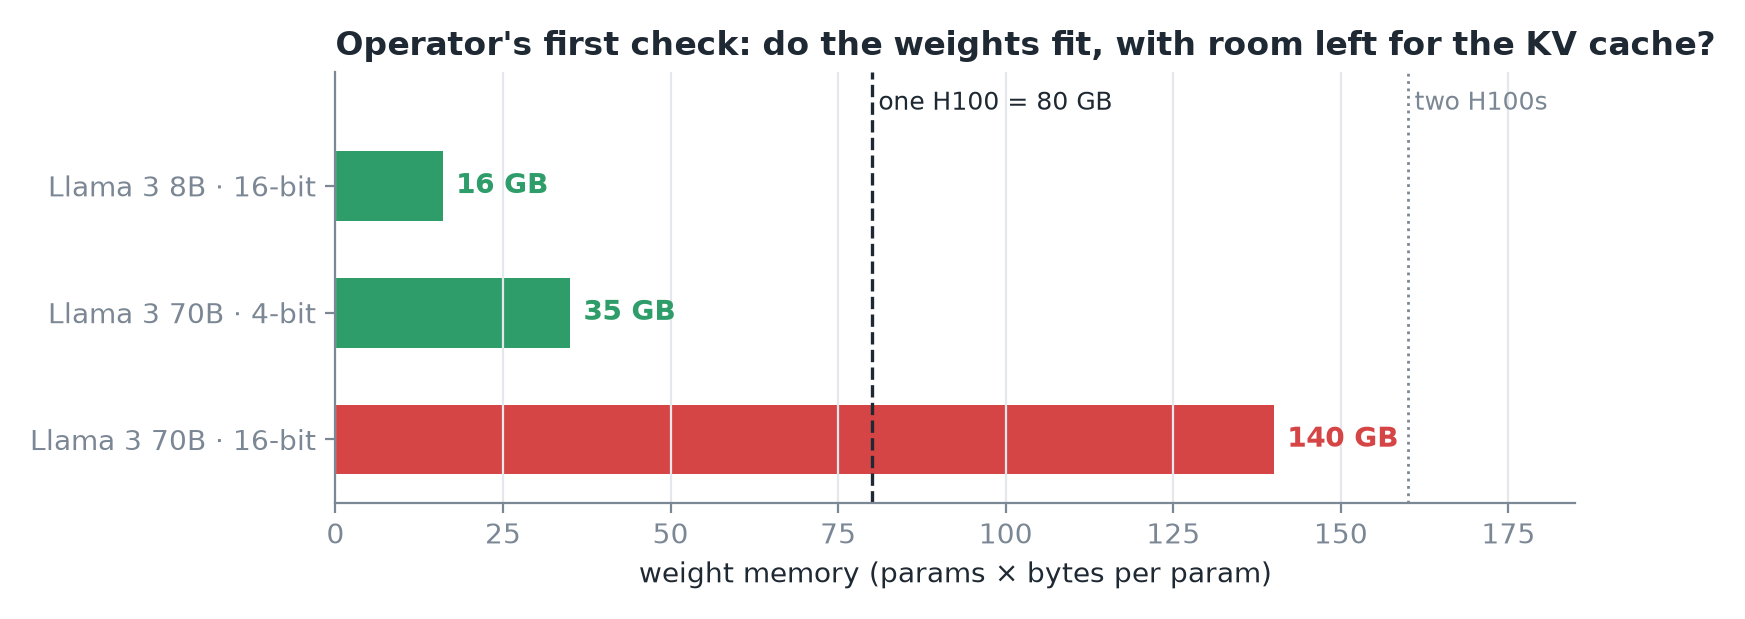 Trọng số so với 80 GB của một H100: 8B vừa và còn chỗ cho cache; 70B ở 16-bit cần hai GPU hoặc 4-bit.
- Kiểm tra độ vừa chỉ là số học: Llama 3 8B ở 16-bit ≈ 16 GB trên 80, dư nhiều cho KV cache. Llama 3 70B ≈ 140 GB: phải chia ra nhiều GPU, hoặc lượng tử hoá xuống 4-bit ≈ 35 GB.
- Khởi động một engine chỉ cần một lệnh (
vllm serve ...) và có ngay API tương thích OpenAI mà code của bạn đã dùng. - Nhưng giờ bạn phải lo những gì API từng che đi: nạp 16 GB khi khởi động, sống sót khi GPU hỏng, triển khai phiên bản model mới mà không làm rơi request.
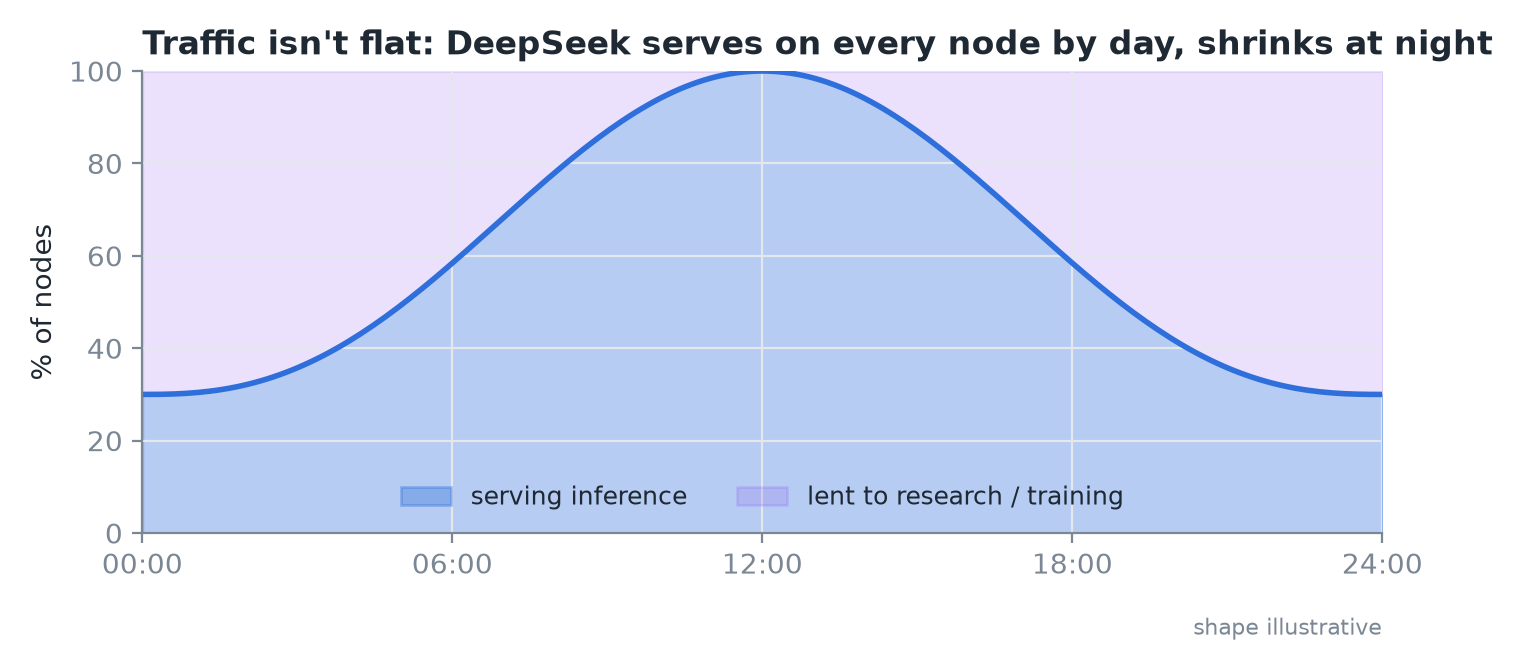 DeepSeek chạy inference trên mọi node vào giờ cao điểm và cho nghiên cứu, huấn luyện mượn GPU vào ban đêm.
3. Cấp 3, optimizer: vắt thêm từ mỗi GPU, trong giới hạn latency
Đo trước: time to first token, time per output token, tổng throughput, chi phí cho mỗi triệu token. Sau đó kéo từng đòn bẩy một.
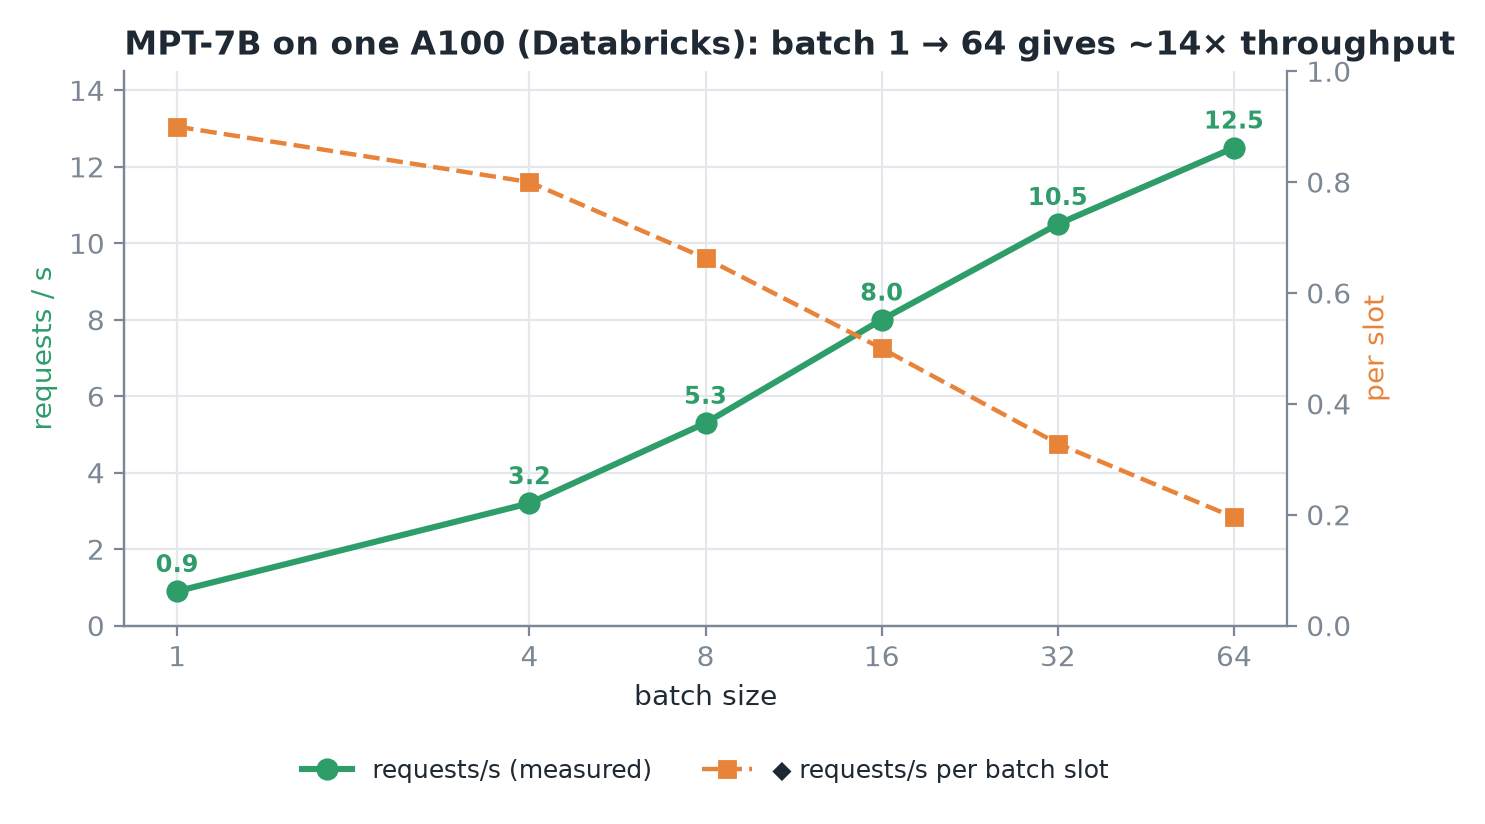 Databricks: MPT-7B trên một A100, batch 1 → 64 đưa throughput từ 0,9 lên 12,5 request/s.
| Đòn bẩy | Được gì |
|---|---|
| Batching | Nhiều người dùng chia nhau mỗi bước (~14 lần trong phép đo trên) |
| Lượng tử hoá (quantization) | Mỗi bước phải chuyển ít byte hơn |
| Prefix caching | Prompt lặp lại thì bỏ qua được phần việc |
| Speculative decoding | Một bước có thể tạo ra nhiều token |
Ở quy mô fleet, các đòn bẩy còn lớn hơn:
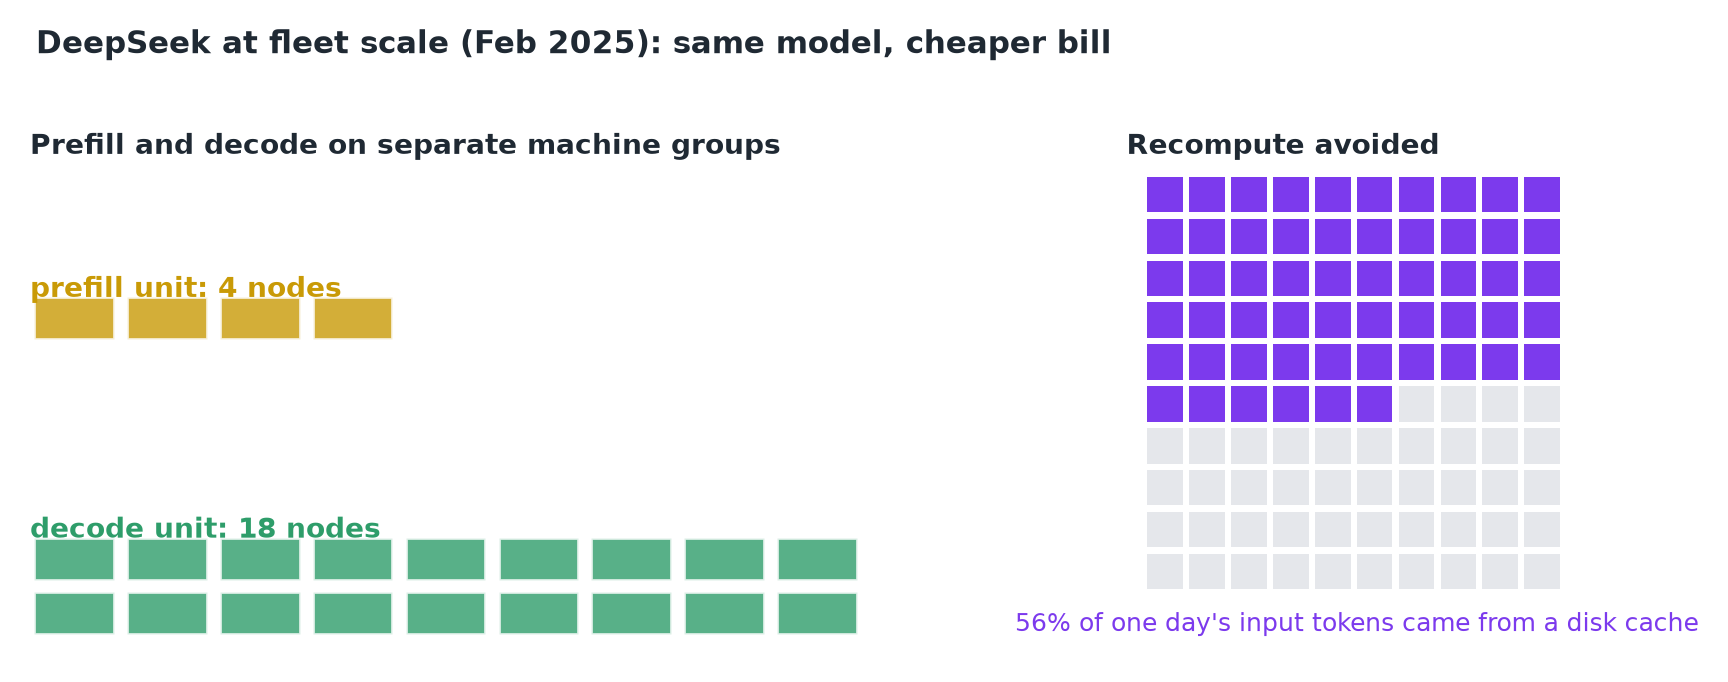 Prefill và decode chạy trên các nhóm được tinh chỉnh riêng (đơn vị 4 node so với 18 node); 56% token đầu vào trong ngày đến từ cache trên đĩa.
Quan trọng
Không cái nào trong số này thay đổi model. Tất cả đều thay đổi hoá đơn.
4. Cấp 4, engine builder: viết công cụ mà các cấp khác cấu hình
Câu hỏi: bản thân engine nên làm gì khác đi? Rất nhiều thứ mà các cấp dưới coi là tham số cấu hình đã khởi đầu từ một ý tưởng ở cấp này.
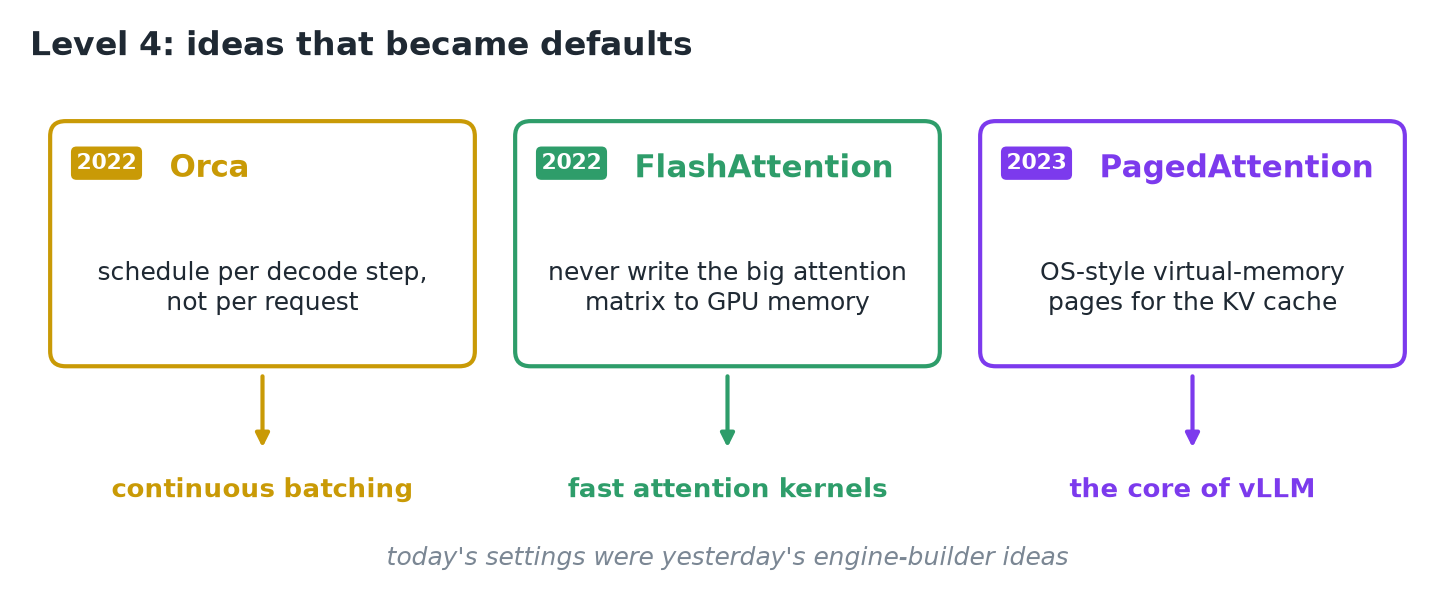 Orca (OSDI 2022), FlashAttention (2022) và PagedAttention (SOSP 2023), và mỗi cái đã trở thành gì.
Công việc: đọc profiler trace, viết kernel, đọc paper. Kỹ sư làm kernel attention +11% sống ở cấp này.
5. Vì sao mỗi cấp cần cấp bên dưới
- Một user biết prefill xử lý toàn bộ prompt sẽ hiểu vì sao prompt dài làm tăng cả thời gian chờ lẫn hoá đơn.
- Một operator biết KV cache tăng theo từng token sẽ hiểu vì sao một server vừa khít lúc khởi động vẫn có thể hết bộ nhớ lúc cao điểm.
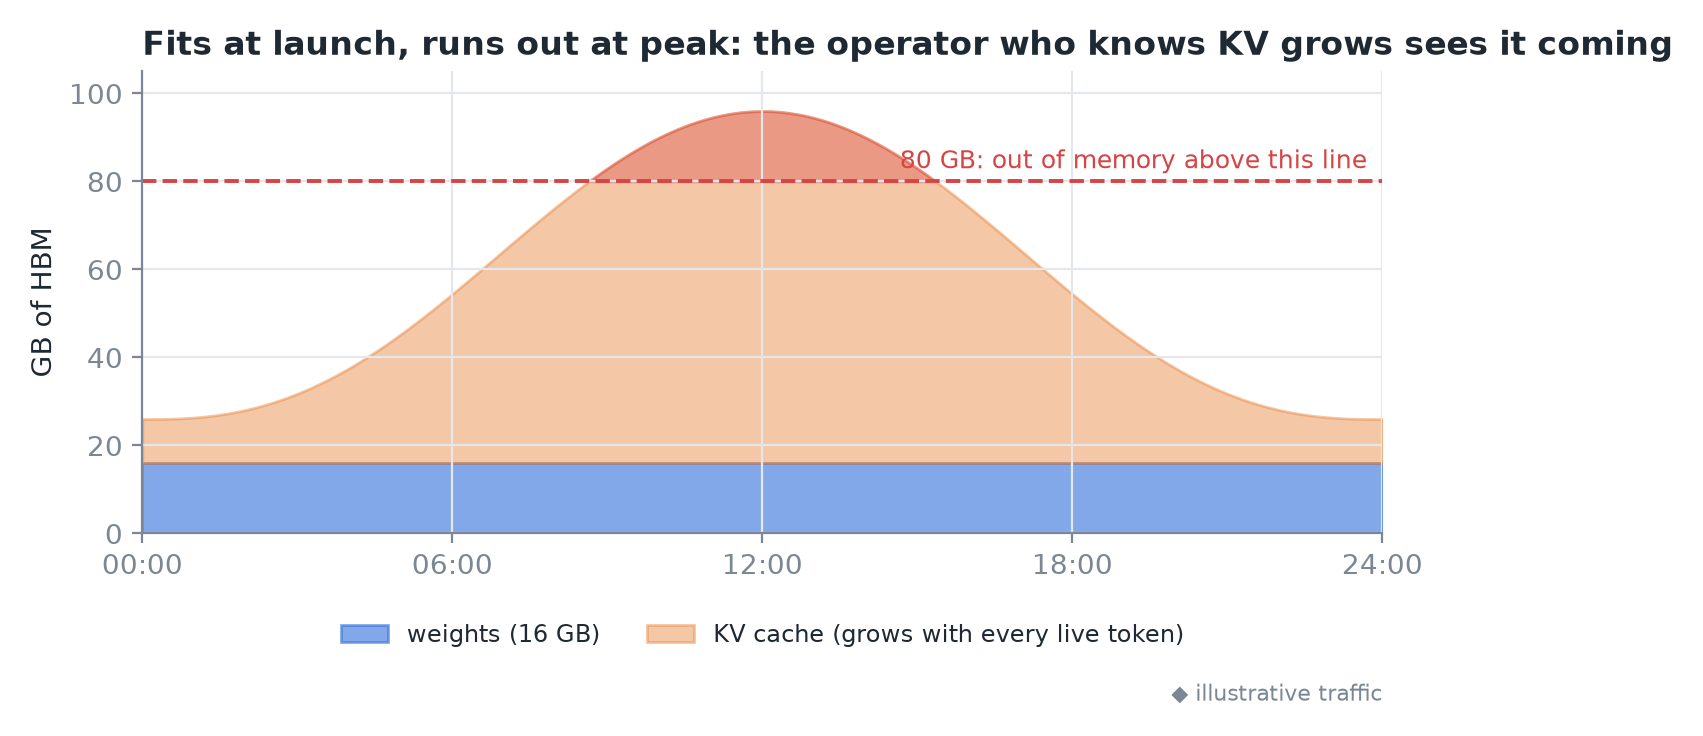 Trọng số cố định; KV cache tăng theo lưu lượng cho tới khi vượt vạch 80 GB.
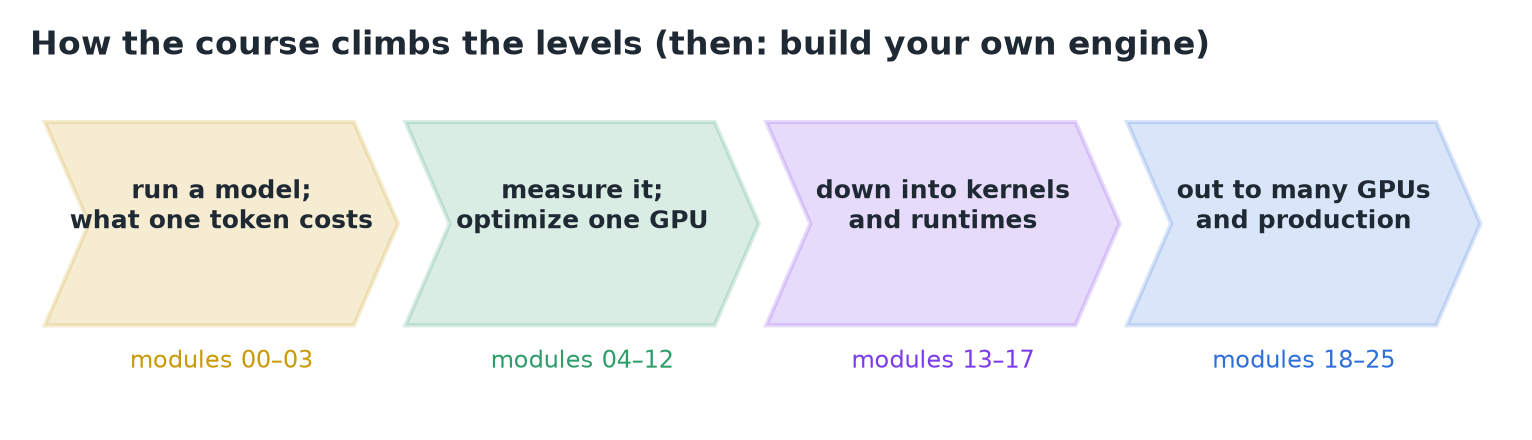 Khoá học leo các cấp theo thứ tự này, và gần cuối bạn tự xây một engine.
Cảnh báo
- Các cấp không phải chức danh hay thâm niên: một người có thể đi từ hoá đơn tới kernel chỉ trong một tuần.
- Cao hơn không có nghĩa là tốt hơn: một model nhỏ hơn, một prompt cố định hay một cache được bật thường thắng cả tháng làm kernel.
6. Tóm tắt
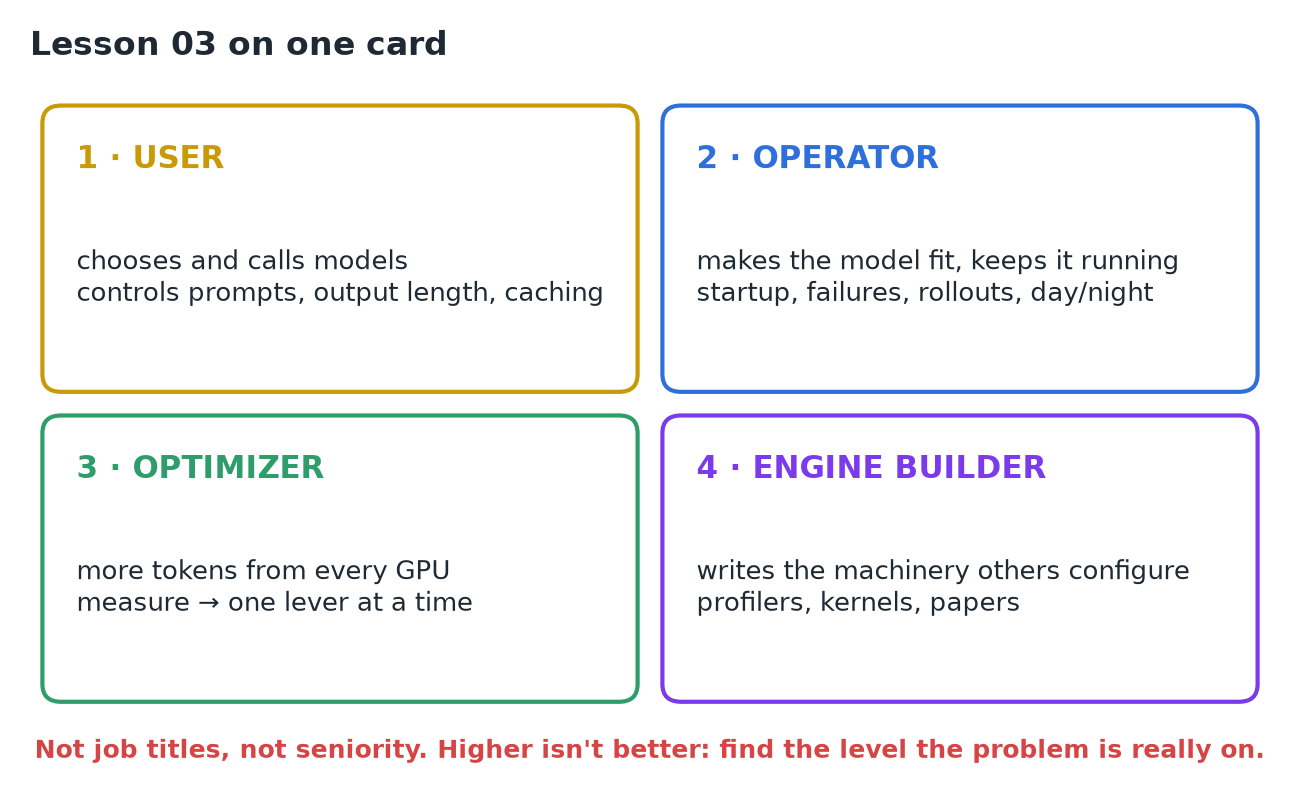
Bên dưới cả bốn cấp là cùng một phép tính: bao nhiêu byte, bao nhiêu phép tính, và phần cứng chuyển chúng nhanh tới đâu.