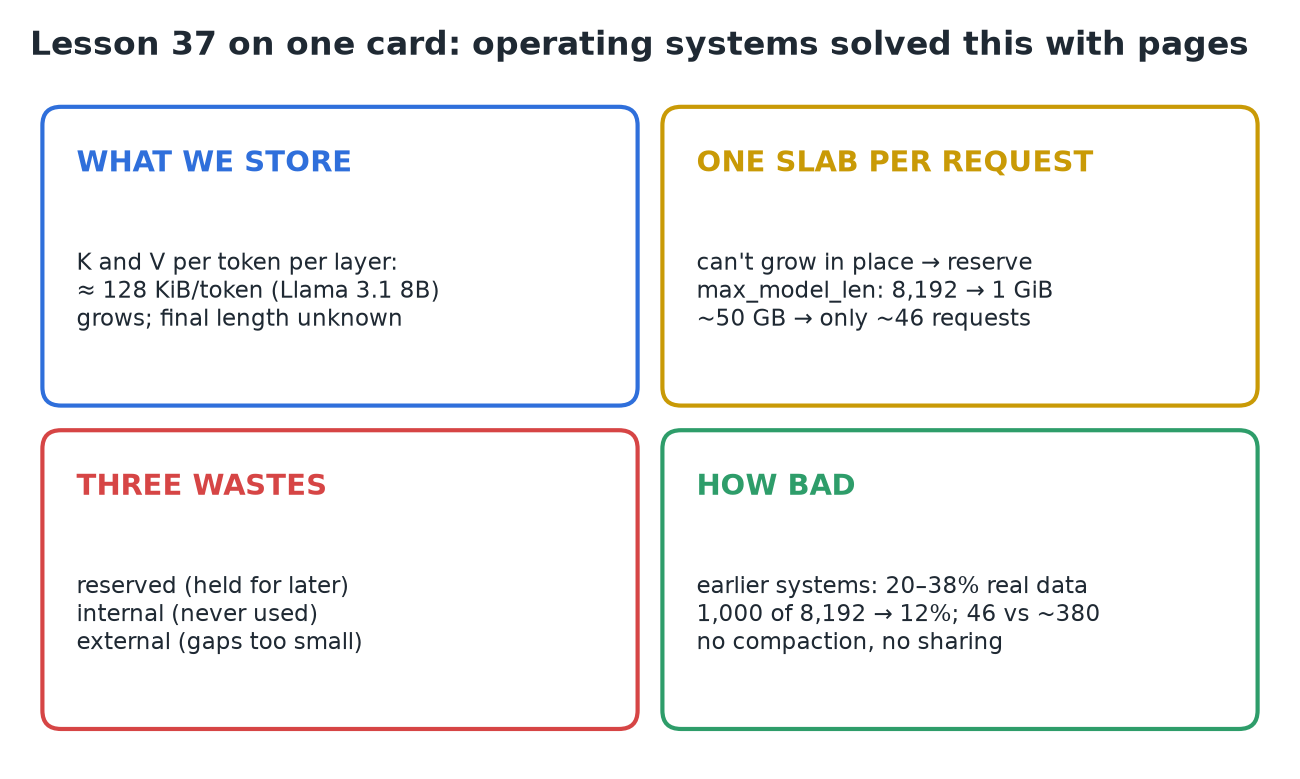
37 · Vì sao cấp phát KV liền mạch không ổn
Nguồn: fanout.sh / inference-eng / 08-01 · ~5 phút
Ghi chú
Bao nhiêu request chạy cùng lúc phụ thuộc vào bao nhiêu KV cache vừa trên GPU, và điều đó phụ thuộc vào cách bố trí bộ nhớ. Cách bố trí hiển nhiên, mỗi request một khối liền mạch (slab), phải đặt trước cho trường hợp xấu nhất vì slab không thể lớn lên tại chỗ: 8.192 token × 128 KiB = 1 GiB mỗi request, nên ~50 GB chỉ chứa được ~46 request, dù về sau chúng ngắn tới đâu. Nó lãng phí bộ nhớ theo ba cách: đặt trước, phân mảnh trong và phân mảnh ngoài. Các tác giả vLLM đo được những hệ thống trước đó chỉ dùng 20–38% bộ nhớ KV cho dữ liệu thật; chỉ lưu những gì thực sự dùng thì chứa được ~380 request thay vì 46.
1. Ta đang lưu gì
Với mỗi token, mỗi layer giữ một vector key và một vector value:
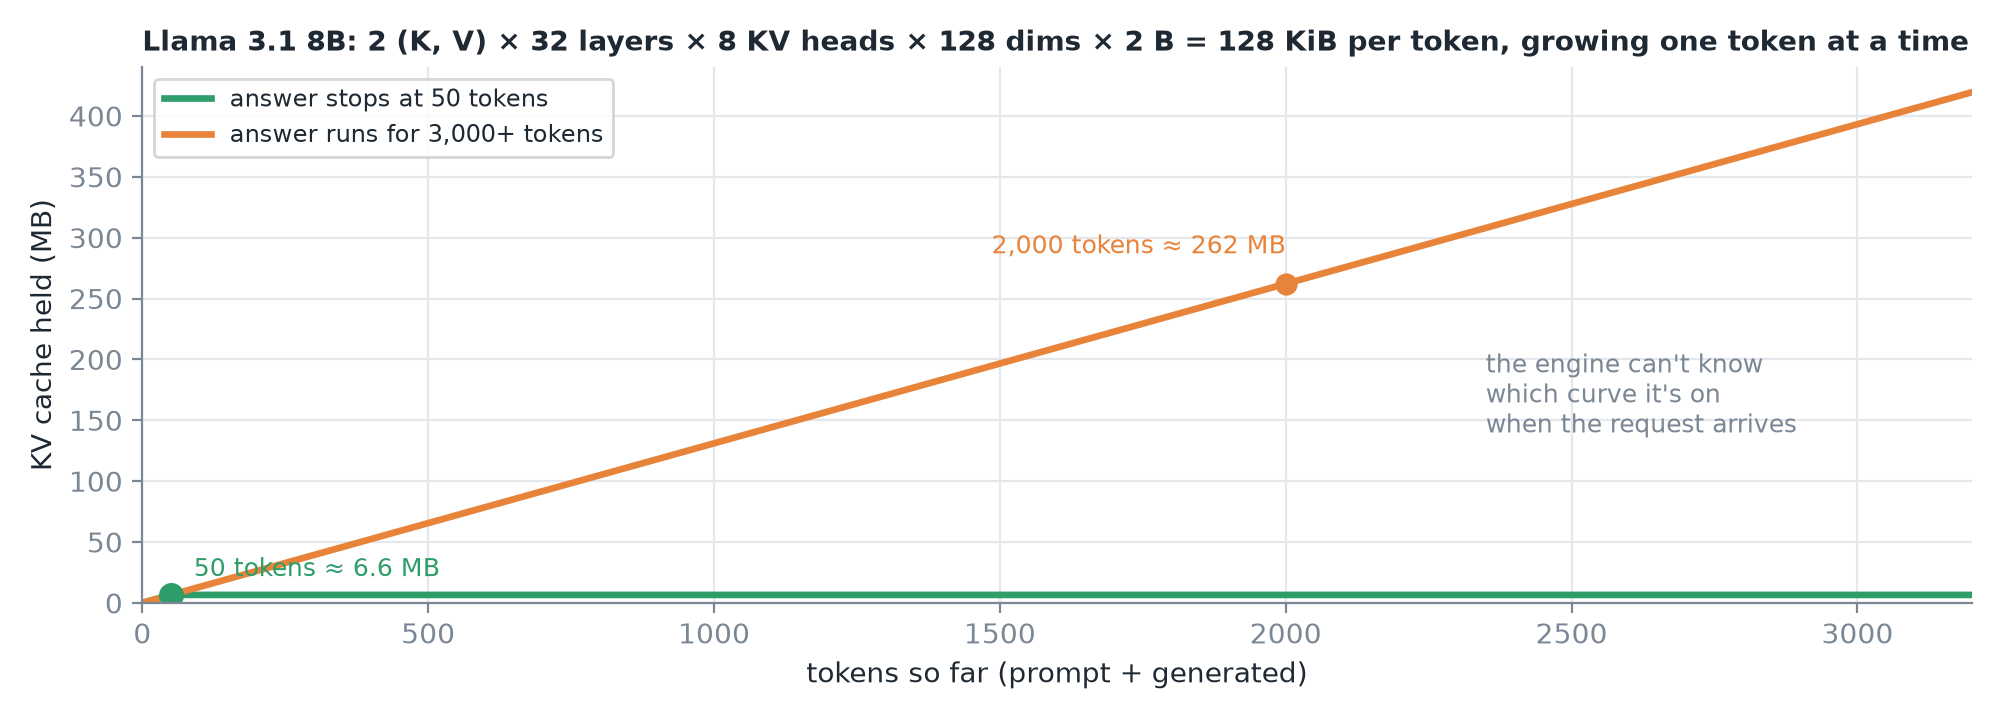 Nó lớn thêm từng token một trong khi request chạy, và không ai biết độ dài cuối cùng: câu trả lời này dừng sau 50 token, câu khác kéo tới hàng nghìn.
2. Mỗi request một slab
- Phần lớn code deep learning muốn mỗi tensor nằm trong một khối liền mạch, nên thiết kế tự nhiên là cho mỗi request một slab và giữ KV của nó theo thứ tự bên trong.
- Một slab không thể lớn lên tại chỗ: vùng nhớ ngay sau nó có thể thuộc về ai đó khác. Vì vậy bạn đặt trước cho trường hợp xấu nhất, độ dài tối đa của model.
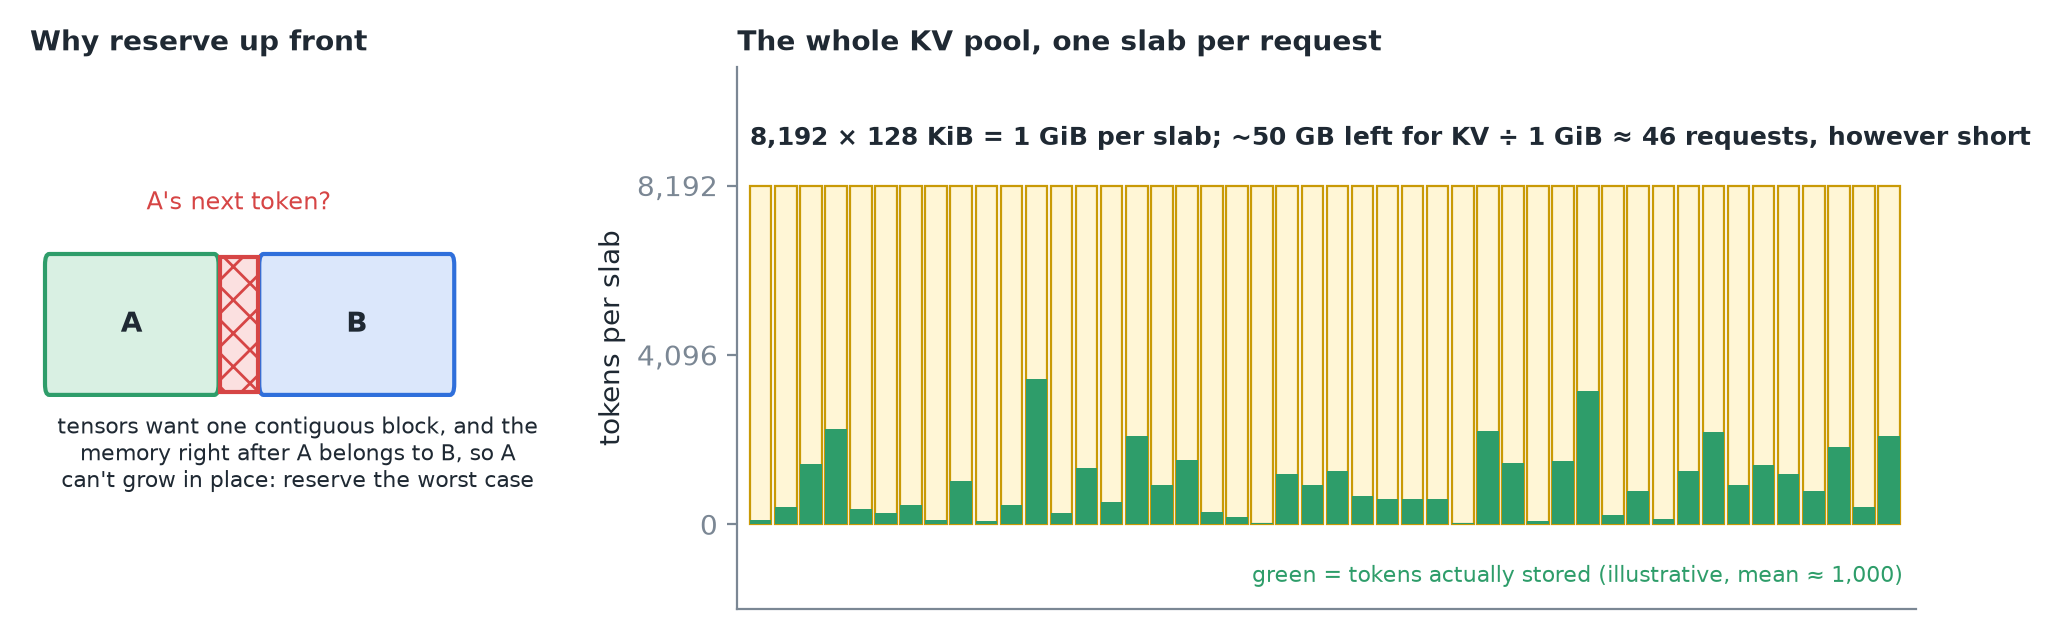 ~50 GB còn lại cho KV sau trọng số (minh hoạ) chỉ chứa được ~46 slab, dù các request về sau ngắn tới đâu. Xanh lá: phần thực sự được lưu.
3. Ba kiểu lãng phí
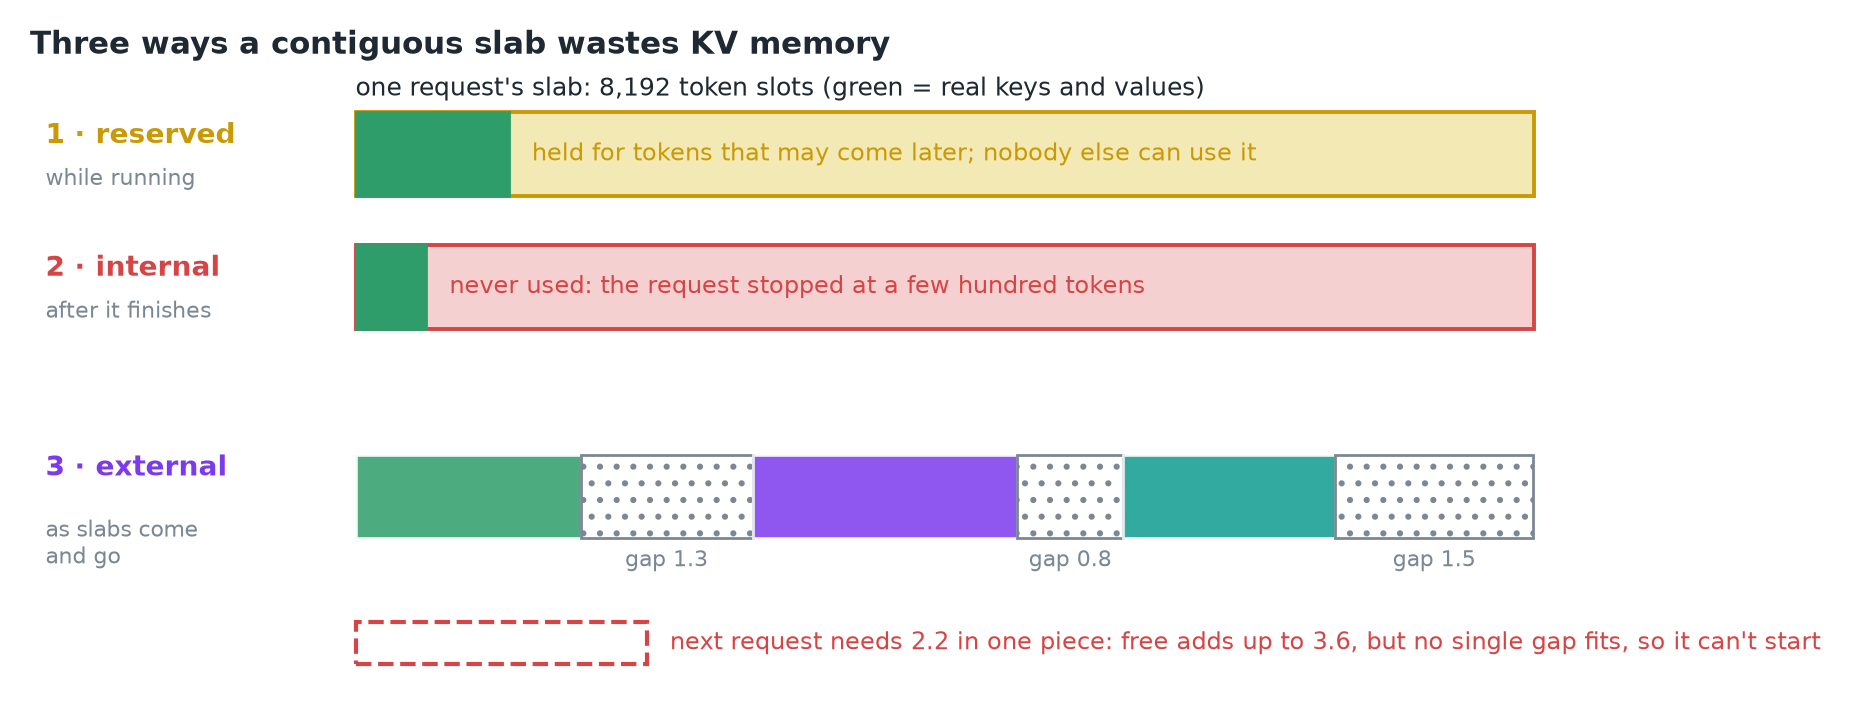 Xanh lá = key và value thật. Các khe hở ở hàng 3 cộng lại được 3,6, nhưng không khe nào vừa một request cần 2,2.
| Lãng phí | Khi nào | Điều gì xảy ra |
|---|---|---|
| Đặt trước | Trong lúc request chạy | Chỗ phía trước các token thật bị giữ "để dành"; không ai khác đụng vào được |
| Phân mảnh trong | Sau khi nó xong sớm | Request dừng ở vài trăm token; phần còn lại của slab không bao giờ được dùng |
| Phân mảnh ngoài | Khi các slab kích thước khác nhau đến rồi đi | Vùng trống cộng lại được 3,6, request kế tiếp cần 2,2, nhưng không khe nào đủ lớn, nên nó không bắt đầu được |
Phân mảnh ngoài xuất hiện khi các slab có kích thước khác nhau, ví dụ mỗi slab được định cỡ theo prompt riêng cộng giới hạn đầu ra riêng.
4. Thực tế tệ tới đâu?
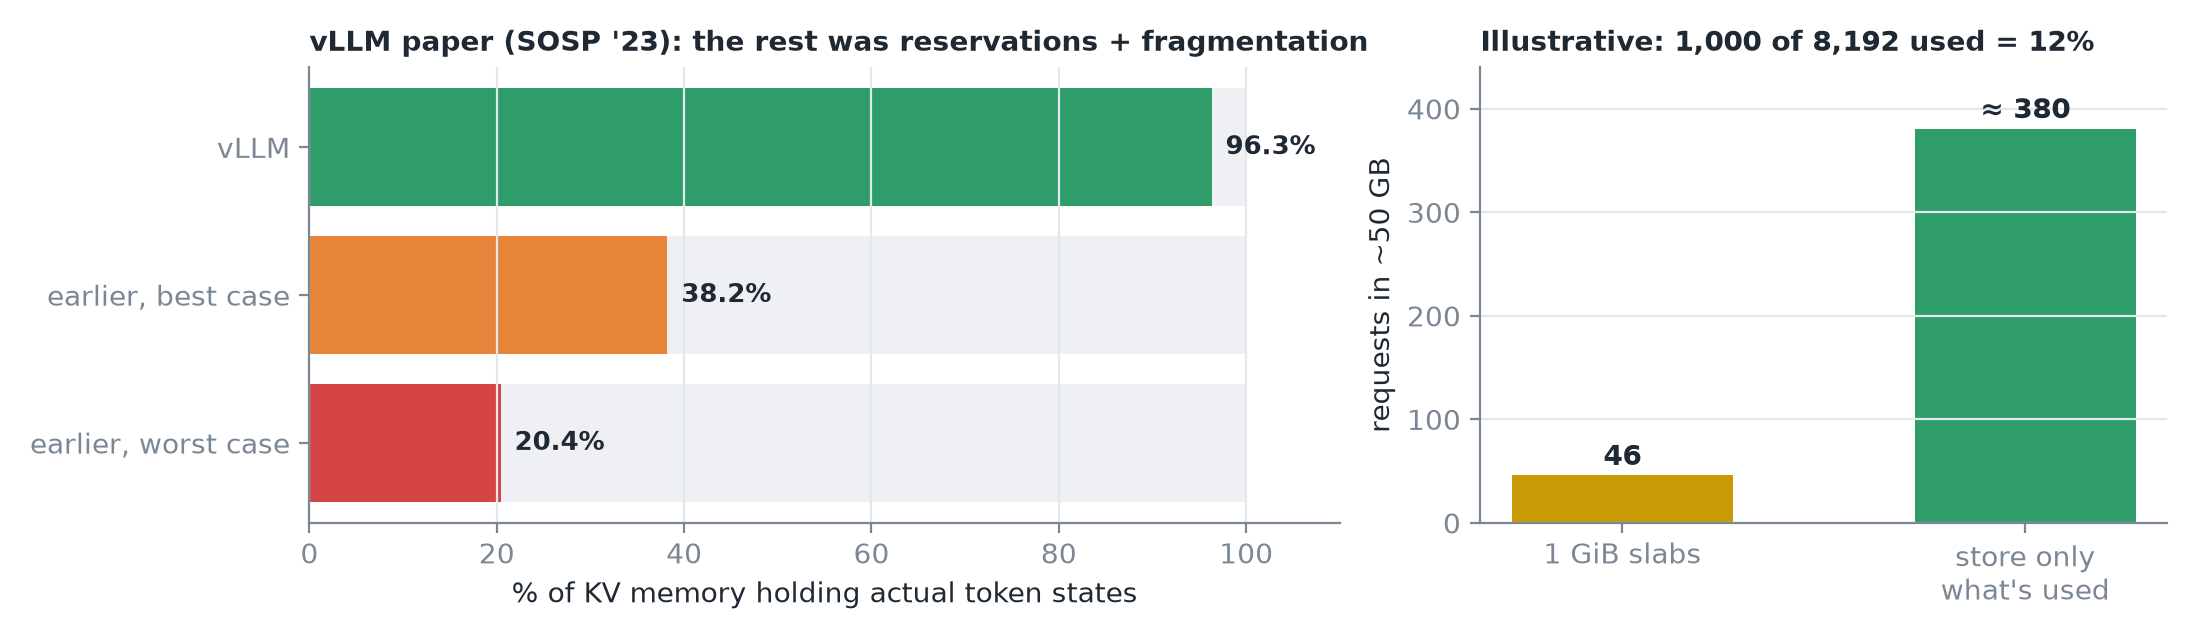 Trái: paper vLLM (SOSP '23) đo các hệ thống trước đó: chỉ 20,4–38,2% bộ nhớ KV chứa trạng thái token; vLLM đạt 96,3%. Phải: các con số minh hoạ của bài.
Nếu request thực sự trung bình 1.000 token, chỉ 12% mỗi slab chứa dữ liệu. Chỉ lưu những gì dùng thì cùng 50 GB đó chứa được ~380 request thay vì 46.
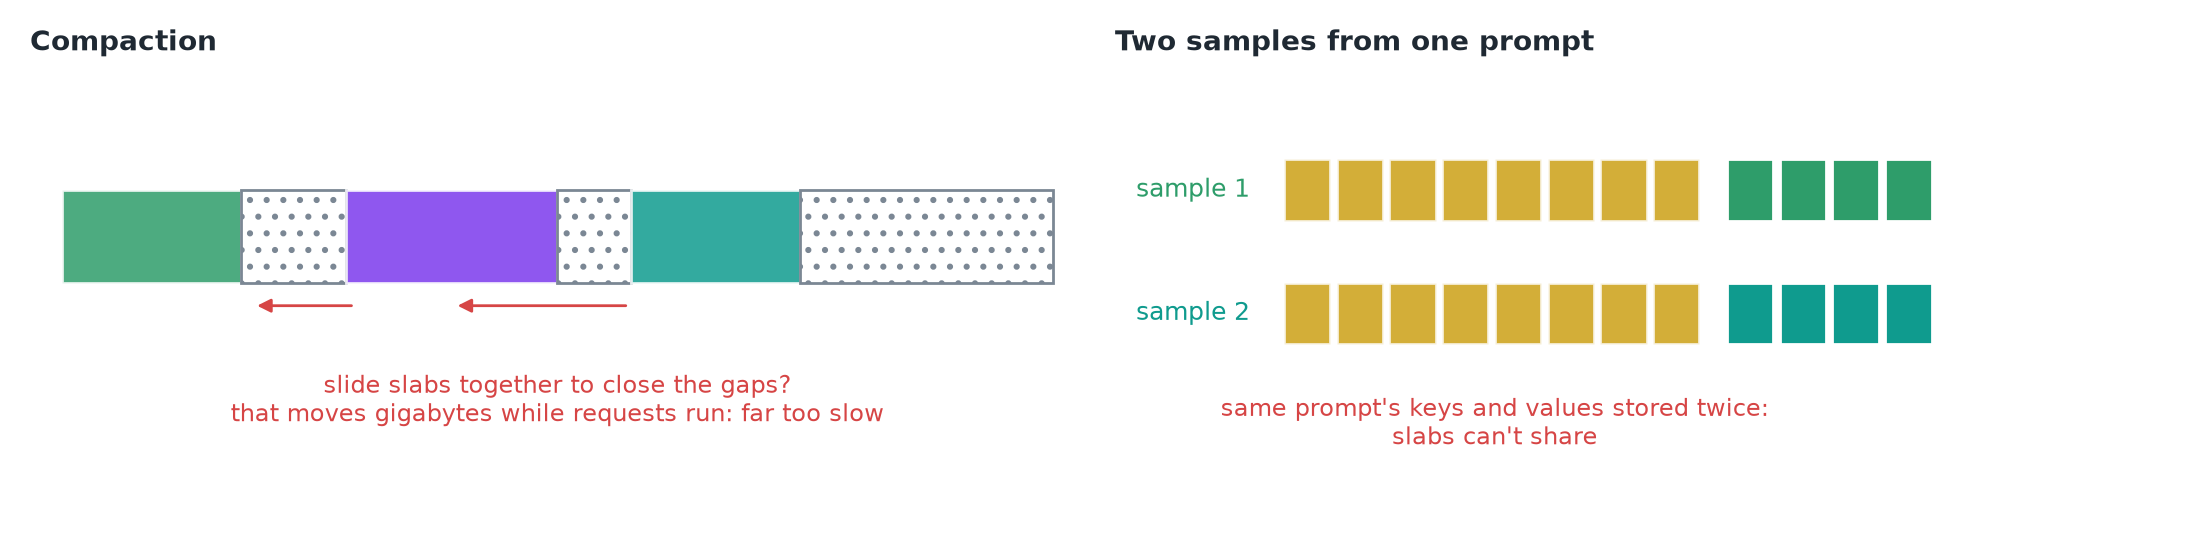 Dồn bộ nhớ (compaction) nghĩa là phải di chuyển hàng gigabyte trong lúc request đang chạy, quá chậm. Và hai lần lấy mẫu từ cùng một prompt mỗi lần lưu một bản key và value riêng, vì slab không chia sẻ được.
Quan trọng
Vấn đề không nằm ở lượng bộ nhớ, mà ở cách bố trí liền mạch, theo trường hợp xấu nhất. Hệ điều hành đã giải quyết đúng vấn đề này từ hàng chục năm trước bằng trang (page).
5. Tóm tắt