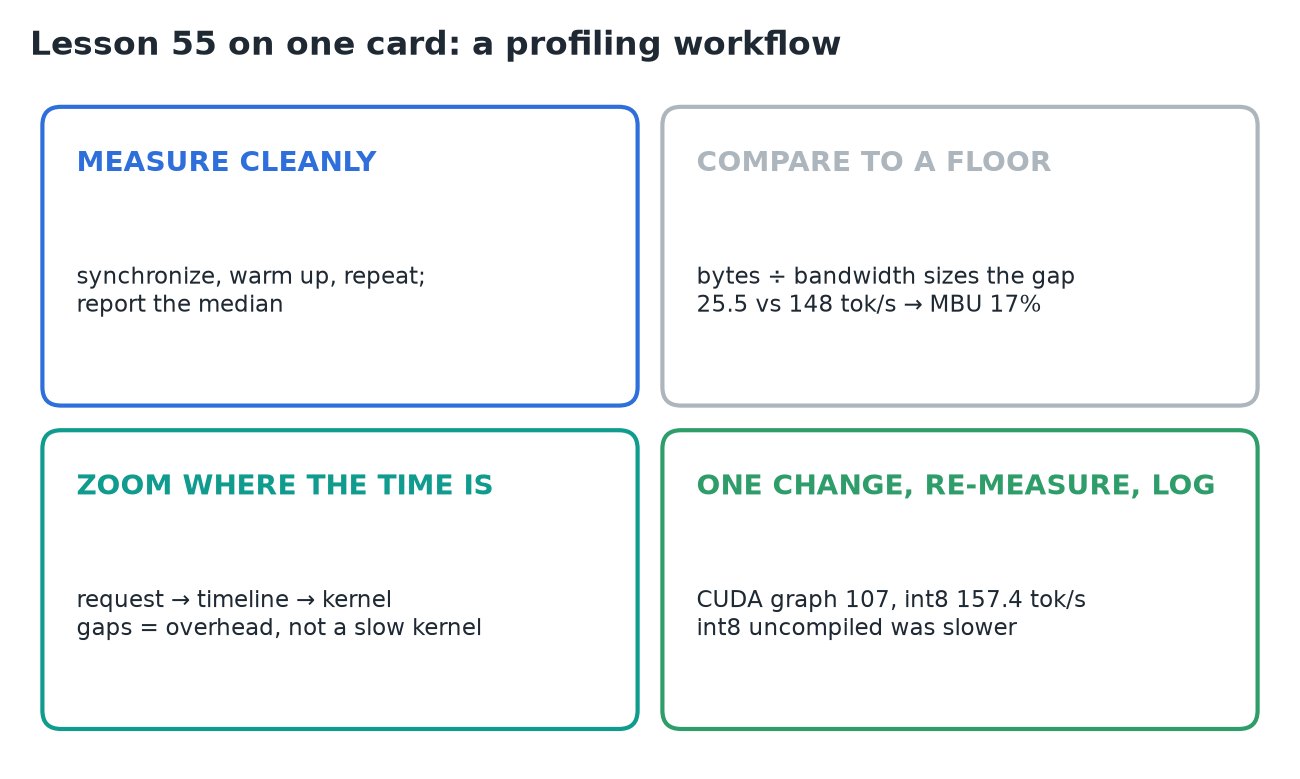
55 · Thôi đoán mò: xây một quy trình profiling
Nguồn: fanout.sh / inference-eng / 12-01 · ~9 phút
Ghi chú
Một Llama 7B chạy PyTorch thuần trên một A100 sinh 25,5 token/s (≈ 39 ms mỗi token). Con số đó có chậm không thì không đoán được; phải đo so với những gì phần cứng có thể làm. Một vòng lặp năm bước làm điều đó: đo một con số sạch, so nó với một mức sàn, định vị khoảng chênh bằng cách chỉ phóng to vào nơi thời gian nằm ở đó, đổi một thứ, rồi đo lại và ghi chép. Chạy trên Llama này, vòng lặp tìm ra overhead launch của CPU, không phải một kernel chậm, và đưa nó từ 25,5 lên 157,4 token/s mà không cần đoán lần nào.
1. Vòng lặp
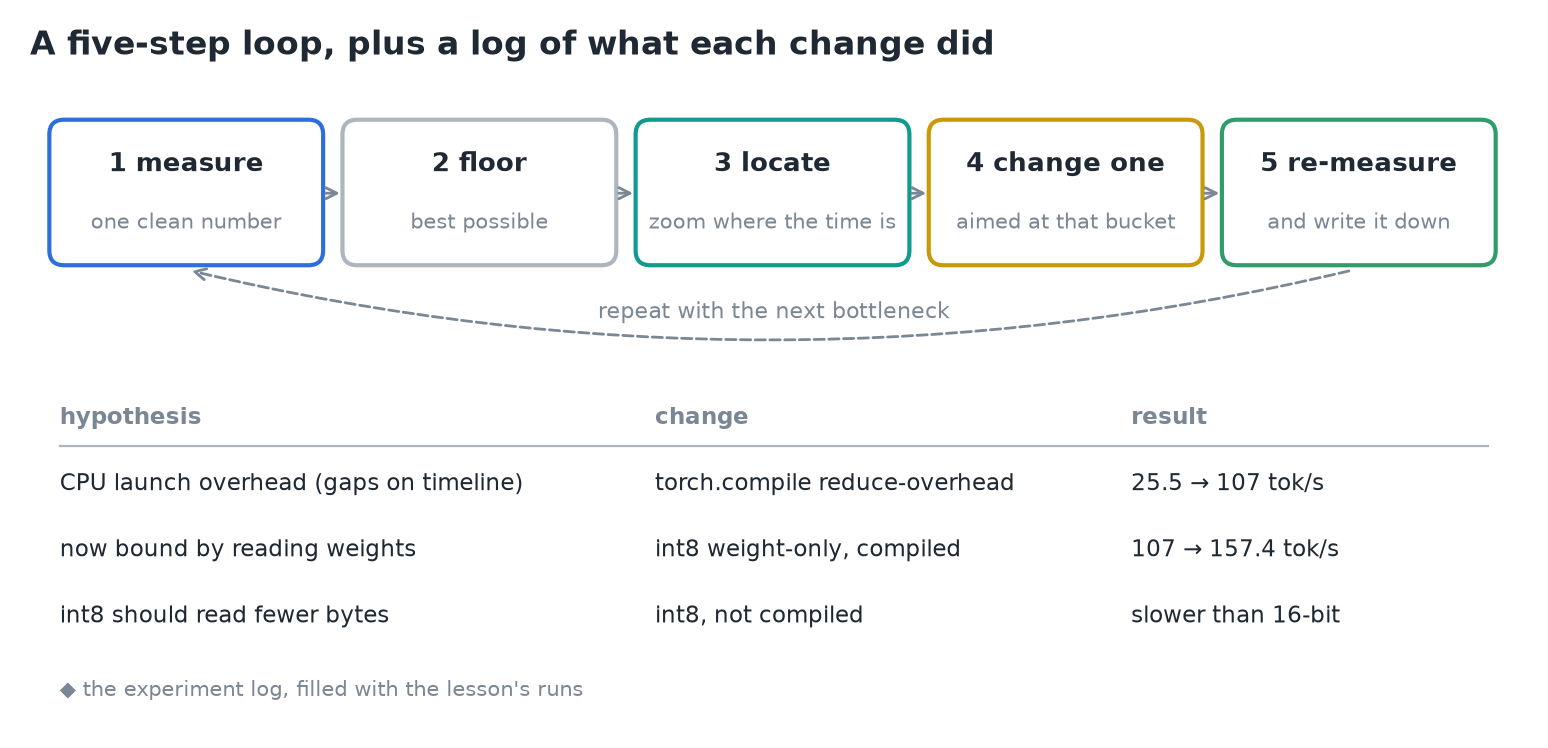 Năm bước, và một bản ghi những gì mỗi thay đổi đã làm.
- Những phỏng đoán thường gặp ("kernel attention chắc là chậm", "ta cần GPU lớn hơn", "viết lại bằng C++") mỗi cái tốn một ngày và phần lớn là trật.
- Bước cuối, ghi chép lại, là thứ ngăn bạn tự lừa mình: một bản ghi ngắn gồm giả thuyết, thay đổi và kết quả đáng giá hơn bất kỳ ảnh chụp profiler nào.
2. Bước 1: đo một con số sạch
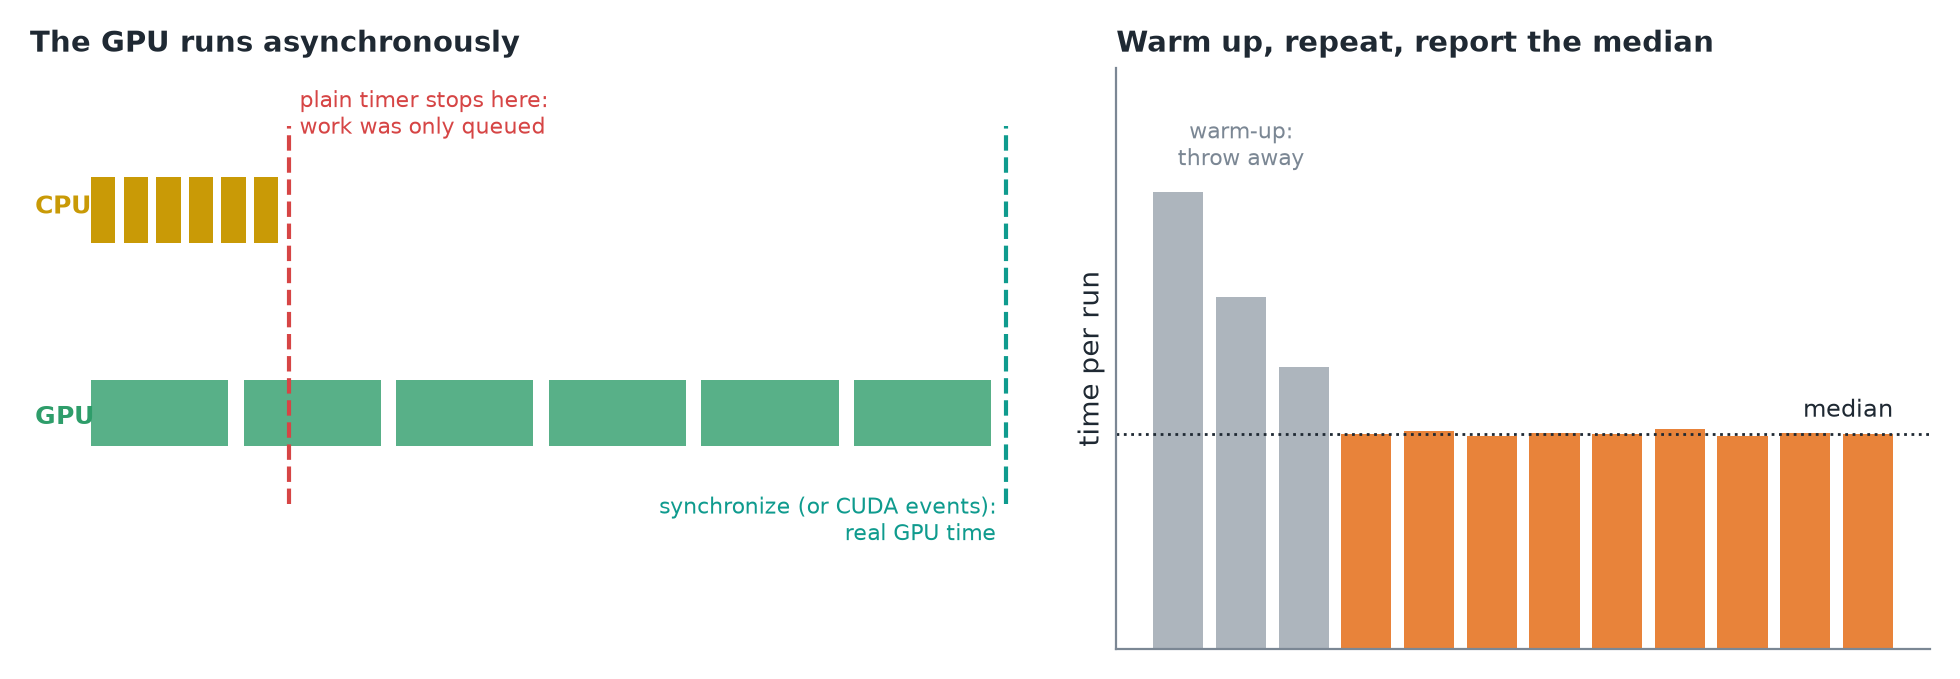 Trái: một bộ đếm giờ thông thường dừng lại khi CPU đã xếp hàng xong công việc. Phải: bỏ các lần chạy warm-up và lấy trung vị (minh hoạ).
- GPU chạy bất đồng bộ: một lần gọi kernel chỉ đưa việc vào hàng đợi rồi trả về ngay. Bộ đếm giờ thông thường đo CPU xếp hàng việc nhanh tới đâu, không đo GPU mất bao lâu.
- Tài liệu PyTorch: "time measurements without synchronization are not accurate." Synchronize trước khi dừng đồng hồ, hoặc dùng CUDA event.
- Warm-up: các lần gọi đầu trả giá cho cấp phát bộ nhớ, chọn kernel và đôi khi biên dịch. Bỏ chúng đi.
- Lặp lại với cùng prompt và độ dài đầu ra, và báo trung vị.
3. Bước 2: so với một mức sàn
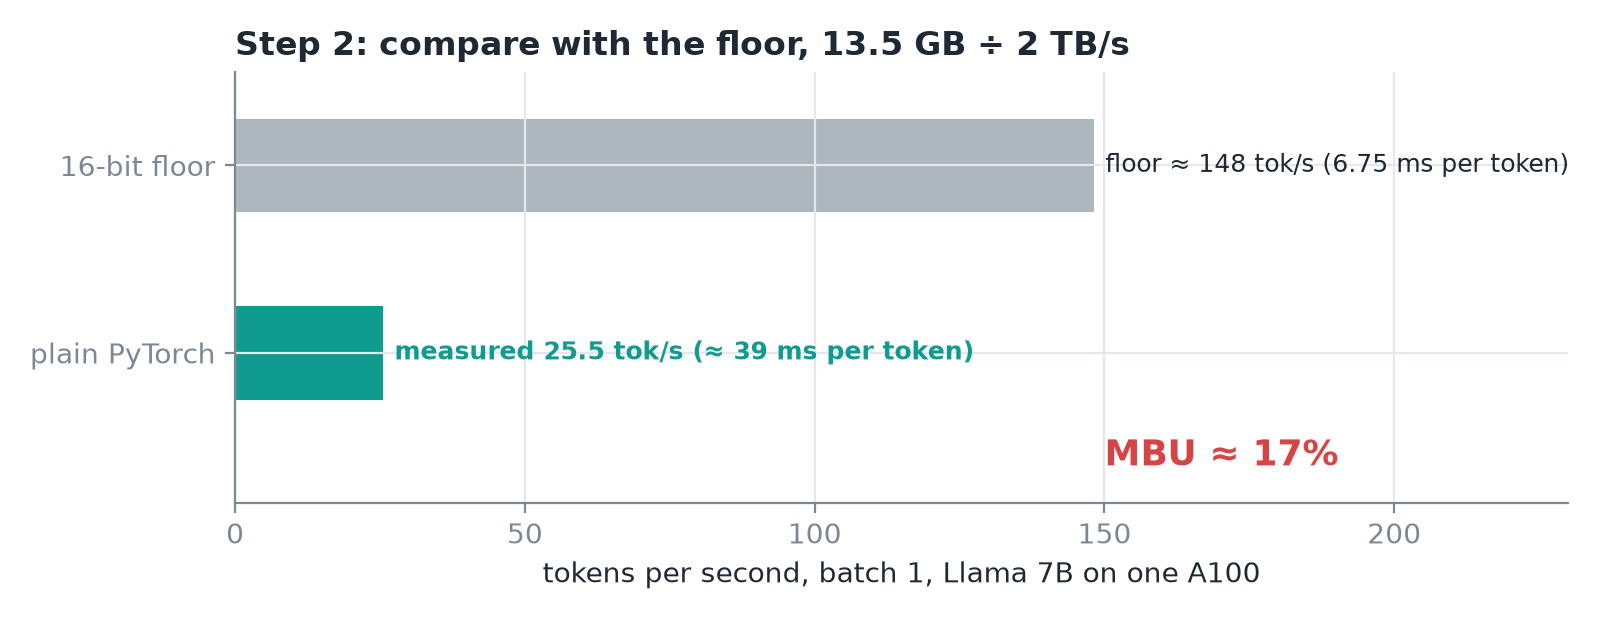 Ở batch 1, mỗi token phải đọc toàn bộ trọng số một lần.
- Model bandwidth utilization (MBU) = băng thông đạt được ÷ băng thông đỉnh. Ở đây 25,5 ÷ 148 ≈ 17%.
- Vậy hơn 80% thời gian mỗi token dành cho thứ gì đó khác với việc duy nhất workload này phải làm: đọc trọng số. Khoảng chênh đó là thứ ta đi săn.
4. Bước 3: định vị khoảng chênh
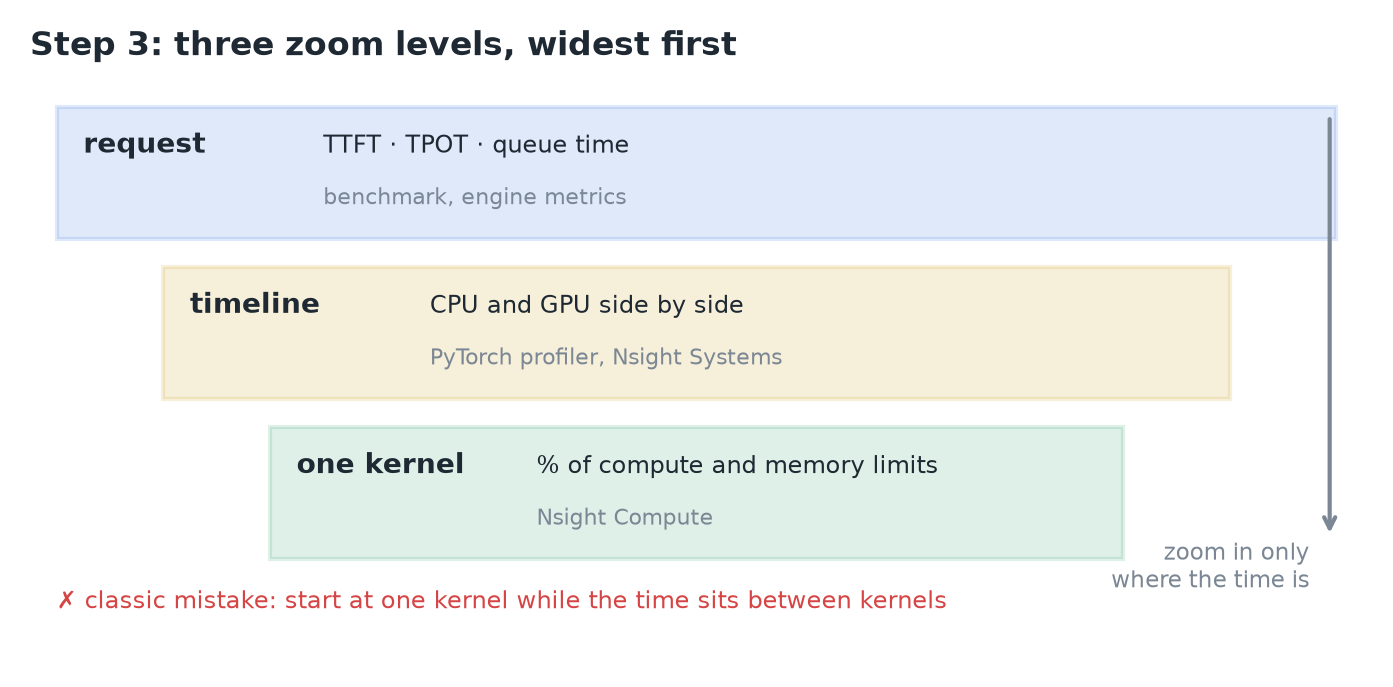 Ba mức phóng to. Chỉ phóng vào nơi thời gian nằm ở đó.
| Mức | Cho thấy | Công cụ |
|---|---|---|
| Request | TTFT, TPOT, thời gian xếp hàng | benchmark của bạn, metric của engine |
| Timeline | Thread CPU và kernel GPU cạnh nhau theo thời gian | PyTorch profiler, Nsight Systems |
| Một kernel | nó tiến gần giới hạn tính toán và bộ nhớ của chip tới đâu | Nsight Compute |
- Sai lầm kinh điển là bắt đầu từ đầu hẹp: đánh bóng một kernel trong khi vấn đề thật nằm giữa các kernel.
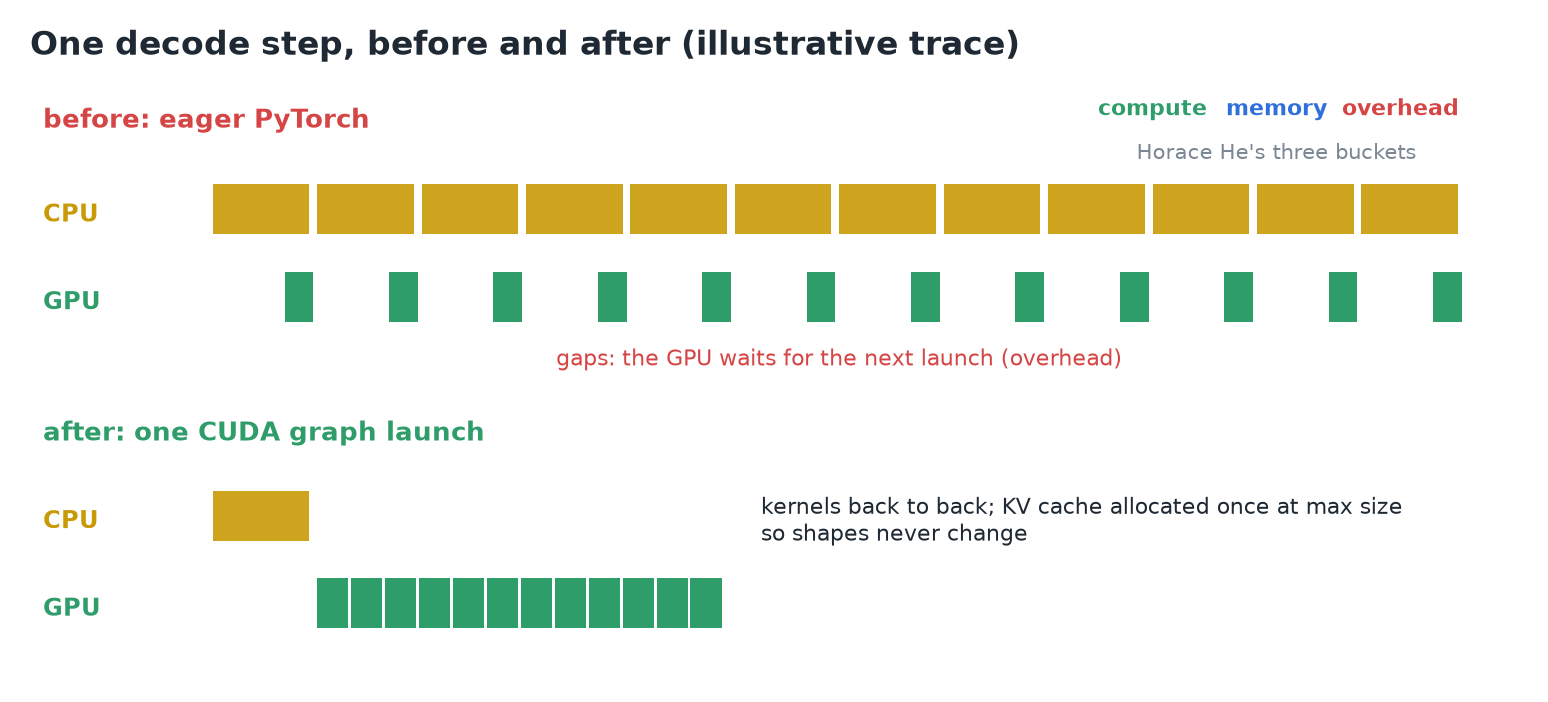 Trace minh hoạ một bước decode trước và sau khi dùng CUDA graph.
- Timeline của một bước decode cho thấy các kernel tí hon với khoảng trống giữa chúng, trong khi thread Python bận suốt để launch hết op nhỏ này tới op nhỏ khác.
- Ba cái giỏ của Horace He: compute (làm phép tính), memory (chuyển byte) và overhead (mọi thứ khác). Các khoảng trống là overhead: GPU làm xong mỗi kernel trước khi CPU kịp trao cho nó cái tiếp theo.
- Kết luận của team PyTorch: "heavily CPU overhead bound." Viết lại kernel attention cũng không sửa được.
5. Bước 4 và 5: đổi một thứ, đo lại
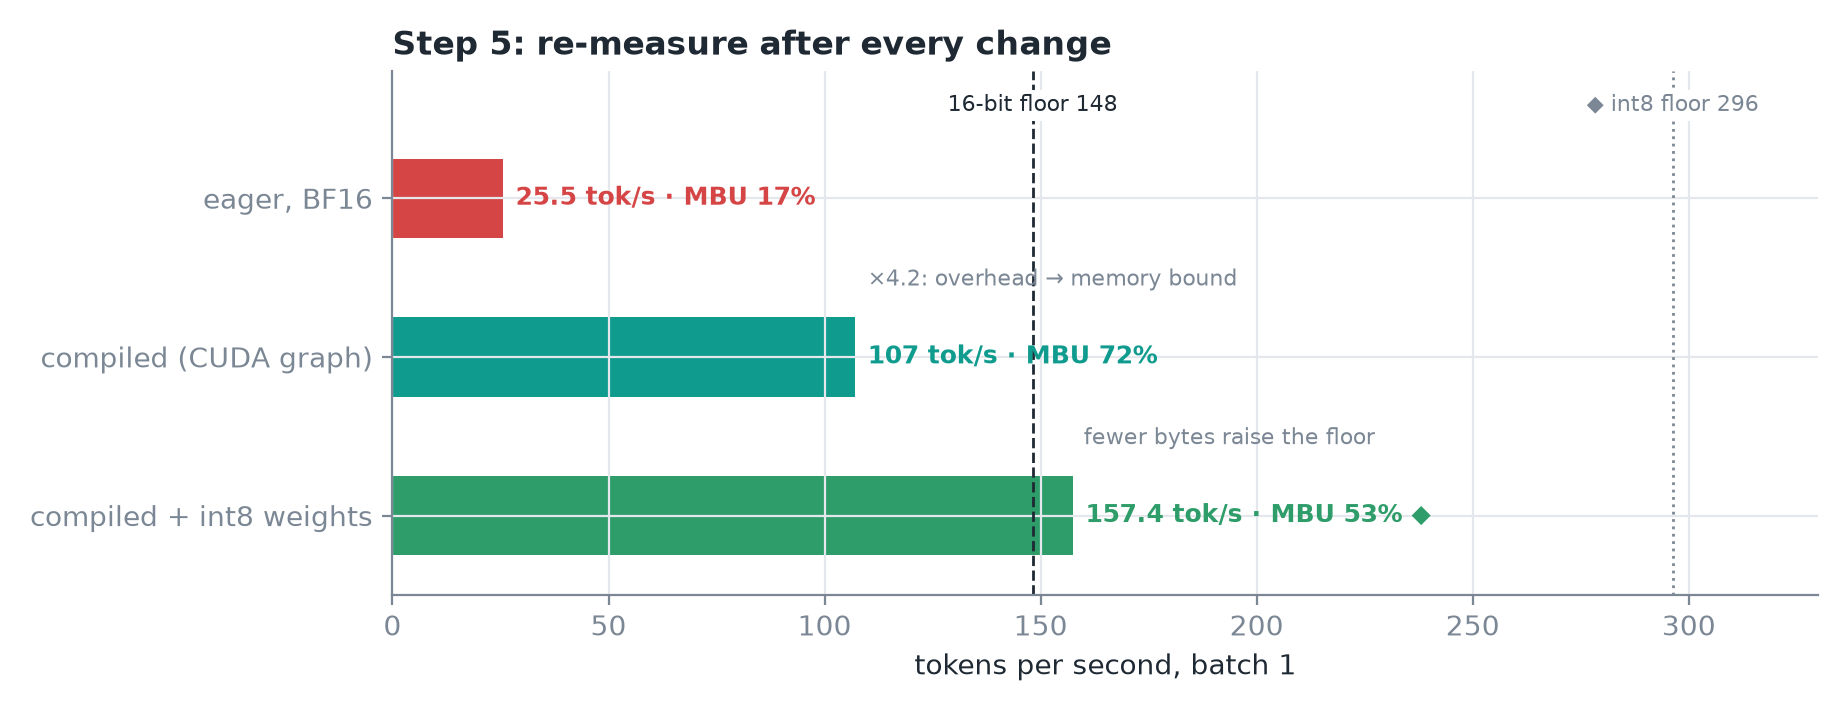 Mỗi lần chạy so với mức sàn 16-bit. ◆ Mức sàn int8 và MBU của nó là phép tính của tôi.
- Thay đổi:
torch.compileở chế độ reduce-overhead ghi cả bước decode thành một CUDA graph và phát lại bằng một lần launch. Để làm được vậy, KV cache được cấp phát một lần ở kích thước tối đa, nên shape không bao giờ đổi. - Đo lại: 107 token/s, ×4,2. MBU tăng lên ≈ 72%: các khoảng trống biến mất và nút thắt chuyển từ overhead sang bộ nhớ.
- Giả thuyết tiếp theo tự hiện ra, đọc ít byte hơn: lượng tử hoá int8 chỉ trọng số đạt 157,4 token/s, vượt mức sàn 16-bit, vì ít byte hơn thì mức sàn cao hơn.
- Không biên dịch, model int8 chậm hơn bản 16-bit: bước giải lượng tử không được gộp vào phép nhân ma trận. Cùng một ý tưởng, kết quả ngược nhau; chỉ việc đo lại mới cho họ biết cái nào.
Mẹo
◆ int8 giảm một nửa số byte, nên mức sàn của nó là ≈ 296 token/s, và 157,4 × 6,75 GB ≈ 1,06 TB/s là MBU ≈ 53%. Vẫn còn dư địa, nên vòng lặp sẽ tiếp tục.
6. Bốn cái bẫy
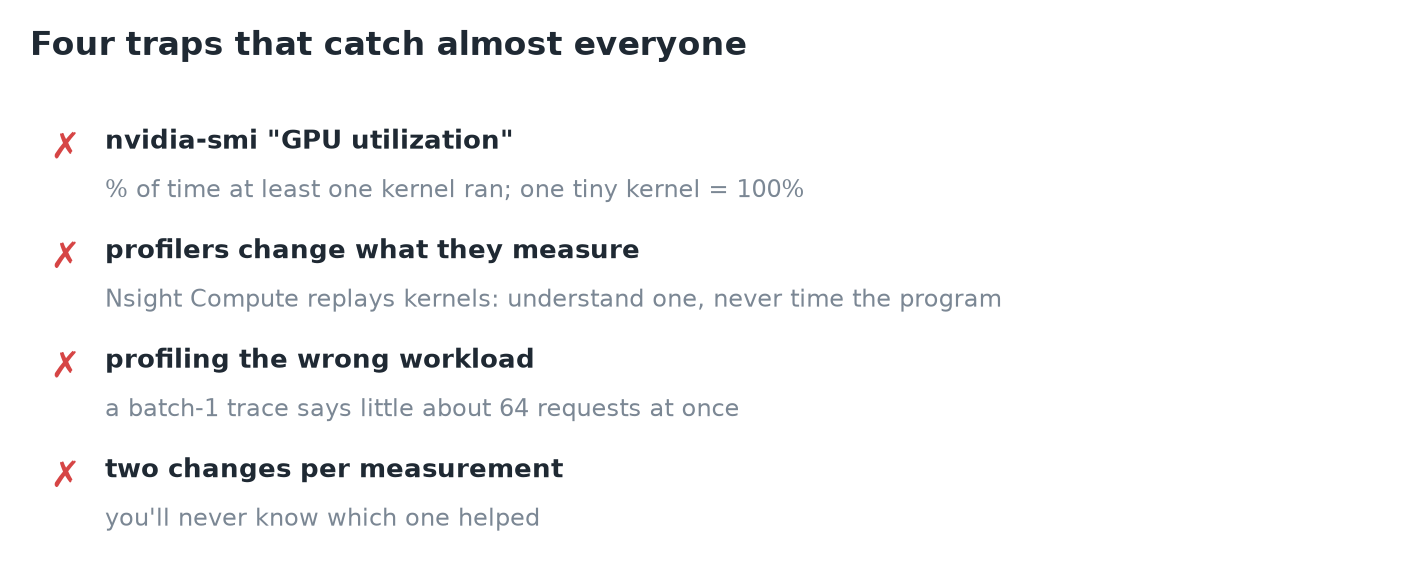
- GPU utilization trong nvidia-smi là phần trăm thời gian có ít nhất một kernel đang chạy. Một kernel tí hon gần như không đụng tới chip vẫn tính là bận 100%.
- Profiler làm thay đổi thứ chúng đo. Nsight Compute phát lại mỗi kernel vài lần để thu thập counter: dùng nó để hiểu một kernel, đừng bao giờ dùng để bấm giờ chương trình.
- Profile đúng workload bạn serve. Một trace batch 1 nói rất ít về một server chạy 64 request cùng lúc.
- Mỗi lần đo một thay đổi. Đổi hai thứ là bạn sẽ không bao giờ biết cái nào có ích.
7. Trong một serving engine thật
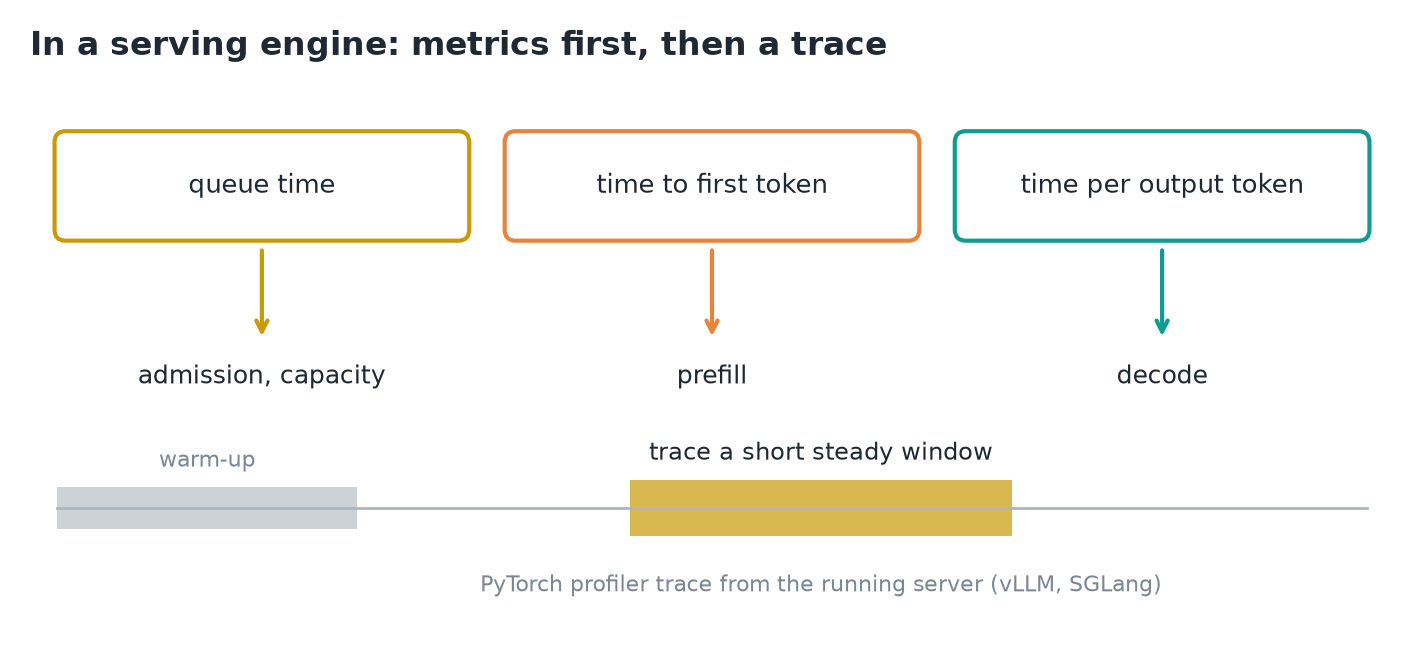 Bắt đầu từ metric của engine; chỉ trace một cửa sổ ổn định.
- vLLM và SGLang đã dùng CUDA graph cho decode, nên các khoảng trống được sửa ở trên thường đã không còn. Vòng lặp vẫn vậy, nhưng điểm xuất phát dịch đi.
- Bắt đầu với metric của chính engine: thời gian đang đổ vào hàng đợi (nhận request, năng lực), token đầu tiên (prefill) hay mọi token sau đó (decode)? Mỗi cái chỉ tới một phần khác nhau của hệ thống.
- Chỉ sau đó mới capture trace, trên một cửa sổ ngắn lưu lượng ổn định sau warm-up. Cả hai engine đều có thể ghi trace PyTorch profiler từ một server đang chạy.
Quan trọng
Đo sạch sẽ, định cỡ khoảng chênh so với một mức sàn, chỉ phóng to vào nơi có thời gian, và mỗi lần đổi một thứ. Nút thắt dịch chuyển sau mỗi lần sửa, nên lần nào cũng phải đo lại.
8. Tóm tắt