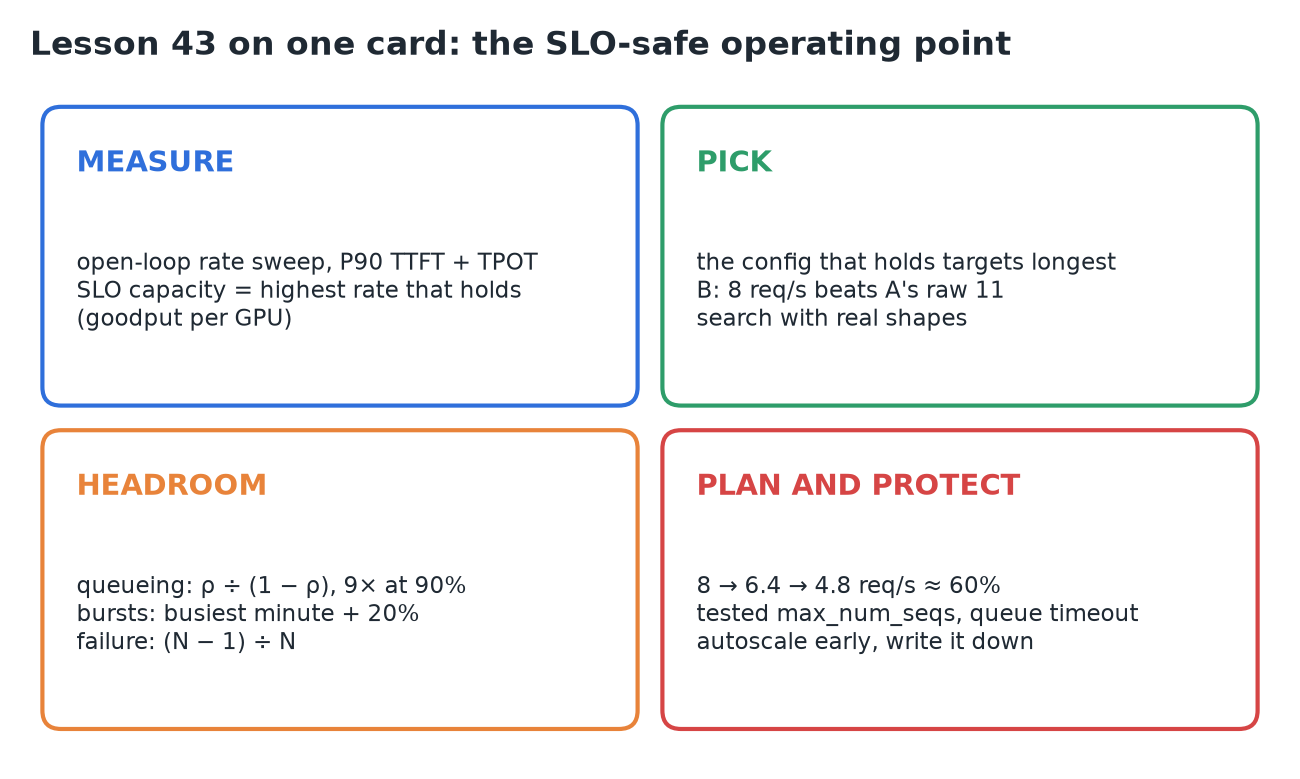
43 · Tìm cấu hình an toàn theo SLO và khoảng dự phòng
Nguồn: fanout.sh / inference-eng / 09-05 · ~8,5 phút
Ghi chú
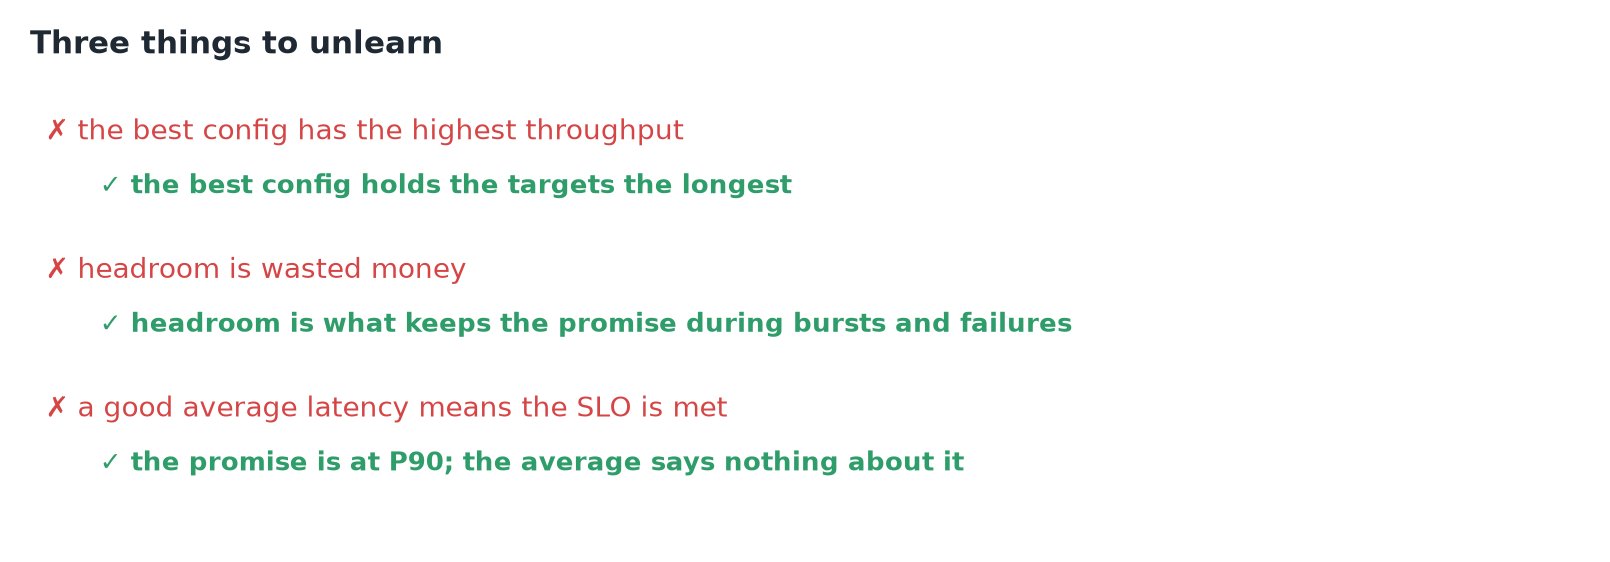
Một benchmark throughput thô trả lời sai câu hỏi. Hãy đo năng lực theo SLO thay vào đó: request rate cao nhất mà P90 TTFT ≤ 400 ms và P90 TPOT ≤ 40 ms cùng giữ được, tìm bằng một lần quét rate vòng hở (DistServe gọi là goodput mỗi GPU). Chọn cấu hình giữ được mục tiêu lâu nhất, không phải cấu hình nhanh nhất. Rồi lên kế hoạch thấp hơn hẳn mức đó: xếp hàng bùng nổ khi gần đầy tải (9 lần thời gian phục vụ ở 90% bận), đợt dồn cần biên 20%, và để sống sót khi mất một trong bốn replica thì mỗi replica chỉ chạy ở 75%. Với cấu hình B đó là 8 → 6,4 → 4,8 req/s mỗi GPU, khoảng 60% con số benchmark.
1. Lời hứa và con số sai
- Dịch vụ chat hứa: 90% người dùng thấy token đầu tiên trong vòng 400 ms, rồi ít nhất mỗi 40 ms một token.
- Một benchmark nói một H100 đẩy được 9 req/s, nên team lên kế hoạch cho 9. Ngày ra mắt, phần đuôi vượt qua mục tiêu; rồi một GPU hỏng và mọi GPU khác sụp theo.
- Benchmark không sai. Nó đo nhanh tới đâu, không đo chịu được bao nhiêu tải mà vẫn giữ lời hứa.
2. Đo năng lực theo SLO bằng lần quét vòng hở
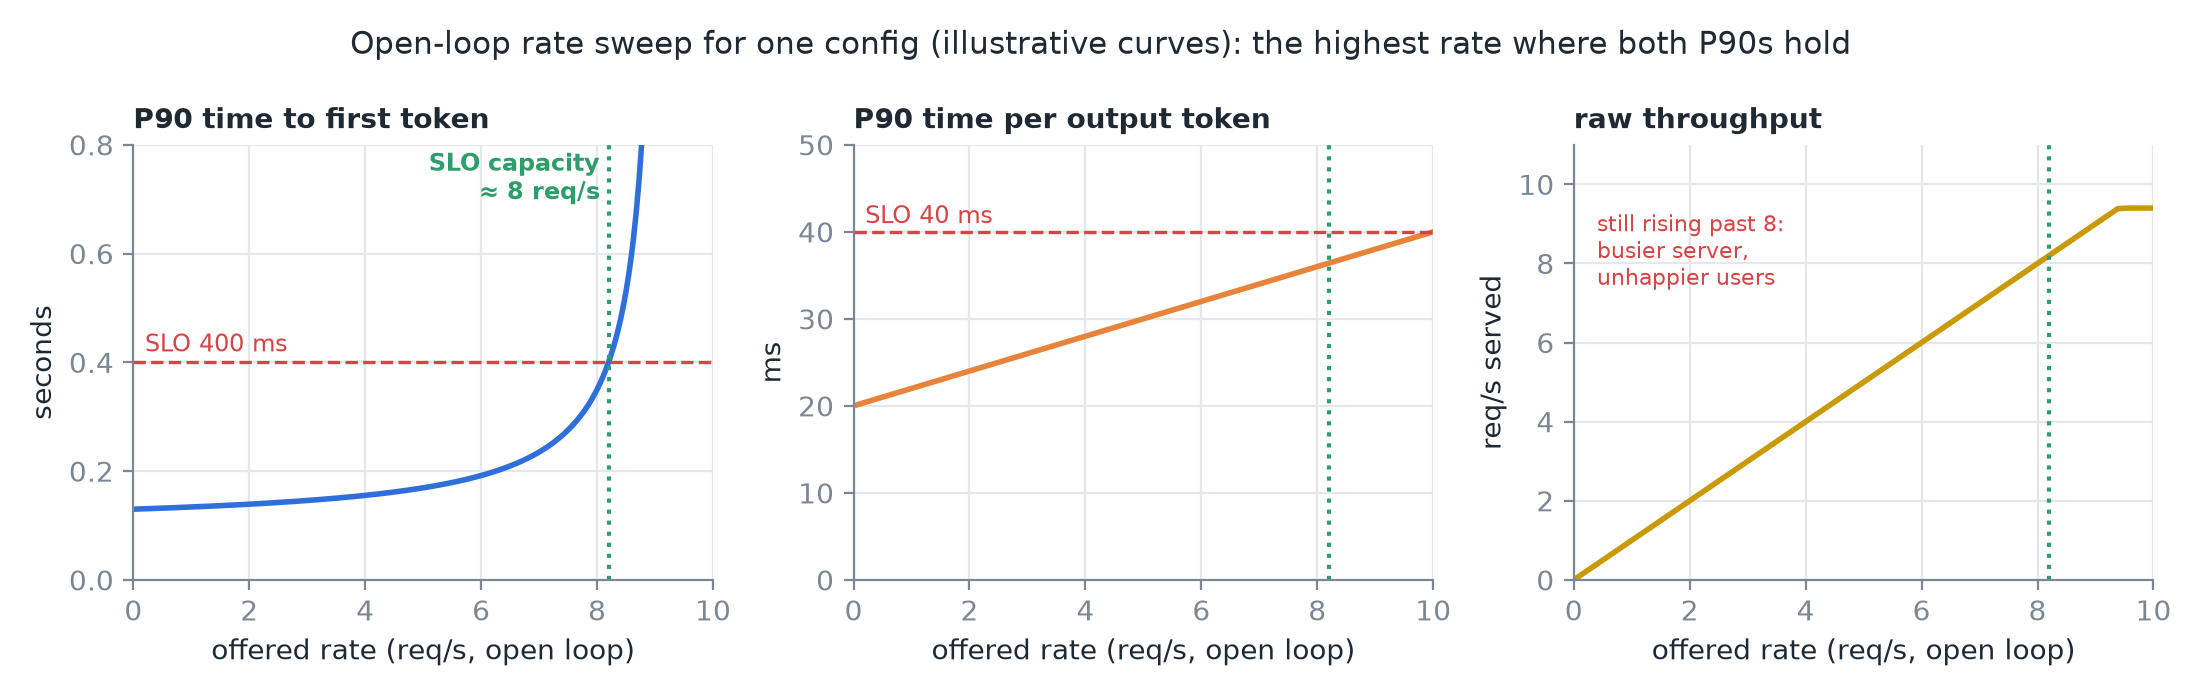 Hình dạng đường cong mang tính minh hoạ; điểm cắt ở ≈ 8 req/s khớp với cấu hình B của bài.
- Vòng hở: gửi request ở rate cố định, như cách người dùng thật đến, dù server đã theo kịp hay chưa. Quét 2, 4, 6, 8 req/s.
- Ở mỗi rate ghi lại P90 TTFT và P90 TPOT. Khi rate tăng, hàng đợi hình thành nên TTFT cong lên; mỗi bước decode mang batch lớn hơn nên TPOT cũng nhích dần lên.
- Năng lực theo SLO = rate cao nhất mà cả hai vẫn đạt mục tiêu. Mỗi cấu hình một con số.
- Throughput thô tiếp tục tăng qua mức đó: server bận hơn trong khi người dùng kém hài lòng hơn.
3. Chọn cấu hình giữ lời hứa lâu nhất
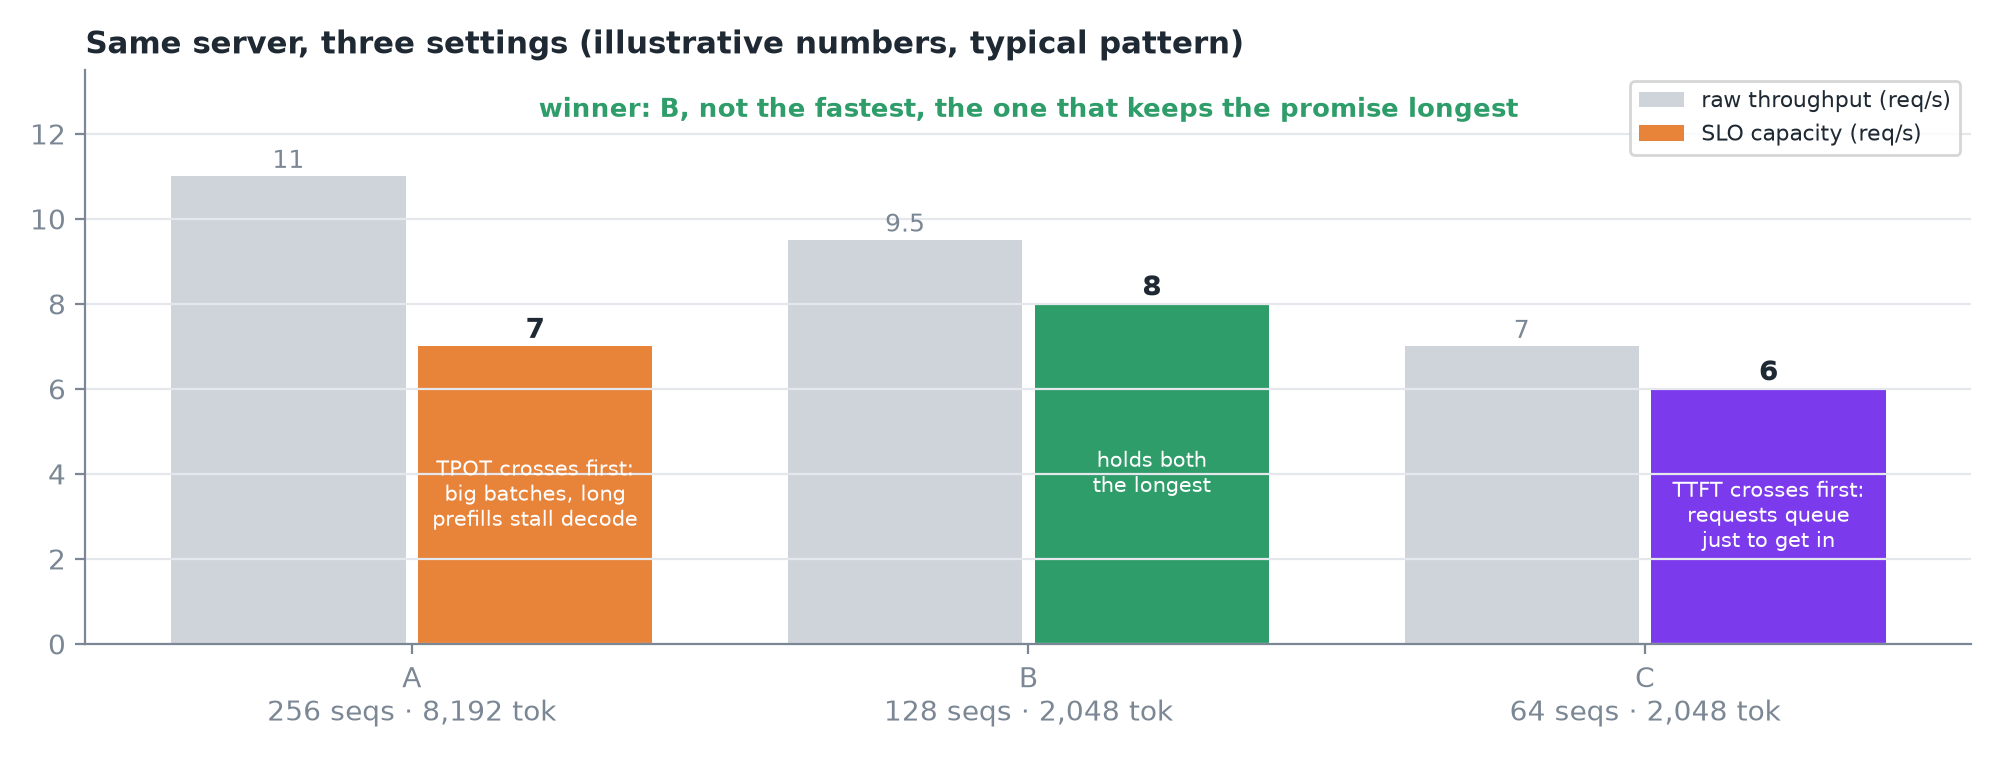 Các con số của bài mang tính minh hoạ, nhưng khuôn mẫu là thứ bạn sẽ gặp.
| Cấu hình | max_num_seqs · token mỗi bước | Thô | Năng lực theo SLO | Vỡ cái gì trước |
|---|---|---|---|---|
| A | 256 · 8.192 | 11 | 7 | TPOT: batch lớn làm chậm mọi bước, prefill dài làm mọi người khựng |
| B | 128 · 2.048 | 9,5 | 8 | Giữ được cả hai lâu nhất |
| C | 64 · 2.048 | 7 | 6 | TTFT: request phải xếp hàng chỉ để được vào |
- Người thắng là B: không phải nhanh nhất, mà là cái ở trong lời hứa lâu nhất.
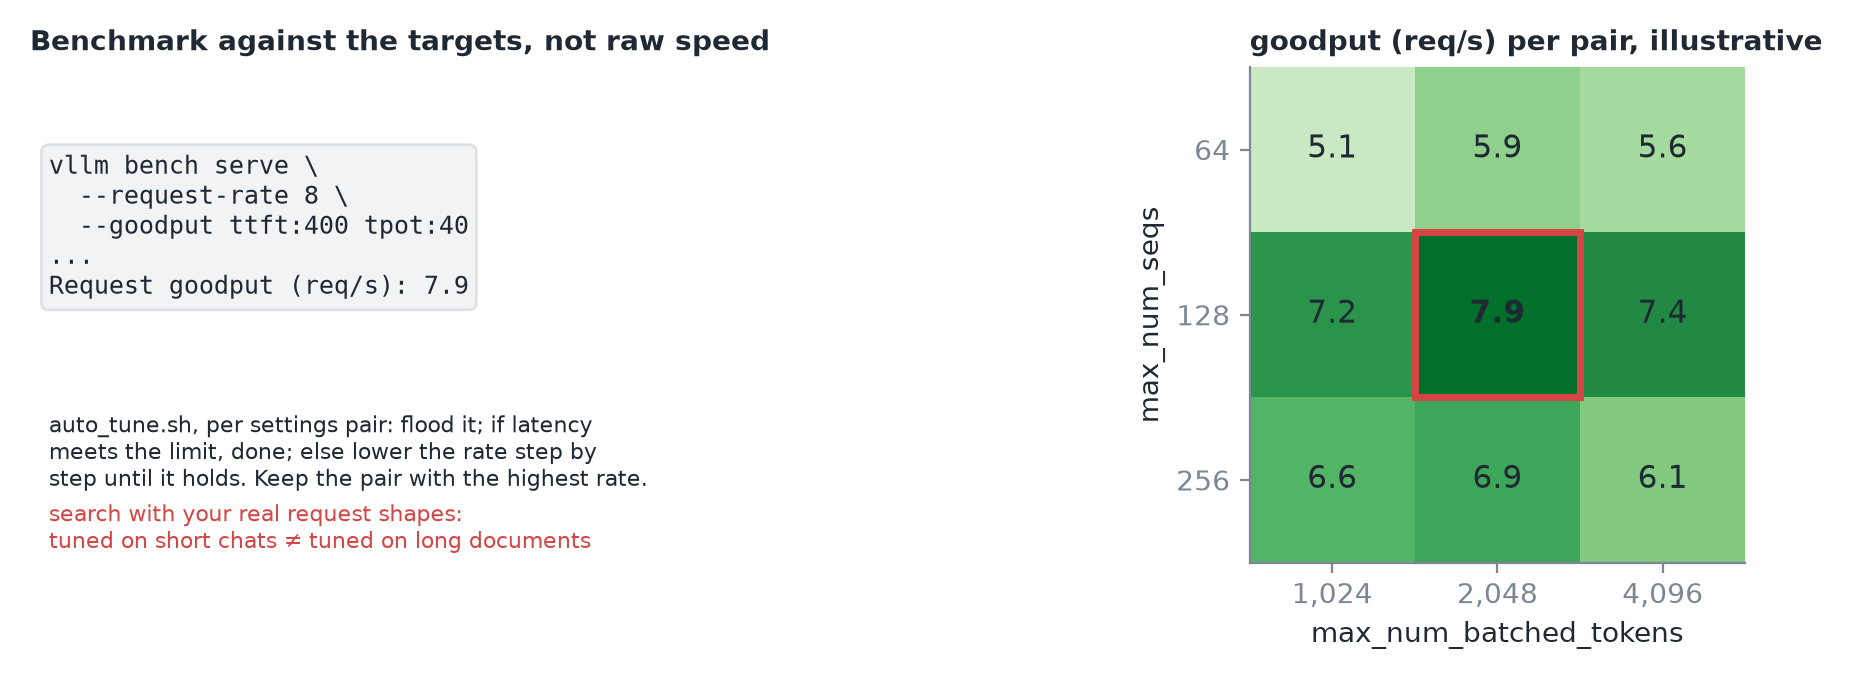 Giá trị lưới mang tính minh hoạ; cặp tốt nhất (128, 2.048) là cấu hình B.
vllm bench serve --goodput ttft:400 tpot:40nhận mục tiêu của bạn trực tiếp và báo goodput, số request mỗi giây đạt mục tiêu.- Script tự tinh chỉnh của vLLM chạy cả lượt tìm kiếm: với mỗi cặp cấu hình, khởi động server, dội tải vào, và nếu latency trượt giới hạn thì hạ rate cho tới khi giữ được. Giữ cặp có rate cao nhất.
Cảnh báo
Chạy lượt tìm kiếm với shape request thật của bạn. Một cấu hình tinh chỉnh cho chat ngắn có thể thua với tài liệu dài.
4. Sao không chạy ở 8? Xếp hàng
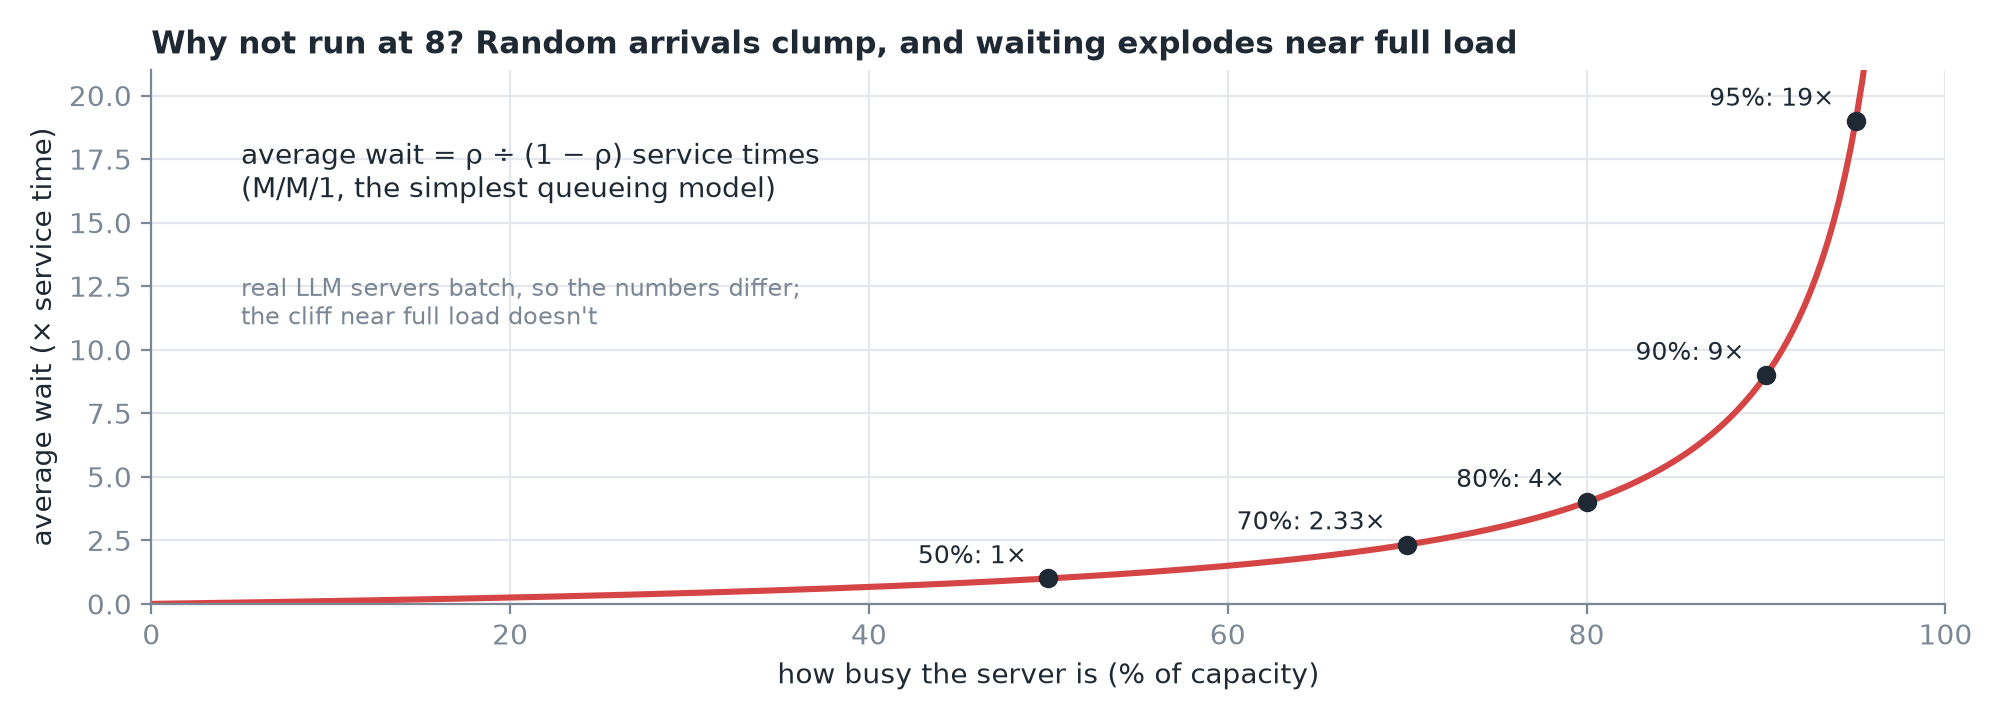 Cả năm điểm đều khớp với ρ ÷ (1 − ρ).
- Request dồn cục: có lúc ba cái đến cùng lúc, có lúc một hồi không có cái nào. Server càng đầy, những request không may càng phải chờ lâu.
- Trong mô hình đơn giản nhất (M/M/1), thời gian chờ là tải ÷ năng lực dư: 1 lần ở 50% bận, 2,3 lần ở 70%, 4 lần ở 80%, 9 lần ở 90%, 19 lần ở 95%.
- Server LLM thật có batching, nên con số cụ thể khác. Nhưng vách đá gần đầy tải thì không. Chạy ở mức năng lực là để latency phần đuôi của bạn đứng chênh vênh ngay mép vực.
5. Đợt dồn
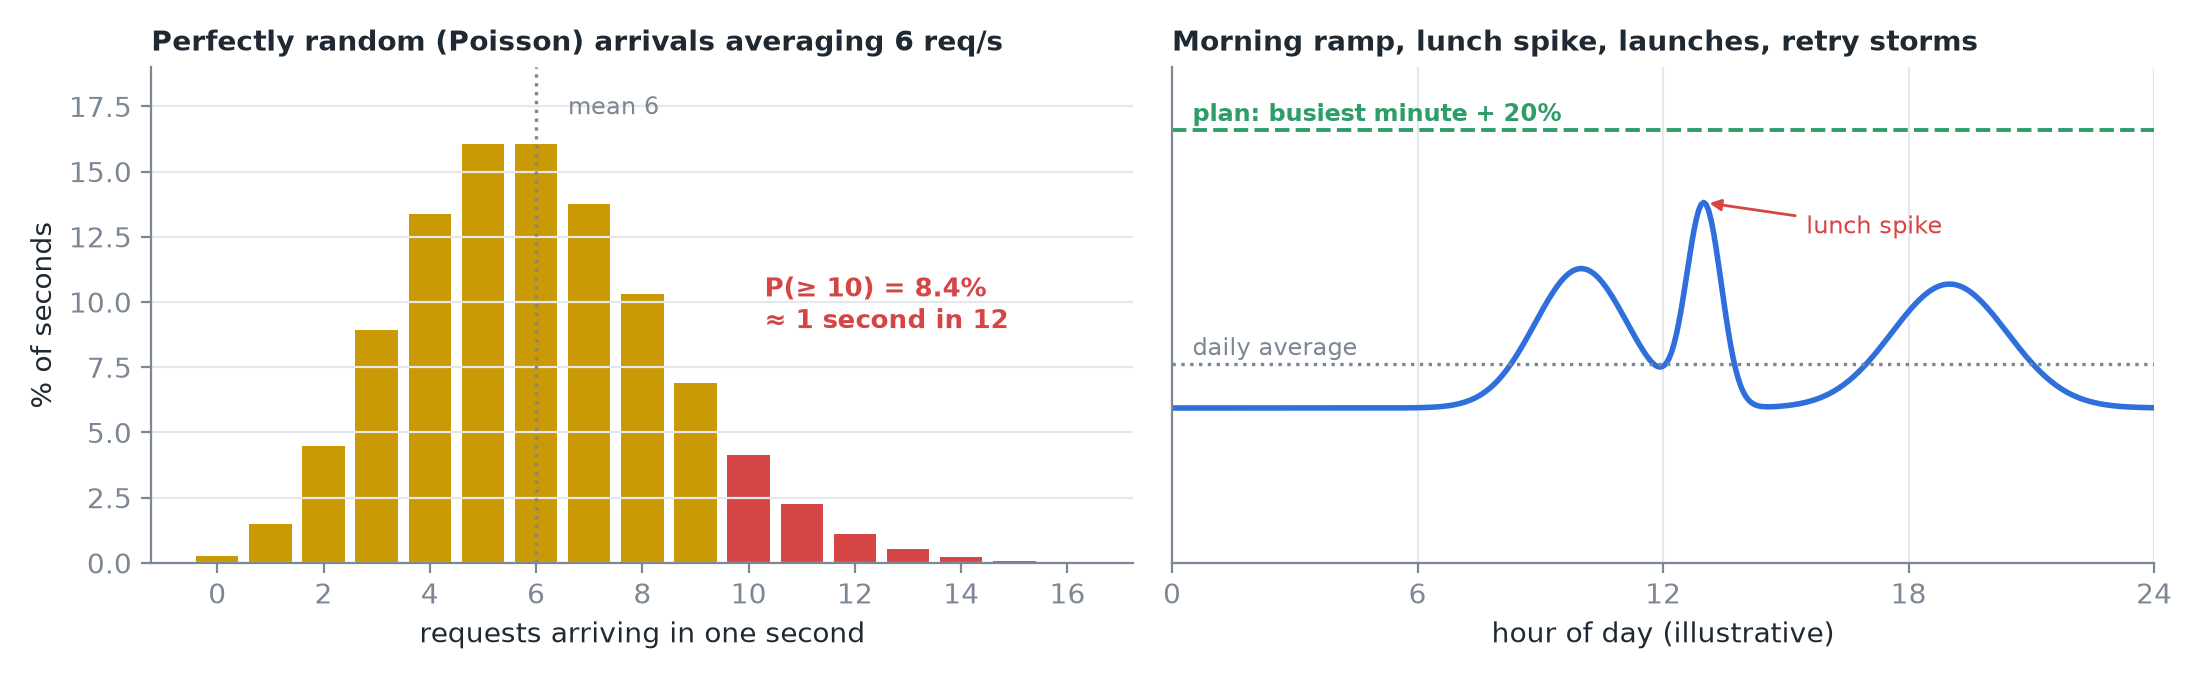 Trái là phân phối Poisson chính xác với trung bình 6; phải là hình dạng theo ngày mang tính minh hoạ.
- Kể cả request đến hoàn toàn ngẫu nhiên với trung bình 6 req/s cũng mang tới 10 cái trở lên trong khoảng 1 giây trên mỗi 12 giây (P = 8,4%).
- Lưu lượng thật cũng không phẳng: tăng dần buổi sáng, đỉnh giờ trưa, một đợt ra mắt, một cơn bão retry.
- Lên kế hoạch cho phút bận nhất, không phải trung bình ngày, và giữ thêm một biên phía trên. Ở đây: 20%.
6. Sự cố
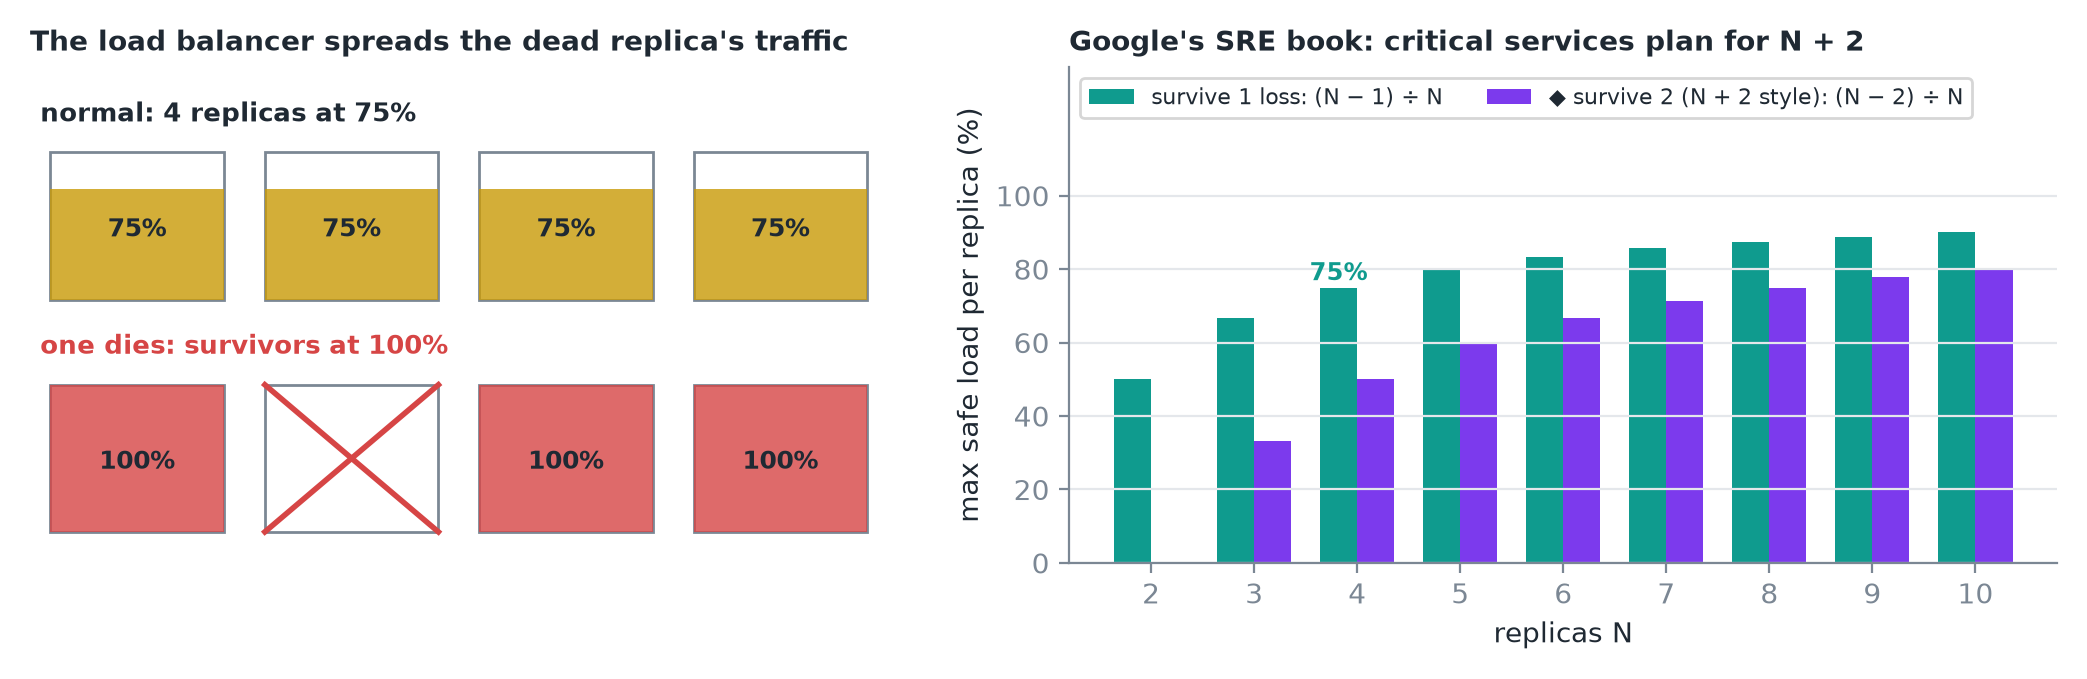 ◆ Các thanh (N − 2) ÷ N là phép tính của tôi cho quy tắc N + 2.
- Bốn replica, mỗi cái ở 75%. Một cái chết; lưu lượng của nó không biến mất. Load balancer rải nó lên ba cái còn lại, chúng nhảy lên 100%: ngay mép vực, đúng vào ngày bạn đã đang gặp rắc rối.
- Để sống sót khi mất một trong N replica, mỗi replica chỉ được chạy ở (N − 1) ÷ N năng lực của nó: 75% với bốn.
- Sách SRE của Google mô tả các team lên kế hoạch cho N + 2, sống sót khi mất hai cái cùng lúc. Dịch vụ càng quan trọng, biên càng lớn.
7. Ngân sách cho cấu hình B
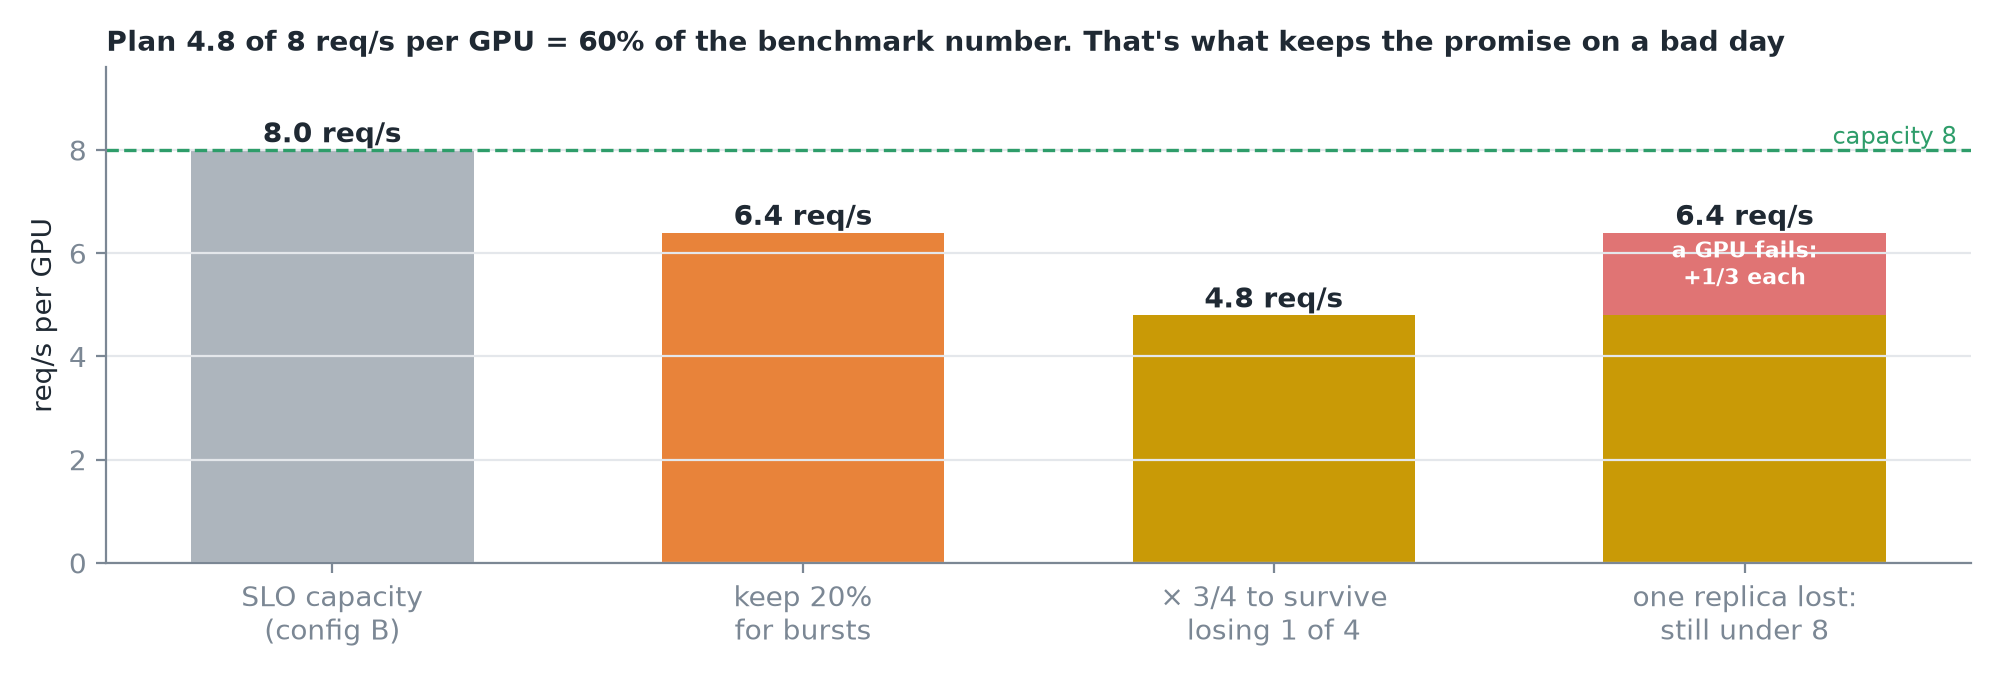 Năng lực mang tính minh hoạ; phép tính là phương pháp.
- Năng lực theo SLO 8 req/s, giữ 20% cho đợt dồn → 6,4.
- Bốn replica phải sống sót khi mất một → bình thường mỗi cái chạy ở ¾ của 6,4 = 4,8 req/s mỗi GPU.
- Một GPU hỏng → các replica còn lại tăng lên 6,4: vẫn dưới năng lực.
- Lên kế hoạch cho khoảng 60% con số benchmark. Đó không phải lãng phí; đó là thứ giữ được lời hứa vào ngày tồi tệ.
Mẹo
◆ Trong lúc có sự cố, các replica còn lại nằm ở 6,4, nên biên 20% cho đợt dồn giờ là thứ hấp thụ phần tải thêm. Một đợt dồn trong lúc có sự cố thì không còn gì che chắn, đó là lý do các dịch vụ quan trọng đi tới N + 2.
8. Bảo vệ điểm vận hành
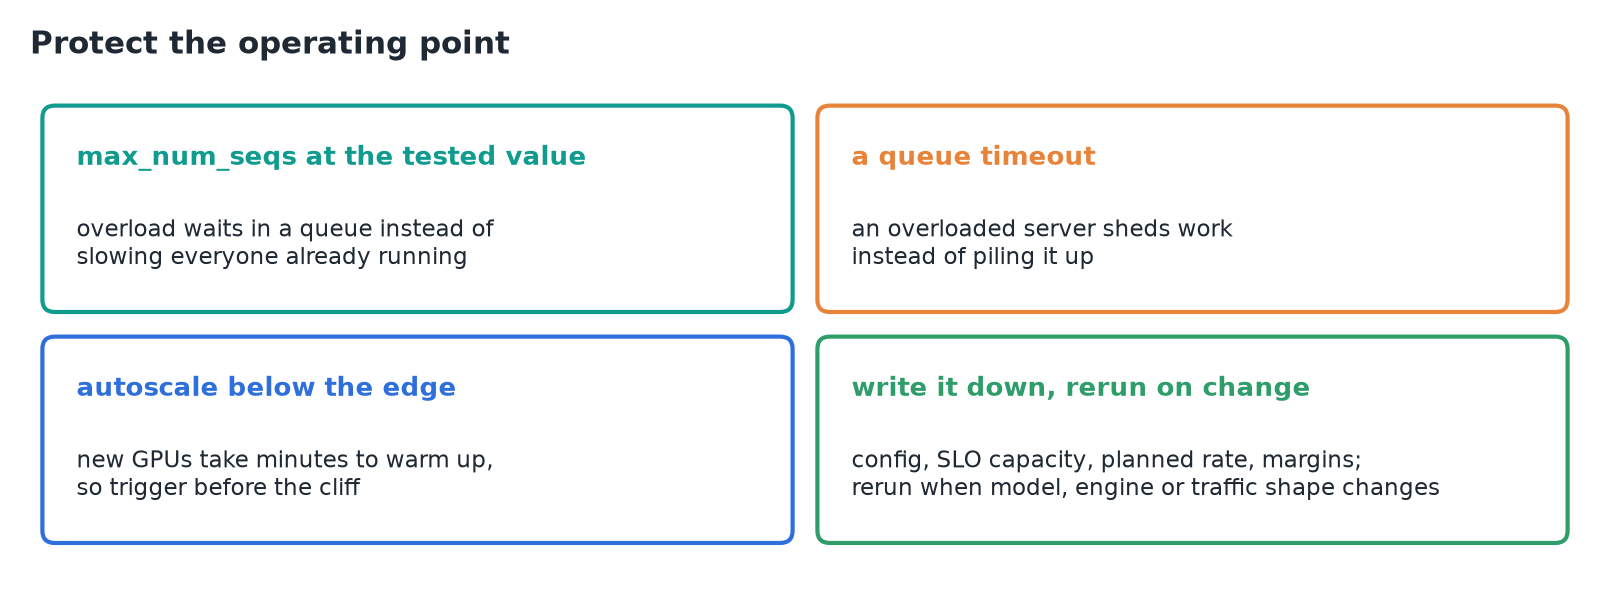
max_num_seqsở giá trị đã kiểm thử, để quá tải thì chờ trong hàng đợi thay vì làm chậm mọi người đang chạy.- Một queue timeout, để server quá tải bỏ bớt việc thay vì dồn chồng nó lên.
- Autoscale trước khi tới mép, không phải ngay ở mép: GPU mới cần vài phút để khởi động xong.
- Ghi lại: cấu hình, năng lực theo SLO, rate dự kiến và các biên. Chạy lại mỗi khi model, engine hoặc shape lưu lượng thay đổi.
9. Tóm tắt