13 · Logits, lấy mẫu và token tiếp theo
Nguồn: fanout.sh / inference-eng / 02-04 · ~7 phút
Ghi chú
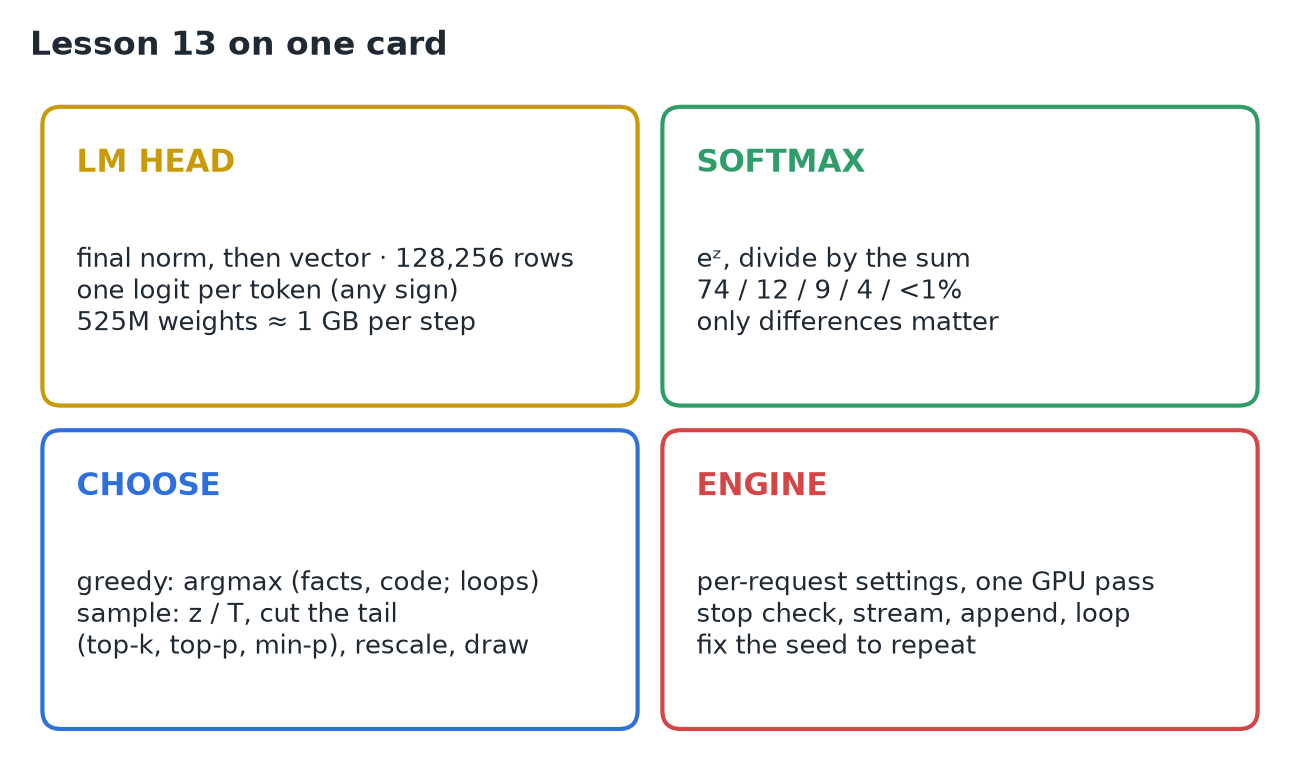
Sau 32 layer, vector của token cuối thành văn bản qua ba bước: điểm cho từng mục trong vocabulary, xác suất từ các điểm đó, và một lựa chọn. LM head (sau một lần RMSNorm cuối) tính tích vô hướng của vector với 128.256 hàng để ra logits. Softmax biến chúng thành xác suất, và chỉ hiệu số giữa chúng là quan trọng. Sau đó hoặc lấy cái cao nhất (greedy) hoặc lấy mẫu (sample), sau khi temperature nắn lại phân phối và top-k / top-p / min-p cắt bỏ phần đuôi. Engine làm việc này cho mọi request trong batch, ở mọi bước, trên GPU, rồi kiểm tra điều kiện dừng, stream, nối token và lặp lại.
1. LM head: mỗi token một điểm
Vector đi qua một lần RMSNorm cuối, rồi được nhân với language model head: một ma trận có mỗi hàng cho một token trong vocabulary (128.256 với Llama 3). Mỗi hàng là một hướng trong cùng không gian 4.096 chiều; tích vô hướng với vector chính là điểm của token đó, tức logit của nó. Hàng nào cùng hướng với vector thì có logit cao.
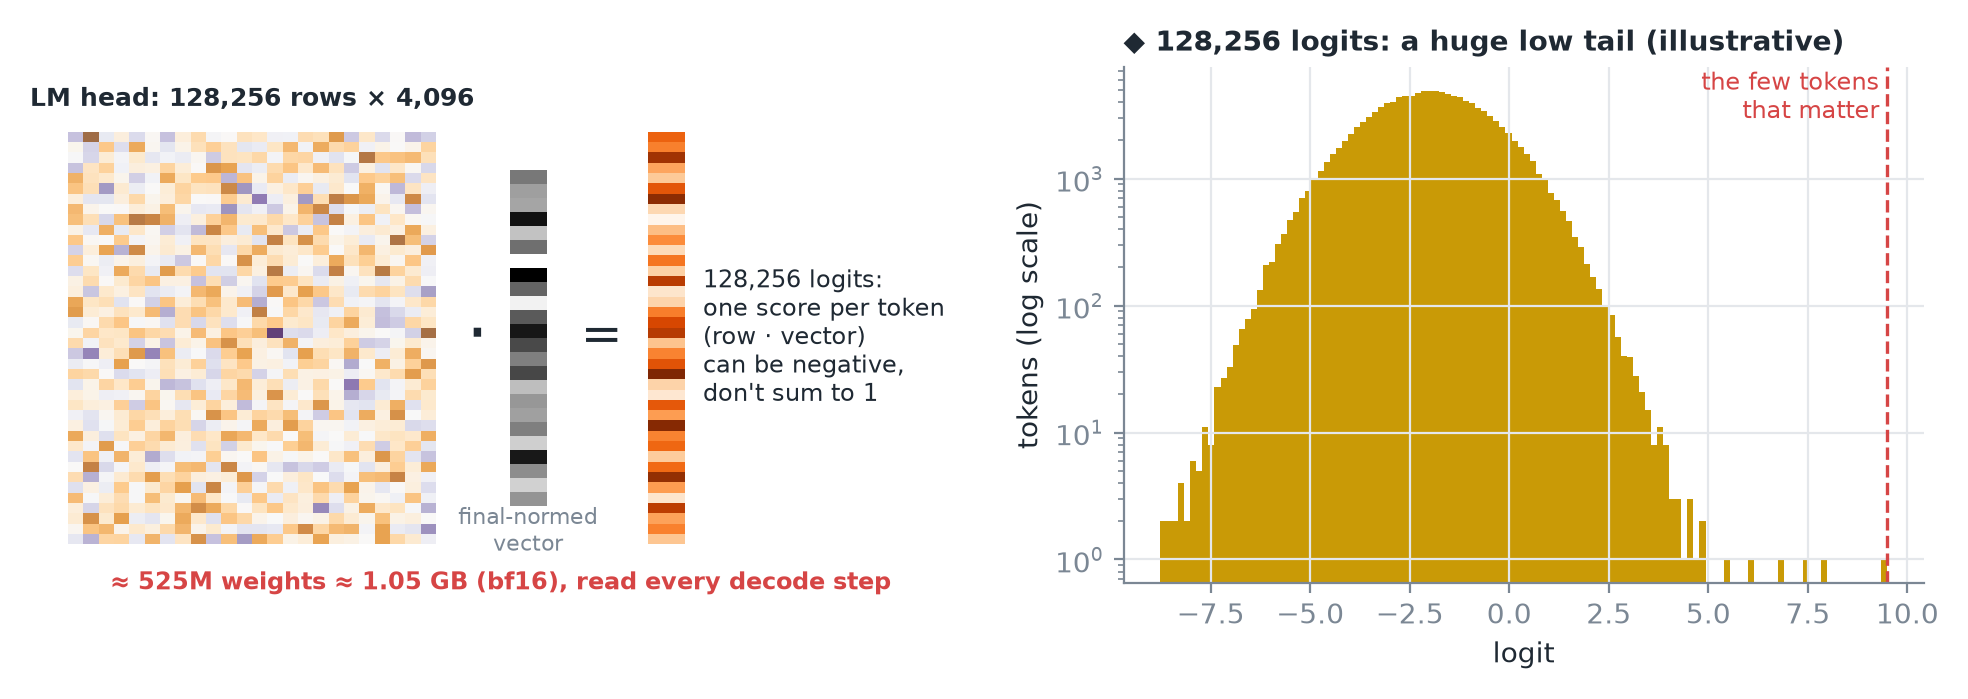 128.256 × 4.096 ≈ 525 triệu trọng số ≈ 1 GB ở bf16, bị đọc ở mọi bước decode.
Mẹo
Chỉ logits ở vị trí cuối quyết định token tiếp theo, nên trong prefill engine chỉ chạy head cho một vị trí, không phải cả prompt (kích thước xem bài 10).
2. Softmax: từ điểm sang xác suất
Logits chỉ là điểm: chúng có thể âm và tổng không bằng con số cụ thể nào. Vocabulary đồ chơi, prompt "The capital of France is":
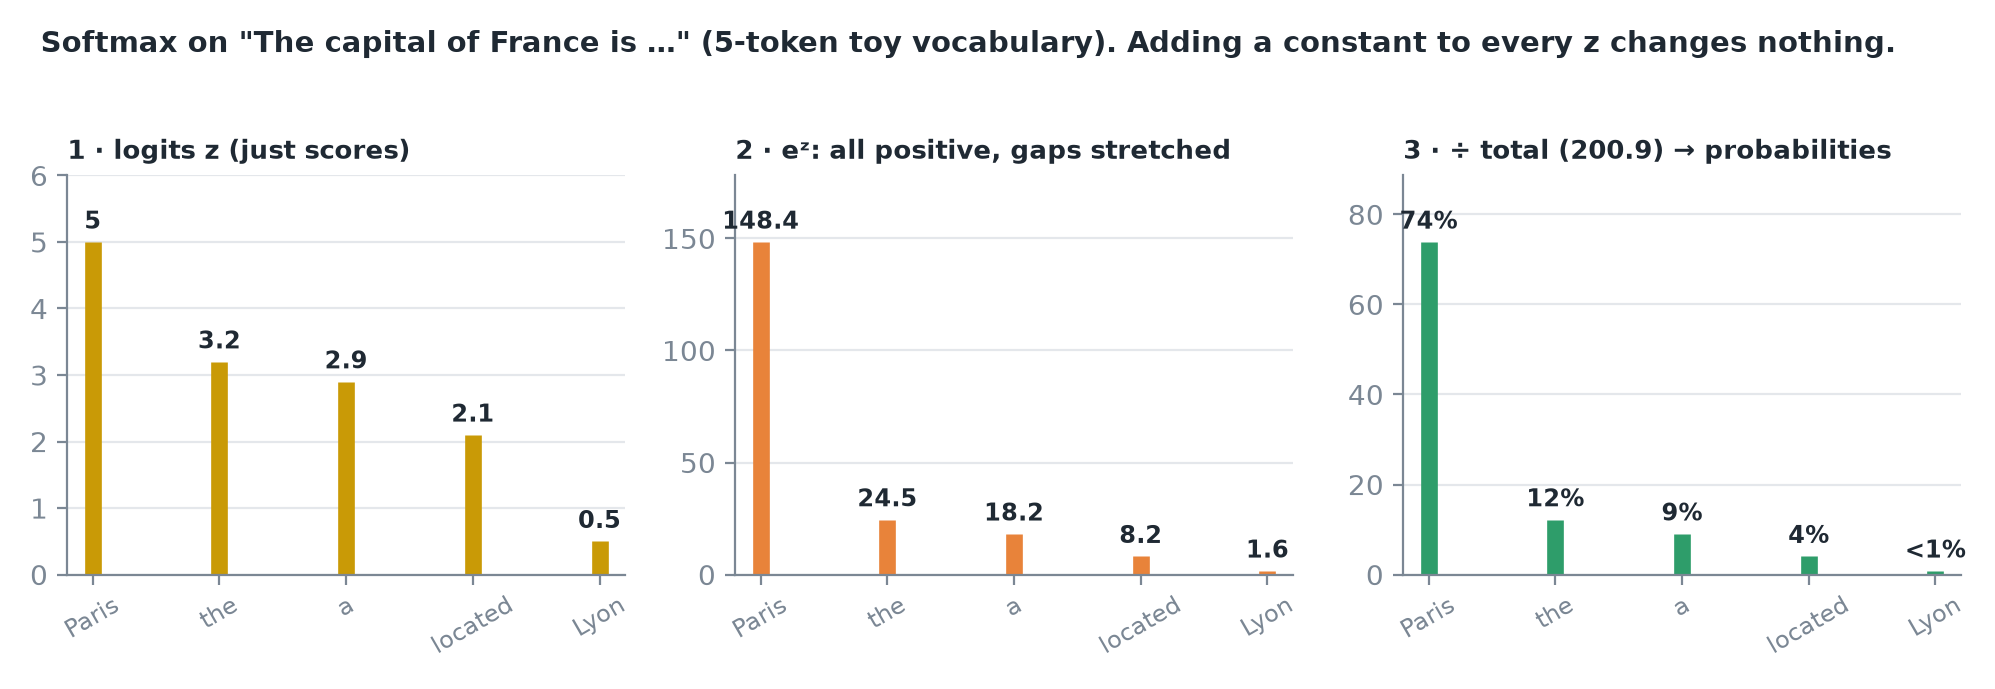 Lấy e mũ từng logit (tất cả thành dương, khoảng cách bị kéo giãn), rồi chia cho tổng (200,9) để tổng bằng 1.
Quan trọng
Cộng cùng một số vào mọi logit không thay đổi gì. Chỉ hiệu số giữa các logit là quan trọng.
3. Lựa chọn: greedy hay lấy mẫu
- Greedy: luôn lấy token có khả năng cao nhất (ở đây là Paris). Nhanh và lặp lại được, rất hợp cho sự kiện và code. Khi viết tự do, nó có thể mắc kẹt trong vòng lặp ("…and the cat sat on the mat and the cat sat on the mat…").
- Lấy mẫu: rút ngẫu nhiên, có trọng số theo xác suất.
Temperature nắn lại xác suất trước khi rút: chia mọi logit cho T, rồi softmax lại.
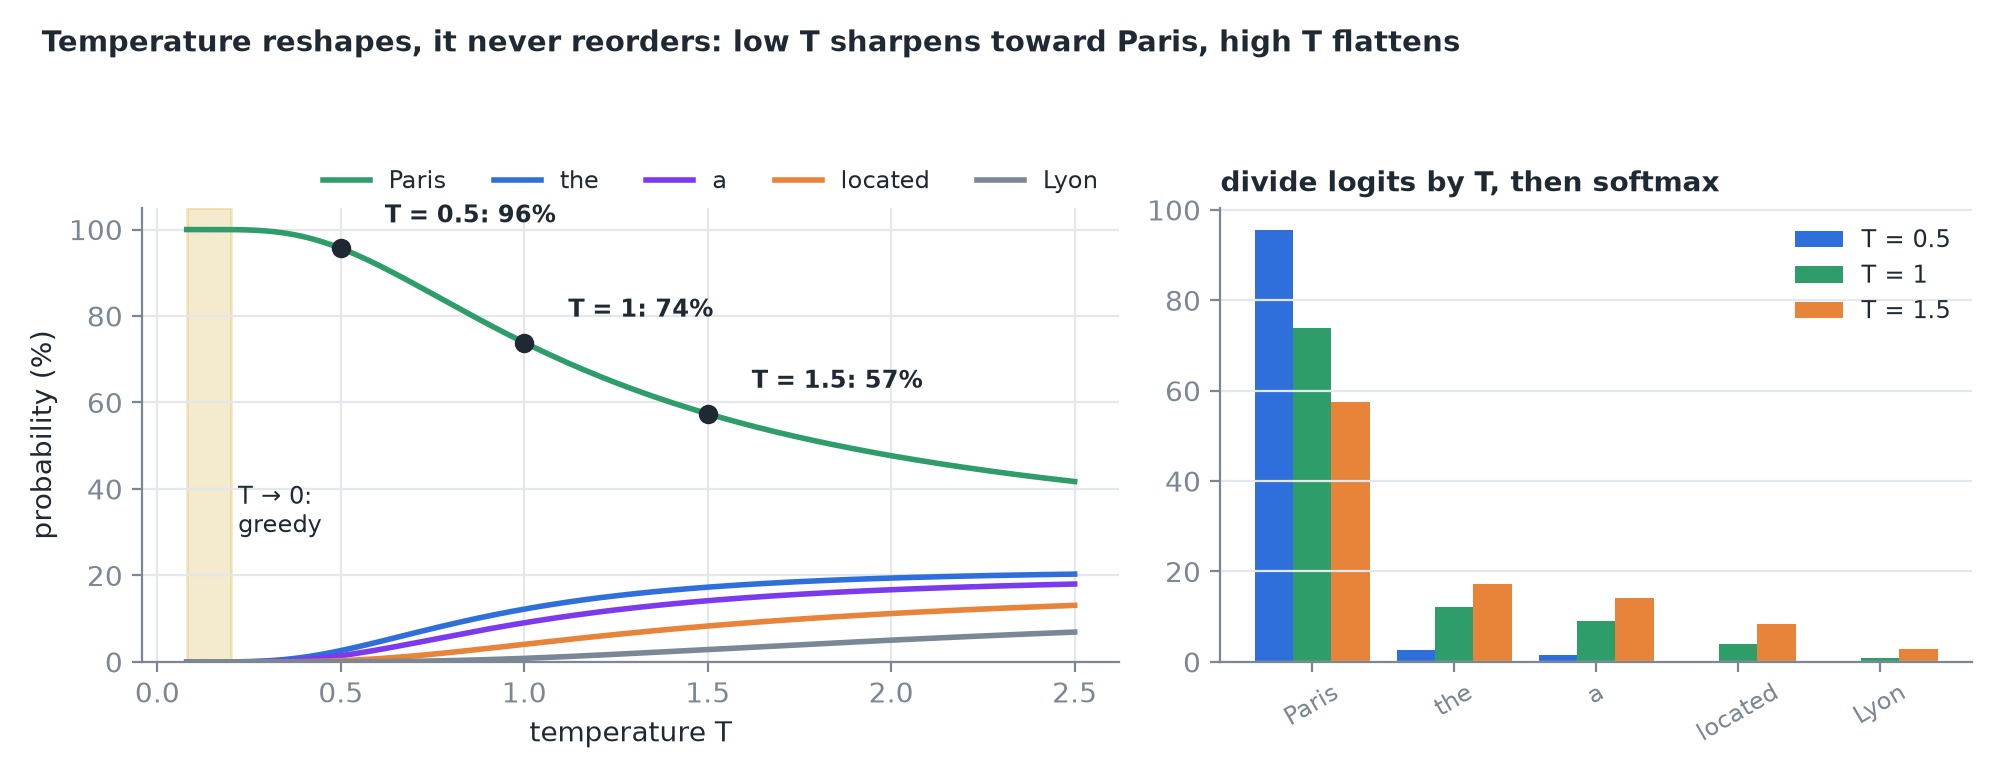 T = 1 không đổi gì; T = 0,5 kéo giãn khoảng cách (Paris 96%); T = 1,5 ép chúng lại (Paris 57%). Khi T → 0, lấy mẫu trở thành greedy, nên các API coi temperature 0 là greedy.
4. Cắt bỏ phần đuôi
Kể cả ở temperature hợp lý, ~128.000 token ít khả năng vẫn chia nhau một chút xác suất. Rút đủ nhiều token thì sớm muộn một token kỳ quặc sẽ được chọn. Vì vậy ta cắt bỏ phần đuôi và chia lại phần còn lại cho tổng bằng 1.
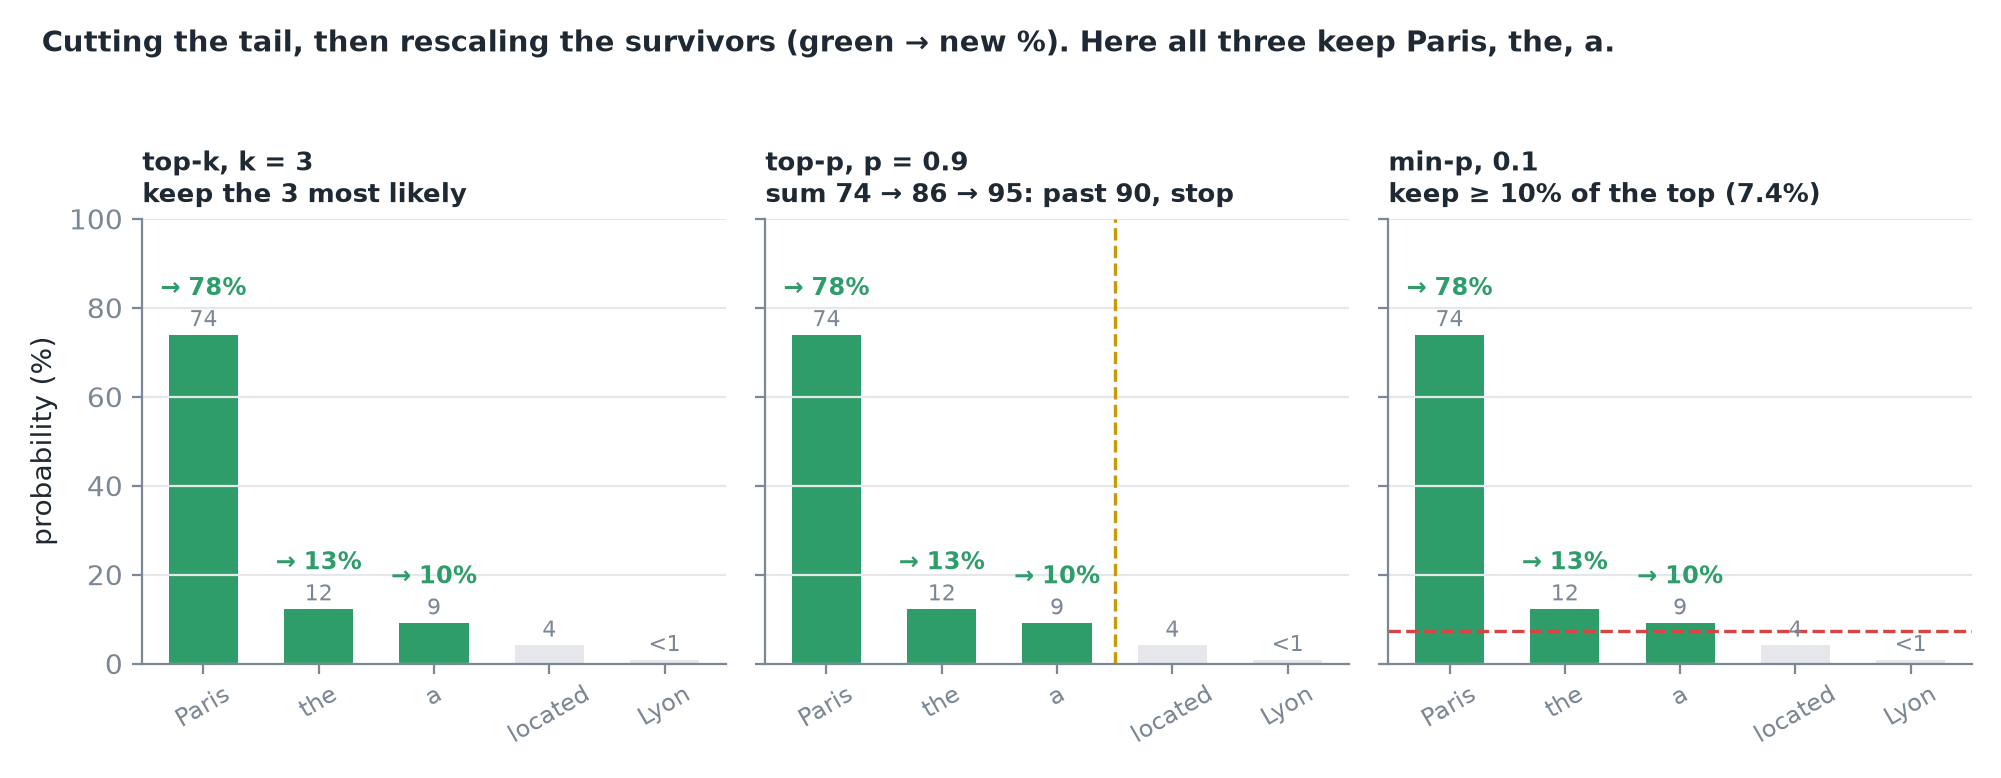 Top-k giữ một số lượng cố định; top-p giữ tập nhỏ nhất có tổng cộng dồn vượt p; min-p giữ mọi token có xác suất ít nhất bằng một tỷ lệ của token cao nhất.
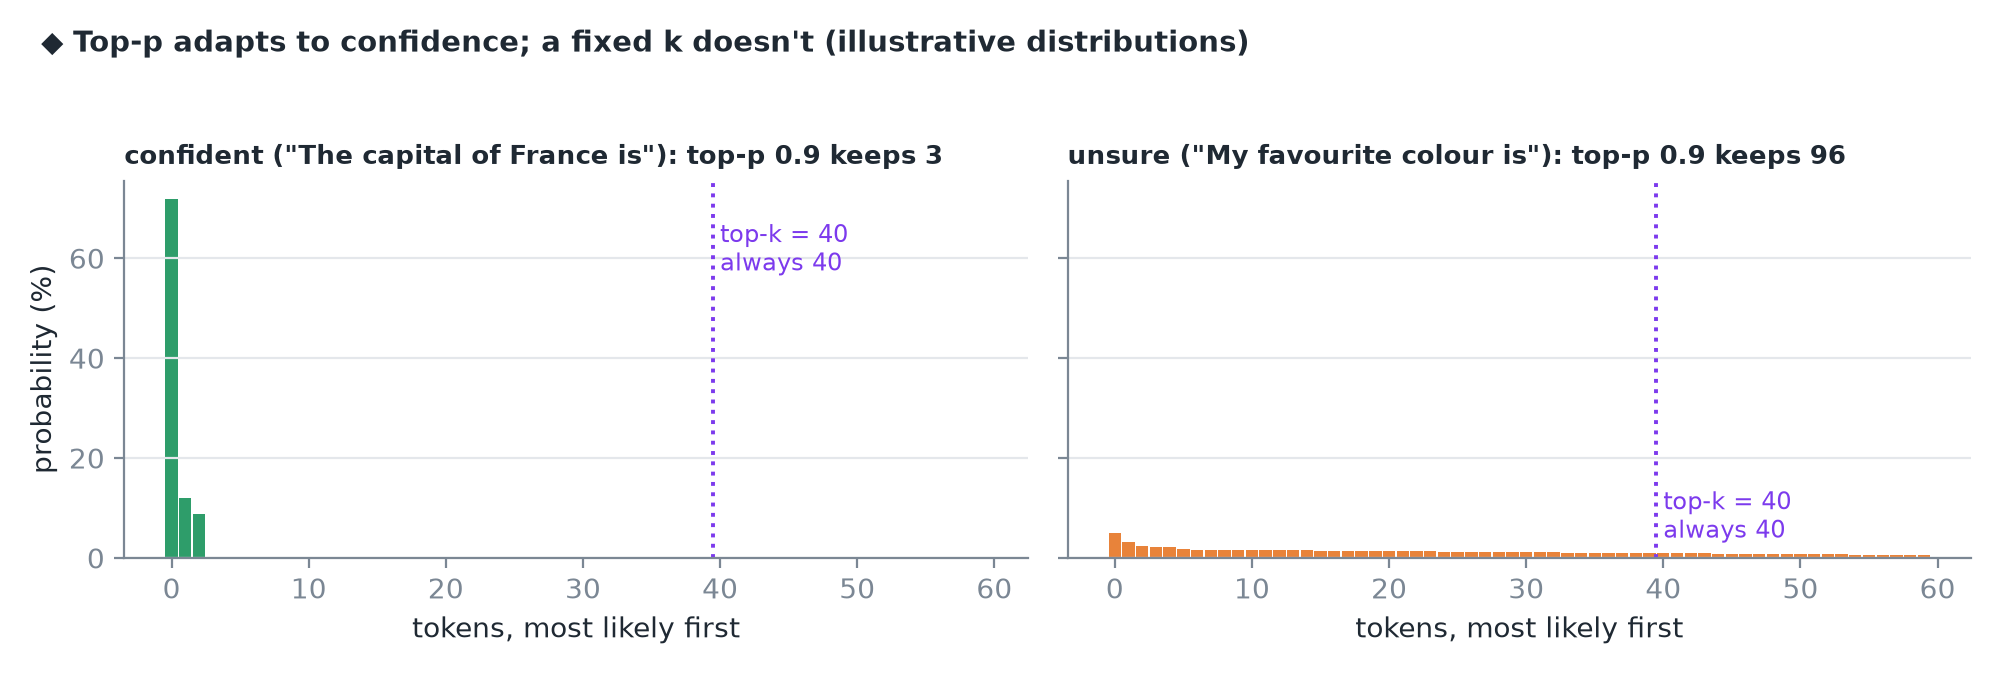
Một k cố định bỏ qua mức tự tin của model. Top-p tự thích ứng: khi model tự tin, nucleus rất nhỏ; khi nó phân vân, nucleus lớn lên. Min-p là quy tắc mới hơn theo cùng tinh thần.
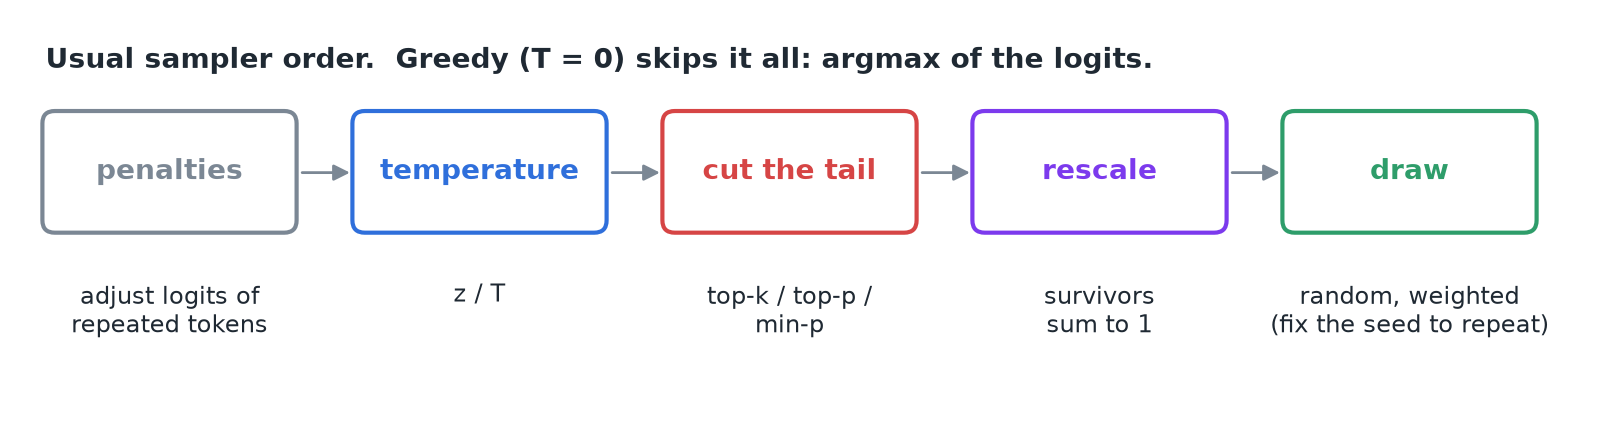
Thứ tự thường gặp:
5. Bên trong một engine
Khi serve nhiều request cùng lúc, mỗi bước sinh ra một hàng logits cho mỗi request, và mỗi request có thể mang cấu hình riêng (một cái greedy, cái khác T 0,8 với top-p 0,95). Sampler của engine áp cấu hình của từng request lên hàng của nó, tất cả trên GPU, trong một lượt.
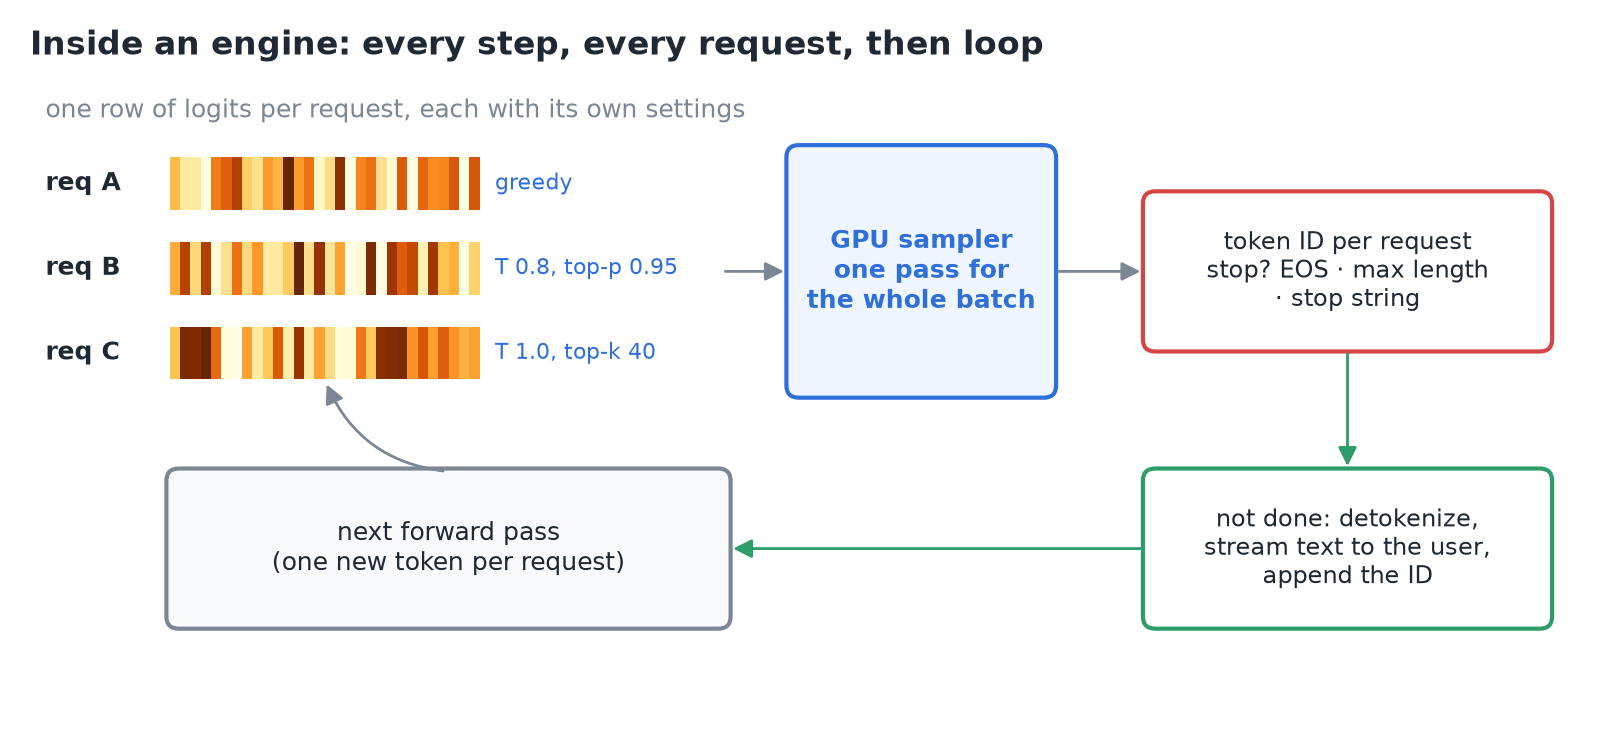 Đầu ra là một token ID cho mỗi request. Dừng nếu đó là token kết thúc văn bản, đạt độ dài tối đa, hoặc gặp stop string. Nếu không thì đổi ID thành văn bản, stream đi, và nối vào để forward pass kế tiếp sinh ra token sau nó.
Cần cùng một đầu ra được lấy mẫu hai lần? Cố định random seed.
6. Tóm tắt