01 · Inference và Inference Engineering là gì?
Nguồn: fanout.sh / inference-eng / in-01 · ~9 phút
Ghi chú
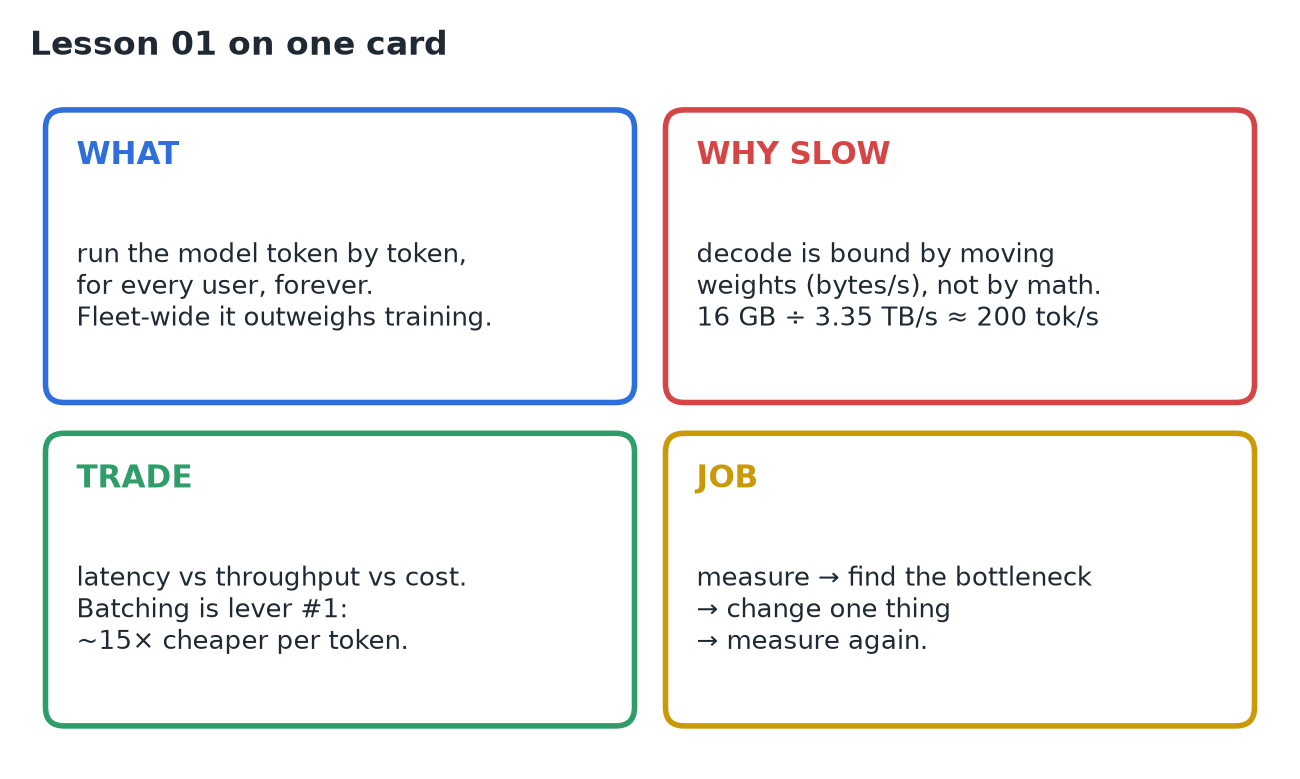
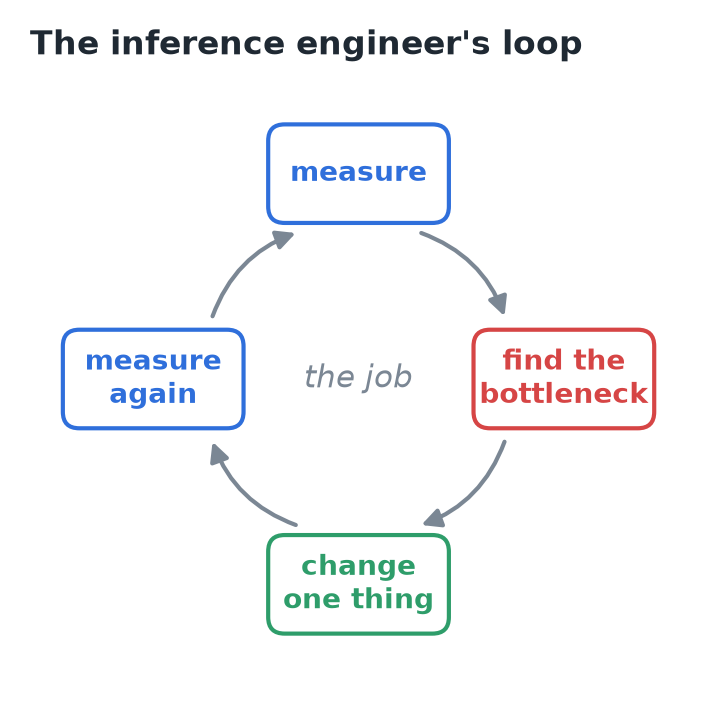
Inference là chạy một model đã huấn luyện, từng token một, mỗi khi có người dùng nó, nên tính trên cả fleet thì chi phí thường cao hơn huấn luyện. Decode bị giới hạn bởi băng thông bộ nhớ (chuyển trọng số), không phải bởi phép tính. Latency, throughput và chi phí kéo nhau theo các hướng ngược nhau, và batching là đòn bẩy đầu tiên. Công việc là một vòng lặp: đo, tìm nút thắt, đổi một thứ, đo lại.
1. Vì sao inference quan trọng: hoá đơn của DeepSeek
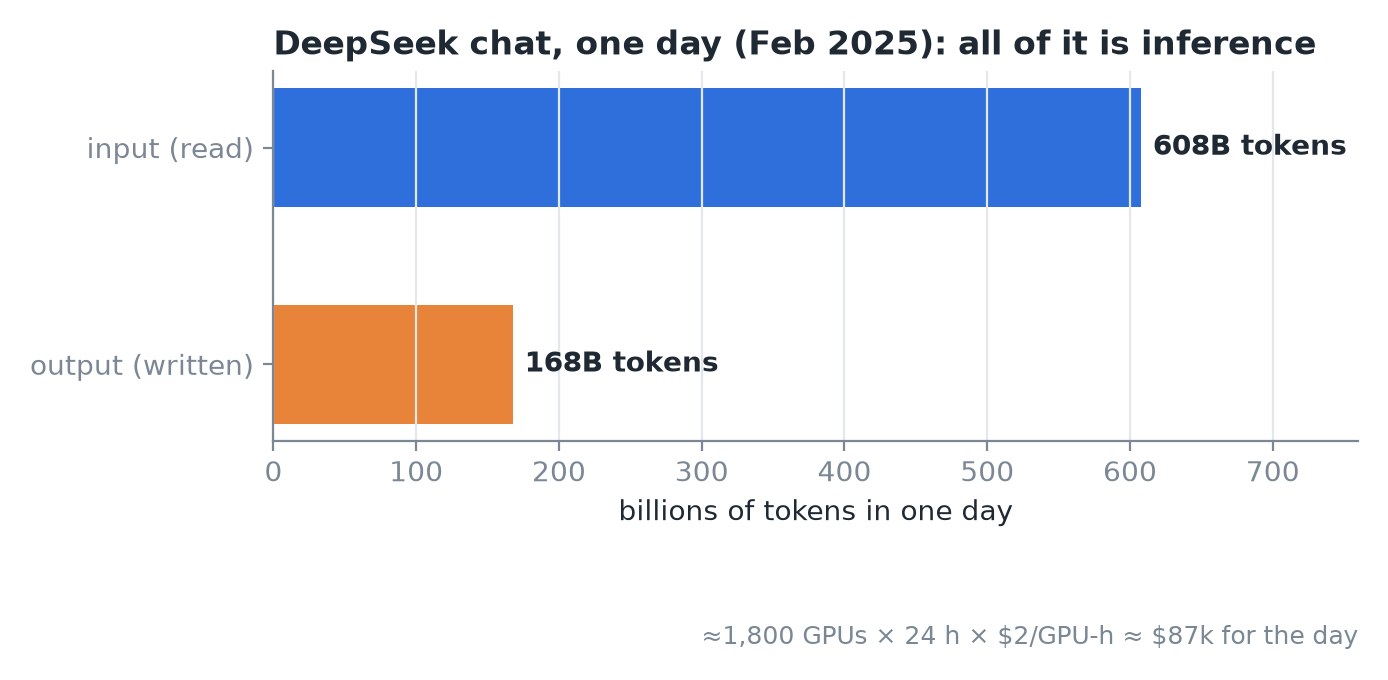 Dịch vụ chat DeepSeek, 24 giờ, tháng 2/2025: trung bình ~1.800 GPU, ~87 nghìn USD cho cả ngày với giá 2 USD/GPU-giờ.
- Một ngày chat của DeepSeek: đọc 608 tỷ token đầu vào, viết 168 tỷ token đầu ra.
- Chạy trên trung bình ~1.800 GPU. Với giá 2 USD/GPU-giờ: 1.800 × 24 × 2 USD ≈ 87 nghìn USD/ngày.
- Model đã được huấn luyện từ nhiều tháng trước. Từng token trong số đó đều là inference.
Quan trọng
Khoảng cách giữa serving tốt và serving tệ đến từ một số ít quyết định kỹ thuật. Khoảng cách đó chính là công việc.
2. Inference thực ra là gì
- Một model đã huấn luyện chỉ là một file chứa các con số. Llama 3 8B có khoảng 8 tỷ tham số ở 16 bit (mỗi số 2 byte), nên file nặng khoảng 16 GB.
- Inference = chạy file đó. Đưa văn bản vào, dự đoán token tiếp theo, nối nó vào, rồi lặp lại cho tới khi xong. Đây là sinh tự hồi quy (autoregressive).
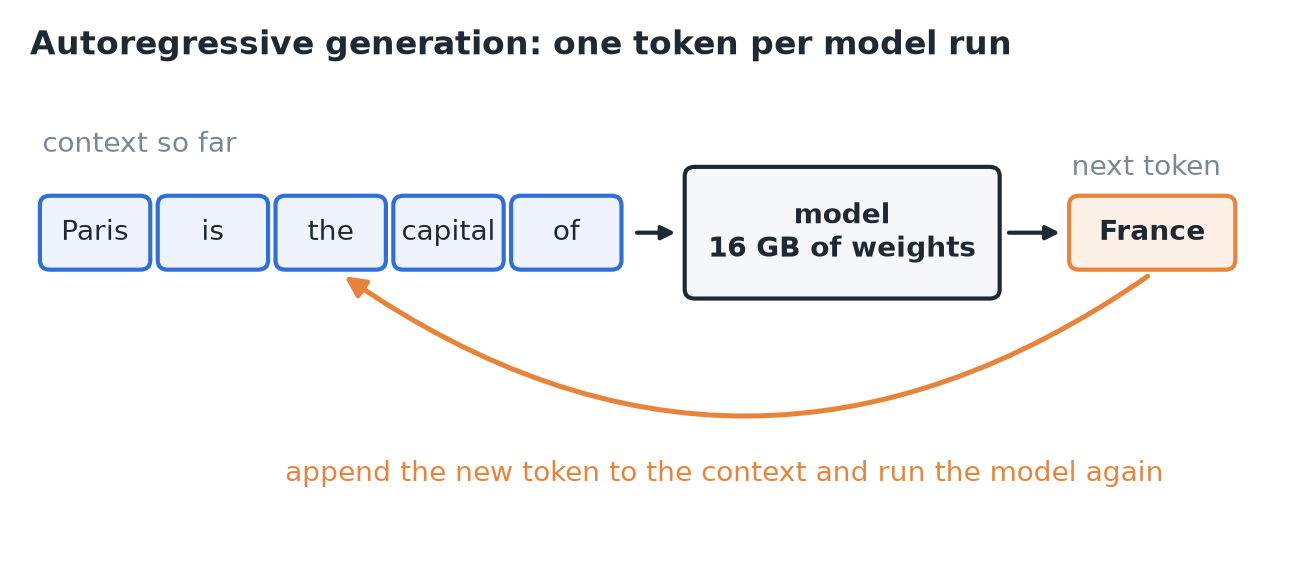 Vòng lặp tự hồi quy: mỗi token vừa sinh ra được đưa ngược lại làm đầu vào.
Huấn luyện so với inference
| Huấn luyện | Inference | |
|---|---|---|
| Tần suất | Một lần, hoặc vài lần | Mỗi request, mỗi cuộc chat, mỗi bước của agent |
| Dạng chi phí | Một khoản rất lớn, trả một lần | Liên tục, tăng theo lượng sử dụng |
- Trên toàn fleet của Google, 2019 đến 2021: ~3/5 năng lượng ML dành cho inference và ~2/5 cho huấn luyện.
- "Train một lần, serve mãi mãi." Chi phí lệch hẳn về một phía này là lý do inference thành một chuyên ngành riêng.
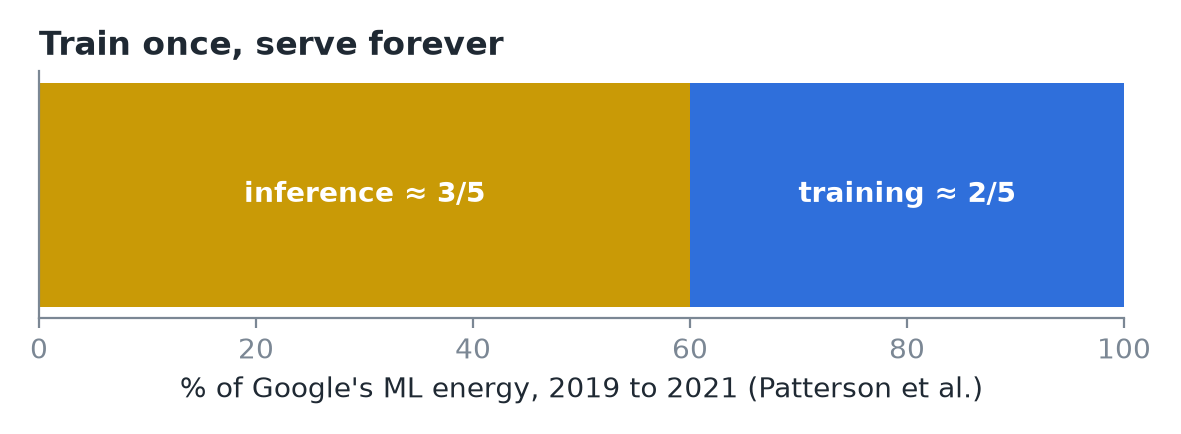 Năng lượng ML của Google, 2019 đến 2021 (Patterson và cộng sự).
3. Một request: prefill và decode
Ví dụ xuyên suốt: một ứng dụng chat serve Llama 3 8B trên một H100. Prompt dài ~500 token và câu trả lời ~250 token.
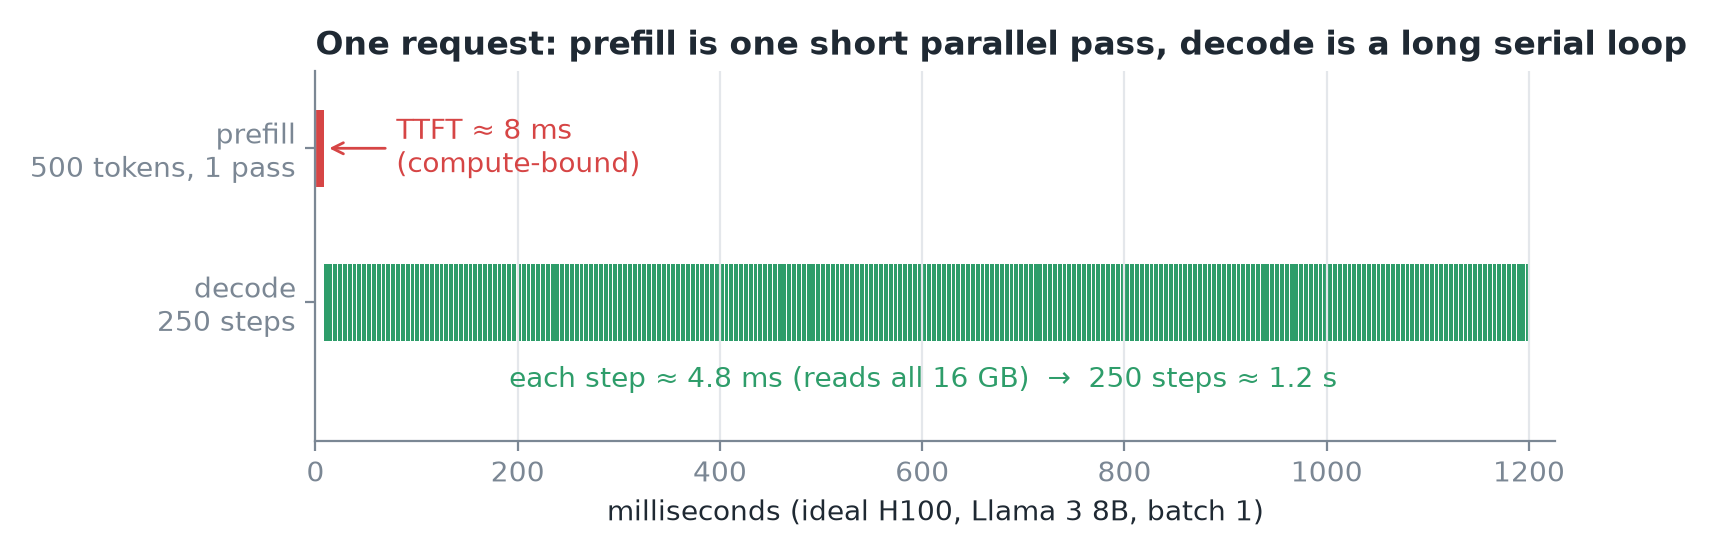 Thời gian lý tưởng: prefill xử lý cả 500 token prompt trong một lượt (dải đỏ mỏng là thời gian tới token đầu tiên), sau đó decode chạy 250 bước nối tiếp, mỗi bước khoảng 4,8 ms.
- Prefill: cả 500 token prompt đi qua model trong một lượt song song. Đây là khoảng dừng trước khi chữ đầu tiên hiện ra, gọi là TTFT (time to first token).
- Decode: sinh một token, nối vào, chạy lại. 250 bước tuần tự.
- Điều bất ngờ: mỗi bước decode đọc toàn bộ 16 GB trọng số từ bộ nhớ GPU (HBM) chỉ để tạo ra một token.
Trần băng thông (hãy thuộc phép tính này)
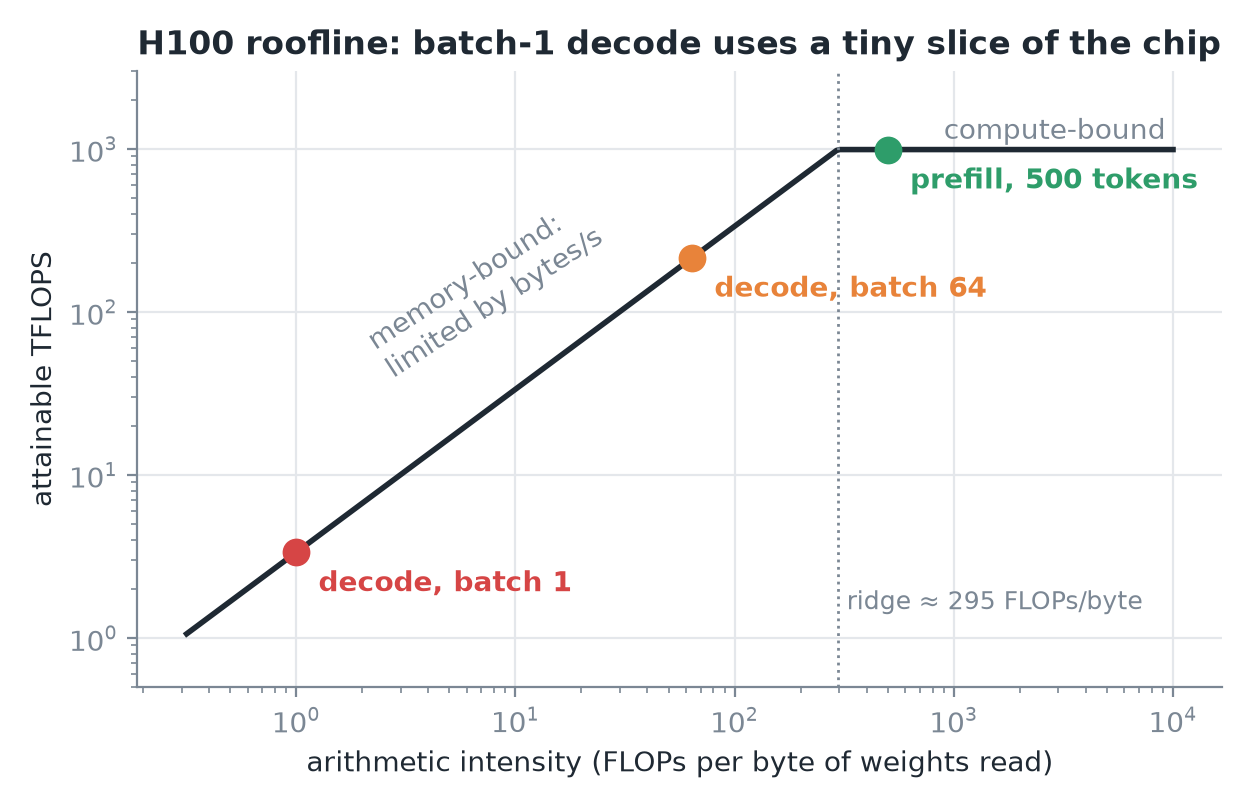 Decode với batch 1 làm khoảng 1 FLOP trên mỗi byte trọng số đọc vào, nằm rất xa bên trái điểm gãy, nên băng thông bộ nhớ quyết định tốc độ. Prefill nằm qua điểm gãy và bị giới hạn bởi tính toán (compute-bound).
Quan trọng
Đây là trần cứng cho một người dùng, kể cả khi code hoàn hảo. Chip có thể tính nhiều hơn rất nhiều; giới hạn nằm ở tốc độ byte đến nơi. Decode ở batch 1 bị giới hạn bởi băng thông bộ nhớ (memory-bandwidth-bound).
4. Ba con số (và một ràng buộc)
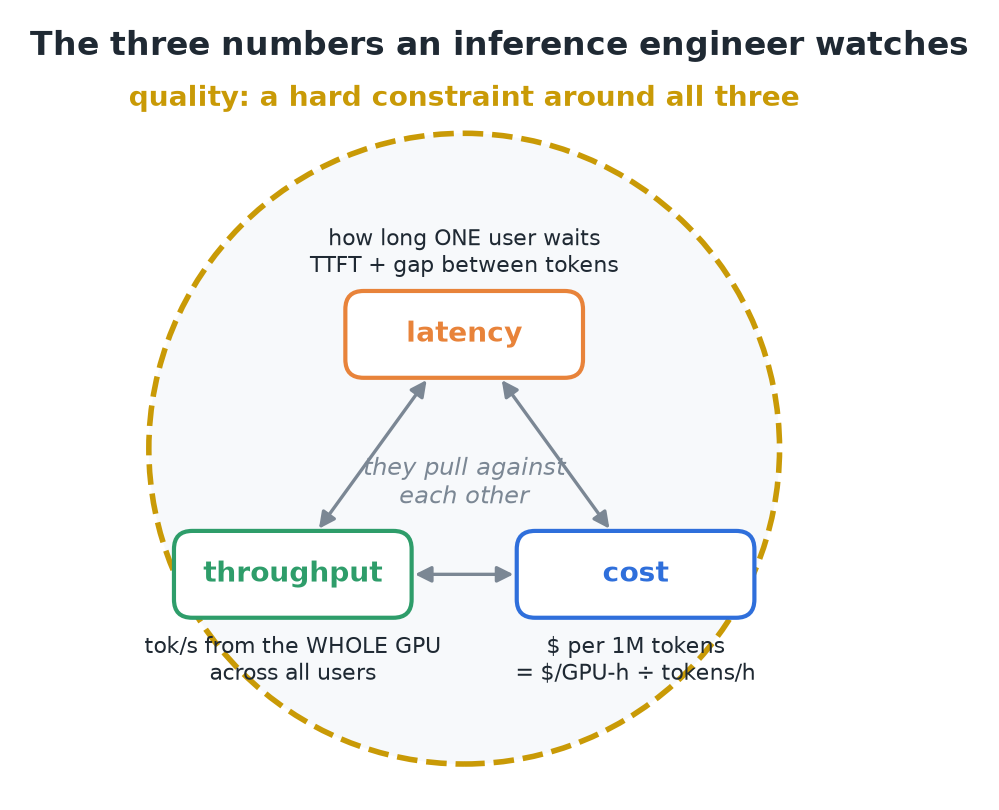 Chất lượng không được đem ra đánh đổi: câu trả lời nhanh hơn nhưng tệ hơn không phải là thắng.
- Khoảng cách giữa các token gọi là ITL (inter-token latency) hoặc TPOT (time per output token).
Đánh đổi đầu tiên: batching
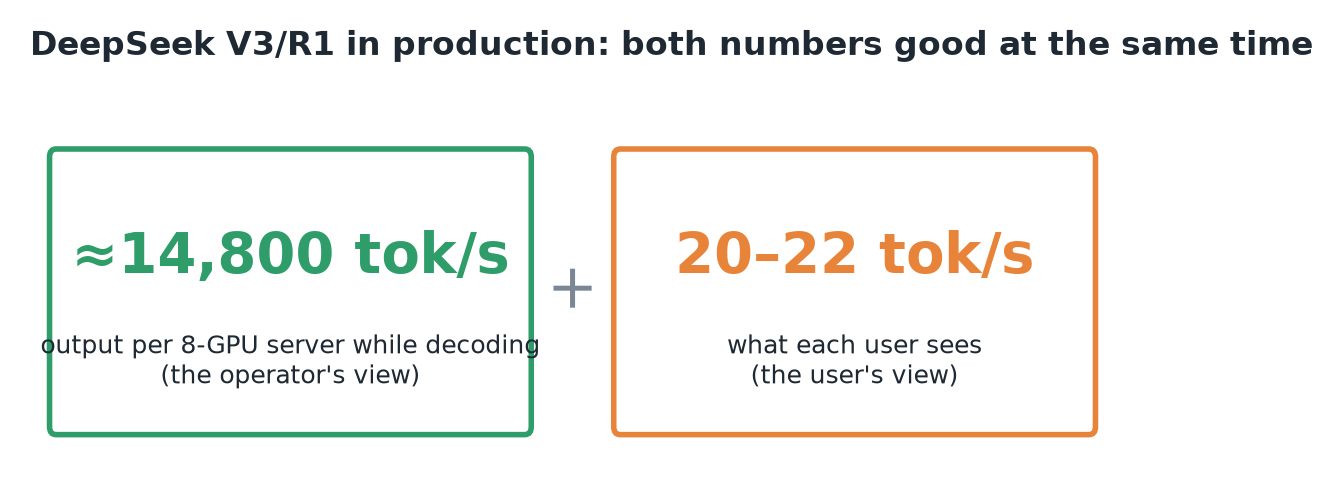
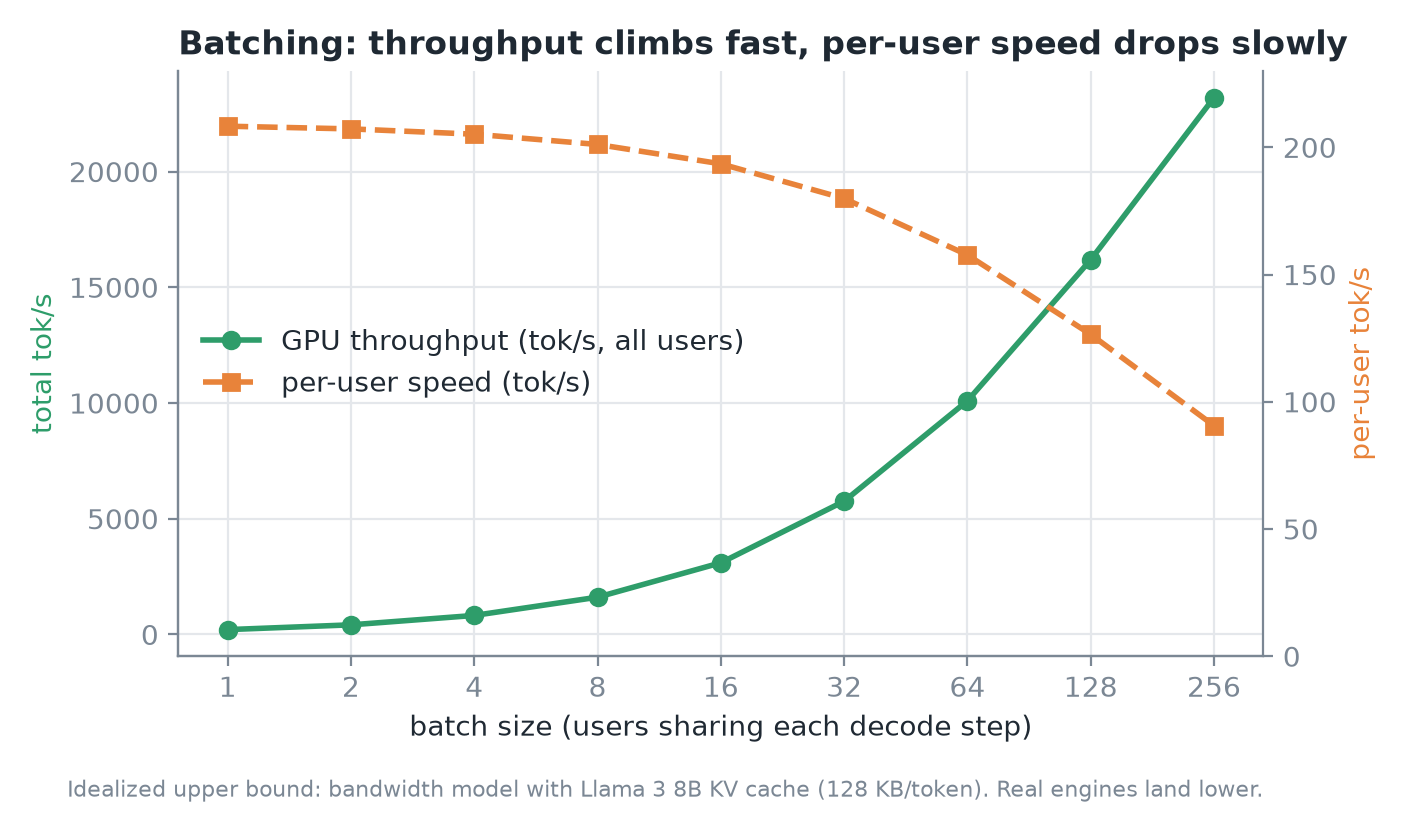 Một lần đọc trọng số phục vụ mọi người dùng trong batch, nên tổng throughput tăng vọt trong khi tốc độ của từng người chỉ giảm từ từ.
- Batch 1: đọc 16 GB và được 1 token.
- Batch 64: đọc cùng 16 GB đó và được 64 token, mỗi người dùng một token. Lần đọc trọng số được chia đều (amortize).
- Throughput nhảy vọt. Mỗi bước làm nhiều việc hơn, nên latency của từng người dùng tăng lên một chút.
- "Cả cuộc chơi là làm cho đánh đổi này có lợi hơn." Phần lớn khoá học xoay quanh việc lấy thêm throughput mà chỉ phải trả thêm ít latency.
5. Quy ra tiền
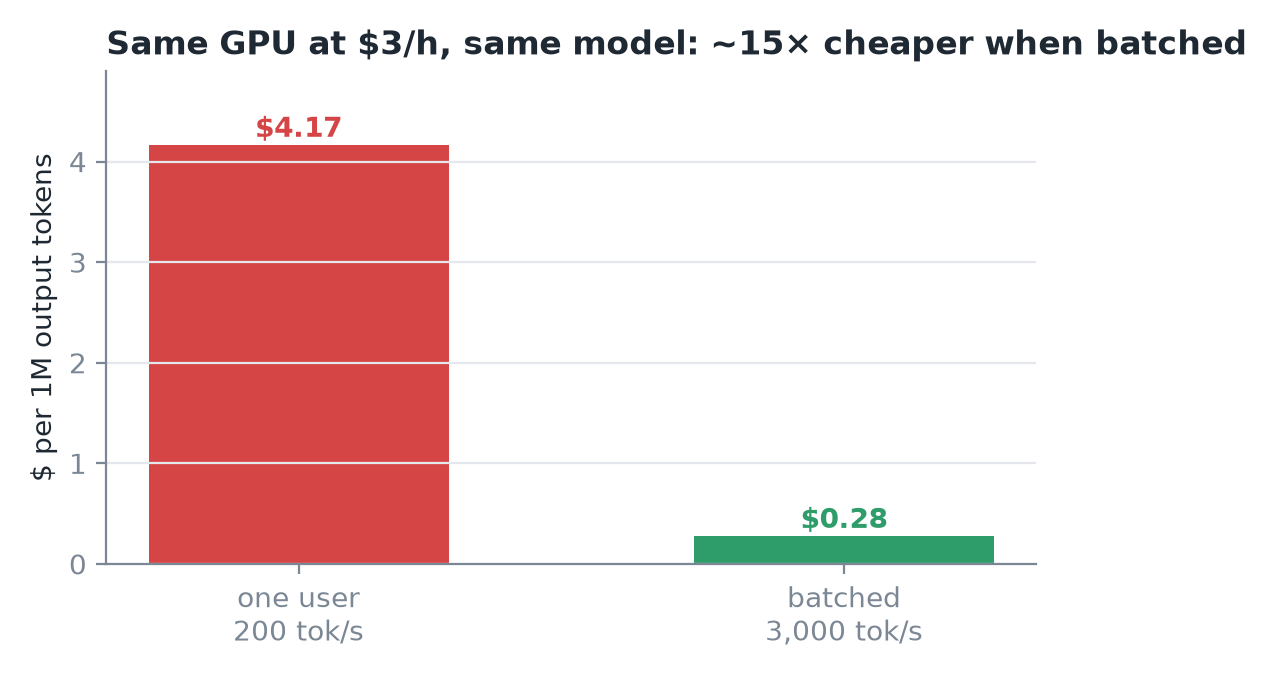 Giá mang tính minh hoạ, phép tính là thật. Chi phí cho 1 triệu token = 3 USD ÷ (tok/s × 3.600) × 10⁶.
Bằng chứng thực tế:
- vLLM (2023): throughput cao tới 24 lần so với Hugging Face Transformers thuần, cùng GPU và cùng trọng số.
6. Một inference engineer làm gì cả ngày
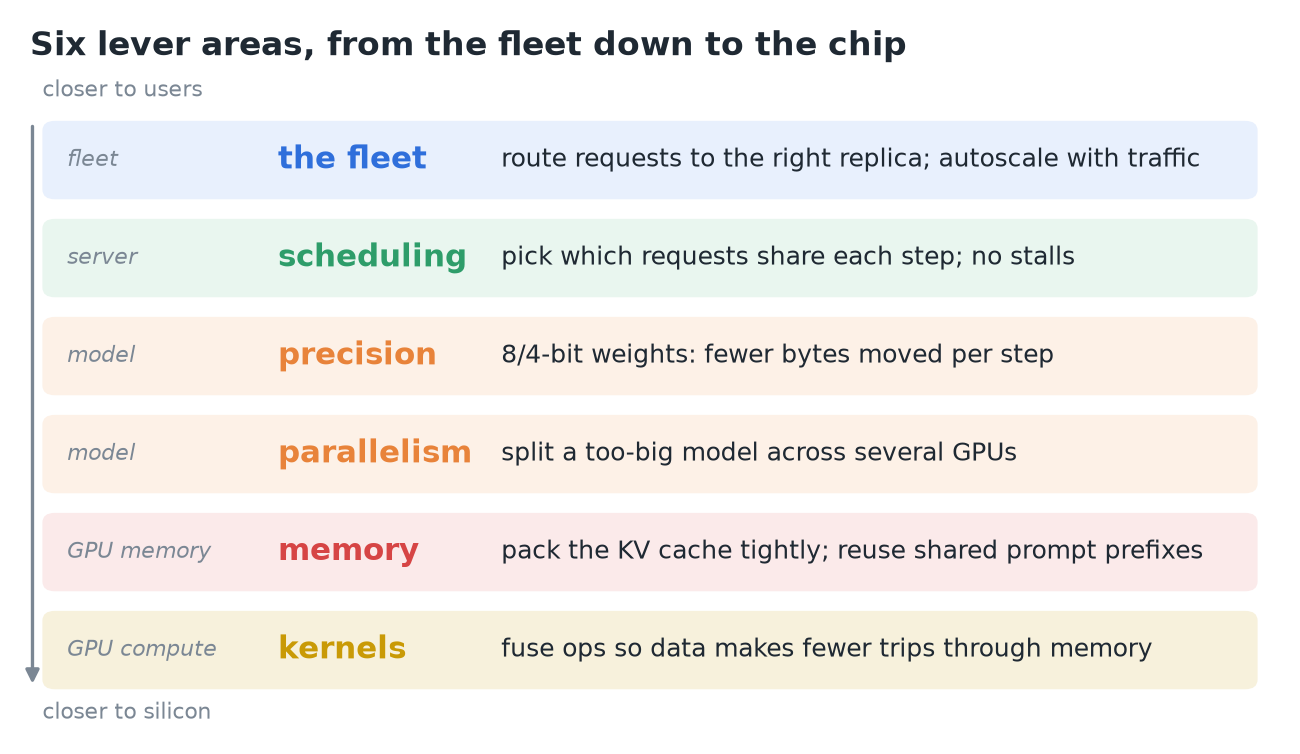 Mỗi nhóm đòn bẩy có một module riêng ở phần sau của khoá học.
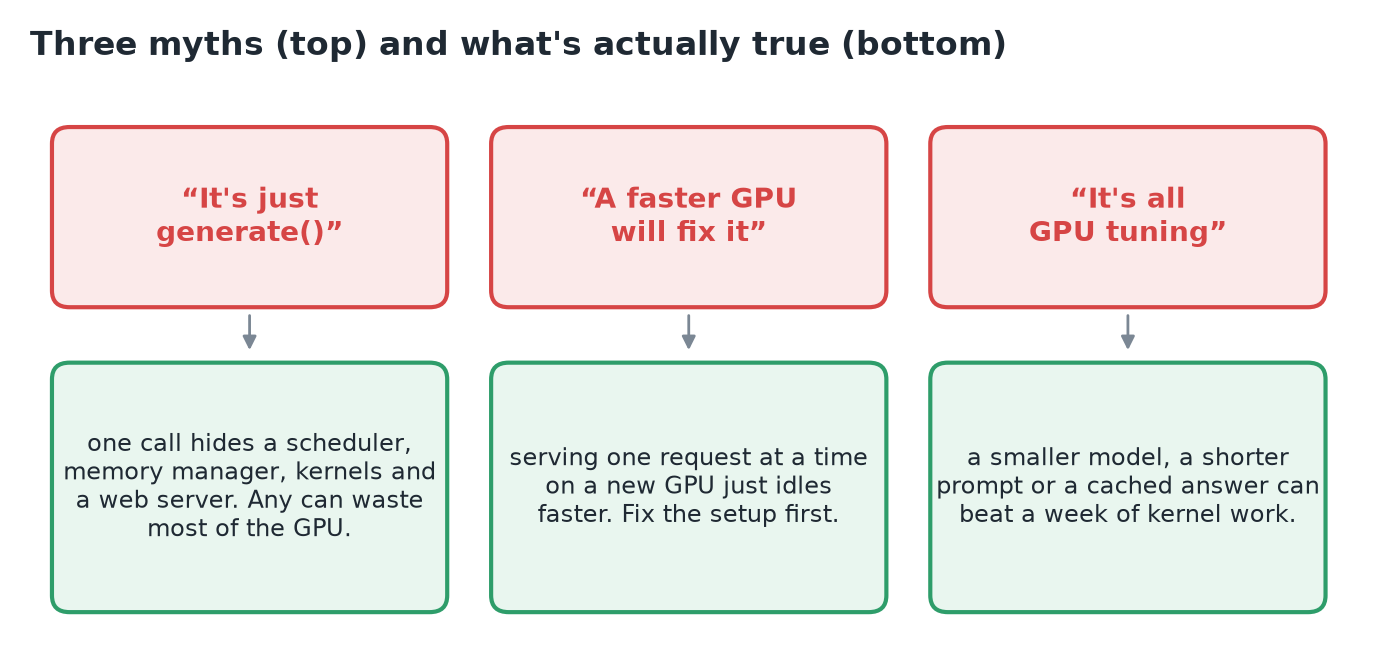
7. Ba hiểu lầm
8. Tóm tắt