42 · Tinh chỉnh bộ nhớ GPU và dung lượng KV
Nguồn: fanout.sh / inference-eng / 09-02 · ~9,5 phút
Ghi chú
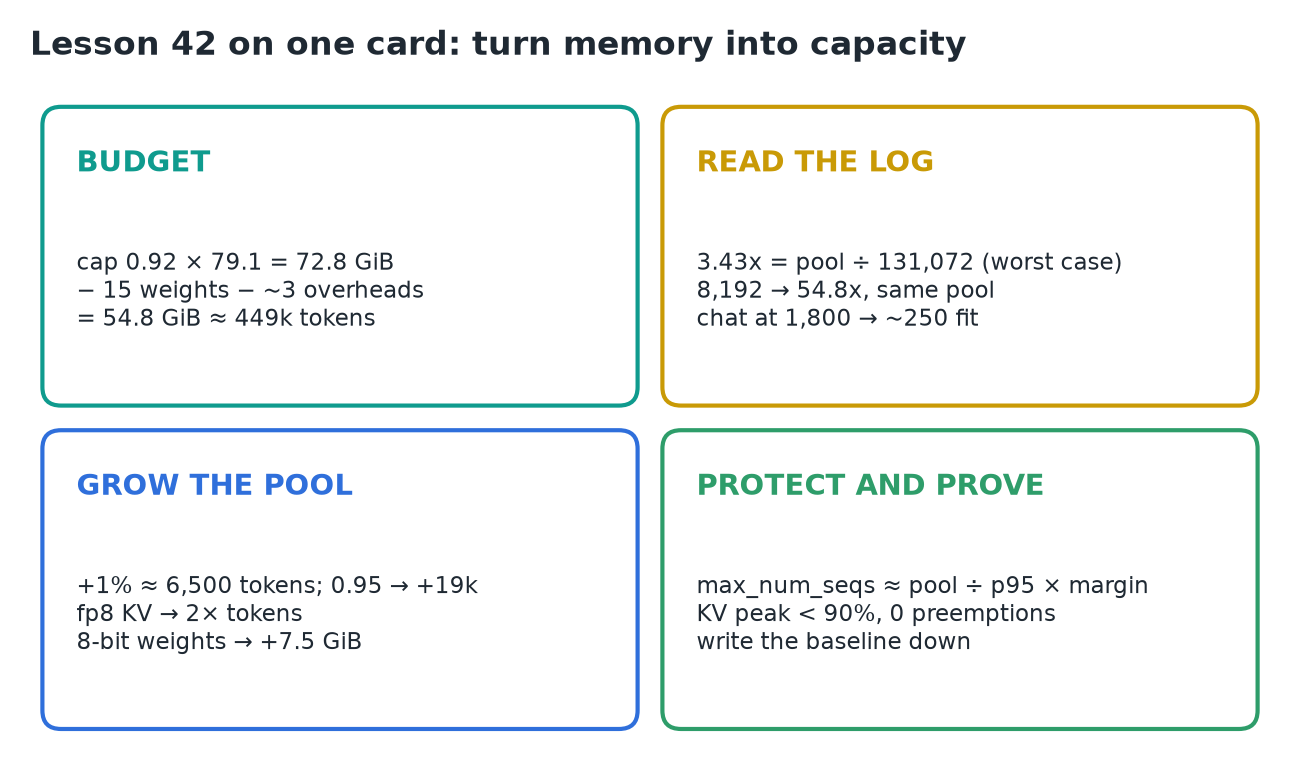
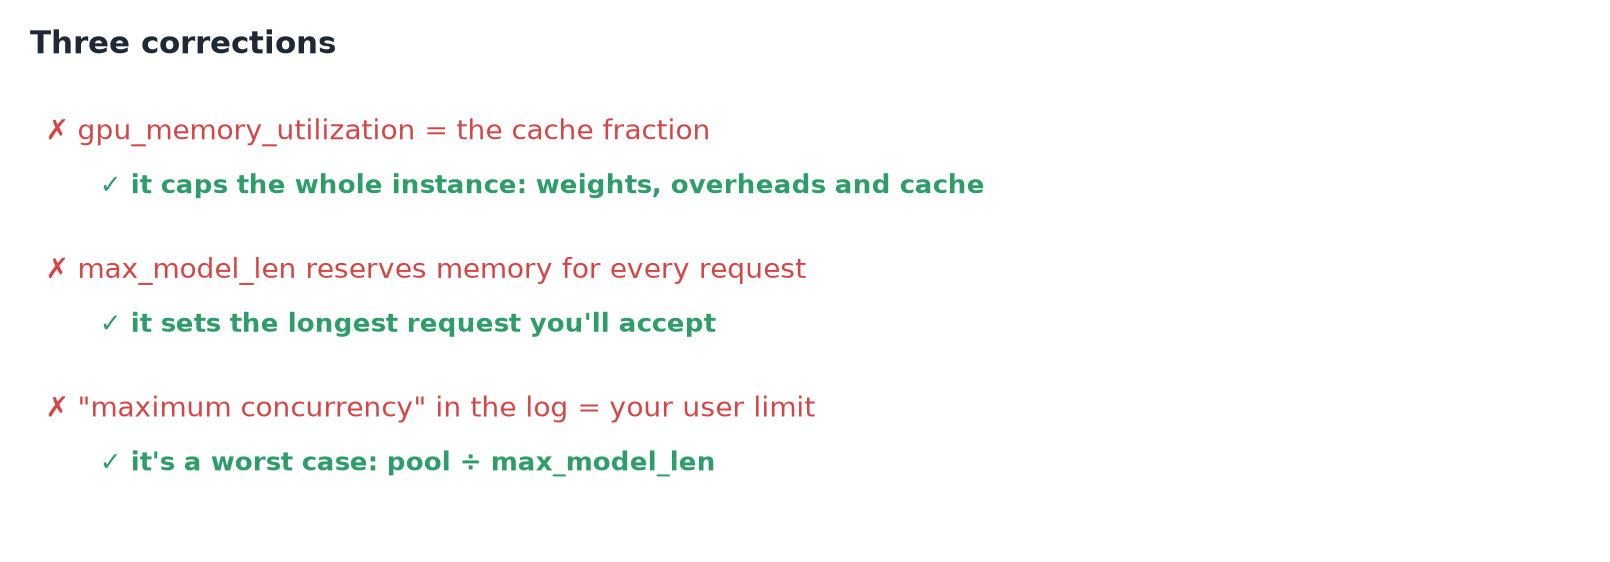
vLLM cho KV cache bất cứ phần nào còn lại dưới mức trần gpu_memory_utilization sau trọng số, overhead và CUDA graph: với Llama 3.1 8B trên H100 là 54,8 GiB ≈ 449 nghìn token. Dòng "maximum concurrency 3.43x" trong log chỉ là pool đó ÷ max_model_len (131.072), một trường hợp xấu nhất, không phải giới hạn người dùng: một cuộc chat 1.800 token chỉ chiếm 1.800 token, nên chứa được ~250. Nới rộng pool bằng một mức trần cẩn thận (+1% ≈ 6.500 token) và ít byte hơn (KV fp8 gấp đôi nó); bảo vệ nó bằng một max_model_len hợp lý và max_num_seqs định cỡ theo shape thật; rồi chứng minh nó dưới tải: đỉnh KV dưới ~90% và không có preemption nào.
1. Từng gibibyte đi đâu
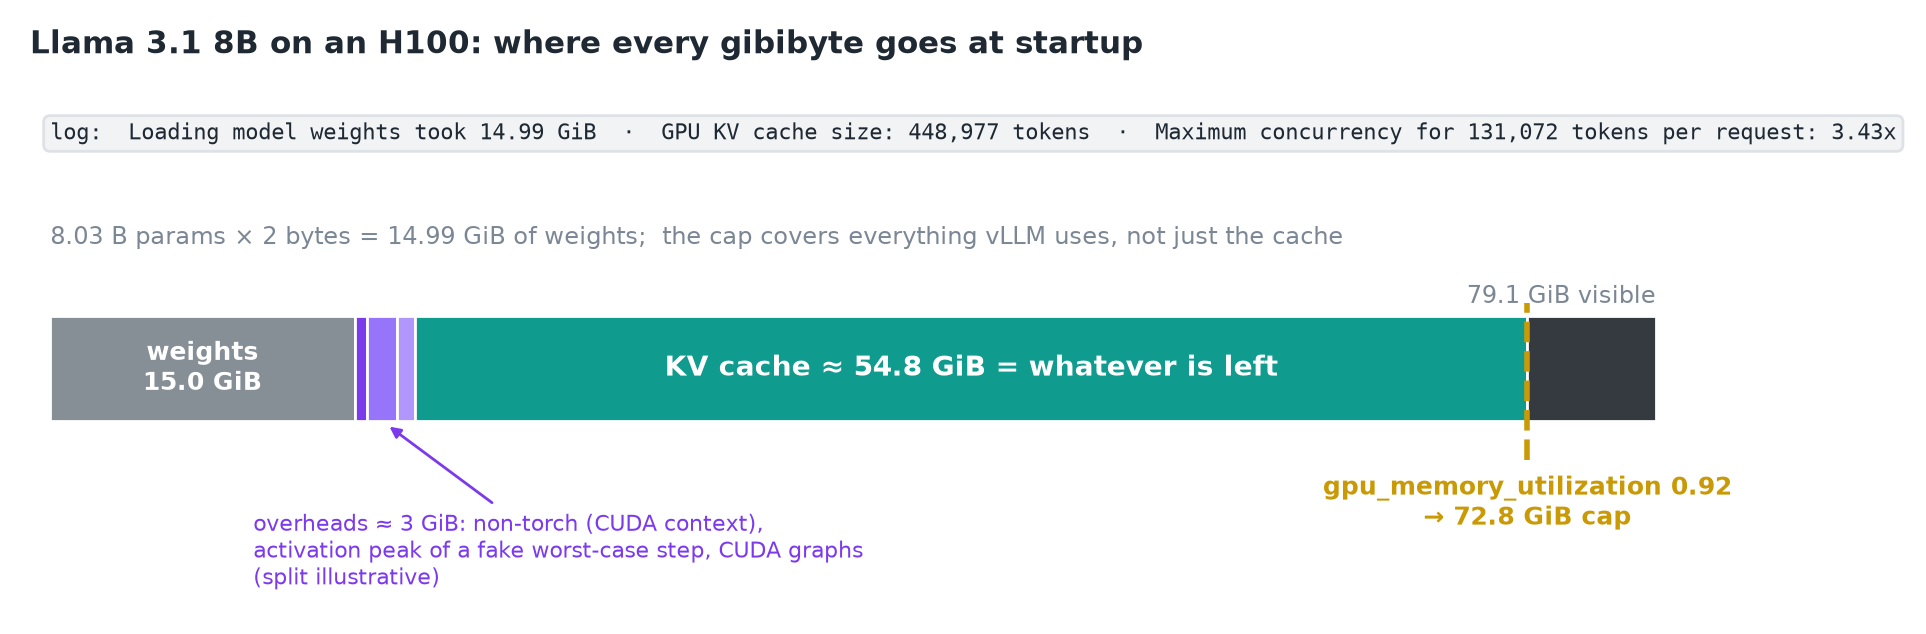 Mức trần phủ toàn bộ instance. Cache là phần còn lại, không phải một tỷ lệ bạn đặt.
- vLLM thấy 79,1 GiB trên card này.
gpu_memory_utilizationmặc định là 0.92, nên instance cho phép mình dùng 72,8 GiB. - Trọng số: 8,03 tỷ tham số × 2 byte ≈ 15 GiB.
- Overhead ≈ 3 GiB: bộ nhớ ngoài PyTorch (CUDA context), đỉnh activation từ một bước giả trong trường hợp xấu nhất (batch lớn nhất nó có thể lập lịch), và CUDA graph, các lần launch kernel đã ghi sẵn giúp decode nhanh.
- KV cache = phần còn lại: 72,8 − 15 − 3 ≈ 54,8 GiB.
2. Từ gibibyte sang token, và "3.43x" nghĩa là gì
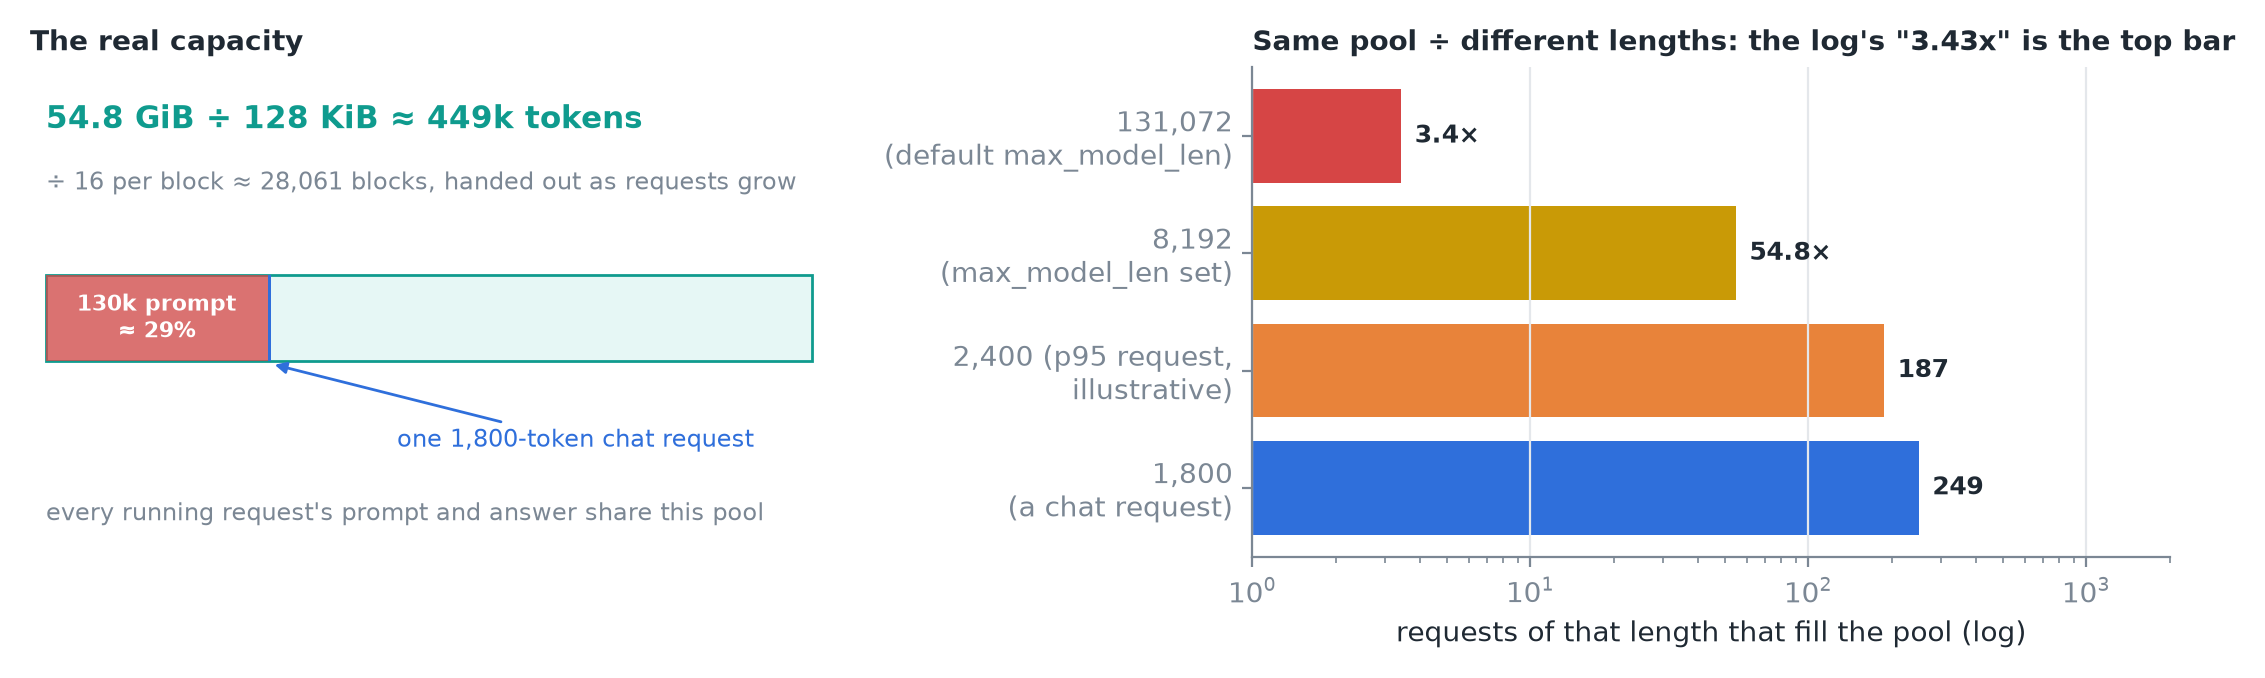 Pool là năng lực thật; "maximum concurrency" chia nó cho request dài nhất mà bạn nói sẽ chấp nhận.
- 3.43x = 449 nghìn ÷ 131.072,
max_model_lenmặc định của Llama 3.1: ba request độ dài tối đa sẽ lấp đầy cache. Nó không nói gì về người dùng thật của bạn; block được cấp khi request lớn lên, nên một cuộc chat 1.800 token chiếm 1.800 token.
Vậy đặt max_model_len để làm gì? Hai lý do:
- Kiểm tra lúc khởi động: ít nhất một request độ dài đó phải vừa, nếu không vLLM từ chối khởi động và cho bạn biết độ dài dài nhất có thể vừa.
- Lời hứa chấp nhận request khổng lồ: một prompt 130 nghìn token tự nó đã chiếm ~29% cả pool.
- Nếu sản phẩm không bao giờ cần quá 8k token, hãy đặt
--max-model-len 8192: log giờ báo 54.8x. Pool không đổi; trường hợp xấu nhất của bạn đổi.
3. Núm 1: mức trần utilization
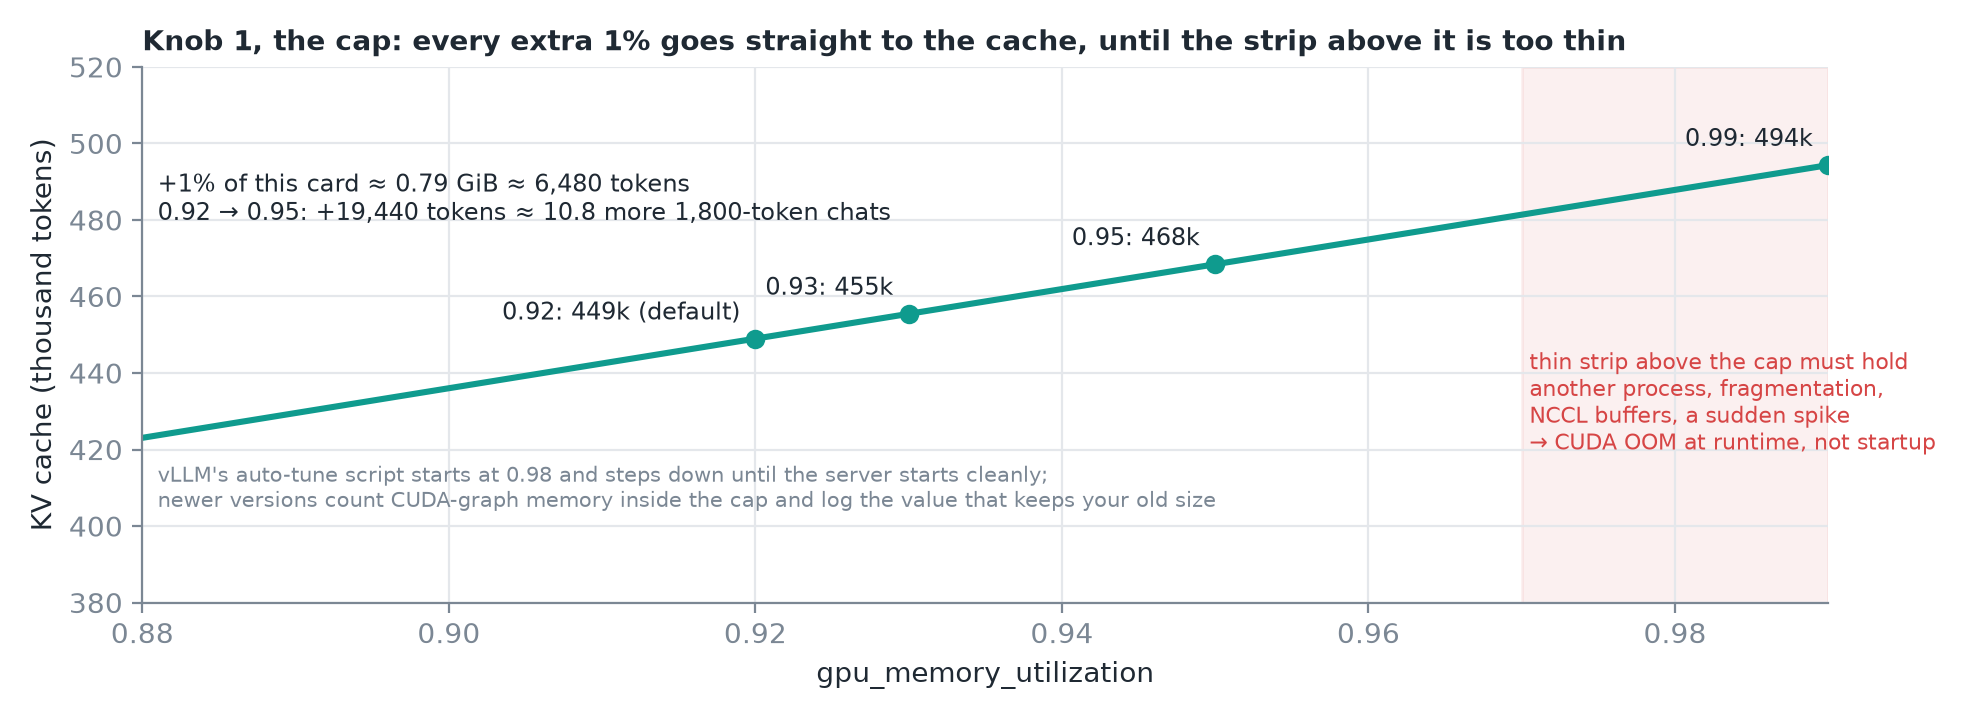 Các điểm ở 0.92, 0.93 và 0.95 khớp với bài học. Khung hình 0.99 trong video hiện ≈ 491 nghìn; cùng ngân sách đó cho ≈ 494 nghìn.
- Mỗi 1% của card này ≈ 0,79 GiB ≈ 6.500 token. Nâng 0.92 → 0.95 được thêm ~19.000 token, khoảng 10 request chat nữa.
- Cái khó là dải phía trên mức trần: vLLM chỉ kiểm soát những gì chính nó cấp phát. Một process khác, phân mảnh, buffer truyền thông NCCL hay một đợt tăng đột ngột đều phải vừa trong đó. Nếu không vừa: CUDA out of memory lúc đang chạy, không phải lúc khởi động, tệ hơn nhiều.
- Script tự tinh chỉnh của vLLM bắt đầu từ 0.98 và hạ dần cho tới khi server khởi động sạch sẽ.
- Các phiên bản mới tính bộ nhớ CUDA graph vào trong ngân sách, và log cho biết giá trị utilization nào cho cùng kích thước cache như trước.
4. Núm 2: ít byte hơn cho mỗi thứ
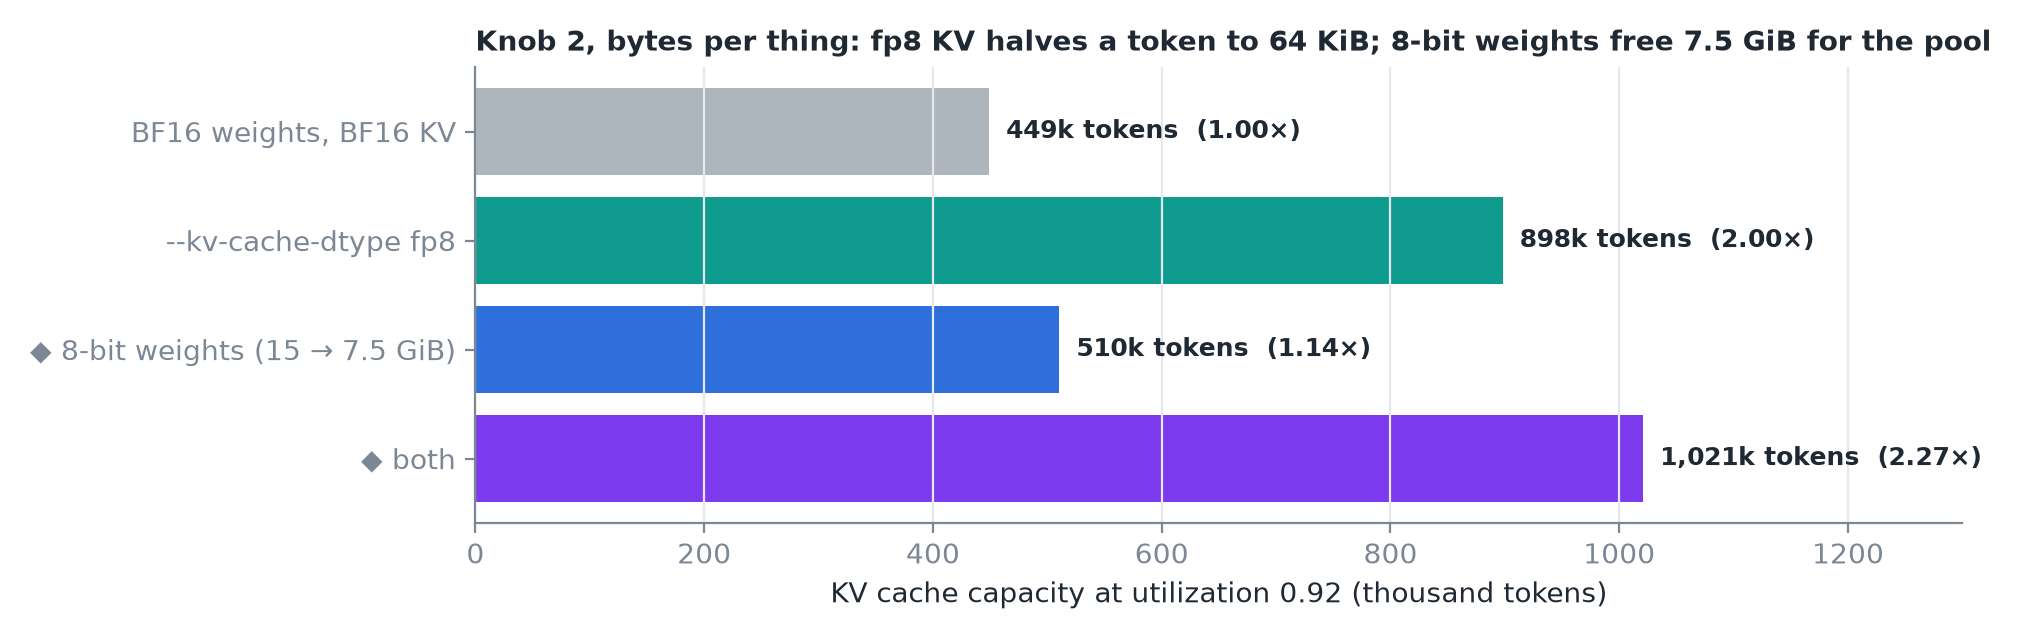 ◆ Thanh trọng số 8-bit và thanh kết hợp là phép tính của tôi: bộ nhớ trọng số được giải phóng đi thẳng vào pool.
--kv-cache-dtype fp8: mỗi token chiếm 64 KiB thay vì 128, nên cùng 54,8 GiB chứa được ~900 nghìn token: gấp đôi dung lượng chỉ với một cờ.- Trọng số 8-bit: 15 → 7,5 GiB, và phần trống đi thẳng vào pool.
Thận trọng
Không cái nào miễn phí: cả hai đều thay đổi những con số model dùng để tính, nên hãy đo chất lượng trước khi ship.
5. Núm 3: cho bao nhiêu request vào
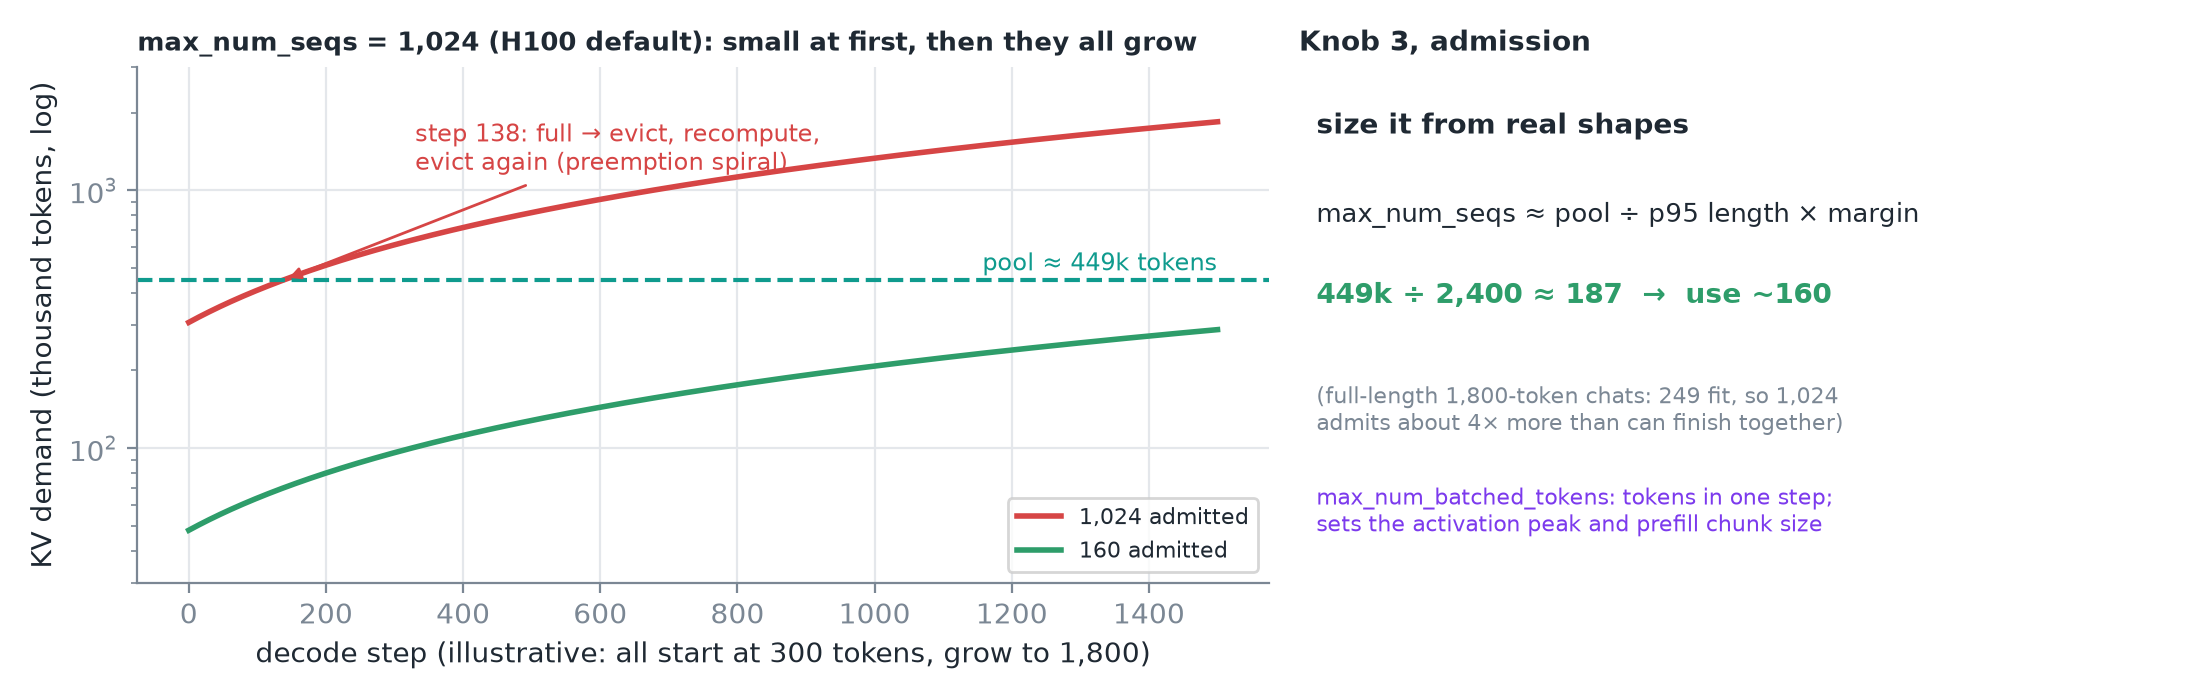 Trái (shape minh hoạ): 1.024 request vừa khi chúng còn nhỏ, rồi tất cả lớn thêm một token mỗi bước cho tới khi pool cạn.
max_num_seqslà số request tối đa scheduler chạy cùng lúc; mặc định trên server H100 là 1.024.- Pool chứa được ~250 request chat ở độ dài đầy đủ, nên mặc định nhận gấp 4 lần số có thể cùng hoàn thành → pool đầy, request bị đuổi và tính lại: một vòng xoáy preemption.
- Định cỡ nó từ shape thật: pool ÷ độ dài request ở percentile cao (không phải trung bình) × một biên an toàn. Ví dụ: 449 nghìn ÷ 2.400 (p95) ≈ 187 → dùng ~160.
max_num_batched_tokenslà núm nhận request còn lại: nó giới hạn số token trong một bước, quyết định đỉnh activation được đo lúc khởi động và kích thước chunk prefill.
6. Chứng minh dưới tải
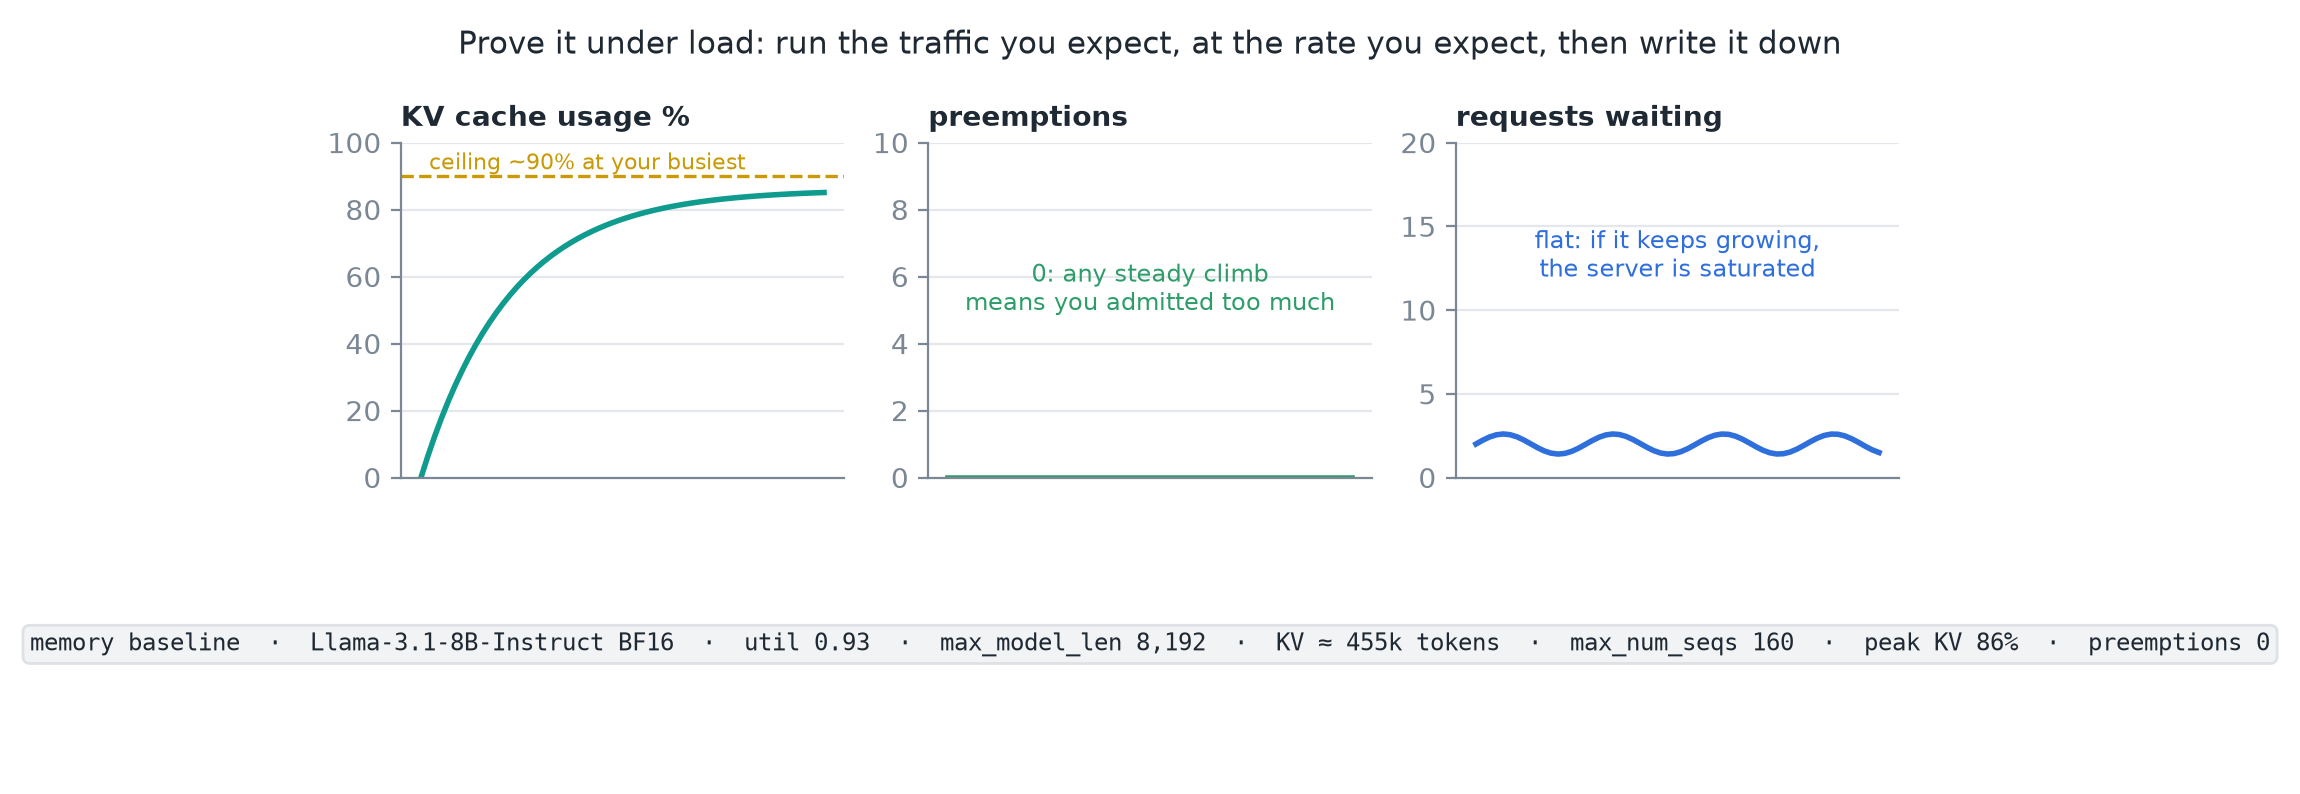 Chạy lưu lượng bạn kỳ vọng, ở rate bạn kỳ vọng, và ghi kết quả lại làm baseline bộ nhớ.
| Theo dõi | Khoẻ mạnh | Nếu không |
|---|---|---|
| Mức dùng KV cache | Đỉnh thoải mái dưới mức đầy, ~90% lúc bận nhất | Ít dư địa cho đợt tăng đột ngột |
| Preemption | 0 ở tải đã lên kế hoạch | Tăng đều: bạn đã nhận nhiều hơn mức vừa |
| Request đang chờ | Phẳng | Cứ tăng: server đã bão hoà, bộ nhớ không phải vấn đề duy nhất |
- Đang bị preempt? Cho cache thêm bộ nhớ (utilization, fp8, thêm GPU) hoặc nhận ít request cùng lúc hơn.
- Ghi lại cấu hình và dung lượng: đó là baseline bộ nhớ cho mọi thứ tiếp theo.
7. Tóm tắt