23 · Goodput, SLO và tỷ lệ lỗi
Nguồn: fanout.sh / inference-eng / 04-06 · ~6 phút
Ghi chú
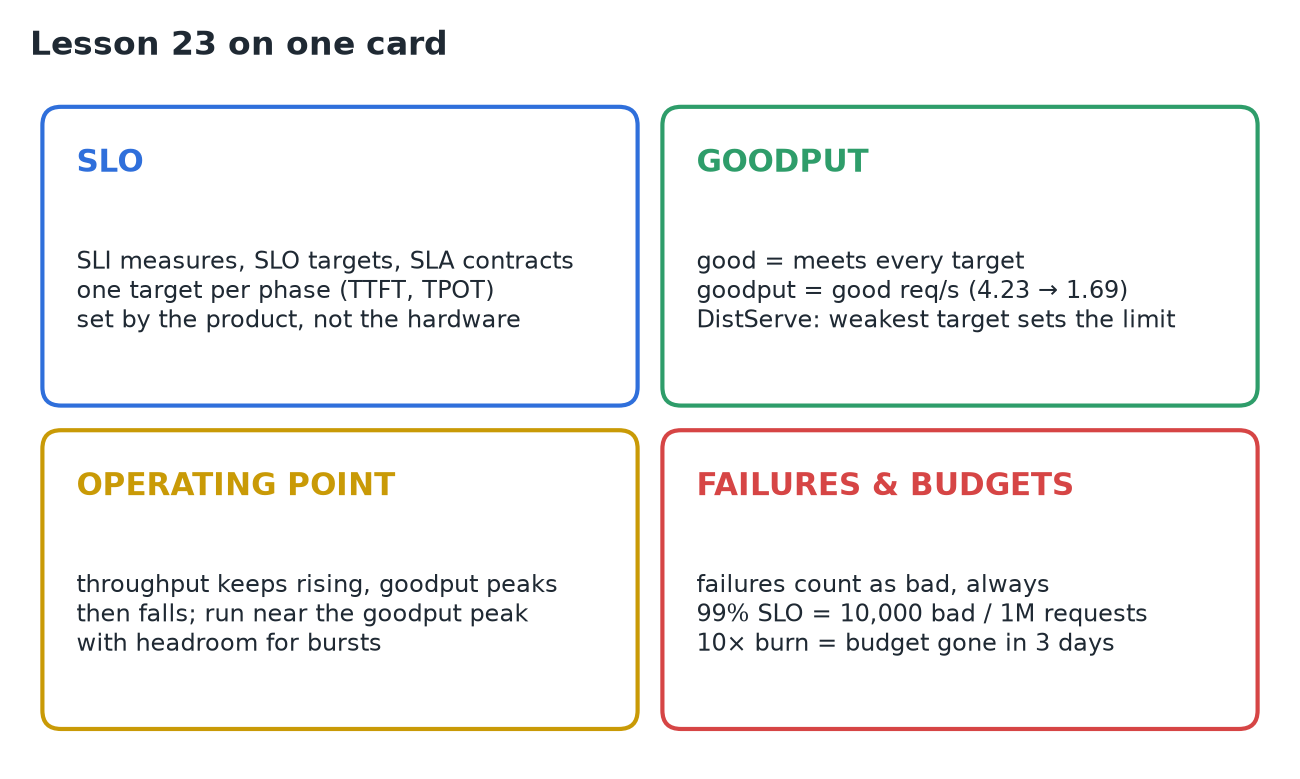
Throughput đếm khối lượng công việc, không đếm công việc đó có đủ tốt hay không. Một SLO biến một phép đo thành mục tiêu do sản phẩm đặt ra (ví dụ P90 TTFT < 400 ms), thường mỗi pha một mục tiêu. Một request là tốt nếu nó đạt mọi mục tiêu; goodput = số request tốt mỗi giây (ví dụ của vLLM: throughput 4,23 req/s, goodput 1,69). Quét theo tải thì throughput cứ tăng trong khi goodput lên đỉnh rồi giảm: hãy vận hành gần đỉnh goodput và chừa khoảng dự phòng. Lỗi luôn tính là xấu, nếu không thì bỏ đi các request chậm nhất sẽ làm P99 trông tuyệt vời. Một error budget (SLO 99% → 10.000 request xấu mỗi triệu) và burn rate của nó (10× → hết sạch trong 3 ngày) biến điều này thành công việc vận hành.
1. Throughput không phải mục tiêu
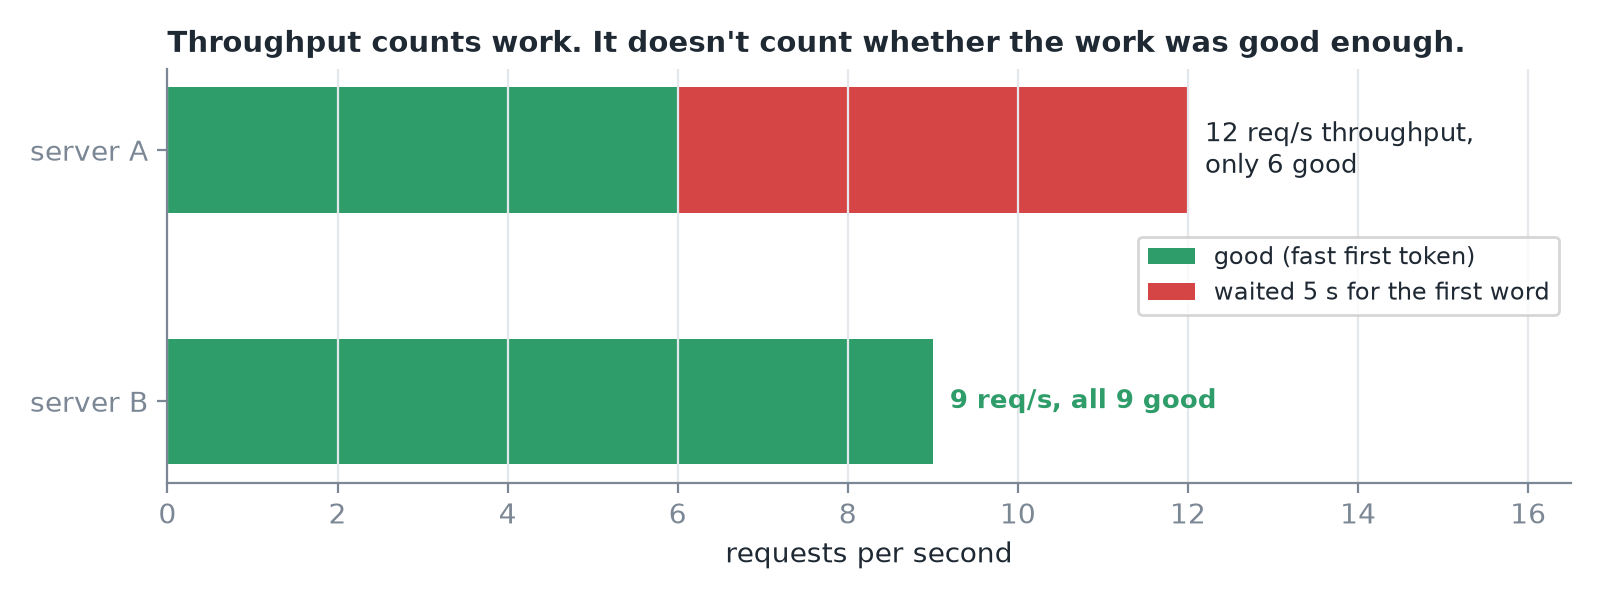 Server A hoàn thành 12 req/s nhưng một nửa người dùng phải chờ 5 s mới thấy chữ đầu tiên. Server B hoàn thành 9, tất cả đều nhanh. B phục vụ được nhiều người dùng hài lòng hơn.
2. SLI, SLO, SLA
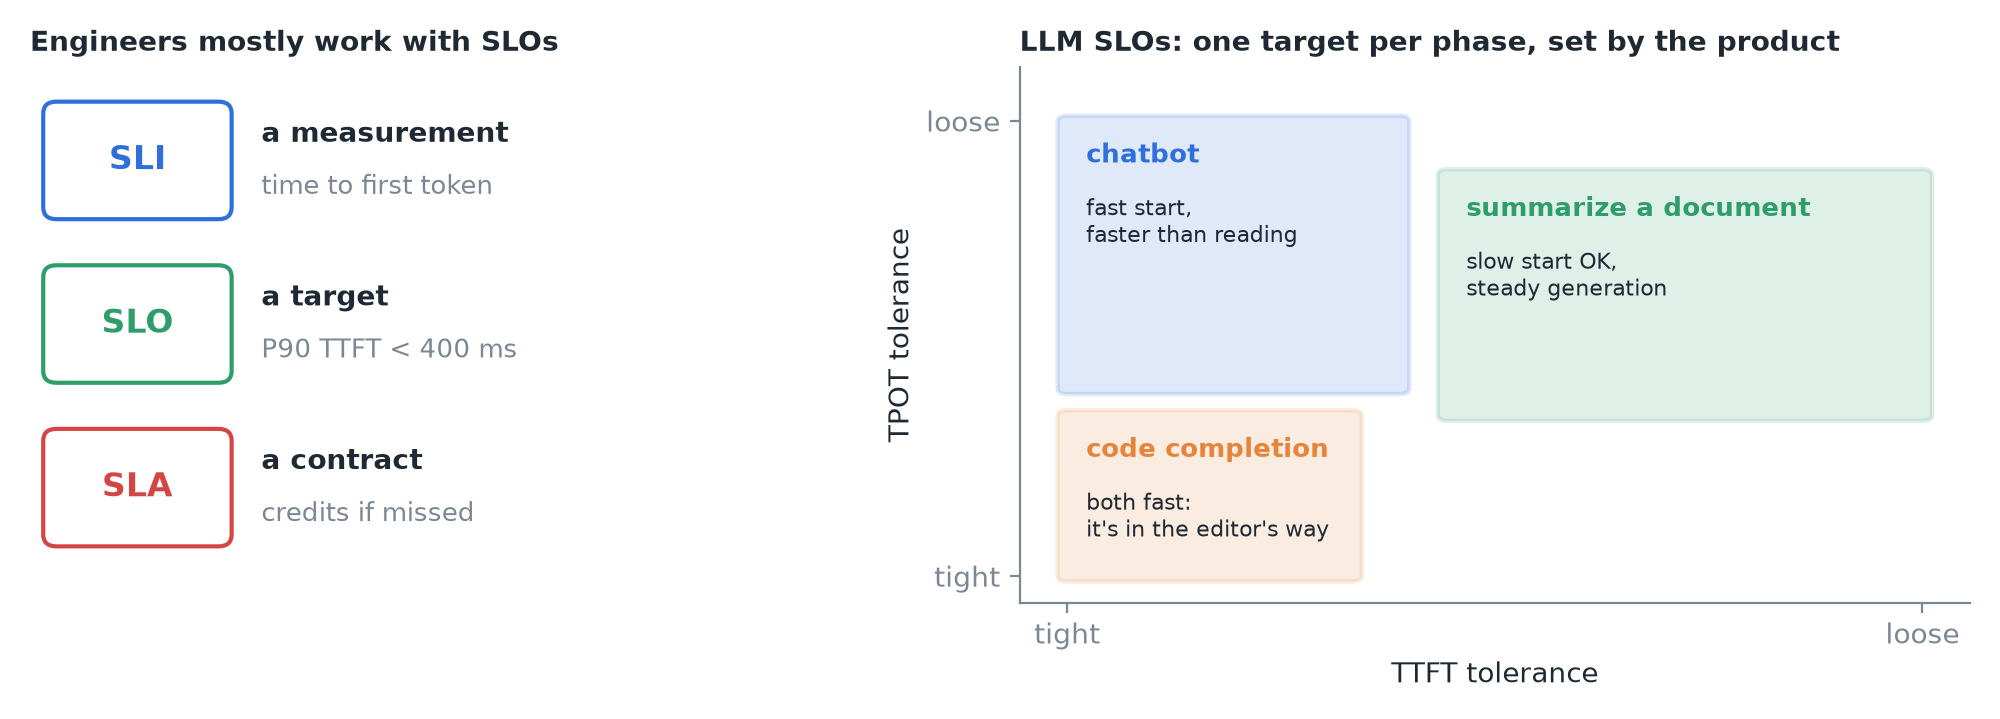 Trái: ba thuật ngữ từ site reliability engineering. Phải: mục tiêu theo từng sản phẩm (theo bảng workload của paper DistServe).
- Một SLO hữu ích cho LLM kết hợp mục tiêu cho cả hai pha (TTFT và TPOT).
- Chatbot: token đầu nhanh, tốc độ token nhanh hơn tốc độ đọc. Gợi ý code: cả hai đều phải nhanh, vì nó nằm ngay trên đường gõ của editor. Tóm tắt tài liệu dài: bắt đầu chậm cũng được, nhưng sinh phải đều đặn.
Quan trọng
Mục tiêu đến từ sản phẩm, không đến từ phần cứng.
3. Goodput
Một request là tốt nếu TTFT < giới hạn của nó và TPOT < giới hạn của nó. Goodput = số request tốt hoàn thành mỗi giây.
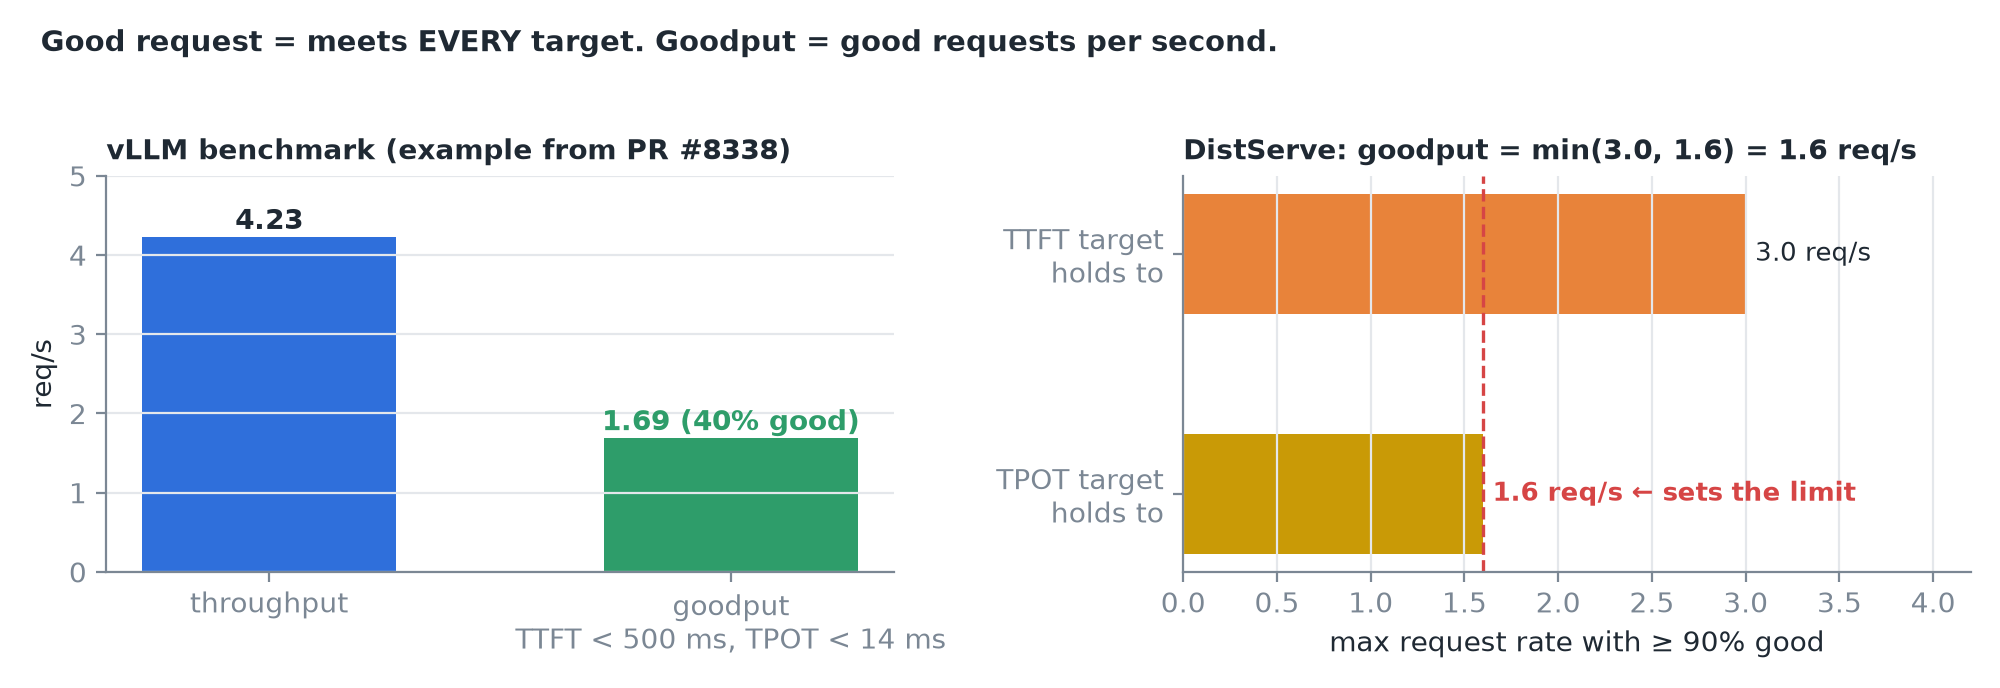 Trái: benchmark của vLLM báo goodput khi bạn truyền mục tiêu vào; trong pull request thêm tính năng này, throughput 4,23 req/s chỉ tương ứng goodput 1,69 req/s. Phải: phiên bản chặt hơn của DistServe là request rate cao nhất mà ≥ 90% request vẫn tốt; mục tiêu yếu nhất quyết định nó.
vllm bench serve ... --goodput ttft:500 tpot:144. Throughput so với goodput
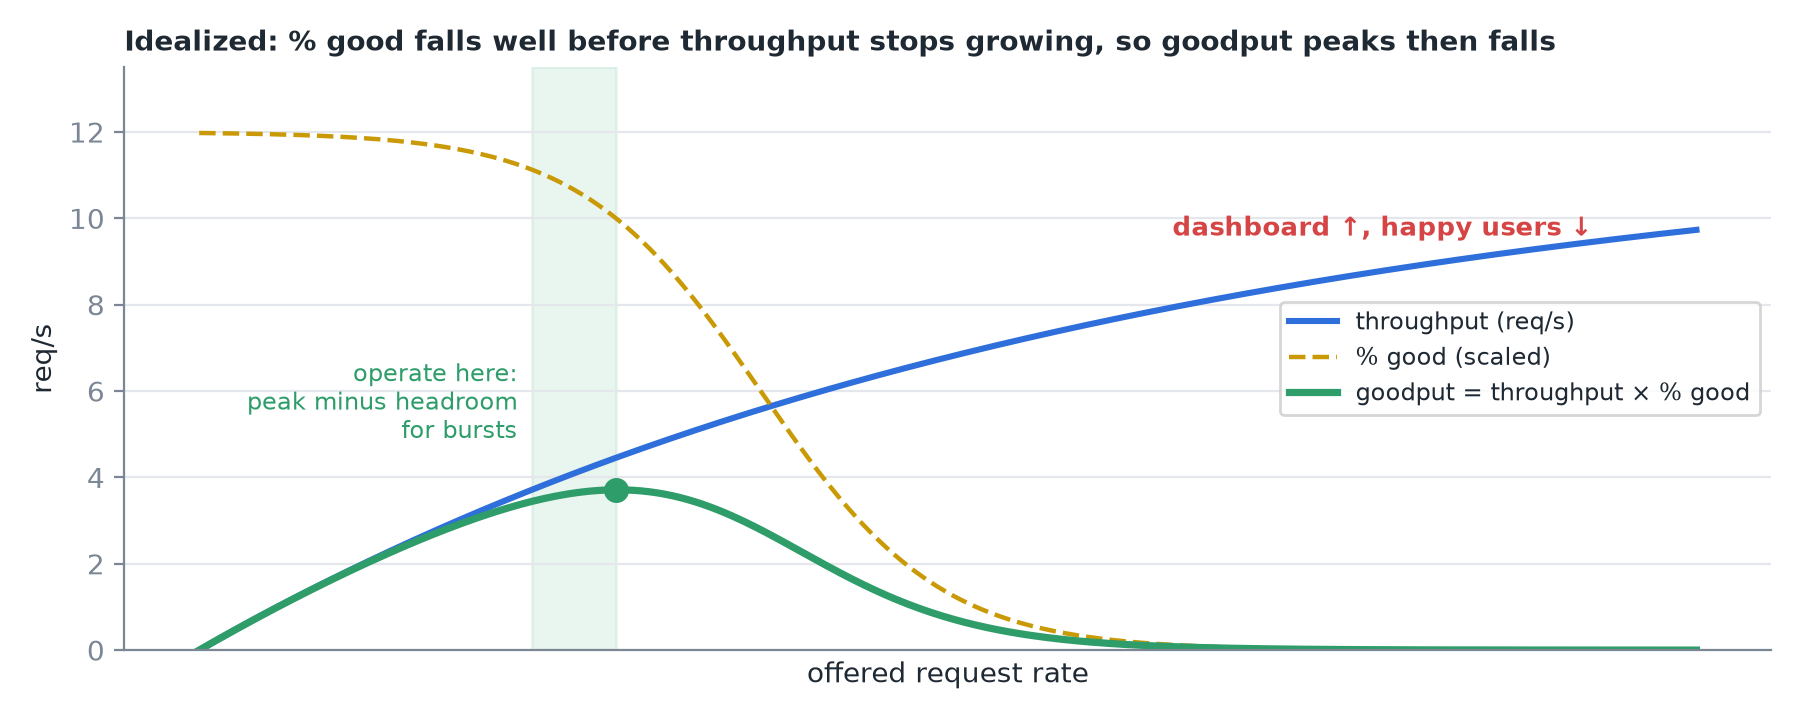 Khi request rate tăng, throughput leo lên rồi đi ngang khi GPU đầy. Tỷ lệ request tốt bắt đầu giảm sớm hơn nhiều, khi hàng đợi và batching làm mọi người chậm lại. Tích của chúng, goodput, lên đỉnh rồi giảm.
Thận trọng
Qua khỏi đỉnh goodput, tải nhiều hơn làm dashboard đi lên trong khi số người dùng hài lòng đi xuống. Hãy vận hành gần đỉnh goodput với khoảng dự phòng cho các đợt dồn, không phải ở mức throughput tối đa.
5. Lỗi
Một số request không chỉ chạy chậm, mà thất bại: lỗi server (5xx), timeout, bị từ chối khi quá tải (429 / load shedding), crash do hết bộ nhớ, câu trả lời bị cắt ở giới hạn độ dài.
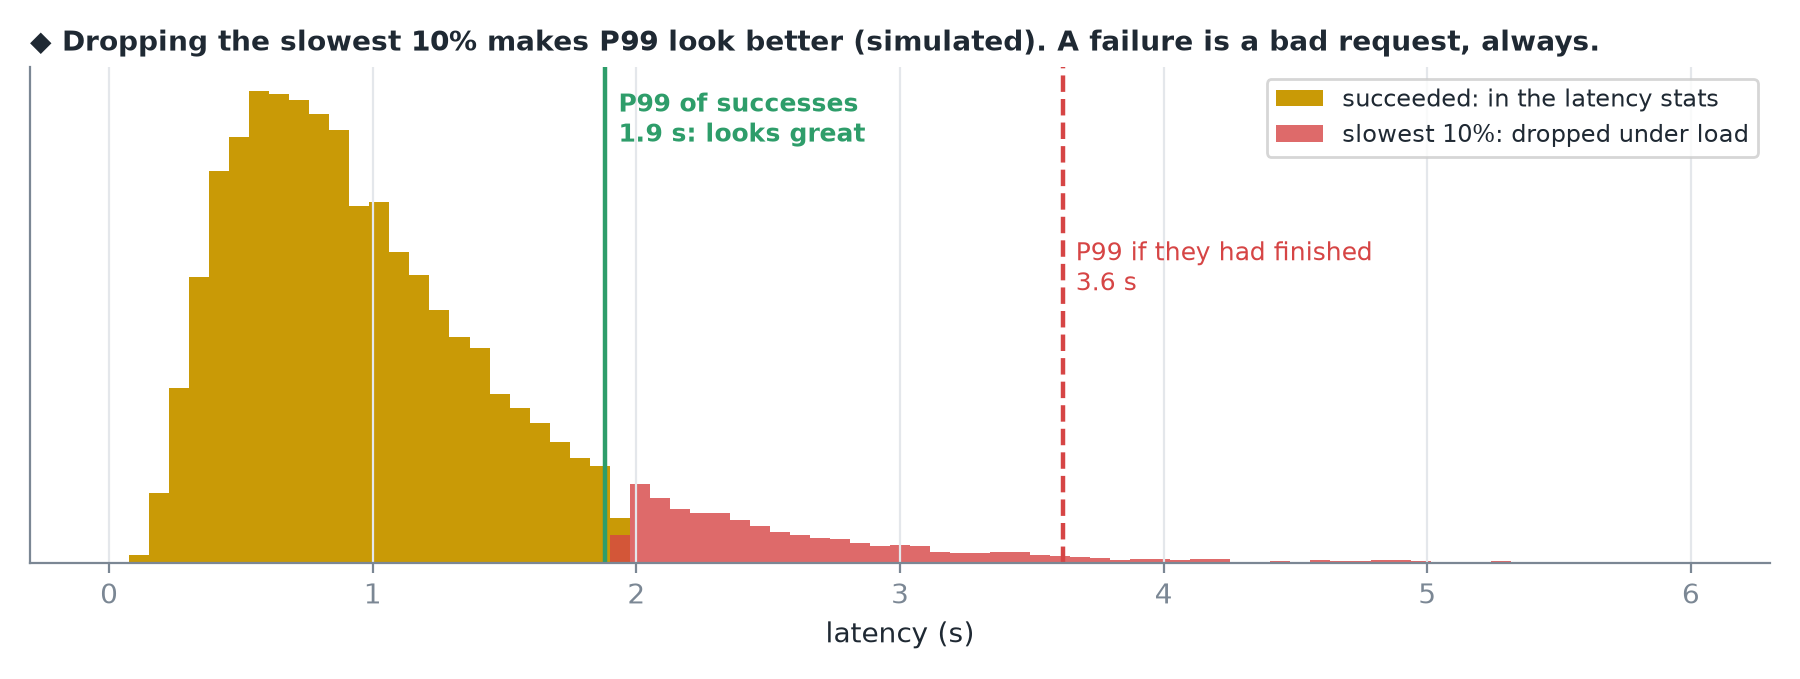 Thống kê latency thường chỉ tính trên các request thành công. Một server bỏ đi 10% request chậm nhất khi tải cao bỗng có P99 tuyệt đẹp, vì những request tệ nhất đã rời khỏi dữ liệu.
Quan trọng
Một lỗi tính là request xấu, mọi lúc. Báo cáo tỷ lệ lỗi bên cạnh latency và tính cả lỗi vào goodput.
6. Error budget
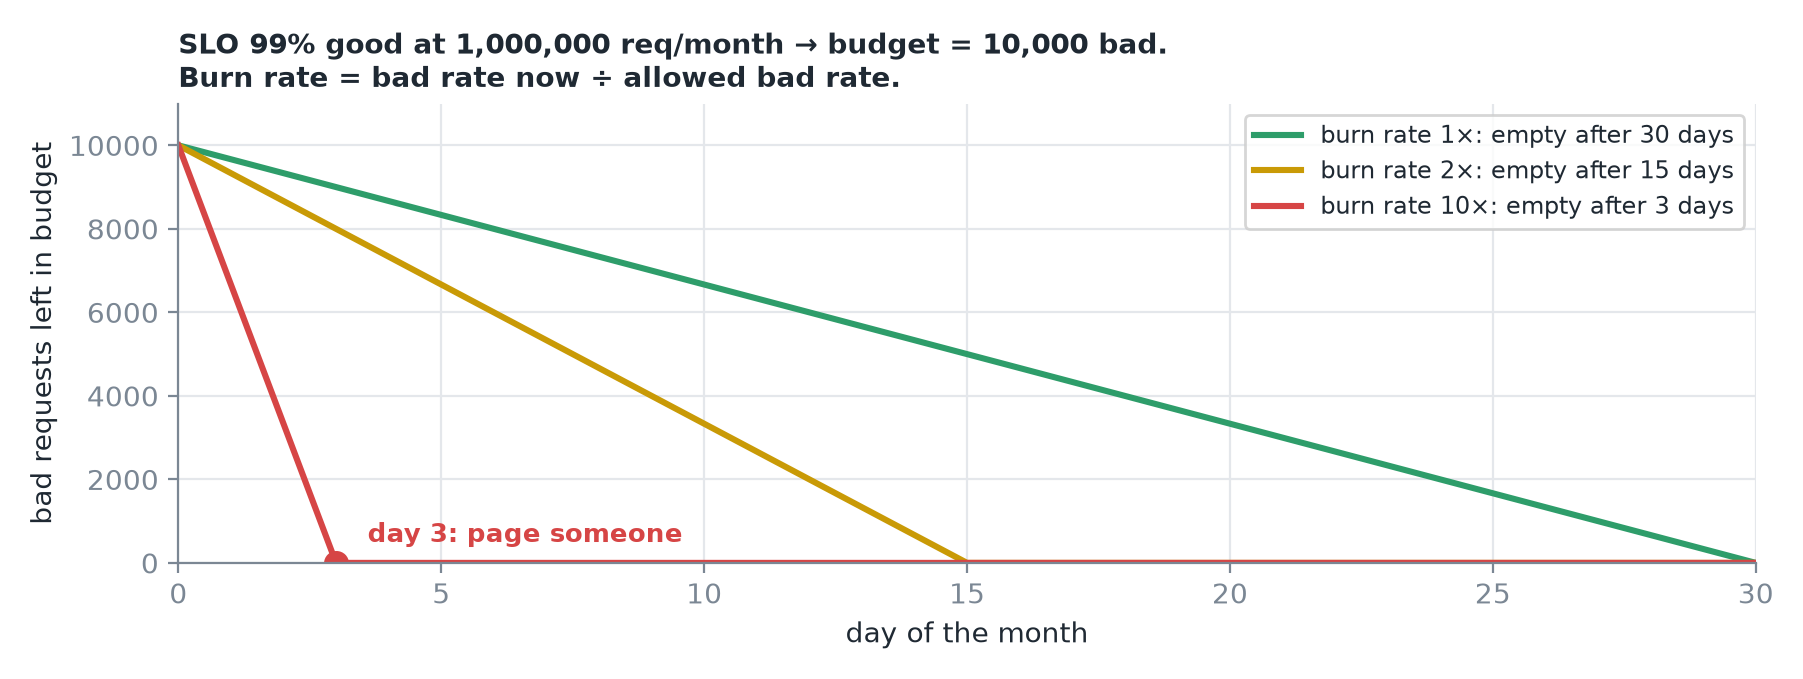 SLO 99% tốt cho phép 1% xấu: với một triệu request mỗi tháng là 10.000 request xấu.
- Tiêu chậm: bạn có thể ship các thay đổi rủi ro. Đốt nhanh: đóng băng và sửa.
- Cảnh báo theo burn rate (tỷ lệ xấu hiện tại ÷ tỷ lệ xấu cho phép). Đốt nhanh gấp 10 lần là hết ngân sách cả tháng trong khoảng 3 ngày: phải gọi người trực.
7. Tóm tắt