51 · Inference ở BF16, FP8, INT8 và 4-bit
Nguồn: fanout.sh / inference-eng / 11-02 · ~5,5 phút
Ghi chú
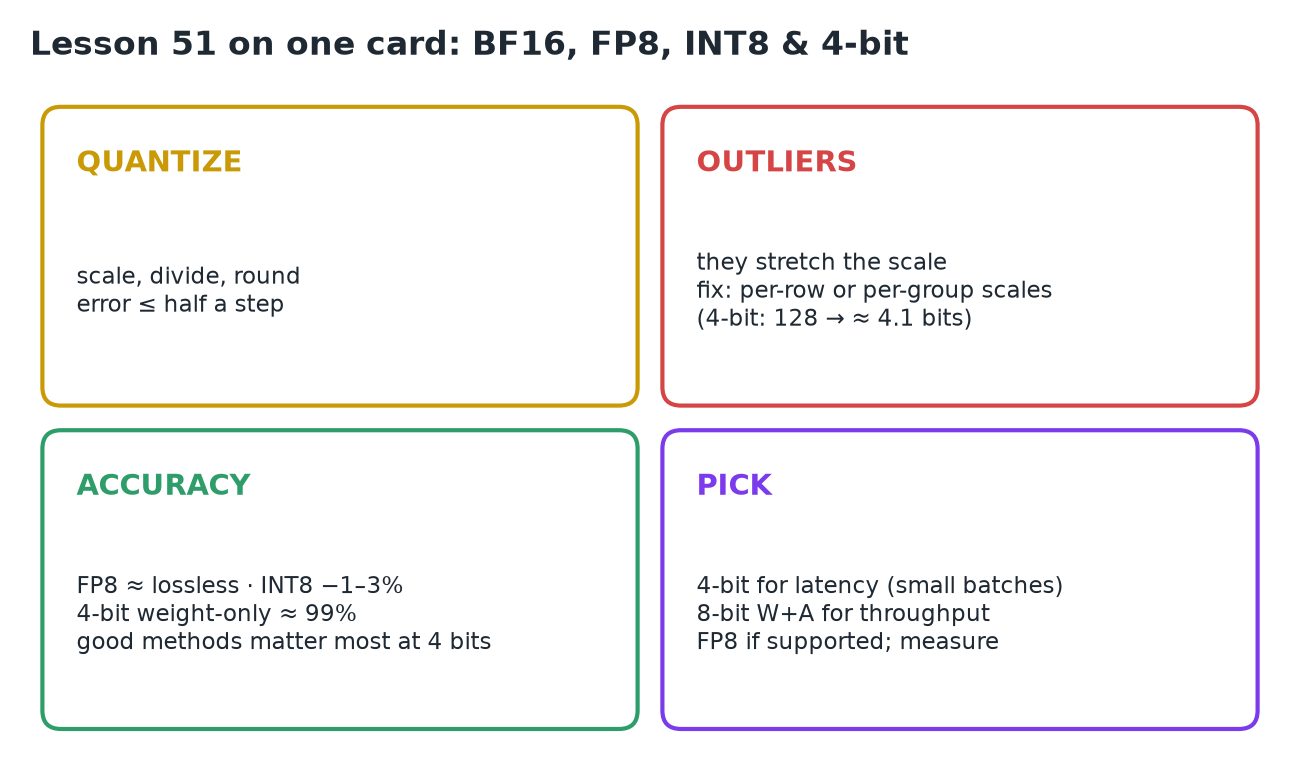
Lượng tử hoá là một hệ số scale, một phép chia và một phép làm tròn, với sai số tối đa nửa bước. Một giá trị ngoại lai (outlier) kéo giãn scale và xoá sổ mọi giá trị khác, nên hãy dùng scale theo hàng hoặc theo nhóm (4-bit: một scale cho mỗi 128 trọng số, ≈ 4,1 bit mỗi trọng số). Trên Llama 3.1, FP8 cho trọng số + activation về cơ bản không mất mát, INT8 W+A mất ~1–3%, và 4-bit chỉ trọng số giữ lại được ~99% với một phương pháp tốt. 4-bit hợp với latency (batch nhỏ), 8-bit W+A hợp với throughput (batch lớn), và FP8 là mặc định an toàn ở nơi được hỗ trợ. Hãy đo trên tác vụ của chính bạn.
1. Lượng tử hoá một con số gồm những gì
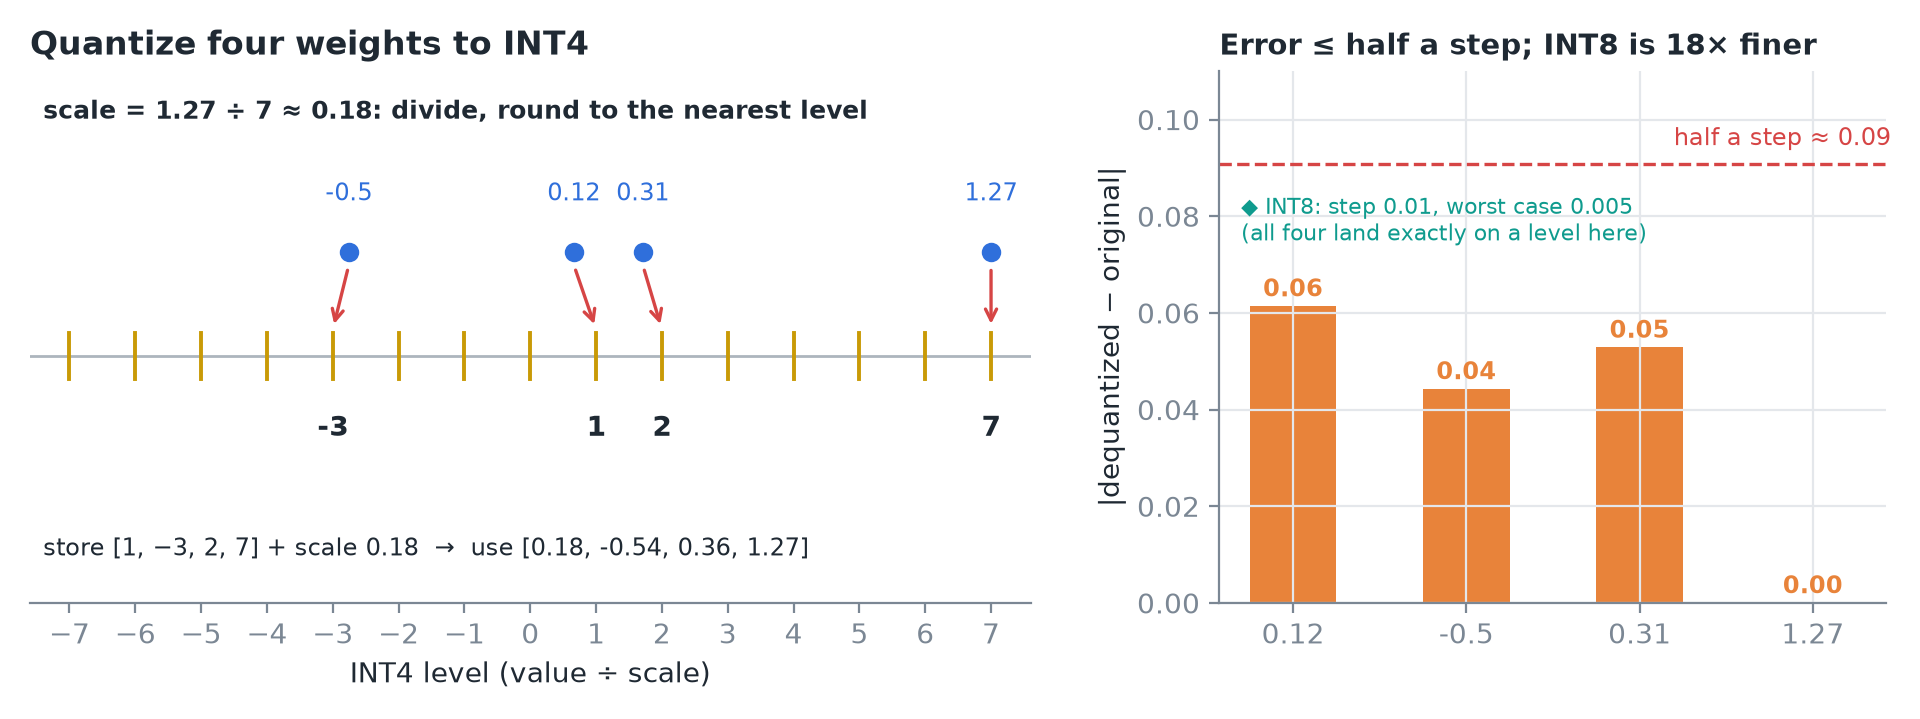 Bốn trọng số lên lưới INT4 có dấu, và mỗi cái dịch đi bao xa.
- INT4 có dấu ở đây dùng các mức −7 tới 7. Chọn scale sao cho giá trị lớn nhất rơi vào mức trên cùng.
- Chia rồi làm tròn: [1, −3, 2, 7]. Đó là thứ bạn lưu: bốn số nguyên nhỏ cộng một scale.
- Khi dùng, nhân ngược lại: [0,18; −0,54; 0,36; 1,27]. Giá trị nào cũng dịch đi, nhưng không bao giờ quá nửa bước (≈ 0,09).
- INT8 có 127 mức mỗi phía, nên bước của nó mịn hơn 18 lần.
2. Outlier, và độ mịn cao hơn
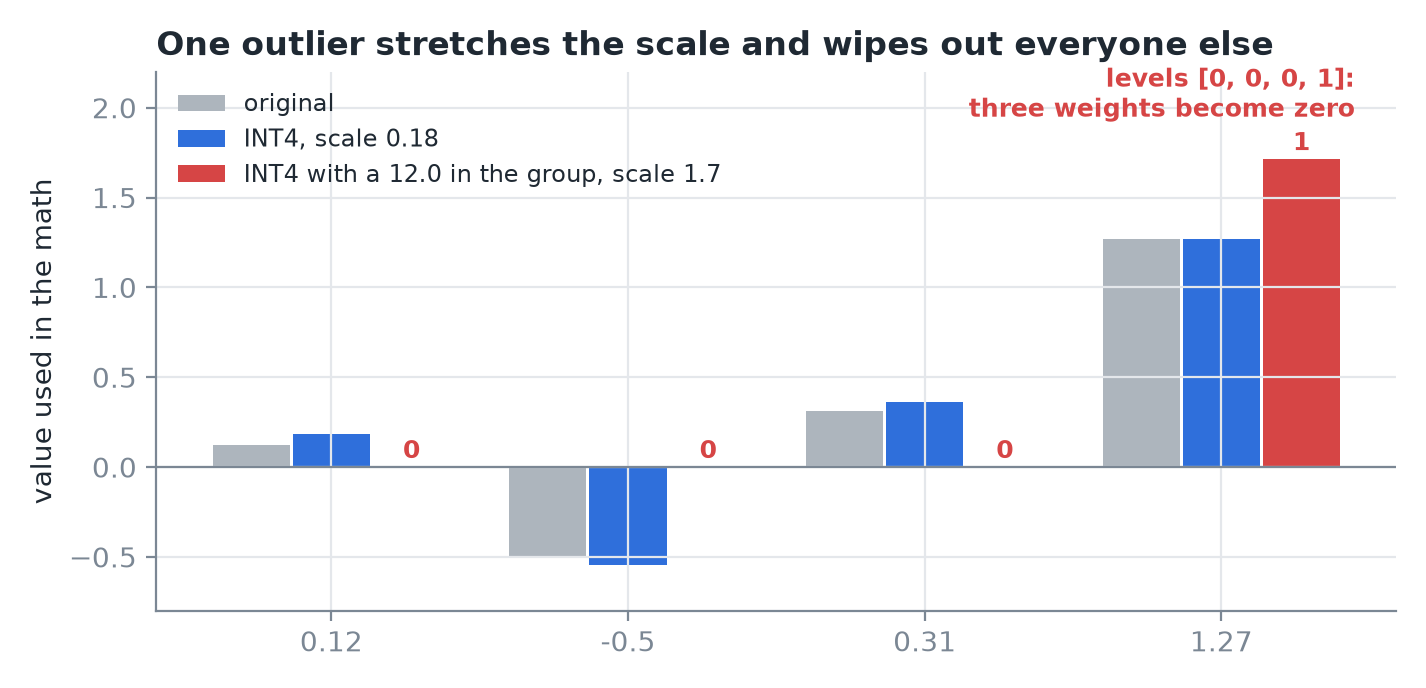 Cùng bốn trọng số đó, lượng tử hoá riêng và khi có một giá trị 12,0 trong nhóm.
- Thêm một giá trị lớn, 12,0, vào nhóm: scale giãn ra 12 ÷ 7 ≈ 1,7, và bốn trọng số bình thường làm tròn thành [0, 0, 0, 1].
- LLM thực sự có outlier, ở cả trọng số và activation.
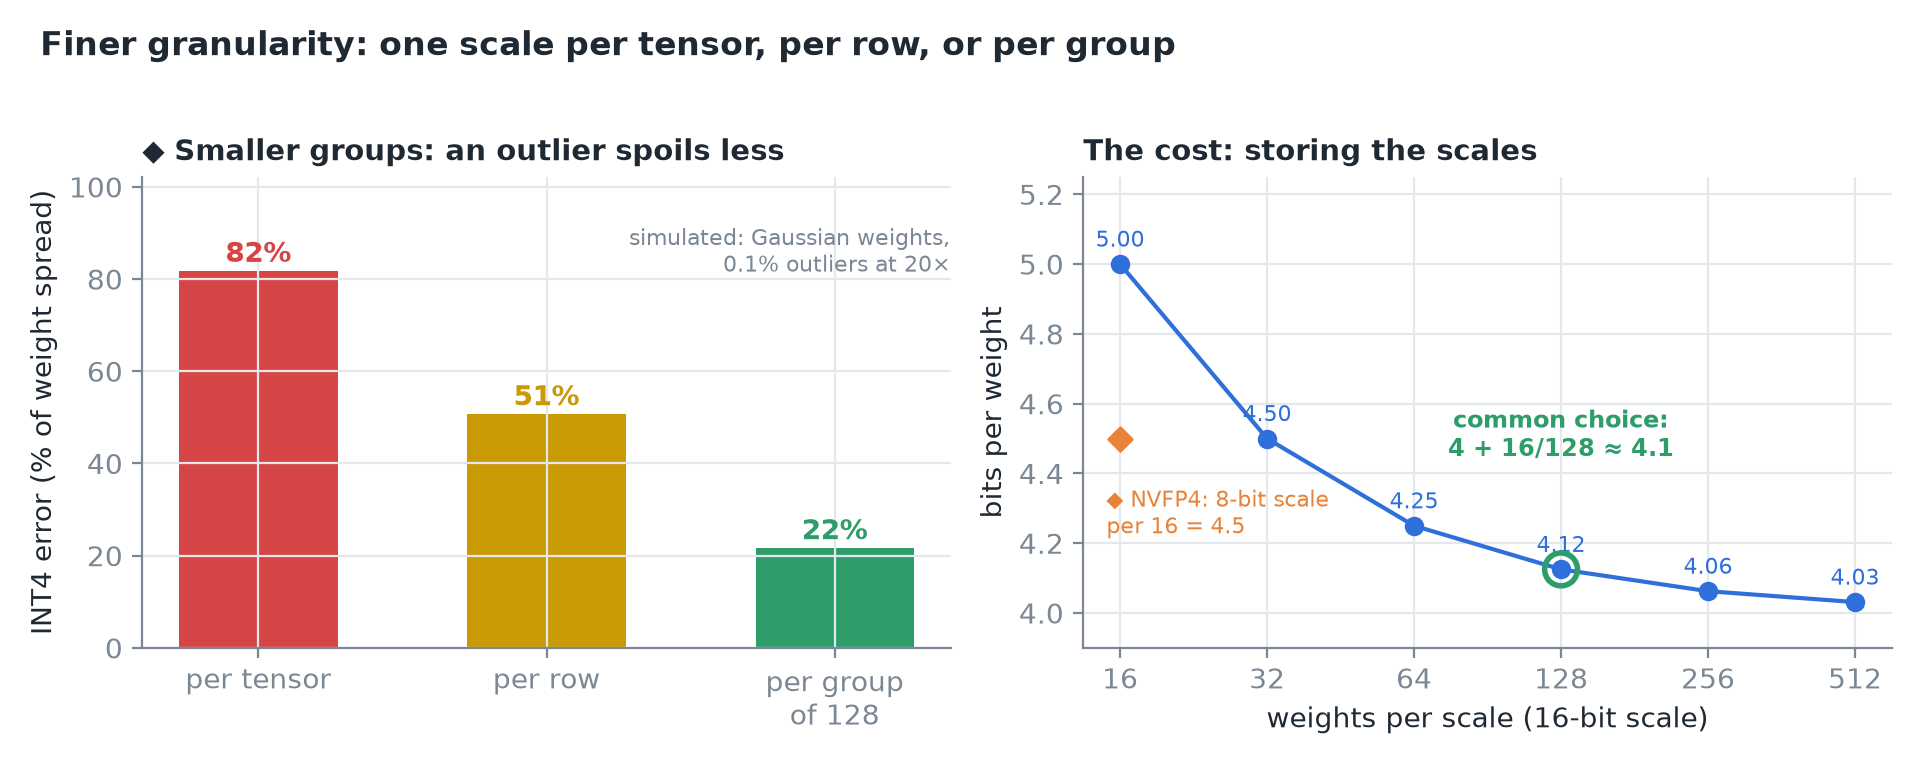 ◆ Trái là mô phỏng của tôi; phải là overhead của scale ở các kích thước nhóm khác nhau.
- Cách sửa là độ mịn cao hơn: thay vì một scale cho cả tensor, dùng một scale mỗi hàng hoặc mỗi nhóm nhỏ. Outlier khi đó chỉ làm hỏng nhóm của chính nó.
- Lựa chọn phổ biến cho trọng số 4-bit: một scale cho mỗi 128.
3. Bốn định dạng
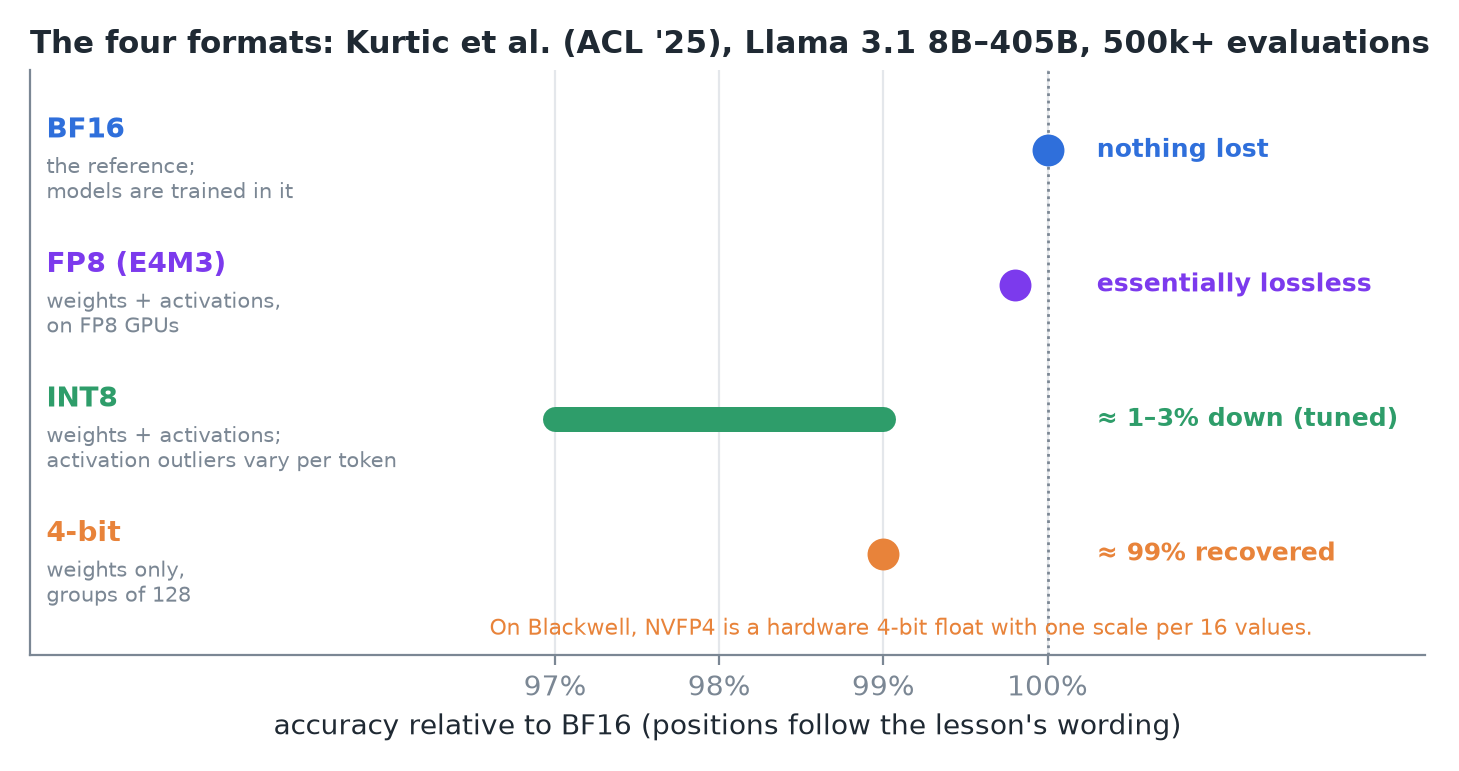 Độ chính xác từ Kurtic và cộng sự, "Give Me BF16 or Give Me Death?" (2024, ACL '25): Llama 3.1 8B–405B, hơn 500 nghìn lần đánh giá.
- BF16 là chuẩn tham chiếu: phần lớn model hiện đại được huấn luyện ở định dạng này, nên serve ở đó không mất gì.
- FP8 (E4M3) là lưới số thực, dày gần 0 và thưa ở xa, hợp với trọng số có phân phối hình chuông. Có scale, trên GPU hỗ trợ, cả trọng số và activation đều xuống FP8: về cơ bản không mất mát.
- INT8 cho trọng số + activation mất khoảng 1–3% khi được tinh chỉnh cẩn thận. Trọng số thì dễ; activation có outlier thay đổi theo từng token.
- 4-bit phần lớn là chỉ trọng số, activation giữ ở 16 bit. Với một thuật toán tốt và nhóm 128, nó giữ lại được ~99% độ chính xác gốc.
- Trên Blackwell, NVFP4 là số thực 4-bit phần cứng với một scale cho mỗi 16 giá trị.
4. Chọn cái nào
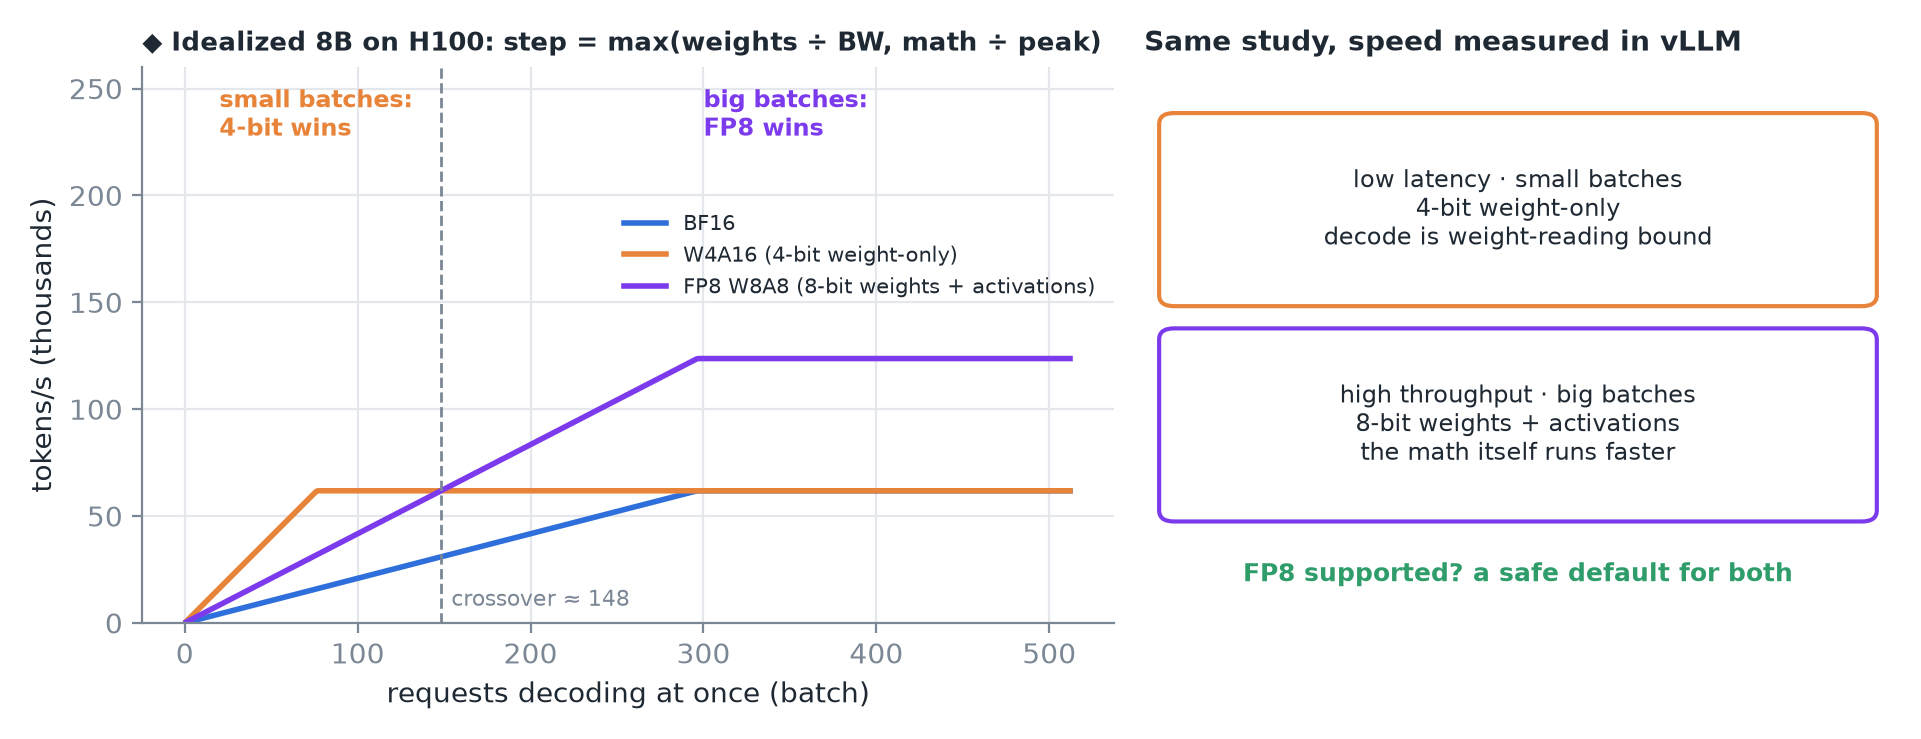 ◆ Panel trái là mô hình lý tưởng hoá, không phải số đo của nghiên cứu; nó cho thấy vì sao hai chế độ khác nhau.
| Kiểu serving | Người thắng trong nghiên cứu (vLLM) | Vì sao |
|---|---|---|
| Latency thấp, batch nhỏ | 4-bit chỉ trọng số | decode bị giới hạn bởi việc đọc trọng số |
| Throughput cao, batch lớn | 8-bit trọng số + activation | bản thân phép tính chạy nhanh hơn |
| GPU hỗ trợ FP8 | FP8 | một mặc định an toàn cho cả hai |
Mẹo
◆ Trong mô hình lý tưởng hoá, 4-bit chỉ trọng số thắng cho tới khoảng 148 request mỗi bước. Quá mức đó, decode bị giới hạn bởi phép tính, và phép tính nhanh gấp 2 của FP8 vượt lên.
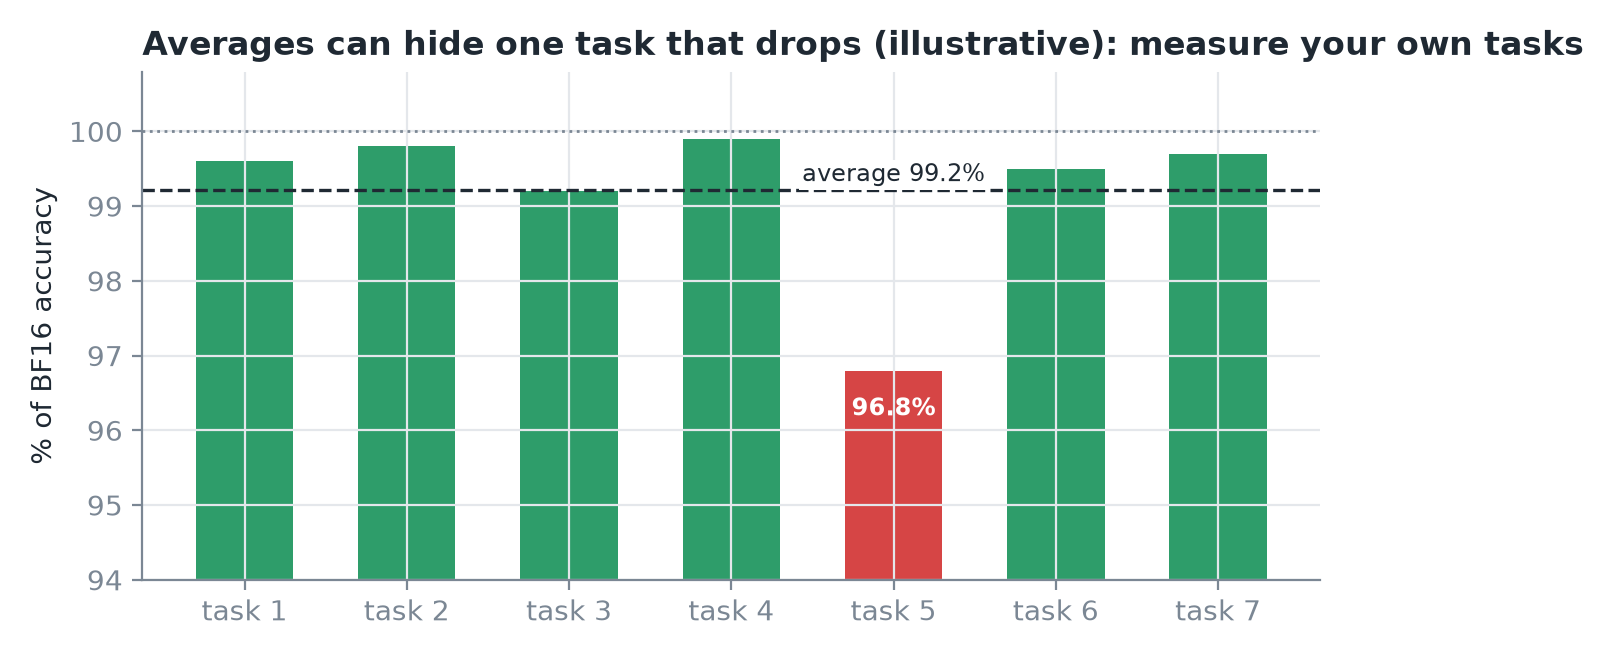 Dù chọn gì, hãy nhìn từng tác vụ, đừng chỉ nhìn trung bình.
5. Tóm tắt