24 · Thiết lập baseline một request
Nguồn: fanout.sh / inference-eng / 05-01 · ~9 phút
Ghi chú
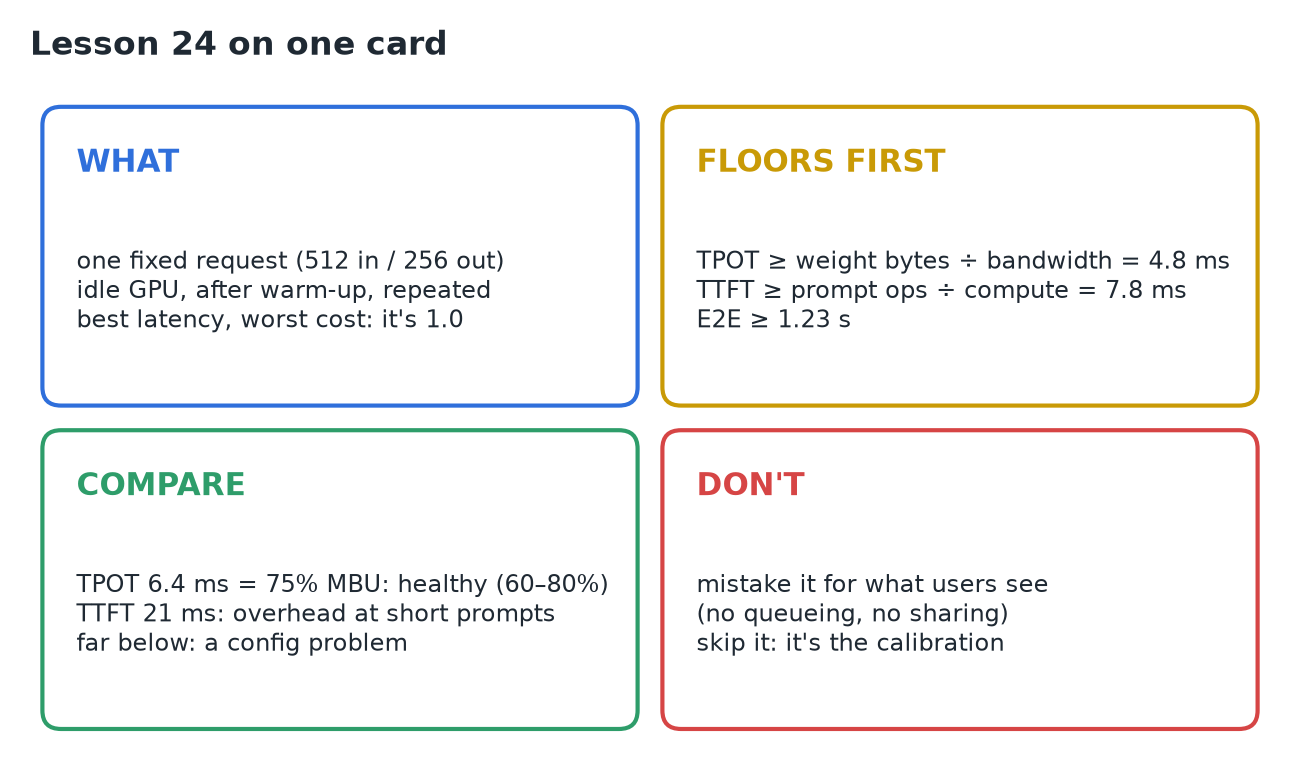
Mọi speedup về sau đều là tỷ số so với một con số ban đầu, nên hãy lấy con số đó cho đúng: một request cố định trên một GPU đang rảnh (Llama 3 8B, 16-bit, một H100, vLLM; 512 vào, 256 ra). Đó là latency tốt nhất người dùng có thể có và chi phí mỗi token tệ nhất. Tính mức sàn trước: TPOT ≥ 16 GB ÷ 3,35 TB/s ≈ 4,8 ms, TTFT ≥ 7,7 TFLOP ÷ 989 TFLOPS ≈ 7,8 ms, E2E ≥ 1,23 s. Đo sạch sẽ (cố định cấu hình, cố định shape, greedy, warm-up, ~30 lần lặp, batch 1). Một lần chạy sạch (minh hoạ) cho TTFT 21 ms, TPOT 6,4 ms, E2E 1,65 s: 75% băng thông bộ nhớ, khoẻ mạnh trong khoảng 60–80%. Tệ hơn nhiều nghĩa là có vấn đề cấu hình, và mức sàn là thứ cho bạn biết điều đó.
1. Vì sao cần baseline, và cái bẫy mặc định
Benchmark latency của vLLM (vllm bench latency) mặc định gửi một batch 8 request cùng lúc. Con số đó đo tám request dùng chung GPU và nói rất ít về một request. Nếu con số ban đầu sai, mọi tỷ số sau nó cũng sai.
Baseline một request trả lời một câu hỏi: khi GPU không có việc gì khác, một request chạy nhanh tới đâu? Ghi lại TTFT, TPOT và E2E.
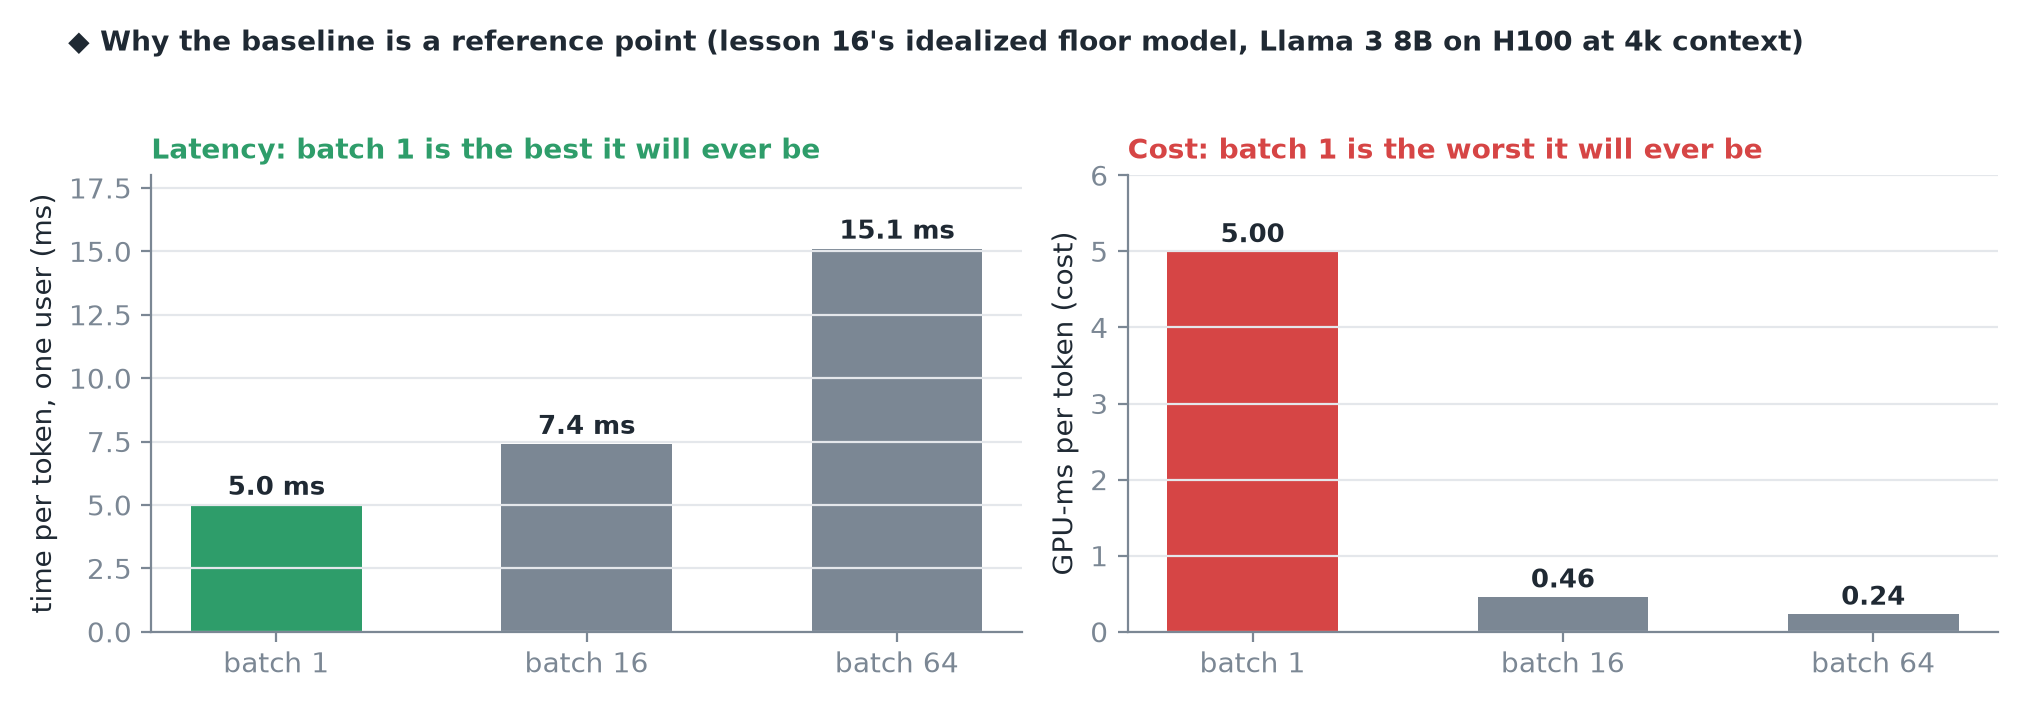 Đó là latency tốt nhất cấu hình này có thể cho một người dùng (không ai tranh GPU) và chi phí mỗi token tệ nhất (GPU làm ít việc hữu ích nhất có thể). Cả hai điều đó làm nó thành một điểm tham chiếu.
2. Tính mức sàn trước
- Decode: mỗi bước đọc toàn bộ ~16 GB trọng số; 16 GB ÷ 3,35 TB/s ≈ 4,8 ms mỗi token. Không cách cài đặt nào xuống dưới mức này được: byte không thể đến nhanh hơn.
- Prefill: 512 token × ~15 GFLOP mỗi token ≈ 7,7 TFLOP; ÷ 989 TFLOPS (16-bit) ≈ 7,8 ms tới token đầu tiên.
- End to end: 7,8 ms + 255 × 4,8 ms ≈ 1,23 s.
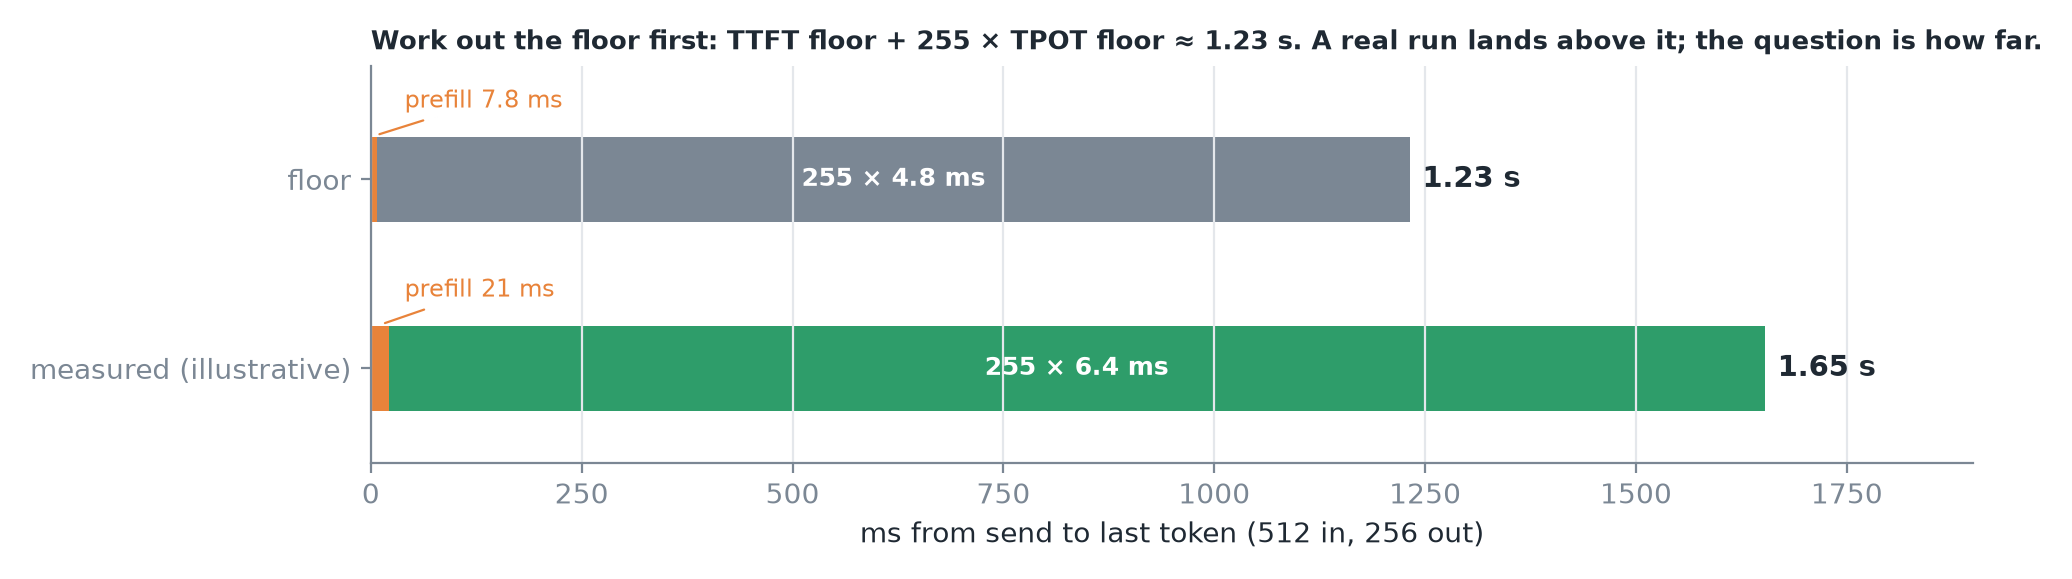 Mức sàn và một lần chạy sạch minh hoạ trên cùng trục. 255, không phải 256: thời gian của token đầu tiên là TTFT.
3. Đo sạch sẽ
Loại bỏ mọi thứ không phải là thứ bạn đang đo.
| Quy tắc | Vì sao |
|---|---|
| Cố định cấu hình: revision model, dtype, phiên bản engine, GPU, driver | Người khác tái tạo lại được |
| Cố định shape: đúng 512 vào, ép 256 ra (bỏ qua EOS) | Nếu không thì lần này dừng ở 40 token, lần khác ở 200 |
| Decode greedy | Mỗi lần chạy cùng một đầu ra |
| Warm-up (vLLM: 10 lần lặp, bỏ đi) | Các request đầu trả chi phí một lần: biên dịch kernel, capture CUDA graph, cấp phát bộ nhớ |
| Lặp lại ~30 lần | Một lần chạy gần như không nói lên gì; 30 lần cho trung vị và độ trải |
| Batch size 1 | Đó là mục đích của bài đo |
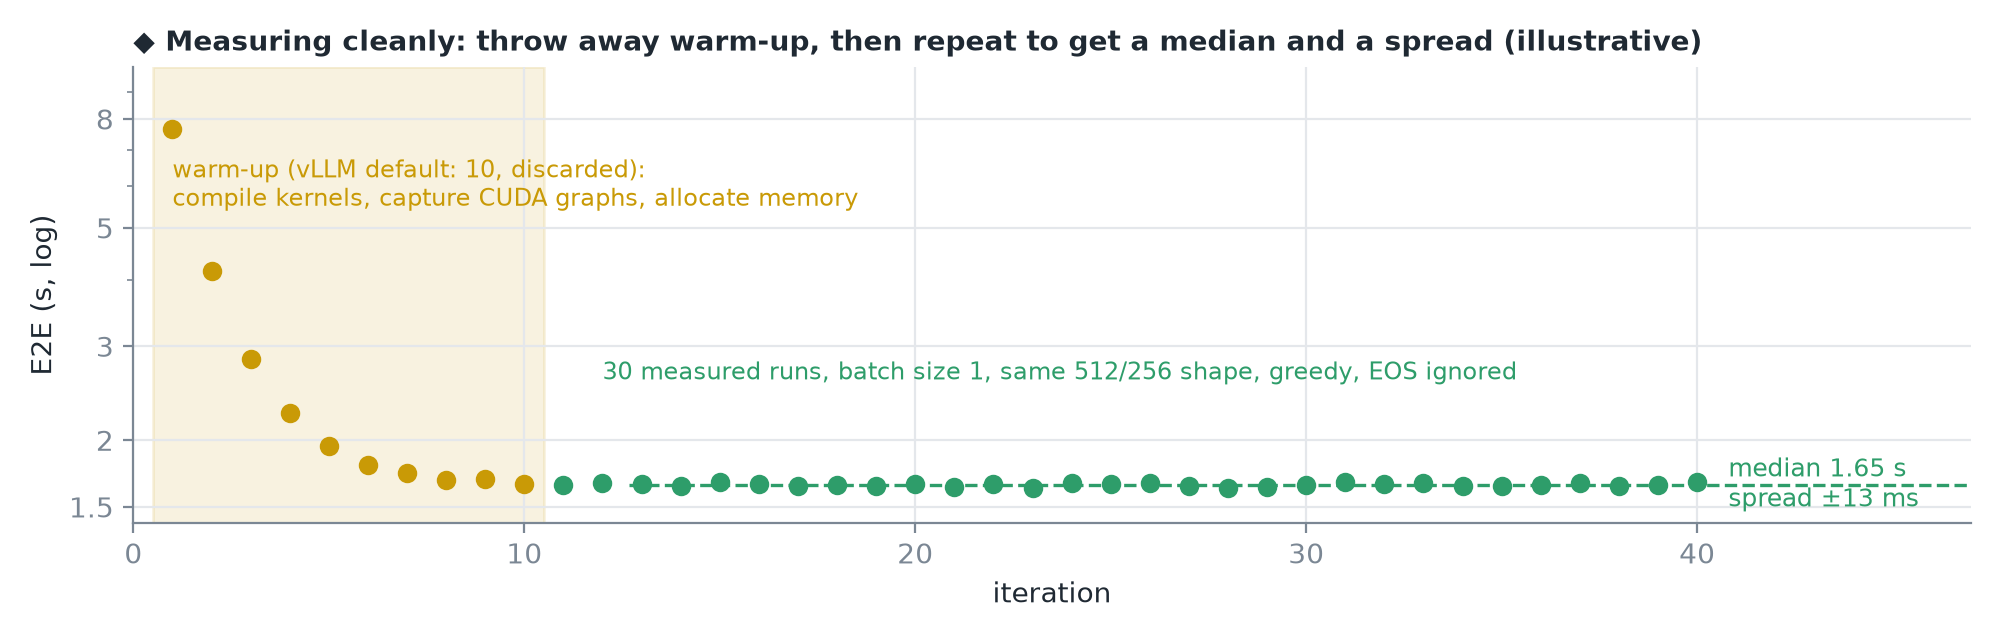
Chạy theo hai cách:
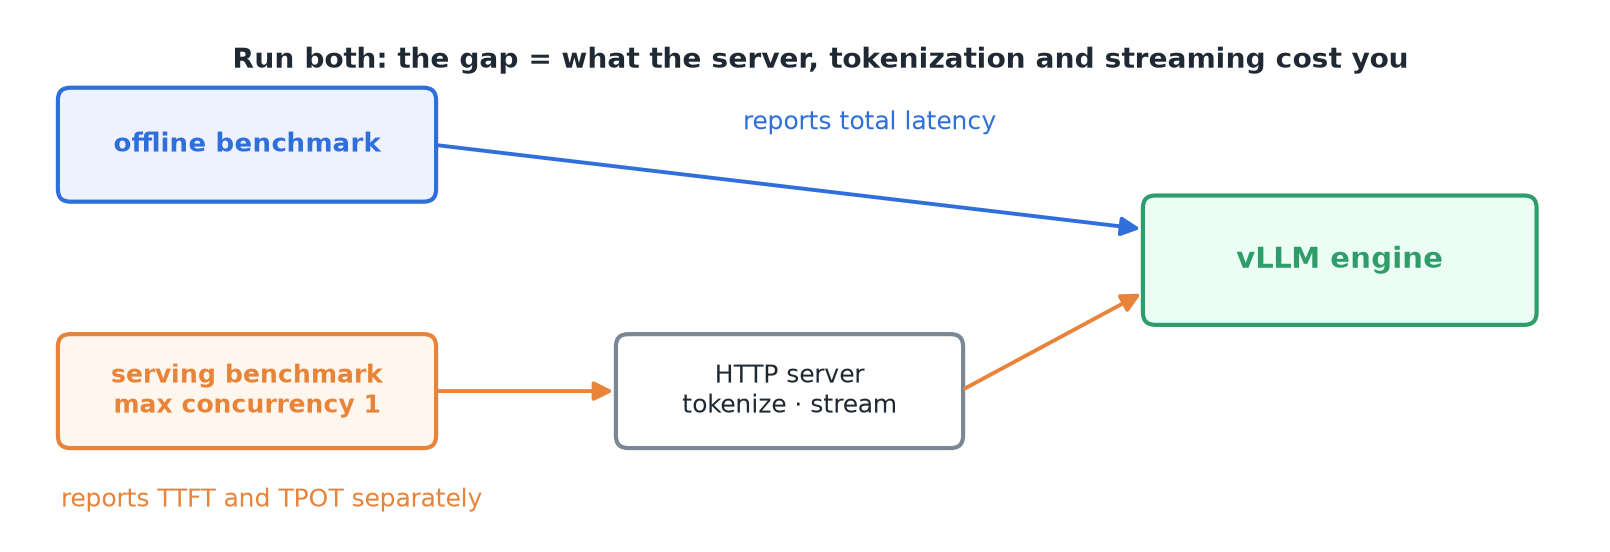 Benchmark offline nói chuyện thẳng với engine và báo tổng latency. Benchmark serving đi qua HTTP server thật với max concurrency 1 và báo TTFT, TPOT riêng.
4. So với các mức sàn
Một lần chạy sạch (số minh hoạ, trong khoảng kỳ vọng): TTFT 21 ms, TPOT 6,4 ms, E2E ≈ 1,65 s.
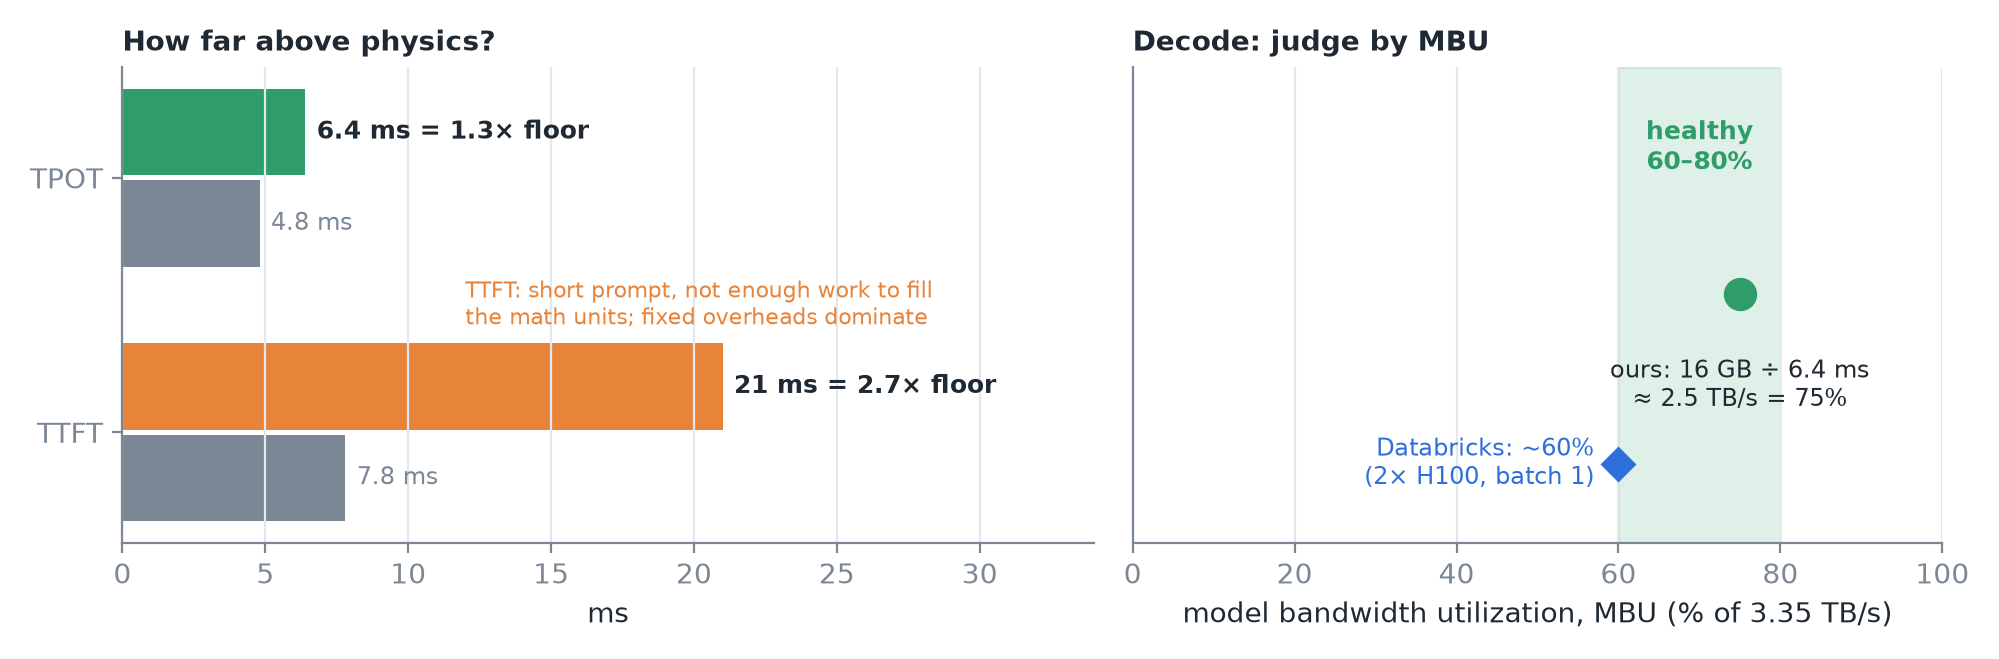 Decode: 16 GB mỗi 6,4 ms ≈ 2,5 TB/s, 75% đỉnh. Databricks gọi đây là model bandwidth utilization (MBU) và báo khoảng 60% ở batch 1 trên hai H100.
- Decode ở 60–80% MBU nghĩa là engine đang làm đúng việc.
- Prefill nằm xa mức sàn hơn (21 so với 7,8 ms). Bình thường với prompt ngắn: 500 token không đủ việc để giữ mọi đơn vị tính toán bận, và chi phí cố định chiếm tỷ trọng lớn hơn.
5. Khi số trông bất thường
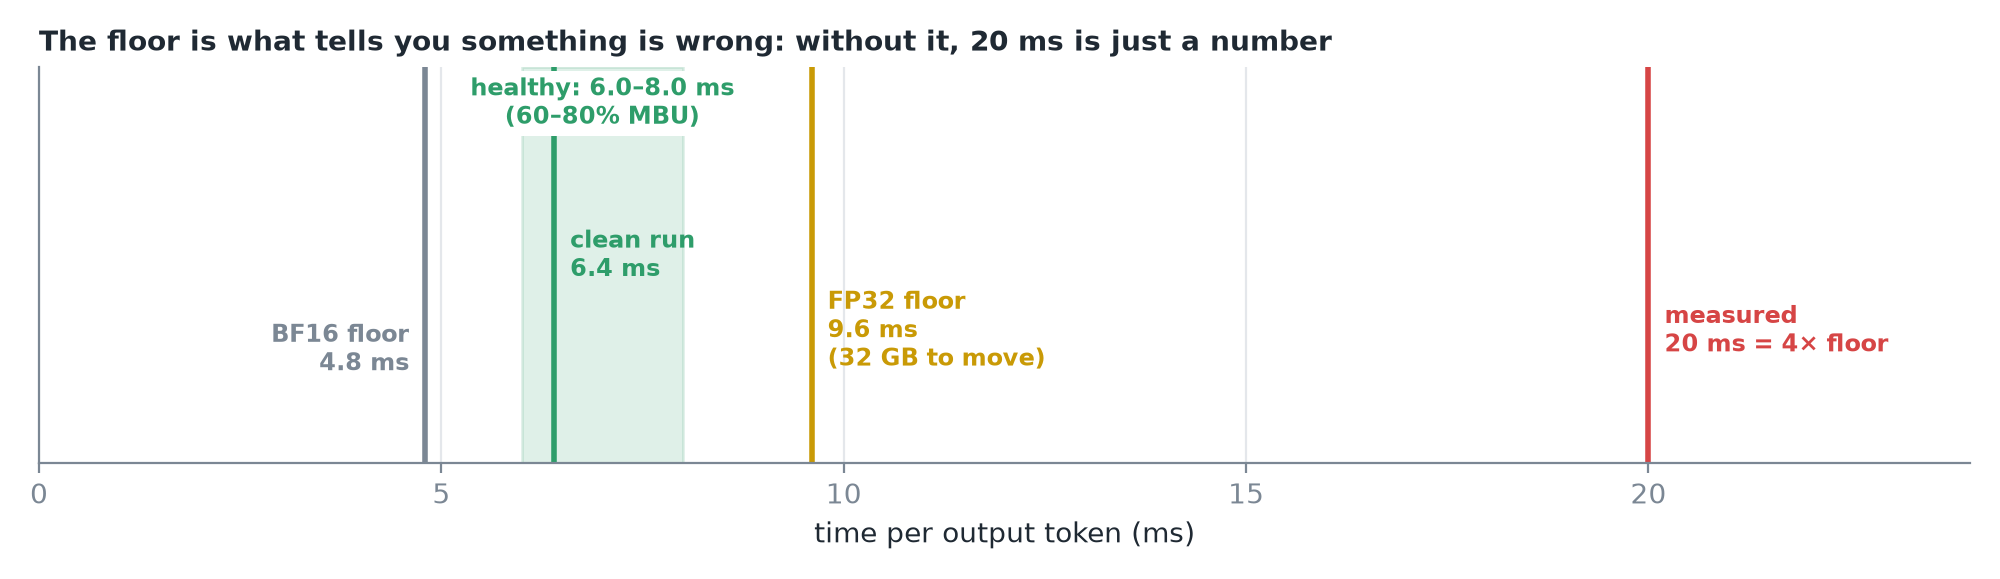 Giả sử TPOT là 20 ms, khoảng 4 lần mức sàn. Đó là một triệu chứng.
| Nghi phạm | Điều gì xảy ra |
|---|---|
Eager mode (--enforce-eager) | Không có CUDA graph hay biên dịch: CPU launch từng op GPU nhỏ một, ở mọi bước |
| Trọng số FP32 | 32 GB phải chuyển: bản thân mức sàn tăng gấp đôi lên 9,6 ms |
| GPU bị nhiễu | Một process khác, một notebook còn sót lại, hoặc xung nhịp bị hạ do công suất hay nhiệt |
| Chỉ TTFT bất thường | Bỏ qua warm-up, hoặc client bấm giờ cả mạng và tokenize |
| Độ trải rộng giữa các lần chạy | Đừng tin con số nào cho tới khi biết lý do |
6. Ghi lại
| Trường | Ví dụ |
|---|---|
| Cấu hình | Revision model, dtype, engine, driver |
| Shape | 512 vào / 256 ra, greedy, bỏ qua EOS |
| Metric (trung vị và độ trải) | TTFT 21 ms · TPOT 6,4 ms · E2E 1,65 s |
| So với mức sàn | TPOT 1,3× mức sàn · MBU 75% |
| Kết luận | "Decode chạy ở 75% băng thông bộ nhớ; prefill bị chi phí cố định chi phối ở độ dài prompt này." |
Từ giờ đây là 1,0: mọi lần quét sau (thêm người dùng, prompt dài hơn, đầu ra dài hơn) là thay đổi tính từ đây.
Thận trọng
Hai hiểu lầm. Baseline không phải thứ người dùng thấy: nó là trường hợp tốt nhất; production thêm xếp hàng, chia sẻ và batching. Và đừng bỏ qua nó: nó là bước hiệu chuẩn, và là phép đo duy nhất bạn có thể đối chiếu với vật lý.
7. Tóm tắt