07 · Ôn lại kiến trúc Transformer
Nguồn: fanout.sh / inference-eng / 00-06 · ~9 phút
Ghi chú
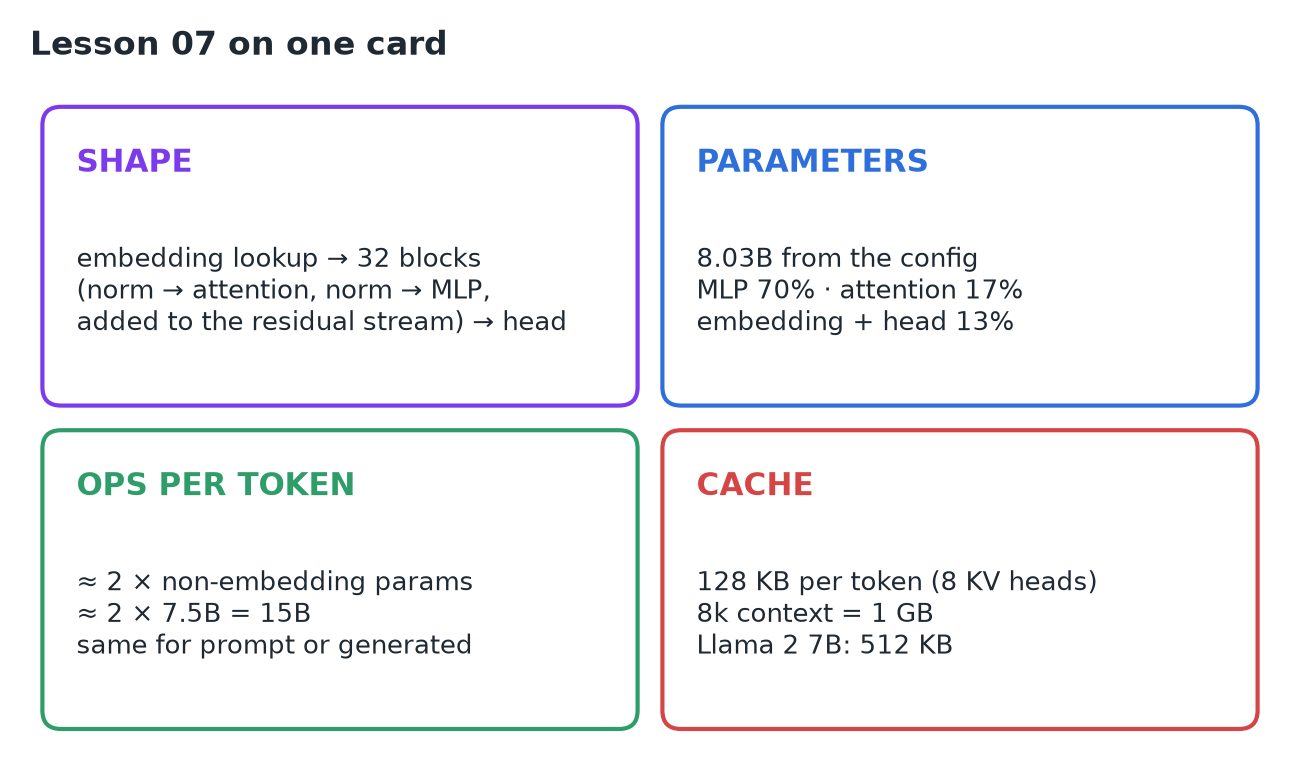
Một transformer gồm một phép tra embedding, một chồng block giống hệt nhau (attention + MLP, mỗi phần cộng kết quả vào một vector chạy dọc), và một head chấm điểm toàn bộ vocabulary. Bảy con số trong file config ~30 dòng của Llama 3 8B quyết định toàn bộ hoá đơn của nó: 8,03 tỷ tham số (70% nằm trong MLP), ~15 tỷ phép tính mỗi token, và KV cache 128 KB mỗi token. Các model mới phần lớn chỉ thay vài phần của bộ khung này, và mỗi lần thay làm dịch chuyển một dòng trong hoá đơn.
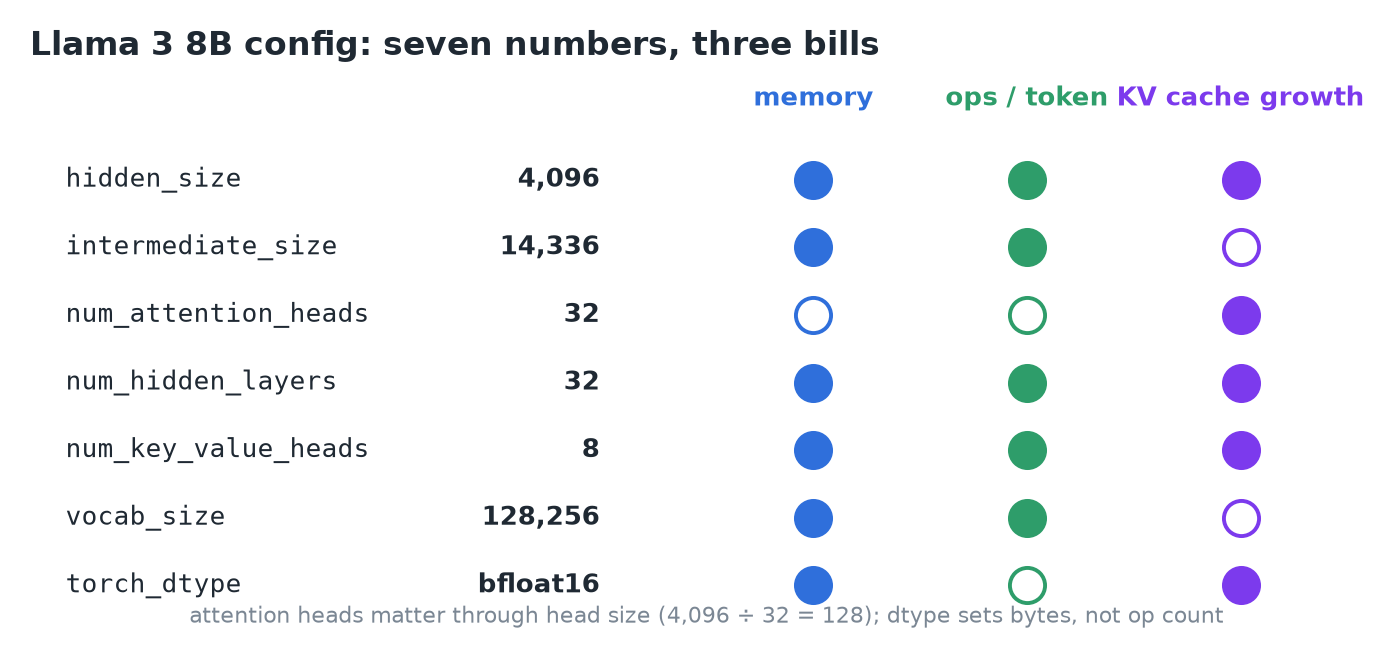 Bảy con số config quan trọng, và mỗi con số đổ vào khoản chi phí nào.
1. Toàn bộ cỗ máy
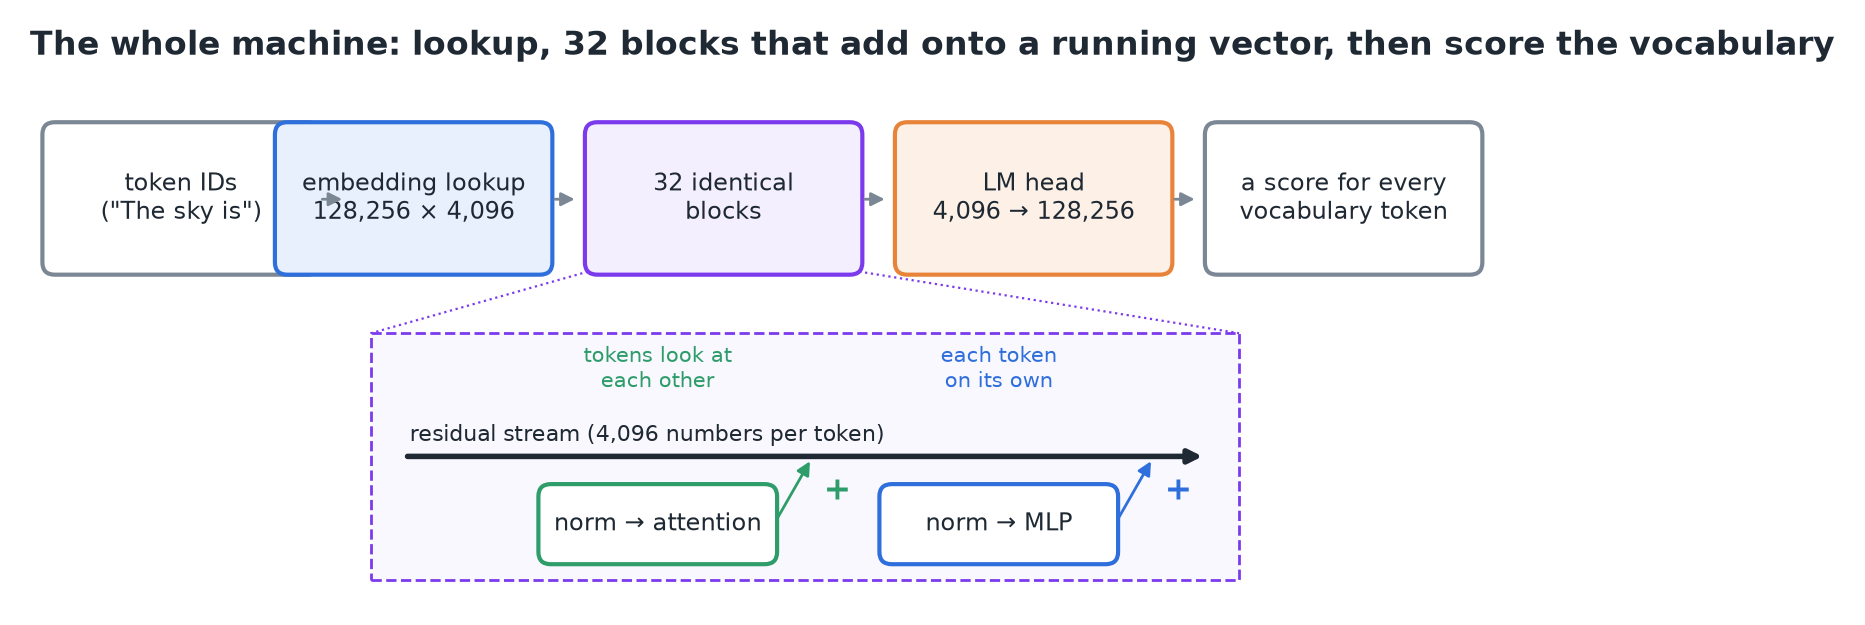 Token ID chọn các hàng của bảng embedding; 32 block cộng kết quả của chúng vào residual stream; LM head chấm điểm cả 128.256 token.
- Mỗi token ID chọn một hàng của bảng embedding: một vector 4.096 số.
- Các vector đi qua 32 block giống hệt nhau. Mỗi block có attention (các token nhìn nhau) và một MLP (mỗi token được xử lý riêng).
- Mỗi phần đọc một bản sao đã chuẩn hoá của vector và cộng kết quả của nó trở lại: vector chạy dọc đó là residual stream.
- LM head biến mỗi vector cuối thành điểm cho từng token trong vocabulary (128.256).
Quan trọng
Đó là toàn bộ kiến trúc. Mọi việc một inference engine làm đều nhằm chạy chồng block này nhanh hơn.
2. Đếm tham số từ config
| Thành phần | Kích thước | Số tham số |
|---|---|---|
| Bảng embedding | 128.256 × 4.096 | ~525 triệu |
| Attention Q, O (mỗi block) | 4.096 × 4.096 mỗi cái | ~17 triệu mỗi cái |
| Attention K, V (mỗi block) | 4.096 × 1.024 mỗi cái (8 KV head × 128) | ~4 triệu mỗi cái |
| Tổng attention (mỗi block) | ~42 triệu | |
| MLP (mỗi block) | 3 ma trận 4.096 × 14.336 | ~176 triệu |
| Một block | ~218 triệu → × 32 ≈ 6,98 tỷ | |
| LM head (riêng, không dùng chung với embedding) | 4.096 × 128.256 | ~525 triệu |
| Tổng | 8,03 tỷ ("8B") |
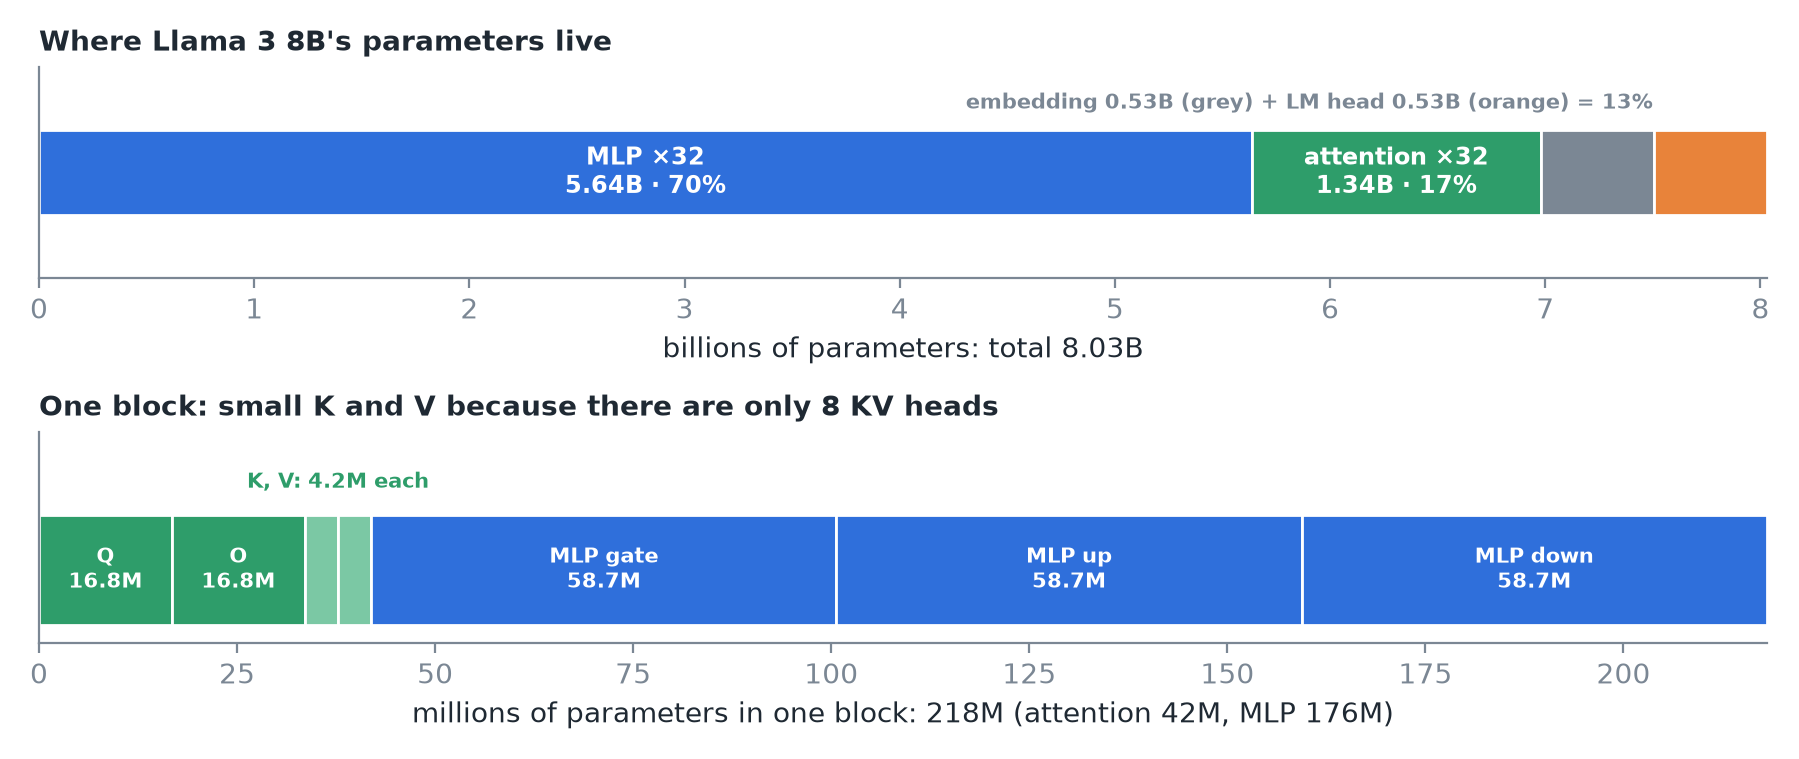 MLP giữ 70% trọng số, attention 17%, embedding + head 13%. Trong một block, K và V nhỏ vì chỉ có 8 KV head.
3. Tham số → byte
Byte = số tham số × số byte mỗi tham số (xem bài 04): 16 GB ở 16-bit, ~8 GB ở 8-bit, ~4 GB ở 4-bit (cộng thêm chút ít cho hệ số scale). Decode đọc mọi byte ở mọi bước, nên độ chính xác vừa là núm chỉnh bộ nhớ vừa là núm chỉnh tốc độ.
Mẹo
70% nằm trong MLP là chỗ lượng tử hoá tiết kiệm được nhiều byte nhất, và nhiều thời gian nhất.
4. Tham số → phép tính
Mỗi trọng số được dùng một lần cho mỗi token dưới dạng một phép nhân + một phép cộng, nên một token tốn ~2 phép tính trên mỗi tham số, trừ bảng embedding vốn chỉ là phép tra (miễn phí). LM head là một phép nhân ma trận thật và là một trong những ma trận lớn nhất.
Token nằm trong prompt hay được sinh ra thì cũng là 15 tỷ như nhau; cái khác là cách chúng đến:
- Prefill: 500 token prompt đi cùng nhau = 7,5 nghìn tỷ phép tính trong một batch, giữ các đơn vị tính toán luôn bận.
- Decode: 15 tỷ phép tính trên 16 GB trọng số phải đọc ≈ 1 phép tính mỗi byte: GPU phần lớn thời gian chờ bộ nhớ (xem bài 01, 04).
5. KV cache: dòng chi phí cứ tăng mãi
Mỗi block giữ key và value của mọi token nó đã thấy, để không bao giờ phải tính lại. Từ config: 8 KV head × 128 × 2 (K, V) × 2 byte = 4 KB mỗi token mỗi layer, × 32 layer = 128 KB mỗi token. Một context 8k đầy ≈ 1 GB, cho một cuộc hội thoại.
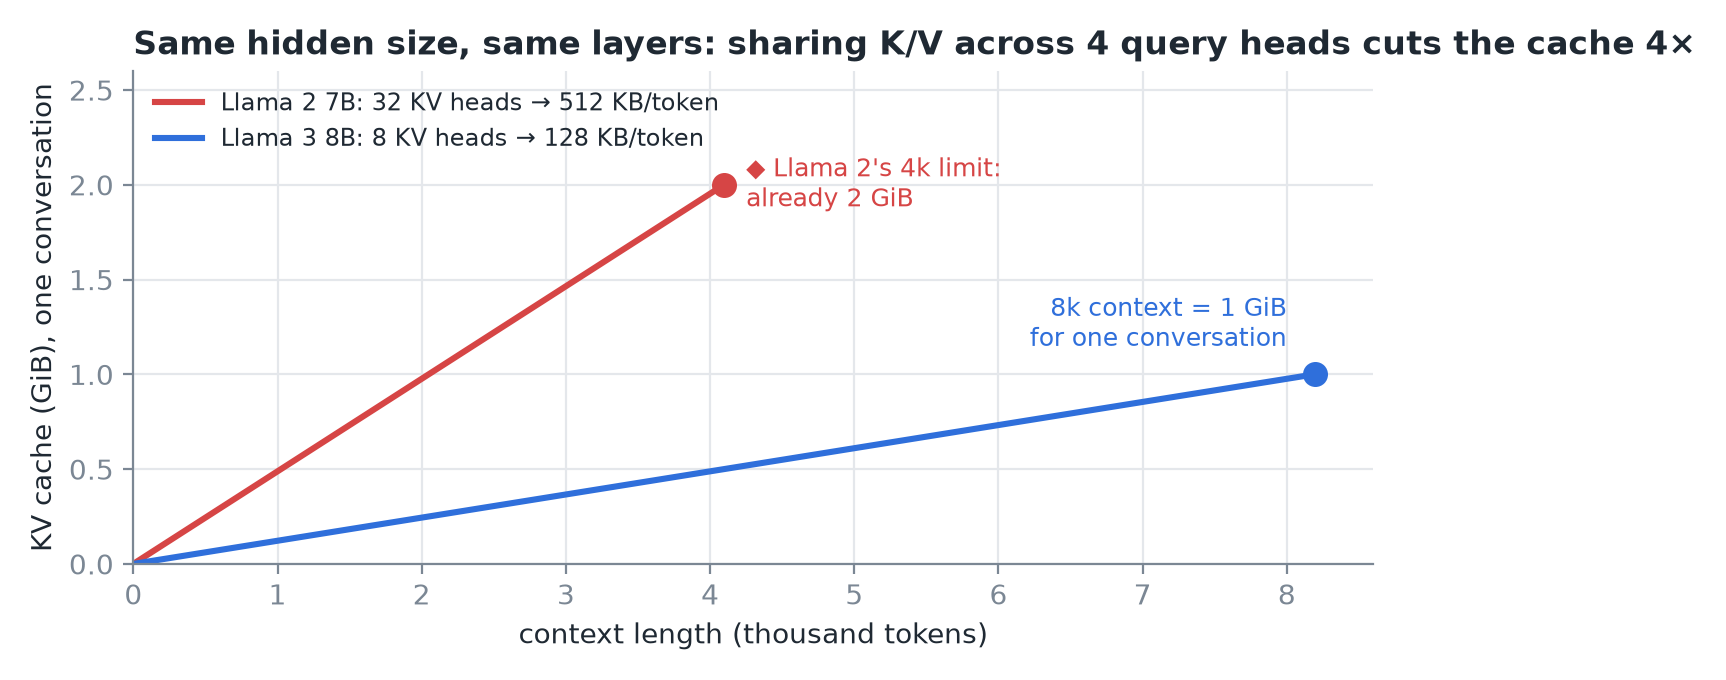 Llama 2 7B cho mỗi query head trong 32 cái một bộ K và V riêng: 512 KB mỗi token, gấp 4 lần Llama 3 8B, dù cùng hidden size và số layer.
Quan trọng
Dùng chung key và value cho từng nhóm query head (GQA) là một trong những cái lợi rẻ nhất của các kiến trúc hiện đại.
6. Các biến thể trên cùng bộ khung
- Mixture of experts (MoE): thay một MLP lớn bằng nhiều expert nhỏ hơn; một router chọn vài expert cho mỗi token.
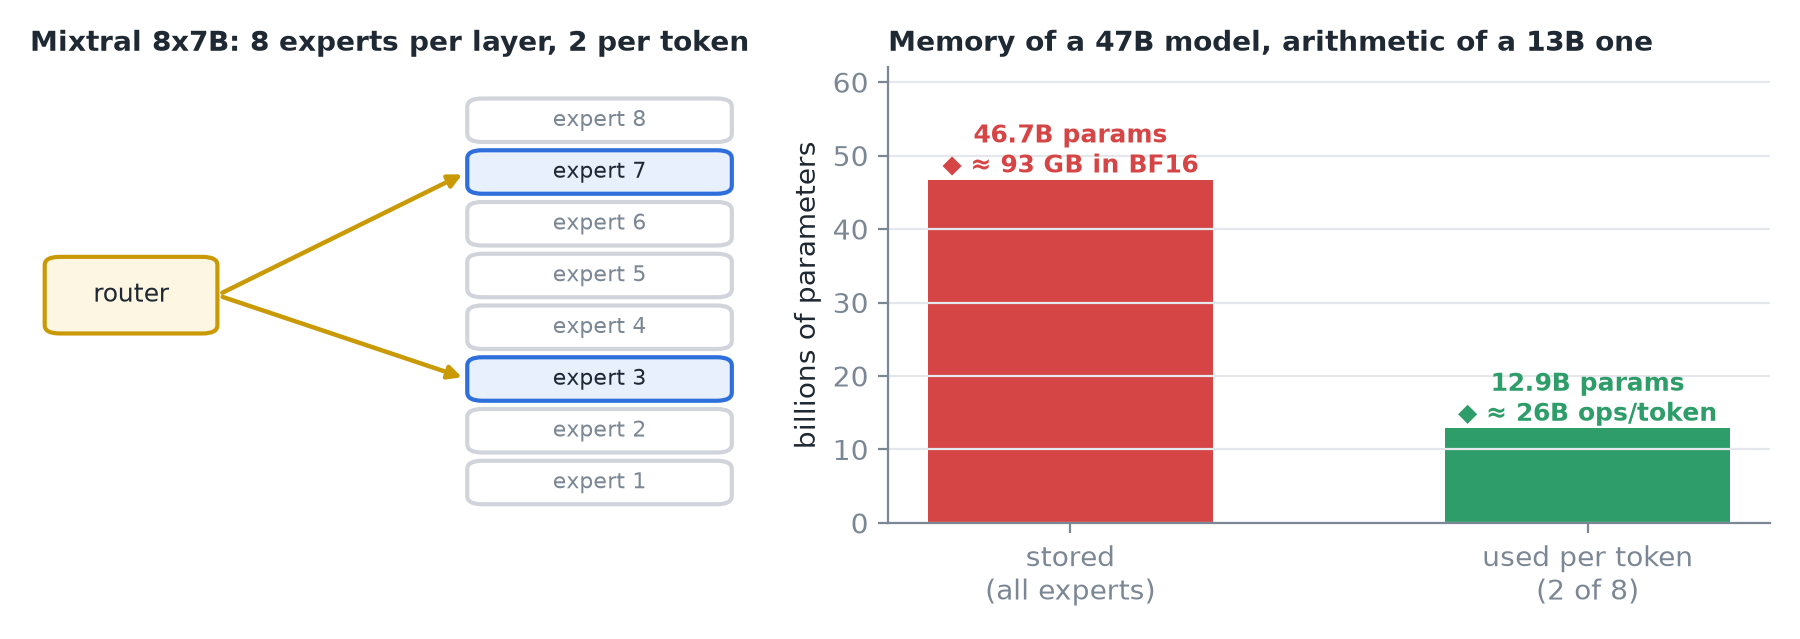 Mixtral 8x7B: 8 expert mỗi layer, 2 expert mỗi token. Lưu 46,7 tỷ tham số, mỗi token dùng 12,9 tỷ: bộ nhớ và tính toán tách khỏi nhau.
- Biến thể attention: ít KV head hơn hoặc nén key và value thu nhỏ trực tiếp dòng chi phí cache.
- Vị trí: Llama xoay mỗi query và key một góc phụ thuộc vị trí (RoPE). Không có bảng vị trí nào để vượt quá, đây là một phần lý do Llama 3.1 đạt context 128k token.
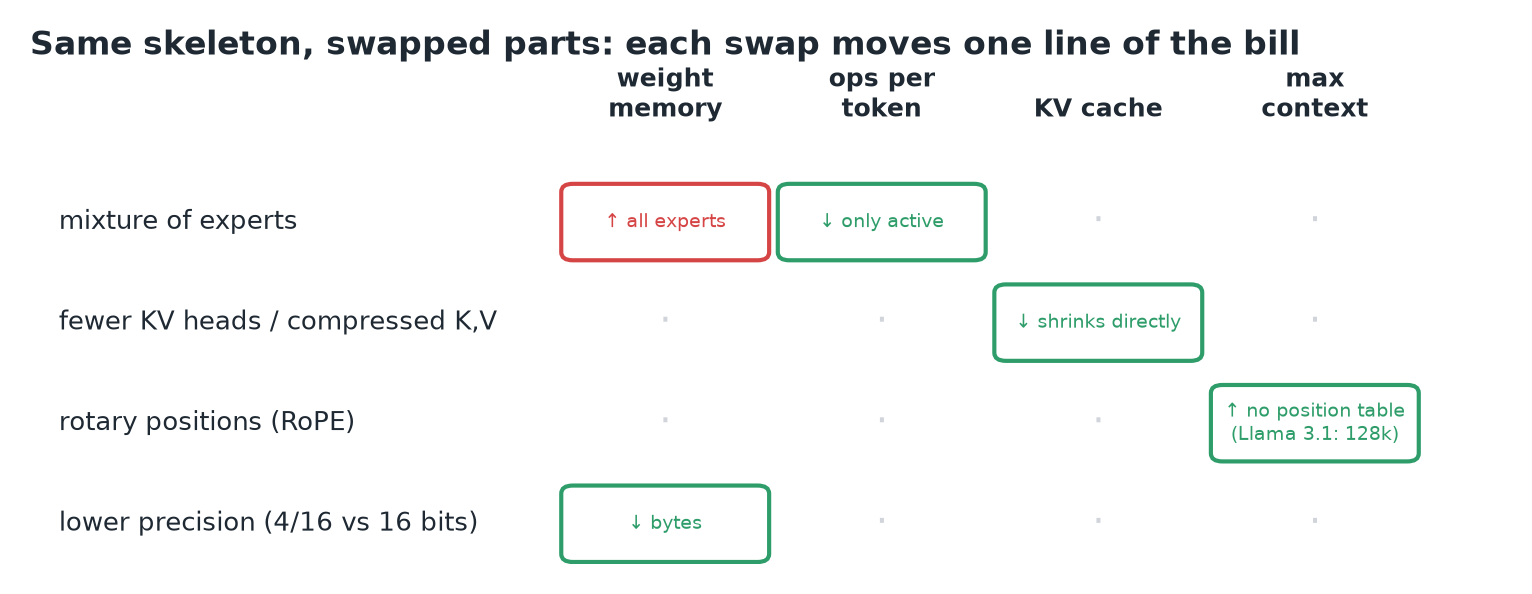 Mỗi lần thay đổi hiện ra ở đúng một dòng của hoá đơn.
7. Ba điều cần chỉnh lại
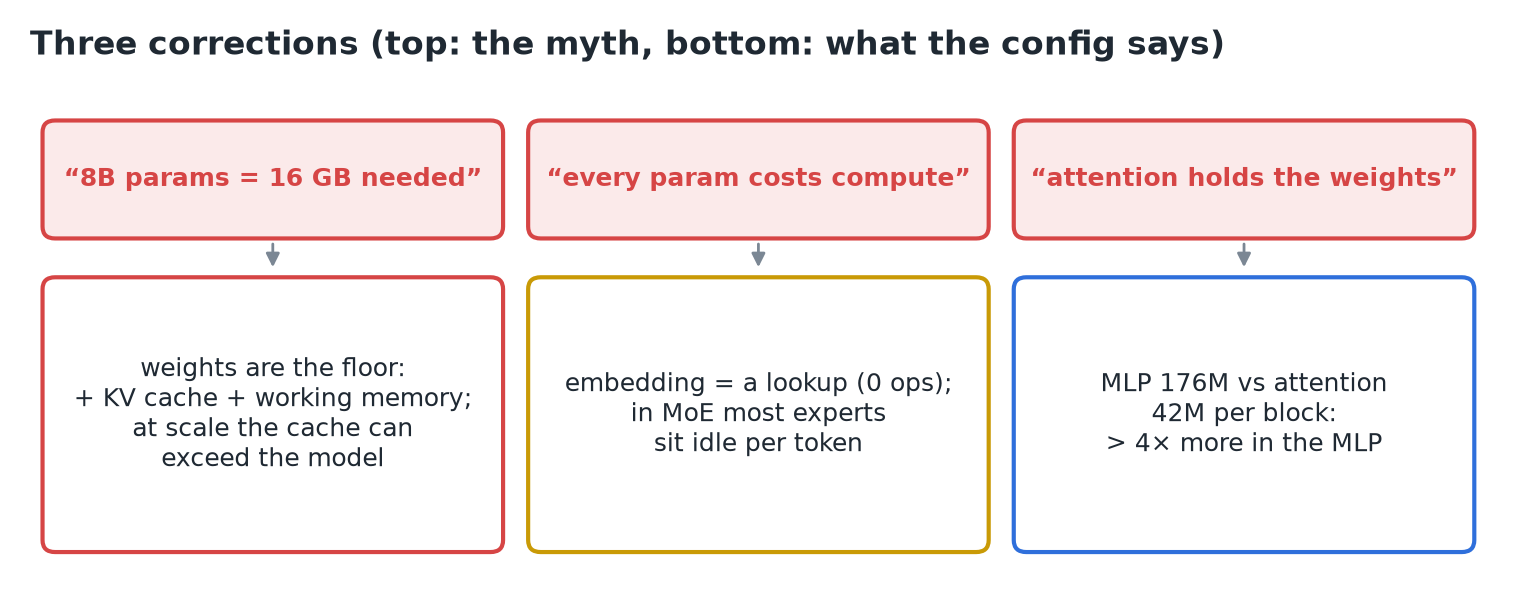 Số tham số không phải lượng bộ nhớ cần; không phải tham số nào cũng tốn tính toán; MLP, chứ không phải attention, giữ phần lớn trọng số.
8. Tóm tắt