29 · API tương thích OpenAI và streaming
Nguồn: fanout.sh / inference-eng / 06-03 · ~8 phút
Ghi chú
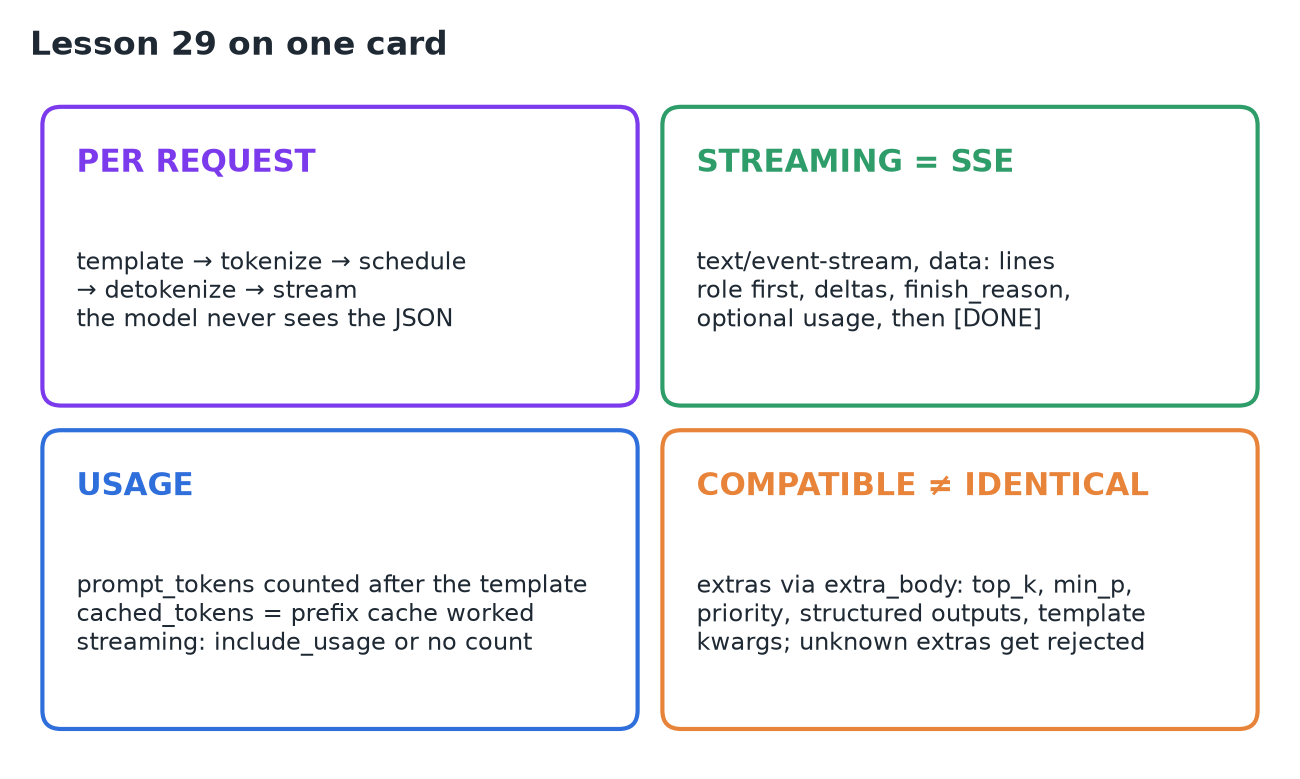
"Tương thích OpenAI" là một hợp đồng về giao thức trên dây, không phải về engine: cùng những byte gửi tới /v1/chat/completions nhận được câu trả lời cùng hình dạng từ vLLM, server của llama.cpp hay của TensorRT-LLM. Với mỗi request, server chạy template → tokenize → lập lịch → detokenize → stream; model không bao giờ thấy JSON. Streaming là Server-Sent Events: role trước, rồi các delta, một finish reason, tuỳ chọn usage, rồi [DONE]. Usage được đếm sau chat template, và cached_tokens cho thấy prefix cache đang hoạt động. Phần lớn lỗi "trả lời kỳ lạ" nằm ở bước template.
1. Hợp đồng
Một request là một URL kết thúc bằng /v1/chat/completions, một body JSON chứa danh sách message, và stream: true. Gửi nó tới vLLM là bạn nhận được câu trả lời; gửi đúng những byte đó tới server của llama.cpp hay TensorRT-LLM là bạn nhận được câu trả lời cùng hình dạng.
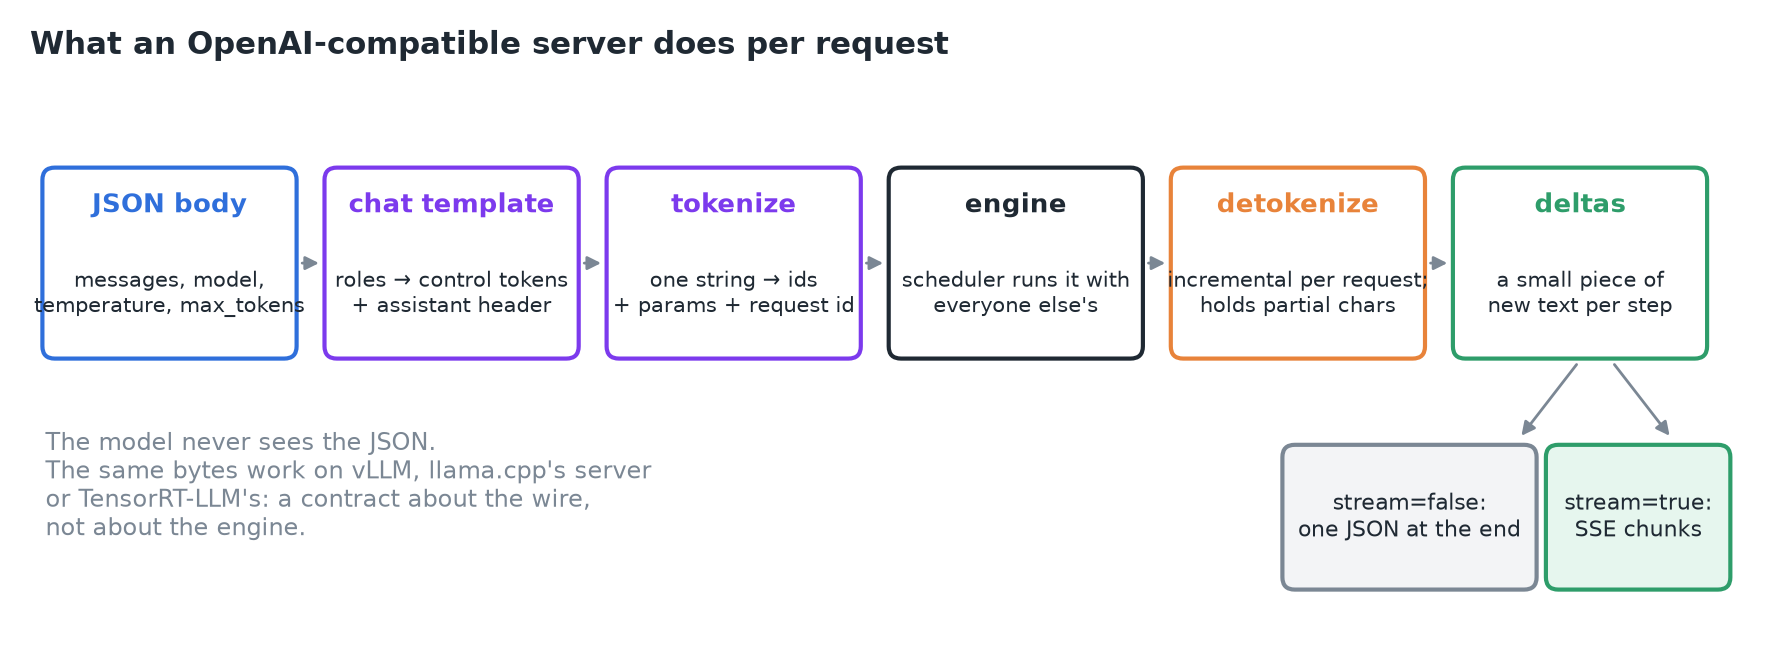 Những gì một server tương thích làm cho mỗi request để giữ đúng hợp đồng.
2. Từ JSON tới token: chat template
- Body chứa messages (role và nội dung), tên model, và các núm sampling: temperature, top-p, ngân sách token.
- Server cho danh sách message đi qua chat template của model, lưu trong
tokenizer_config.json. Các role trở thành control token. Với Llama 3.1: một marker bắt đầu văn bản, rồi với mỗi message là một header chứa role, nội dung, và một marker kết thúc lượt. add_generation_promptmặc định bật, nên còn một header nữa theo sau: assistant, tín hiệu để trả lời.- Chuỗi kết quả được tokenize thành id; các id đó, tham số sampling và một request id mới được gửi tới engine.
- vLLM yêu cầu model có chat template trong tokenizer config; nếu thiếu, hãy cung cấp nó bằng
--chat-template.
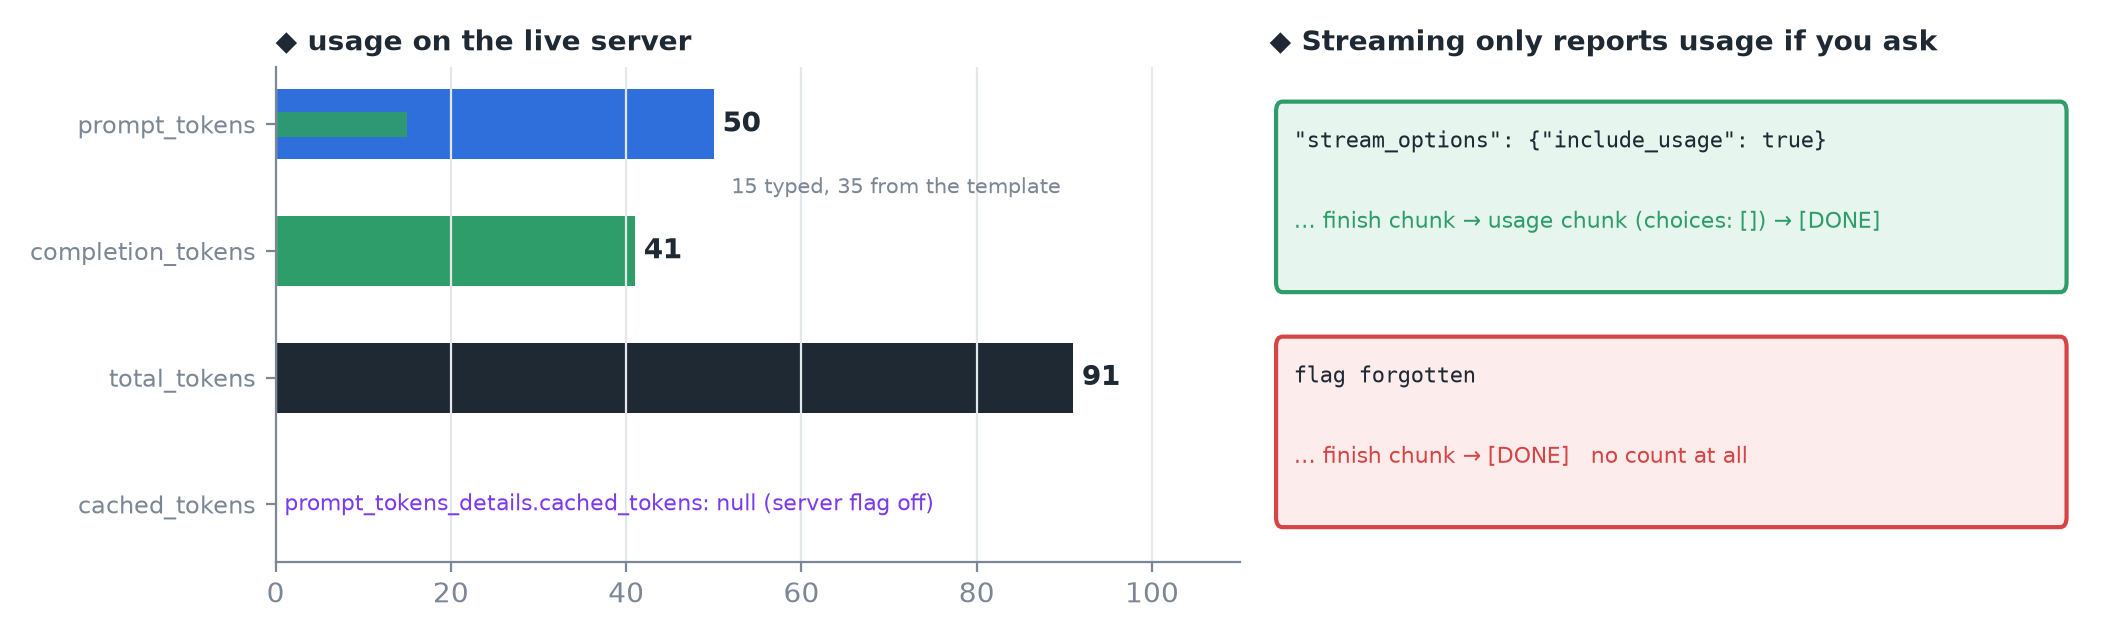
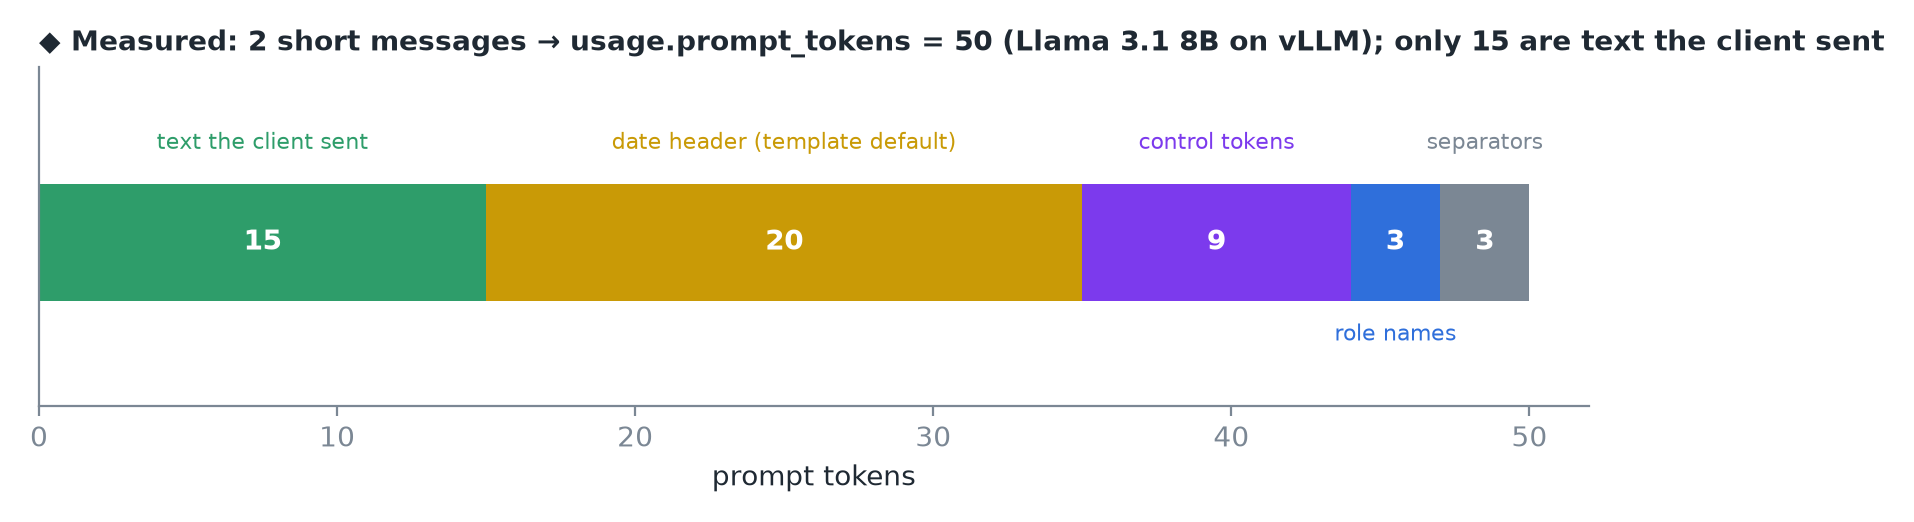 ◆ Đo trên server vLLM của tôi: "You are a support assistant." cộng "Explain the KV cache in one sentence." thành 50 token prompt. Template của Llama 3.1 còn mặc định chèn header "Cutting Knowledge Date / Today Date" vào system message.
Cảnh báo
Phần lớn lỗi "nó trả lời kỳ lạ" nằm ở bước này. Sai template là sai token, và model lịch sự viết tiếp một cuộc hội thoại mà bạn không hề định có.
3. Vào engine rồi quay ra
- Server giao request cho scheduler, nơi quyết định khi nào nó chạy cùng request của những người khác.
- Mỗi bước trả về một token id mới cho request này.
- Server giữ một detokenizer tăng dần cho mỗi request: nó biến id thành văn bản khi chúng đến và giữ lại những byte chưa tạo thành một ký tự hoàn chỉnh.
- Vậy là mỗi bước server có một mẩu văn bản mới nhỏ: delta.
4. Không streaming: một JSON
Server gom các delta cho tới khi request xong, rồi gửi một object:
{
  "id": "chatcmpl-…", "object": "chat.completion",
  "choices": [{"index": 0,
               "message": {"role": "assistant", "content": "A KV (Key-Value) cache is …"},
               "finish_reason": "stop"}],
  "usage": {"prompt_tokens": 50, "completion_tokens": 41, "total_tokens": 91}
}
finish_reason | Ý nghĩa |
|---|---|
stop | Gặp token kết thúc hoặc stop string |
length | Chạm ngân sách token (max_tokens) |
tool_calls | Model yêu cầu gọi một function |
Một JSON, một lượt đi về: ổn với câu trả lời ngắn, nhưng với câu trả lời dài thì người dùng nhìn màn hình trống mười giây.
5. Streaming: Server-Sent Events
Streaming thay đổi giao thức trên dây, không thay đổi vòng lặp. Server trả lời với Content-Type: text/event-stream: kết nối được giữ mở và server đẩy từng dòng, mỗi dòng là data: <json chunk> theo sau là một dòng trống.
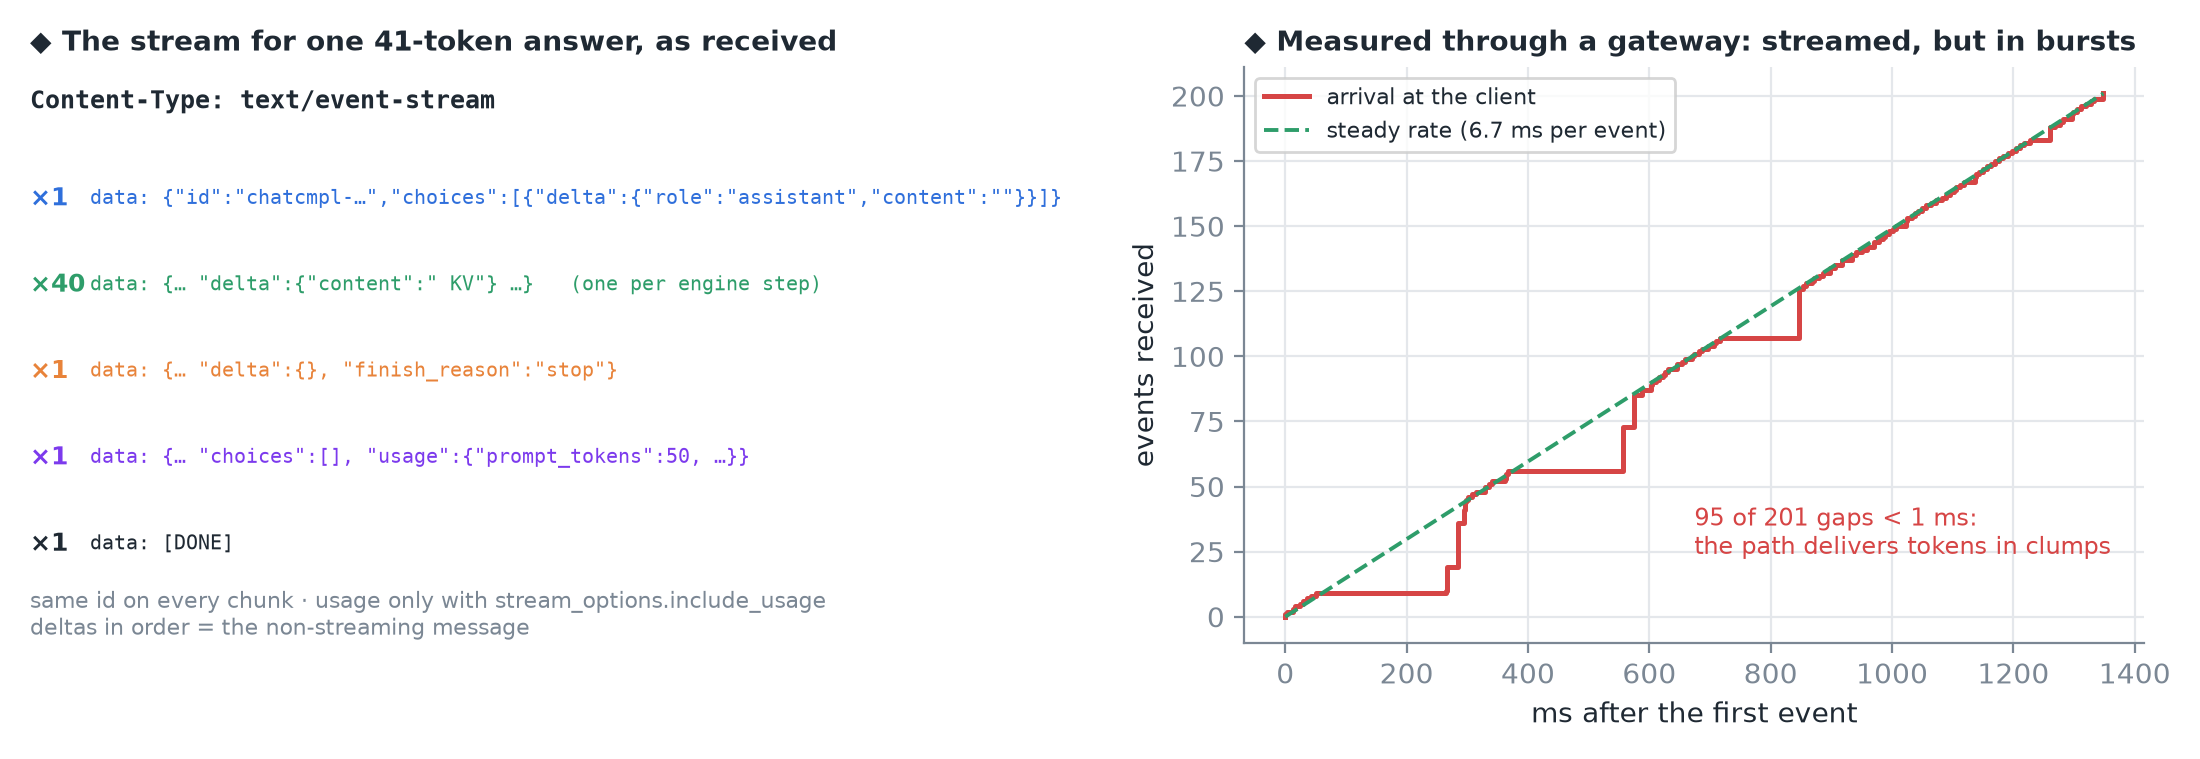 Trái: các event của một câu trả lời khi nhận được (◆ từ server của tôi). Phải: ◆ qua một gateway, 200 token đến thành từng cục (khoảng một nửa số khoảng cách dưới 1 ms) dù server sinh với nhịp đều.
- Chunk đầu tiên mang role,
assistant, với nội dung rỗng. - Mỗi bước của engine cho ra một chunk có
delta.contentlà văn bản mới. Mọi chunk dùng chung một id. Delta rỗng từ chunked prefill bị bỏ qua, nên client chỉ thấy văn bản thật. - Chunk nội dung cuối mang
finish_reason. - Nếu bạn yêu cầu usage, thêm một chunk nữa đến với
choicesrỗng và object usage đã điền. - Cuối cùng là dòng nguyên văn
data: [DONE], và client đóng kết nối.
Ghép các delta lại theo thứ tự là được đúng message mà lời gọi không streaming lẽ ra đã gửi.
6. Tính usage
Usage là cách bạn bị tính tiền và cách bạn nhận ra có cache.
prompt_tokensđược đếm sau template: nó gồm system prompt và mọi control token, không chỉ những gì người dùng gõ.completion_tokenslà những gì model sinh ra.- vLLM thêm
prompt_tokens_details.cached_tokens: bao nhiêu token prompt được lấy từ prefix cache thay vì tính lại. - Khi streaming, bạn chỉ nhận usage nếu yêu cầu:
stream_options: {"include_usage": true}. Đặc tả OpenAI nói chunk usage được stream ngay trước[DONE], với mảngchoicesrỗng.
 ◆ Trên server của tôi
cached_tokens trả về null: vLLM chỉ điền prompt_tokens_details khi khởi động với --enable-prompt-tokens-details (mặc định tắt). Không có include_usage, stream kết thúc mà không có con số nào.
7. Tương thích không có nghĩa là giống hệt
Các engine thêm những núm mà API OpenAI chưa từng có. Từ request schema của vLLM:
| Phần mở rộng của vLLM | Tác dụng |
|---|---|
top_k, min_p, repetition_penalty | Sampling ngoài bộ của OpenAI |
priority | Số thấp hơn chạy sớm hơn, nếu server dùng lập lịch theo độ ưu tiên |
structured_outputs | Ràng buộc đầu ra: JSON schema, regex, grammar, hoặc một tập lựa chọn cố định |
chat_template_kwargs | Công tắc của template (ví dụ bật/tắt thinking) |
continue_final_message | Điền sẵn phần đầu câu trả lời |
Client gửi chúng qua extra_body, bên cạnh các trường chuẩn:
client.chat.completions.create(
    model="llama-8b", messages=messages, stream=True,
    extra_body={"top_k": 40, "priority": 1},
)
Server nào không biết chúng sẽ từ chối, nên phần mở rộng là chỗ duy nhất các engine khác nhau trên dây. Hai cờ của server định hình hợp đồng từ phía bên kia: --max-model-len giới hạn prompt cộng đầu ra, và --chat-template ghi đè template của chính model.
8. Ba lỗi, đều thấy được trên dây
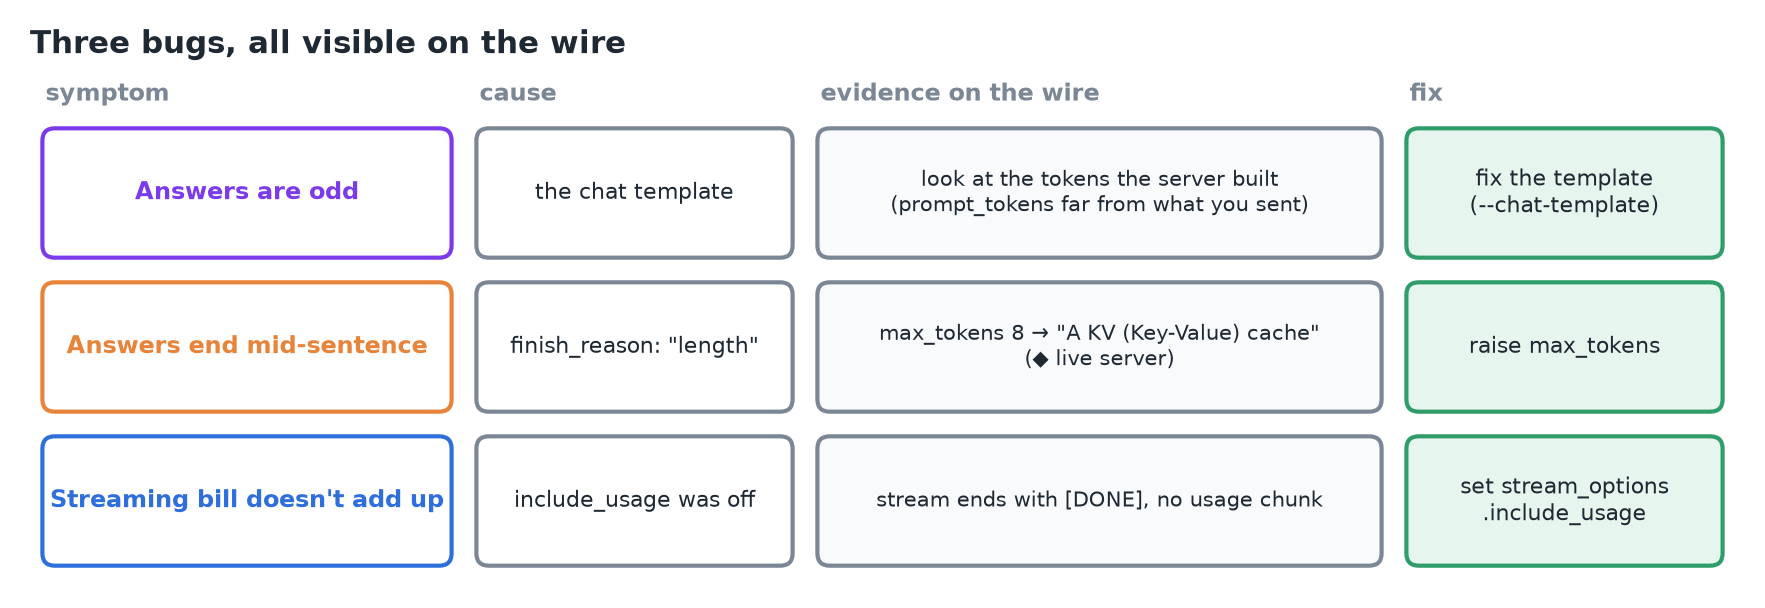 Câu trả lời kỳ lạ: kiểm tra các token server thực sự dựng ra. Dừng giữa câu:
finish_reason báo length. Hoá đơn streaming không khớp: include_usage đang tắt.
9. Tóm tắt