25 · Quét concurrency và request rate
Nguồn: fanout.sh / inference-eng / 05-02 · ~9 phút
Ghi chú
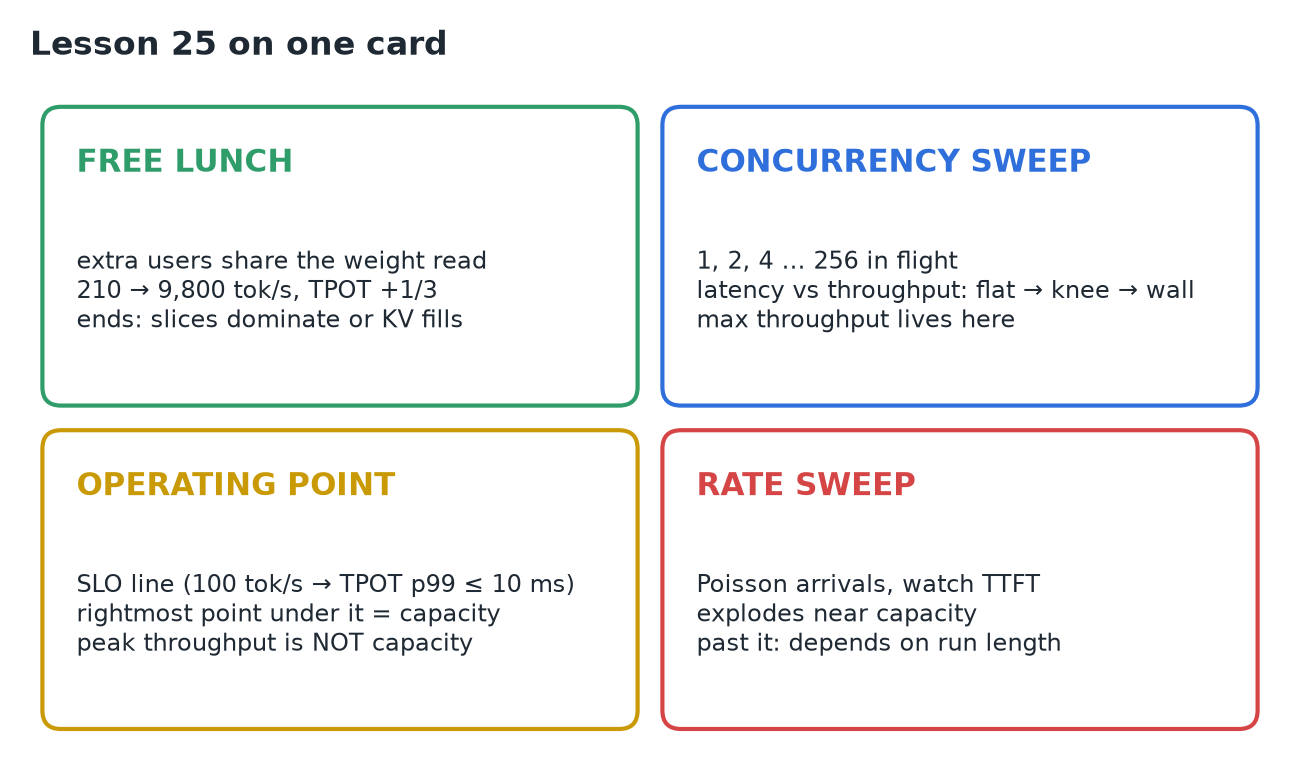
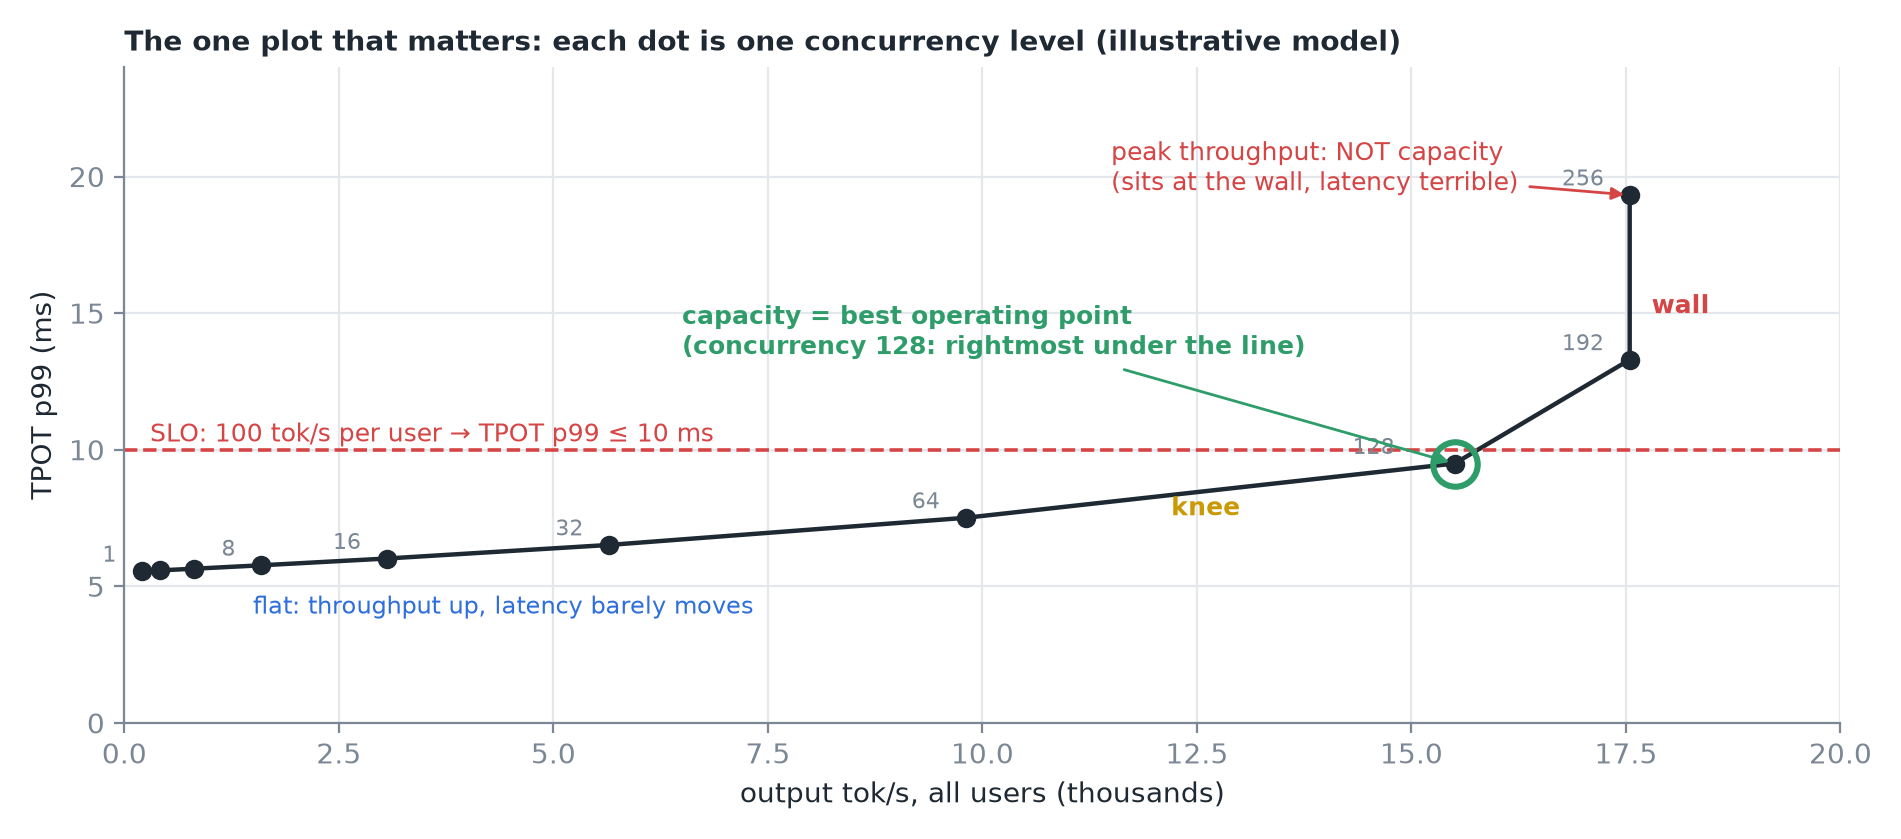
Lúc đầu batching gần như miễn phí: người dùng thêm vào đi nhờ một lần đọc trọng số vốn đằng nào cũng xảy ra (minh hoạ: 1 người dùng ở 4,8 ms/bước → 64 người dùng ở 6,5 ms cho throughput ~47 lần với TPOT chỉ tăng 1/3; Databricks đo được 14 lần trên một A100). Nó kết thúc khi chi phí riêng của từng người dùng chiếm ưu thế hoặc KV cache đầy. Một lần quét concurrency (1, 2, 4 … 256 request đang xử lý) vẽ ra đường cong latency-throughput: phẳng → điểm gãy → bức tường, và đường SLO của bạn chọn ra điểm vận hành (chấm ngoài cùng bên phải còn nằm dưới đường đó). Một lần quét request rate với request đến ngẫu nhiên cho thấy TTFT bùng nổ gần mức năng lực và, vượt qua đó, tăng mãi chừng nào bạn còn chạy. Throughput đỉnh không phải năng lực: năng lực là tải lớn nhất mà vẫn đạt mục tiêu.
1. Bữa trưa miễn phí
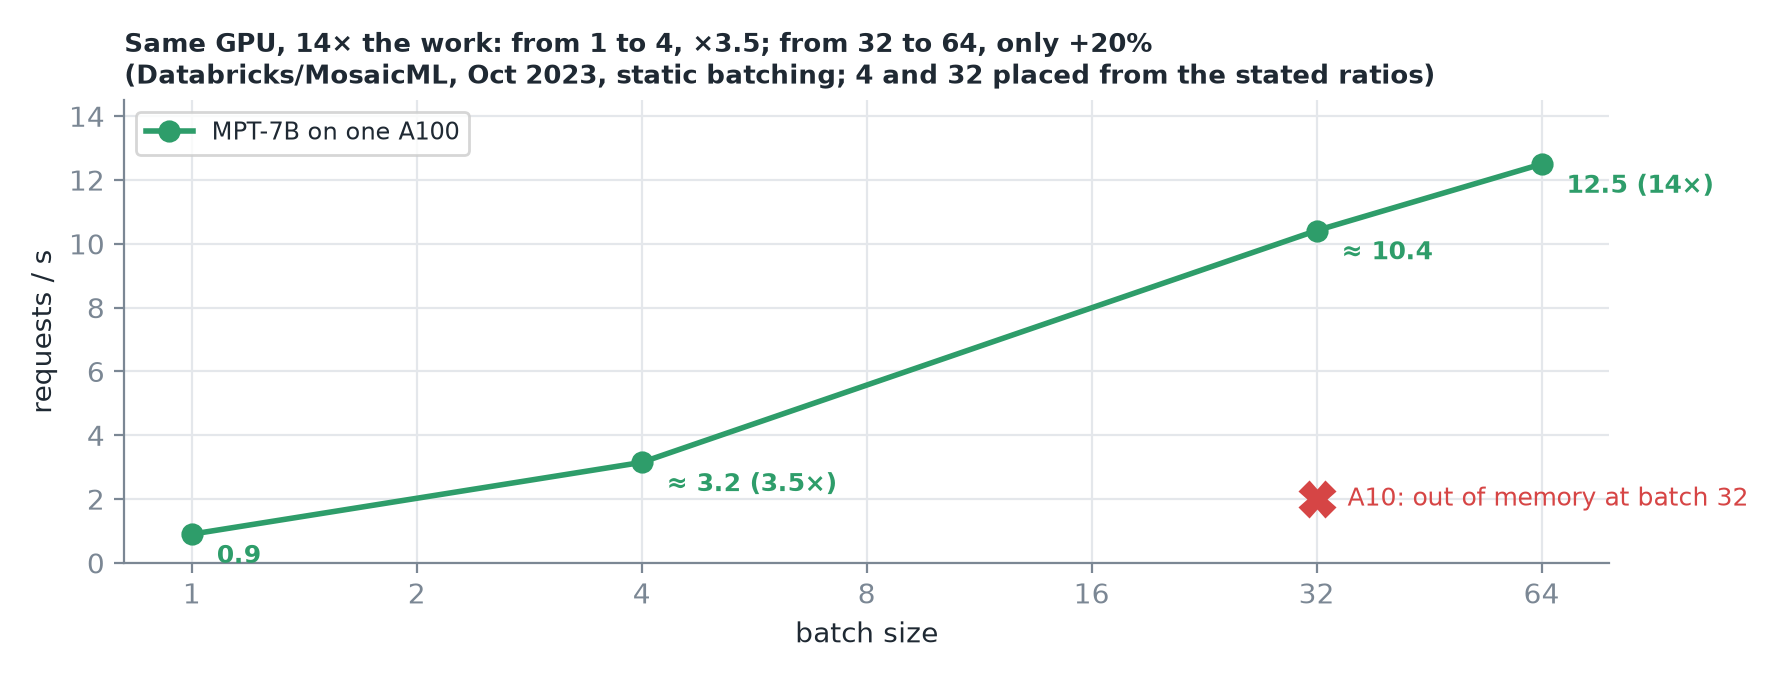 Năm 2023, MosaicML ở Databricks serve MPT-7B trên một A100: 0,9 req/s khi chạy từng cái một, 12,5 req/s ở batch 64. Trên A10 nhỏ hơn, đà tăng dừng ở batch 32: hết bộ nhớ.
Bắt đầu từ baseline một request: một người dùng trên H100, mỗi bước decode ≈ 4,8 ms, gần như toàn bộ là đọc trọng số. Thêm người dùng thứ hai: bước đó vẫn đọc trọng số một lần, và lần đọc đó giờ làm ra hai token. Người dùng thêm vào chỉ cộng thêm phần key và value riêng phải đọc, cộng một chút phép tính.
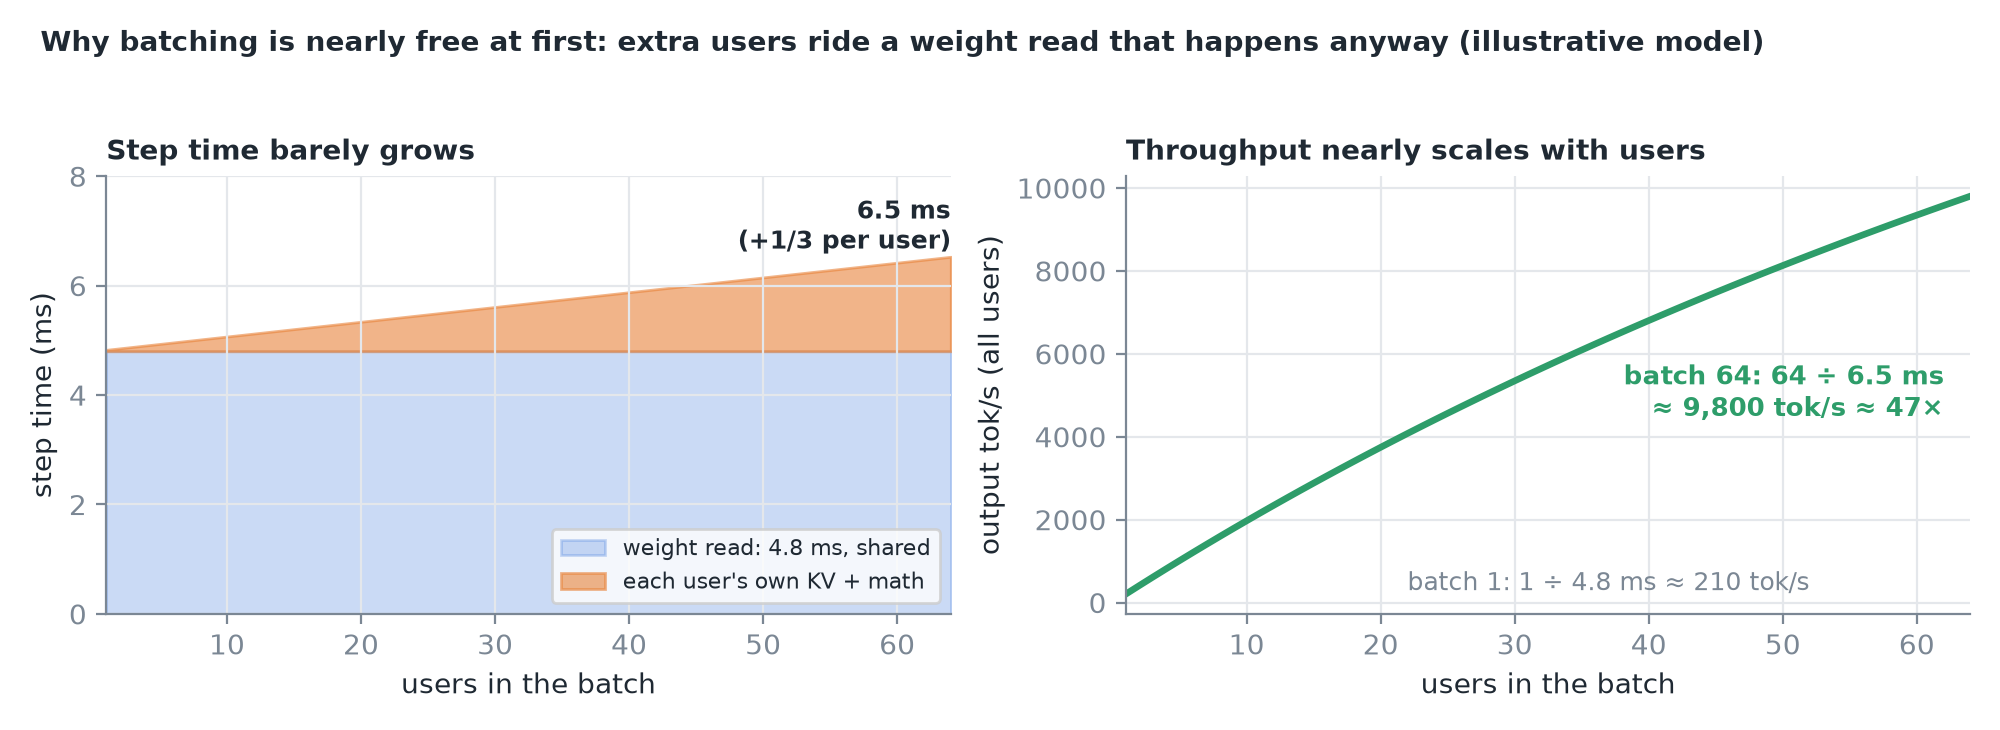 Mô hình minh hoạ: 4,8 ms cộng một lát nhỏ cho mỗi người dùng. Ở 64 người dùng, một bước mất ~6,5 ms: TPOT của mỗi người tăng một phần ba, nhưng GPU làm ra 64 token mỗi bước thay vì một.
Nó kết thúc theo hai cách: các lát riêng cộng dồn cho tới khi chiếm phần lớn bước, hoặc KV cache lấp đầy bộ nhớ GPU và người dùng mới phải chờ.
2. Lần quét 1: concurrency cố định
Giữ đúng N request đang xử lý; khi một cái xong thì cái tiếp theo bắt đầu. Chạy N = 1, 2, 4, 8 … nhân đôi lên tới 256 hoặc tới khi có gì đó vỡ. Ở mỗi mức ghi lại tổng throughput đầu ra và trung vị cùng P99 của TPOT và TTFT.
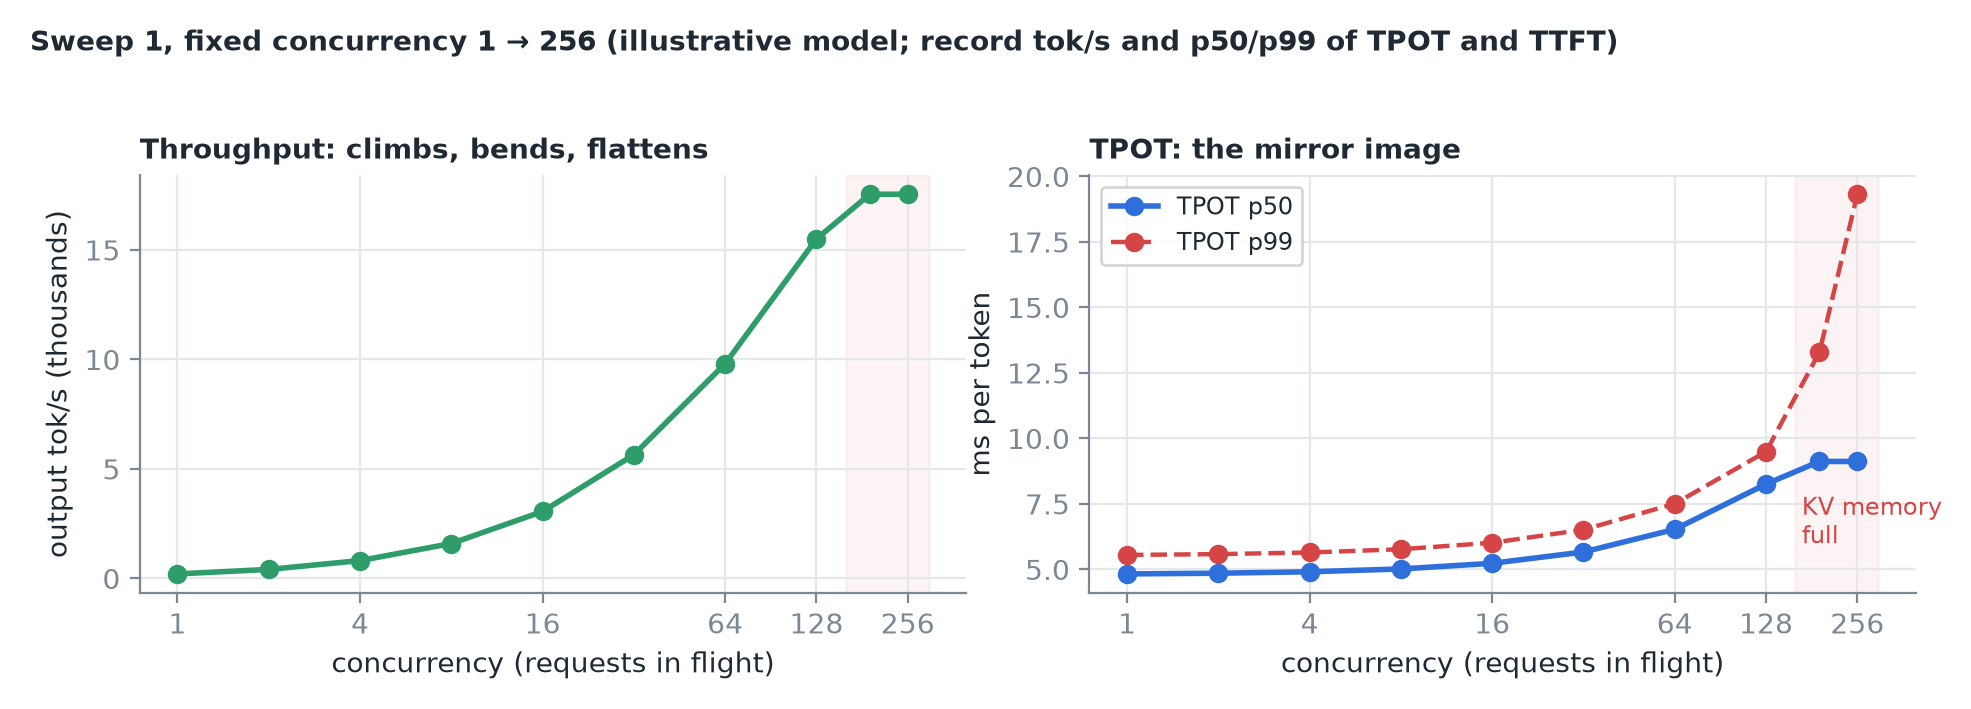 Throughput leo dốc, cong, rồi đi ngang; TPOT là hình ảnh phản chiếu. Databricks thấy cùng hình dạng đó: 1 → 4 người dùng cho throughput gấp 3,5 lần, 32 → 64 chỉ thêm khoảng 20%.
3. Biểu đồ duy nhất quan trọng
Đặt throughput lên trục x và TPOT lên trục y, mỗi mức concurrency một chấm, và đọc từ trái sang phải.
| Vùng | Điều gì xảy ra |
|---|---|
| Phẳng | Throughput tăng nhiều, latency gần như không nhúc nhích. Bạn gần như luôn nên đi ít nhất tới đây |
| Điểm gãy | Mỗi người dùng thêm vẫn tăng throughput, nhưng làm mọi người khác chậm đi rõ rệt |
| Bức tường | Throughput ngừng tăng; latency tiếp tục leo khi request chờ bộ nhớ hoặc chỗ trống |
Quan trọng
Mục tiêu latency của bạn chọn ra vị trí. Nếu mọi người dùng phải thấy ≥ 100 token/s, đó là TPOT ≤ 10 ms ở P99: kẻ đường đó, và điểm vận hành tốt nhất là chấm ngoài cùng bên phải vẫn còn nằm dưới nó.
4. Lần quét 2: request rate cố định
Quét concurrency chỉ gửi request mới khi request cũ xong, nên nó chậm lại khi server chậm lại. Người dùng thật đến bất cứ lúc nào họ muốn. Vì vậy lần quét thứ hai cố định tốc độ đến (đến ngẫu nhiên với trung bình, giả sử, 10/s) rồi tăng dần, theo dõi TTFT.
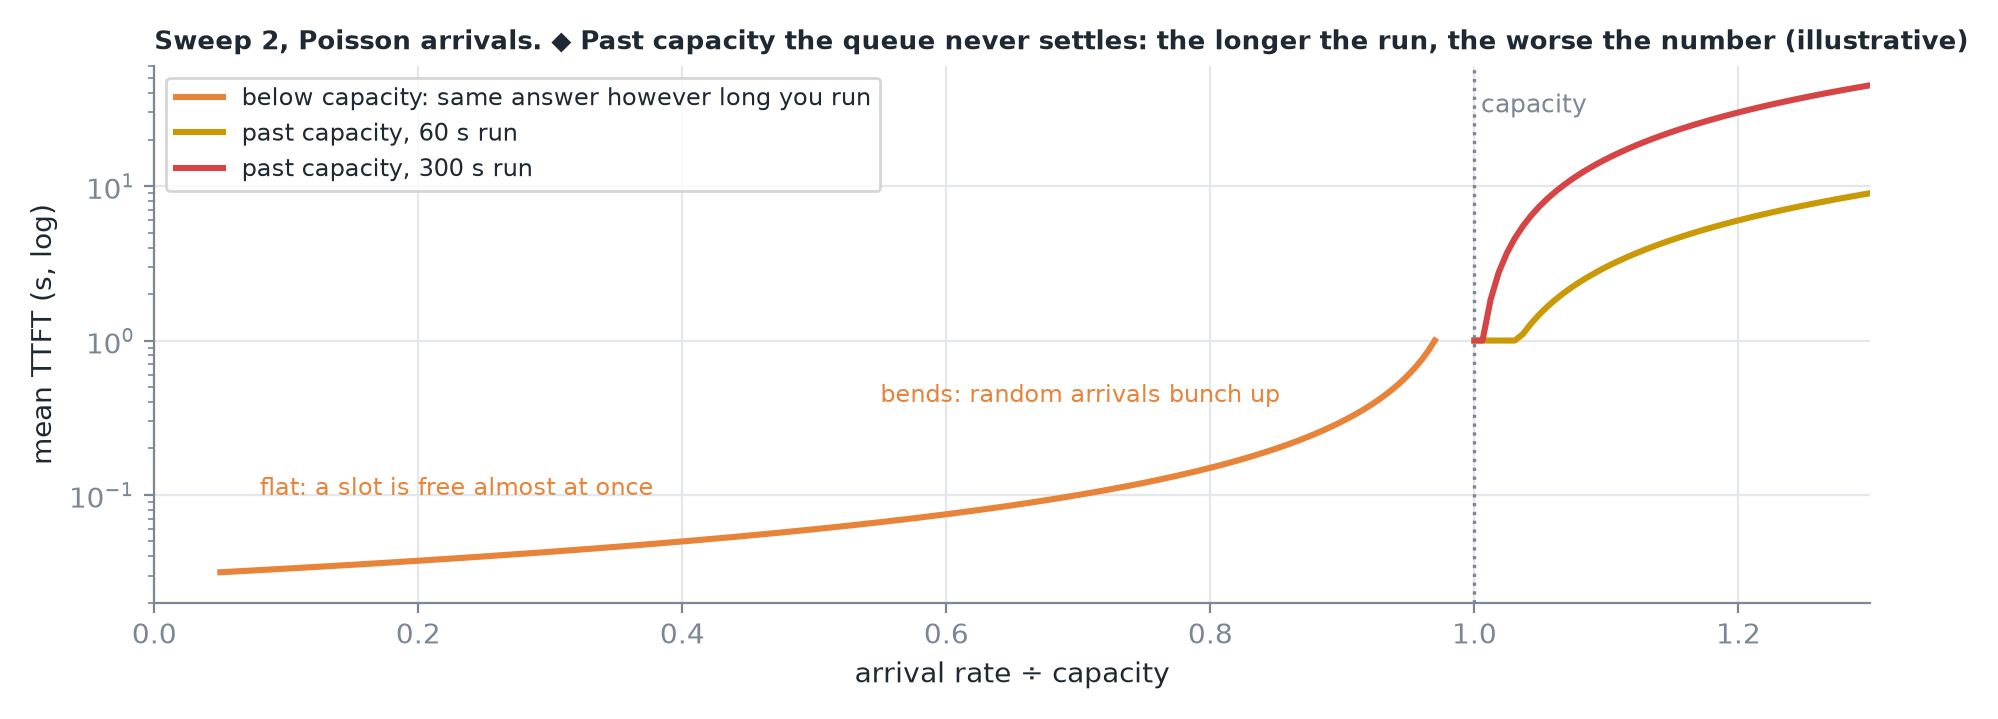 Ở rate thấp, TTFT phẳng: gần như lập tức có chỗ trống. Gần mức năng lực nó cong gắt khi các request đến ngẫu nhiên dồn cục. Vượt quá năng lực, hàng đợi tăng không giới hạn.
Mẹo
Nếu kết quả của bạn phụ thuộc vào thời gian chạy benchmark, bạn đã vượt quá năng lực.
5. Chạy cả hai với vLLM
vllm bench serve \
  --max-concurrency 32 \
  --request-rate 10 --burstiness 1 \
  --dataset-name random --random-input-len 512 \
  --random-output-len 256 --ignore-eos \
  --percentile-metrics ttft,tpot,e2el \
  --metric-percentiles 50,90,99 \
  --goodput ttft:500 tpot:10
--max-concurrency Ncho lần quét 1;--request-ratevới--burstiness 1(kiểu Poisson) cho lần quét 2.- Shape cố định: prompt ngẫu nhiên 512 token, 256 token đầu ra, bỏ qua EOS.
--goodputđếm các request đạt mục tiêu. vllm bench sweepchạy cả một lưới; GuideLLM có chế độ sweep tự tìm ra khoảng cần quét.
Thận trọng
Nếu bạn không đặt request rate thì nó là vô hạn: mọi request được gửi ở thời điểm 0. Đó là một đợt dồn, không phải một tốc độ đều.
6. Những cách lần quét âm thầm hỏng
| Cạm bẫy | Hậu quả |
|---|---|
| Quá ít request | Ở rate cao, lần chạy ngắn không bao giờ đạt trạng thái ổn định: bạn đo giai đoạn khởi động |
| Client yếu | Bên gửi không theo kịp: bạn đang benchmark client. So rate đạt được với rate yêu cầu |
| Prompt không thực tế | Prompt ngẫu nhiên không bao giờ chung prefix, nên prefix caching không bao giờ có ích; chat thật thì thường có |
| Trung bình | Trung vị trông ổn trong khi P99 đã vượt quá mục tiêu |
Thận trọng
Throughput cao nhất trên đường cong không phải năng lực của bạn: nó nằm ở bức tường, nơi latency tệ hại. Năng lực là tải cao nhất vẫn đạt mục tiêu latency (goodput), luôn nằm bên trái đỉnh.
7. Tóm tắt