12 · MLP, RMSNorm và kết nối residual
Nguồn: fanout.sh / inference-eng / 02-03 · ~7 phút
Ghi chú
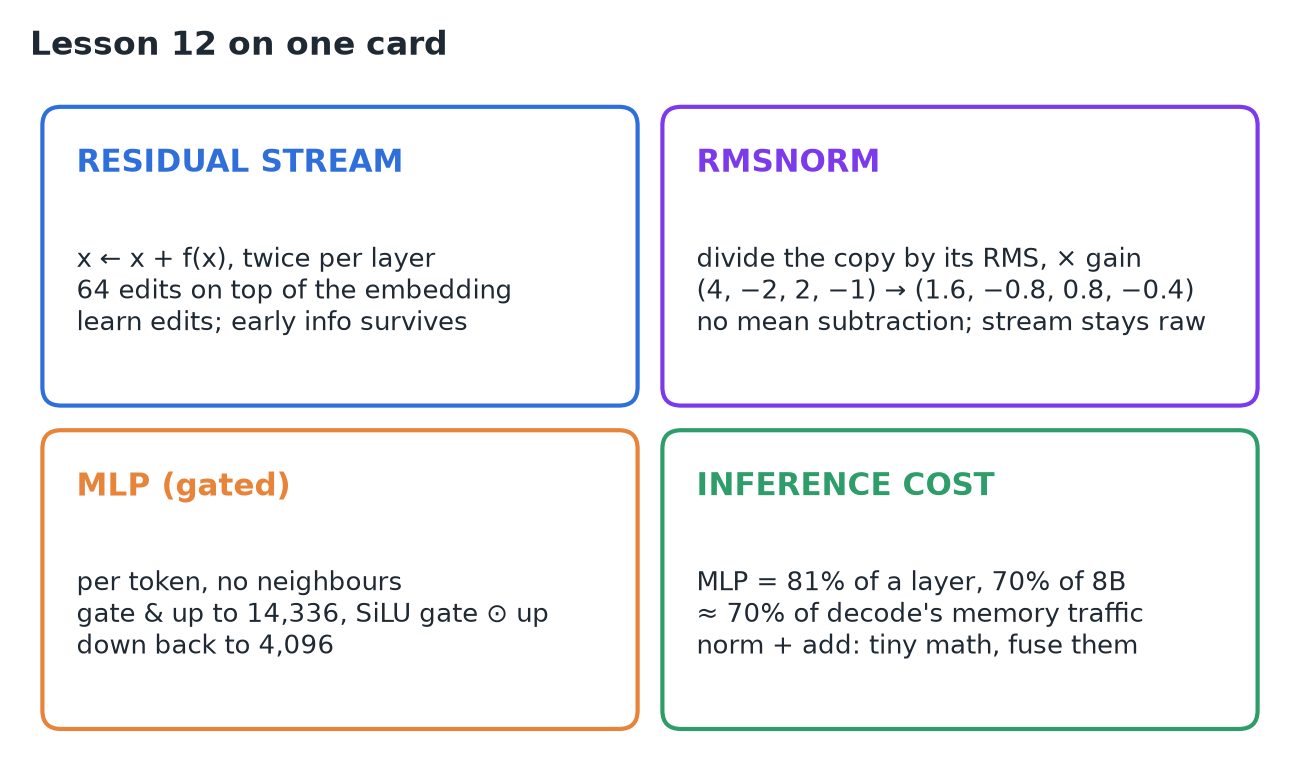
Ngoài attention, mỗi layer có một bước chuẩn hoá, một MLP và hai phép cộng. Các phép cộng tạo thành residual stream: mỗi sublayer đọc một bản sao, tính một chỉnh sửa rồi cộng nó trở lại (x ← x + f(x)). RMSNorm đưa bản sao đó về một độ lớn dự đoán được trước mỗi sublayer. MLP làm việc trên từng token riêng lẻ: mở rộng 4.096 → 14.336 hai lần (gate và up), lọc bằng SiLU, rồi thu nhỏ lại. Với inference, MLP là nơi chứa trọng số: 81% một layer, ~70% của model 8B, nên ~70% lưu lượng bộ nhớ ở mỗi bước decode. Norm và phép cộng chỉ là phép tính nhỏ, nên engine gộp (fuse) chúng lại.
1. Residual stream: chỉnh sửa, không xây lại
Hãy hình dung hidden state của mỗi token như một vector chạy trên đường cao tốc qua cả 32 layer. Một layer không thay thế vector đó: nó đọc một bản sao, tính một thay đổi, và cộng thay đổi đó trở lại.
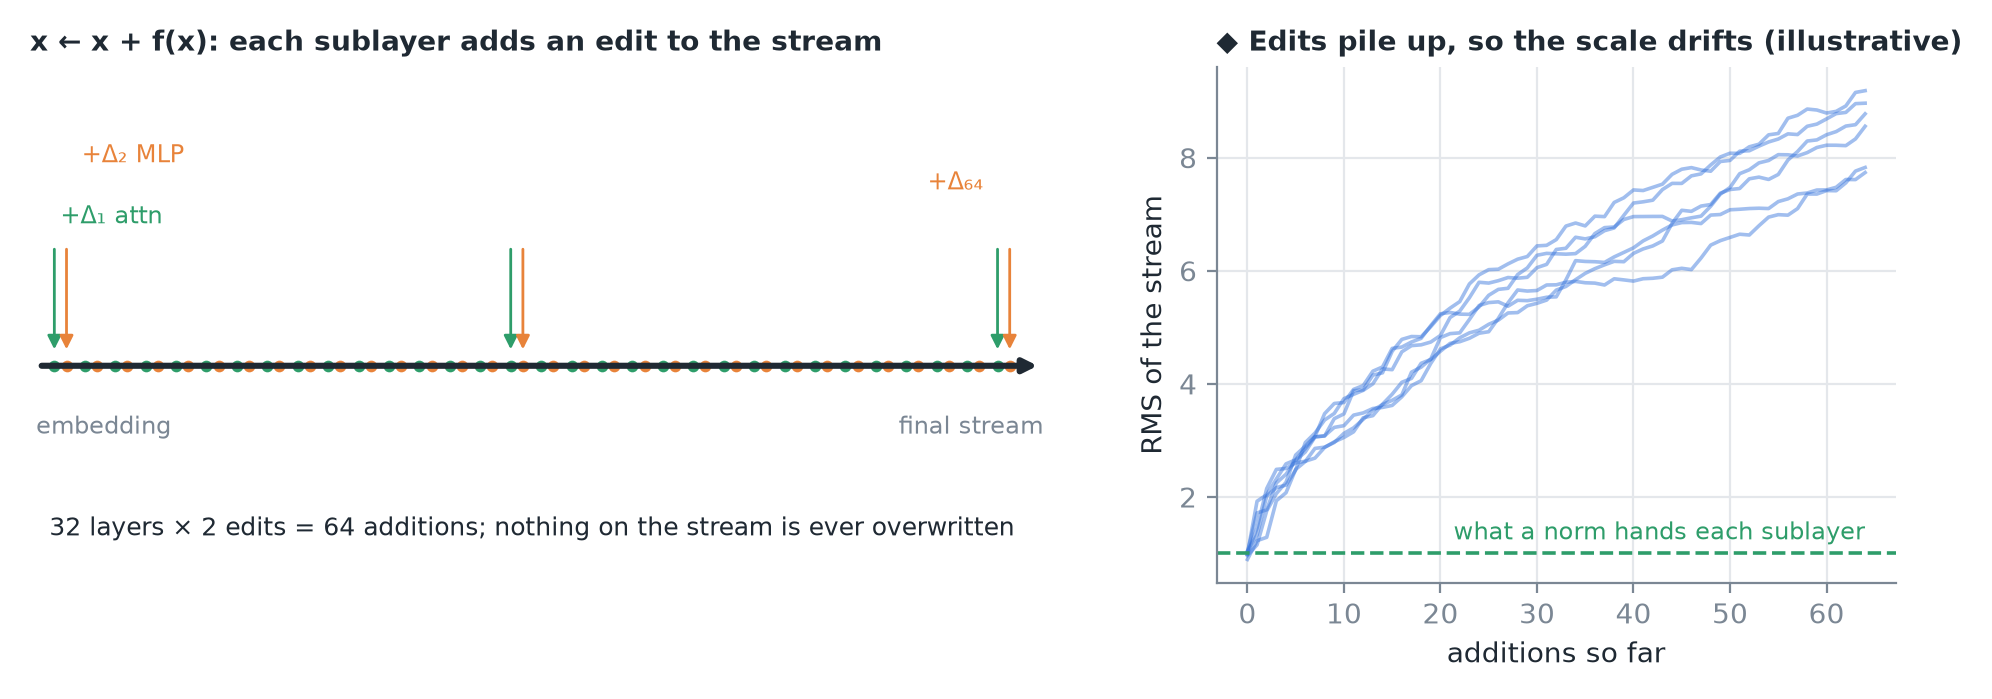 Phải (◆): cộng hết chỉnh sửa này tới chỉnh sửa khác làm độ lớn của stream trôi dạt, nên mỗi sublayer nhận một bản sao đã chuẩn hoá.
- Mỗi layer cộng hai lần (attention, rồi MLP), nên stream cuối cùng = embedding + 64 chỉnh sửa.
- Một layer chỉ phải học một chỉnh sửa hữu ích, không phải xây lại toàn bộ biểu diễn.
- Thông tin từ các layer đầu sống sót tới cuối, vì không có gì ghi đè lên nó.
2. RMSNorm: đưa bản sao về đúng tỷ lệ
Sublayer làm việc tốt nhất với đầu vào có độ lớn dự đoán được, nhưng các số trong stream cứ trôi dạt. Vì thế trước attention và một lần nữa trước MLP, bản sao đi vào được chuẩn hoá. Llama dùng RMSNorm (root mean square normalization).
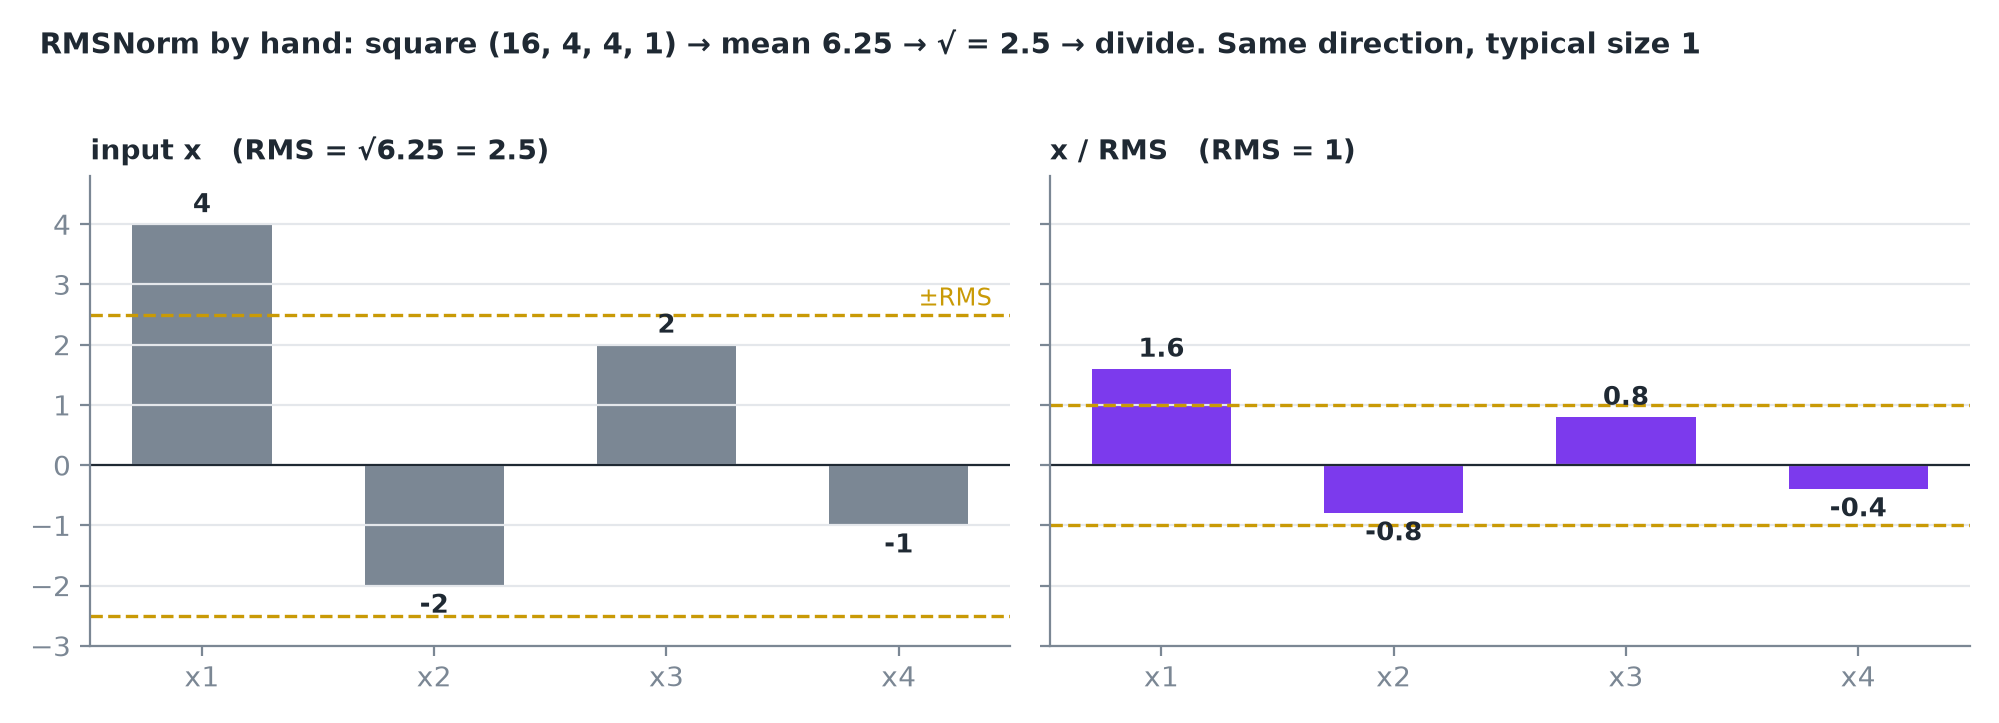 Sau đó một hệ số gain học được, mỗi chiều một số, phóng to hoặc thu nhỏ từng phần tử.
| LayerNorm (transformer đời cũ) | RMSNorm (Llama) | |
|---|---|---|
| Công thức | γ · (x − μ) / σ + β | γ · x / RMS(x) |
| Có trừ trung bình không? | Có | Không: bỏ qua mà vẫn tốt như vậy |
| Có độ dịch β học được không? | Có | Không |
Quan trọng
Chỉ bản sao được chuẩn hoá. Bản thân stream vẫn giữ giá trị thô.
3. MLP: lọc đặc trưng theo từng token
Attention chuyển thông tin giữa các token. MLP (feed-forward network) làm việc trên từng token hoàn toàn riêng lẻ và không bao giờ nhìn sang hàng xóm.
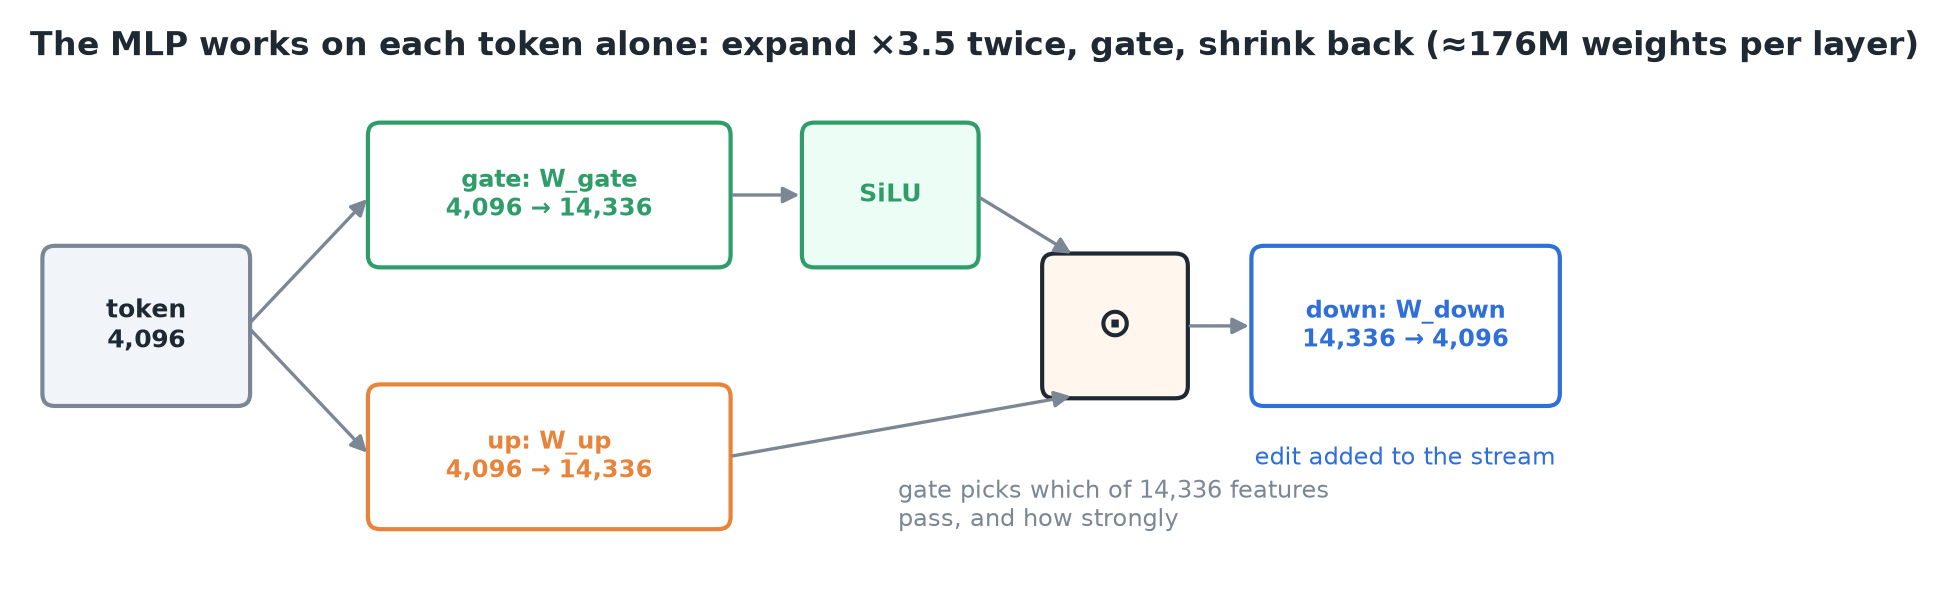 Llama 3 8B: hai phép chiếu 4.096 → 14.336 (gate, up), rồi down 14.336 → 4.096. Kết quả là chỉnh sửa được cộng vào stream.
Gate đi qua SiLU, một đường cong trơn: đầu vào dương lớn đi qua gần như nguyên vẹn, đầu vào âm bị ép về gần 0. Vector đã lọc sau đó nhân với vector up theo từng phần tử.
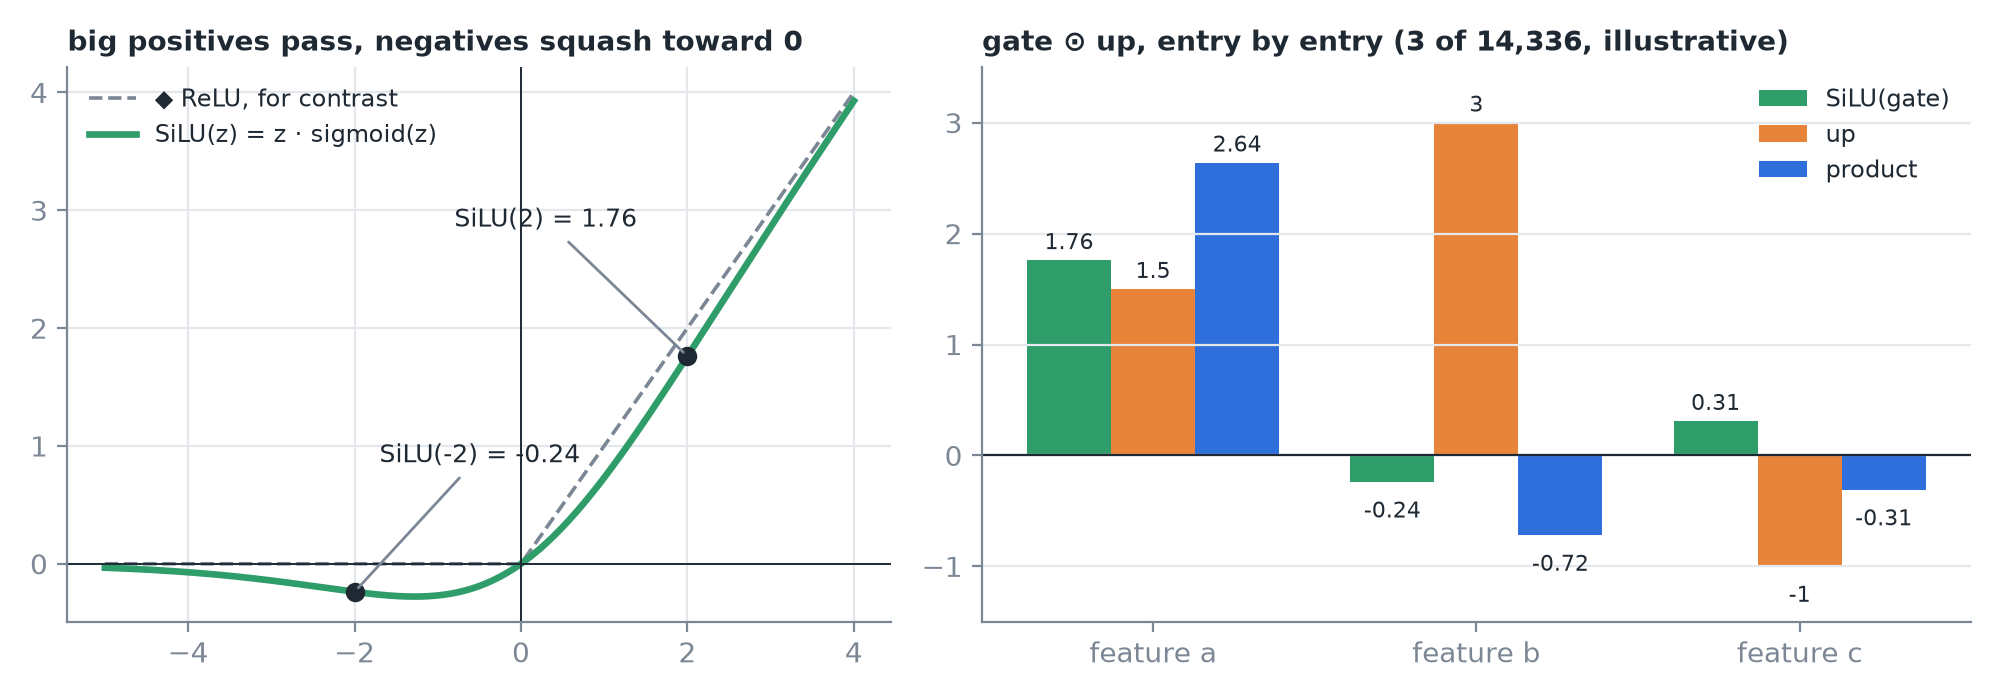 SiLU(gate) ⊙ up = (1,76; −0,24; 0,31) ⊙ (1,5; 3; −1) = (2,64; −0,72; −0,31).
Mẹo
Gate quyết định, theo từng token, đặc trưng nào trong 14.336 đặc trưng được đi qua và mạnh tới đâu. Các nhà nghiên cứu nhận thấy phần lớn những gì model biết (sự kiện, khuôn mẫu) được lưu trong các trọng số MLP này.
4. Trọng số nằm ở đâu (và lưu lượng bộ nhớ)
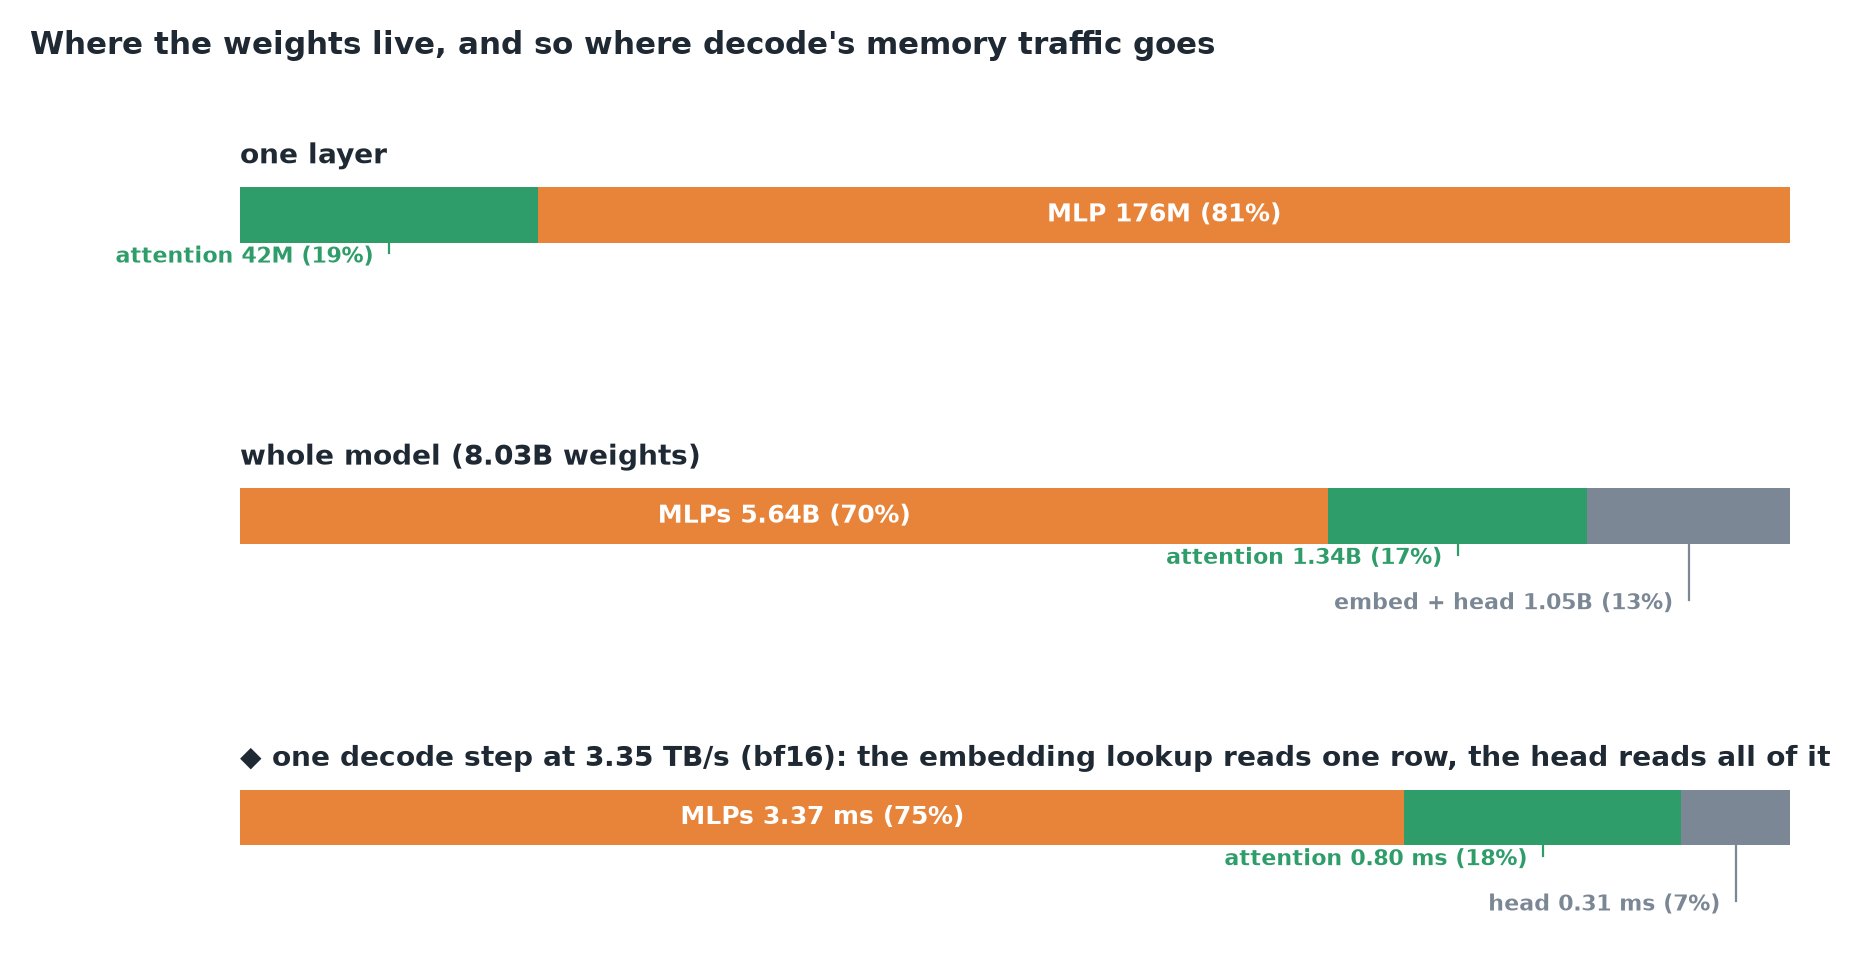 Mỗi layer: attention ≈ 42 triệu, MLP ≈ 176 triệu (81%). Toàn model: MLP giữ 5,64 tỷ trên 8,03 tỷ (70%).
Sinh một token nghĩa là đọc mọi trọng số từ bộ nhớ, nên khoảng 70% lưu lượng bộ nhớ của mỗi bước decode là MLP. ◆ Mỗi token, phép tra embedding chỉ đọc một hàng, nên phần byte thực sự đọc thuộc về MLP gần với 75% hơn. Dù thế nào, MLP là nơi đầu tiên cần nhìn khi thu nhỏ trọng số.
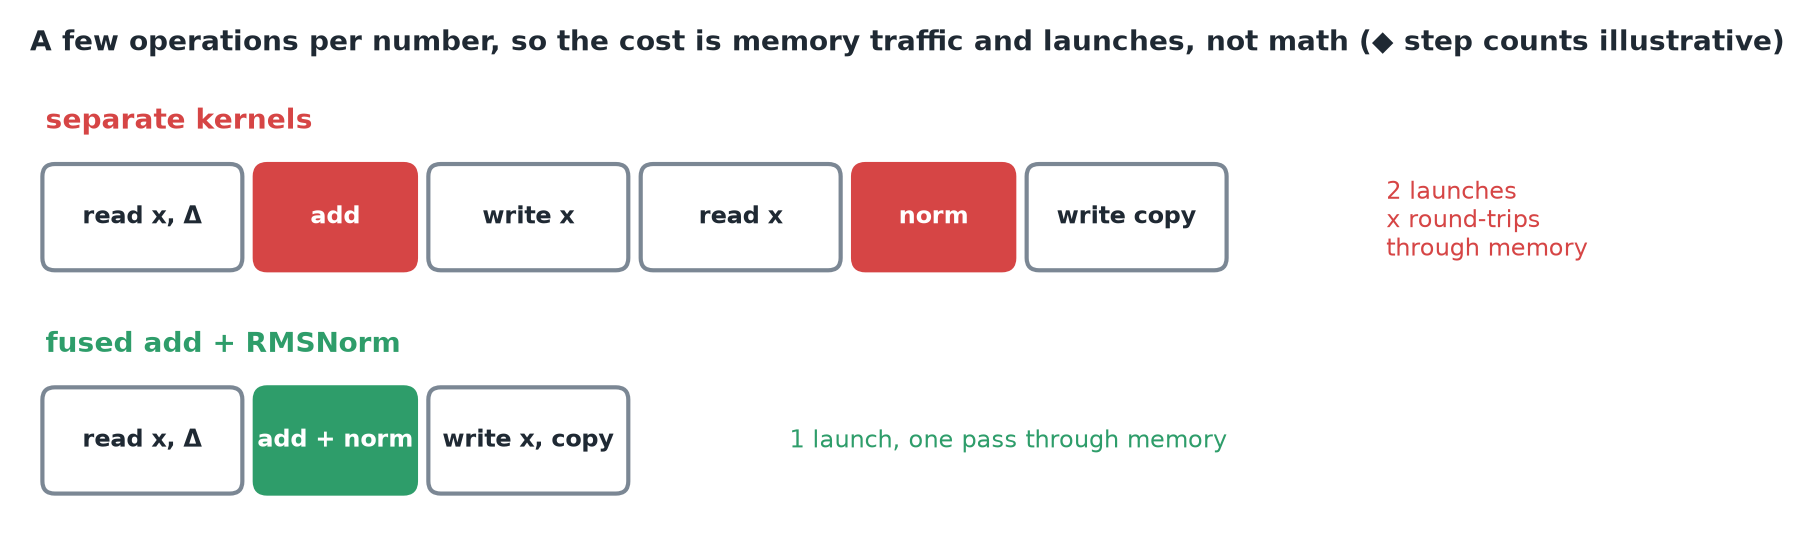
Norm và phép cộng chỉ làm vài phép tính trên mỗi số, nhưng mỗi cái vẫn phải đọc toàn bộ hidden state từ bộ nhớ rồi ghi lại. Vì vậy engine gộp chúng: một kernel làm cả phép cộng lẫn norm trong một lượt.
5. Một layer đầy đủ
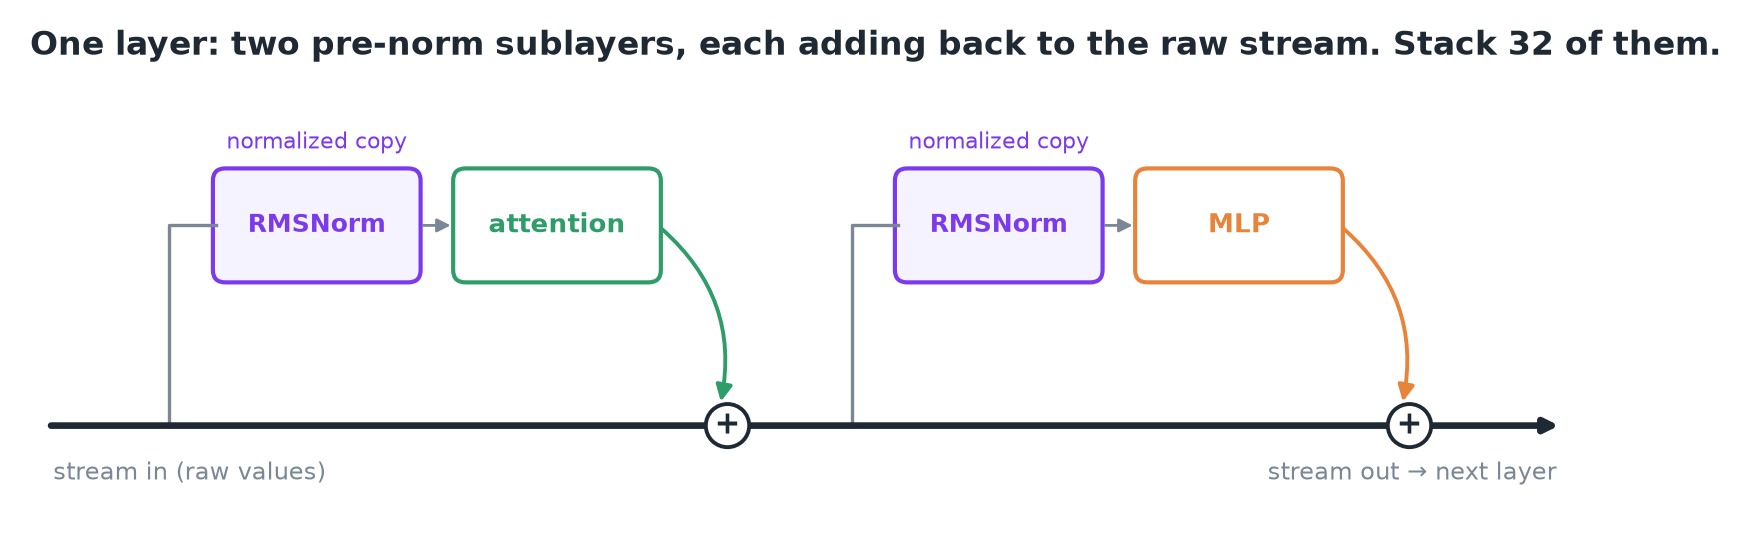 Bản sao đã chuẩn hoá → attention → cộng lại. Bản sao đã chuẩn hoá → MLP → cộng lại. Ba mươi hai layer như vậy làm nên thân model, và stream kết thúc với một vector giàu thông tin cho token cuối cùng.
6. Tóm tắt