34 · Continuous batching
Nguồn: fanout.sh / inference-eng / 07-03 · ~5,5 phút
Ghi chú
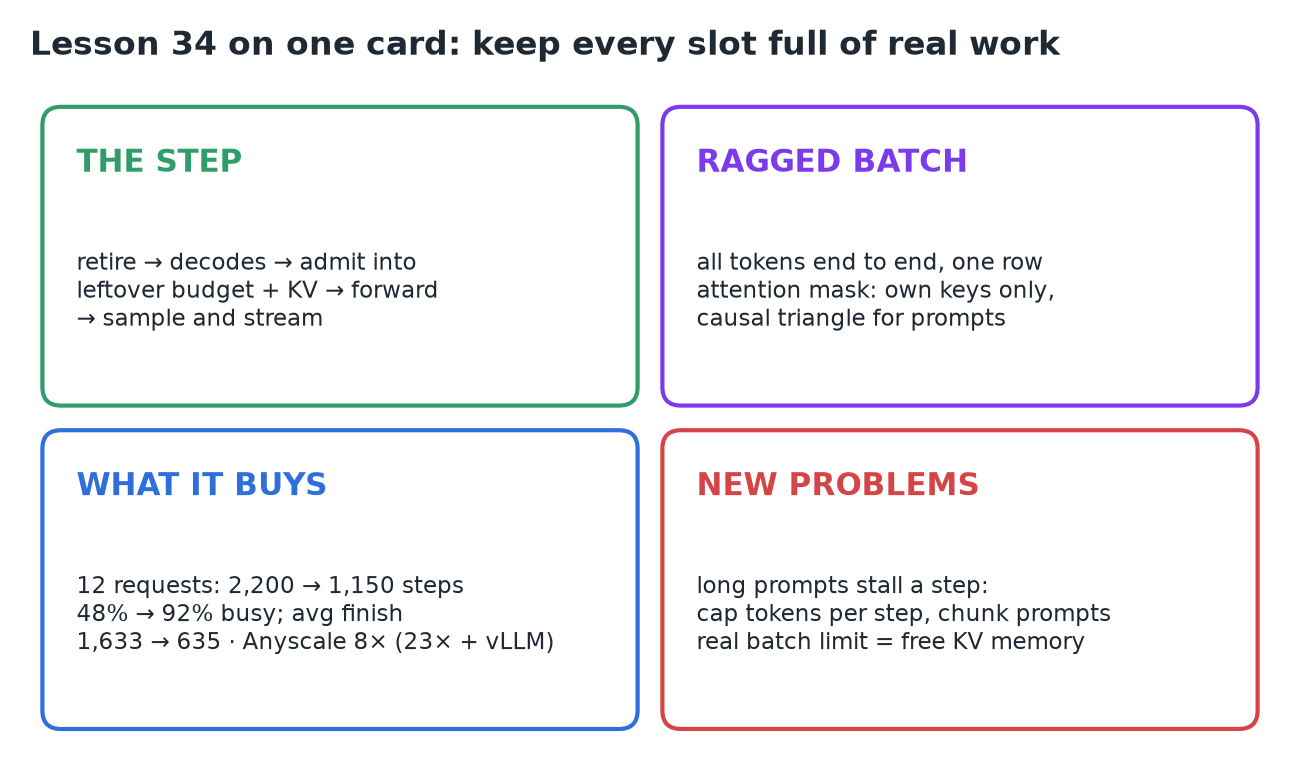
Continuous batching dùng lập lịch theo từng bước cho một mục tiêu: giữ mọi slot luôn đầy việc thật, mọi lúc. Nó là mặc định ở mọi nơi: vLLM, SGLang và TGI gọi là continuous batching, TensorRT-LLM gọi là in-flight batching. Mỗi bước cho nghỉ các request đã xong, lập lịch mọi decode đang chạy trước, nhận prompt mới vào phần ngân sách token và bộ nhớ KV còn lại, chạy một forward pass trên một batch lởm chởm (ragged) (không padding; attention mask giữ các request tách biệt), rồi lấy mẫu và stream. Với 12 request độ dài không đều, nó giảm một nửa tổng thời gian (2.200 → 1.150 bước) và trả câu trả lời sớm hơn ~2,6 lần; Anyscale đo được 8 lần so với batching ngây thơ, 23 lần khi có thêm quản lý bộ nhớ của vLLM. Kéo theo hai vấn đề mới: prompt dài làm khựng một bước, và bộ nhớ KV, chứ không phải số slot, mới là giới hạn thật của batch.
1. Công thức của một bước
Engine giữ hai danh sách: một hàng đợi waiting gồm các request chưa bắt đầu và một tập running đang sinh token.
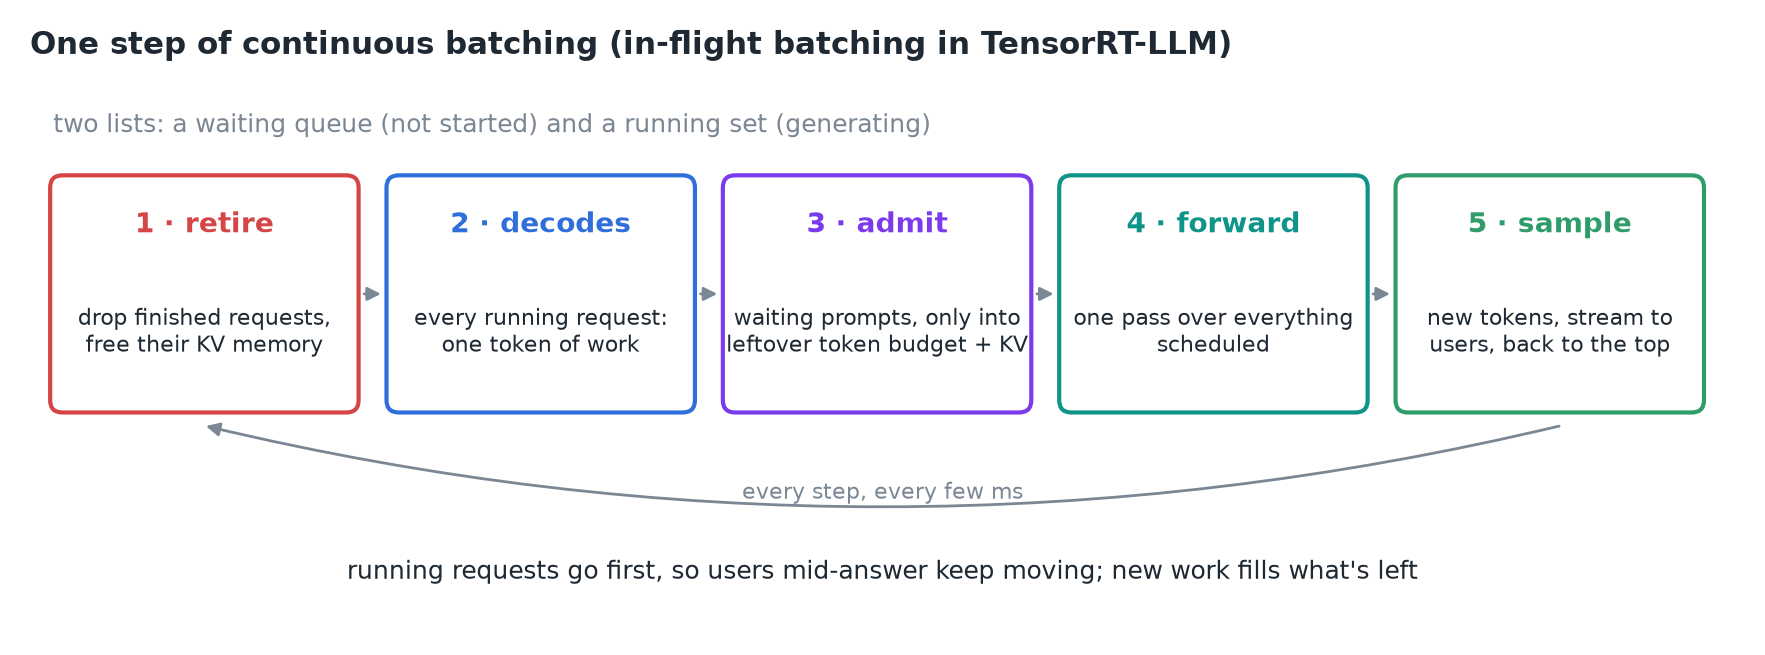 Cho nghỉ, lập lịch decode, nhận request mới, forward, lấy mẫu và stream; rồi quay lại đầu.
Quan trọng
Request đang chạy đi trước, để người dùng đang giữa câu trả lời tiếp tục nhận chữ; việc mới lấp vào phần còn lại.
2. GPU thực sự nhận được gì: một batch lởm chởm
Ba request đang decode (mỗi cái một token) và một prompt mới năm token đang vào. Thay vì một hình chữ nhật có padding, cả tám token nằm nối đuôi nhau trên một hàng.
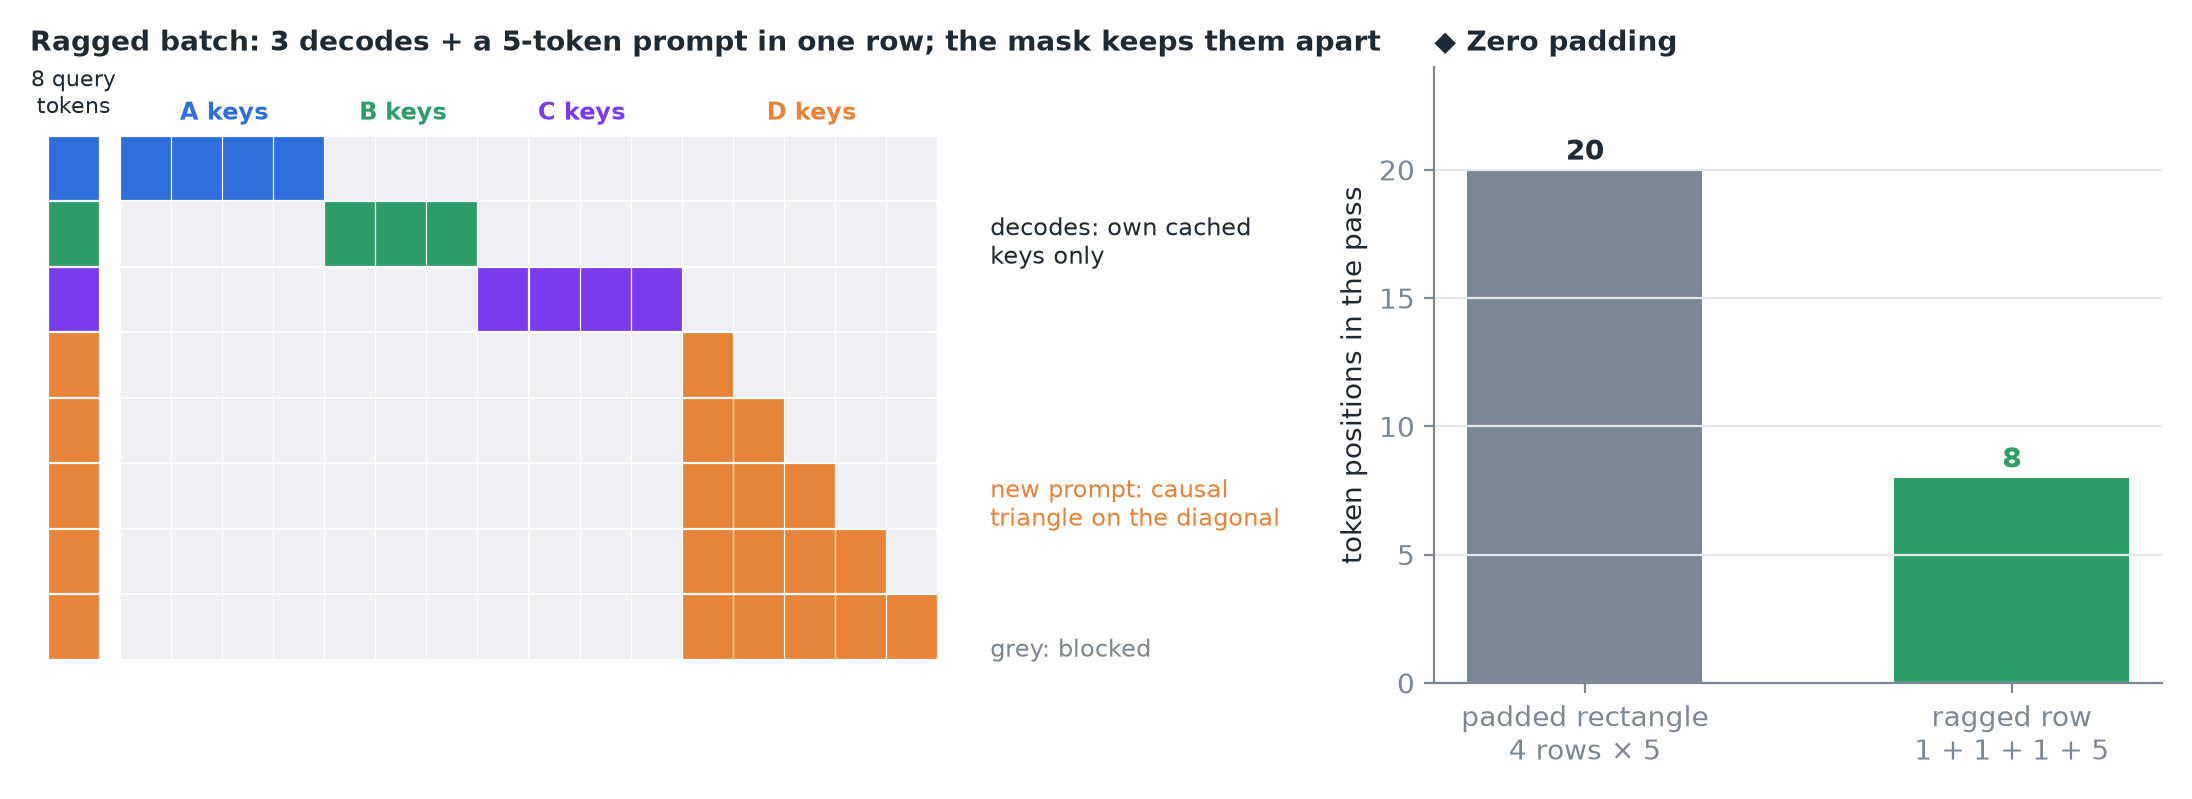 Thứ duy nhất giữ các request tách biệt là attention mask: mỗi token decode thấy các key đã cache của chính request nó; các token của prompt mới chỉ thấy các token trước đó của cùng prompt (một tam giác causal trên đường chéo); mọi thứ khác bị chặn.
Vì thế request độ dài bất kỳ, ở pha bất kỳ, đi chung một lượt với không chút padding nào.
3. Được gì
Mười hai request đang xếp hàng với độ dài đầu ra từ 100 tới 1.000 token, bốn slot, mỗi bước tốn thời gian như nhau (minh hoạ).
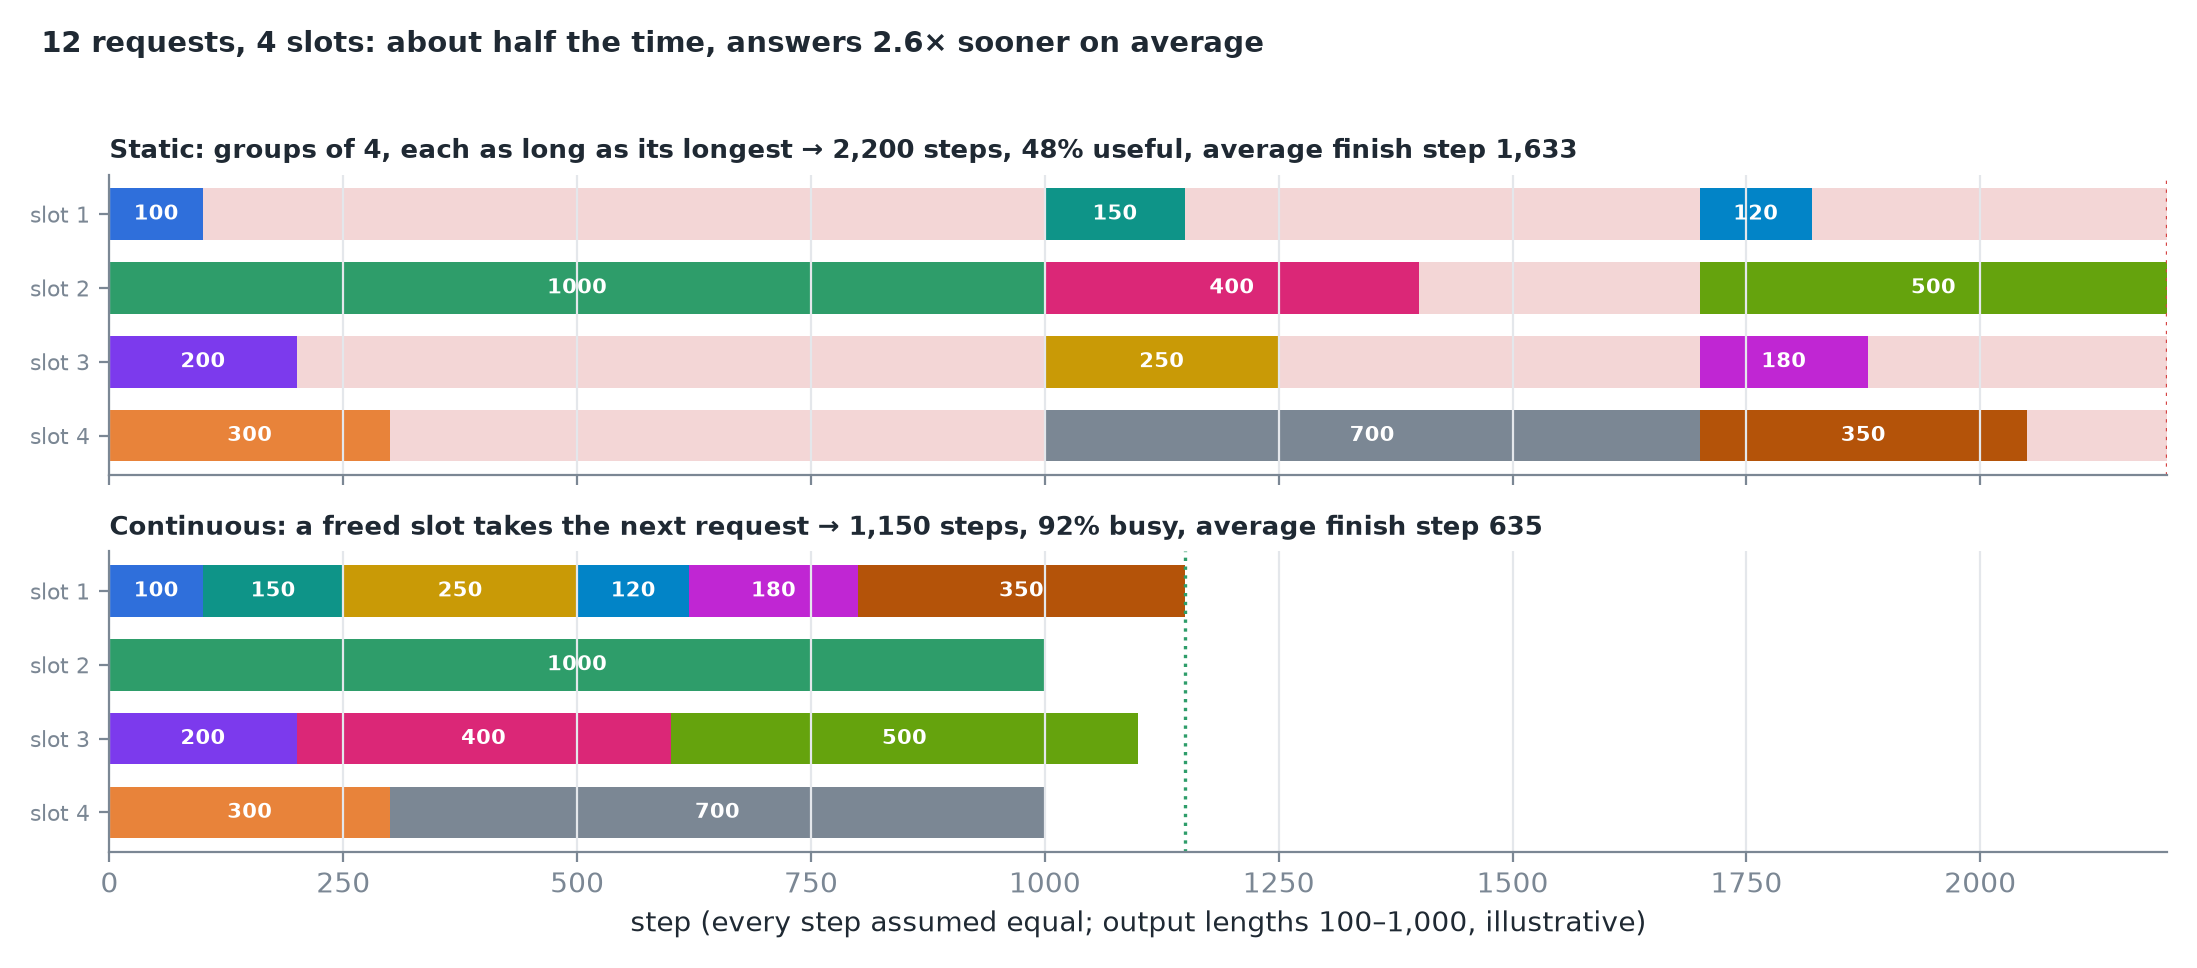 Batch tĩnh lấy bốn cái một lần, mỗi nhóm dài bằng thành viên dài nhất; continuous batching trao slot vừa trống cho request kế tiếp trong hàng đợi.
| Tĩnh | Continuous | |
|---|---|---|
| Tổng số bước | 1.000 + 700 + 500 = 2.200 | 1.150 |
| Thời gian slot có ích | 4.250 ÷ (4 × 2.200) = 48% | 4.250 ÷ (4 × 1.150) = 92% |
| Thời điểm xong trung bình | 1.633 bước | 635 bước |
Cùng GPU, cùng model, cùng request: khoảng một nửa thời gian, và câu trả lời trung bình đến sớm hơn khoảng 2,5 lần (1.633 ÷ 635 ≈ 2,6).
Số đo thật cũng kể cùng câu chuyện: trên một model 13B, Anyscale thấy riêng continuous batching đã cho throughput khoảng 8 lần so với batching ngây thơ, và khoảng 23 lần khi có thêm quản lý bộ nhớ của vLLM.
4. Hai vấn đề mới
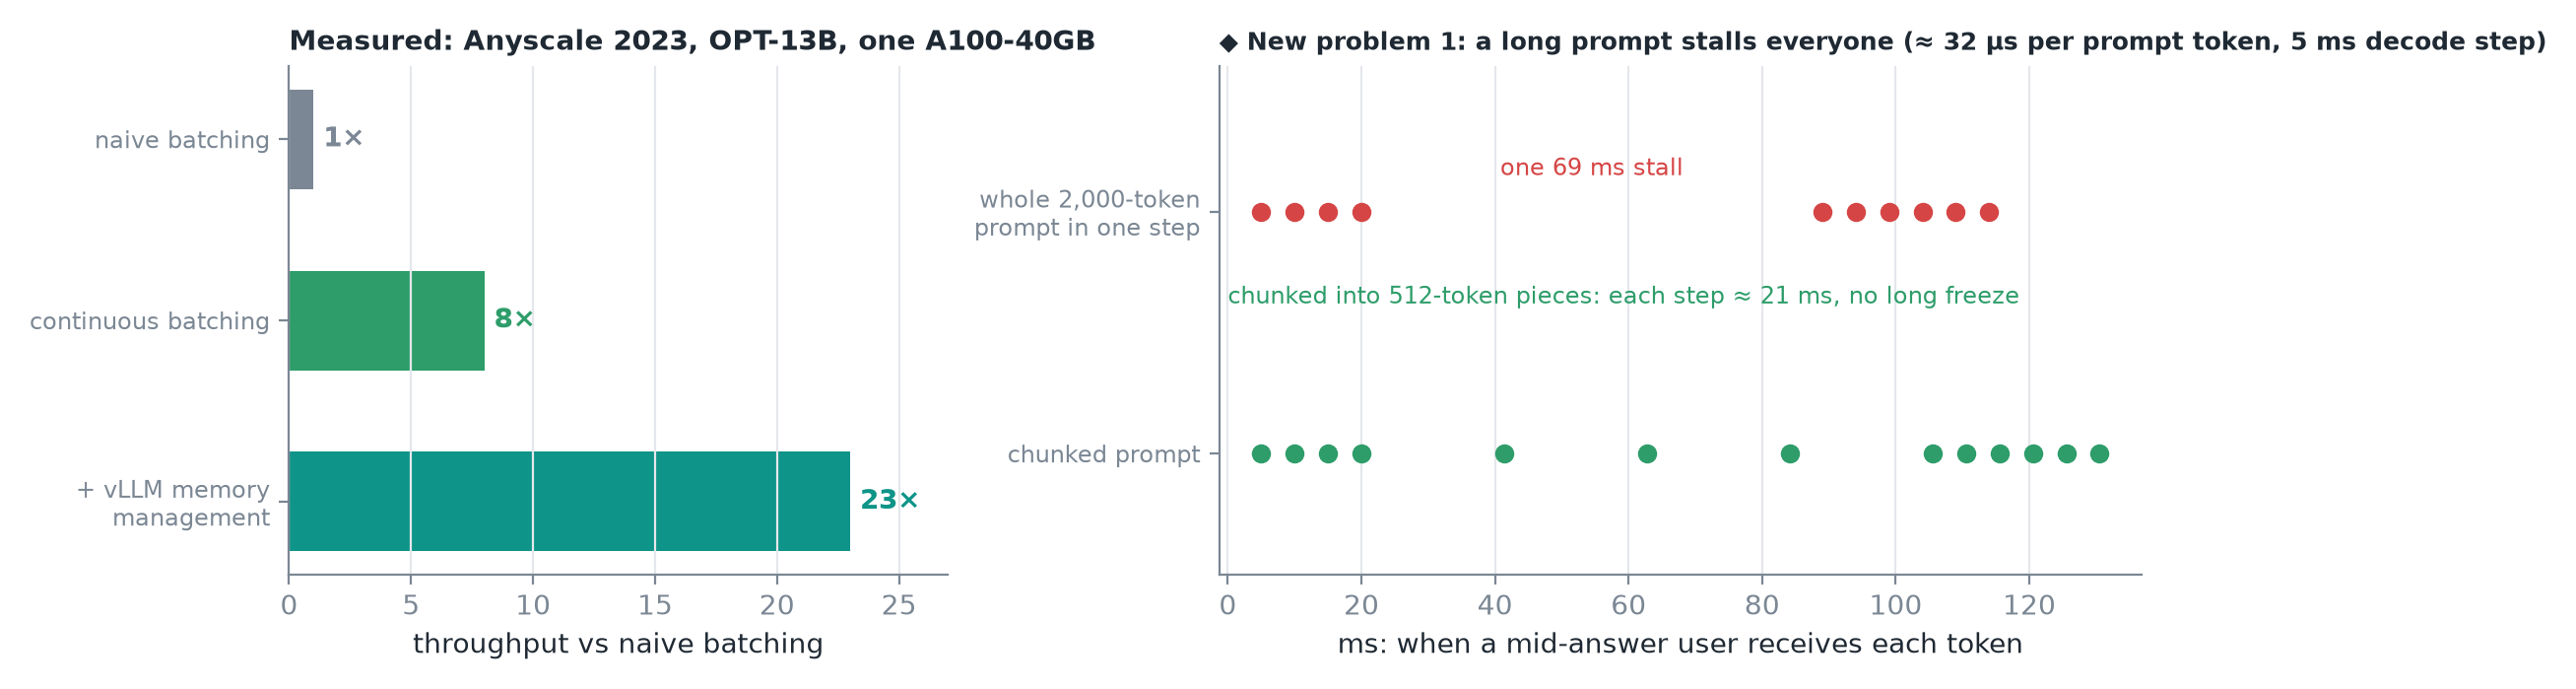 Trái: Anyscale 2023, OPT-13B trên một A100-40GB. Phải: ◆ thời gian minh hoạ cho một người dùng đang giữa câu trả lời khi một prompt 2.000 token vào, nguyên khối so với chia chunk.
- Prompt. Khi một request mới vào, cả prompt của nó chạy trong bước đó. Một prompt 2.000 token làm bước đó dài hơn nhiều so với bước decode bình thường, nên mọi người dùng đang giữa câu trả lời đều thấy một lần khựng. Đó là lý do engine giới hạn số token mỗi bước và cắt prompt dài thành chunk.
- Bộ nhớ. Mỗi request đang chạy giữ một KV cache ngày càng lớn, nên giới hạn thật của batch không phải số slot, mà là còn bao nhiêu bộ nhớ KV trống, và cách bộ nhớ đó được bố trí quyết định bao nhiêu request vừa.
5. Tóm tắt