22 · P50, P95, P99 và phương sai
Nguồn: fanout.sh / inference-eng / 04-05 · ~6 phút
Ghi chú
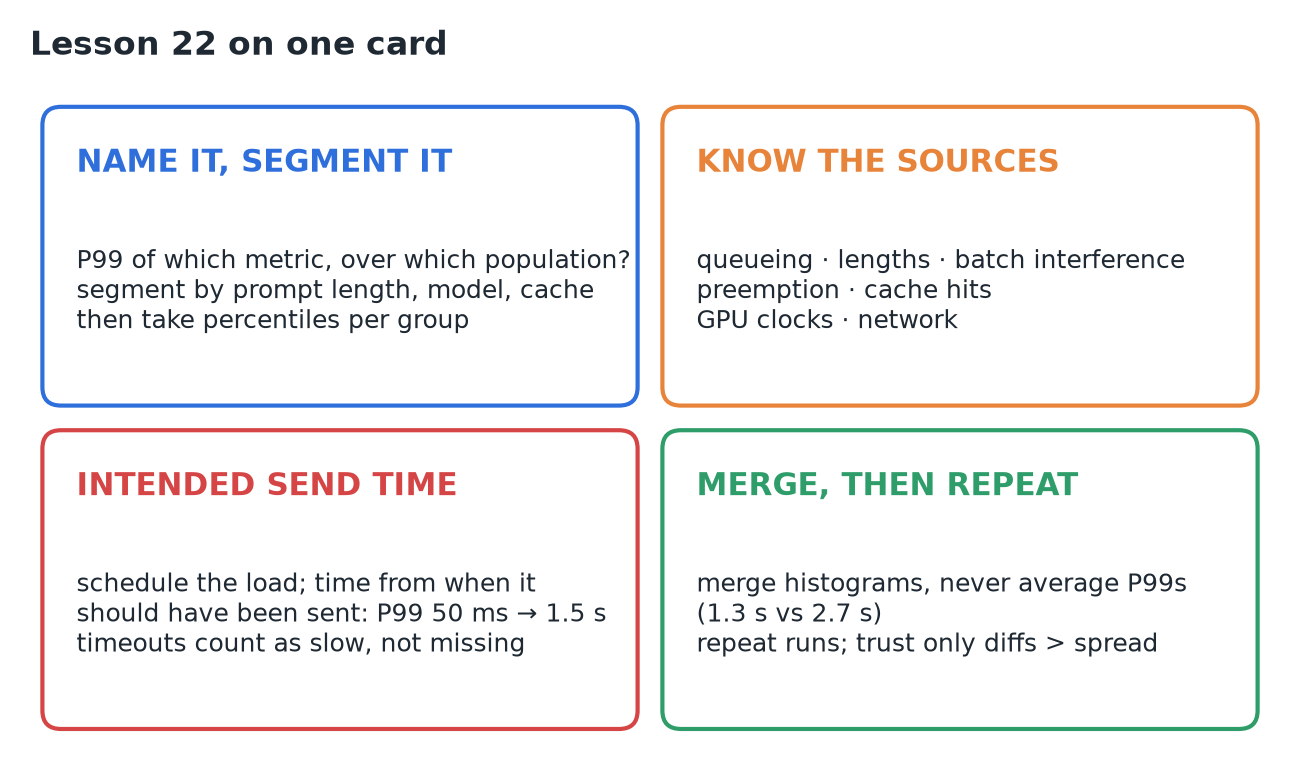
Biết percentile là gì thì dễ; dùng nó trên một server LLM mà không tự lừa mình thì không. Trước hết hãy hỏi P99 của cái gì: metric nào, và tập dữ liệu nào (theo request hay theo token, một kiểu lưu lượng hay một hỗn hợp). Độ trải đến từ xếp hàng, độ dài, ảnh hưởng chéo trong batch, preemption, cache hit, và phần cứng. Một client chờ từng câu trả lời mắc lỗi coordinated omission: nó báo P99 = 50 ms trong khi thực tế là ≈ 1,5 s. Percentile không lấy trung bình được (1,3 s so với thực tế 2,7 s): hãy gộp histogram. Trung vị gần như không đổi giữa các lần chạy (54,0; 53,8; 54,0 ms) nhưng phần đuôi thì trôi dạt, nên hãy chạy lặp lại và báo cáo độ trải.
1. P99 của cái gì?
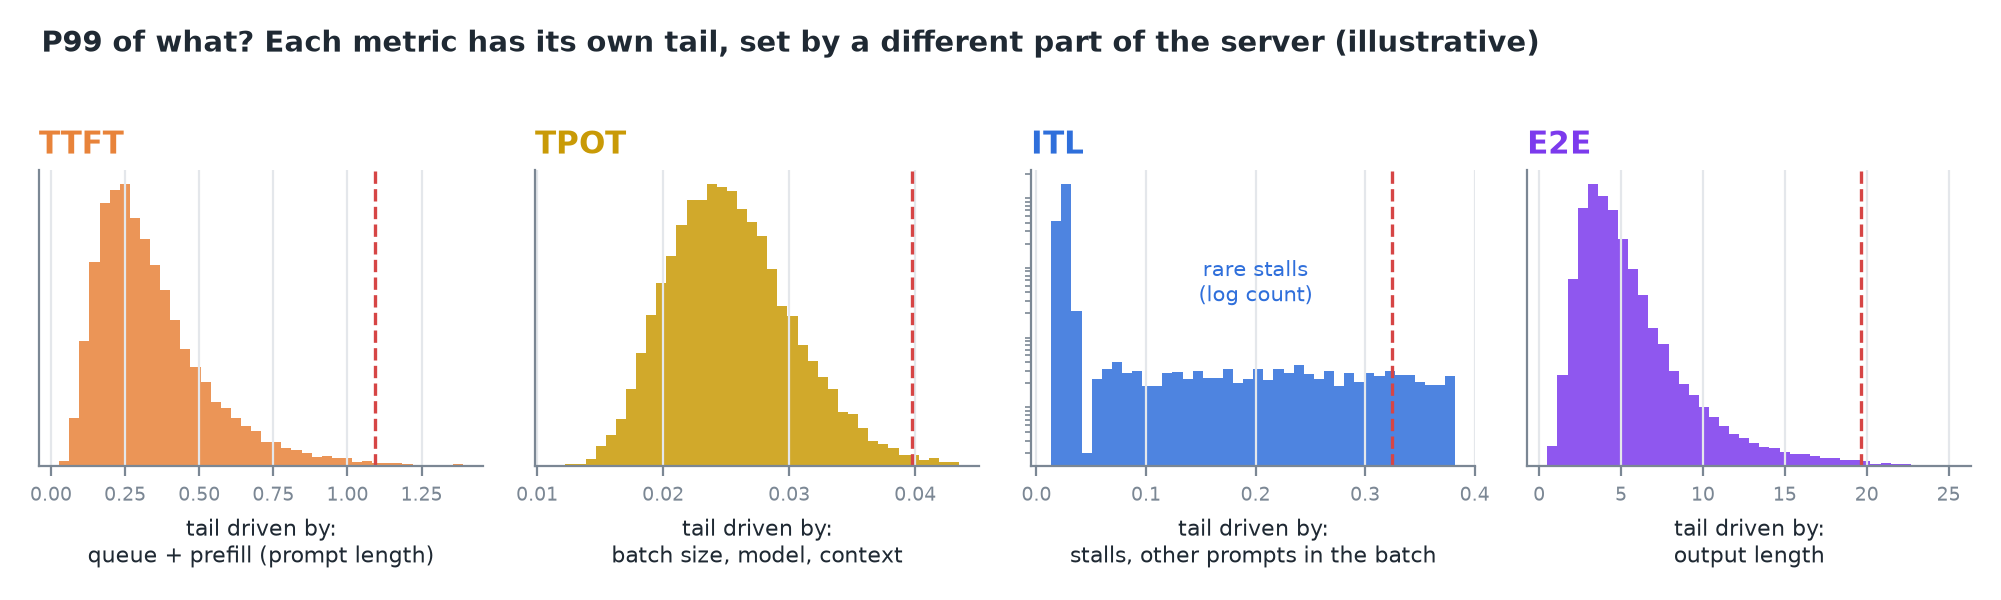 TTFT, TPOT, khoảng cách giữa các token và E2E mỗi cái có phần đuôi riêng, do những phần khác nhau của server chi phối.
- Tập dữ liệu là quan trọng. P99 của TPOT trên các request đếm mỗi request một lần. P99 của khoảng cách giữa các token trên mọi token thì bị các câu trả lời dài chi phối, và bắt được những lần khựng mà trung bình theo request làm mờ đi.
- Đừng trộn các tập dữ liệu. Prompt ngắn và tài liệu dài trong cùng một histogram tạo ra hai cái bướu.
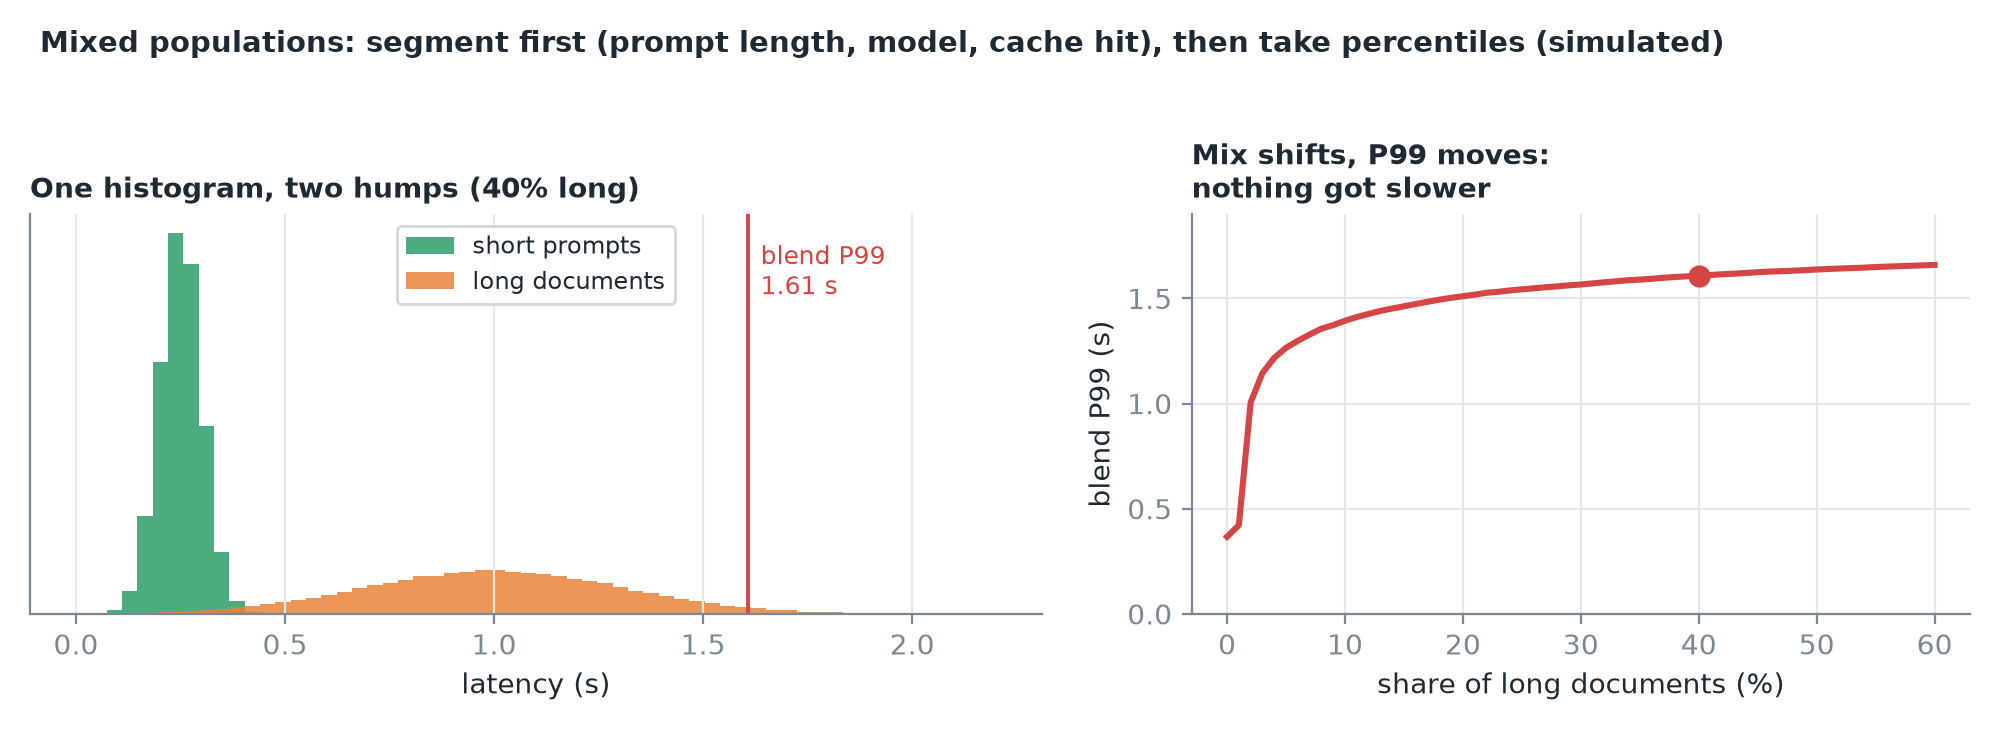 P99 của hỗn hợp (1,61 s khi 40% là tài liệu dài) dịch chuyển mỗi khi tỷ lệ lưu lượng thay đổi, kể cả khi không có gì chậm đi.
Quan trọng
Phân nhóm trước (theo độ dài prompt, theo model, theo việc prompt có được cache hay không), rồi mới lấy percentile trong từng nhóm.
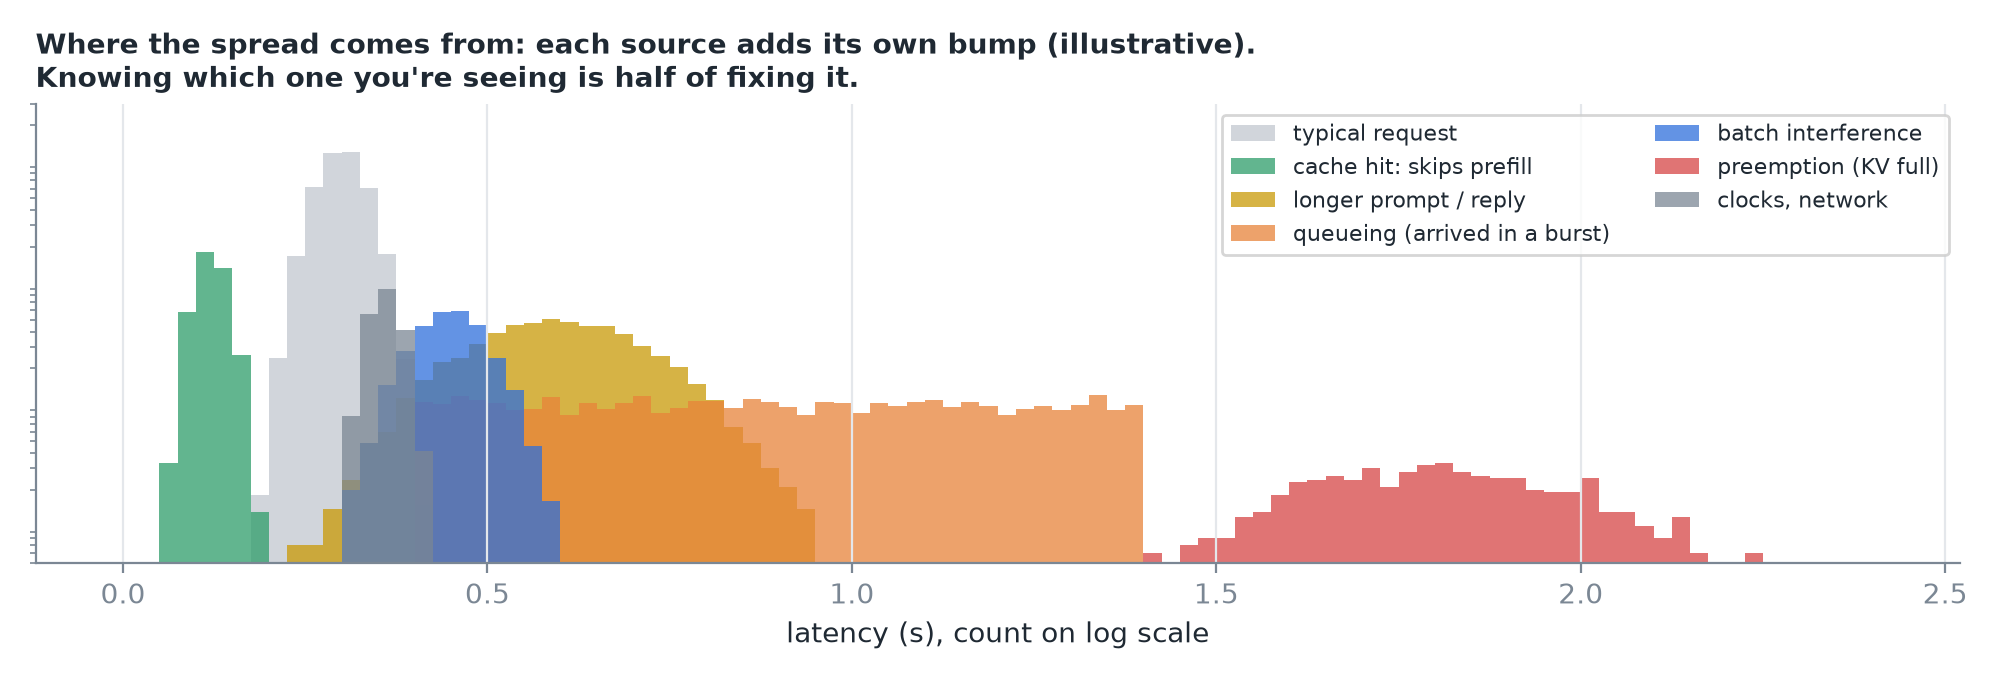
2. Độ trải đến từ đâu
| Nguồn | Điều gì xảy ra |
|---|---|
| Xếp hàng | Request đến giữa một đợt dồn phải chờ sau những request khác |
| Độ dài | Prompt dài hơn → prefill lâu hơn; câu trả lời dài hơn → request lâu hơn |
| Ảnh hưởng chéo trong batch | Prompt dài của người khác chiếm một bước; token tiếp theo của bạn phải chờ |
| Preemption | Hết KV cache: engine tạm dừng hoặc thậm chí tính lại một request |
| Cache hit | Một prefix prompt đã cache bỏ qua phần lớn prefill |
| Phần cứng | Xung nhịp GPU bị hạ do nhiệt hoặc giới hạn công suất; mạng |
Biết mình đang thấy nguồn nào là đã sửa được một nửa.
3. Coordinated omission
Một bộ tạo tải chờ từng response rồi mới gửi request tiếp theo. Server khựng 2 giây. Bộ tạo tải ghi lại một request chậm, và không bao giờ gửi 20 request lẽ ra phải gửi trong lúc khựng: đúng những request lẽ ra sẽ chậm.
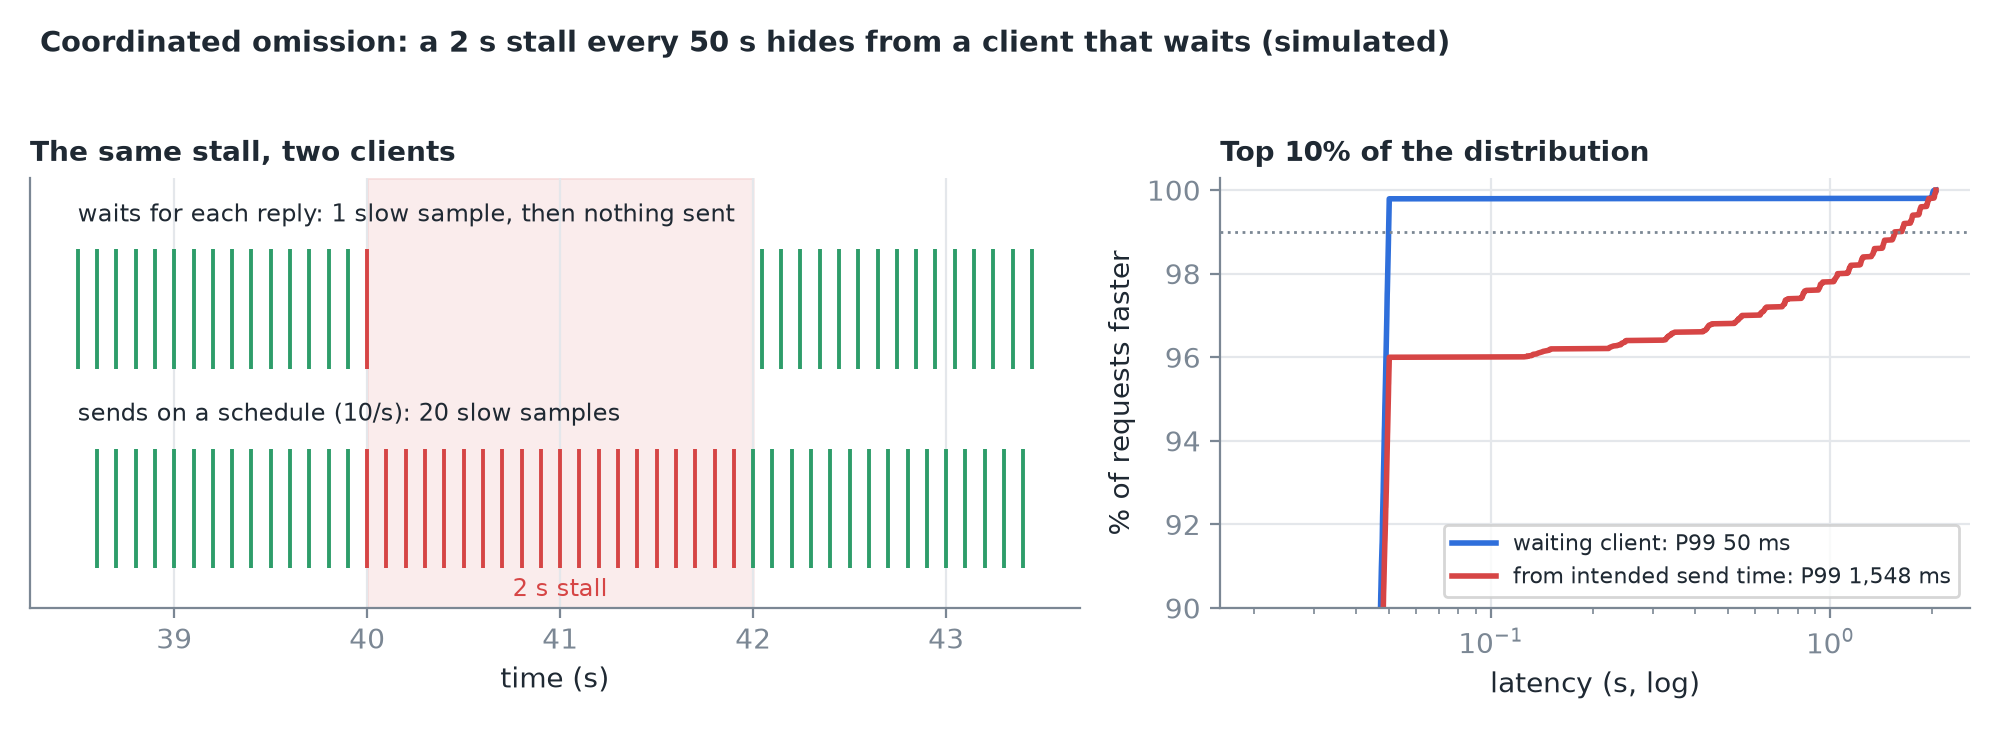 Cứ 50 s khựng 2 s: client chờ đo được P99 = 50 ms; bấm giờ từ lúc mỗi request lẽ ra phải được gửi, P99 thật là ≈ 1,5 s.
Quan trọng
Tạo tải theo lịch và đo latency từ thời điểm dự định gửi. Coi timeout là kết quả chậm, không phải dữ liệu bị thiếu.
4. Percentile không lấy trung bình được
Một dashboard lưu một giá trị P99 mỗi 5 phút. Mười một cửa sổ trông ổn; một cửa sổ, trong lúc có sự cố, thì tệ hại.
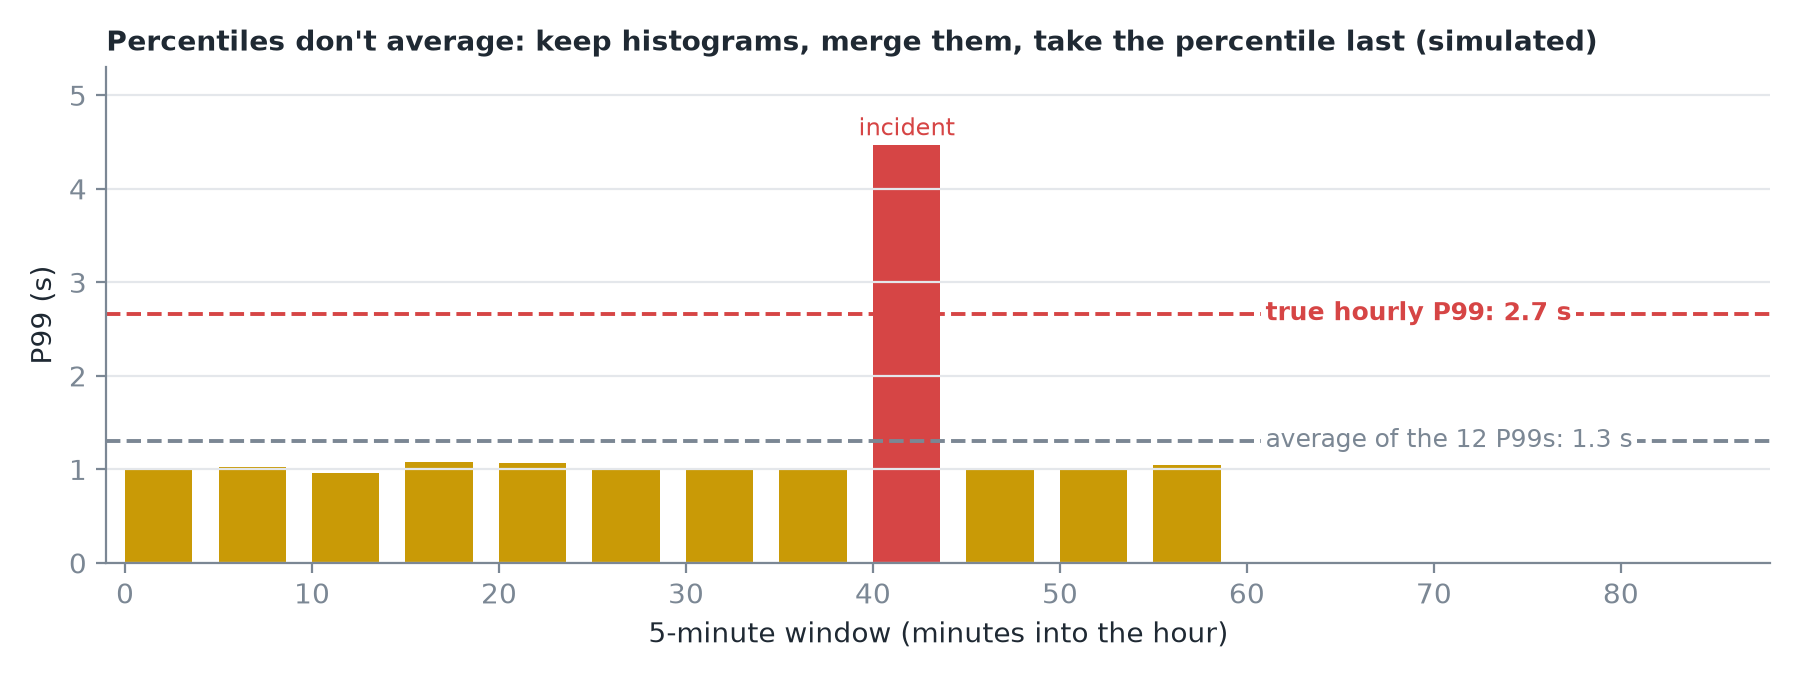 Trung bình của 12 giá trị P99: 1,3 s. P99 thật của cả giờ: 2,7 s.
Quan trọng
Percentile không cộng hay lấy trung bình được. Hãy giữ toàn bộ phân phối dưới dạng histogram, gộp histogram giữa các cửa sổ và các máy, và lấy percentile ở bước cuối cùng.
5. Phương sai giữa các lần chạy
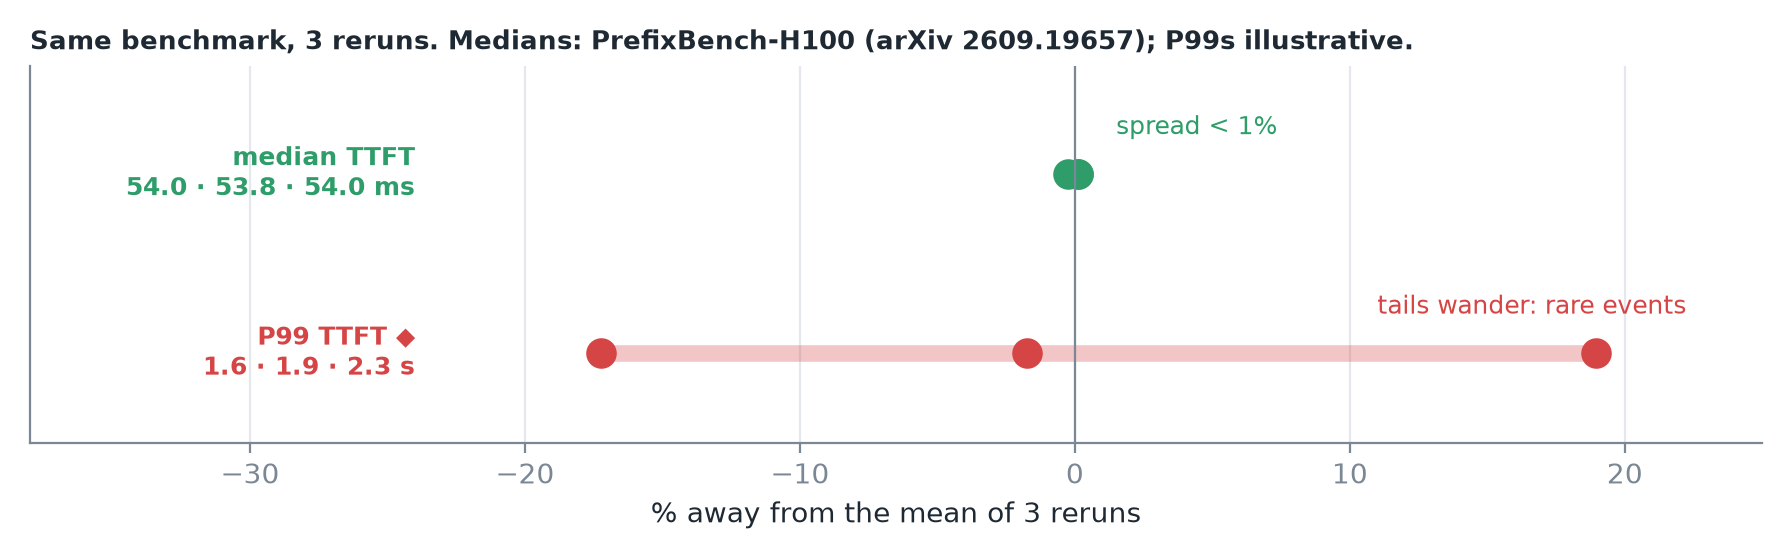 Một nghiên cứu đã công bố trên H100 (PrefixBench-H100, arXiv 2609.19657) đo trung vị TTFT là 54,0; 53,8 và 54,0 ms qua ba lần chạy: độ trải dưới 1%. Phần đuôi phụ thuộc vào một nhúm sự kiện hiếm, nên trôi dạt nhiều hơn hẳn.
- Lặp lại mỗi cấu hình vài lần.
- Báo cáo trung vị của các lần chạy kèm độ trải.
- Chỉ tin một chênh lệch ở phần đuôi khi nó lớn hơn độ trải đó.
6. Tóm tắt