52 · AWQ, GPTQ và SmoothQuant
Nguồn: fanout.sh / inference-eng / 11-03 · ~6 phút
Ghi chú
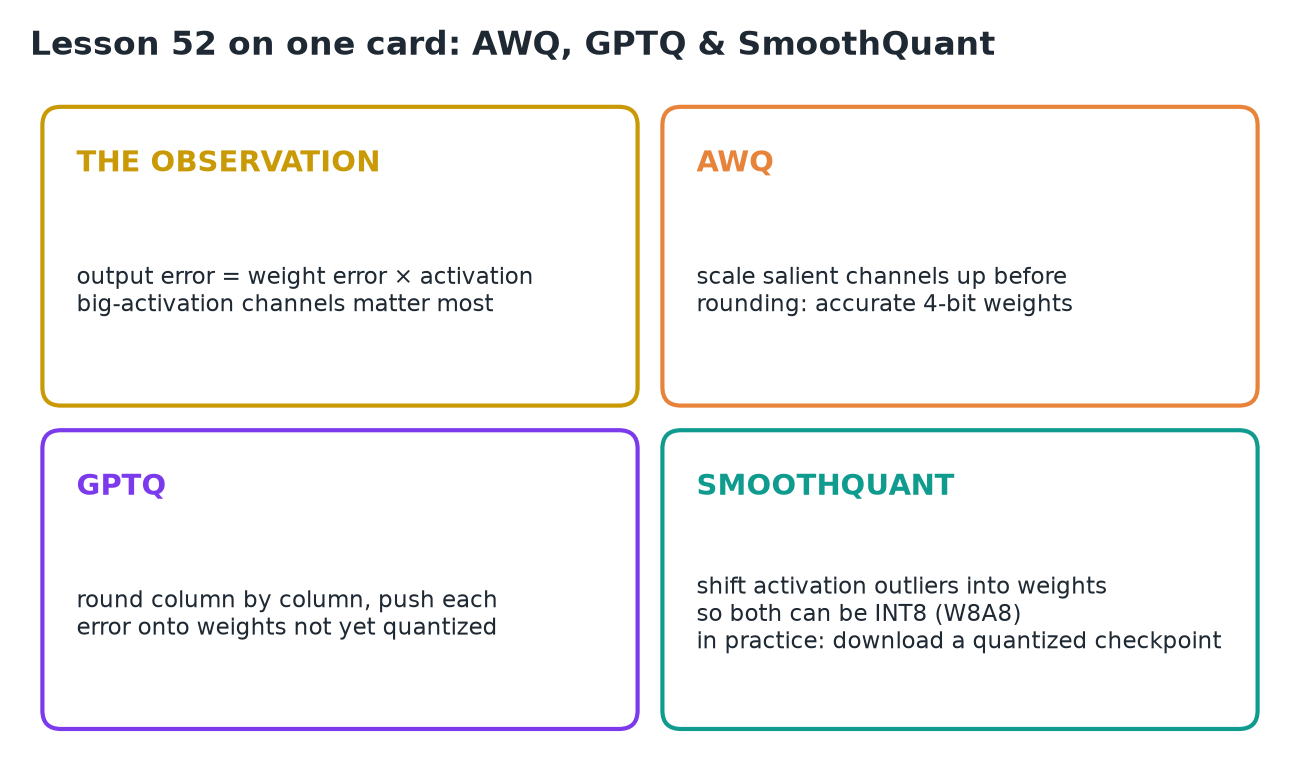
Làm tròn thông thường có thể làm hỏng model: ở 3 bit, nó làm perplexity của OPT-6.7B tăng hơn gấp đôi (10,9 → 23,5). Điều quan trọng là sai số ở đầu ra của layer, và sai số của một trọng số bị nhân với đầu vào mà nó gặp, nên các trọng số ứng với vài kênh activation lớn là quan trọng nhất. AWQ phóng to các kênh nổi bật đó trước khi làm tròn (23,5 → 11,9); GPTQ làm tròn từng cột và đẩy sai số của mỗi cột sang các trọng số chưa lượng tử hoá (175B trong ≈ 4 GPU-giờ); SmoothQuant chuyển outlier của activation sang trọng số để cả hai đều có thể là INT8 (nhanh tới ≈ 1,5 lần, nửa bộ nhớ). Cả ba chạy sau khi huấn luyện trên một mẫu hiệu chuẩn nhỏ, trong vài phút tới vài giờ.
1. Vì sao làm tròn thông thường không đủ
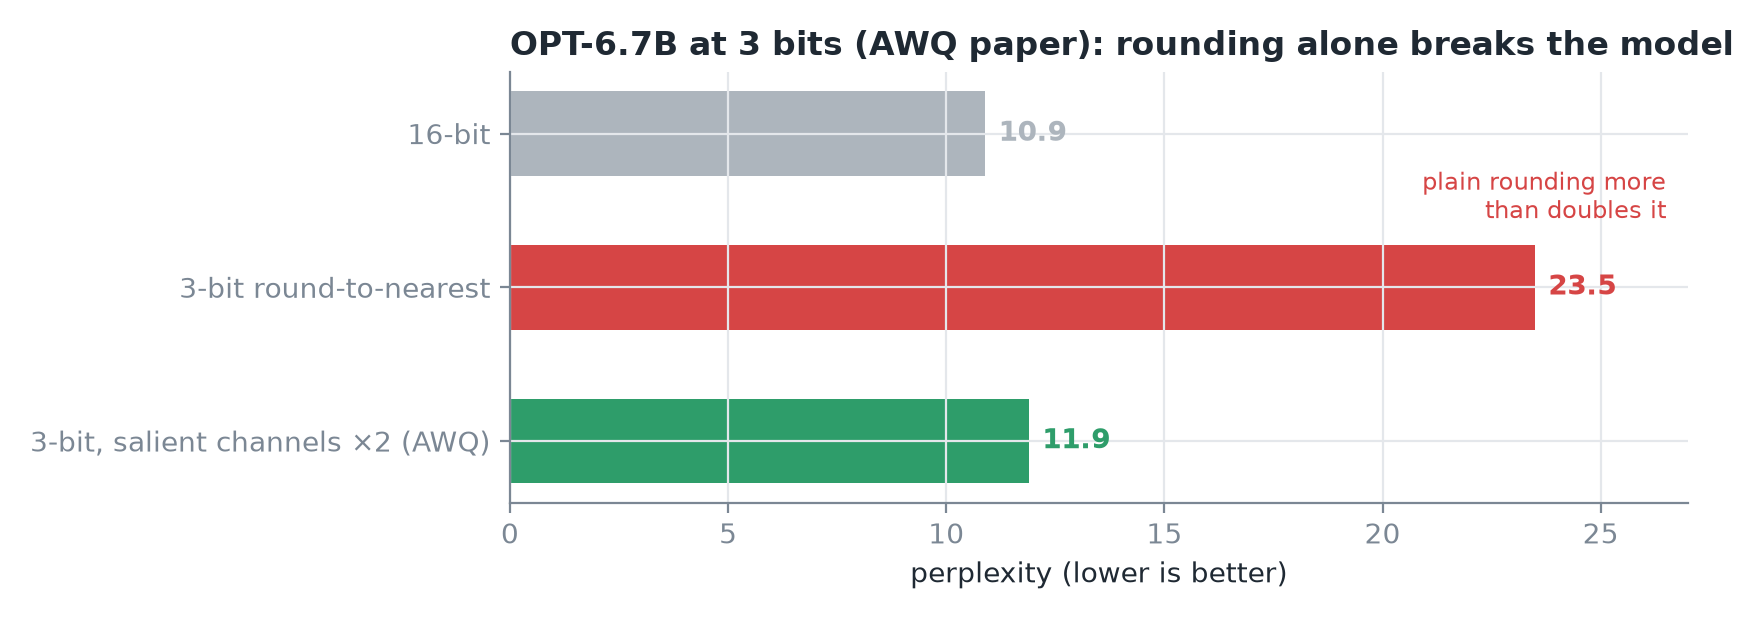 Perplexity từ paper AWQ; cột thứ ba sẽ xuất hiện lại ở mục 3.
- Làm tròn mọi trọng số về mức 4-bit gần nhất có thể làm hỏng nặng một model. Ở 3 bit, làm tròn thông thường đưa một model 6.7B từ perplexity 10,9 lên 23,5.
- Các cách sửa chuẩn: AWQ, GPTQ và SmoothQuant. Cả ba làm việc sau khi huấn luyện, chỉ cần một tập nhỏ đầu vào mẫu, và mất vài phút tới vài giờ, không phải một lần huấn luyện lại.
2. Quan sát chung
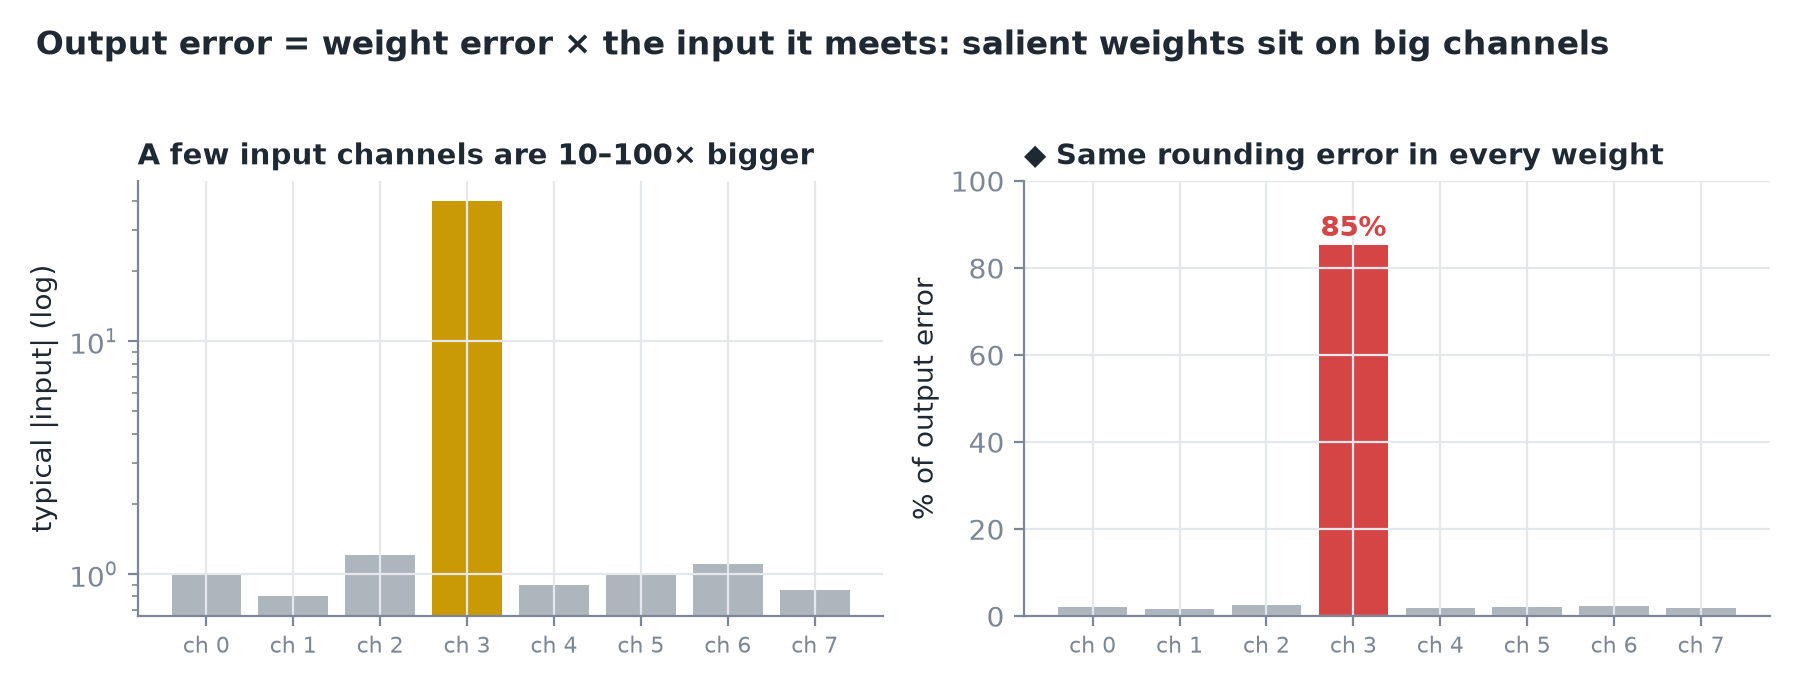 ◆ Phải: nếu mọi trọng số có cùng sai số làm tròn, một kênh lớn duy nhất gây ra 85% sai số đầu ra.
- Ta không quan tâm sai số ở từng trọng số; ta quan tâm sai số ở đầu ra của layer.
- Đầu ra = trọng số × đầu vào, nên sai số làm tròn của một trọng số bị nhân với đầu vào của nó.
- Phần lớn kênh đầu vào nhỏ, nhưng vài kênh mang giá trị lớn gấp 10–100 lần. Sai số ở các trọng số gặp chúng bị khuếch đại theo cùng hệ số đó.
- Đó là các trọng số nổi bật (salient), và bạn tìm ra chúng bằng cách nhìn vào activation, không phải trọng số.
3. AWQ: bảo vệ các trọng số nổi bật
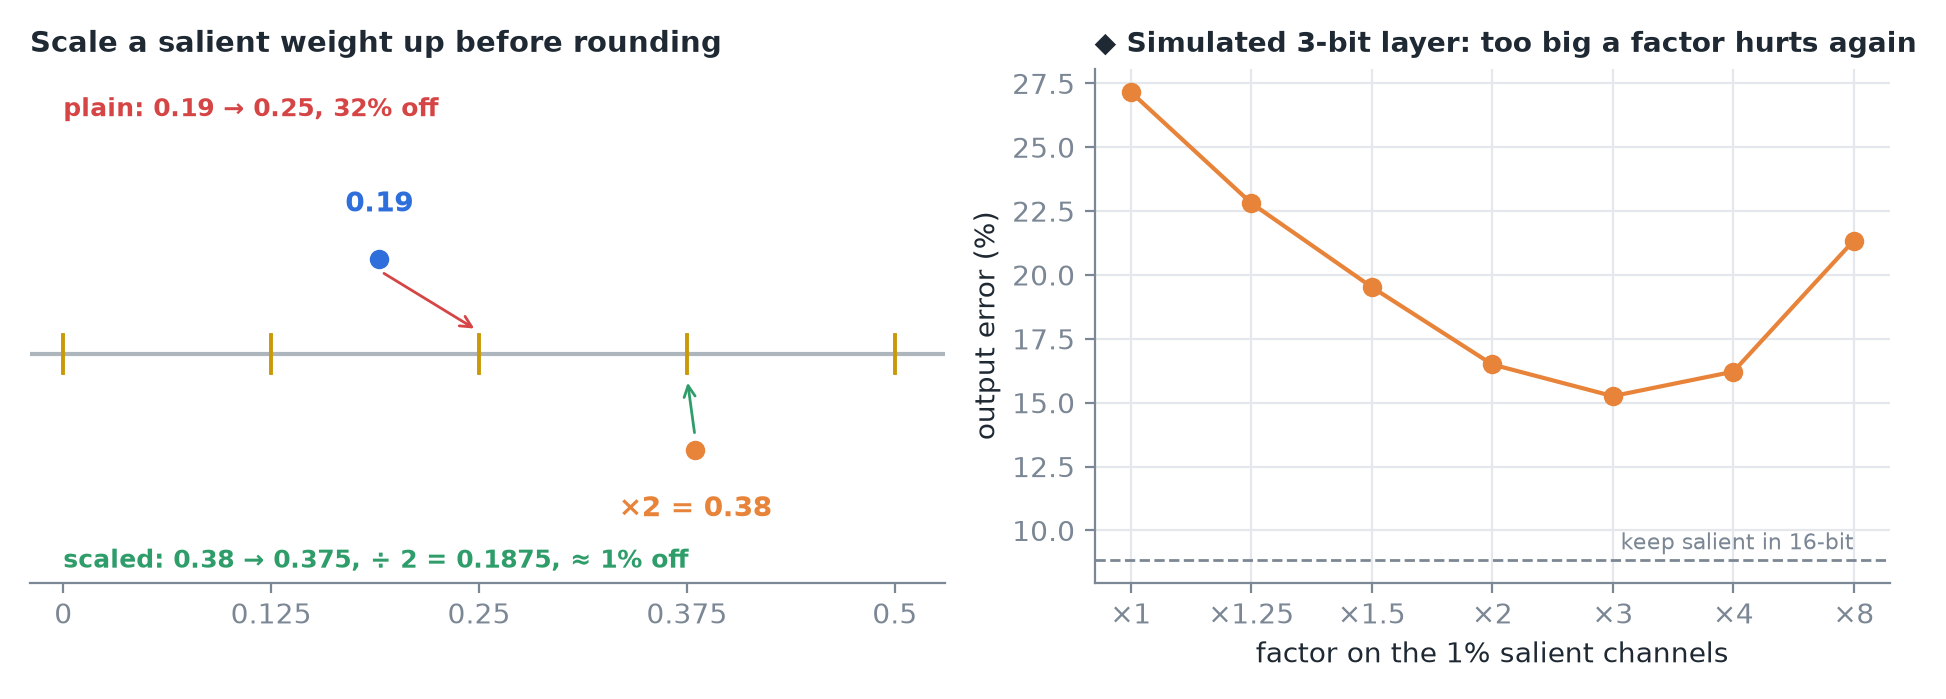 Trái: ví dụ của bài trên lưới minh hoạ bước 0,125. Phải ◆: mô phỏng của tôi cho một layer 3-bit với nhóm 128.
- Activation-aware weight quantization. Chỉ ~1% kênh trọng số là nổi bật. Giữ chúng ở 16 bit sẽ có ích, nhưng trộn nhiều độ chính xác trong một ma trận rất khó cho kernel GPU.
- Thay vào đó: nhân mỗi kênh trọng số nổi bật với một hệ số (giả sử 2) và chia đầu vào của nó cho cùng hệ số đó. Phép toán không đổi (2 × ½ = 1), nhưng các trọng số nổi bật giờ lớn hơn so với bước làm tròn, nên sai số tương đối của chúng co lại.
- Ví dụ: 0,19 làm tròn thành 0,25, lệch 32%. Nhân đôi, 0,38 làm tròn thành 0,375, chia đôi lại là 0,1875, lệch ≈ 1%.
- Trong paper, scale 1% cao nhất lên 2 lần làm perplexity giảm từ ≈ 23,5 xuống ≈ 11,9.
- Các hệ số đến từ một lượt tìm kiếm nhanh dùng độ lớn activation trung bình. Không có lan truyền ngược, nên nó thường không overfit dữ liệu mẫu.
Mẹo
◆ Vì sao hệ số không thể cứ tăng mãi: một khi các trọng số nổi bật đủ lớn để quyết định giá trị lớn nhất của nhóm, bước làm tròn sẽ lớn lên cho mọi trọng số khác trong nhóm đó. Trong mô phỏng của tôi, sai số giảm cho tới khoảng ×3, rồi tăng trở lại.
4. GPTQ: sửa lỗi ngay trong lúc làm
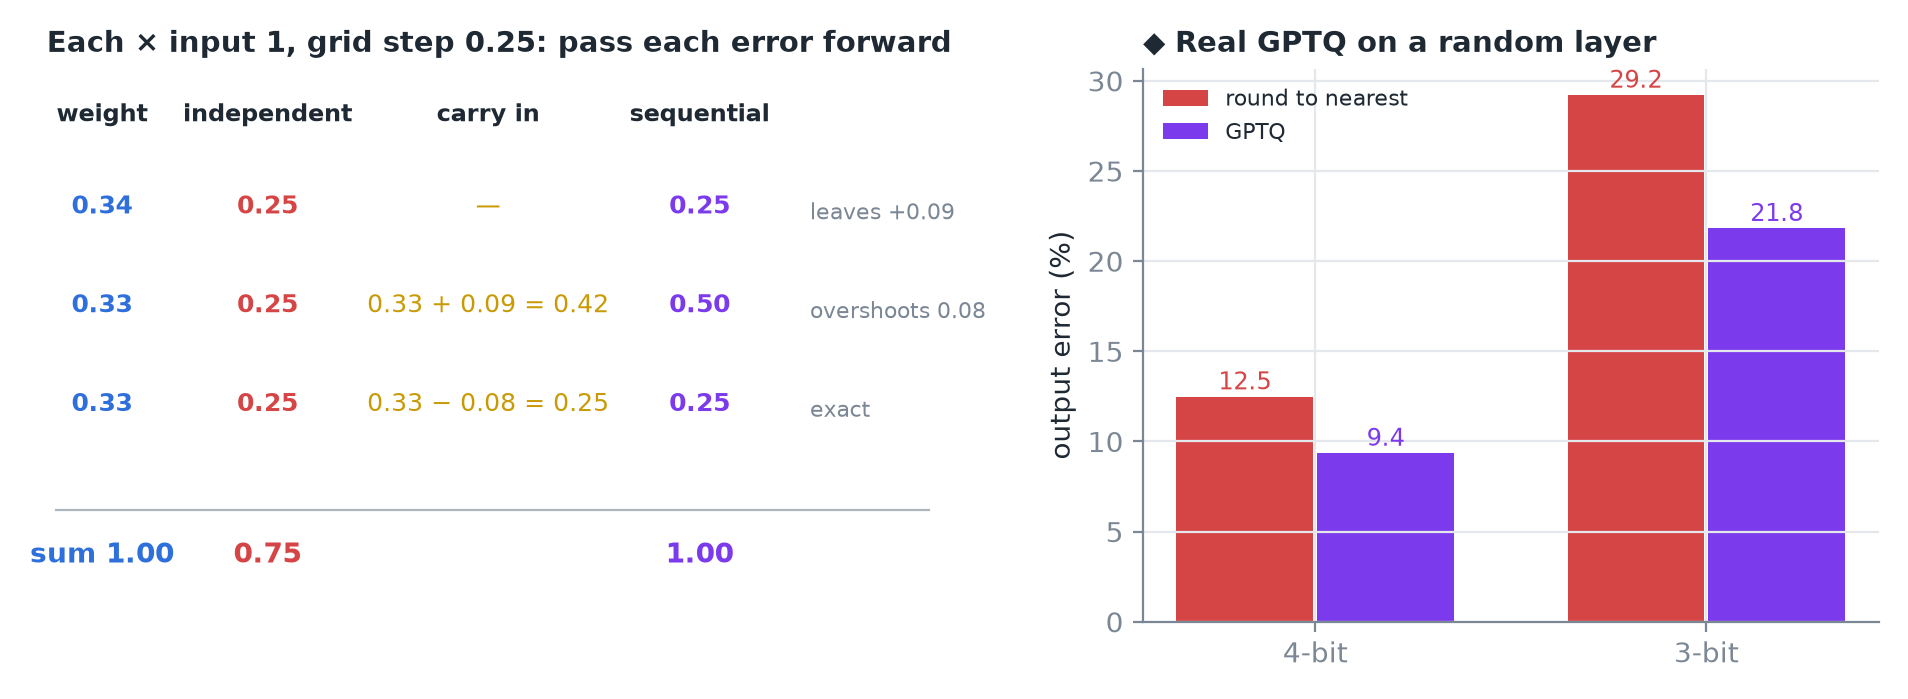 Trái: ba trọng số của bài. Phải ◆: GPTQ thật (scale theo hàng, đầu vào ngẫu nhiên có tương quan) so với làm tròn thông thường.
- Ba trọng số, 0,34; 0,33; 0,33, mỗi cái nhân với đầu vào 1: đầu ra thật 1,00.
- Làm tròn từng cái độc lập về bước 0,25: tất cả thành 0,25, đầu ra 0,75, thấp đi một phần tư.
- Làm tròn từng cái một và chuyển sai số về phía trước: 0,34 → 0,25 để lại +0,09; cái tiếp theo thành 0,42 → 0,50, vượt 0,08; cái cuối thành 0,25 → 0,25. Tổng: đúng 1,00.
- GPTQ làm việc này theo từng cột trên cả ma trận, dùng thống kê bậc hai của đầu vào thật để quyết định cách rải sai số.
- Đủ nhanh để lượng tử hoá một model 175B trong khoảng 4 GPU-giờ.
5. SmoothQuant: trọng số và activation 8-bit
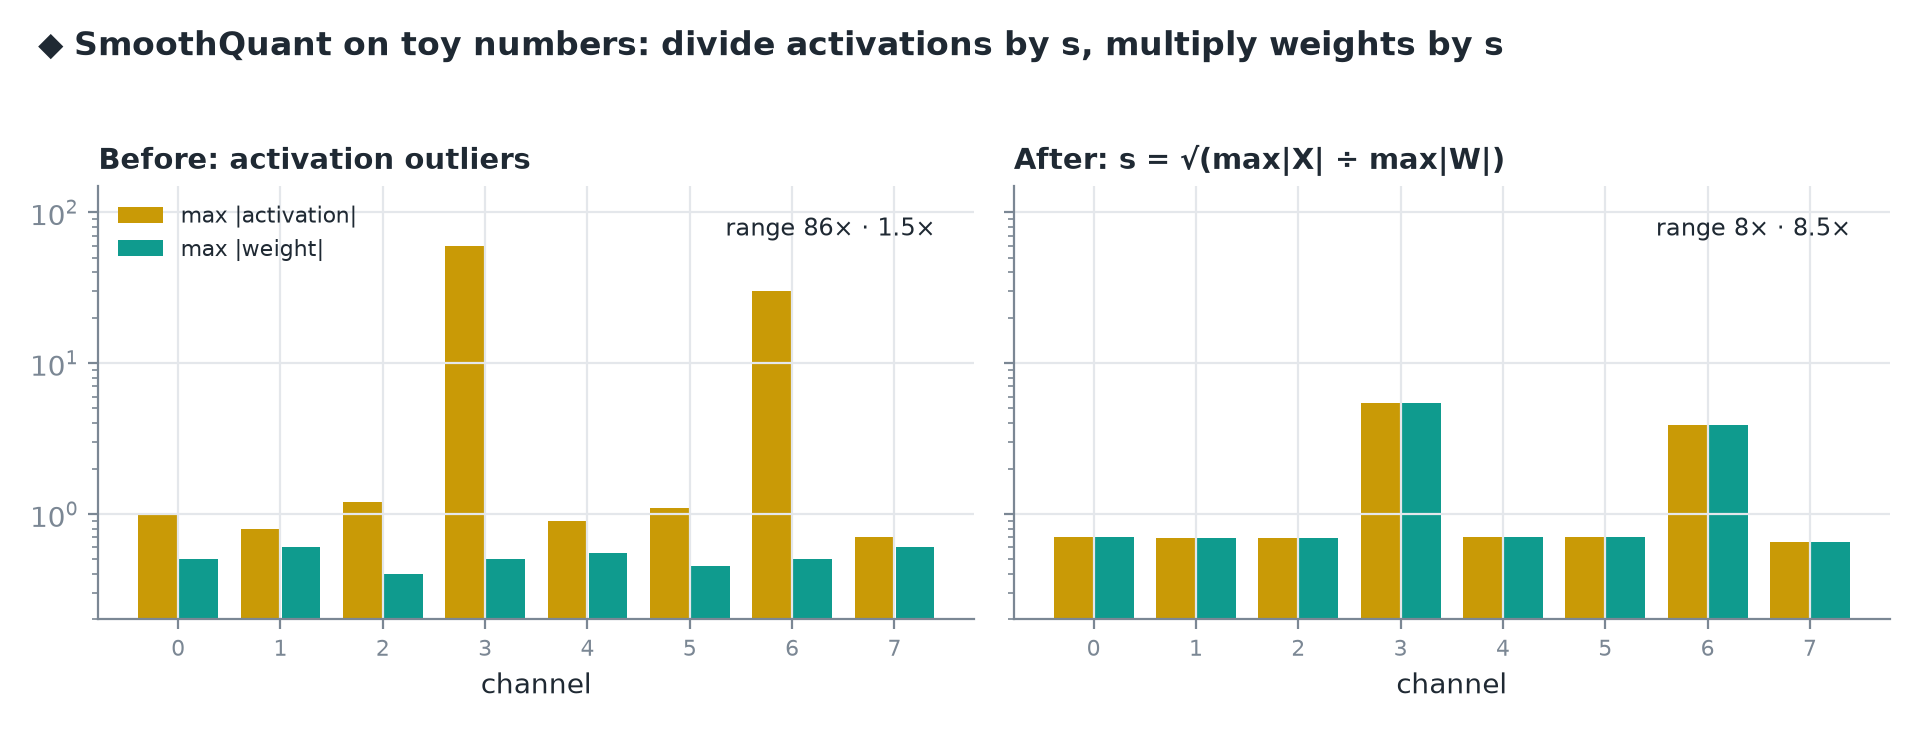 ◆ Giá trị lớn nhất đồ chơi với hai kênh outlier; s cân bằng chính xác từng kênh.
- Một bài toán khác: lượng tử hoá cả activation lẫn trọng số, để bản thân phép tính chạy bằng INT8.
- Trọng số dễ: giá trị của chúng khá đều giữa các kênh. Activation khó: vài kênh có outlier khổng lồ, nên một scale chung đè bẹp mọi kênh khác.
- Chuyển bớt độ khó sang trọng số: chia mỗi kênh activation cho một hệ số và nhân hàng trọng số tương ứng với cùng hệ số đó. Tích không đổi.
- Chọn hệ số để cân bằng hai bên, thường là căn bậc hai của tỷ số giữa chúng. Cả hai đều có phạm vi vừa phải, nên cả hai đều có thể là INT8.
- Việc scale được gộp sẵn vào layer trước đó, nên nó không tốn gì lúc chạy.
- Paper báo inference nhanh hơn tới ≈ 1,5 lần và nửa bộ nhớ, với mất mát độ chính xác không đáng kể.
6. Đặt cạnh nhau
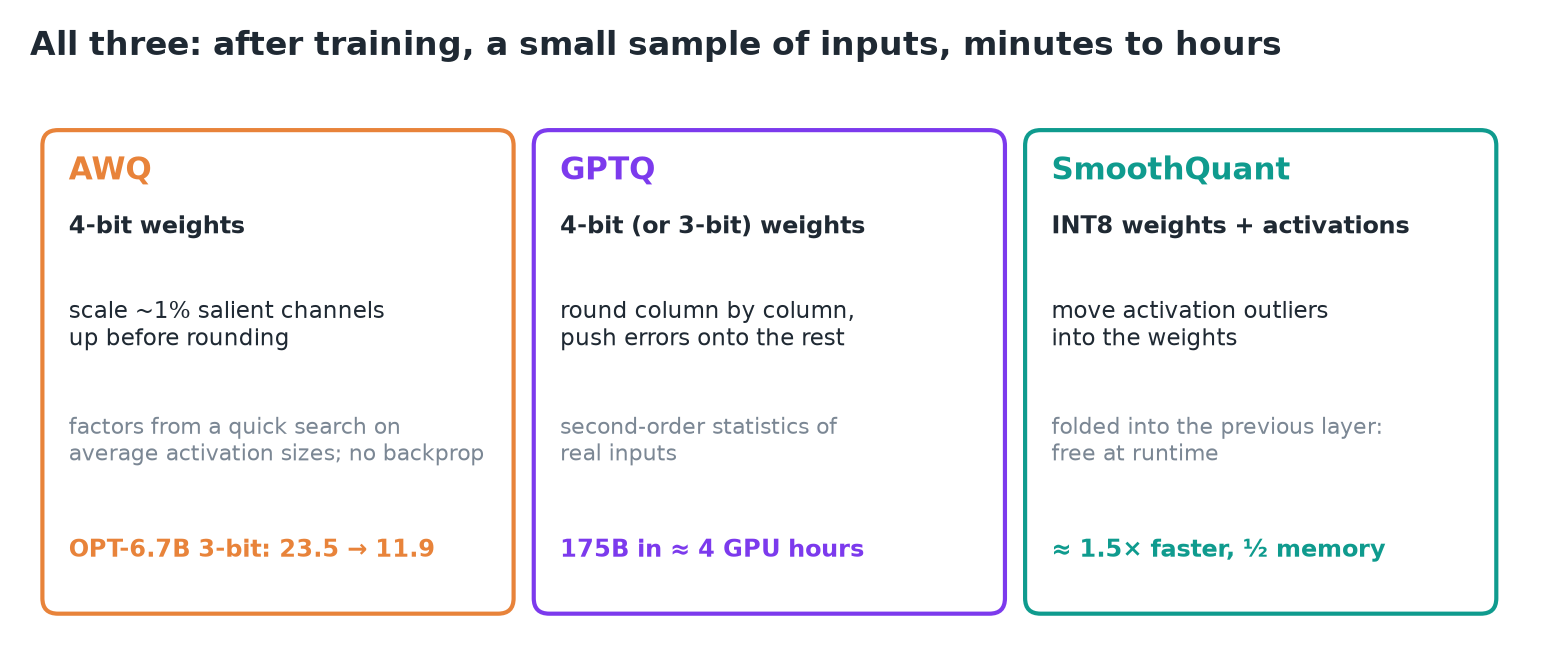
- Trên thực tế bạn thường tải về một checkpoint đã được lượng tử hoá bằng một trong các phương pháp này, và vLLM nạp nó trực tiếp.
7. Tóm tắt