57 · Nsight Systems
Nguồn: fanout.sh / inference-eng / 12-03 · ~7 phút (bài dạng văn bản)
Ghi chú
Công cụ trong process không cho biết cả cỗ máy đang làm gì quanh process của bạn. Nsight Systems, profiler toàn hệ thống của NVIDIA, ghi một cửa sổ trong đời cỗ máy thành một timeline trên một đồng hồ: mọi process, mọi thread, các lời gọi CUDA của từng thread, kernel và các lần chép trên thiết bị, và những quãng một thread bị chặn trong OS. Nó không cần sửa code, nên chạy được với mọi process, ngôn ngữ hay framework, kể cả một serving stack tách thành nhiều process. Nó trả lời thời gian đã đi vào kernel hay khoảng trống nào; nó không nói được điều gì xảy ra bên trong một kernel.
1. Một timeline cho cả cỗ máy
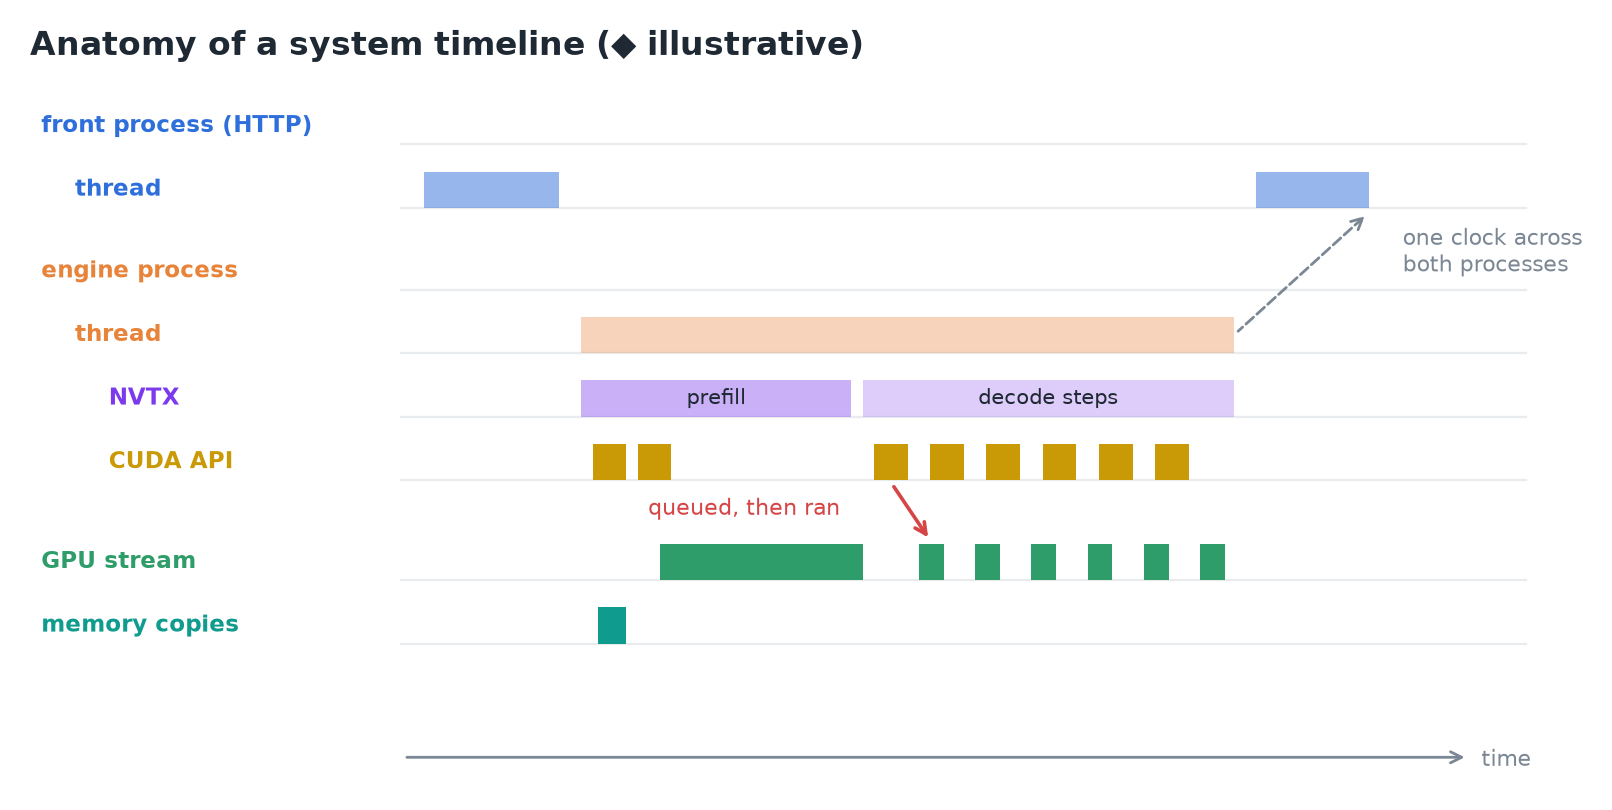 ◆ Timeline minh hoạ: thread và các lời gọi của chúng ở trên, thứ tự riêng của thiết bị ở dưới.
- Một serving stack không phải một process. Ví dụ vLLM có một process phía trước nói HTTP và một engine core đẩy model chạy từng bước. Ghi chép trong process dừng ở đường nối đó; dưới Nsight Systems, cả hai nửa nằm trên một timeline, cùng mọi thứ khác máy đang làm.
- Các hàng đi theo cấu trúc phân cấp của máy:
- mỗi process là một khối, mỗi thread là một hàng bên trong;
- thread dùng CUDA có một hàng CUDA API (các hộp như
cudaLaunchKernel,cudaMemcpyAsync, kéo dài theo wall time của mỗi lời gọi); - dưới cùng là GPU: mỗi CUDA context và các stream của nó, nơi mỗi hộp là một kernel hoặc một thao tác bộ nhớ, theo thứ tự thiết bị đã chạy.
- Một kernel xuất hiện hai lần: một lần là lời gọi API đã xếp hàng nó, trên thread của host, và một lần là lúc thực thi, trên một stream, muộn hơn. Thiết bị chạy sau host là có chủ đích, và timeline cho thấy chậm hơn bao nhiêu.
2. Thu một cửa sổ trên một serving process
nsys profile --trace=cuda,nvtx,osrt \
    --cuda-graph-trace=node \
    --delay=180 --duration=120 --kill=none \
    -e VLLM_WORKER_MULTIPROC_METHOD=spawn \
    -o decode-window \
    vllm serve NousResearch/Meta-Llama-3.1-8B \
      --max-model-len 2048
Lệnh mang tính đại diện, không phải một lần capture thật.
| Cờ | Vì sao |
|---|---|
--trace=cuda,nvtx,osrt | Lời gọi CUDA API và công việc trên thiết bị; range có tên của NVTX; lời gọi OS runtime nơi thread bị chặn |
--cuda-graph-trace=node | mở các CUDA graph được phát lại thành các hàng kernel (xem bên dưới) |
--delay=180 --duration=120 | cửa sổ đã khai báo: bỏ qua khởi động và các request lạnh, ghi trạng thái ổn định |
--kill=none | mặc định công cụ giết process nó đã khởi chạy khi thu thập xong; server nên sống lâu hơn trace của nó |
-e VLLM_WORKER_MULTIPROC_METHOD=spawn | vLLM mặc định khởi động process thứ hai bằng fork, thứ mà công cụ dựa trên injection không theo được một cách an toàn; spawn thì an toàn |
- Mặc định công cụ còn lấy mẫu xem mỗi thread đang thực thi ở đâu. Nên giữ trong lượt đầu;
--sample=none --cpuctxsw=nonelà dạng nhẹ hơn khi bạn đã biết mình tìm gì.
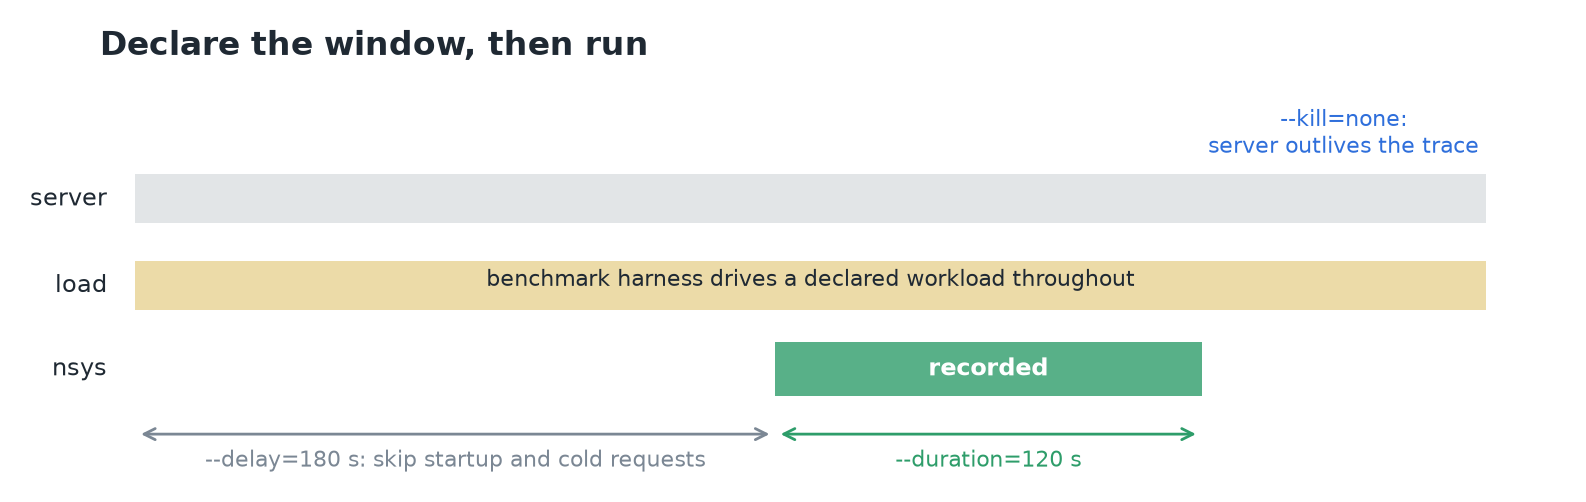 Cửa sổ chỉ cho thấy điều gì đó nếu có một workload đã khai báo chạy qua nó; server rảnh thì cho một timeline trống rỗng.
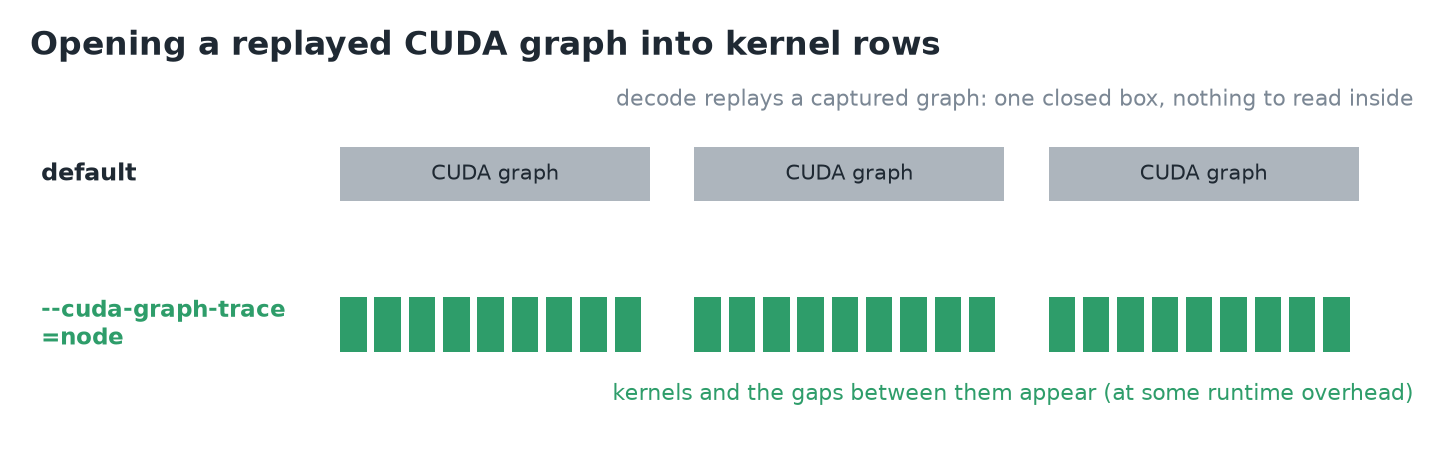 Không trace theo node, một decode graph được phát lại là một hộp đóng kín.
- vLLM phát lại decode dưới dạng một CUDA graph đã capture. Ở độ mịn mặc định, một graph được vẽ thành một mục không có gì để đọc bên trong.
--cuda-graph-trace=nodemở nó ra thành các hàng kernel, với cái giá mà hướng dẫn cảnh báo có thể là overhead runtime đáng kể. Không có nó, các kernel của decode và khoảng trống giữa chúng không bao giờ hiện ra.
Đọc đầu ra:
decode-window.nsys-repmở trong GUI,nsys-ui.- Qua SSH,
nsys stats decode-window.nsys-repin ra các bảng tóm tắt đã xếp hạng. Ba bảng nên đọc trước nằm trong bộ mặc định:cuda_gpu_kern_sum: kernel theo thời gian trên thiết bị;cuda_api_sum: lời gọi API theo wall time;nvtx_sum: các range có tên của bạn.
- Muốn tự khoanh cửa sổ bằng tay:
nsys launchkhởi chạy mục tiêu dưới công cụ, rồinsys start/nsys stopmở và đóng việc thu thập.
3. Ba cách đọc một cửa sổ decode
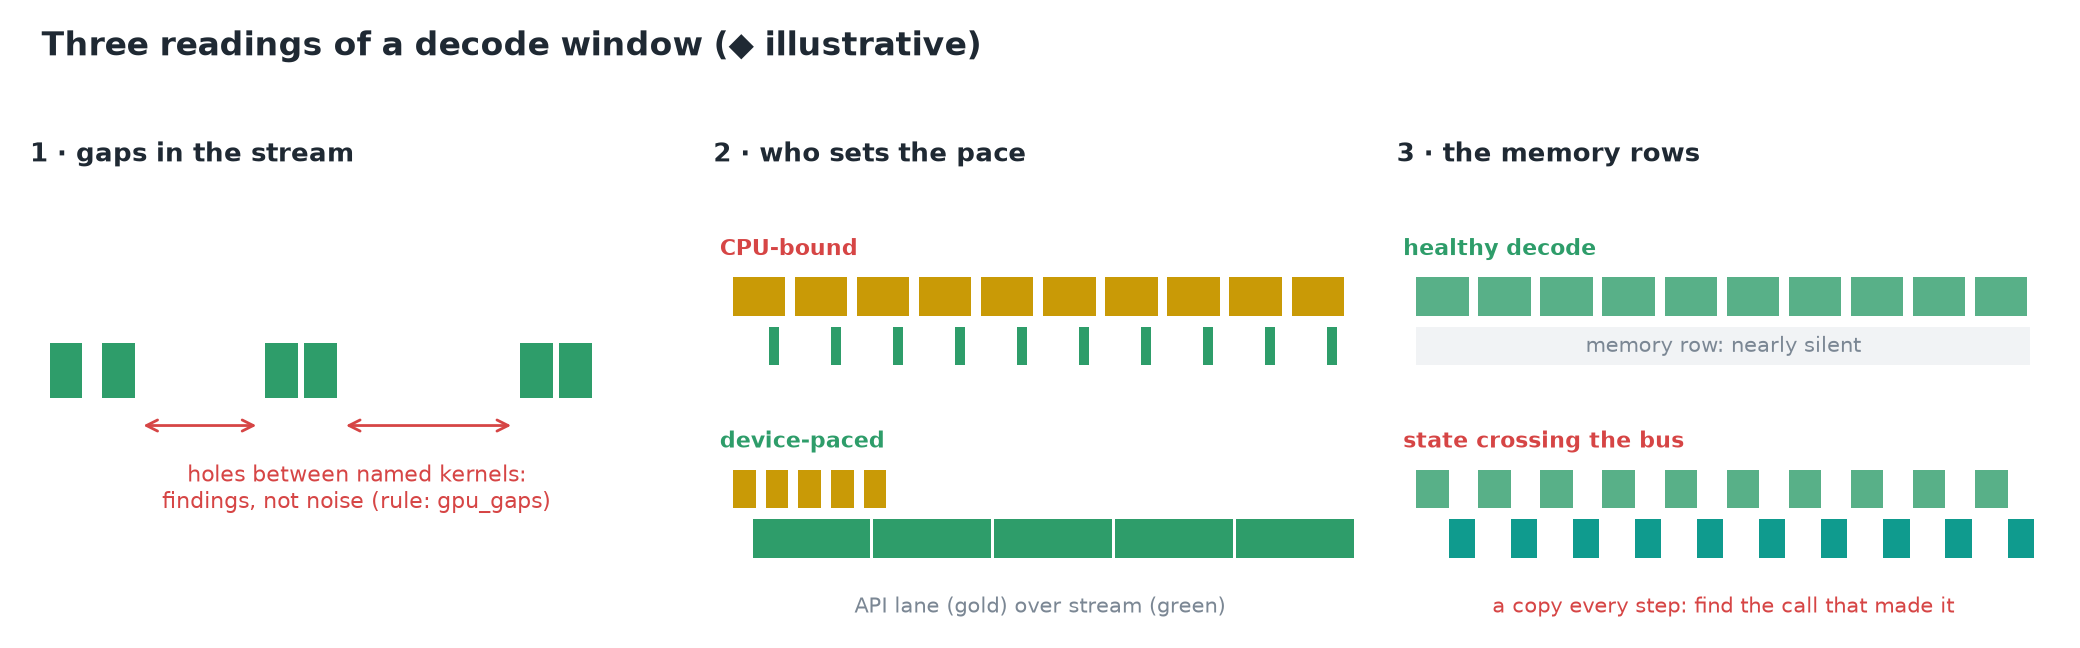 ◆ Hình dạng minh hoạ cho mỗi cách đọc.
- Khoảng trống trong stream. Không cần phóng to: các hàng stream hoặc dày đặc hoặc đầy lỗ hổng. Thiết bị phần lớn rảnh trong khi người gọi phải chờ thì không phải vấn đề của kernel. Mỗi lỗ hổng nằm giữa hai kernel có tên, bên dưới một làn API hoặc im lặng (không có gì được yêu cầu) hoặc bận (đã yêu cầu, nhưng việc không tới). Khoảng trống là phát hiện, không phải nhiễu; CLI có một expert rule,
gpu_gaps, cho lượt quét này. - Ai quyết định nhịp. Decode là rất nhiều kernel ngắn nối tiếp nhau.
- CPU-bound: một làn API đầy lời gọi launch phía trên một stream gồm những lát mỏng cách nhau bởi khoảng không. Host quyết định nhịp, từng lần launch một.
- Thiết bị quyết định nhịp: một stream chạy vai kề vai, các hộp rộng hơn các lời gọi đã xếp hàng chúng. Host đi trước một cách thoải mái.
- Các hàng bộ nhớ. Decode ổn định nên giữ chúng gần như im lặng: KV cache giữ trạng thái trên thiết bị, và một bước chỉ cần chuyển token, vốn rất nhỏ. Các lần chép host↔device rộng hoặc lặp lại theo nhịp nghĩa là trạng thái đi qua bus ở mỗi bước, và timeline cho thấy lời gọi nào trên thread nào đã tạo ra từng lần chép.
4. Đặt tên cho các pha bằng NVTX
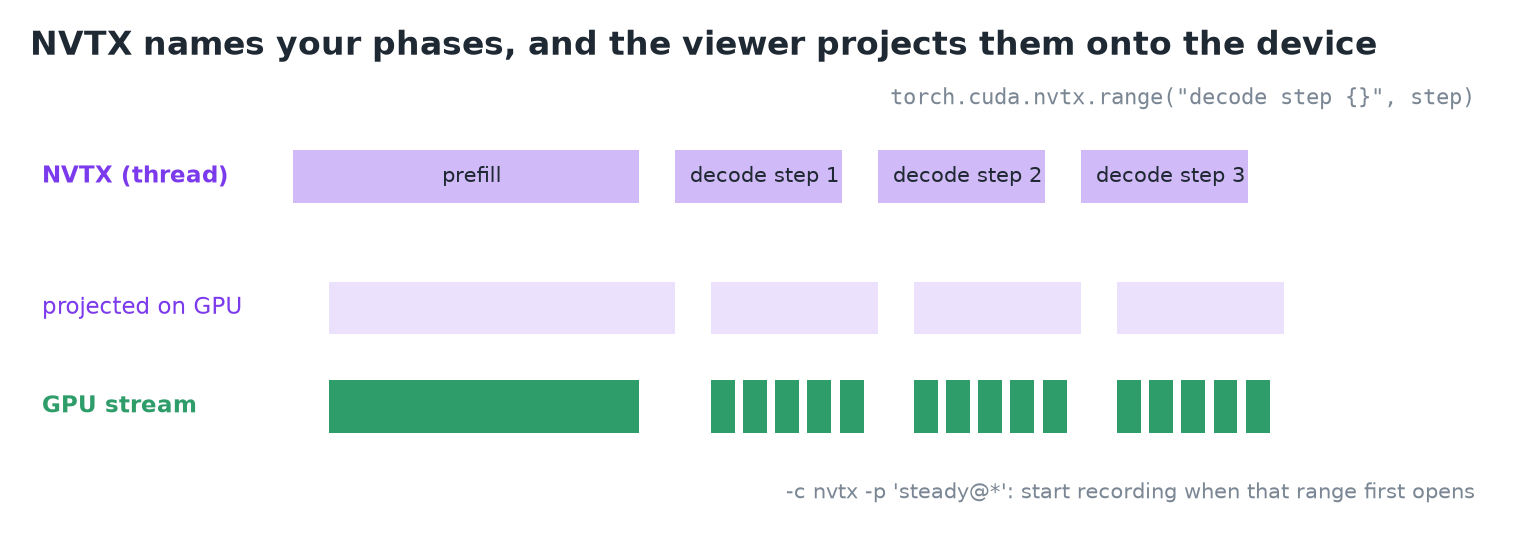 Range được đẩy trên thread được chiếu xuống các hàng GPU.
- Tên kernel là từ vựng của thiết bị; các pha của bạn (prefill của request này, các bước decode của request kia) không tồn tại trên trace cho tới khi bạn đặt tên cho chúng.
- NVTX (NVIDIA Tools Extension): đẩy một range có tên khi một pha bắt đầu, bật nó ra khi pha kết thúc. PyTorch cung cấp nó dưới dạng context manager:
with torch.inference_mode():
    if past is None:
        with torch.cuda.nvtx.range("prefill"):
            out = model(input_ids=seq, use_cache=True)
    else:
        with torch.cuda.nvtx.range("decode step {}", step):
            out = model(input_ids=seq[:, -1:],
past_key_values=past, use_cache=True)- Đối số thêm điền vào nhãn qua
msg.format(), nên mỗi bước decode có tên riêng. - Trình xem chiếu mỗi range xuống các hàng thiết bị: kernel và các lần chép launch bên trong một range nằm dưới tên đó ở phía GPU, nên câu hỏi theo từng pha được trả lời chỉ bằng cách đọc.
- Một range có thể kích hoạt việc thu thập:
-c nvtx -p 'steady@*'giữ việc ghi cho tới khi một range có message đó lần đầu mở ra. torch.autograd.profiler.emit_nvtxđóng dấu một range lên mọi op autograd. Nó được làm để khớp backward với forward khi huấn luyện; với một vòng lặp sinh, vài range đặt bằng tay nói được nhiều hơn.
5. Giới hạn của hình dạng
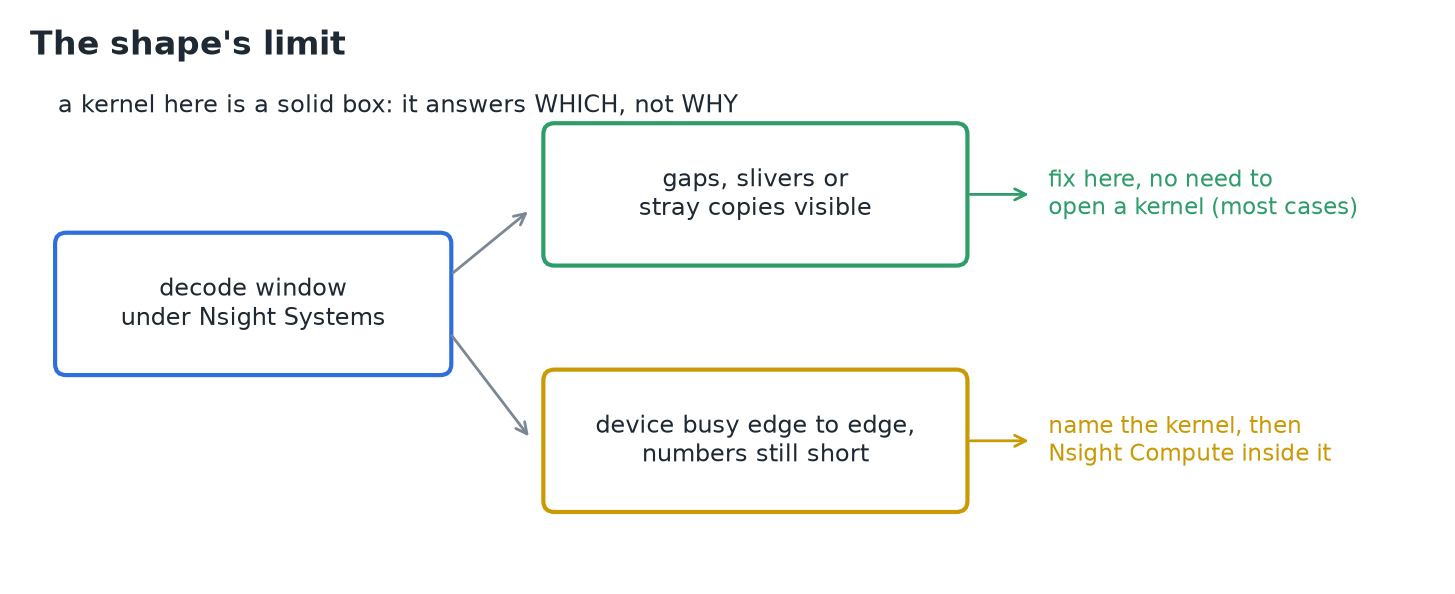 Phần lớn chẩn đoán serving kết thúc ở độ cao này.
- Mọi thứ ở đây là một hộp có tên với một độ rộng trên một làn. Vừa đủ để trả lời cái nào: kernel nào chiếm thời gian thiết bị, khoảng trống nào nuốt mất những mili giây bị thiếu, làn nào quyết định nhịp.
- Đó cũng là giới hạn: một kernel là một hình chữ nhật đặc, và không gì trên nó nói silicon đã dùng độ rộng đó vào việc gì. Đó là việc của Nsight Compute, được nhắm tới sau khi Nsight Systems đã gọi tên mục tiêu.
- Khoảng trống không bao giờ cần đi xuống sâu như thế. Một quãng rảnh, một đoàn lát mỏng do launch quyết định nhịp, một lần chép lẽ ra không nên tồn tại: mỗi cái đều thấy được và sửa được mà không cần mở một kernel nào.
- Một cửa sổ mà thiết bị bận từ mép này tới mép kia nhưng con số vẫn hụt mới là lúc đáng dùng tới công cụ cấp kernel.
Quan trọng
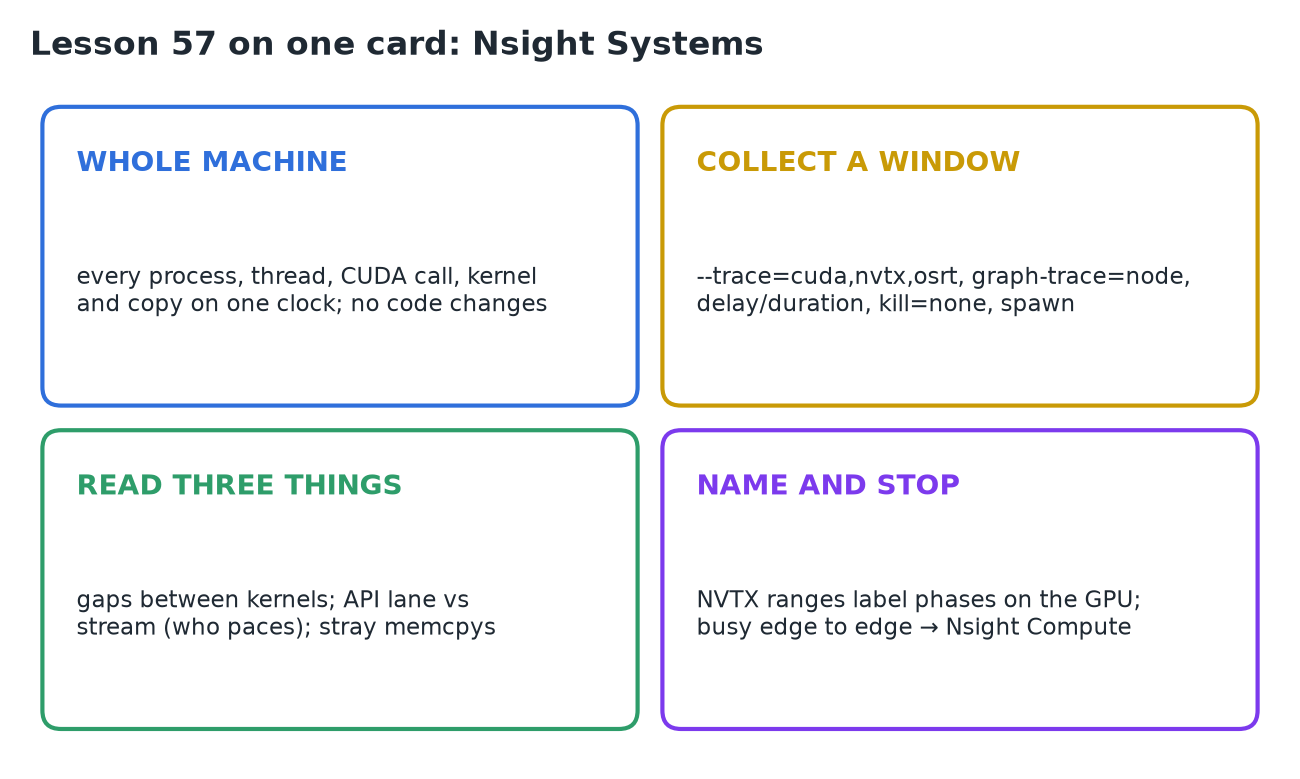
Nsight Systems cho thấy cả cỗ máy trên một đồng hồ, mà không đụng tới code. Khai báo một cửa sổ ổn định dưới tải thật, đọc khoảng trống, nhịp độ và các lần chép, và chỉ đi vào bên trong một kernel khi thiết bị đã bận từ mép này tới mép kia.
6. Tóm tắt