05 · Tích vô hướng, Softmax và toán của Attention
Nguồn: fanout.sh / inference-eng / 00-03 · ~11 phút
Ghi chú
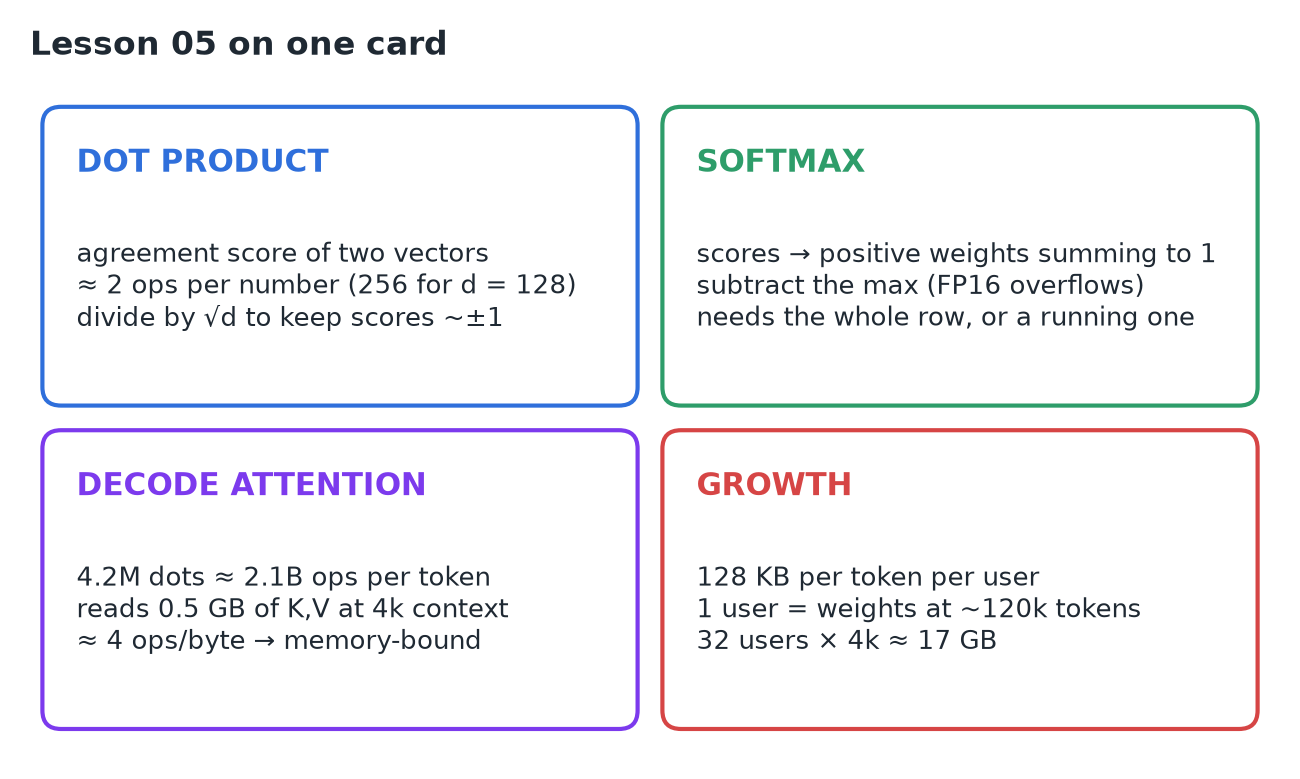
Để viết một token mới khi context dài 4.096 token, attention của Llama 3 8B tính khoảng 4,2 triệu tích vô hướng (~2,1 tỷ phép tính) nhưng phải đọc khoảng 0,5 GB key và value đã lưu. Tức là chỉ ~4 phép tính trên mỗi byte, thấp xa so với mức ~300 mà một H100 cần, nên attention ở pha decode bị giới hạn bởi bộ nhớ (memory-bound). Dữ liệu K/V tăng theo từng token và từng người dùng, cho tới khi nặng hơn cả model. Softmax cần cả hàng, vì vậy các kernel nhanh dùng softmax chạy dần (online softmax).
1. Tích vô hướng: điểm đồng thuận
Nhân hai danh sách cùng độ dài theo từng cặp, rồi cộng lại:
- Trong attention, mỗi danh sách có 128 số: 128 phép nhân + ~128 phép cộng ≈ 256 phép tính.
- Kết quả cho biết hai vector cùng hướng tới mức nào:
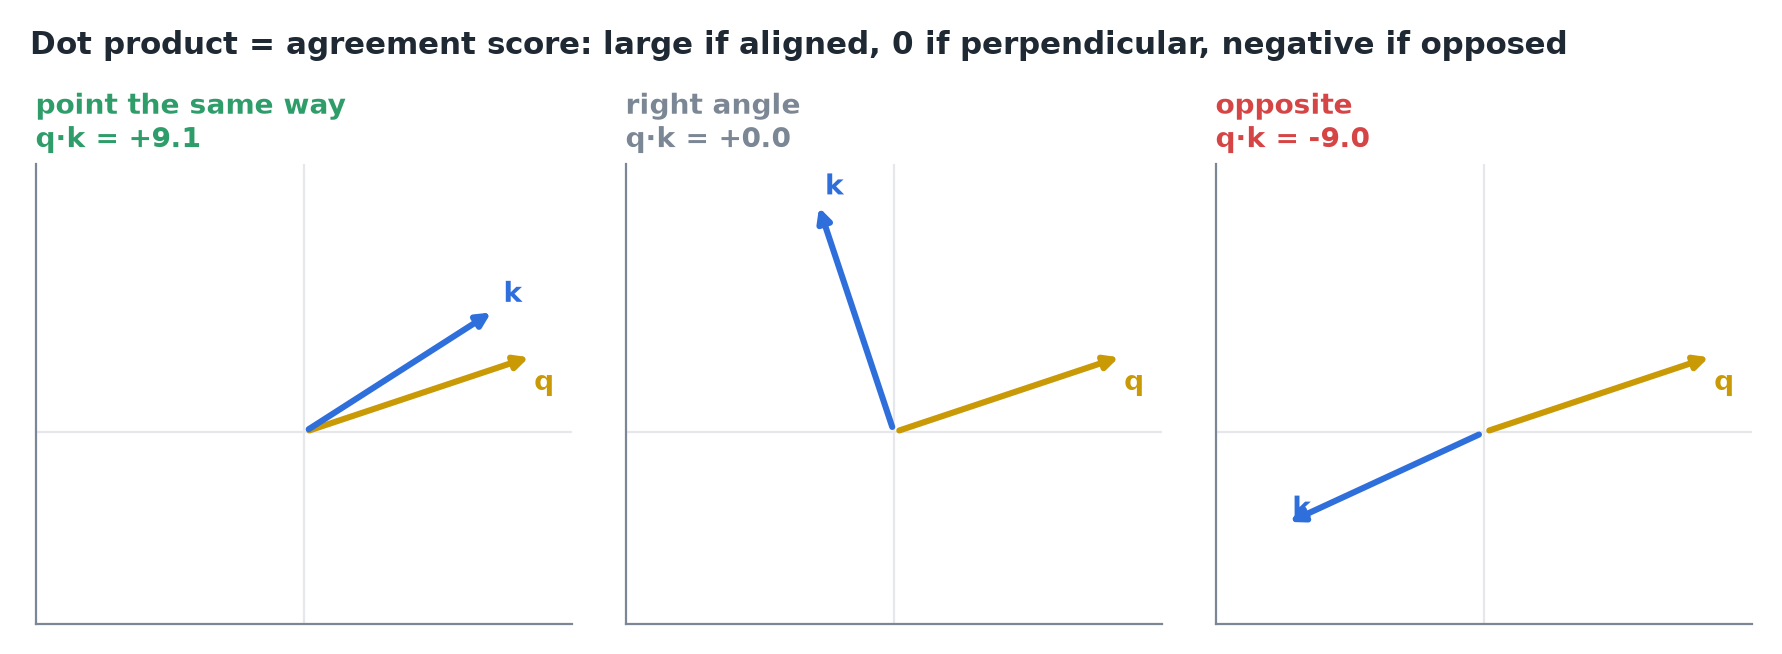 Hai vector cùng hướng cho điểm dương lớn, vuông góc cho 0, ngược hướng cho điểm âm.
- Attention dùng nó làm điểm liên quan: query của token hiện tại hỏi, key của từng token trước đó trả lời, và q·k cho biết hai bên khớp nhau tới đâu.
Vì sao chia cho √128
Nếu các phần tử của query và key là ngẫu nhiên với trung bình 0 và phương sai 1, thì tích vô hướng của chúng có phương sai = độ dài vector (chú thích trong Attention Is All You Need). Với 128 số, điểm trải rộng tới khoảng ±11, và softmax dồn gần như toàn bộ trọng số vào một token: attention thôi pha trộn mà chỉ chọn một.
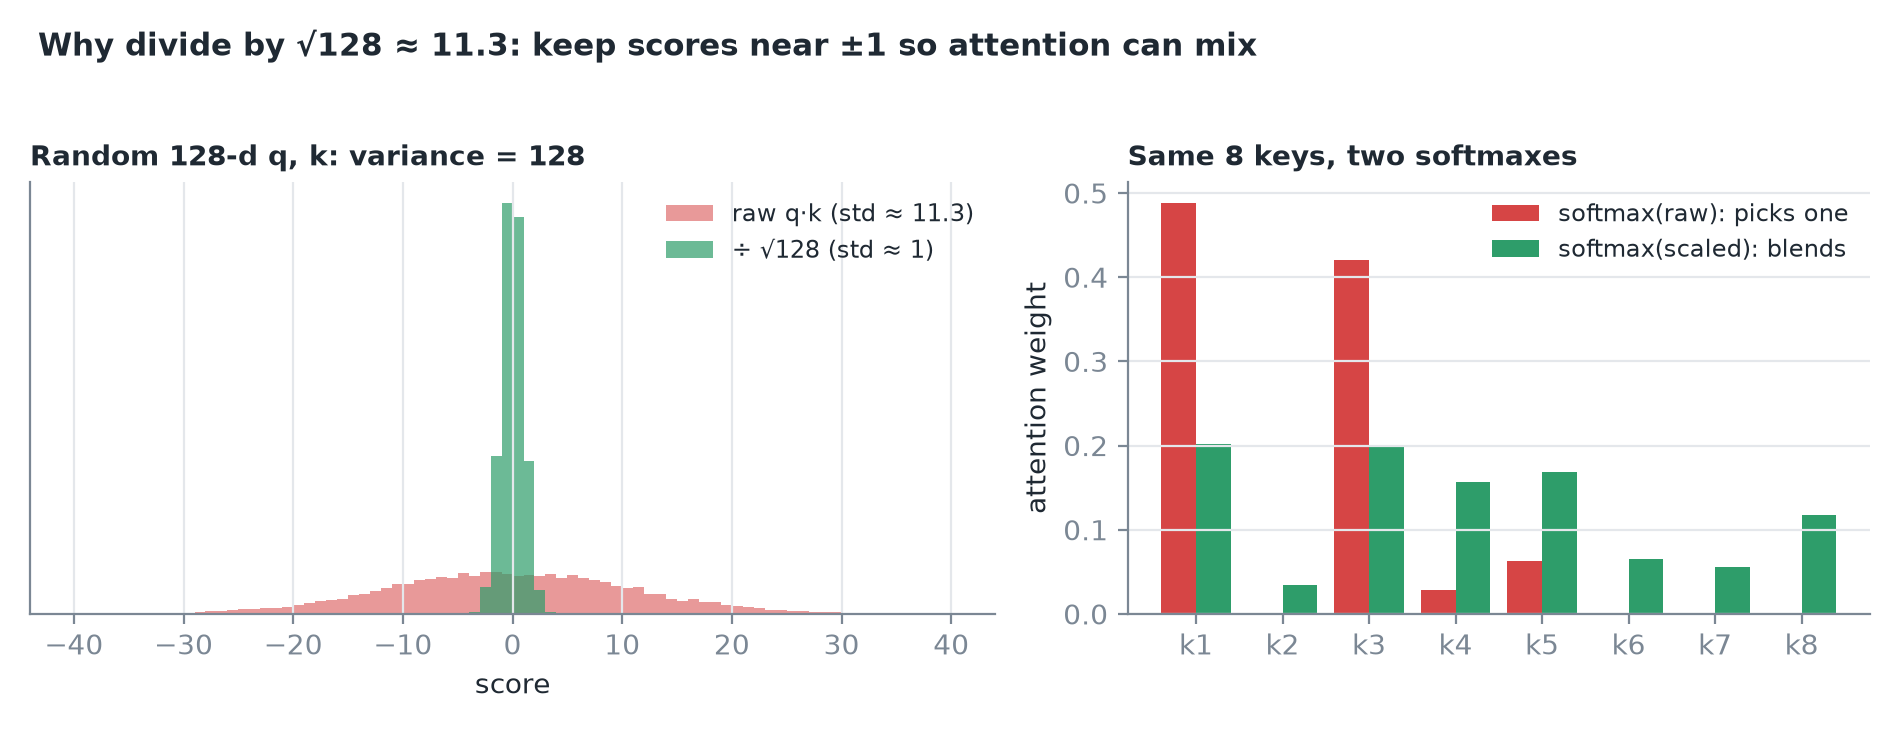 Mô phỏng: điểm thô trải ±11 và softmax chọn ra một token thắng; chia cho √128 ≈ 11,3 đưa điểm về ±1 và các trọng số được pha trộn.
Mẹo
Với inference, phép chia tỷ lệ gần như miễn phí: một phép nhân cho mỗi điểm, và kernel nhanh gộp nó vào phần việc vốn đã phải làm.
2. Softmax: biến điểm thành trọng số
Softmax làm cho các điểm dương và có tổng bằng 1: lấy e mũ từng điểm, rồi chia cho tổng.
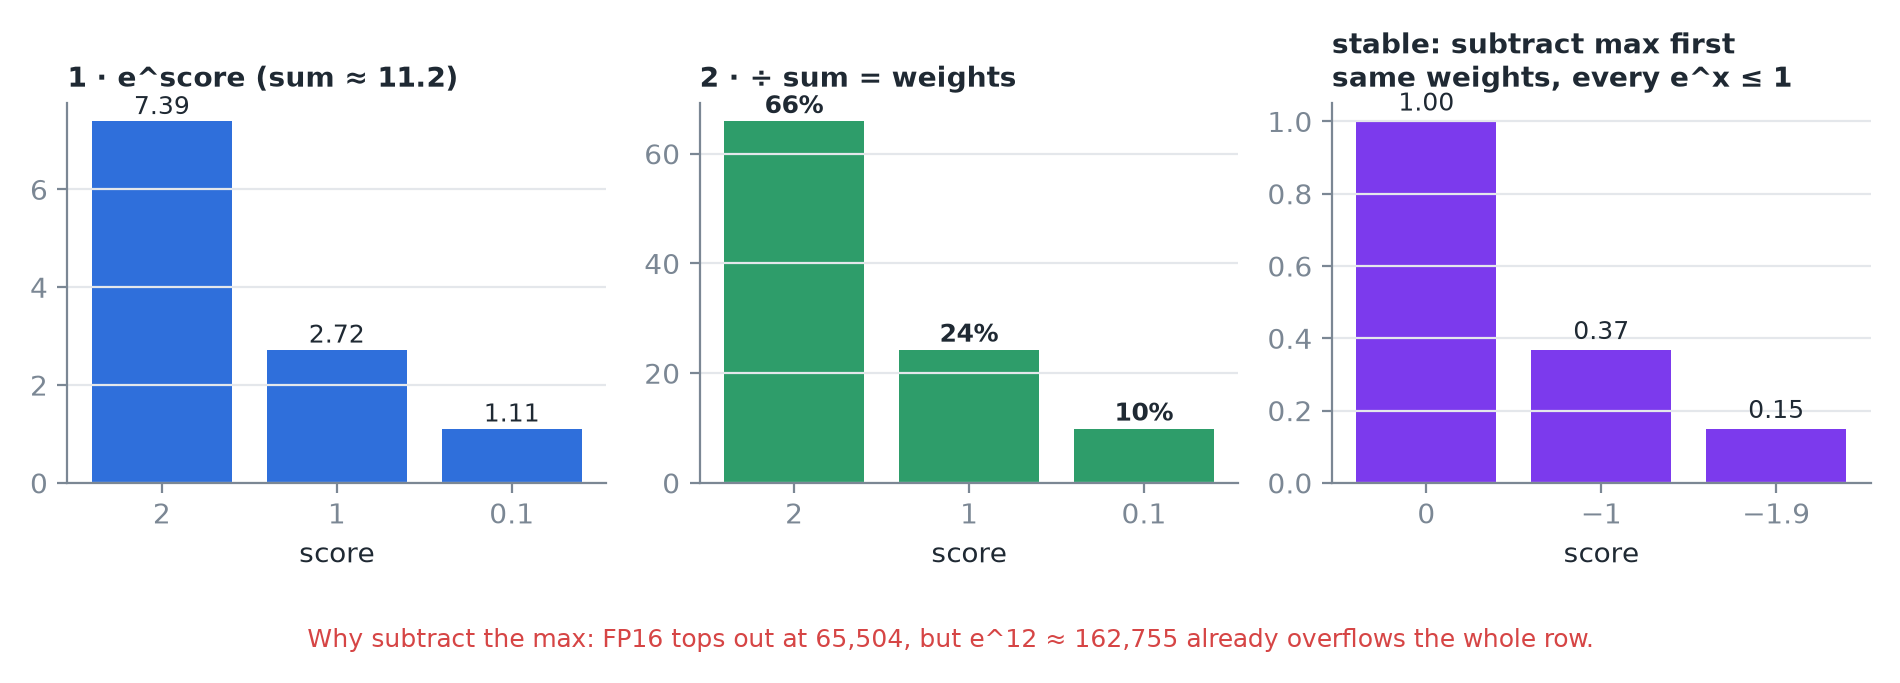 Điểm 2; 1; 0,1 → e^x ≈ 7,39; 2,72; 1,11 (tổng ≈ 11,2) → 66%, 24%, 10%. Điểm lớn nhất nhận nhiều nhất, nhưng không điểm nào bằng 0.
- Bẫy tràn số: giá trị lớn nhất của FP16 là 65.504, nhưng e¹² ≈ 162.755. Chỉ một điểm lớn cũng biến cả hàng thành rác.
- Cách sửa: trừ đi giá trị lớn nhất của hàng trước (2; 1; 0,1 → 0; −1; −1,9). Trọng số không đổi, và mọi lũy thừa đều ≤ 1.
Quan trọng
Softmax cần max và tổng của cả hàng trước khi bất kỳ trọng số nào được chốt. Điều này quyết định cách xây mọi kernel attention nhanh (mục 6).
3. Một head, một token mới
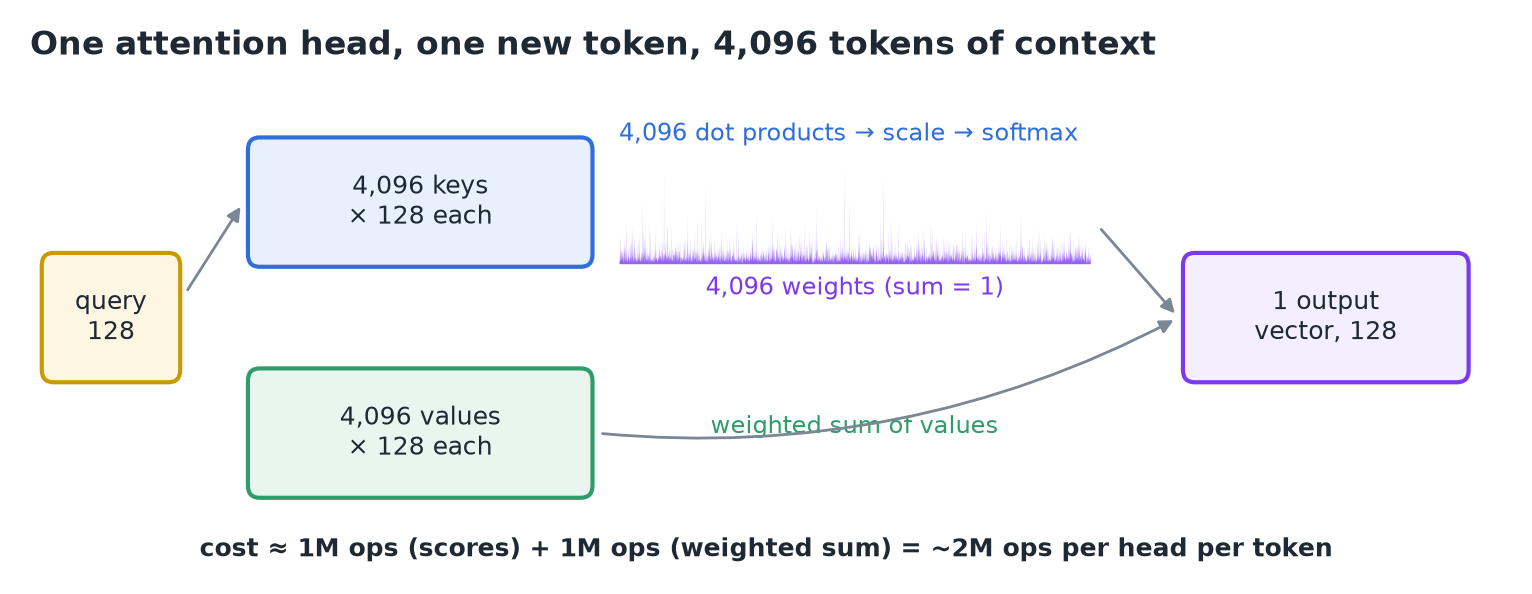 Query · 4.096 key → chia tỷ lệ → softmax → tổng có trọng số của 4.096 value → một bản tóm tắt 128 số về cuộc hội thoại, nhìn từ token mới.
Khối lượng: ~1 triệu phép tính cho điểm + ~1 triệu cho tổng có trọng số = ~2 triệu phép tính mỗi head.
4. Hóa đơn cho một token: phép tính so với byte
Nhân lên toàn model: 32 layer × 32 query head × 4.096 = 4.194.304 tích vô hướng ≈ 2,1 tỷ phép tính. Các ma trận trọng số tốn ~15 tỷ phép tính mỗi token, nên ở độ dài context này phần số học của attention chỉ chiếm ~1/8.
2,1 tỷ đến từ đâu: hai nửa bằng nhau, phần tính điểm và phần tổng có trọng số của value (chia tỷ lệ và softmax chỉ thêm vài triệu).
~15 tỷ đến từ đâu: mỗi trọng số làm một phép nhân và một phép cộng cho mỗi token, tức ~2 phép tính trên mỗi tham số. Bảng embedding đầu vào ~0,5 tỷ tham số (vocab 128.256 × 4.096) chỉ là phép tra bảng chứ không phải nhân ma trận, nên chỉ ~7,5 tỷ tham số thực sự làm việc:
Giờ đếm byte. Llama 3 dùng grouped-query attention (GQA): 32 query head chỉ dùng chung 8 bộ key và value.
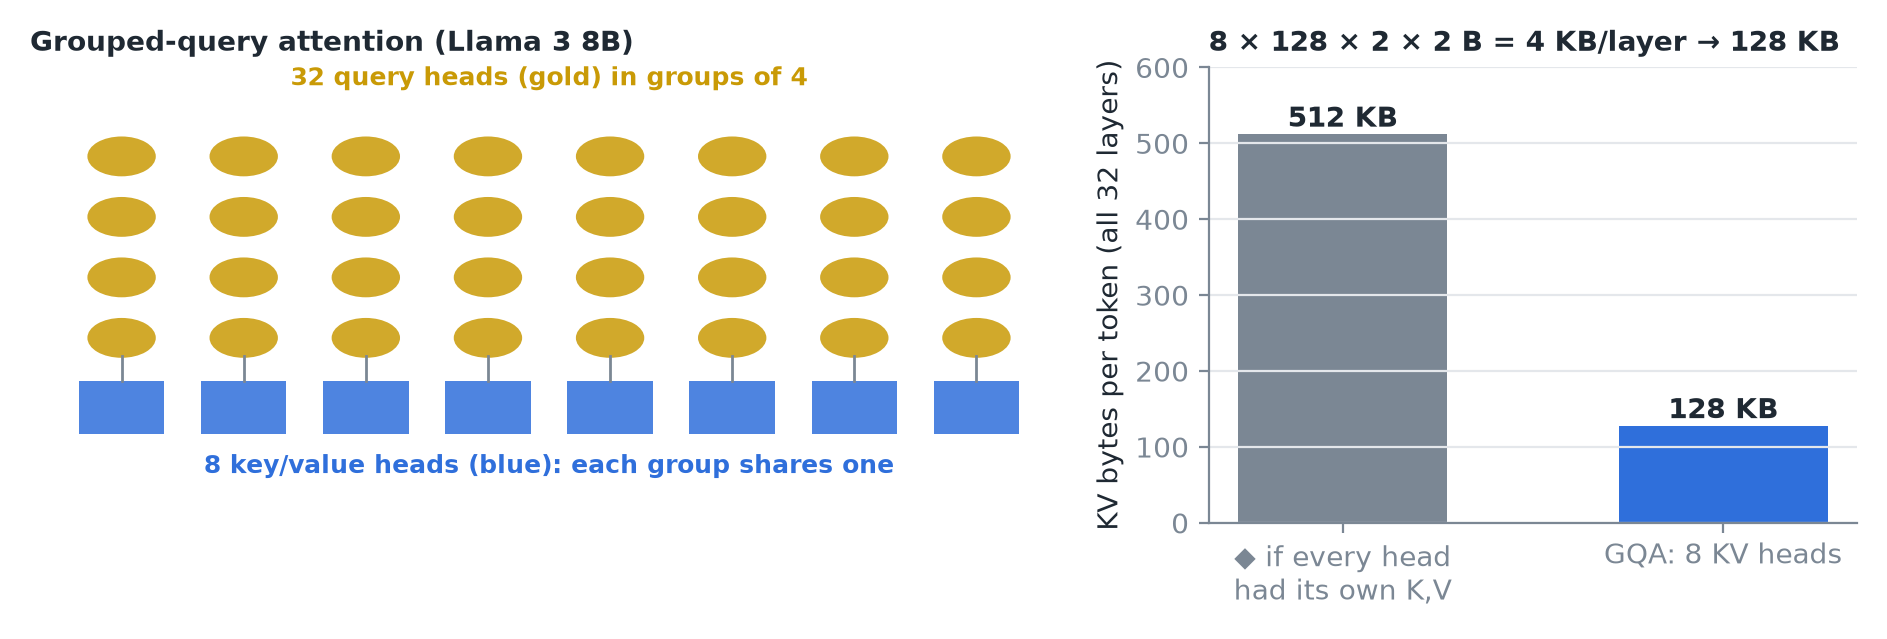 Bốn query head dùng chung mỗi K/V head, nên mỗi layer lưu 8 key + 8 value cho mỗi token.
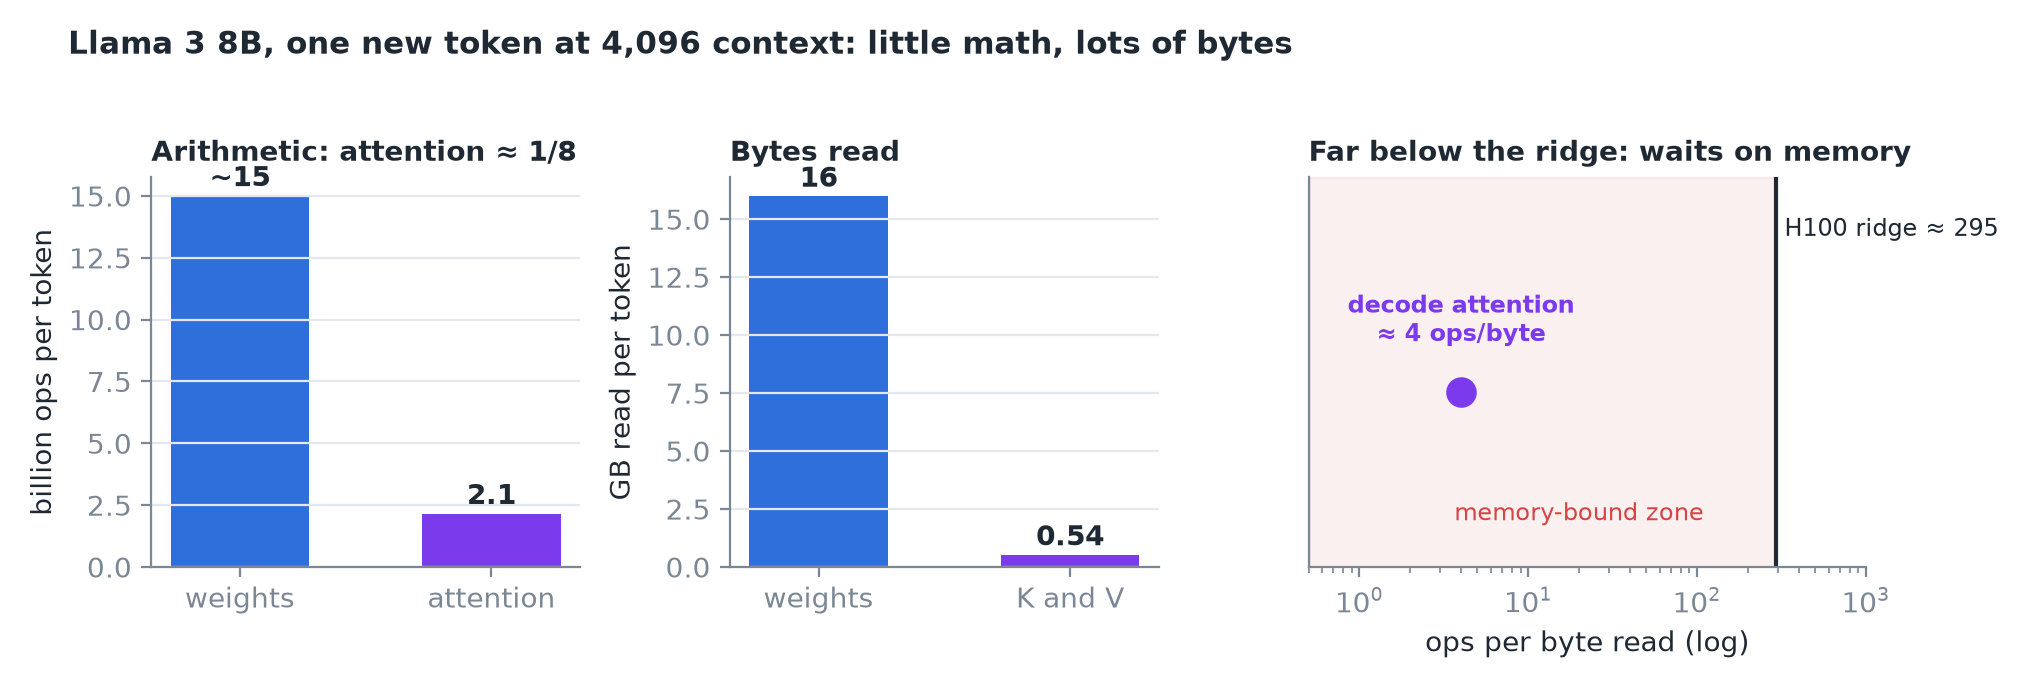 2,1 tỷ phép tính trên ~0,54 tỷ byte ≈ 4 phép tính/byte; H100 cần ~295 (989 TFLOPS ÷ 3,35 TB/s) để giữ các đơn vị tính toán luôn bận.
Quan trọng
Bốn còn cách rất xa 300: attention ở pha decode dành gần hết thời gian để chờ bộ nhớ.
5. Hóa đơn bộ nhớ ngày càng lớn
- Trọng số: cố định 16 GB, mỗi bước đọc một lần dù cuộc hội thoại dài bao nhiêu.
- Key và value: +128 KB mỗi token, cho từng người dùng.
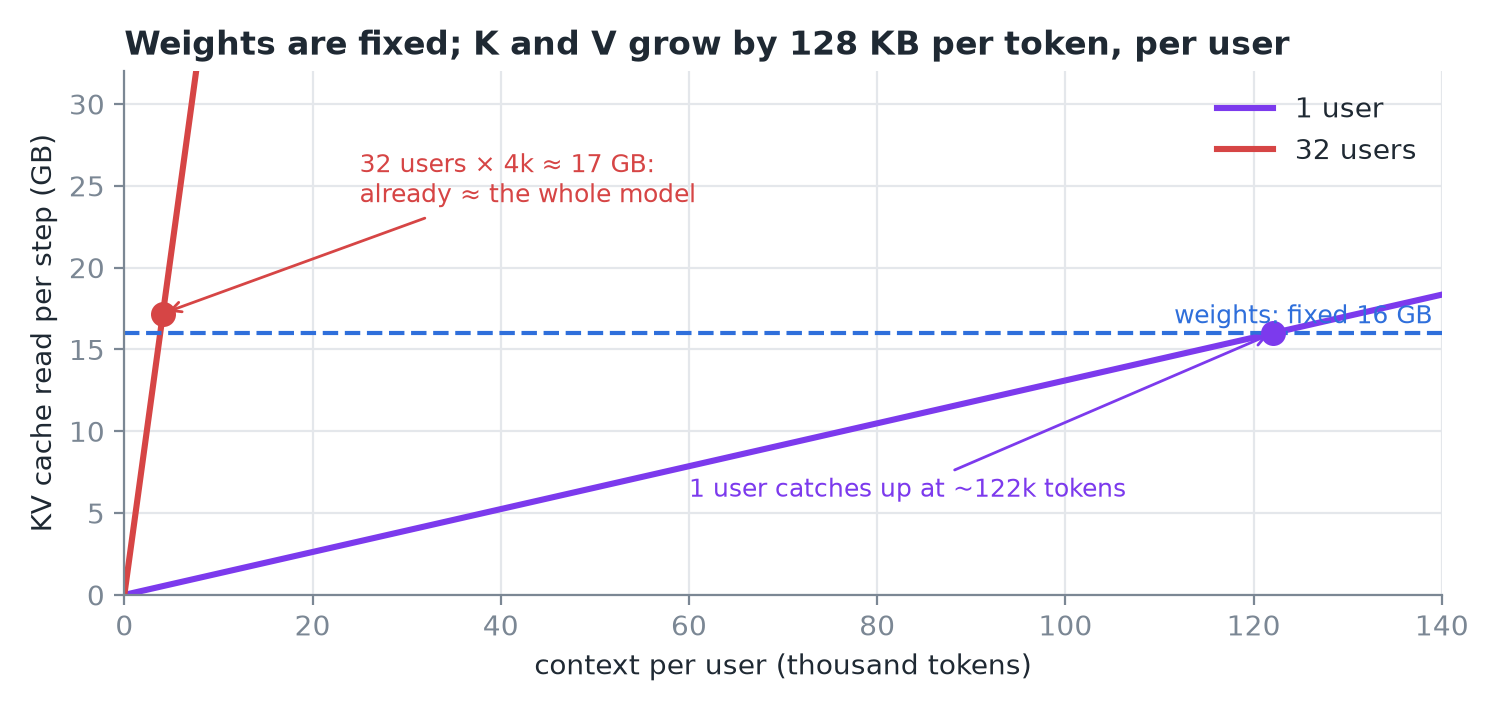 K/V của một người dùng đuổi kịp trọng số ở ~120k token; 32 người dùng mỗi người 4k token đã chiếm ~17 GB.
Prefill gặp vấn đề khác: mọi token của prompt cùng lúc là query, nên ma trận điểm là một hình vuông n × n.
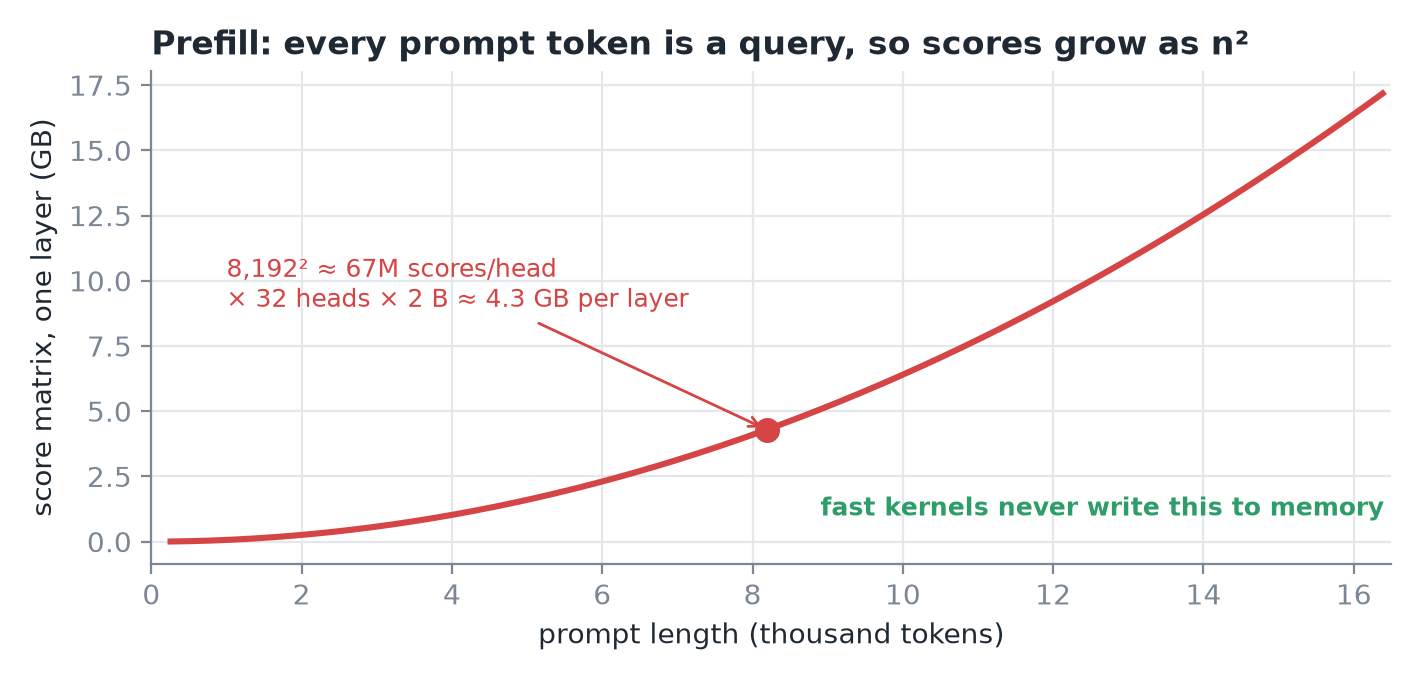 Prompt 8.192 token: ~67 triệu điểm mỗi head; × 32 head × 2 byte ≈ 4,3 GB bộ nhớ tạm cho mỗi layer.
6. Online softmax: không bao giờ ghi ra hình vuông
Các kernel attention nhanh duyệt key theo từng khối và giữ một max chạy dần và tổng chạy dần. Khi khối mới làm max tăng lên, nhân tổng cũ với e^(max cũ − max mới), rồi cộng thêm các số hạng mới.
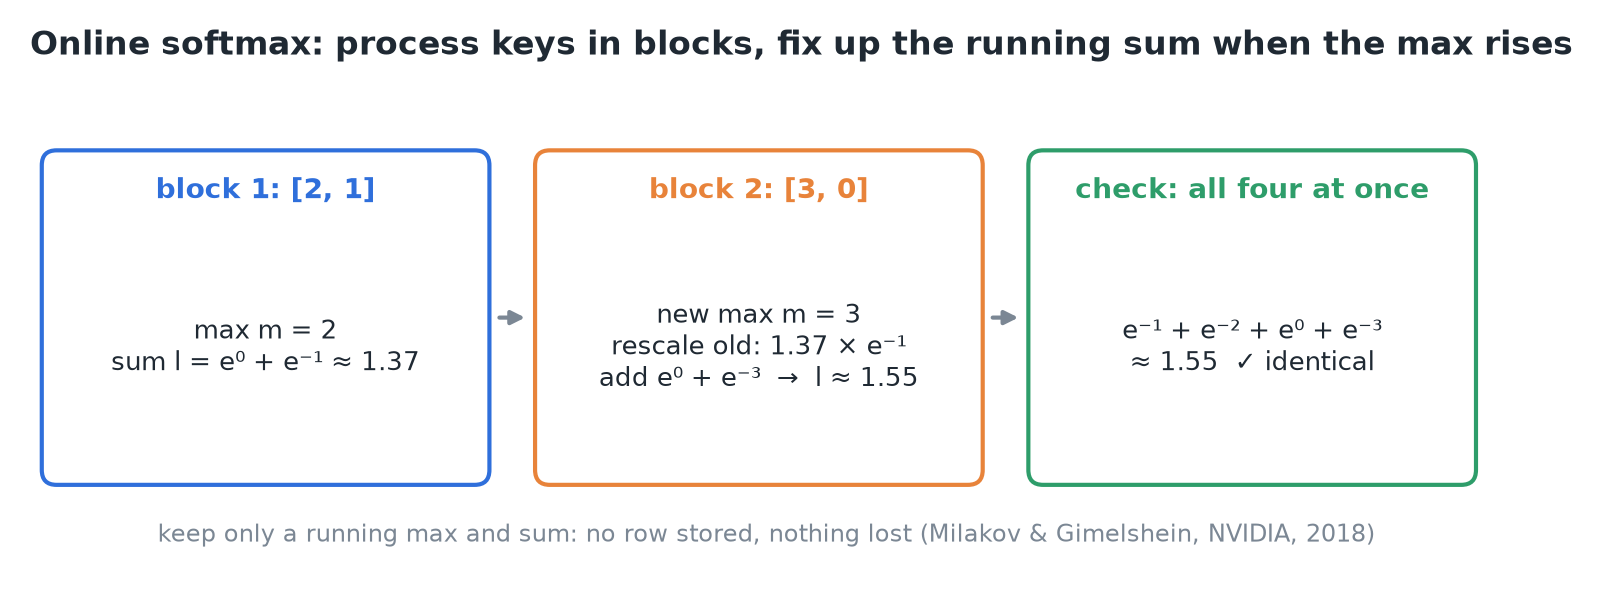 Khối [2, 1] rồi [3, 0] cho tổng chạy dần ~1,55, đúng bằng kết quả tính trên cả hàng. Không lưu gì, không mất gì.
Đây là online softmax (hai kỹ sư NVIDIA, 2018), nền móng của FlashAttention; module về attention xây tiếp trên nó.
7. Hai hiểu lầm
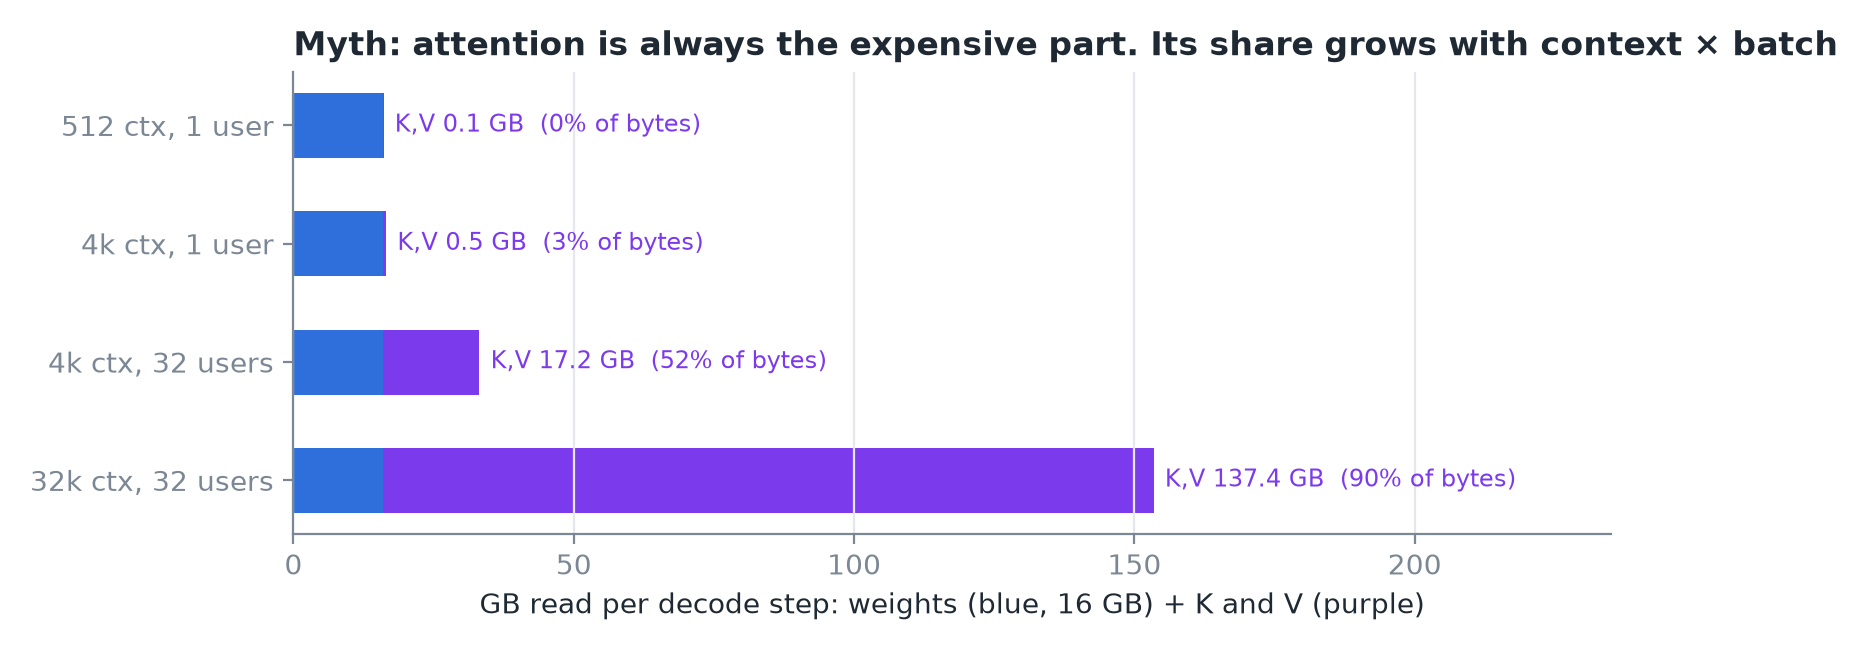 Ở context ngắn và batch nhỏ, trọng số chiếm phần lớn số byte; tỷ trọng của attention tăng theo context × batch, chủ yếu qua bộ nhớ.
Cảnh báo
- "Attention lúc nào cũng là phần đắt nhất": không đúng ở context ngắn và batch nhỏ.
- "Softmax rẻ nên không quan trọng": phần số học thì rẻ, nhưng việc cần cả hàng định hình mọi kernel nhanh.
8. Tóm tắt