45 · Chunked prefill và chọn kích thước chunk
Nguồn: fanout.sh / inference-eng / 10-02 · ~5,5 phút
Ghi chú
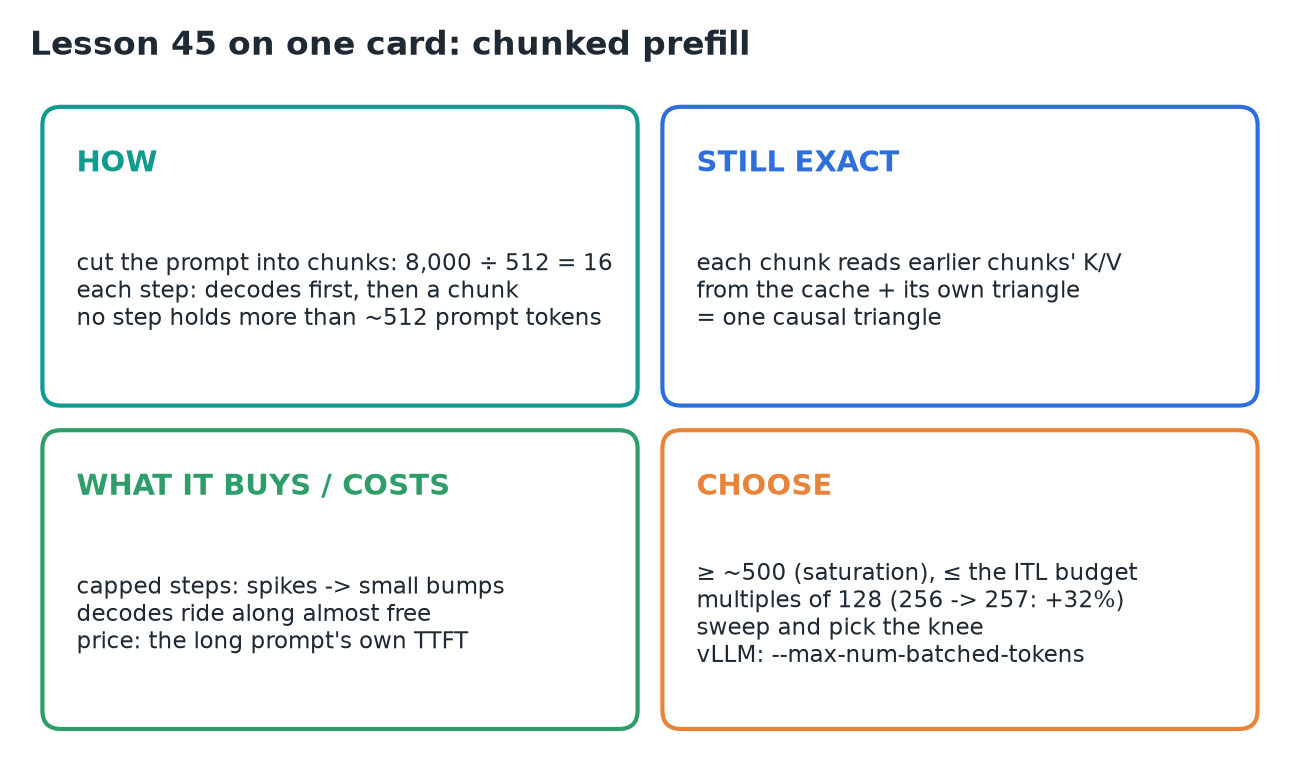
Đừng xử lý một prompt dài trong một bước: cắt nó thành chunk và trải ra nhiều bước, với token decode của mọi request đang chạy được lập lịch trước. Một prompt 8.000 token chia chunk 512 mất 16 bước, và không bước nào chứa quá ~512 token prompt. Attention mask theo chunk làm nó tương đương tuyệt đối với một lượt prefill lớn. Các bước bị giới hạn, nên đỉnh ITL co lại thành những gợn nhỏ, và decode đi nhờ gần như miễn phí; cái giá là TTFT của chính prompt dài đó. Chunk quá nhỏ làm phí GPU (64 token ≈ prefill chậm hơn 5 lần), và chunk quá lớn mang các đỉnh nhọn trở lại: giữ ≥ ~500, dưới ngân sách ITL của bạn, theo bội số của 128, rồi quét và chọn điểm gãy.
1. Cách nó hoạt động
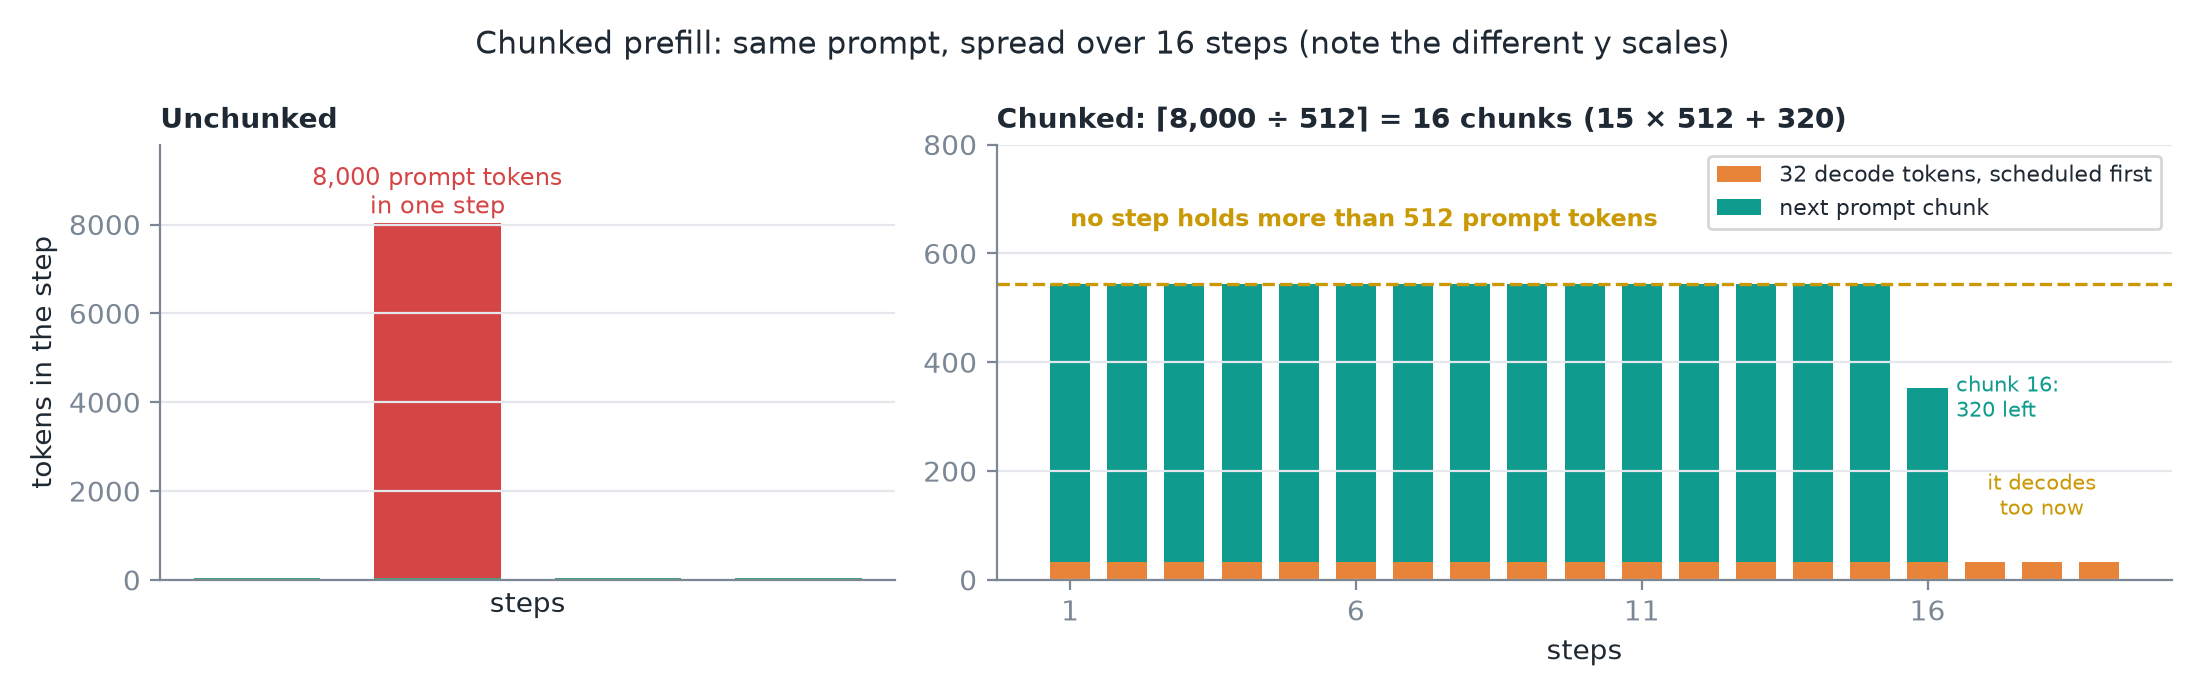 Số token mỗi bước. Chunk cuối chứa 320 token còn lại; sau đó prompt bắt đầu decode như mọi request khác.
- Dựng mọi bước theo cùng một cách: trước hết, mọi request đang chạy nhận một token decode; rồi lấp đầy phần còn lại của bước bằng chunk kế tiếp của prompt dài.
- Mười sáu bước sau, prompt được xử lý xong. Không bước nào dài cả.
2. Vì sao nó vẫn đúng tuyệt đối
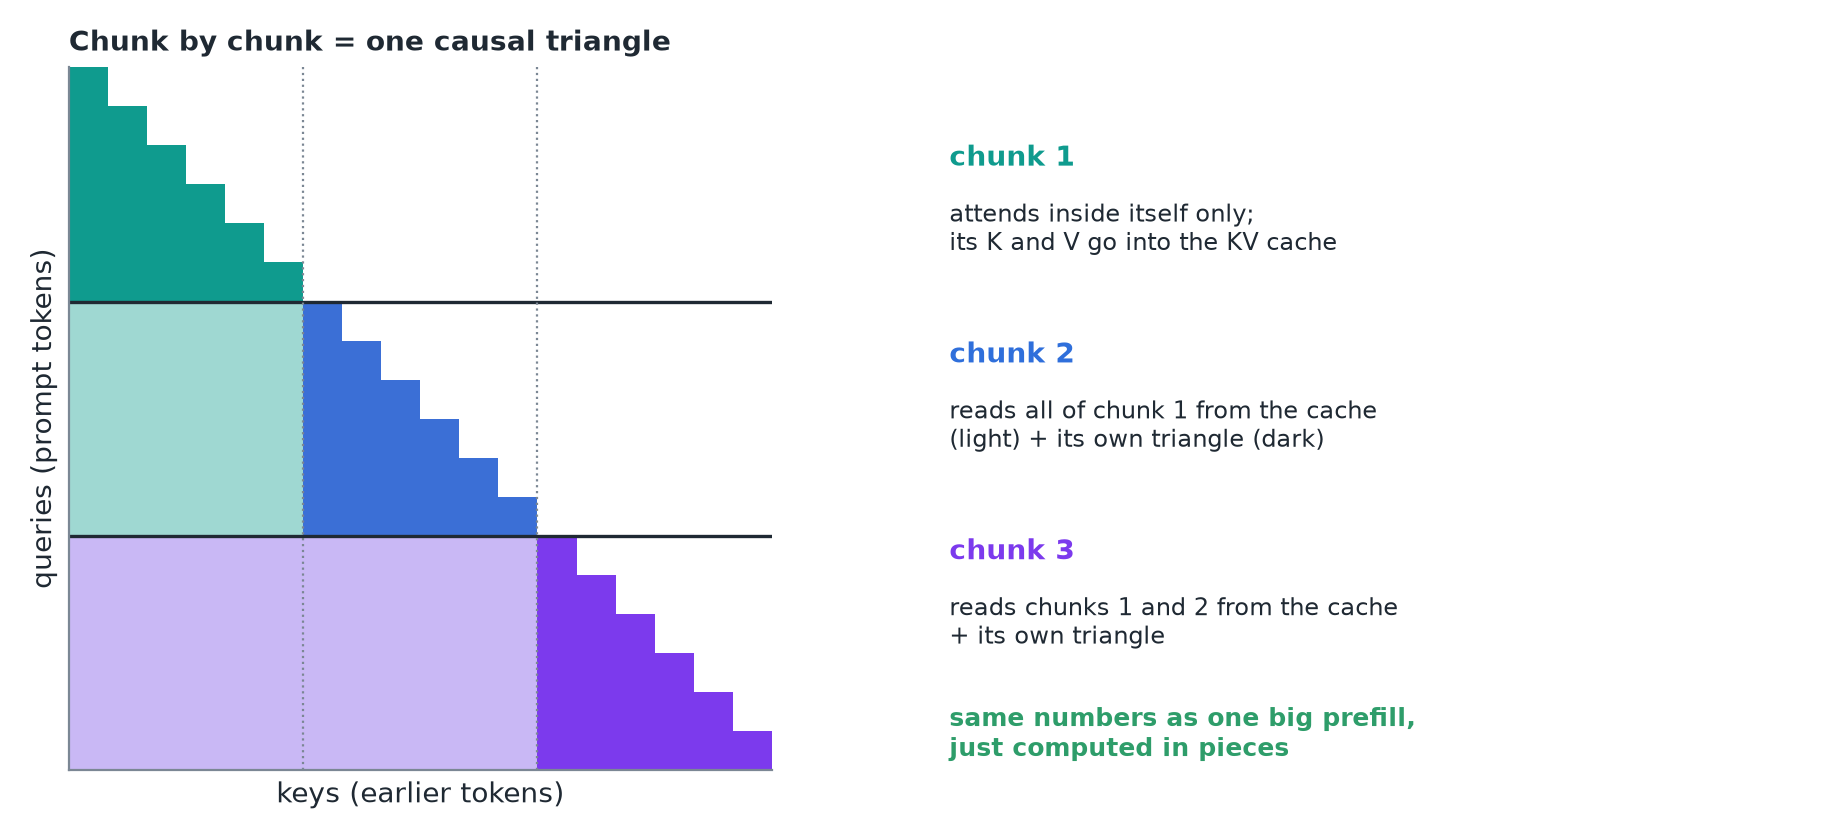 Ba chunk mỗi chunk sáu token. Ô nhạt là key được đọc lại từ KV cache.
- Token của chunk 1 attend vào các token trước nó bên trong chunk 1; K và V của nó sau đó được lưu vào KV cache.
- Chunk 2 attend vào toàn bộ chunk 1 (đọc từ cache) cộng các token trước nó trong chunk 2. Chunk 3 thấy chunk 1 và 2, và cứ thế.
- Ghép lại, đó là cùng một tam giác causal như khi xử lý prompt một lần: cùng những con số, chỉ tính theo từng mảnh.
3. Được gì, và mất gì
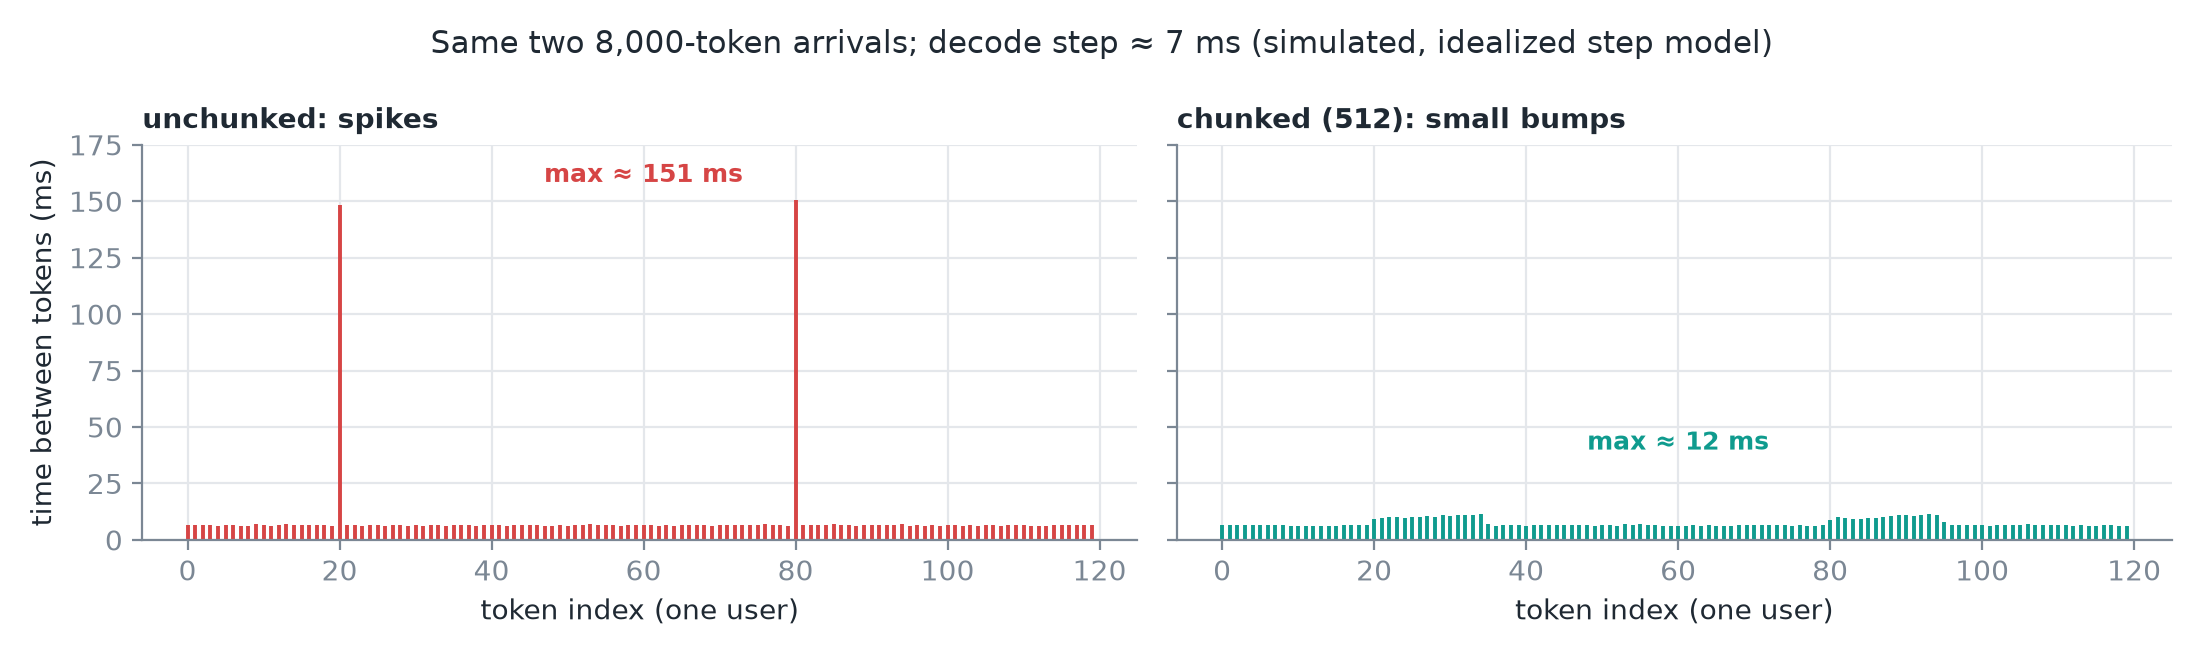 ◆ Mô phỏng với mô hình bước lý tưởng hoá (Llama 3.1 8B trên H100, 32 decode): đỉnh ~150 ms thành gợn ~12 ms.
- Mỗi bước bị giới hạn, nên các đỉnh ITL khổng lồ co lại thành những gợn nhỏ.
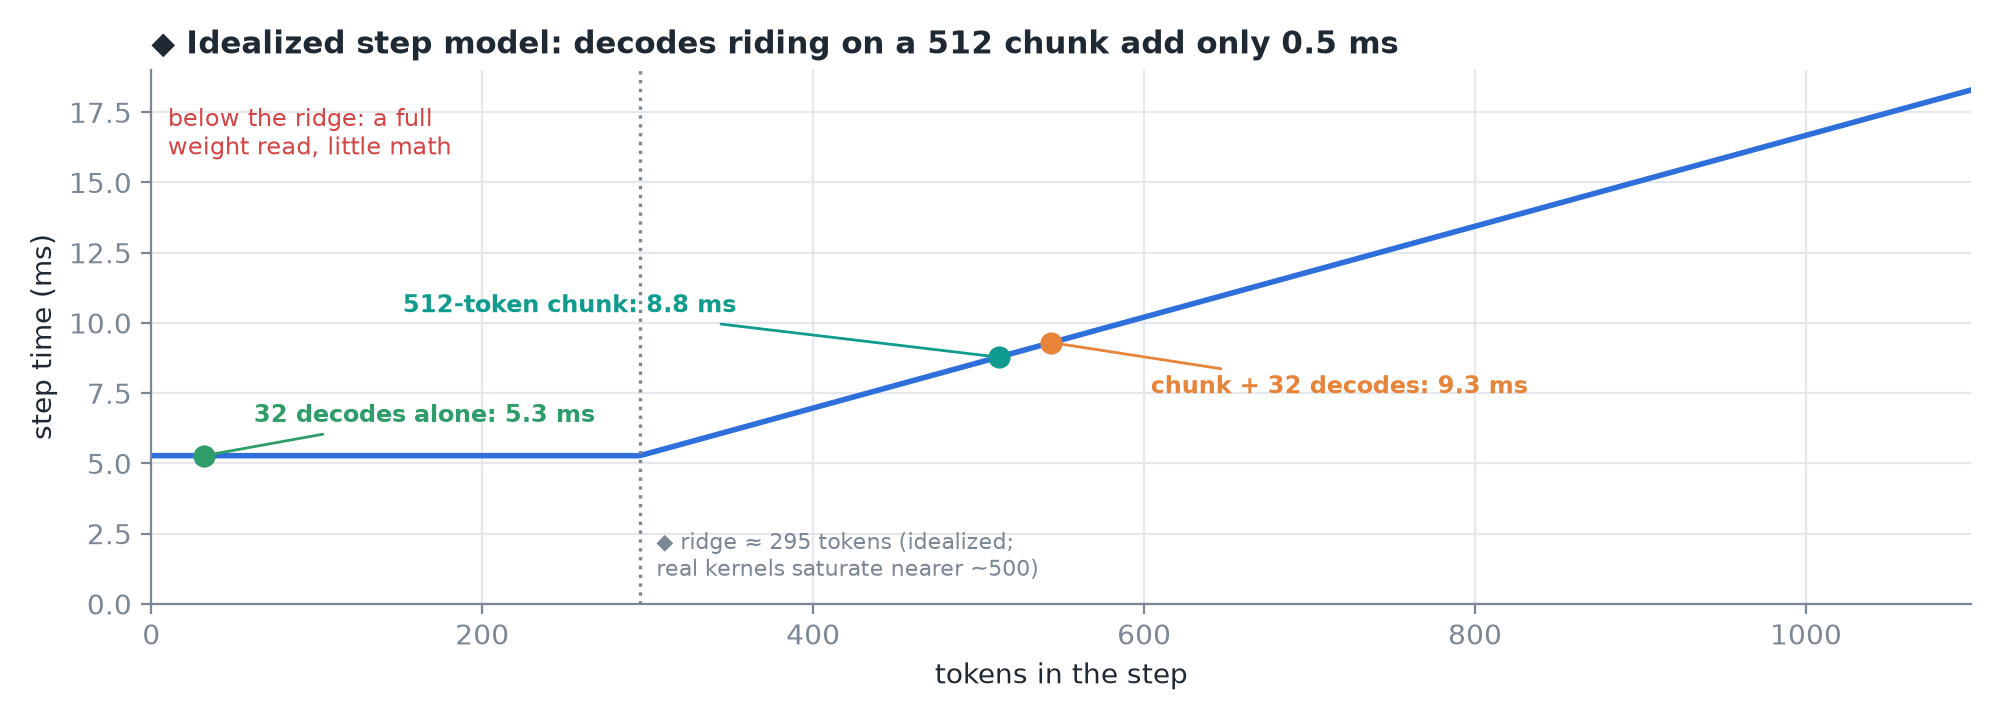 ◆ Cùng mô hình lý tưởng hoá: thời gian bước là cái chậm hơn giữa đọc trọng số và làm phép tính.
- Phần thưởng: một chunk ~500 token đã giữ các đơn vị tính toán bận rộn, nên các token decode đi kèm gần như không tốn thêm gì. Chúng đi nhờ (piggyback) trên phần việc GPU vốn đang làm.
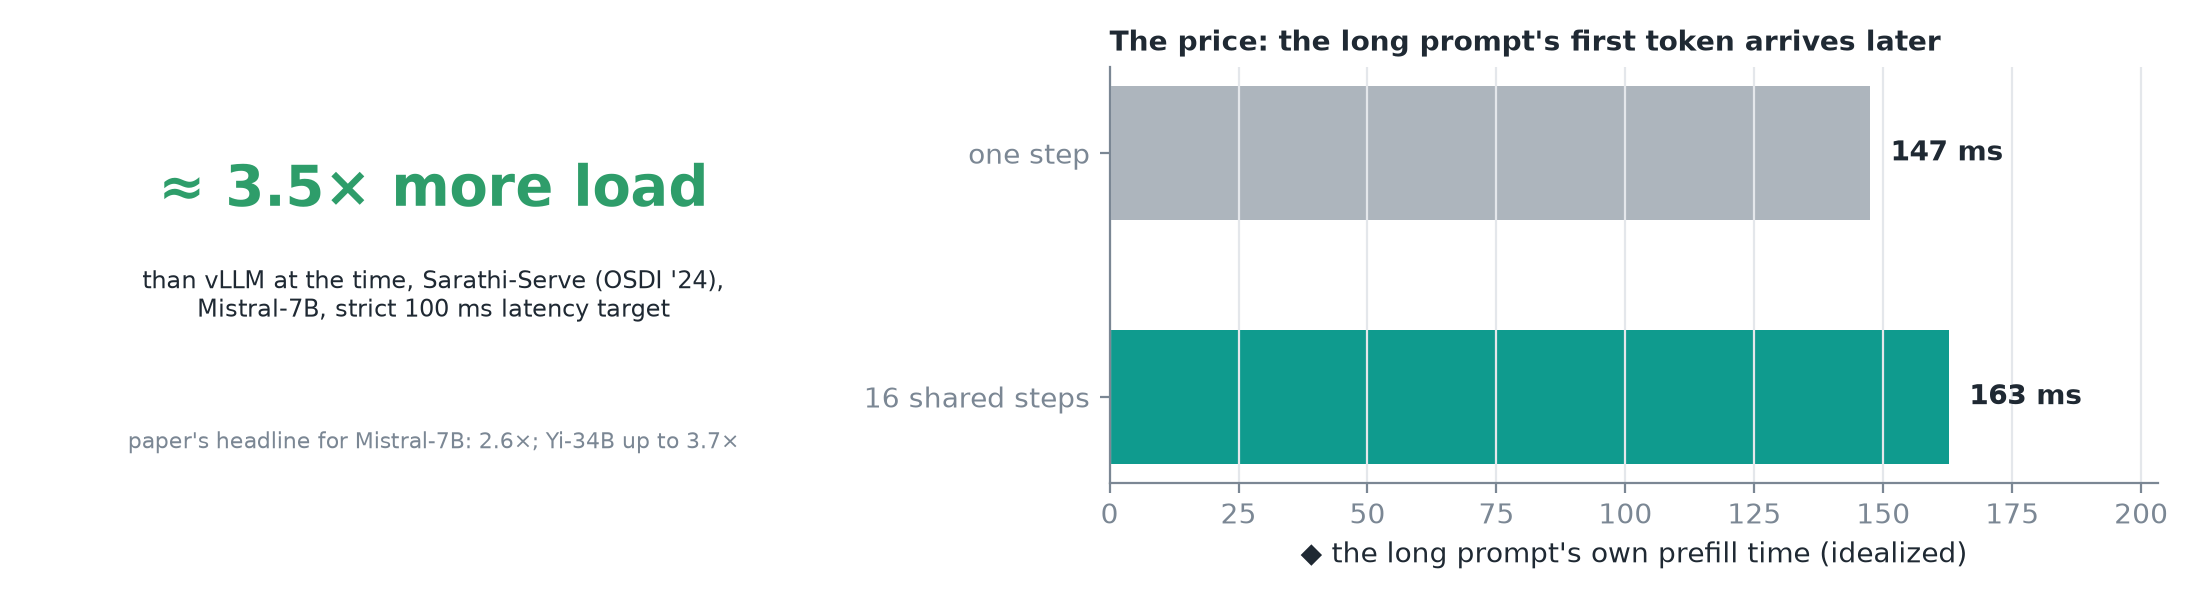 ◆ Thời gian prefill lấy từ mô hình lý tưởng hoá; bài học chỉ nói "muộn hơn một chút".
- Sarathi-Serve, nơi phổ biến cách tiếp cận này, phục vụ được tải nhiều hơn ≈ 3,5 lần so với vLLM thời đó (Mistral-7B, mục tiêu latency chặt 100 ms). Phần tóm tắt của paper ghi 2,6 lần cho Mistral-7B và tới 3,7 lần cho Yi-34B; 3,5 lần có lẽ là thanh của một workload cụ thể.
- Cái giá do chính prompt dài trả: prefill của nó trải qua 16 bước dùng chung với người khác, nên token đầu tiên của nó đến muộn hơn một chút.
4. Sao không dùng chunk thật nhỏ?
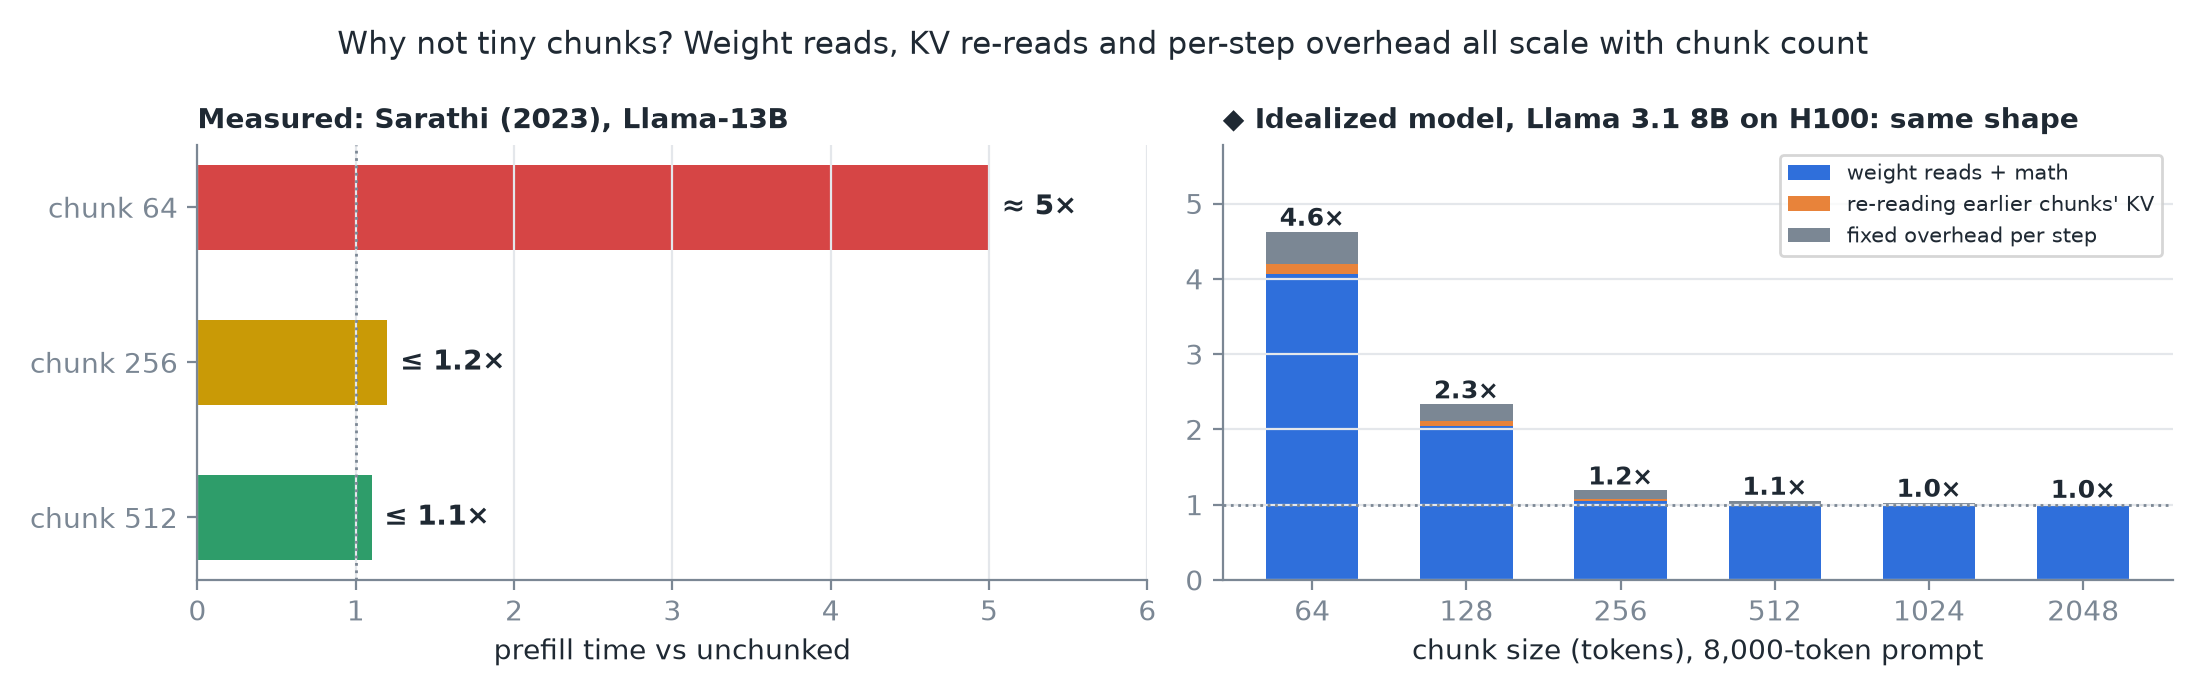 Trái: Sarathi (2023), Llama-13B. ◆ Phải: mô hình lý tưởng hoá của tôi cho cùng hình dạng, 4,6 lần ở 64 token; với prompt 8k, việc đọc lại trọng số chiếm ưu thế.
Ba lý do:
- Chunk nhỏ để GPU ngồi không. Dưới vài trăm token, một bước bị giới hạn bởi việc đọc trọng số: bạn trả tiền cho một lần đọc trọn vẹn mà làm được ít việc.
- Mỗi chunk đọc lại K/V của mọi chunk trước nó. Chunk 2 đọc chunk 1, chunk 3 đọc 1 và 2, và cứ tăng mãi: càng nhiều chunk, càng đọc lại nhiều.
- Overhead cố định mỗi bước: lập lịch và launch kernel.
Trong các thí nghiệm Sarathi gốc, chunk 64 làm prefill chậm hơn khoảng 5 lần; 256 và 512 chỉ chậm trong khoảng 20% và 10%.
5. Chọn kích thước chunk
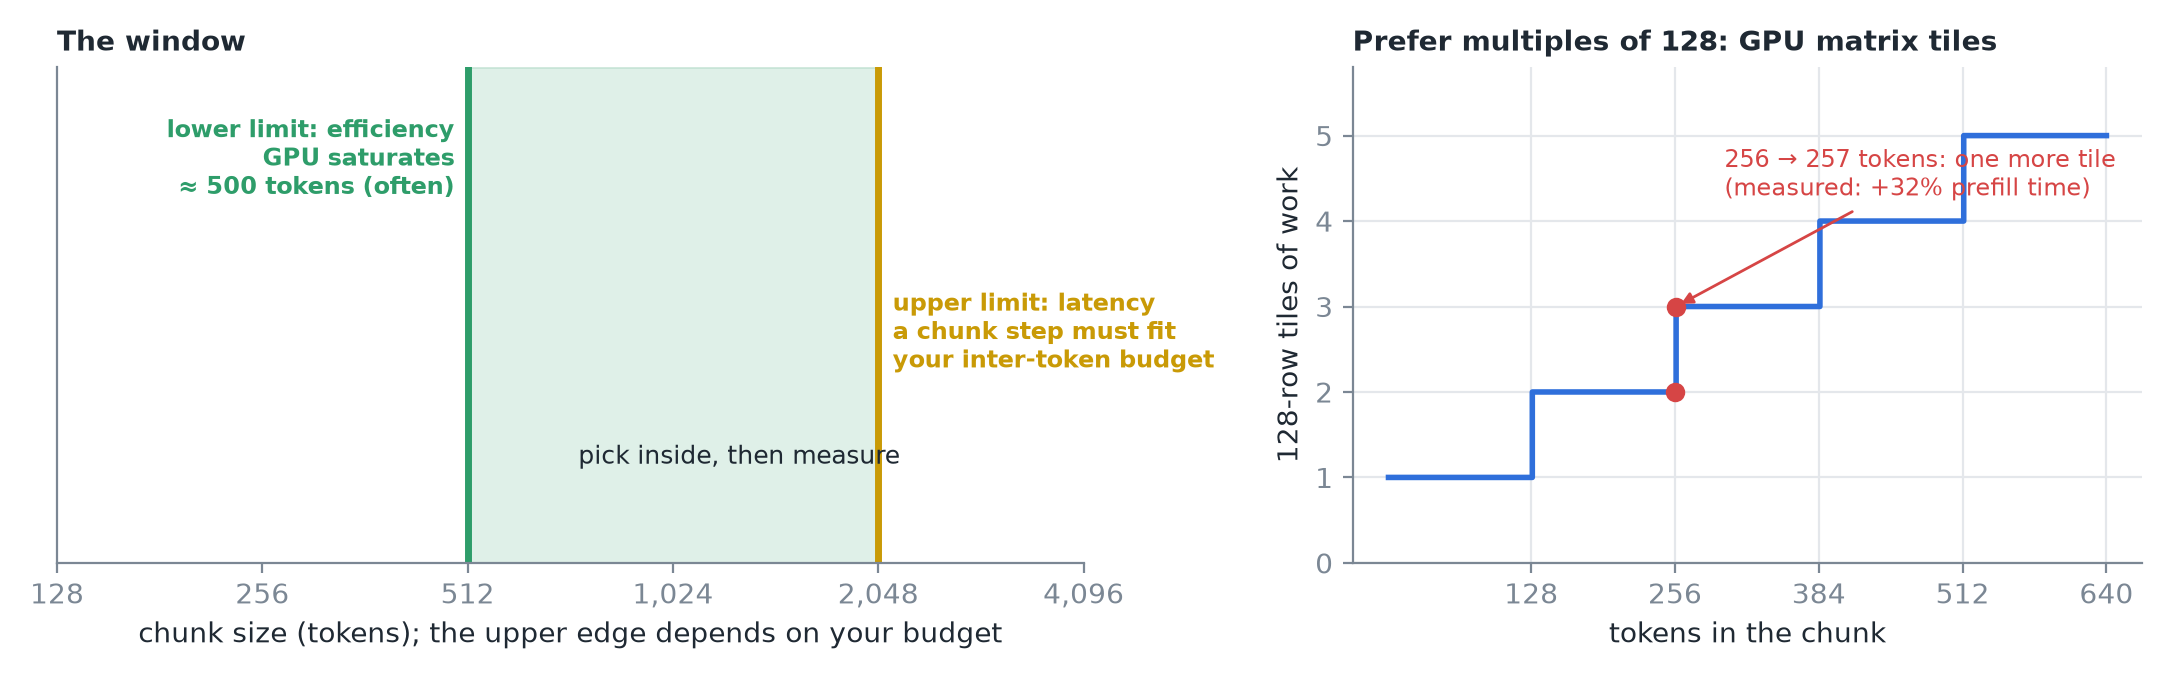 Cận trên 2.048 mang tính minh hoạ; của bạn đến từ ngân sách ITL của bạn.
- Cận trên, từ latency: bước mang một chunk vẫn phải xong trong ngân sách inter-token của bạn.
- Cận dưới, từ hiệu quả: giữ ở mức bằng hoặc trên điểm GPU bão hoà, thường khoảng 500 token.
- Ưu tiên bội số của 128: tile ma trận của GPU có kích thước đó. Một nghiên cứu thấy 256 → 257 token làm prefill chậm hơn 32%.
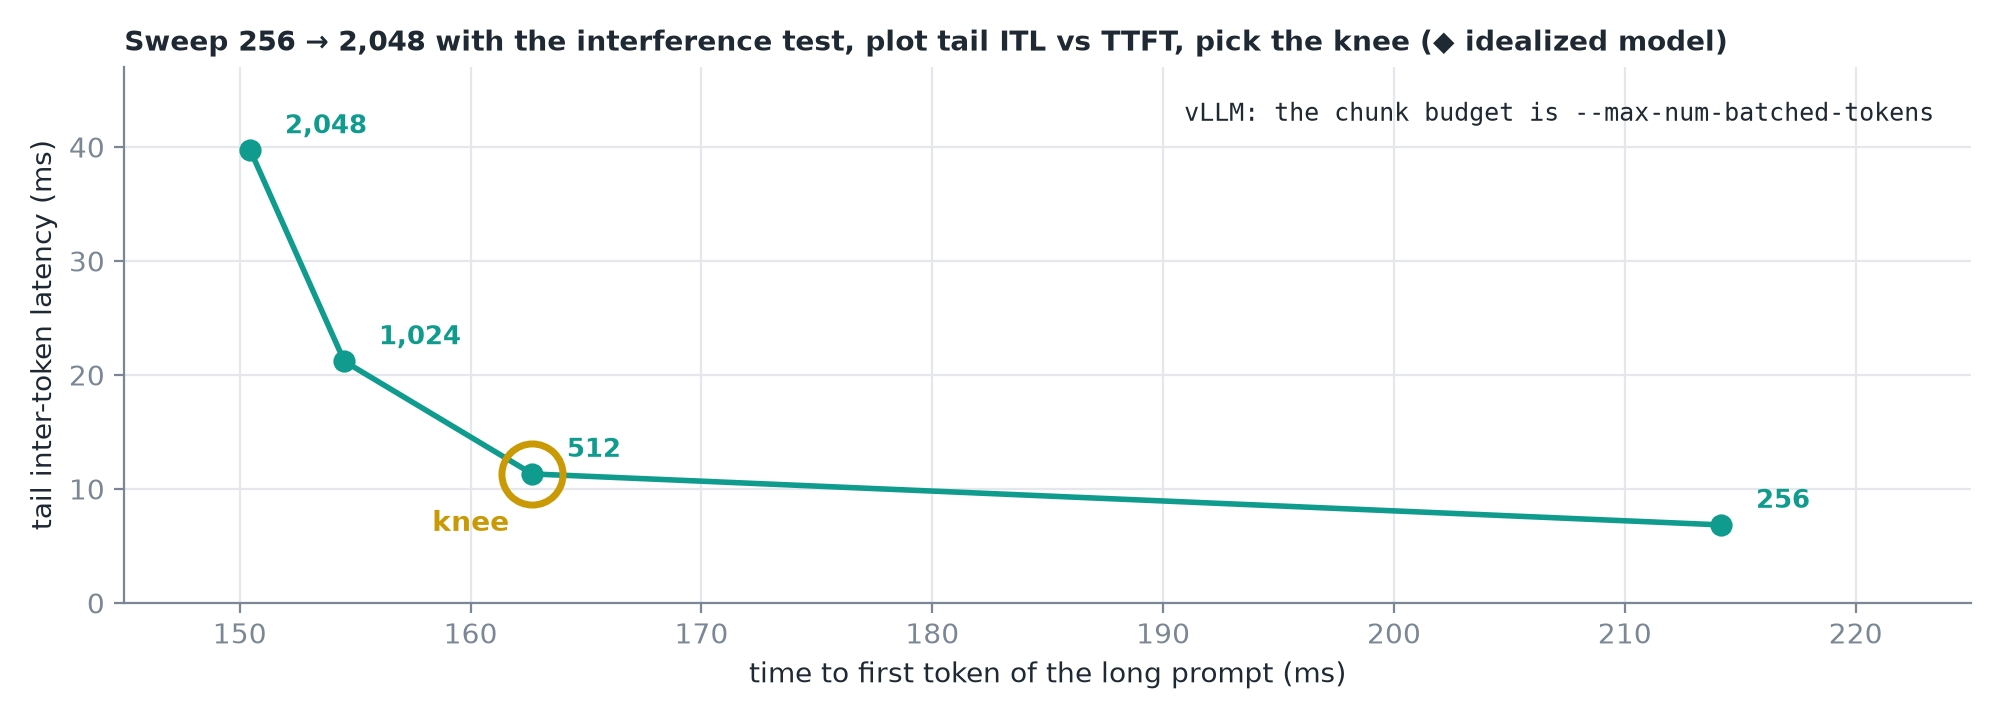 ◆ Các điểm lấy từ mô hình lý tưởng hoá; trên phần cứng thật thì hãy đo.
- Rồi đo: chạy lại bài test nhiễu do prompt dài với kích thước chunk từ 256 tới 2.048, vẽ ITL phần đuôi theo TTFT, và chọn điểm gãy.
- Trong vLLM, ngân sách chunk là
--max-num-batched-tokens.
6. Tóm tắt