31 · Theo chân một request đi qua vLLM
Nguồn: fanout.sh / inference-eng / 06-05 · ~5,5 phút
Ghi chú
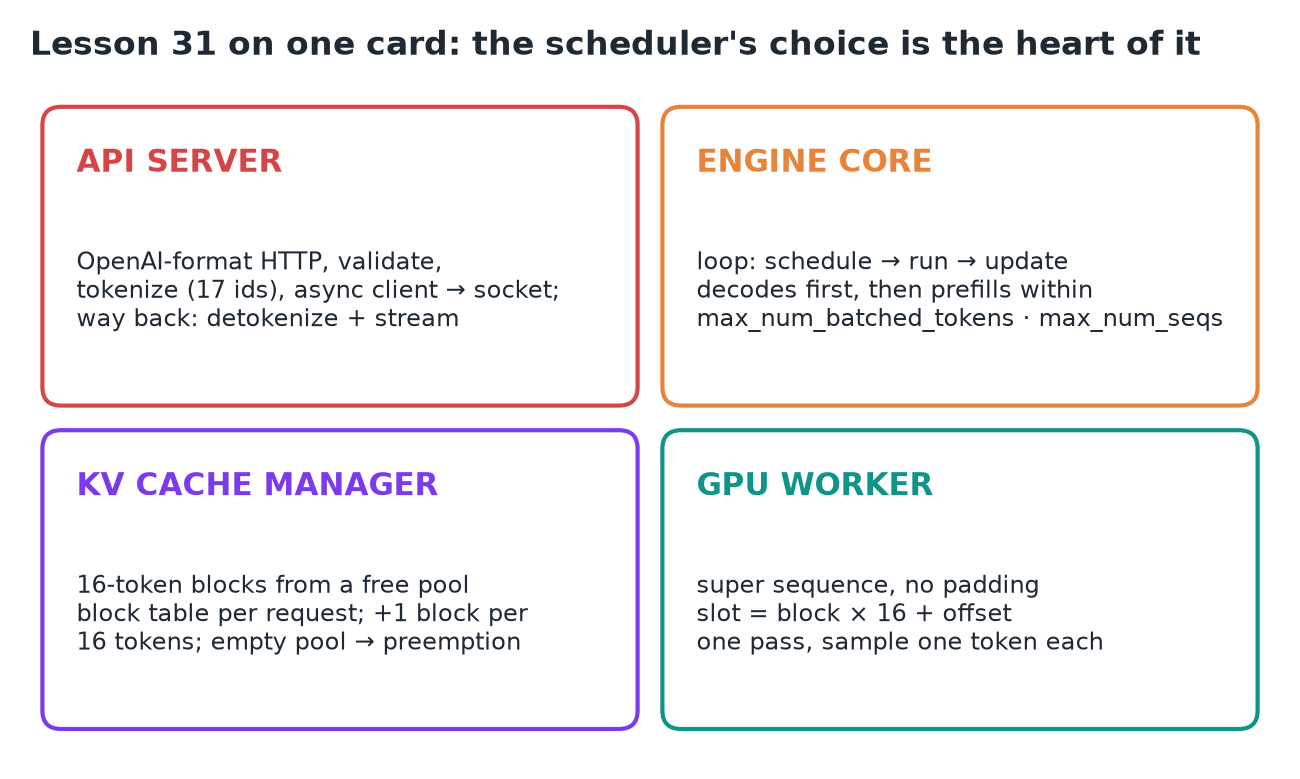
Một request ("Explain the KV cache in one sentence") đi qua ba process, hai hàng đợi, một bộ quản lý bộ nhớ, và một bước GPU dùng chung với các request khác. API server xử lý HTTP và tokenize trong process riêng để không bao giờ chặn vòng lặp GPU. Engine core lặp mãi mãi (lập lịch → chạy → cập nhật): decode trước, rồi prefill trong phạm vi hai ngân sách. KV cache manager cấp block 16 token được theo dõi trong một block table. GPU worker gói mọi request vào một siêu chuỗi (super sequence) không có padding và chạy một forward pass duy nhất. Trái tim của tất cả là lựa chọn của scheduler về việc chạy gì ở mỗi bước.
1. Toàn bộ đường đi
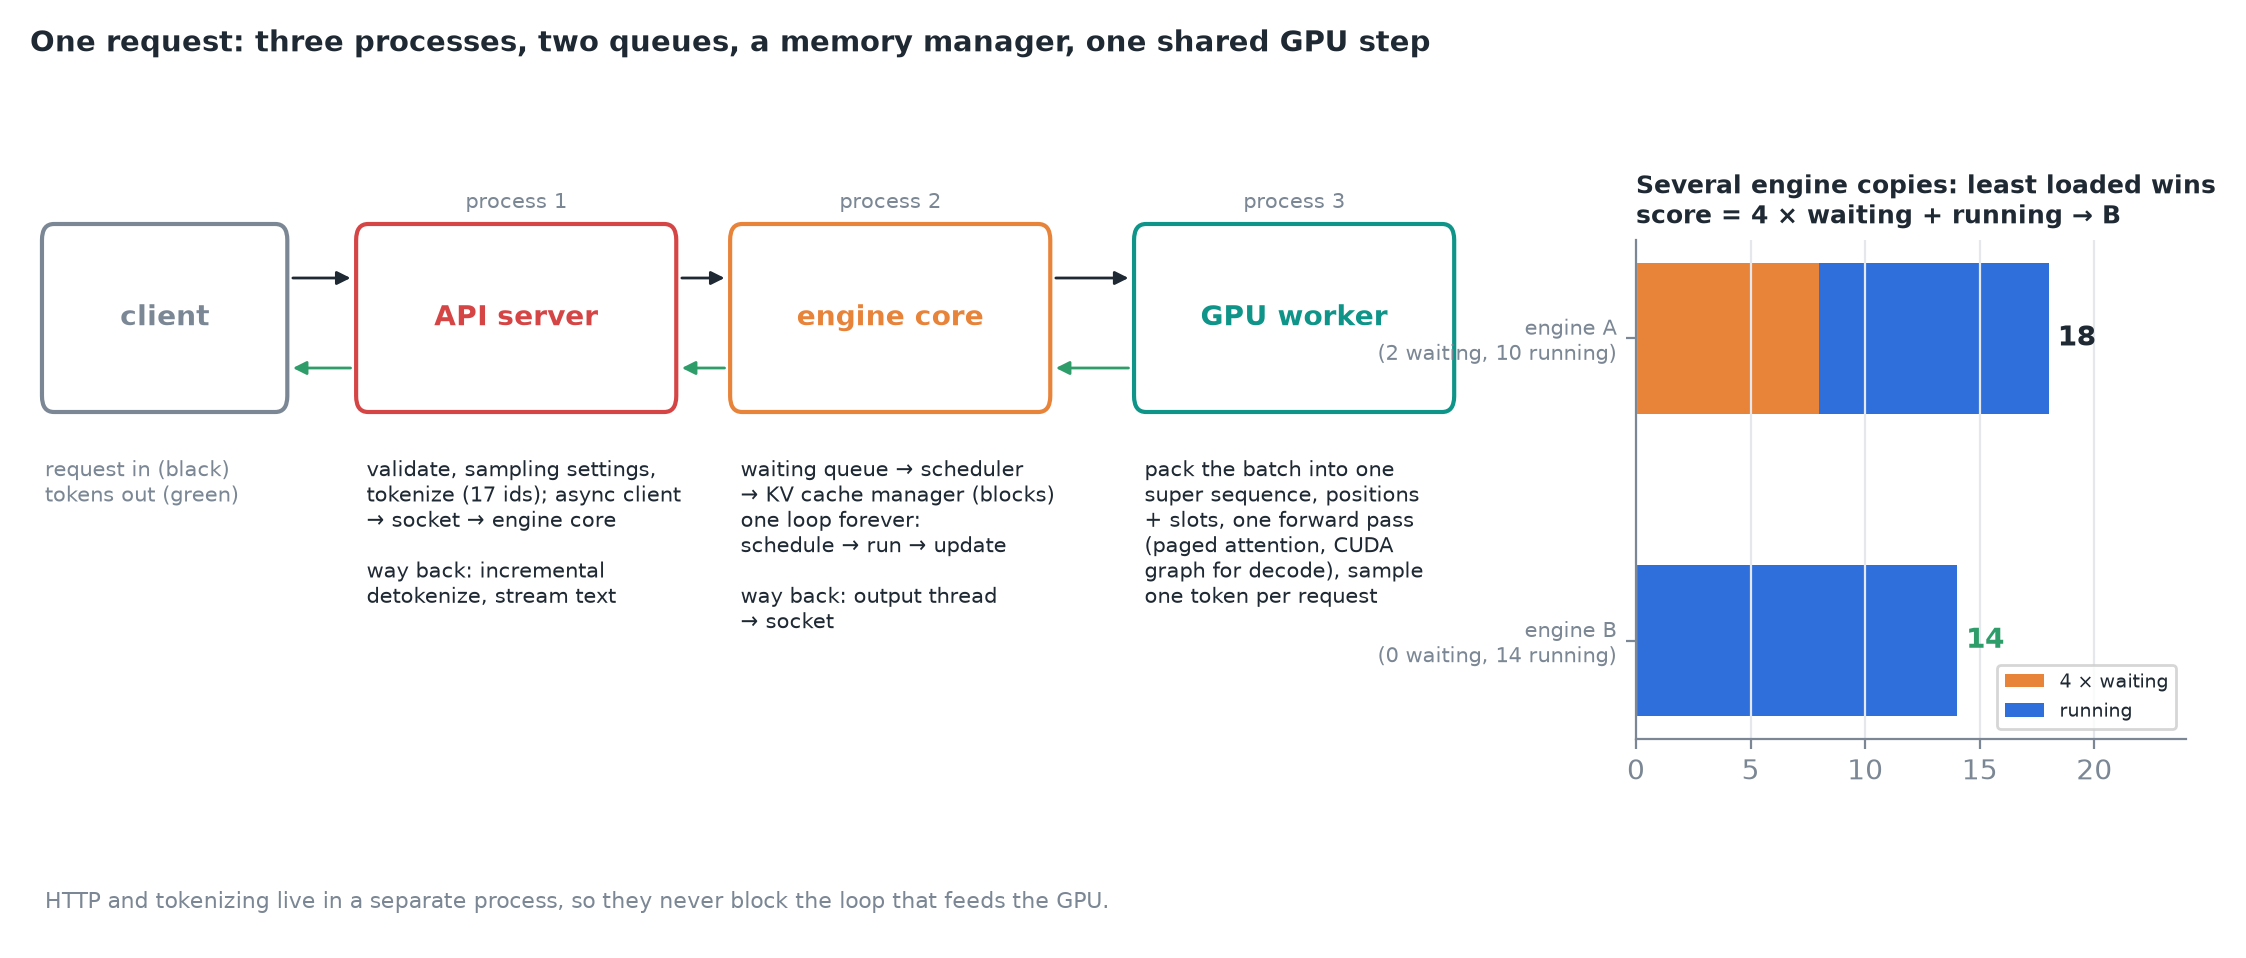 Request đi vào (mũi tên đen), token đi ra (xanh lá). Khi có nhiều bản engine, async client chọn bản ít tải nhất: request đang chờ tính nặng gấp bốn lần request đang chạy.
2. Trạm một: API server
- Một web server Python nói định dạng HTTP của OpenAI. Nó kiểm tra request, đọc cấu hình sampling và chạy tokenizer: prompt của ta thành 17 token ID.
- Nó giao request cho một async client, client này chuyển tiếp qua socket tới một process riêng, engine core.
- Vì sao tách riêng: vấn đề overhead CPU. Xử lý HTTP và tokenize không được chặn vòng lặp cấp việc cho GPU.
3. Trạm hai: engine core
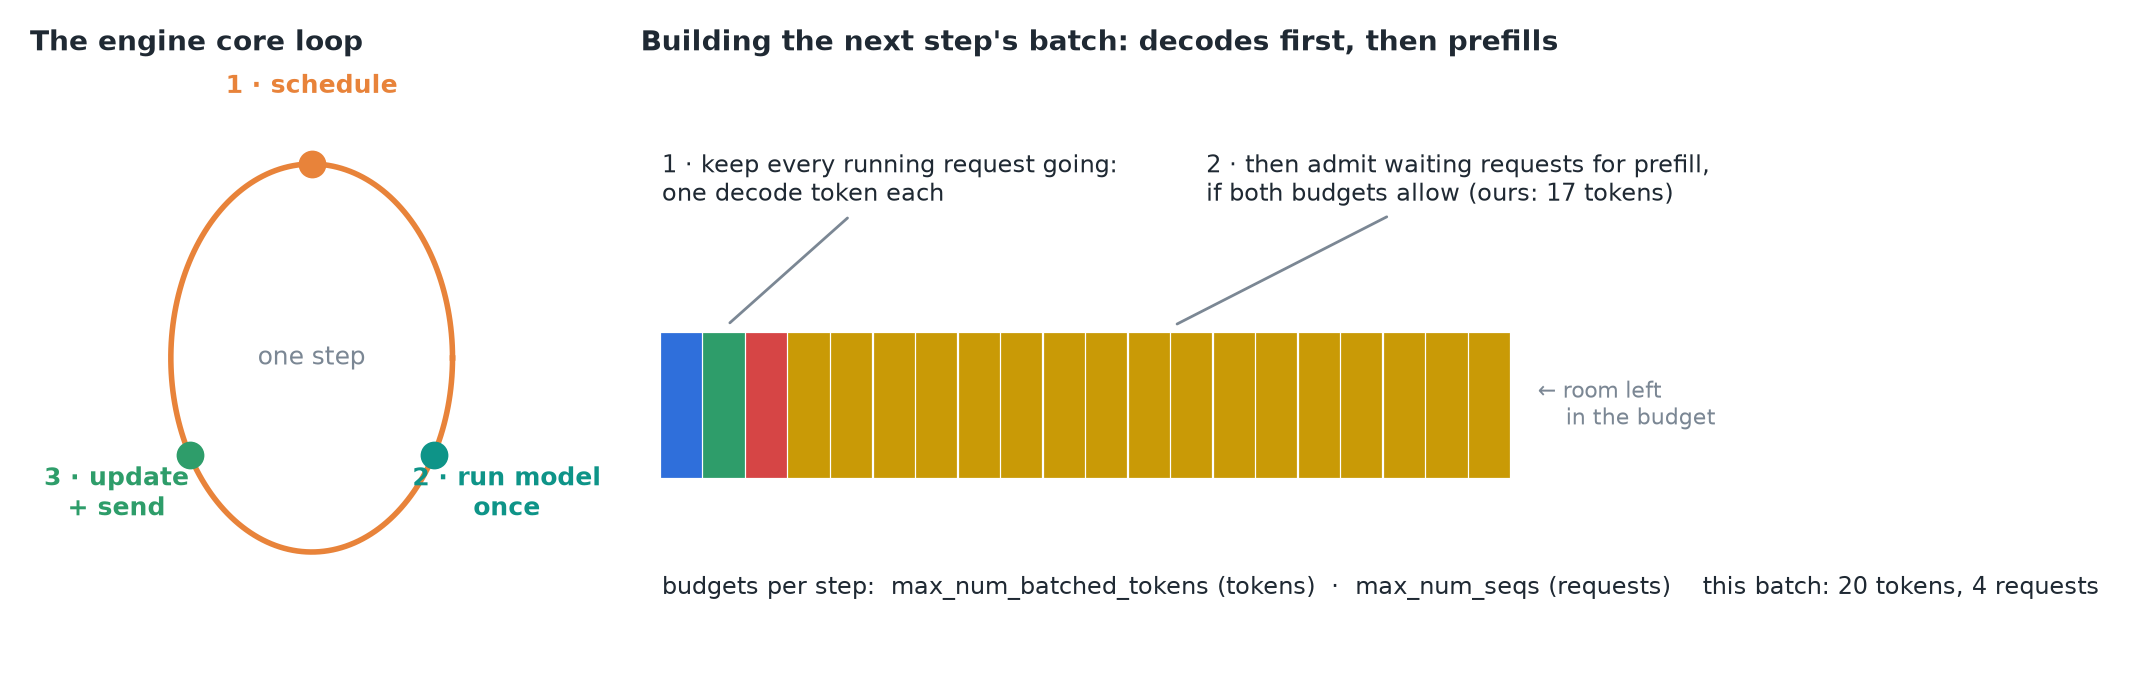 Mỗi vòng lặp là một bước: lập lịch, chạy model một lần, rồi cập nhật và gửi kết quả đi.
- Request của ta vào hàng đợi waiting.
- Scheduler dựng batch cho bước kế tiếp: trước hết nó giữ mọi request đang chạy tiếp tục (mỗi cái một token decode), rồi, nếu còn chỗ, nó nhận request đang chờ vào prefill.
- Còn chỗ nghĩa là hai ngân sách: số token mỗi bước tối đa (
max_num_batched_tokens) và số sequence tối đa (max_num_seqs). Prompt 17 token của ta vừa, nên nó vào bước này.
4. KV cache manager
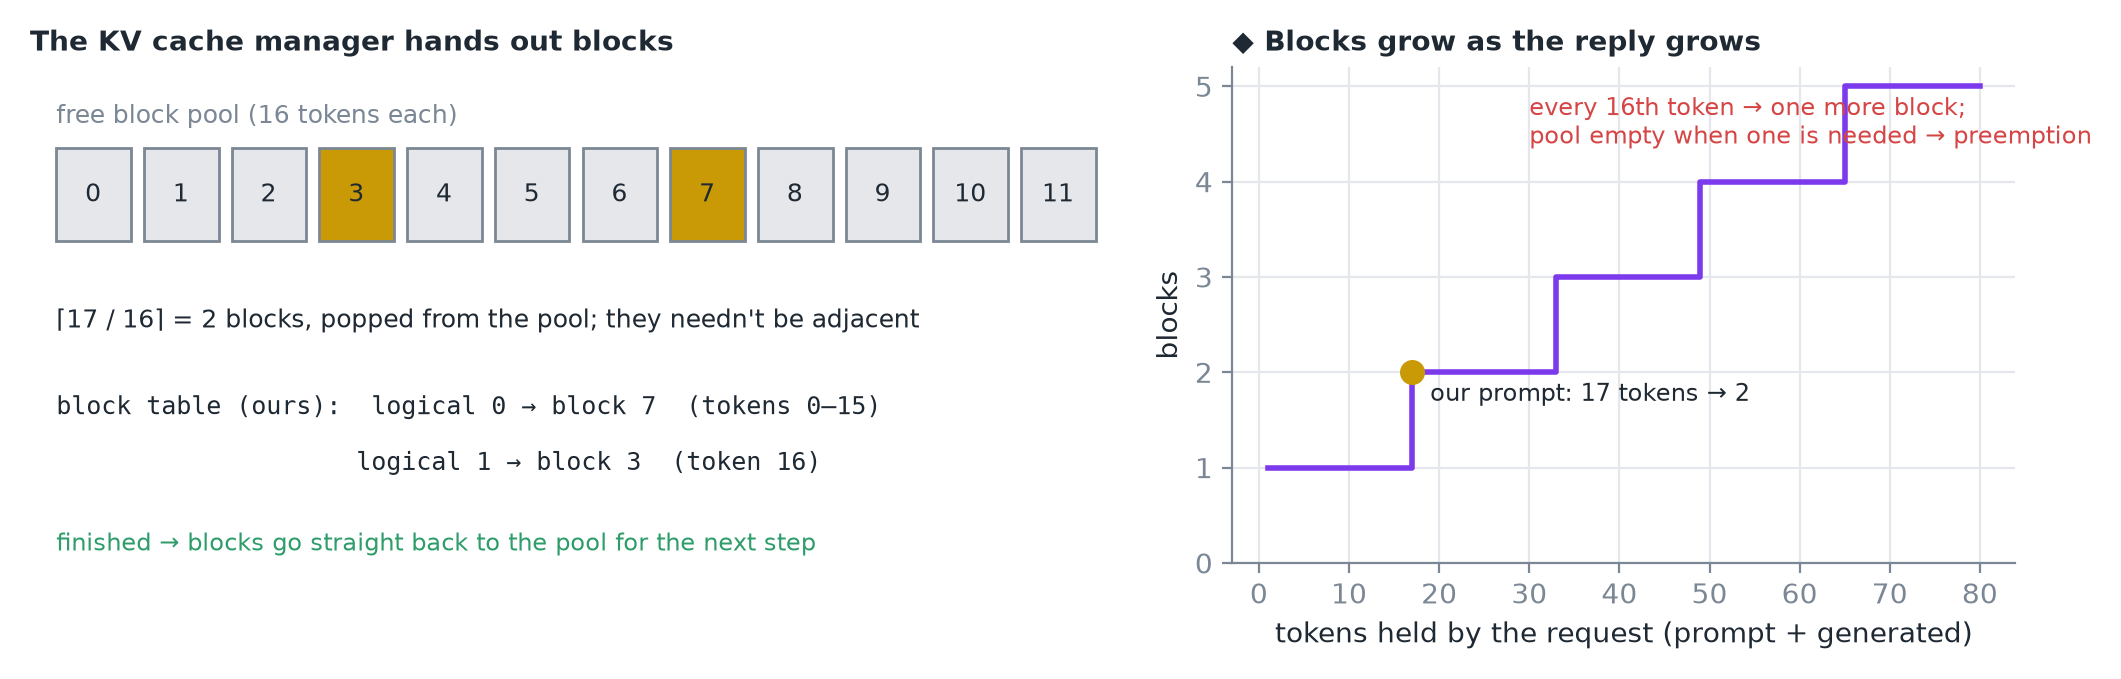 vLLM lưu cache trong các block 16 token; manager lấy block trống từ pool và ghi chúng vào block table của request.
- Hai block không cần nằm cạnh nhau: ở đây là block 7 (token 0–15) và block 3 (token 16).
- Khi câu trả lời dài ra, cứ mỗi token thứ 16 lại cần thêm một block.
- Nếu pool trống khi một request đang chạy cần block, đó là lúc preemption xảy ra.
- ◆
/metricstrên server của tôi hiệnblock_size="16"vànum_gpu_blocks="33298": 33.298 × 16 = 532.768 token, đúng bằng kích thước cache nó báo.
5. Trạm ba: GPU worker
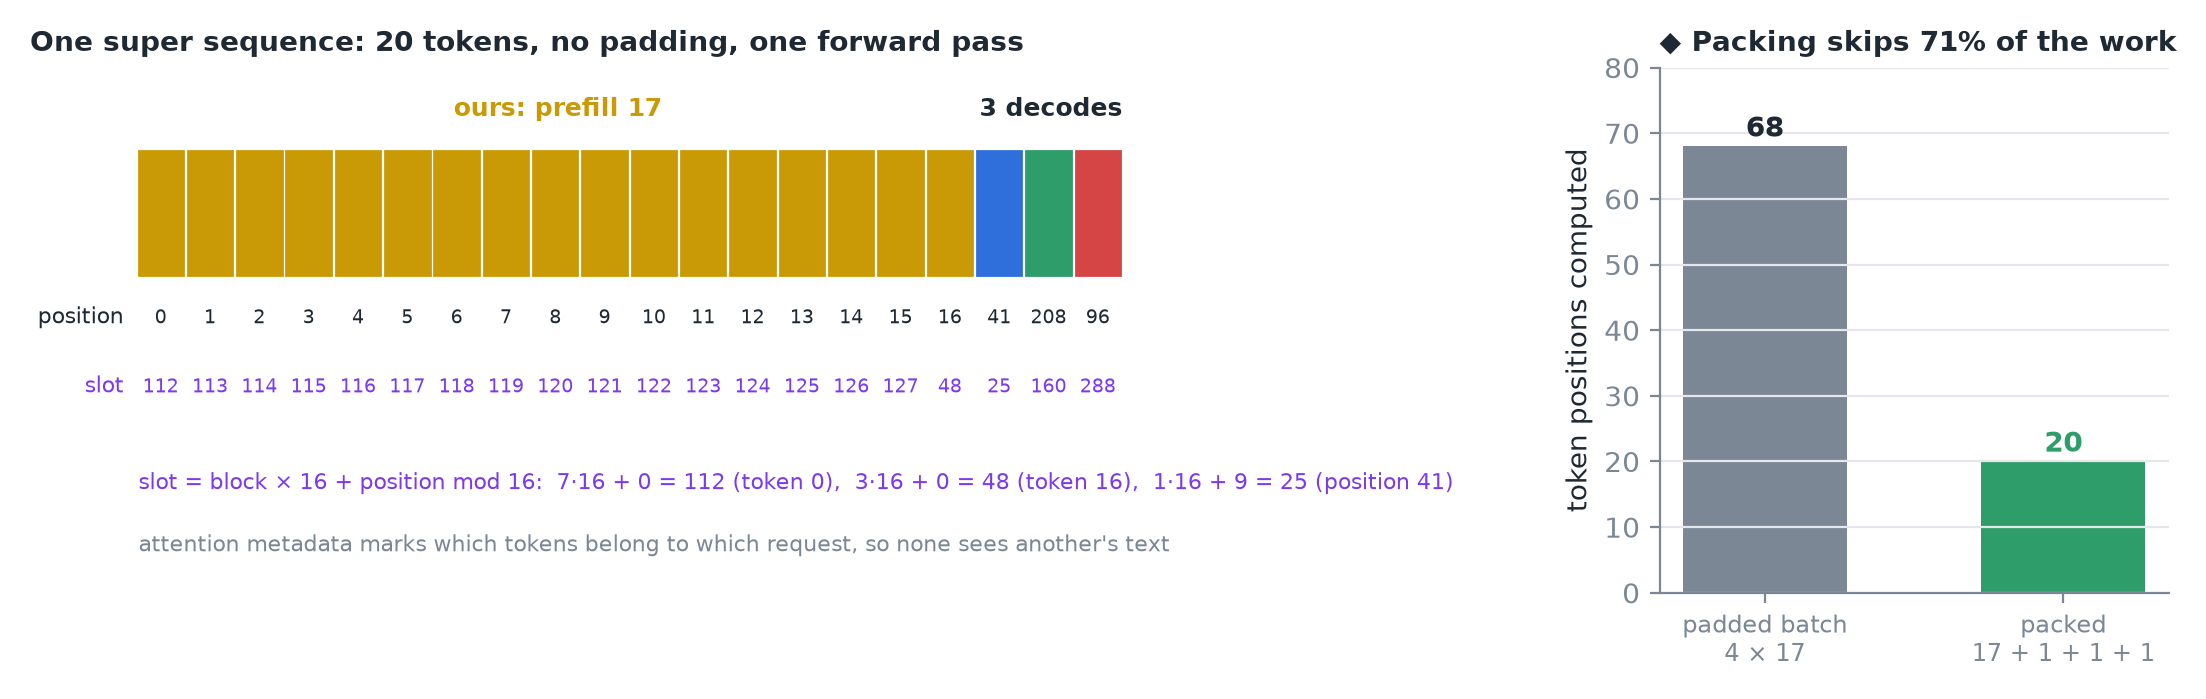 Batch của bước này: 17 token prompt của ta cộng một token decode từ mỗi request trong ba request khác, gói vào một siêu chuỗi 20 token không có padding. ◆ Slot decode 171 và 300 trong video không khớp với vị trí 208 và 96 (offset của slot trong block phải bằng vị trí mod 16), nên hình dùng các giá trị nhất quán.
- Với mỗi token, runner tính một vị trí (position) và một slot: chính xác nơi key và value của token đó sẽ được ghi.
- Attention metadata cho kernel biết token nào thuộc request nào, để không request nào thấy văn bản của request khác.
- Một forward pass chạy trên cả siêu chuỗi bằng các kernel paged attention. Với các bước decode, một CUDA graph đã capture sẵn được phát lại thay vì launch từng kernel một.
- Runner lấy vị trí cuối của mỗi request, tính logits, và lấy mẫu mỗi request một token.
6. Trạm bốn: đường về
- Các token ID đã lấy mẫu đi tới output thread của engine core, rồi qua socket về lại API server.
- Một output handler detokenize chúng tăng dần và stream từng mẩu văn bản mới tới client. Token đầu tiên của ta đã tới: đó là TTFT của nó.
- Bước tiếp theo nó là request đang chạy, nên mỗi vòng lặp nó nhận một token decode cho tới khi sinh ra token kết thúc hoặc chạm giới hạn.
- Khi nó xong, các block của nó trở thẳng về pool trống, sẵn sàng cho request khác ngay ở bước kế tiếp.
7. Tóm tắt