08 · Sinh và stream những token đầu tiên
Nguồn: fanout.sh / inference-eng / 01-03 · ~8 phút
Ghi chú
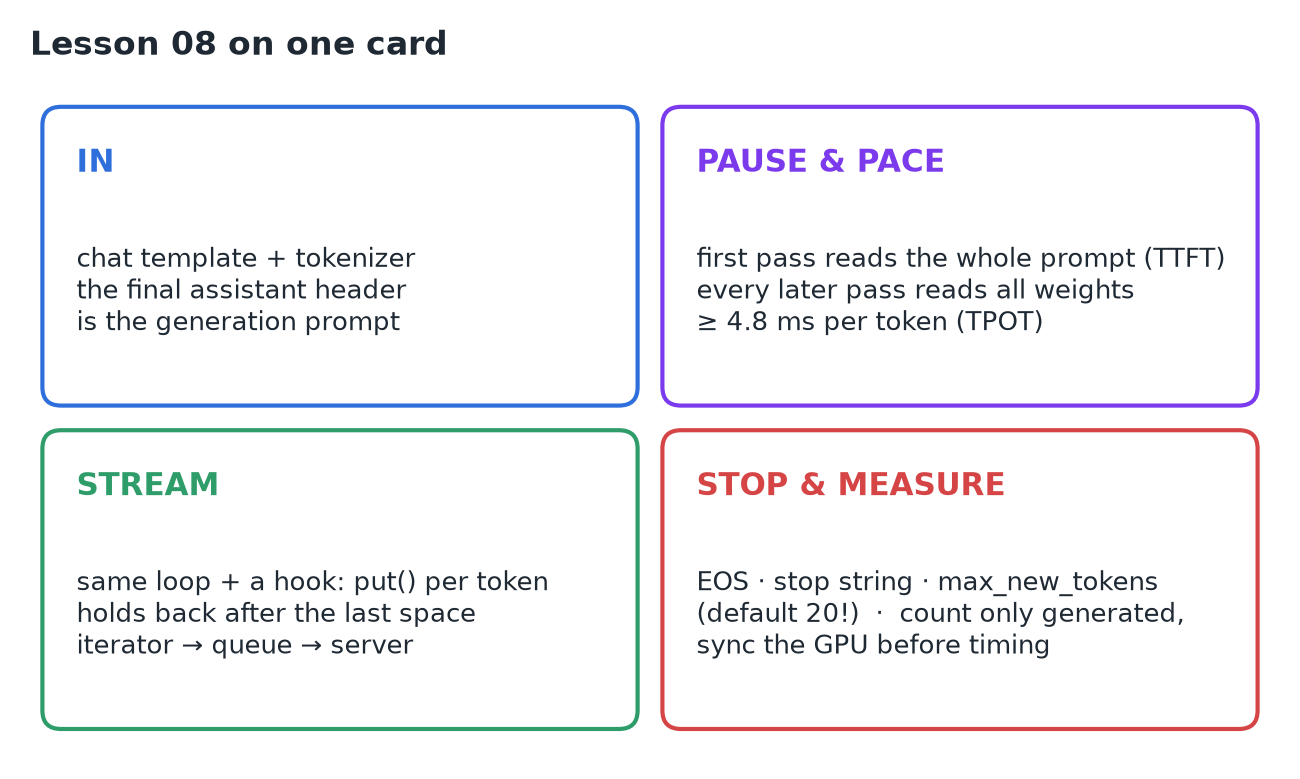
Những gì người dùng thấy, một khoảng dừng rồi một dòng chữ đều đặn, chính là toàn bộ inference nhìn từ bên ngoài. Prompt được bọc trong một chat template rồi tokenize; generate() chạy một forward pass cho mỗi token. Lượt đầu đọc cả prompt (khoảng dừng, TTFT); mỗi lượt sau đọc toàn bộ trọng số một lần (nhịp độ, TPOT, ≥ 4,8 ms trên H100). Streaming là cùng vòng lặp đó gắn thêm một hook. Quá trình sinh dừng vì đúng ba lý do, và con số tokens/s bạn thấy rất dễ bị đo sai.
Ví dụ xuyên suốt: Llama 3.1 8B Instruct trên một H100.
1. Model thực sự nhận được gì
Một language model chỉ viết tiếp một chuỗi token. "User" và "assistant" là quy ước học được từ cách dữ liệu huấn luyện được trình bày; chat template (đi kèm trong tokenizer_config.json) tái tạo lại cách trình bày đó.
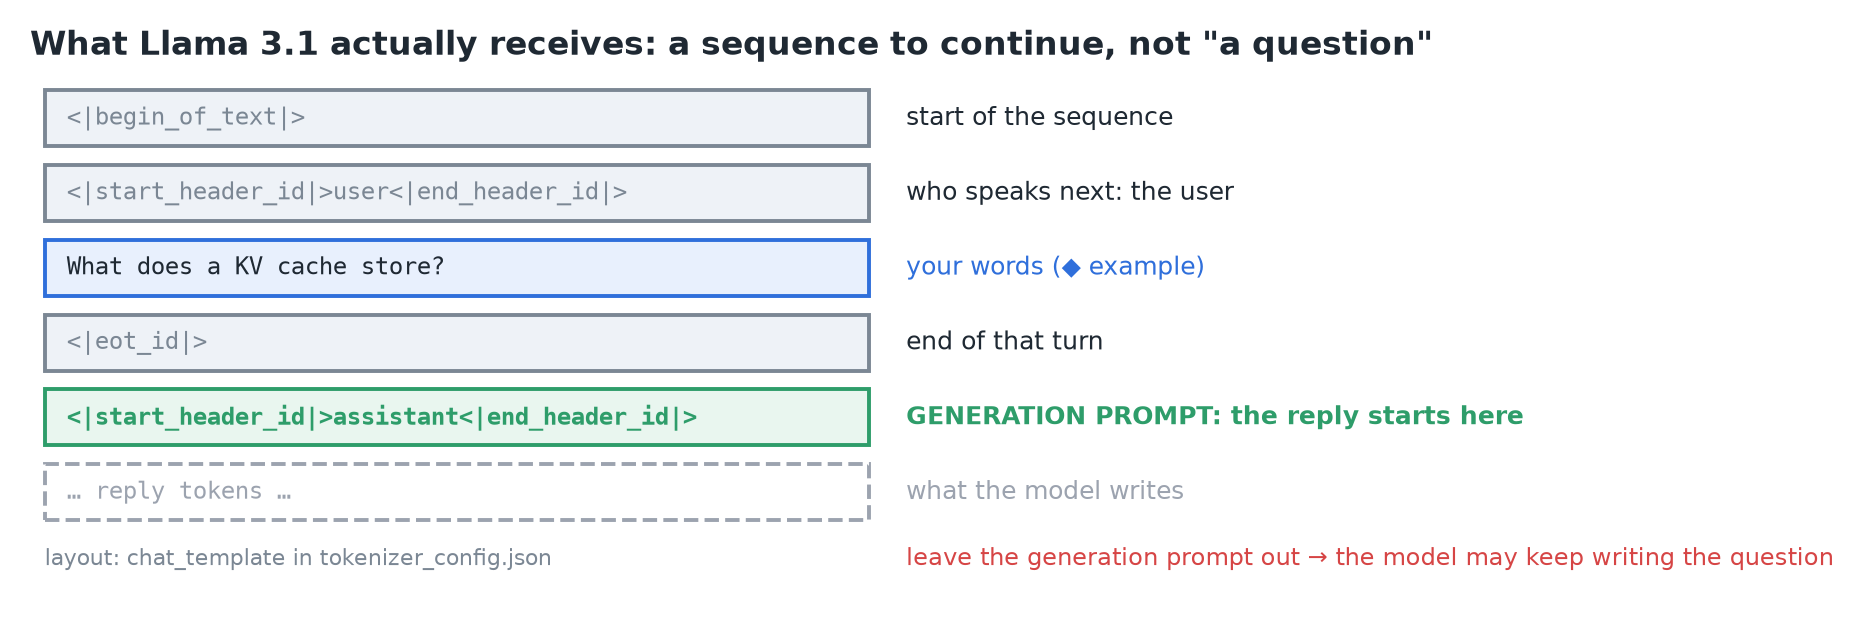 Tin nhắn của bạn được bọc trong các marker đặc biệt, rồi template nối thêm header của assistant và dừng lại.
- Header assistant cuối cùng đó là generation prompt: tín hiệu báo rằng các token tiếp theo là câu trả lời. Bỏ nó đi thì model có thể viết tiếp chính câu hỏi của bạn, vì đó là cách viết tiếp tự nhiên nhất.
- Sau đó tokenizer biến văn bản thành số nguyên: một câu hỏi ~30 từ ≈ ~30 token (minh hoạ).
2. Vòng lặp
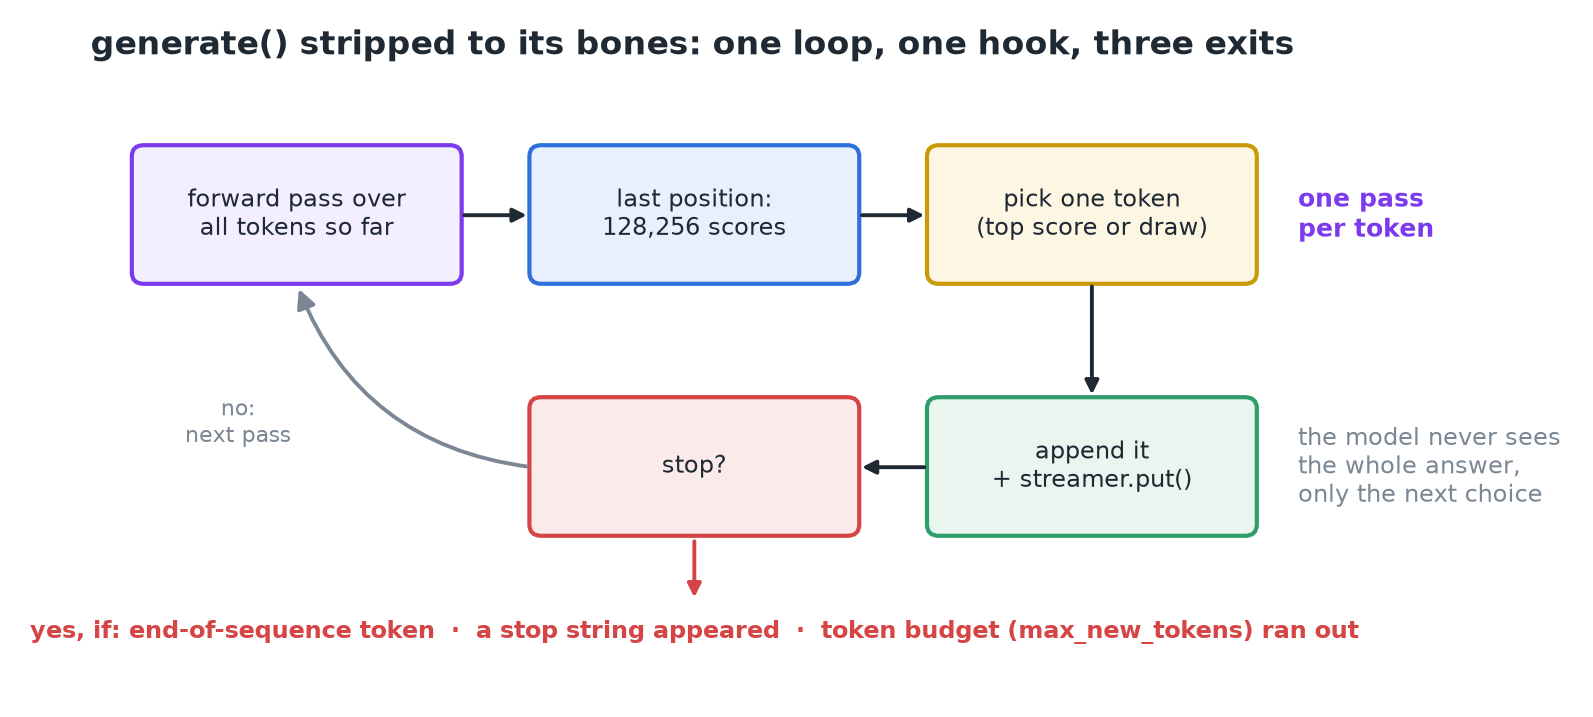 Chạy model, lấy 128.256 điểm ở vị trí cuối, chọn một token, nối vào, kiểm tra có dừng không, lặp lại.
Quan trọng
Một forward pass cho mỗi token. Model không bao giờ thấy cả câu trả lời, chỉ thấy lựa chọn kế tiếp. Và vòng đầu tiên khác hẳn mọi vòng còn lại.
3. Khoảng dừng và nhịp độ
- Lượt đầu (prefill): đọc cả ~30 token prompt cùng lúc, song song qua mọi layer, và lưu key và value của chúng để dùng sau. Phép tính thật sự: GPU bận rộn.
- Mỗi lượt sau (decode): thêm một token và dùng lại K/V đã lưu. Phép tính rất ít, nhưng vẫn phải đọc toàn bộ 16 GB trọng số:
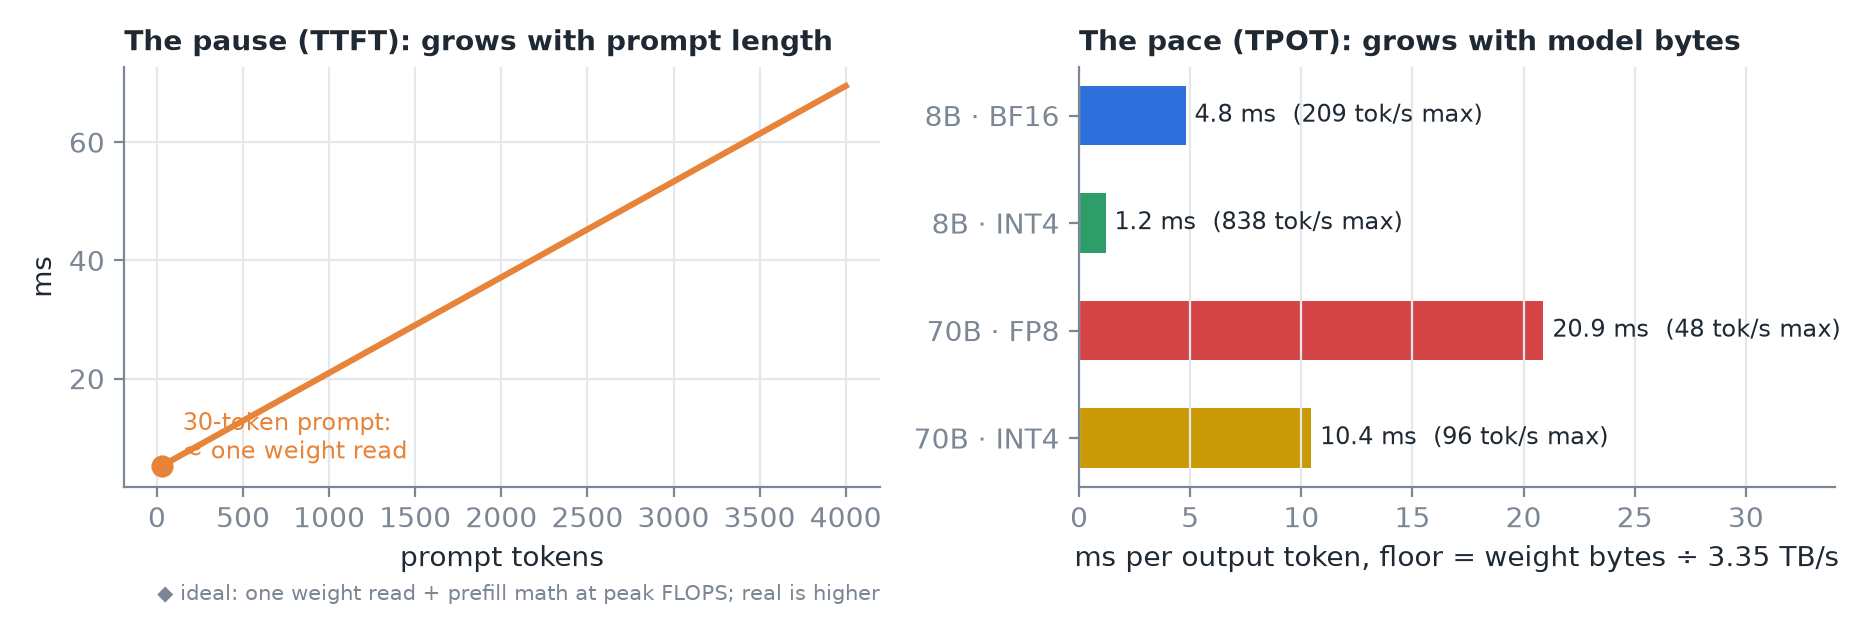 Trái: prompt dài hơn thì khoảng dừng dài hơn. Phải: model lớn hơn (hoặc ít lượng tử hoá hơn) thì nhịp chậm hơn. Vòng lặp vẫn vậy.
Khoảng dừng = time to first token (TTFT); nhịp độ = time per output token (TPOT).
4. Streaming: cùng vòng lặp, thêm một hook
Trong Transformers, bạn truyền cho generate() một streamer; mỗi khi một token được chọn, vòng lặp gọi streamer.put().
TextStreamergiữ các token đã có, decode cả buffer, và chỉ in phần mới.- Nó giữ lại mọi thứ sau dấu cách cuối cùng: một token thường chỉ là nửa từ, và token kế tiếp có thể thay đổi cách viết của token trước. Vì vậy phần hiển thị chậm hơn model khoảng một từ, có chủ đích; ký tự xuống dòng sẽ đẩy nó ra.
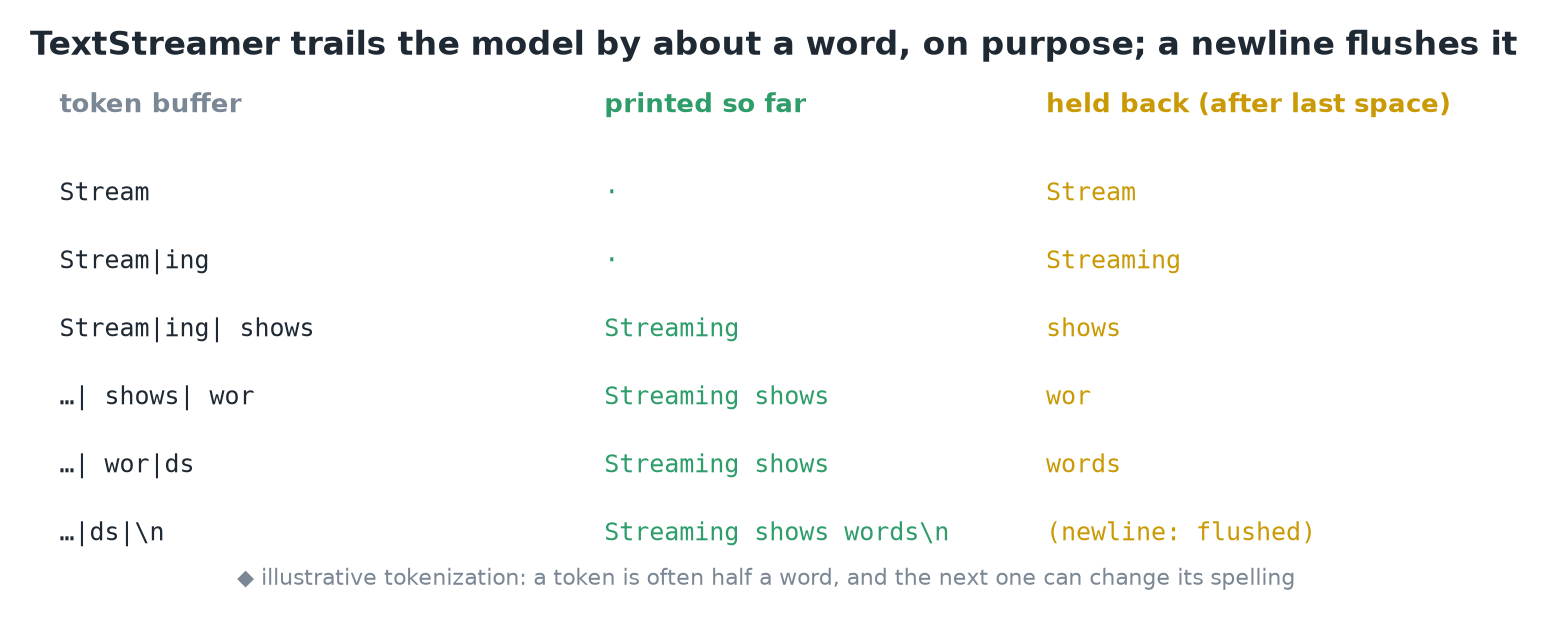 Văn bản chỉ được in tới dấu cách cuối cùng; từ đang dở chờ token tiếp theo.
TextIteratorStreamerđẩy văn bản đã hoàn chỉnh vào một hàng đợi (queue); server của bạn đọc từ đầu kia mà không chặn vòng lặp. Đó là khớp nối để gắn một chat server vào.
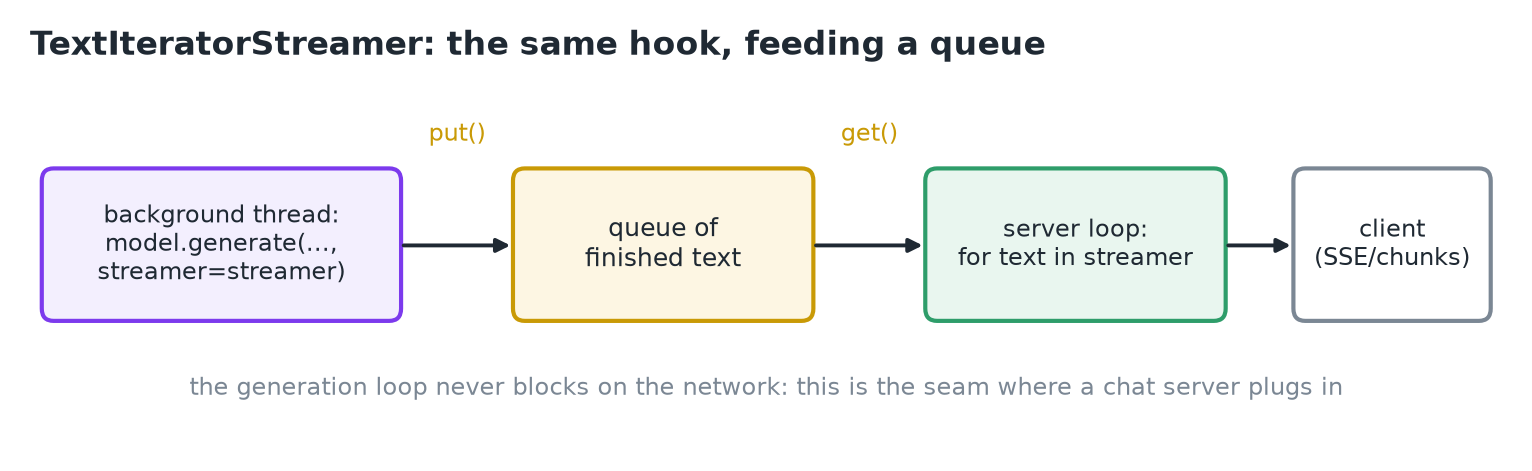 generate() chạy trong một thread nền; server duyệt qua hàng đợi và chuyển văn bản tới client.
5. Vì sao nó dừng
Chỉ có ba lý do, và không lý do nào là dấu câu:
| Lý do | Đặt ở đâu |
|---|---|
| Model chọn một token kết thúc chuỗi (EOS) | generation_config.json: Llama 3.1 liệt kê ba EOS id |
| Xuất hiện một stop string bạn đã yêu cầu | Theo từng request |
| Hết ngân sách token | max_new_tokens: mặc định là 20 trong Transformers trừ khi config của model nói khác |
Cảnh báo
Không đặt max_new_tokens là nguyên nhân kinh điển khiến câu trả lời dừng giữa chừng.
Cùng file config đó chứa mặc định sampling của model này: bật sampling, temperature 0.6, top-p 0.9. Đó là lựa chọn của ai đó, không phải định luật: hãy đọc chúng, và ghi đè theo từng request.
6. Đọc các con số
Phần lớn công cụ in ra: prompt tokens (những gì đưa vào, sau khi áp template), generated tokens (những gì sinh ra), và tokens/s, thường là generated tokens ÷ thời gian kể từ token đầu tiên.
Request của chúng ta (minh hoạ): ~30 token prompt, 60 token sinh ra, khoảng dừng vài trăm ms, rồi xấp xỉ 200 tok/s ở mức sàn (mức sàn là phép tính).
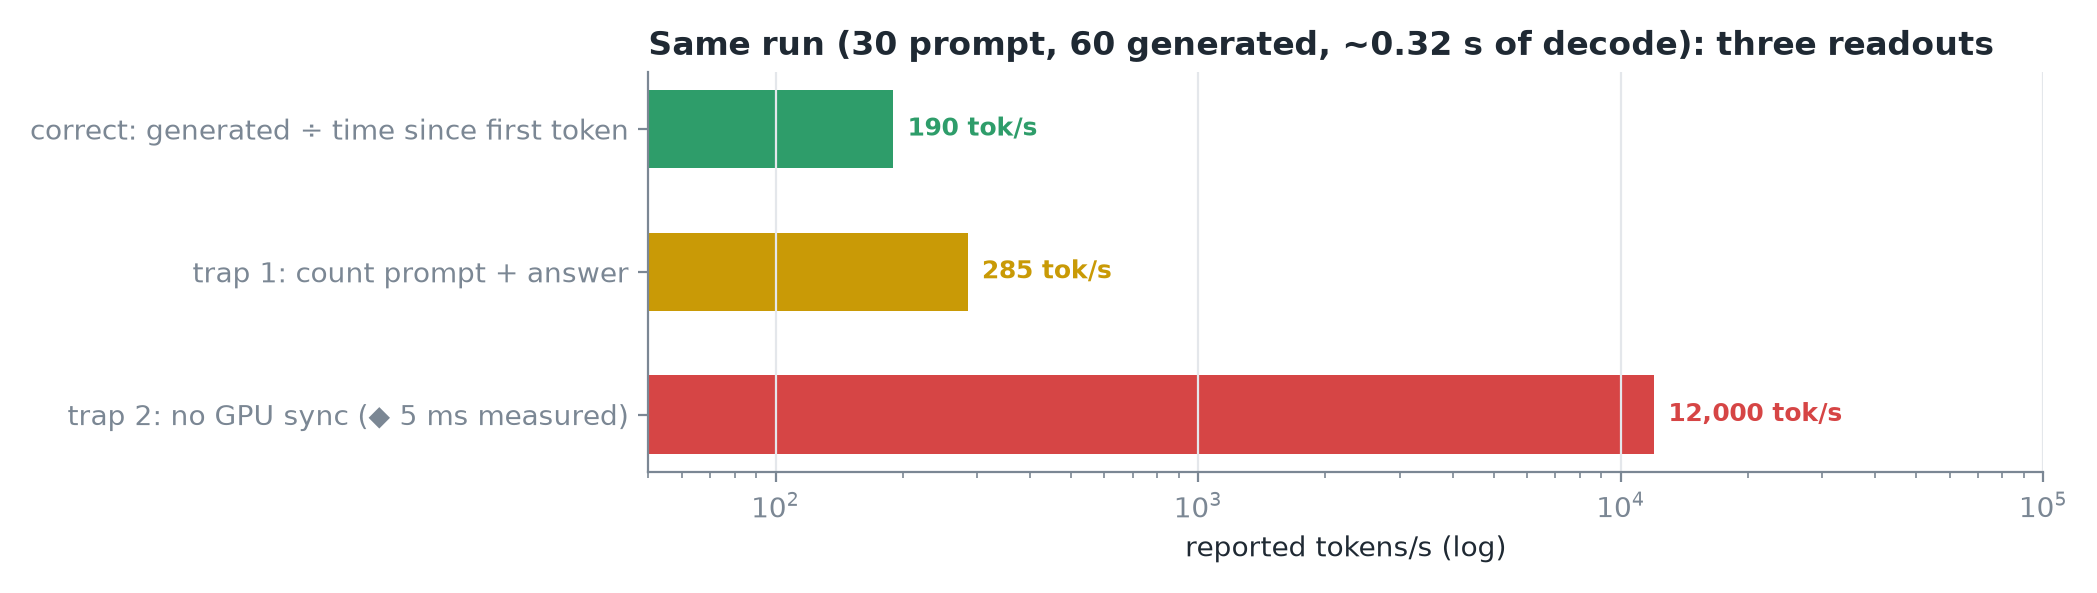 Cùng một lần chạy được báo theo ba cách: đúng, đếm prompt như đầu ra, và bấm giờ một lệnh gọi GPU chưa đồng bộ.
- Bẫy 1:
generate()trả về prompt + câu trả lời; đếm cả đầu ra là đếm thừa. - Bẫy 2: công việc trên GPU là bất đồng bộ: lệnh gọi Python trả về trước khi GPU làm xong, nên bấm giờ quanh nó gần như không đo được gì. Đồng bộ (synchronize) trước, hoặc dùng CUDA event.
Cảnh báo
- "Model khởi động chậm": bước đầu tiên đang làm việc của ~30 token trong một lần.
- "Streaming làm sinh nhanh hơn": nó thay đổi lúc bạn thấy token, không phải lúc token được tạo ra.
- "Nó dừng ở cuối câu": nó dừng vì token kết thúc, stop string hoặc hết ngân sách.
7. Tóm tắt