32 · Serve từng request so với batch tĩnh
Nguồn: fanout.sh / inference-eng / 07-01 · ~6,5 phút
Ghi chú
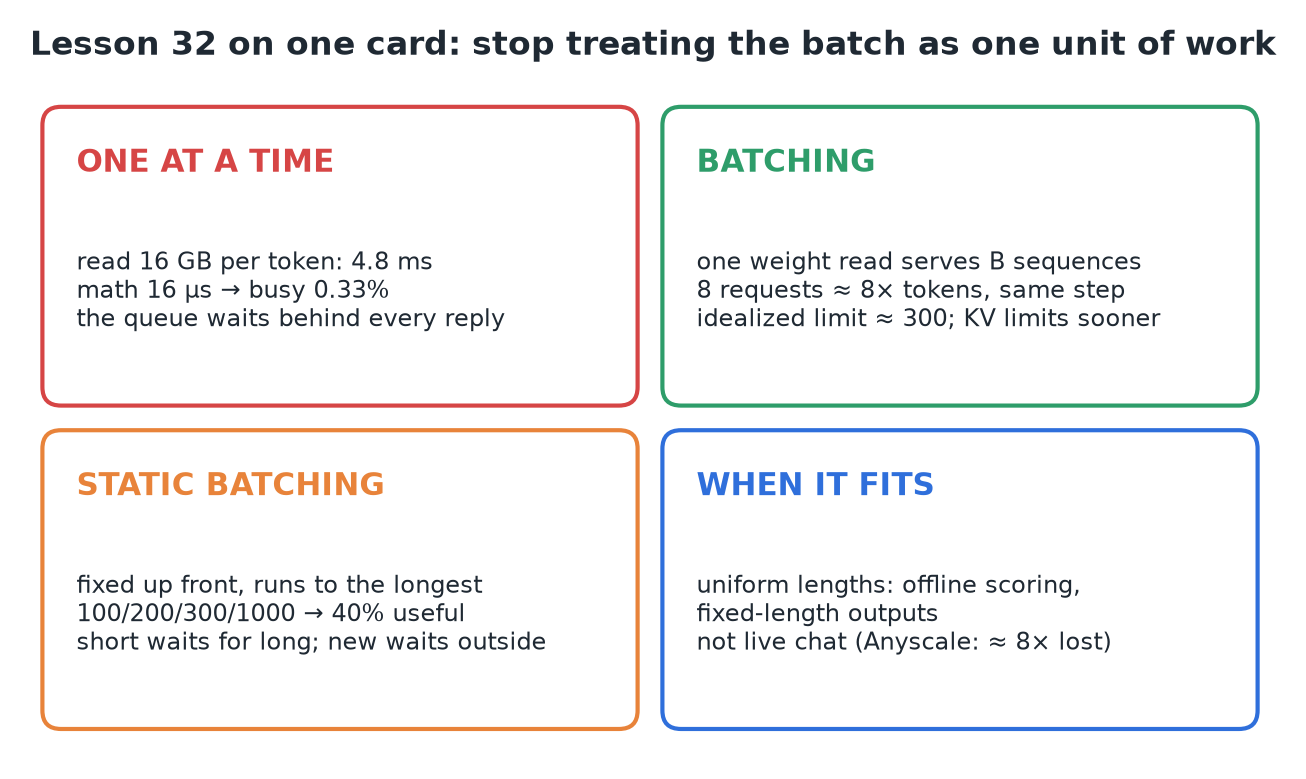
Serve từng request một khiến H100 ngồi đọc trọng số trong khi các đơn vị tính toán chỉ bận khoảng 0,33% mỗi bước, còn mọi người khác xếp hàng. Batching chia mỗi lần đọc trọng số cho nhiều sequence, nên throughput tăng gần như miễn phí: 8 request làm ra 8 token trong cùng một bước ~4,8 ms. Batch tĩnh (static batching) chốt batch từ đầu và chạy nó theo nhịp của request dài nhất: với câu trả lời 100, 200, 300 và 1.000 token, chỉ 40% batch làm việc có ích, câu trả lời ngắn phải chờ câu dài, và request mới phải chờ ngoài cửa. Cách sửa là thôi coi cả batch là một đơn vị công việc.
1. Từng request một
Llama 3.1 8B ở BF16 là ~16 GB trọng số, và sinh một token dùng mọi trọng số một lần.
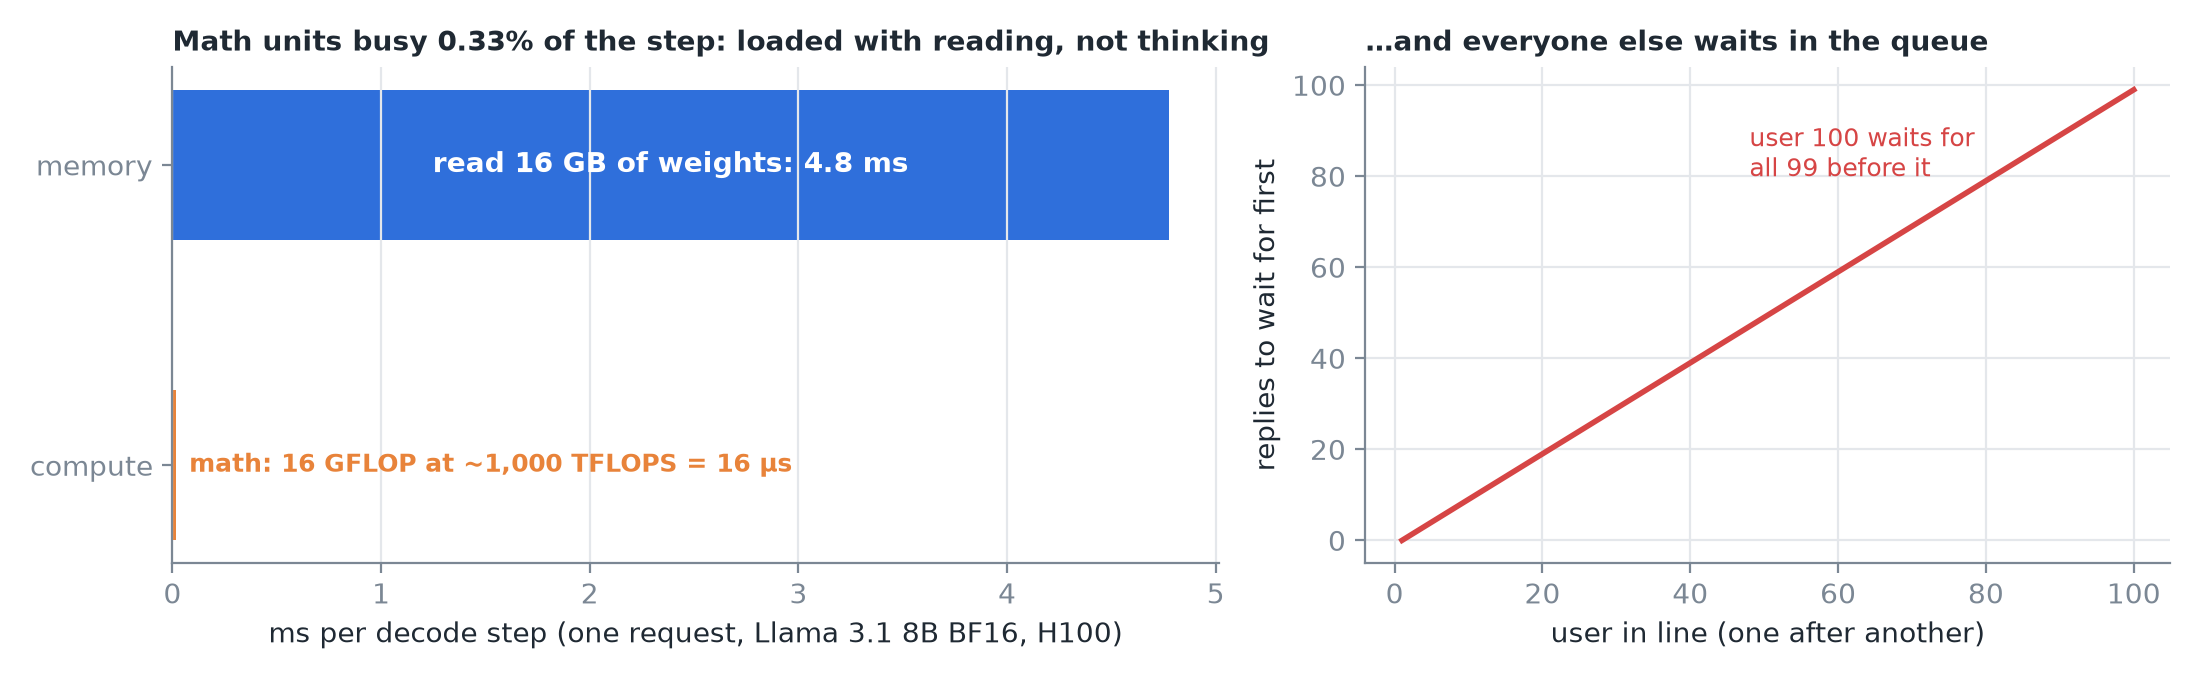 GPU trông như đầy tải, nhưng là đầy việc đọc chứ không phải việc tính. Phục vụ 100 người dùng nối tiếp nhau thì người cuối phải chờ cả 99 người trước.
2. Batching: speedup rẻ nhất trong decode
- Một khi trọng số đã lên chip, dùng lại nó gần như miễn phí. Xếp 8 request cạnh nhau và đẩy chúng qua cùng một lần đọc trọng số: bước đó vẫn stream 16 GB và vẫn mất ~4,8 ms, nhưng làm ra 8 token thay vì một. Throughput tăng ~8 lần và bước của không ai chậm đi đáng kể.
- Tăng batch thì số phép tính trên mỗi byte đọc tăng theo. Trong bức tranh lý tưởng, phép tính chỉ đuổi kịp việc đọc khi có vài trăm sequence (≈ 4,8 ms ÷ 16 µs ≈ 300).
- Thực tế mỗi sequence còn đọc KV cache riêng, và cache đó phải vừa trong bộ nhớ, nên giới hạn thật đến sớm hơn.
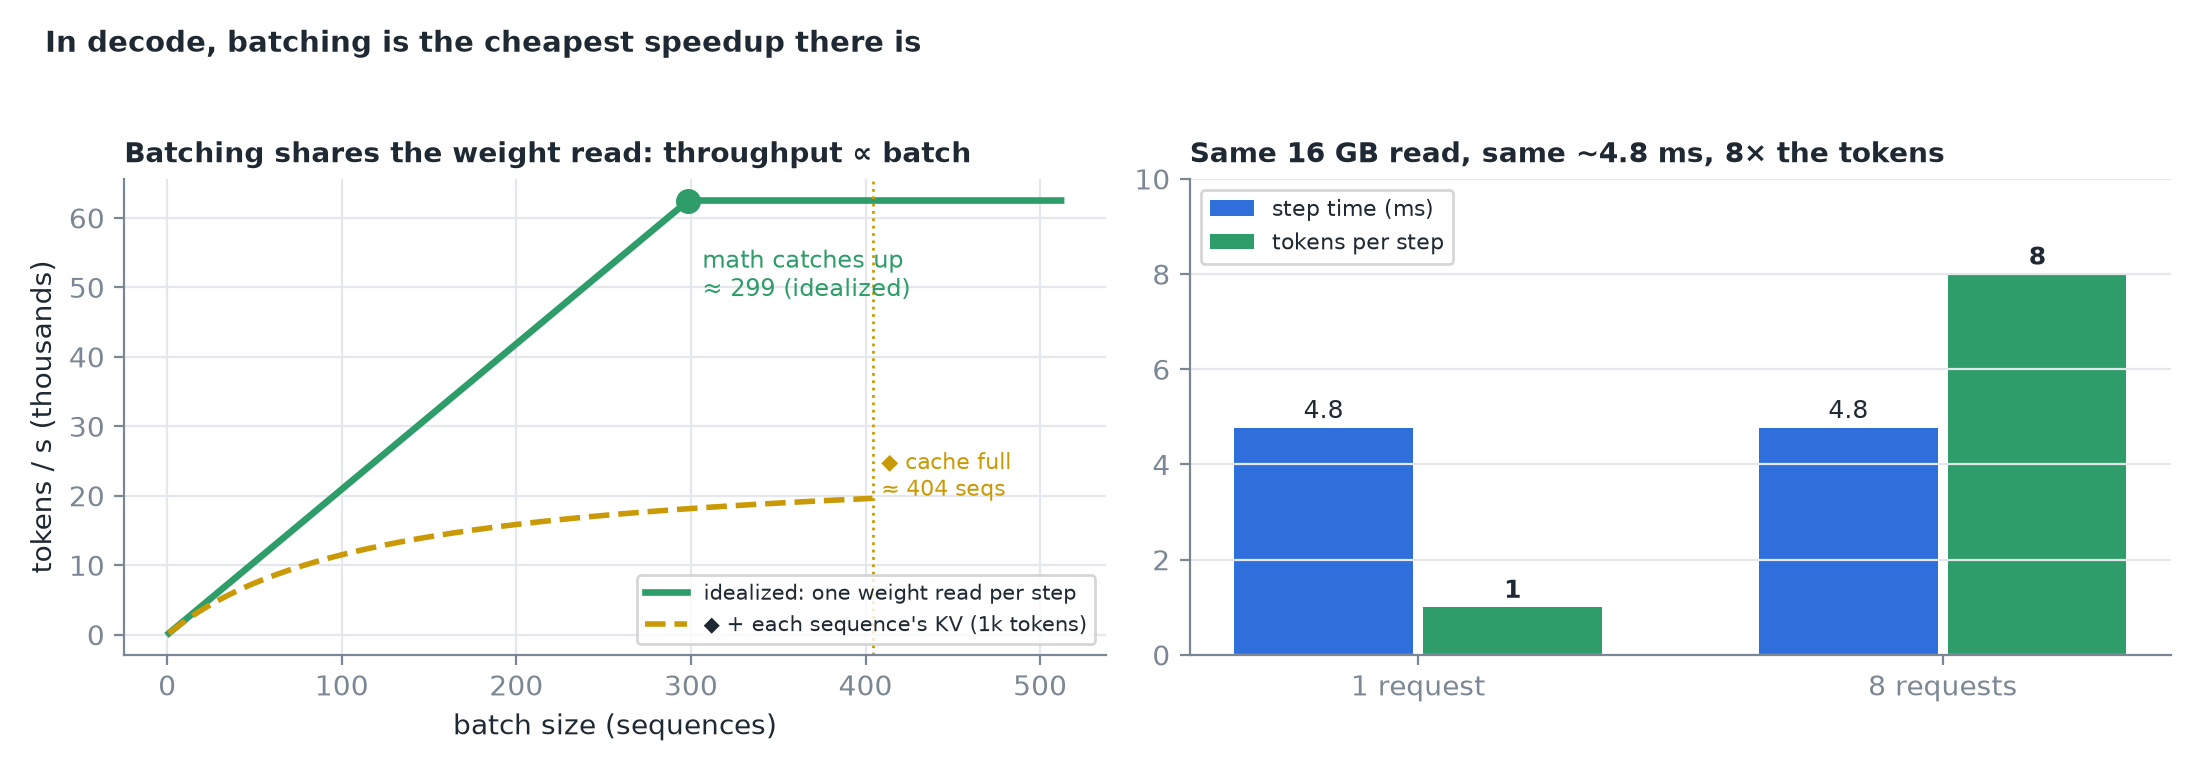 ◆ Đường nét đứt cộng thêm phần đọc KV của mỗi sequence ở context 1.000 token (128 KiB mỗi token) và dừng ở nơi cache ~53 GB đầy.
3. Batch tĩnh
Chờ tới khi có, giả sử, bốn request; chạy chúng cùng nhau từng bước một cho tới khi tất cả đều xong; trả kết quả; bắt đầu batch tiếp theo.
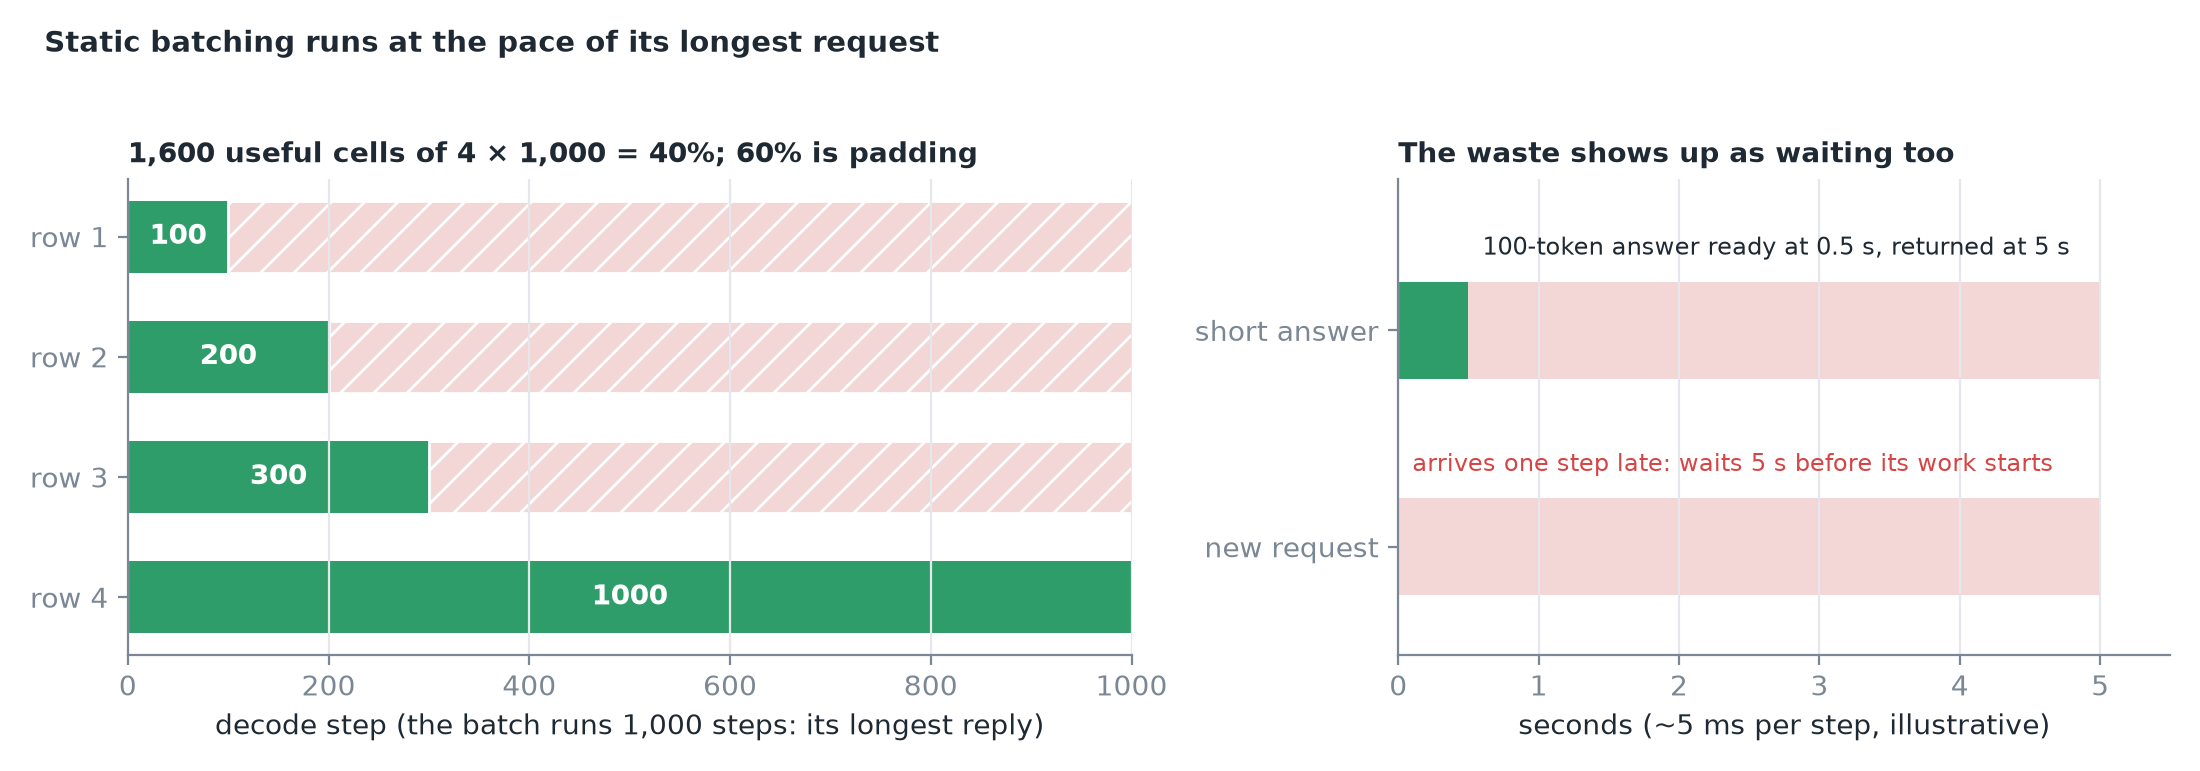 Câu trả lời dài 100, 200, 300 và 1.000 token: batch chạy 1.000 bước vì hàng dài nhất, và các hàng đã xong vẫn đi theo mà không làm gì.
| Lãng phí | Điều gì xảy ra |
|---|---|
| Padding | Hàng đã xong giữ slot cho tới khi câu trả lời dài nhất kết thúc; prompt ngắn bị đệm cho bằng prompt dài nhất ngay từ đầu |
| Câu trả lời ngắn phải chờ | Ở ~5 ms mỗi bước, câu trả lời 100 token xong sau 0,5 s nhưng được trả về cùng những cái khác sau 5 s |
| Request mới phải chờ | Request đến một bước sau khi batch bắt đầu không vào được; nó chờ trọn 5 s mới bắt đầu phần việc của mình |
4. Số đo thực tế, và khi nào batch tĩnh vẫn hợp
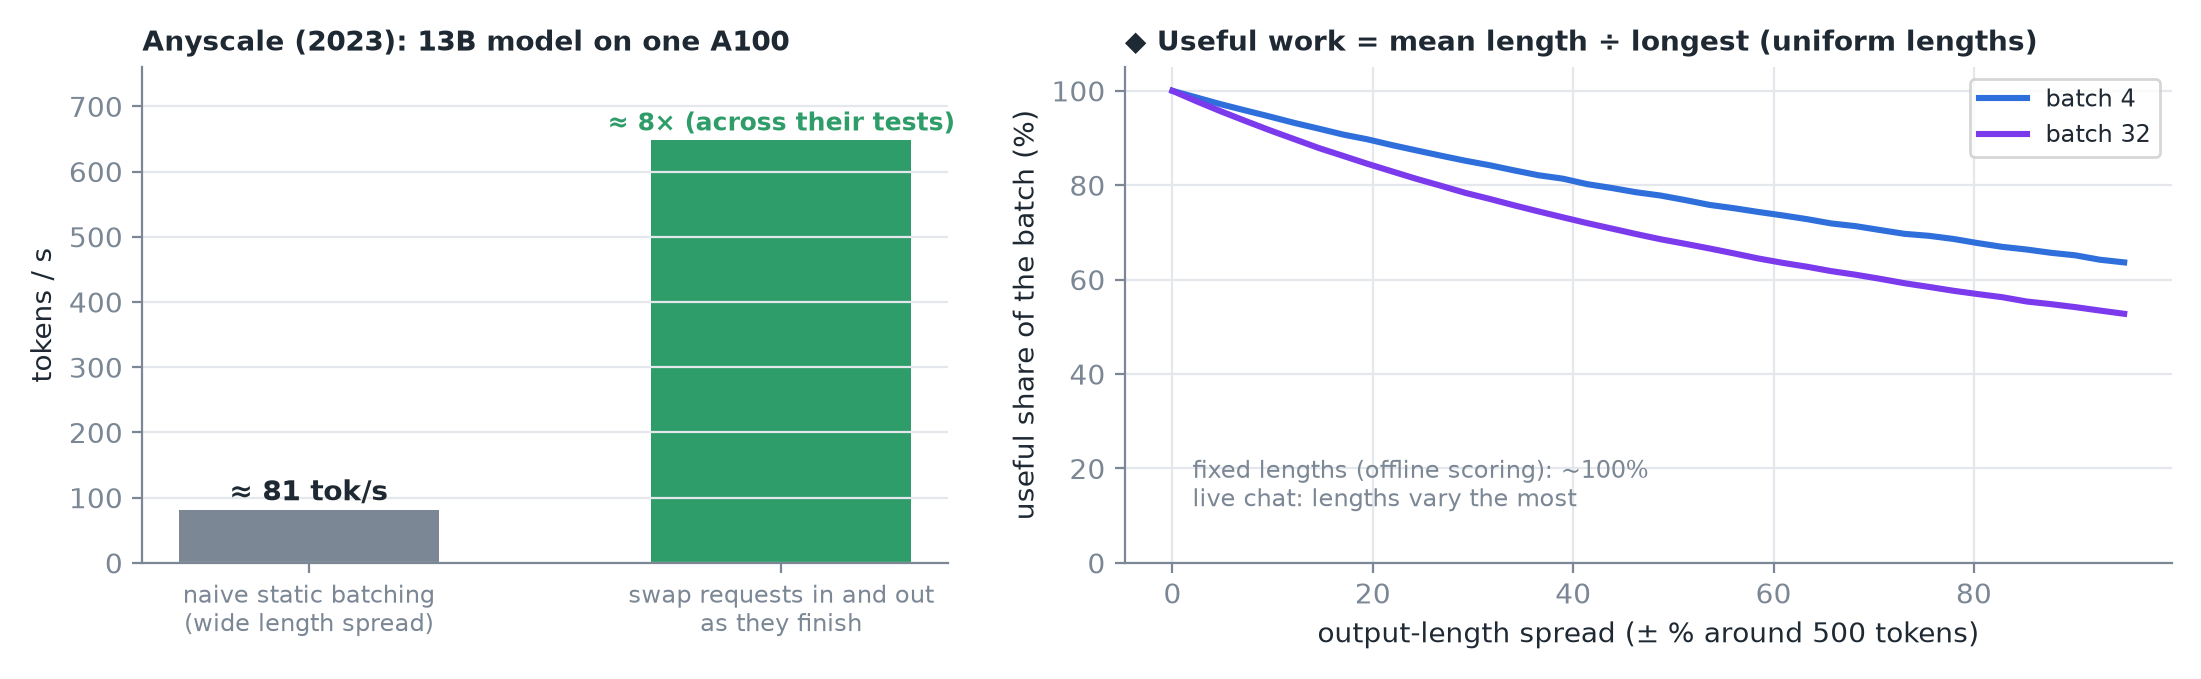 Anyscale đo một model 13B trên một A100: khi độ trải của độ dài đầu ra tăng, batch tĩnh ngây thơ tụt xuống khoảng 81 token/s, và qua các bài test của họ, engine thay request vào ra khi chúng xong đạt throughput khoảng gấp 8 lần. ◆ Phải: với độ dài ngẫu nhiên đều, tỷ lệ có ích xấp xỉ trung bình ÷ dài nhất, giảm khi độ trải tăng và khi batch lớn hơn.
- Batch tĩnh vẫn có chỗ đứng khi mọi job sinh ra độ dài gần như nhau: chấm điểm offline, đầu ra độ dài cố định. Padding gần như biến mất.
- Lưu lượng chat trực tiếp chính là nơi độ dài dao động nhiều nhất.
Quan trọng
Cách sửa là quyết định ai có mặt trong batch sau từng bước một: iteration-level scheduling.
5. Tóm tắt