10 · Lần theo forward pass của Transformer
Nguồn: fanout.sh / inference-eng / 02-01 · ~5 phút
Ghi chú
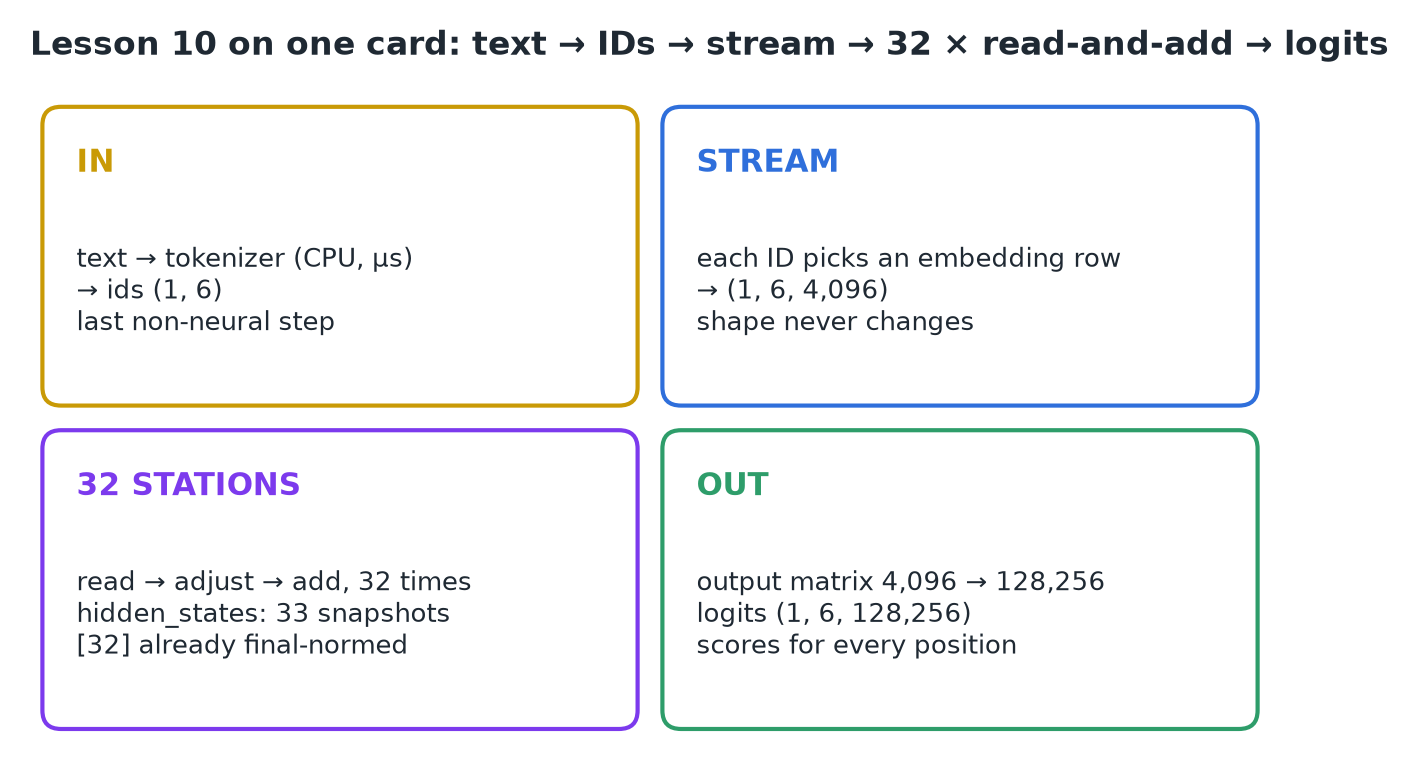
Mỗi token được sinh ra là một forward pass: tensor vào, tensor ra. Lần theo "The capital of France is" qua Llama 3.1 8B, bạn nhận lại ba thứ: 6 token ID, logits có shape (1, 6, 128.256), và 33 hidden state có shape (1, 6, 4.096). Văn bản thành ID, ID thành một residual stream có shape không bao giờ đổi, 32 block đọc rồi cộng vào nó, và một phép chiếu biến nó thành điểm cho từng mục trong vocabulary, ở mọi vị trí.
1. Bỏ qua lớp bọc, gọi thẳng model
model.generate() là một lớp bọc cho tiện; bên dưới là forward pass, chạy một lần cho mỗi token. Gọi thẳng model và yêu cầu nó giữ lại các kết quả trung gian:
enc = tok("The capital of France is", return_tensors="pt")
out = model(**enc, output_hidden_states=True)
enc.input_ids.shape        # (1, 6)
out.logits.shape           # (1, 6, 128256)
len(out.hidden_states)     # 33, mỗi cái (1, 6, 4096)
Toàn bộ dấu vết nằm trong ba kết quả đó.
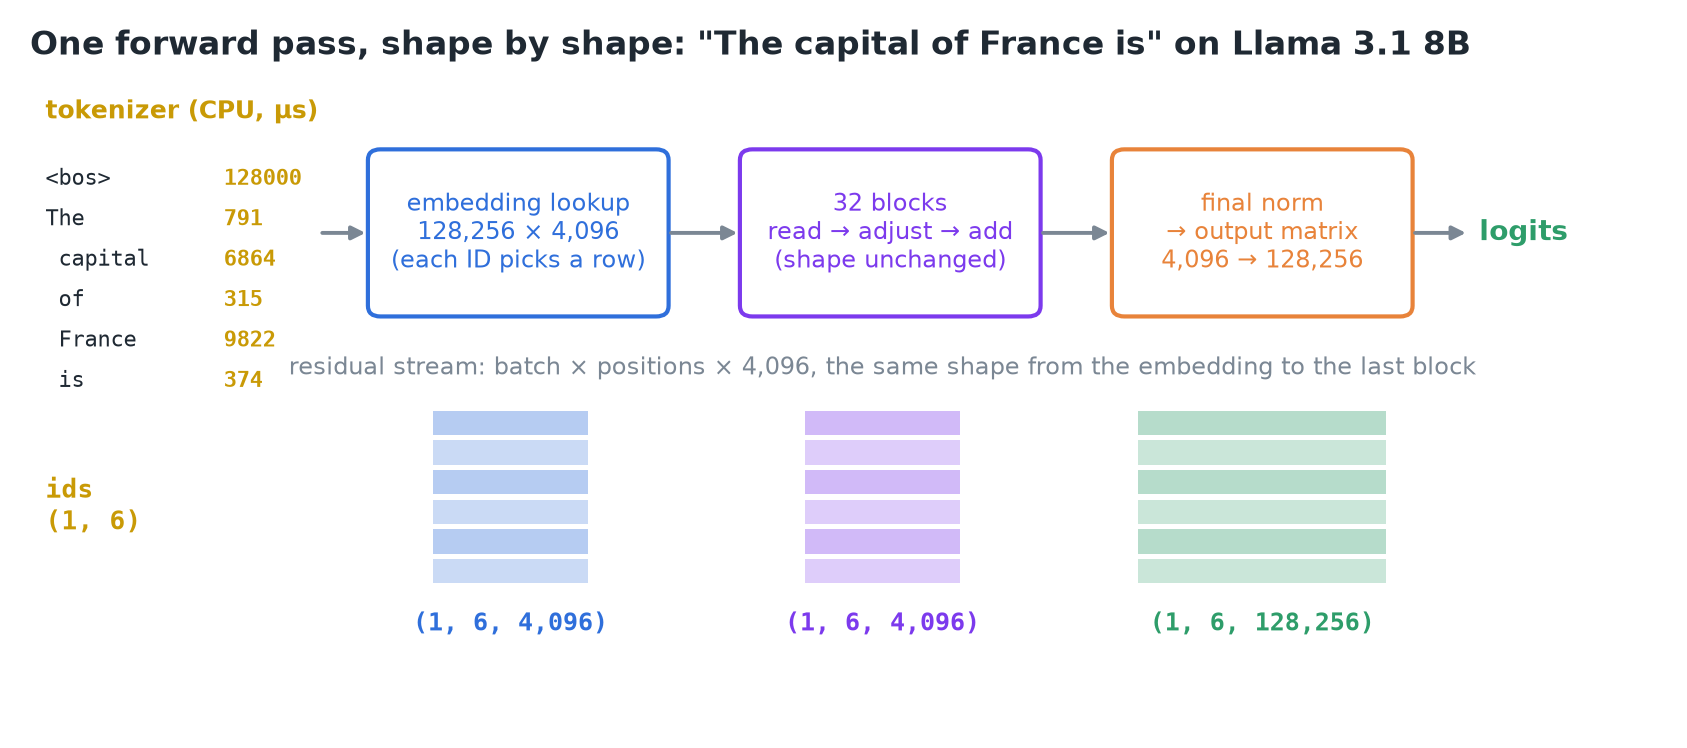 Từ sáu token ID thành một stream (1, 6, 4.096) rồi thành logits (1, 6, 128.256).
2. Đầu vào: tokenizer và embedding
- Tokenizer: 5 từ + một marker bắt đầu văn bản → 6 ID (128000, 791, 6864, 315, 9822, 374). Đây là bước không-neural cuối cùng: một bảng tra cộng các quy tắc merge, chạy trên CPU trong vài micro giây. Sau bước này, request chỉ còn là tensor.
- Embedding: mỗi ID chọn hàng của nó trong ma trận embedding 128.256 × 4.096. Sáu hàng xếp chồng = (1, 6, 4.096): batch, vị trí, số lượng số mỗi vị trí.
Quan trọng
Tensor đó là residual stream, và từ đây tới tận cuối model shape của nó không bao giờ đổi.
3. Đi qua: 32 trạm đọc-rồi-cộng
Mỗi block trong 32 block đọc stream, tính một điều chỉnh, và cộng nó trở lại: shape vào thế nào thì ra thế ấy. Bên trong mỗi block, attention cho sáu vị trí trao đổi thông tin với nhau dưới một mask chỉ nhìn về trước (causal), và MLP (nơi chứa phần lớn tham số) làm việc theo từng vị trí, với bước chuẩn hoá bao quanh cả hai.
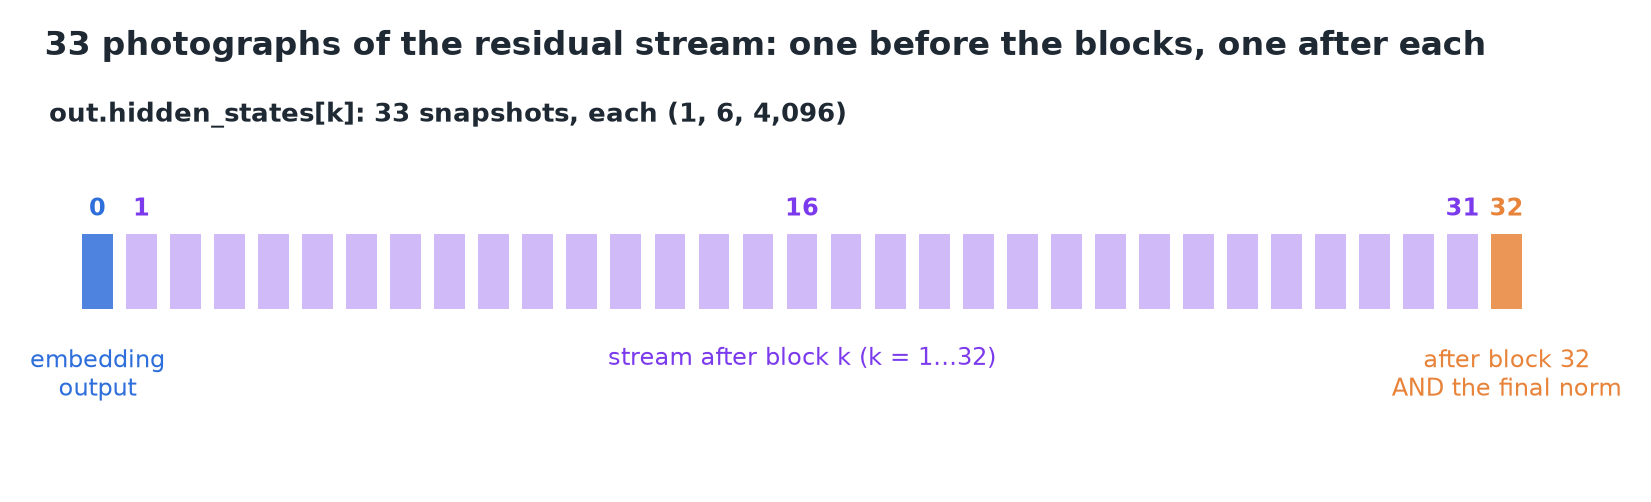 Chỉ số 0 là đầu ra embedding; 1–32 là stream sau mỗi block. Cái cuối cùng đã được áp final norm.
hidden_states[0]= đầu ra embedding (trước mọi block);hidden_states[k]= stream sau block k.- Chi tiết cần để ý: thư viện trả về ảnh chụp cuối cùng sau khi đã áp final norm.
- So vài số đầu ở vị trí cuối tại chỉ số 0 và chỉ số 32: cùng vị trí, cùng shape, số khác nhau. Phần khác nhau đó chính là cách model đọc hiểu prompt.
4. Đầu ra: logits cho mọi vị trí
Sau block cuối và final norm, một ma trận đầu ra (cùng kích thước với embedding) chiếu 4.096 số của mỗi vị trí lên vocabulary: 128.256 điểm, gọi là logits.
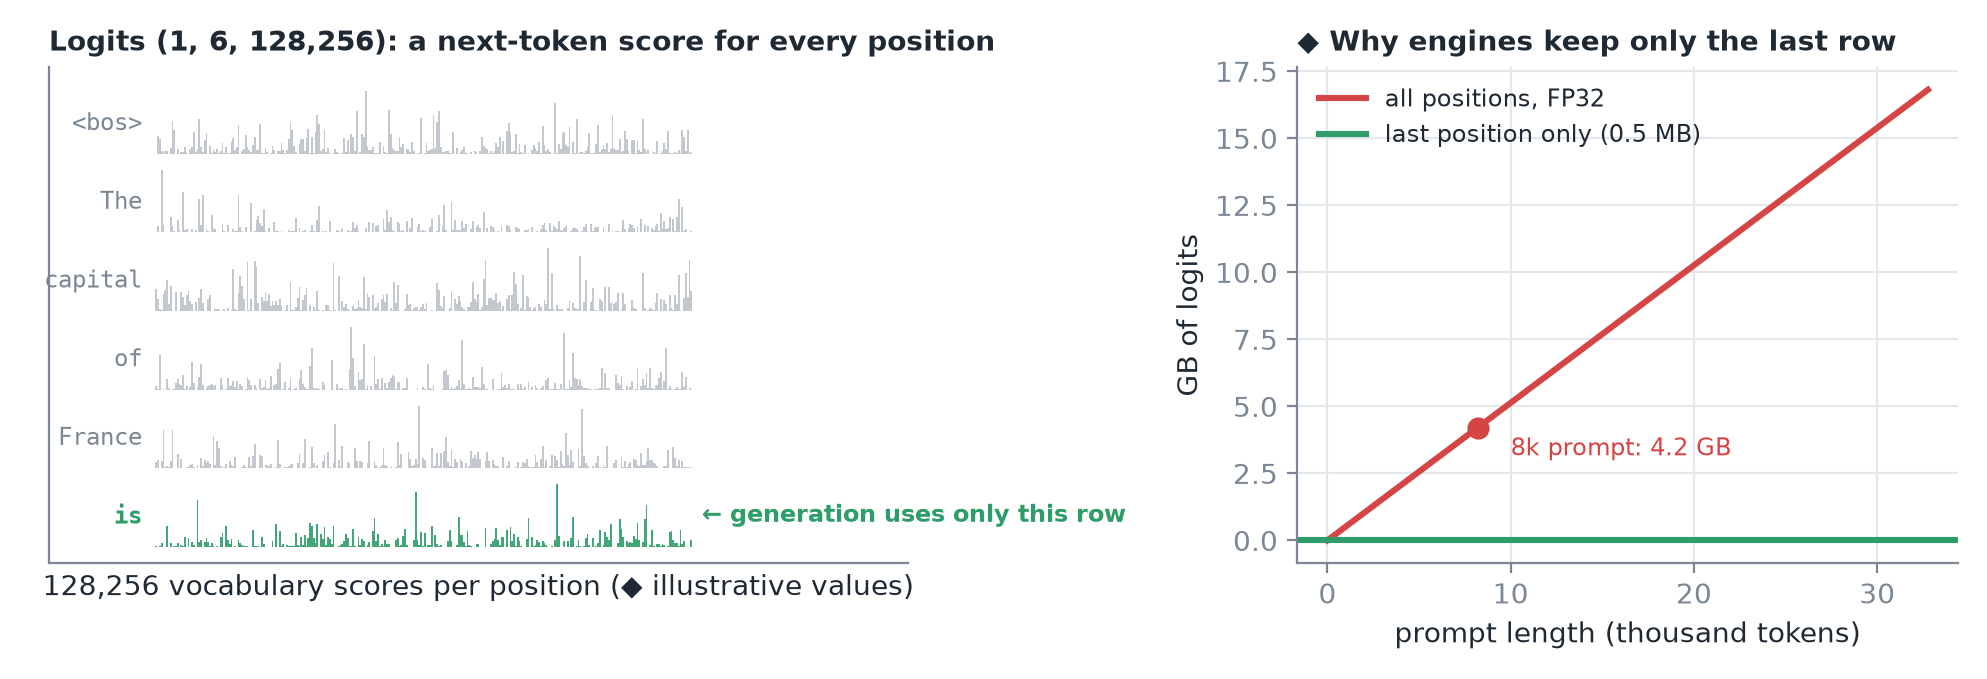 Trái: model chấm điểm token tiếp theo ở cả sáu vị trí. Phải (◆): giữ logits của mọi vị trí trở nên tốn kém với prompt dài.
Quan trọng
Shape là (1, 6, 128.256): model chấm điểm token tiếp theo cho cả sáu vị trí, không chỉ vị trí cuối. Quá trình sinh chỉ dùng hàng của vị trí cuối.
5. Tóm tắt