54 · Đo mức suy giảm chất lượng
Nguồn: fanout.sh / inference-eng / 11-07 · ~7 phút
Ghi chú
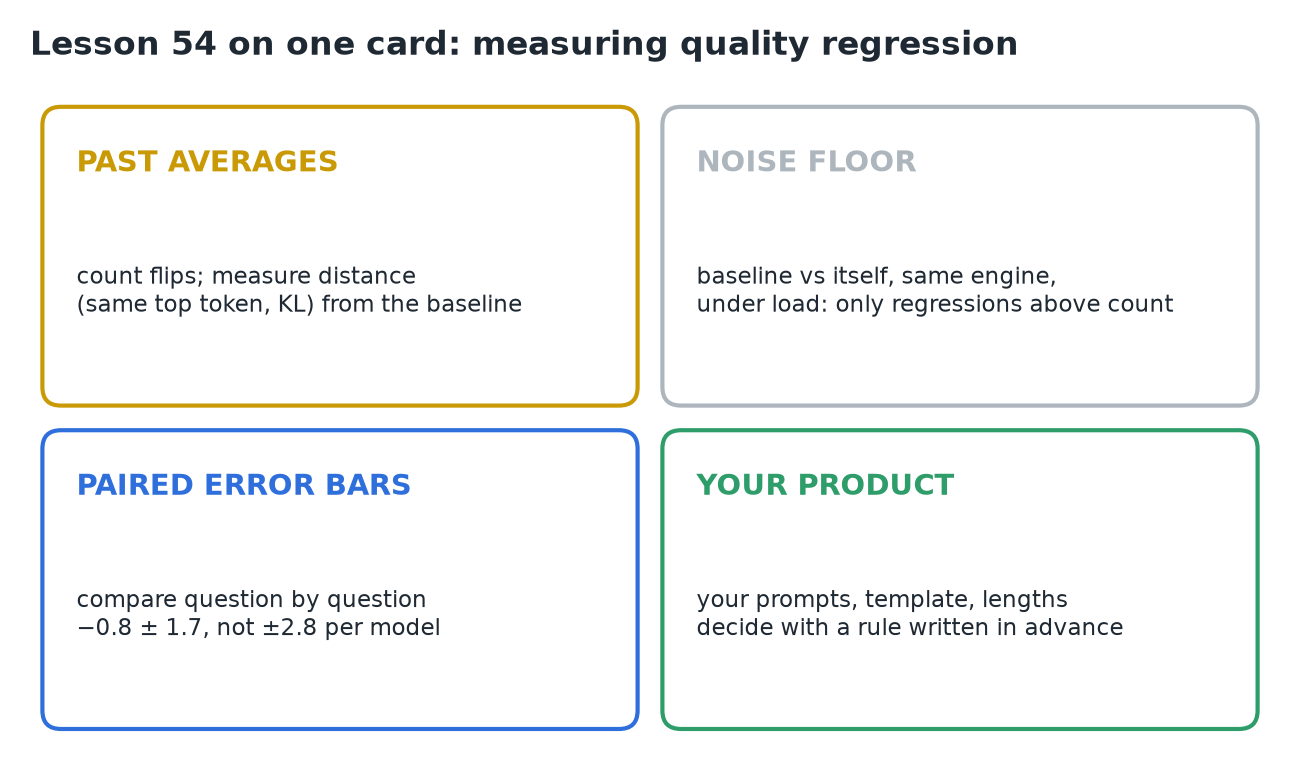
Một model 4-bit có thể nhanh hơn ≈ 2,5 lần với một người dùng và trọng số dưới ⅓ bộ nhớ, trong khi điểm benchmark chỉ giảm 72,0% → 71,2%. Riêng điểm số không cho biết nó có tệ đi hay không: trung bình che giấu các lần lật (flip) (câu trả lời bị thay đổi), và bản thân model gốc đã có nhiễu. Hãy leo một chiếc thang bốn bước kiểm tra: khoảng cách so với bản gốc, số lần lật so với mức nhiễu nền, độ chính xác theo cặp kèm thanh sai số, và prompt sản phẩm của chính bạn. Rồi quyết định bằng một quy tắc viết ra trước khi chạy.
1. Cái bẫy trong giá trị trung bình
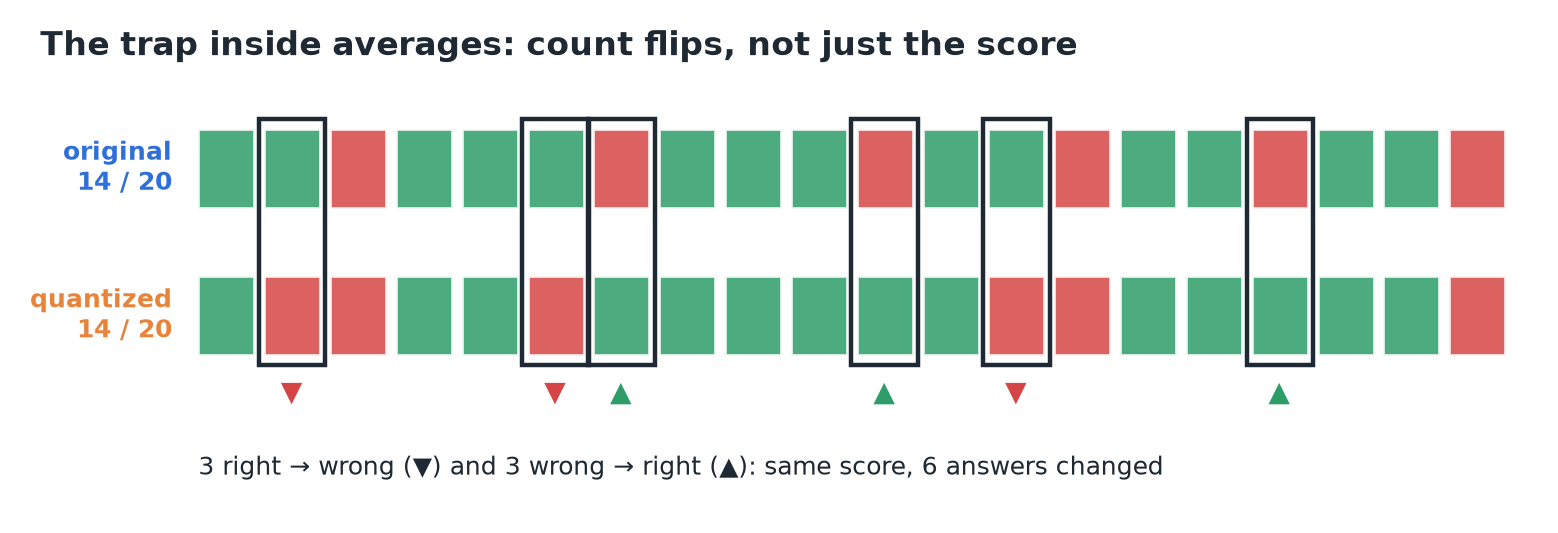 Hai mươi câu hỏi, cách sắp xếp của tôi cho các con số đếm của bài.
- Cả hai model đều đạt 14 / 20, nhưng 3 câu chuyển từ đúng → sai và 3 câu chuyển từ sai → đúng: 6 trên 20 đã thay đổi.
- Dutta và cộng sự, Microsoft Research (NeurIPS 2024): trên các model lượng tử hoá, độ chính xác thay đổi ≤ 2% trong khi số lần lật lên tới 13,6%.
- Model có nhiều lần lật hơn bị đánh giá tệ hơn trong hội thoại mở, kể cả khi điểm benchmark của chúng bằng nhau.
2. Chiếc thang
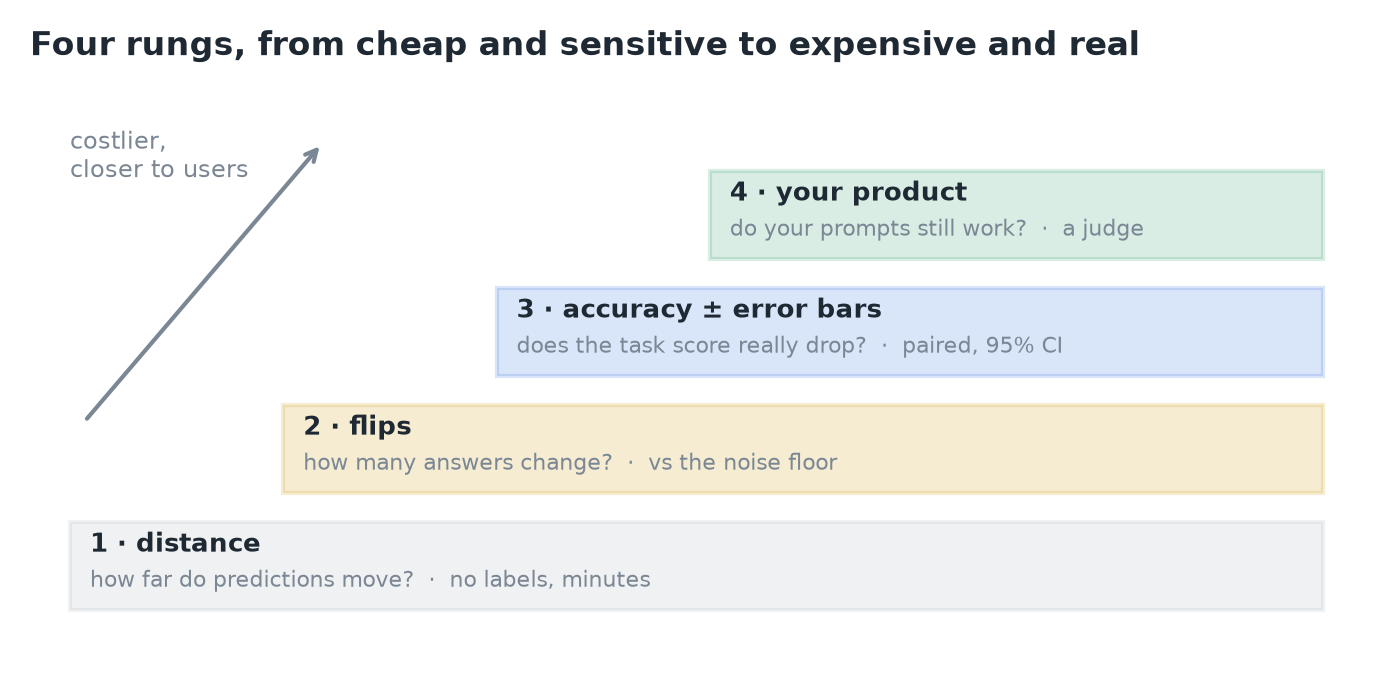 Mỗi bậc tốn hơn và gần với người dùng thật hơn.
- Khoảng cách: dự đoán dịch chuyển bao xa so với bản gốc?
- Lần lật: bao nhiêu câu trả lời thay đổi, so với mức nhiễu nền?
- Độ chính xác kèm thanh sai số: điểm tác vụ có thực sự giảm không?
- Sản phẩm của bạn: prompt của chính bạn còn chạy tốt không?
3. Bậc 1: khoảng cách
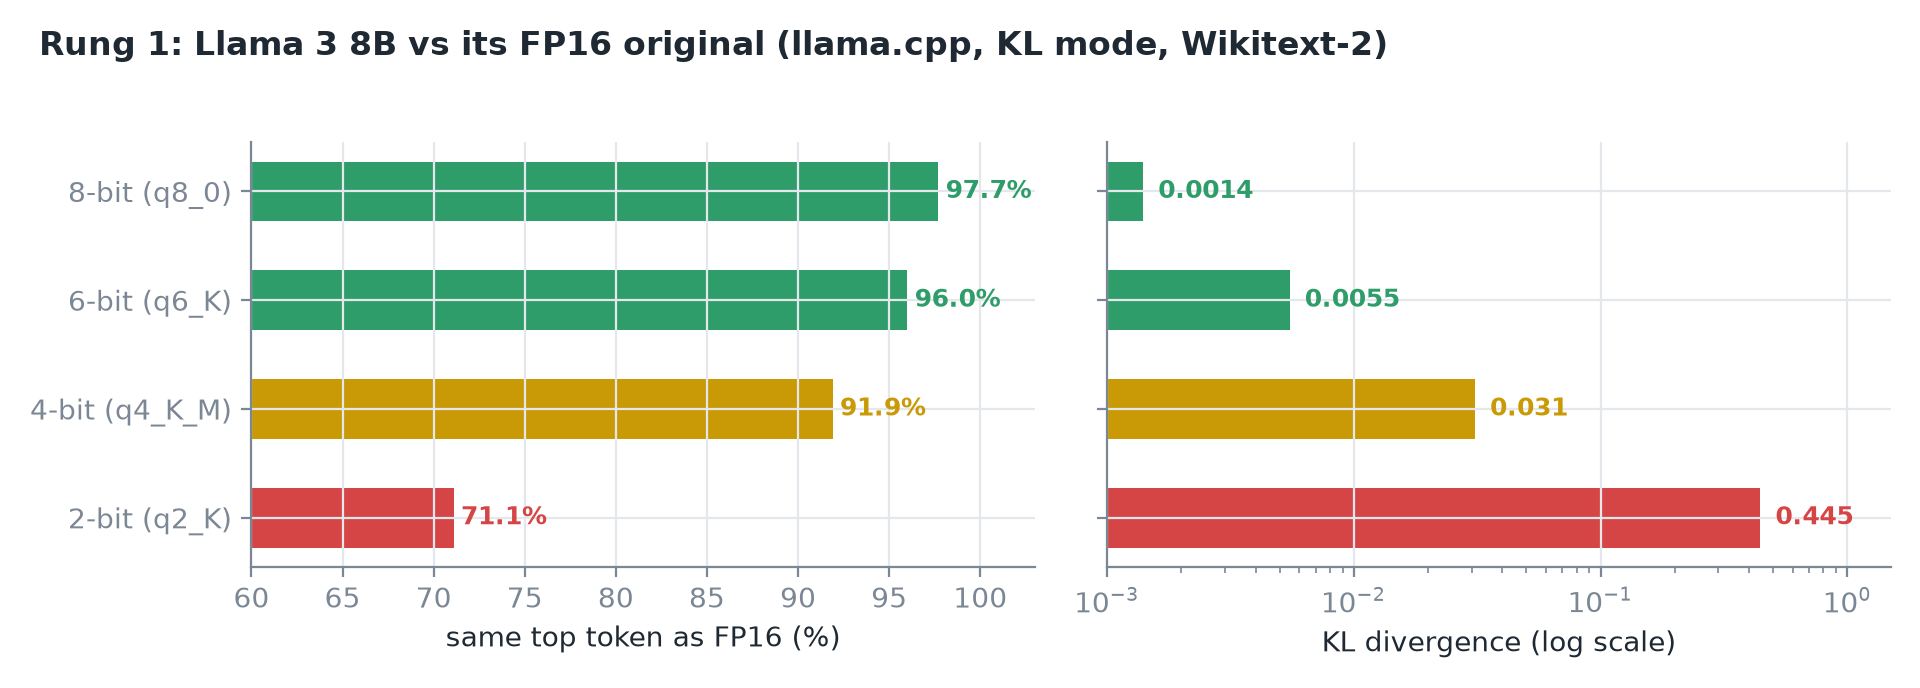 Chế độ KL-divergence của llama.cpp, Llama 3 8B so với FP16 trên Wikitext-2.
- Chạy model gốc và model lượng tử hoá trên cùng văn bản và so sánh, từng token một:
- tần suất chúng chọn cùng token cao nhất;
- KL divergence giữa hai phân phối xác suất.
- Nó không cần nhãn và chạy trong vài phút, nên rất tốt để bắt lỗi (một lần chuyển đổi hỏng hiện ra thành KL khổng lồ).
- 4-bit (q4_K_M) giữ cùng token cao nhất 91,9% số lần; 2-bit tụt xuống 71,1%, với KL lớn hơn ≈ 14 lần.
- Giới hạn: nó đo khoảng cách, không đo tác hại. Một token khác đi vẫn có thể là câu trả lời tốt ngang bằng.
4. Mức nhiễu nền
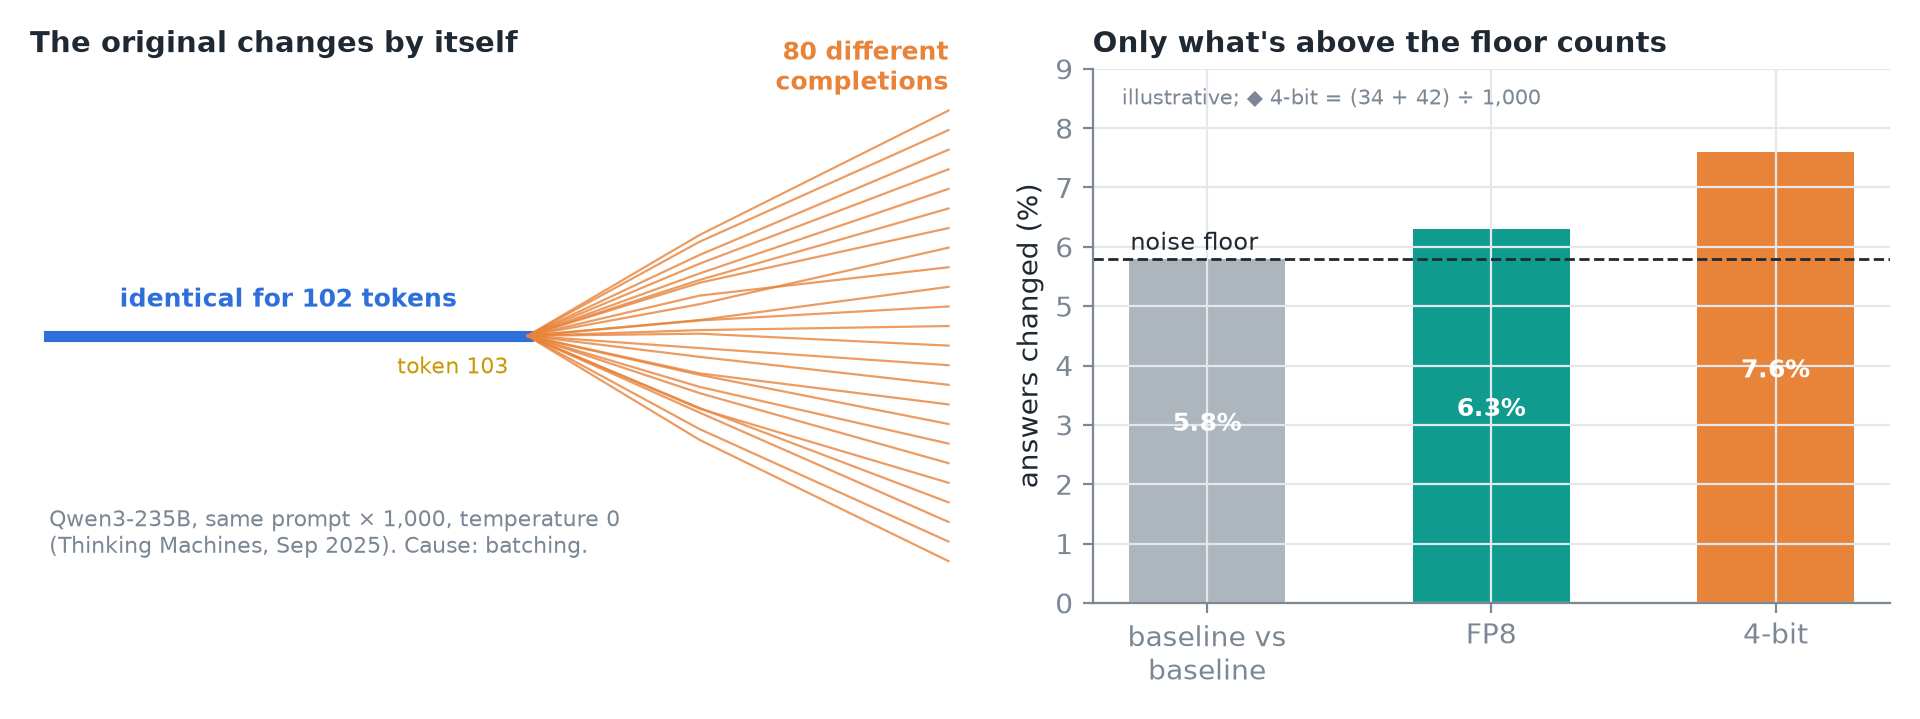 Panel phải: tỷ lệ lật minh hoạ. ◆ Tôi đặt thanh 4-bit ở 7,6% để khớp với ví dụ theo cặp bên dưới.
- Trước hết hãy hỏi bản gốc tự nó thay đổi bao nhiêu:
- BF16 so với FP16, cùng trọng số, bất đồng về token cao nhất ≈ 0,26% số lần.
- Thinking Machines (tháng 9/2025): Qwen3-235B, cùng một prompt 1.000 lần ở temperature 0, cho ra 80 kết quả khác nhau. Tất cả giống hệt nhau trong 102 token, rồi tách ra ở token 103.
- Nguyên nhân là batching: kích thước batch khác nghĩa là phép tính hơi khác, nên kết quả có thể khác.
- Vì vậy hãy đo mức nền bằng cách chạy baseline với chính nó, trong cùng engine, dưới tải. Chỉ những lần lật vượt trên mức nền mới tính là lỗi của model lượng tử hoá.
5. Bậc 3: độ chính xác kèm thanh sai số
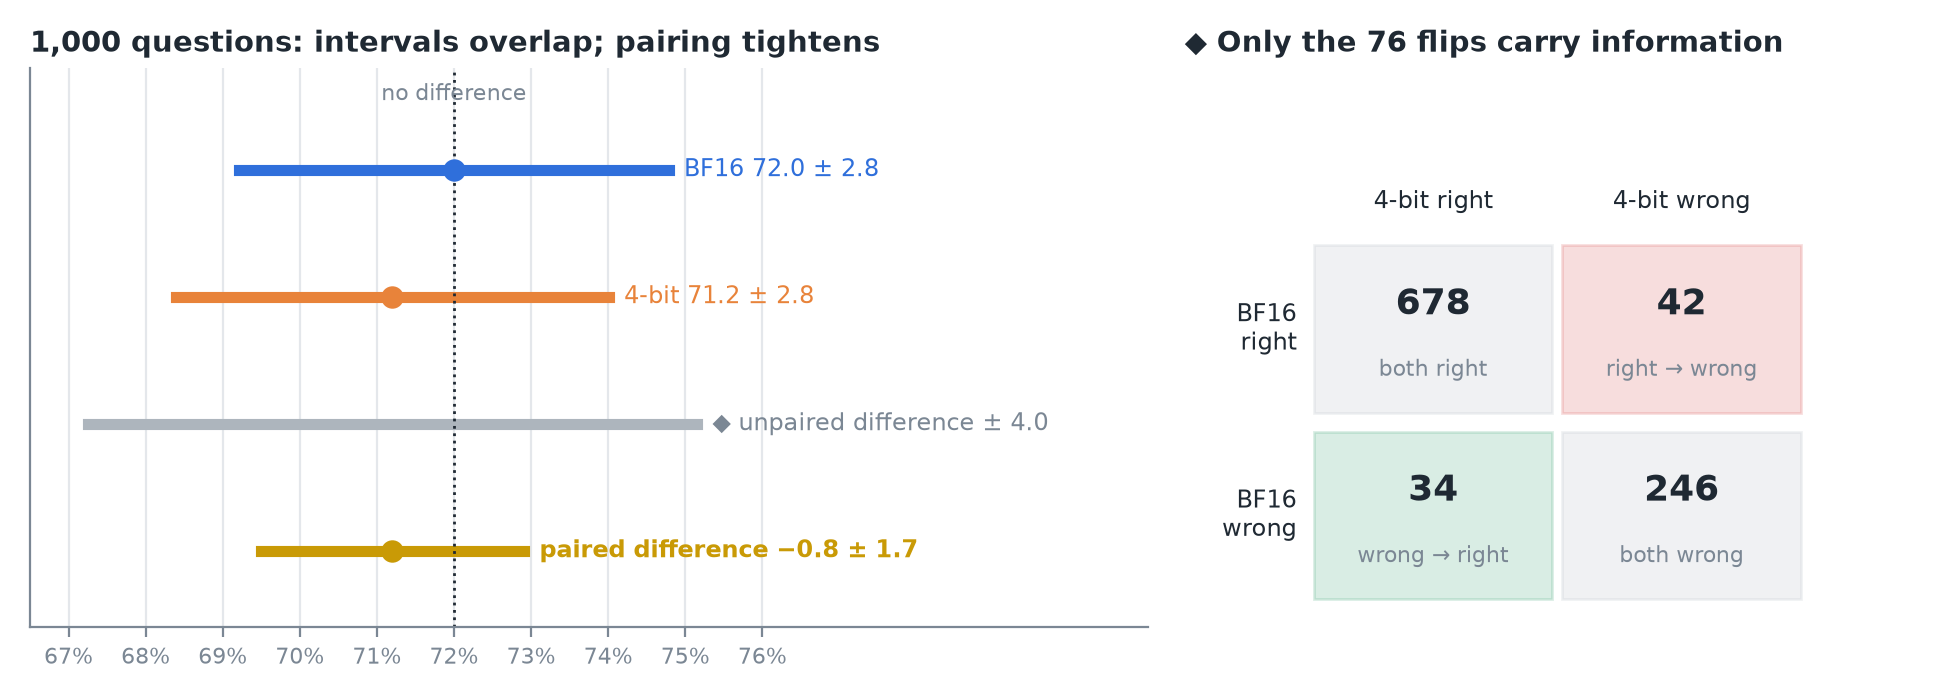 Điểm số là số minh hoạ của bài; phép tính là thật. ◆ Bảng 2×2 và thanh hiệu số không ghép cặp là của tôi.
- Trên 1.000 câu hỏi ở mức ≈ 70%, mỗi điểm số có khoảng tin cậy 95% vào khoảng ±2,8 điểm. Hai khoảng chồng lên nhau gần như hoàn toàn, nên nói lên rất ít.
- Cả hai model trả lời cùng 1.000 câu hỏi, nên hãy so sánh chúng theo từng câu:
- 34 câu chuyển sai → đúng, 42 câu chuyển đúng → sai.
- Hiệu số theo cặp: −0,8 ± 1,7 điểm. Khoảng này chứa 0, nên không có mức giảm có ý nghĩa thống kê.
- Không giảm có ý nghĩa không có nghĩa là không thay đổi: vẫn cần có người đọc 42 câu bị tụt.
Mẹo
◆ Ghép cặp có ích vì 924 câu cả hai model đồng ý triệt tiêu nhau. Coi là hai mẫu riêng biệt thì hiệu số mang ±4,0 điểm, hơn gấp đôi mức ±1,7 khi ghép cặp. Cùng các con số đó cho một kiểm định McNemar: (42 − 34)² ÷ 76 ≈ 0,84, p ≈ 0,36. Và tỷ lệ lật là (34 + 42) ÷ 1.000 = 7,6%, gần gấp mười lần mức thay đổi điểm 0,8.
6. Bậc 4: sản phẩm của bạn
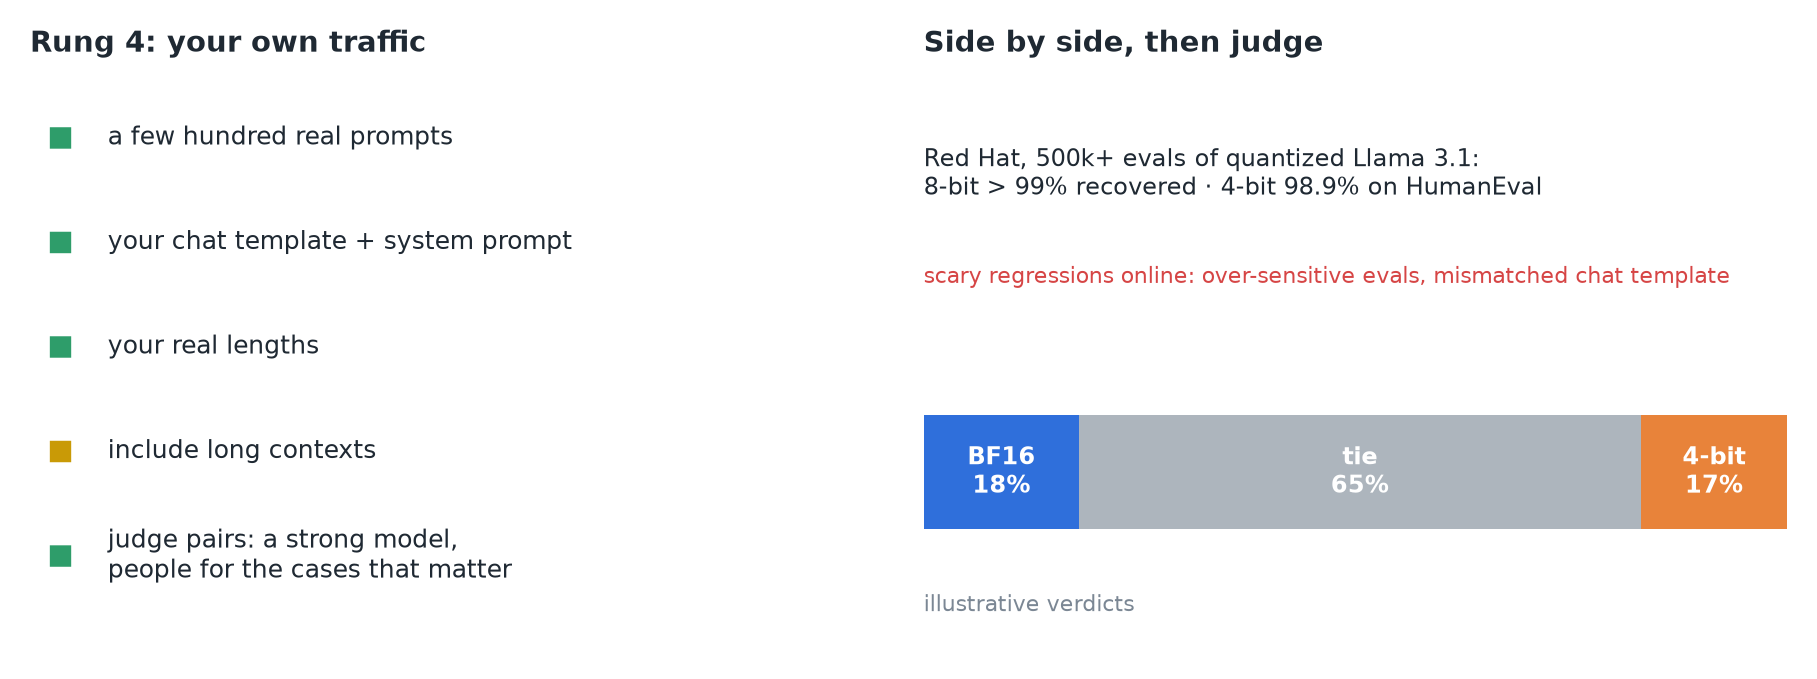 Phán quyết của giám khảo mang tính minh hoạ.
- Dùng vài trăm prompt thật, với chat template, system prompt và độ dài thật của bạn. Có cả context dài.
- Đặt câu trả lời của bản gốc và của model lượng tử hoá cạnh nhau và để một giám khảo chọn: một model mạnh, cộng con người cho các trường hợp quan trọng.
- Một kết quả như 18% / 65% hoà / 17% là hoà.
- Red Hat, hơn 500.000 lần đánh giá Llama 3.1 lượng tử hoá (8B, 70B, 405B): 8-bit giữ lại > 99%; 4-bit đạt 98,9% với code (HumanEval).
- Nhiều trường hợp suy giảm đáng sợ được đăng trên mạng đến từ bộ đánh giá quá nhạy hoặc chat template không khớp, không phải do lượng tử hoá.
7. Quyết định
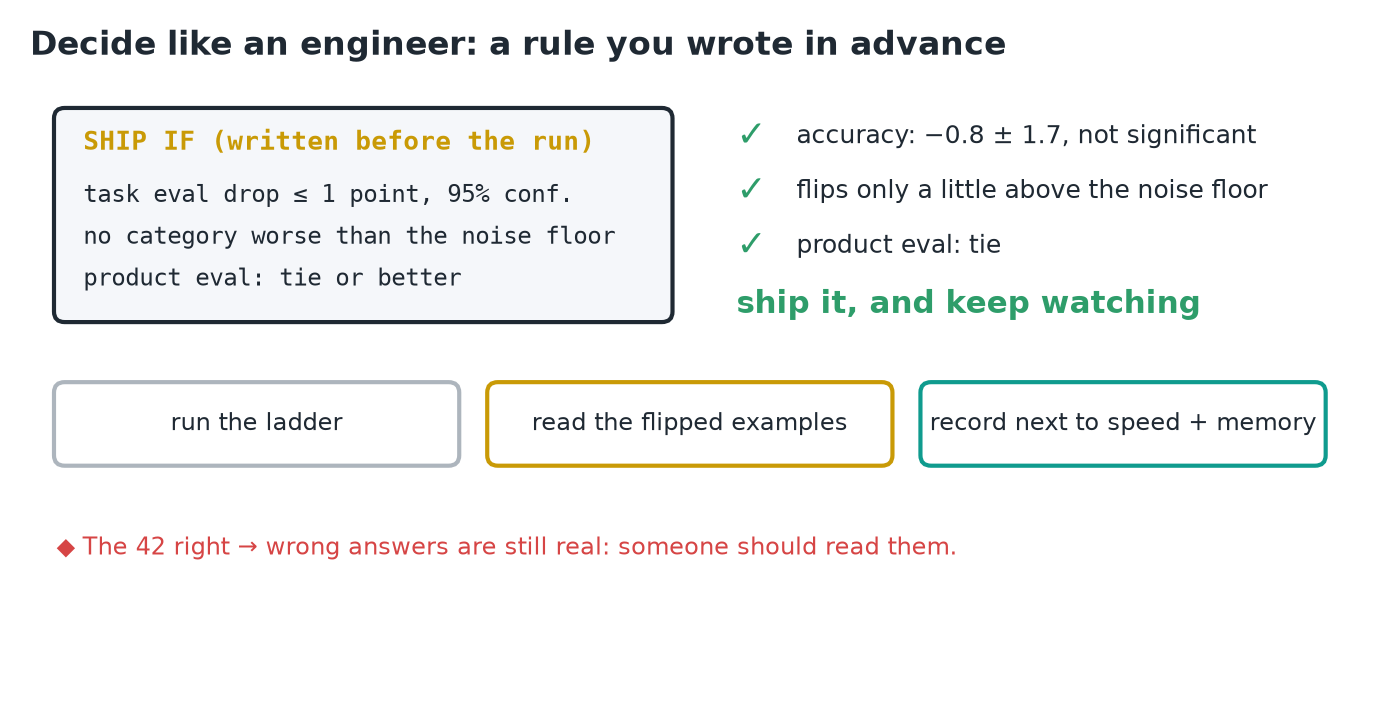 Kết quả là số minh hoạ của bài.
- Viết quy tắc trước khi chạy, ví dụ:
- điểm đánh giá tác vụ giảm ≤ 1 điểm ở độ tin cậy 95%;
- không hạng mục nào tệ hơn mức nhiễu nền;
- đánh giá sản phẩm: hoà hoặc tốt hơn.
- Sau đó leo chiếc thang, đọc các ví dụ bị lật, và ghi kết quả cạnh lợi ích về tốc độ và bộ nhớ.
- Ở đây: độ chính xác −0,8 ± 1,7, không có ý nghĩa; số lần lật chỉ hơi trên mức nền; đánh giá sản phẩm hoà. Ship nó, và tiếp tục theo dõi.
Quan trọng
Một khẳng định về chất lượng cần ba thứ: mức nhiễu nền, một so sánh theo cặp kèm thanh sai số, và một lần kiểm tra trên prompt của chính bạn. Một điểm số trung bình duy nhất không chứng minh được gì theo cả hai chiều.
8. Ba điều chỉnh nhanh
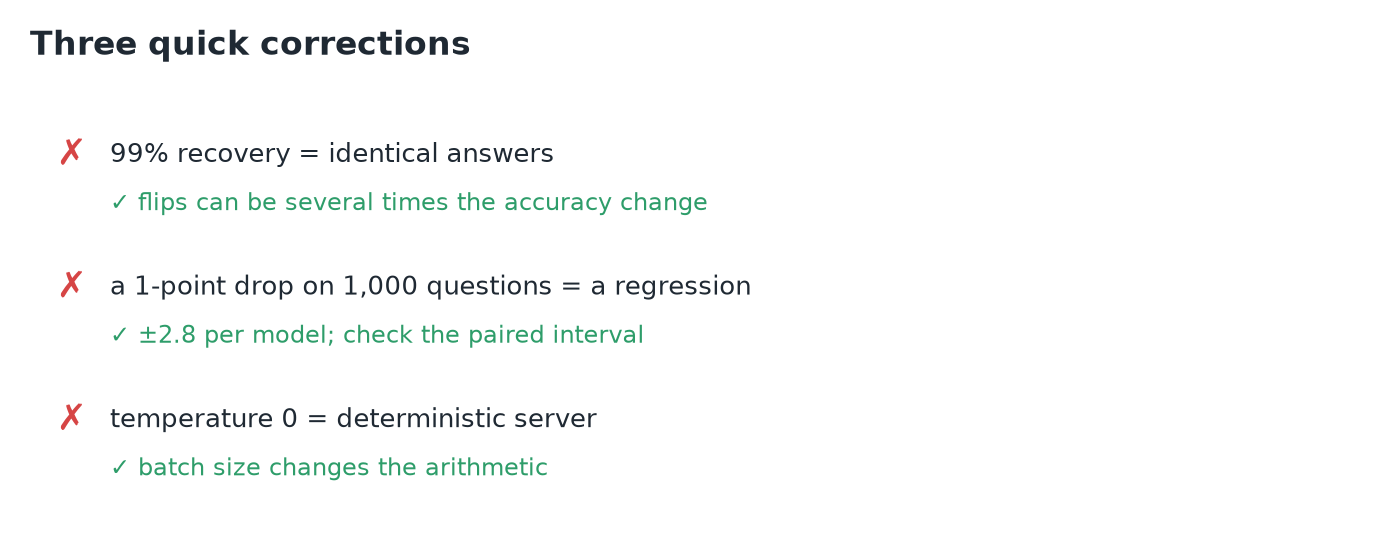
- Giữ lại 99% không có nghĩa là câu trả lời giống hệt: số lần lật có thể gấp nhiều lần mức thay đổi độ chính xác.
- Giảm 1 điểm trên 1.000 câu tự nó chưa phải là suy giảm: hãy kiểm tra khoảng tin cậy theo cặp.
- Temperature 0 không làm server tất định: batching làm thay đổi phép tính.
9. Tóm tắt