18 · Tính bộ nhớ model và runtime
Nguồn: fanout.sh / inference-eng / 03-05 · ~7 phút
Ghi chú
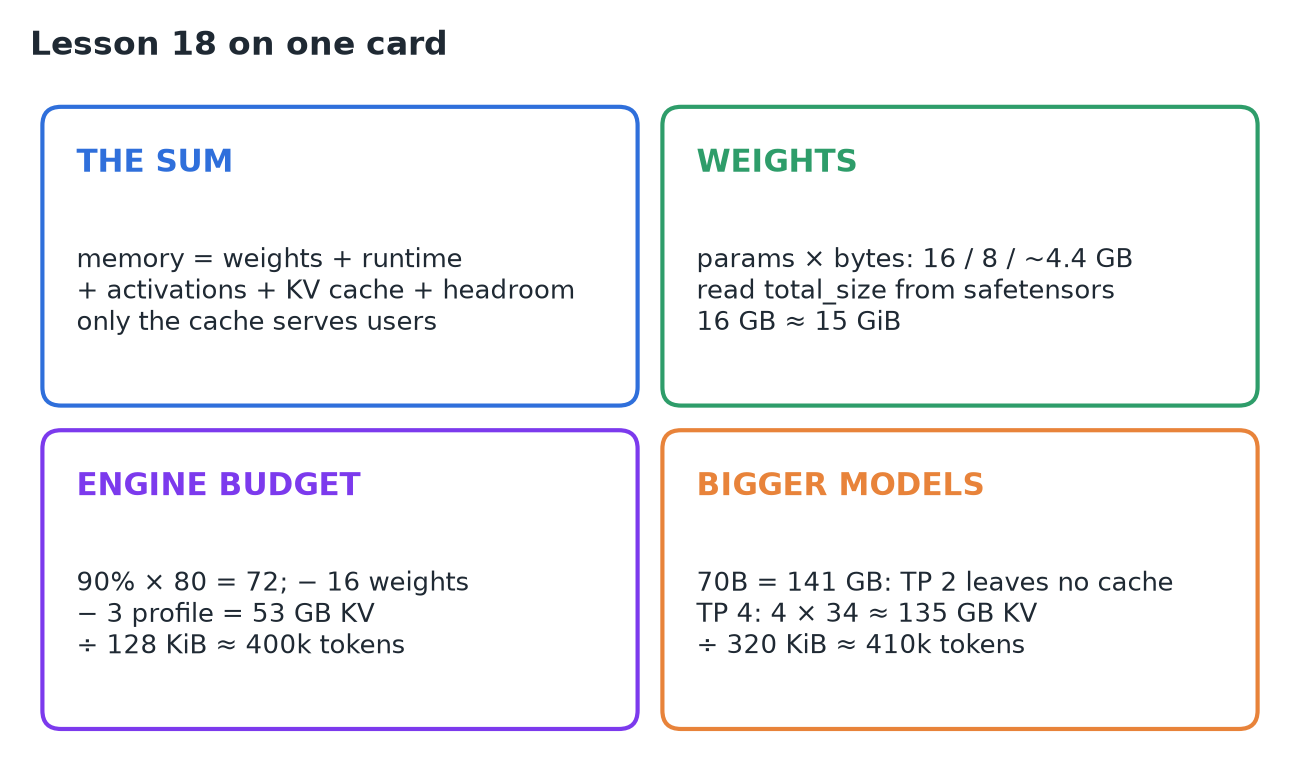
16 GB trọng số Llama 3 8B trên một H100 80 GB không để lại 64 GB trống. Bộ nhớ GPU = trọng số + overhead runtime + activation + KV cache + khoảng dự phòng, và chỉ KV cache thực sự phục vụ người dùng, nên cuộc chơi là: biết chính xác phần overhead và dành phần còn lại cho cache. vLLM làm việc này lúc khởi động: lấy ngân sách 90% (72 GB), trừ trọng số đo được (16) và đỉnh của một lần chạy profile (≈ 3), phần còn lại, ≈ 53 GB ≈ 400 nghìn token, thành KV cache. Llama 3 70B (141 GB) không vừa một GPU, trên hai GPU thì không còn chỗ cho cache, và trên bốn GPU thì được ≈ 135 GB cache ≈ 410 nghìn token.
1. Bộ nhớ GPU đi đâu
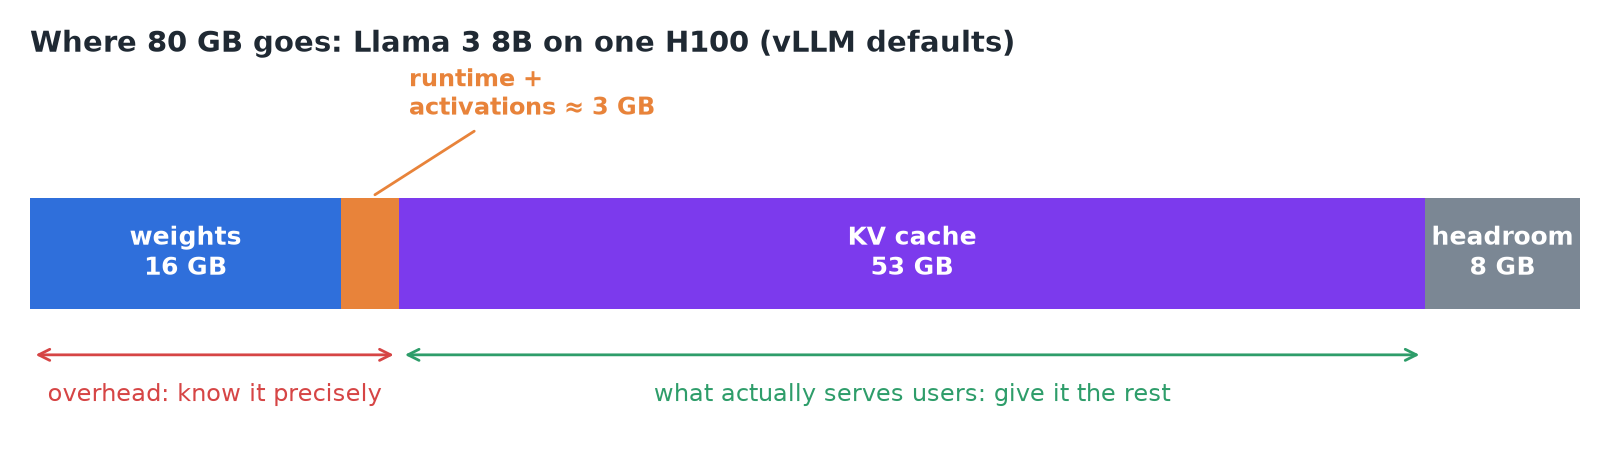 Trọng số (mảnh cố định lớn nhất), một phần cho runtime (CUDA context, buffer truyền thông, workspace của kernel), activation (tensor tạm của một forward pass), KV cache (key và value của mọi request đang chạy), và khoảng dự phòng bạn không bao giờ định dùng (CUDA graph, phân mảnh, biên an toàn).
Quan trọng
Mọi thứ trừ KV cache đều là overhead. KV cache là thứ cho phép bạn phục vụ người dùng.
2. Trọng số: phần dễ
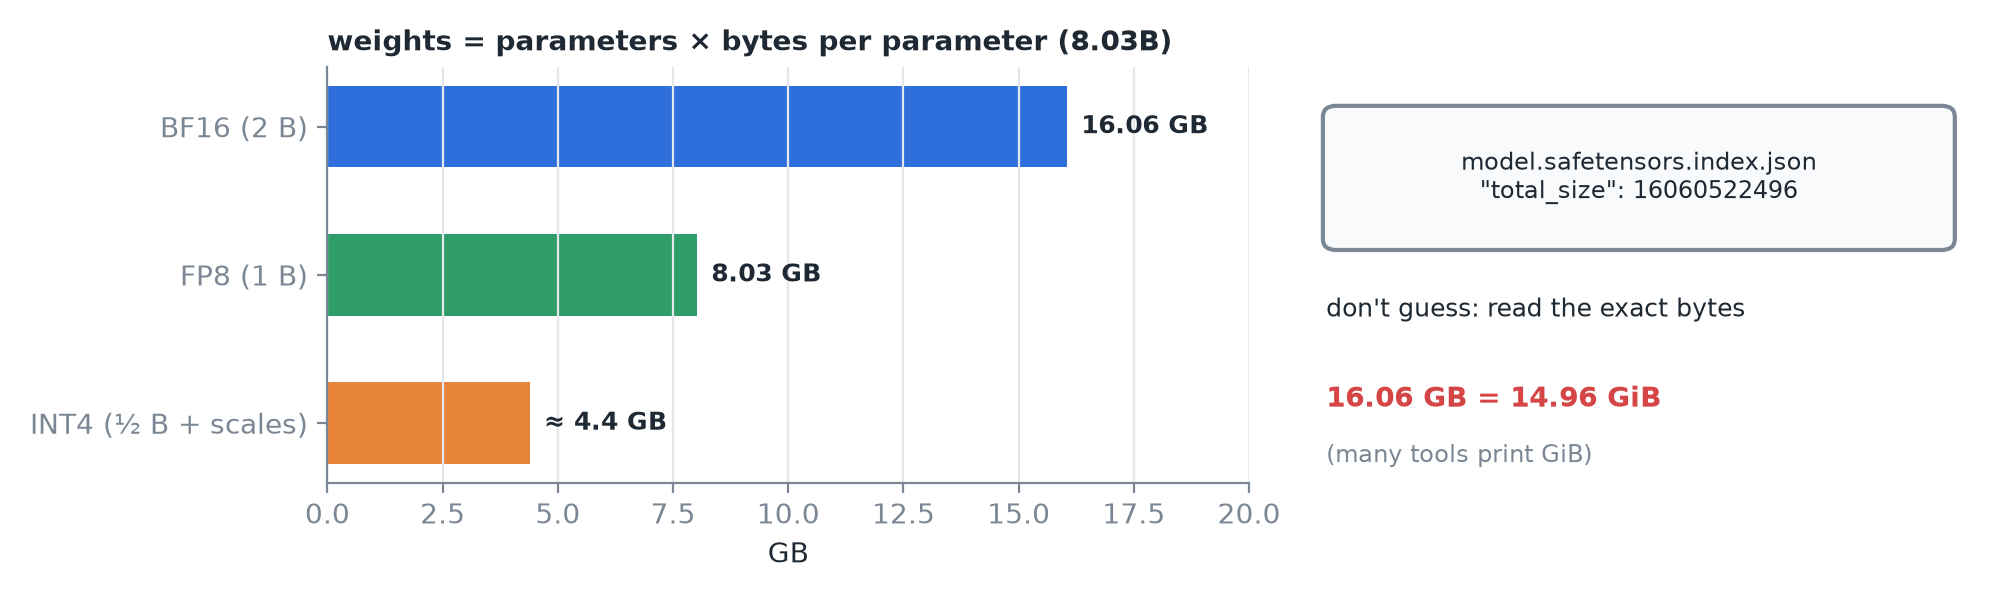 Định dạng 4-bit nặng hơn 4 GB một chút vì hệ số scale cộng thêm.
- Đừng đoán số tham số: file
model.safetensors.index.jsoncủa model ghi chính xáctotal_sizetính bằng byte. - Để ý đơn vị: 16 GB ≈ 15 GiB, đơn vị mà nhiều công cụ thực sự in ra (bảng đơn vị ở bài 04).
3. Phần của runtime (dễ quên)
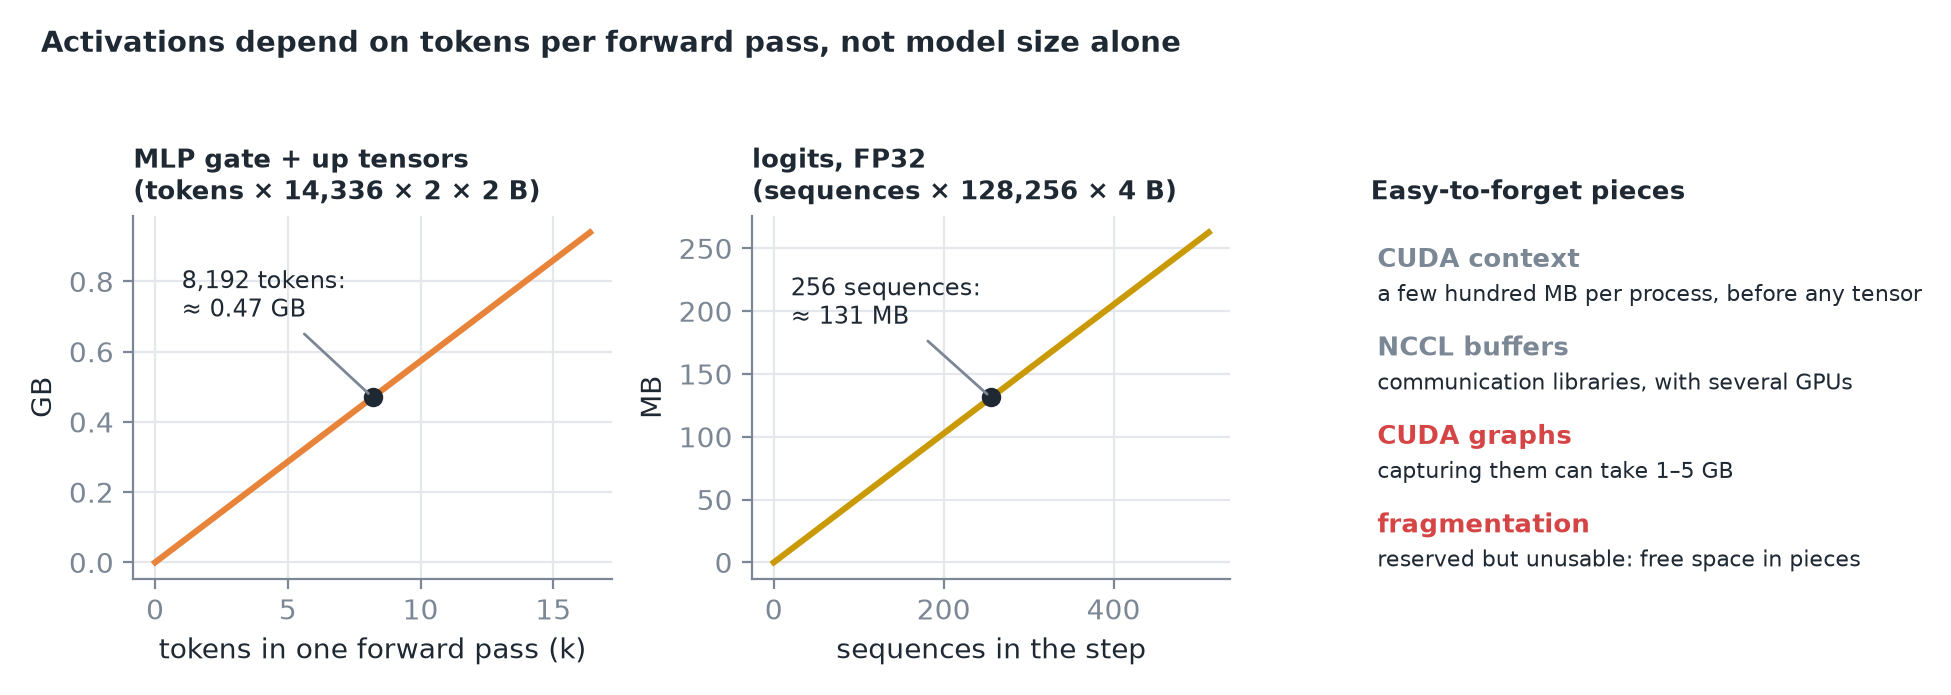
- CUDA context: chỉ khởi tạo GPU trong một process đã tốn vài trăm MB, trước cả khi có tensor nào. Với nhiều GPU, NCCL thêm buffer riêng của nó.
- Activation: phụ thuộc vào số token một forward pass xử lý, không chỉ vào kích thước model. 8.192 token trong một bước: riêng tensor gate và up của MLP đã chiếm ~0,5 GB, trong một khoảnh khắc. Logits cho 256 sequence ở FP32: ~131 MB.
- CUDA graph: capture chúng để giảm chi phí launch có thể tốn 1–5 GB.
- Phân mảnh: allocator có thể giữ bộ nhớ mà nó không cấp ra được, vì vùng trống bị chia thành những mảnh quá nhỏ để dùng.
4. Một engine thật định cỡ cache thế nào
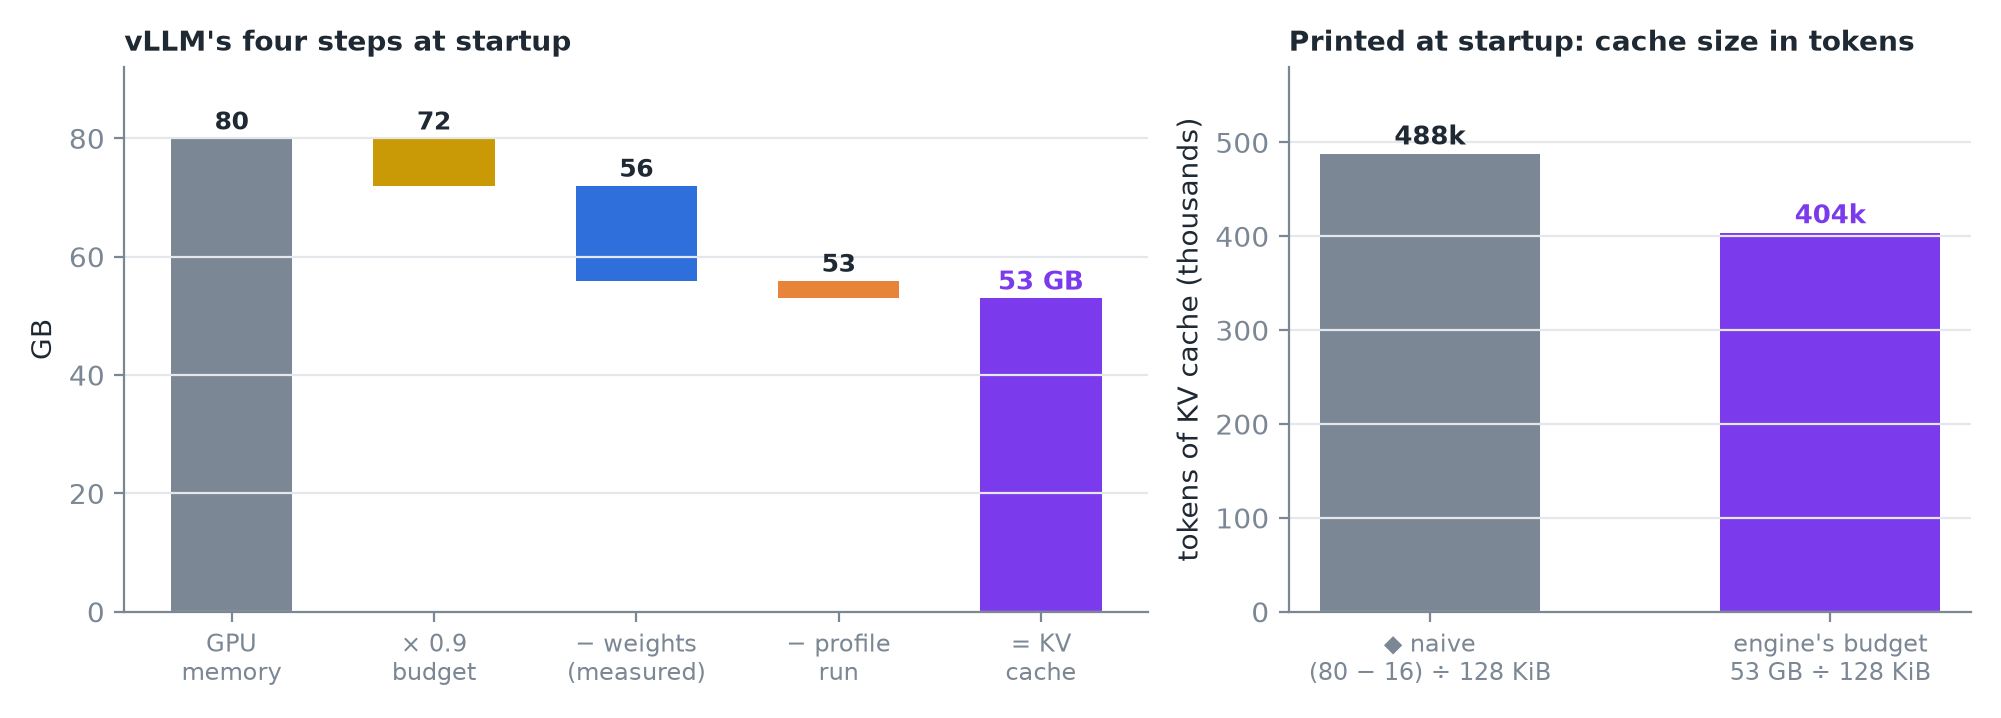 Bước 1: ngân sách = 90% GPU (72 GB). Bước 2: nạp và đo trọng số (16 GB). Bước 3: một forward pass giả ở batch lớn nhất cho phép ghi lại đỉnh activation và bộ nhớ ngoài torch (giả sử 3 GB). Bước 4: phần còn lại là KV cache, ~53 GB ≈ 400 nghìn token với 128 KiB mỗi token. ◆ Phép tính ngây thơ "(80 − 16) ÷ 128 KiB" ở bài 02 thổi phồng nó lên ~20%.
Engine in ra con số này lúc khởi động: kích thước KV cache tính bằng token, và bao nhiêu request độ dài tối đa vừa được. 10% cuối, nằm ngoài ngân sách, được để dành cho CUDA graph và những bất ngờ.
5. Một model lớn hơn: Llama 3 70B
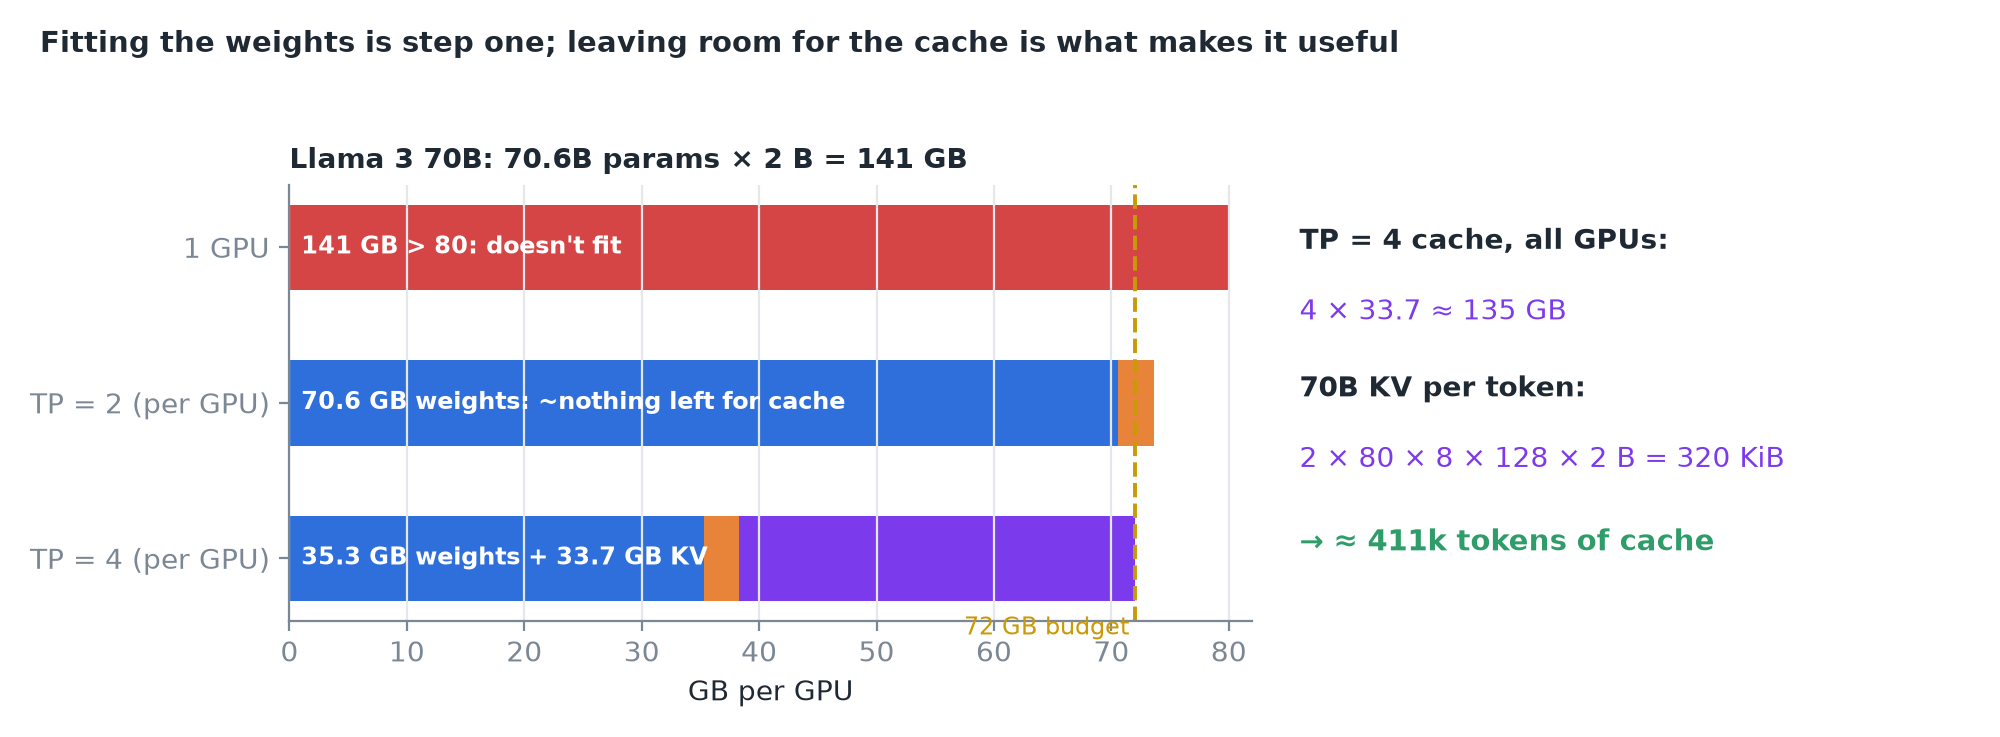 70,6 tỷ × 2 B ≈ 141 GB. Tensor parallelism chia nó ra: 2 GPU mỗi cái giữ 70,6 GB, gần như không còn gì trong ngân sách 72 GB; 4 GPU mỗi cái giữ ~35 GB và dư ~34 GB mỗi cái cho cache.
Mẹo
Nhét vừa trọng số mới chỉ là bước một. Chừa được chỗ cho cache mới làm cho việc triển khai có ích.
6. Bạn đã gặp lỗi nào?
7. Tóm tắt