46 · Tìm phần tính toán prefix bị lặp lại
Nguồn: fanout.sh / inference-eng / 10-04 · ~7 phút
Ghi chú
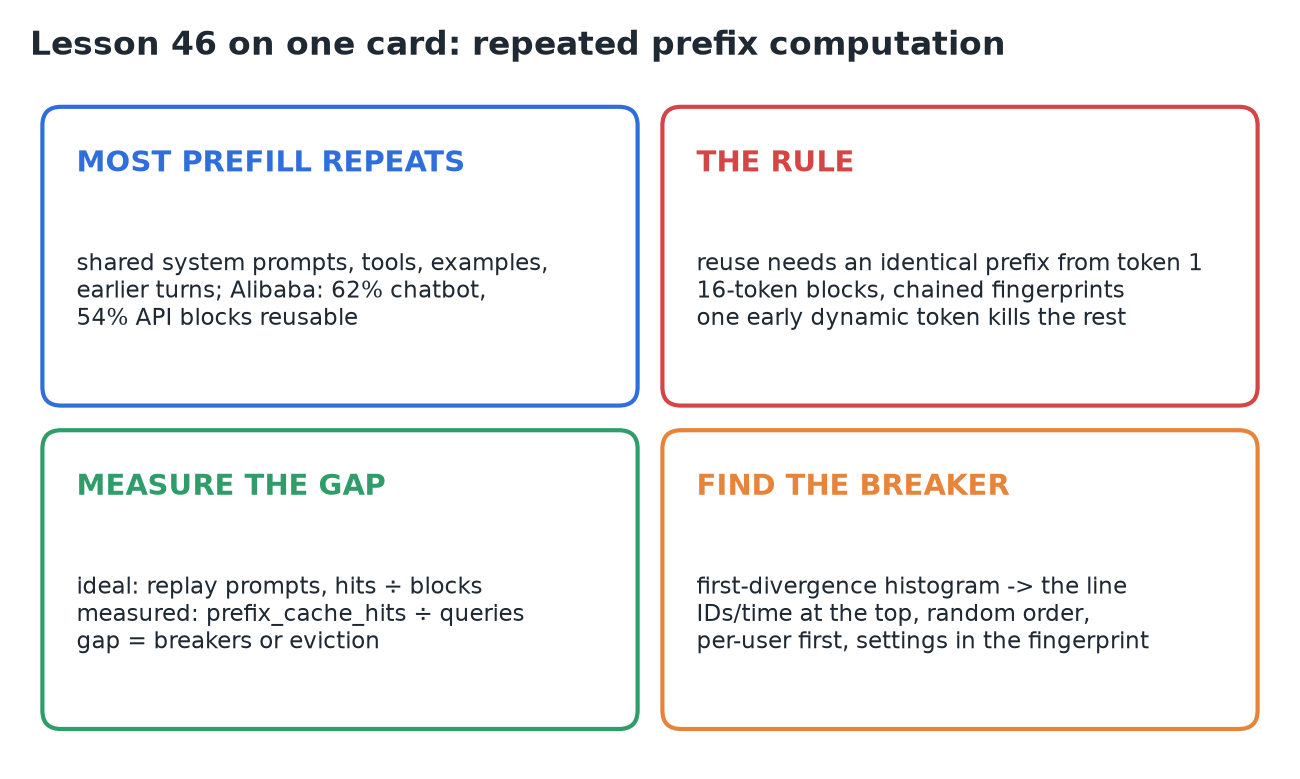
Phần lớn prefill trong lưu lượng thật là việc lặp lại: system prompt dùng chung, định nghĩa tool, ví dụ mẫu và các lượt trước (trace của Alibaba: 62% block chatbot, 54% block API dùng lại được). Nhưng K/V đã cache chỉ dùng lại được cho một prefix giống hệt tính từ token đầu tiên, được kiểm tra theo block 16 token với dấu vân tay nối chuỗi, nên 20 token động gần đầu khiến 3.000 token giống hệt phía sau không dùng lại được. Phát lại các prompt của bạn để có hit rate lý tưởng, đọc hit rate đo được từ prefix_cache_hits ÷ prefix_cache_queries của vLLM, và giải thích khoảng chênh; một histogram điểm khác biệt đầu tiên chỉ ra đúng dòng làm vỡ prefix. Trợ lý của ta: 1% → 78% chỉ nhờ di chuyển một dòng, cắt prefill 105 → 13 ms mỗi request.
1. Cùng một lượt prefill, hàng nghìn lần mỗi giờ
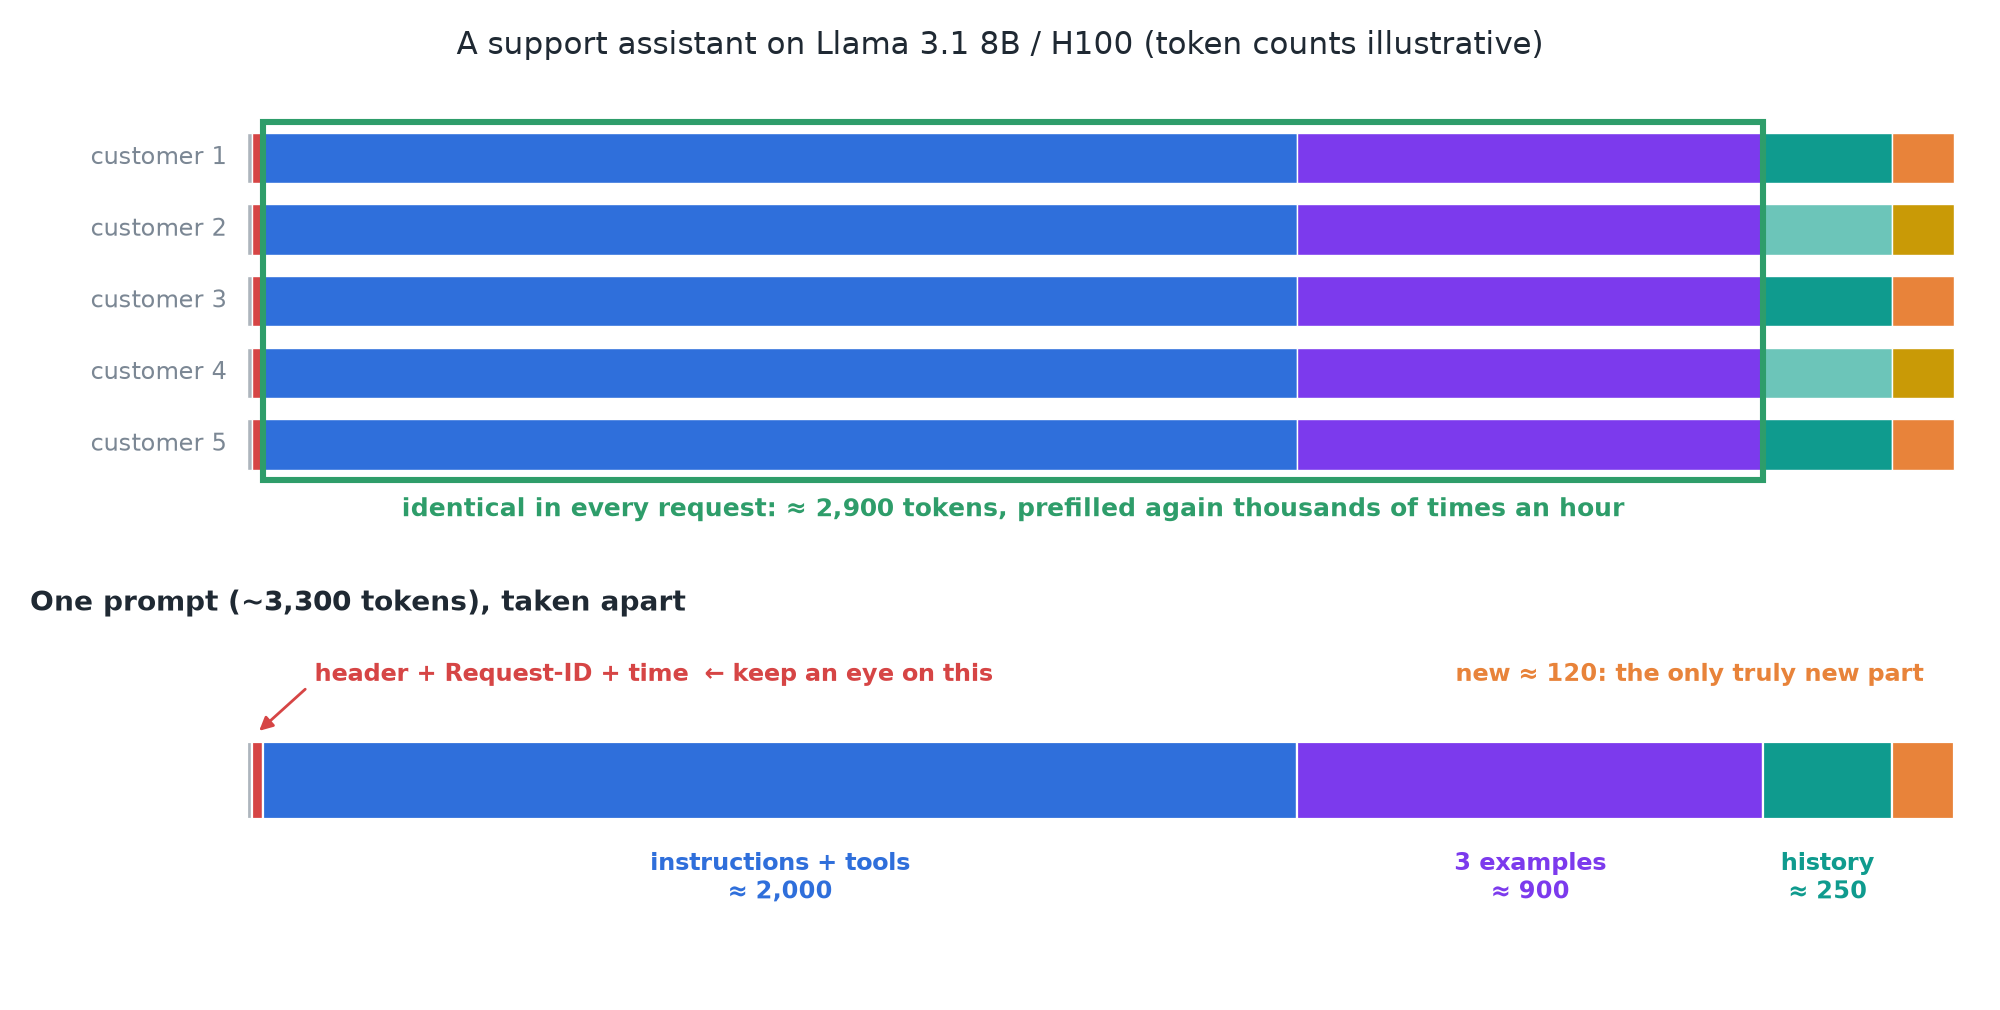 Prompt của năm khách hàng chung nhau ≈ 2.900 token; chỉ ~120 token cuối là thực sự mới.
- Một trợ lý hỗ trợ khách hàng trên H100: mỗi request gửi ~3.300 token prompt, và GPU prefill toàn bộ.
- Mổ xẻ ra: header của chat template, hướng dẫn + tool schema ≈ 2.000, ba ví dụ mẫu ≈ 900, cuộc hội thoại tới giờ ≈ 250, rồi câu hỏi mới ≈ 120.
- Mọi thứ phía trên câu hỏi mới đã từng được gửi, bởi người dùng này hoặc bởi tất cả mọi người.
- Còn một dòng nữa ngay gần đầu: request ID và thời gian hiện tại.
2. Lưu lượng thật cũng như vậy
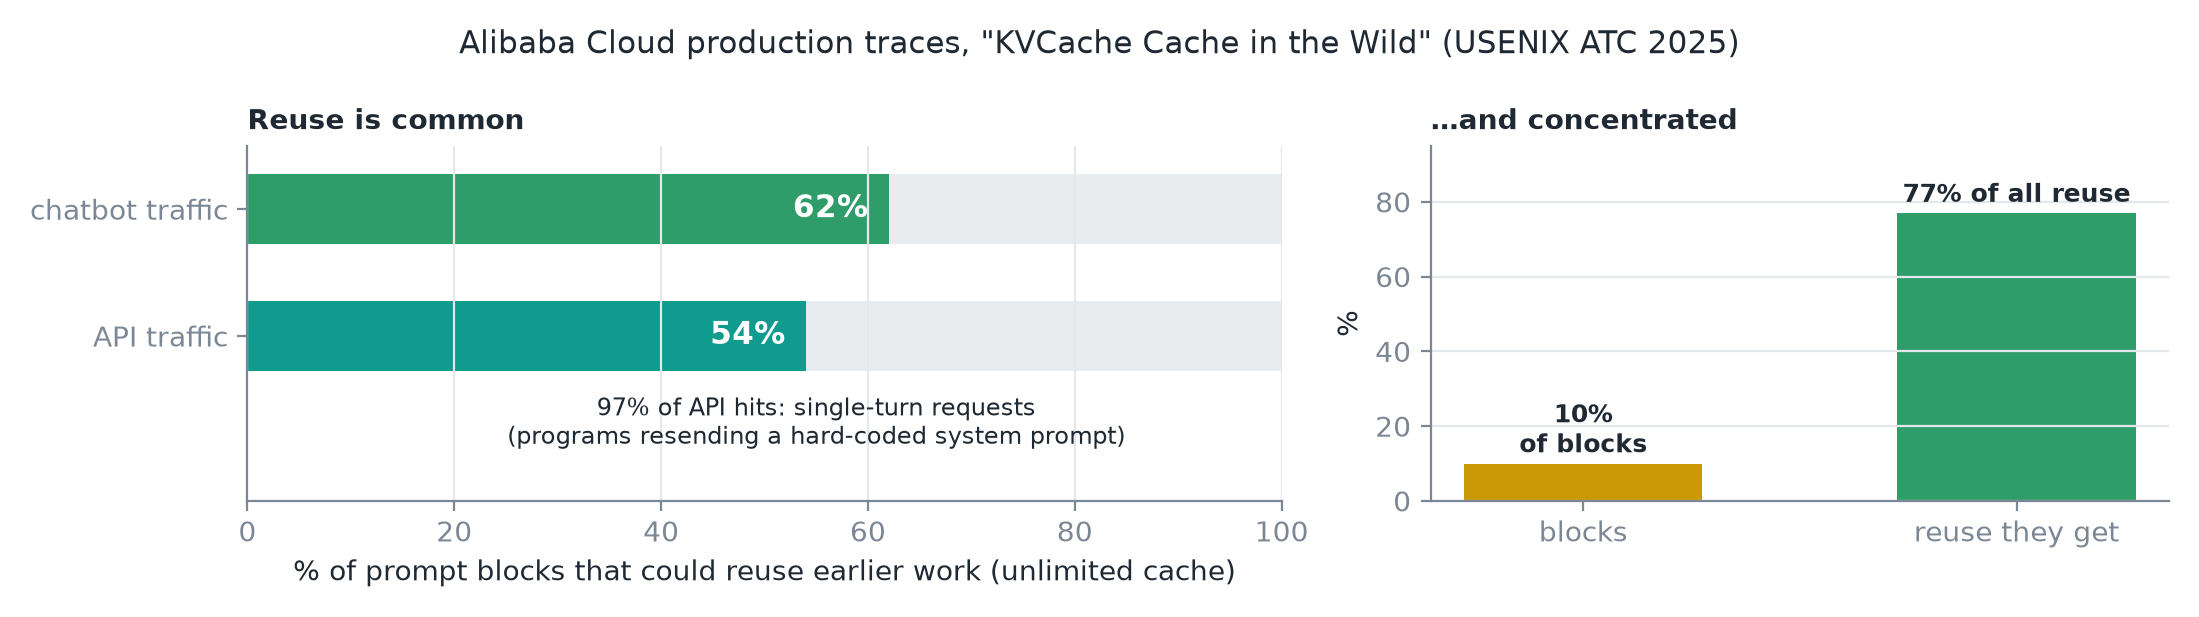 "KVCache Cache in the Wild", USENIX ATC 2025: trace production từ dịch vụ LLM của Alibaba Cloud.
- Với bộ nhớ không giới hạn, 62% block prompt trong lưu lượng chatbot có thể dùng lại việc đã làm; 54% trong lưu lượng API.
- Trong lưu lượng API, 97% số hit đến từ request một lượt: các chương trình gửi cùng một system prompt viết cứng, thường nhiều lần mỗi giây.
- Việc dùng lại tập trung: 10% block chiếm 77% tổng số lần dùng lại.
3. Quy tắc nghiêm ngặt: prefix giống hệt, từ token 1
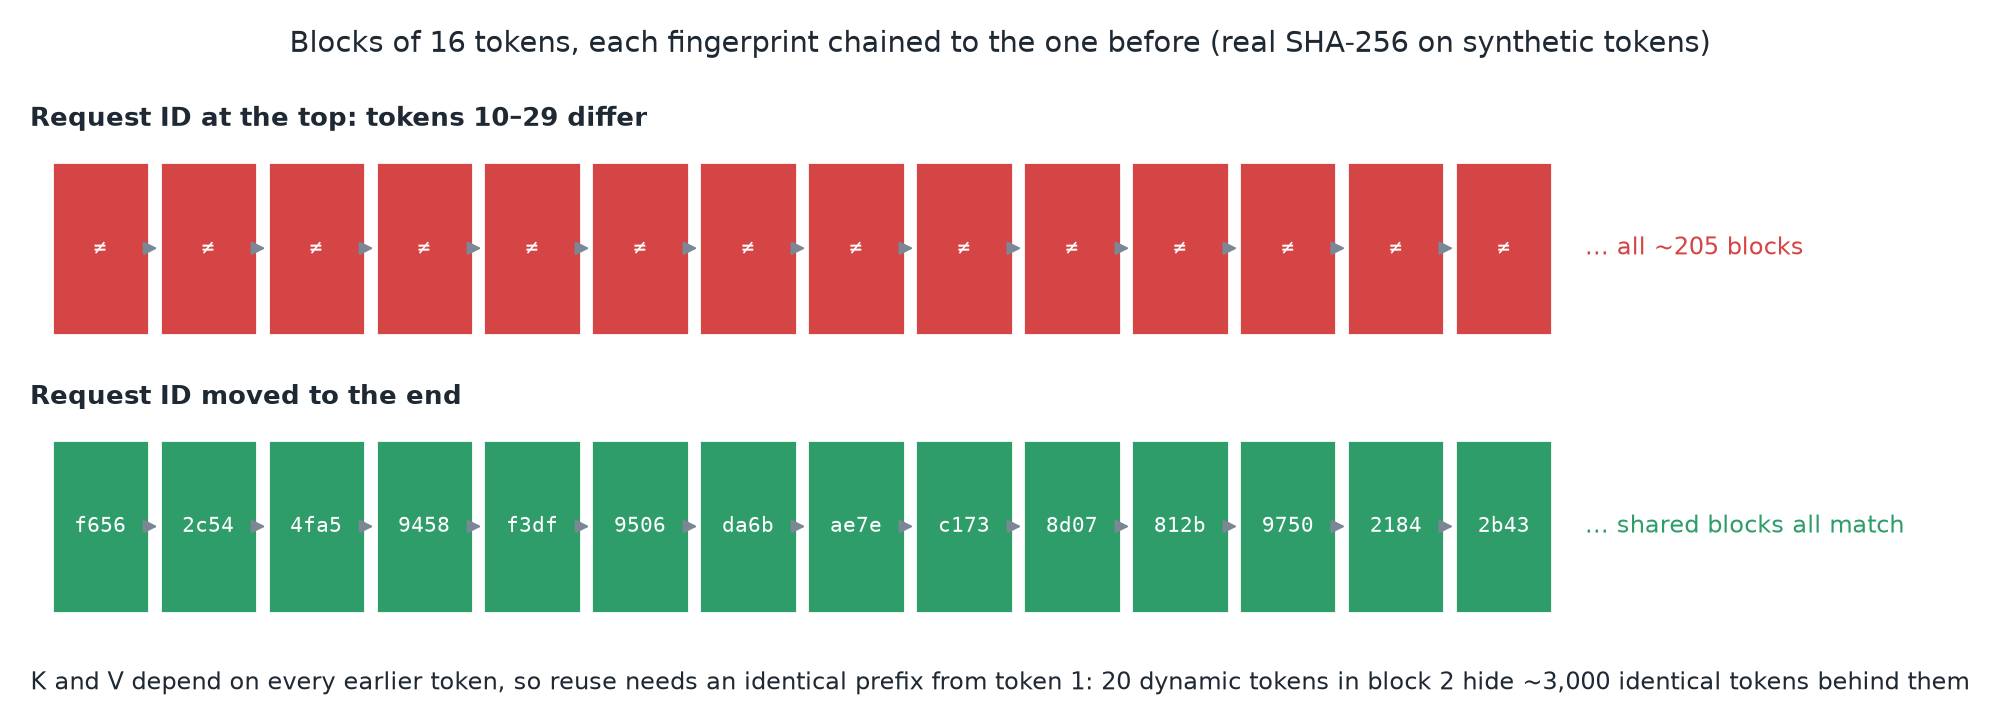 ◆ Hash nối chuỗi thật trên token tổng hợp; vLLM dùng cùng ý tưởng nối chuỗi.
- K và V của một token phụ thuộc vào mọi token trước nó, nên việc đã cache chỉ hợp lệ cho một prefix giống hệt tính từ token đầu tiên.
- vLLM kiểm tra điều này theo block 16 token, dấu vân tay của mỗi block được nối chuỗi với block trước.
- Request ID mỗi lần một khác, nên block 2 khác, làm block 3 khác, và mọi block sau đó. 20 token động đặt sai chỗ là ~3.000 token giống hệt trở nên không thể dùng lại.
4. Đo xem bạn đang bỏ phí bao nhiêu
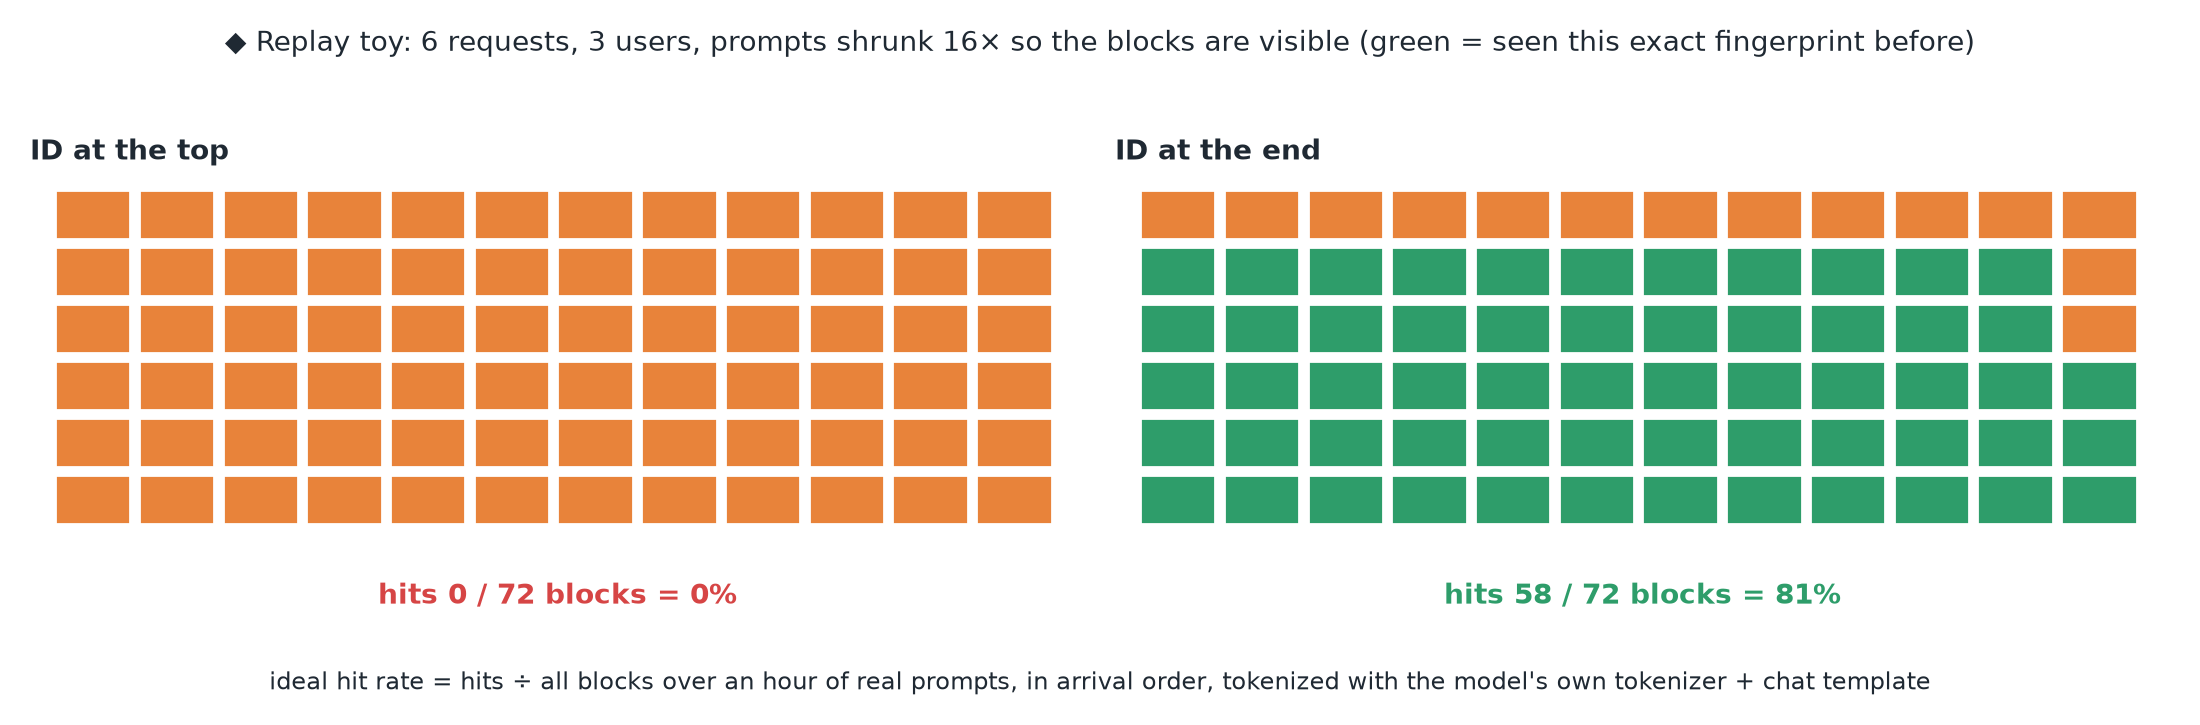 ◆ Lần phát lại đồ chơi của tôi: cùng quy trình đếm trên prompt thu nhỏ.
Bước 1, hit rate lý tưởng:
- Lấy một giờ prompt thật theo thứ tự đến, tokenize bằng chính tokenizer và chat template của model.
- Cắt mỗi prompt thành block 16 token và lấy dấu vân tay theo đúng cách server làm, có nối chuỗi.
- Với mỗi block, hỏi "mình đã thấy đúng dấu vân tay này chưa?" Hit rate lý tưởng = số hit ÷ tổng số block: thứ mà một cache không giới hạn sẽ đạt được trên lưu lượng của bạn.
- Trợ lý của ta, nếu không có request ID: khoảng 80%.
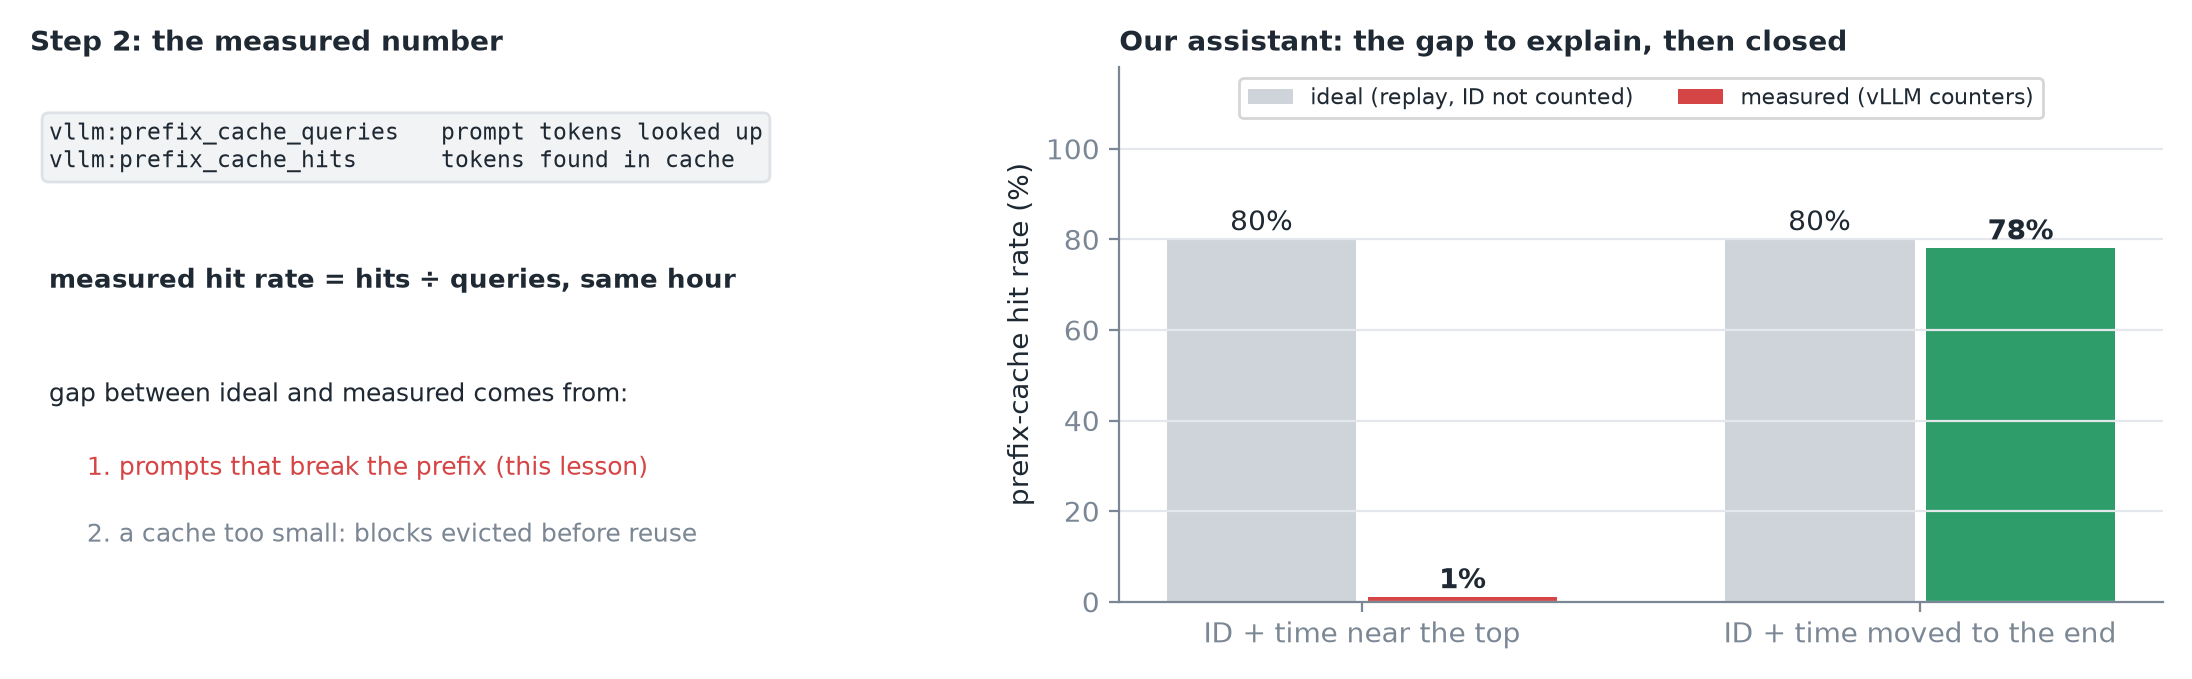 Số của bài: 80% lý tưởng so với 1% đo được trước khi sửa, 80% so với 78% sau khi sửa.
Bước 2, hit rate đo được: vLLM xuất vllm:prefix_cache_queries (số token prompt được tra) và vllm:prefix_cache_hits (số token tìm thấy). Chia hits cho queries trong cùng một giờ. Trợ lý của ta được khoảng 1%.
Khoảng chênh có hai nguồn: prompt làm vỡ prefix (bài này), hoặc cache quá nhỏ, đuổi block đi trước khi chúng được dùng lại.
Cảnh báo
◆ Con số 80% chỉ là "lý tưởng" nếu bạn phát lại khi đã bỏ request ID ra. Phát lại prompt đúng như đã gửi, lấy dấu vân tay như server, thì ID cũng làm vỡ chúng trong lần phát lại: bạn sẽ được ≈ 1%, giống như đo được. Vì vậy hãy đọc hai con số theo cách này:
- Lý tưởng thấp (trên prompt như đã gửi): prompt làm vỡ prefix. Tìm dòng gây lỗi bằng histogram bên dưới.
- Lý tưởng cao nhưng đo được thấp: do bị đuổi khỏi cache, hoặc một cấu hình mà lần phát lại không sao chép.
5. Tìm chỗ prompt bị vỡ
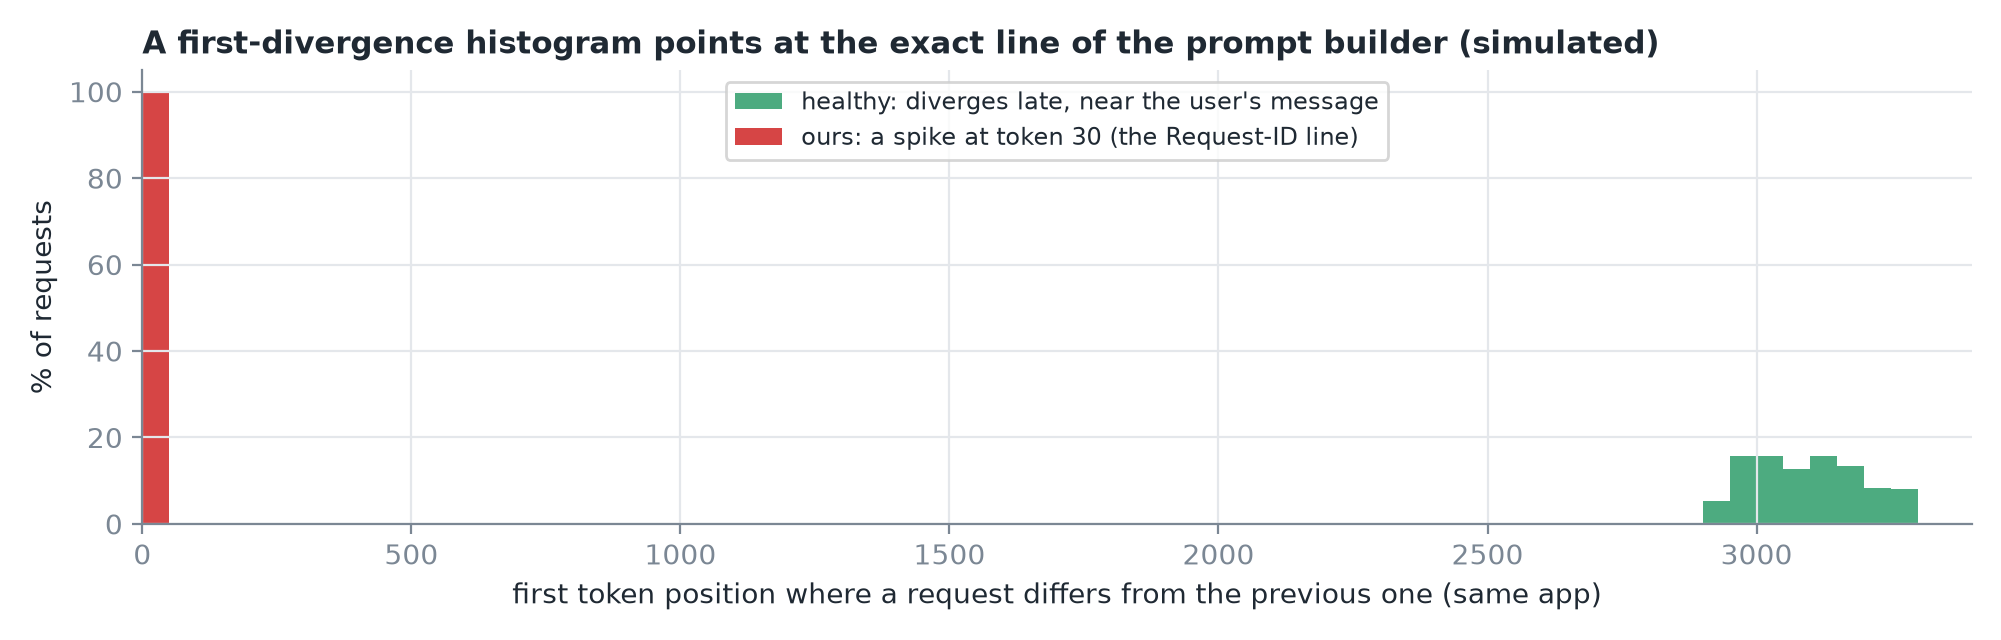 Phân phối mô phỏng; phân phối của bài cũng chỉ mang tính minh hoạ.
- So mỗi request với request trước đó từ cùng ứng dụng và ghi lại vị trí token đầu tiên mà chúng khác nhau. Vẽ histogram.
- Lưu lượng khoẻ mạnh khác nhau muộn, gần message của người dùng, sau vài nghìn token.
- Trợ lý của ta có một cột cao vút ở vị trí 30: request ID. Cột đó cho bạn biết dòng nào trong bộ dựng prompt cần xem.
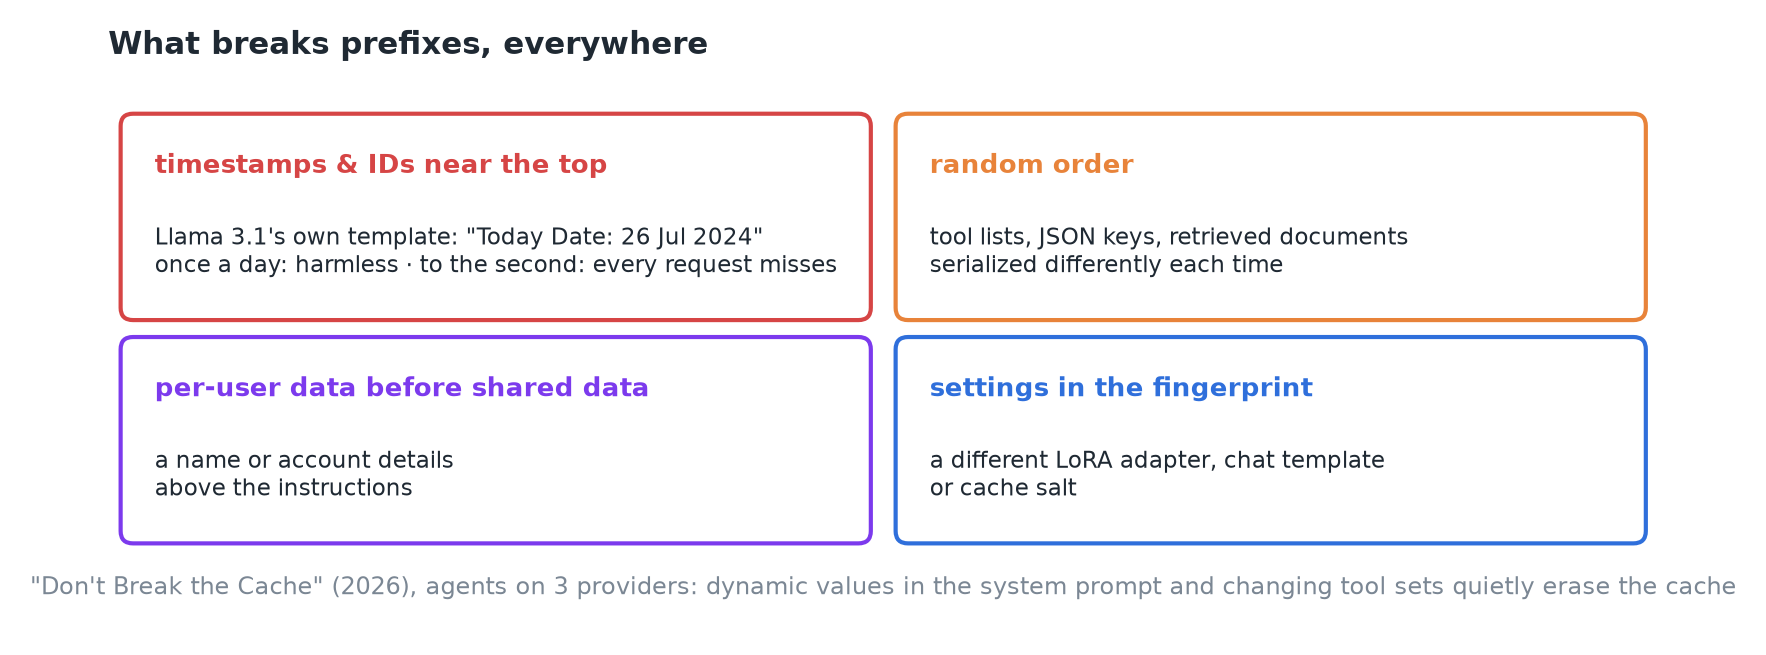 Cùng một nhúm thứ làm vỡ prefix ở mọi nơi.
- Ngay cả chat template của chính Llama 3.1 cũng đặt ngày hôm nay vào header: vô hại khi mỗi ngày một lần, thảm hoạ khi có cả giây.
- Một nghiên cứu về prompt caching trong agent ("Don't Break the Cache", 2026) cũng thấy điều tương tự: giá trị động trong system prompt và bộ tool thay đổi âm thầm xoá sạch cache.
6. Ước lượng phần thưởng
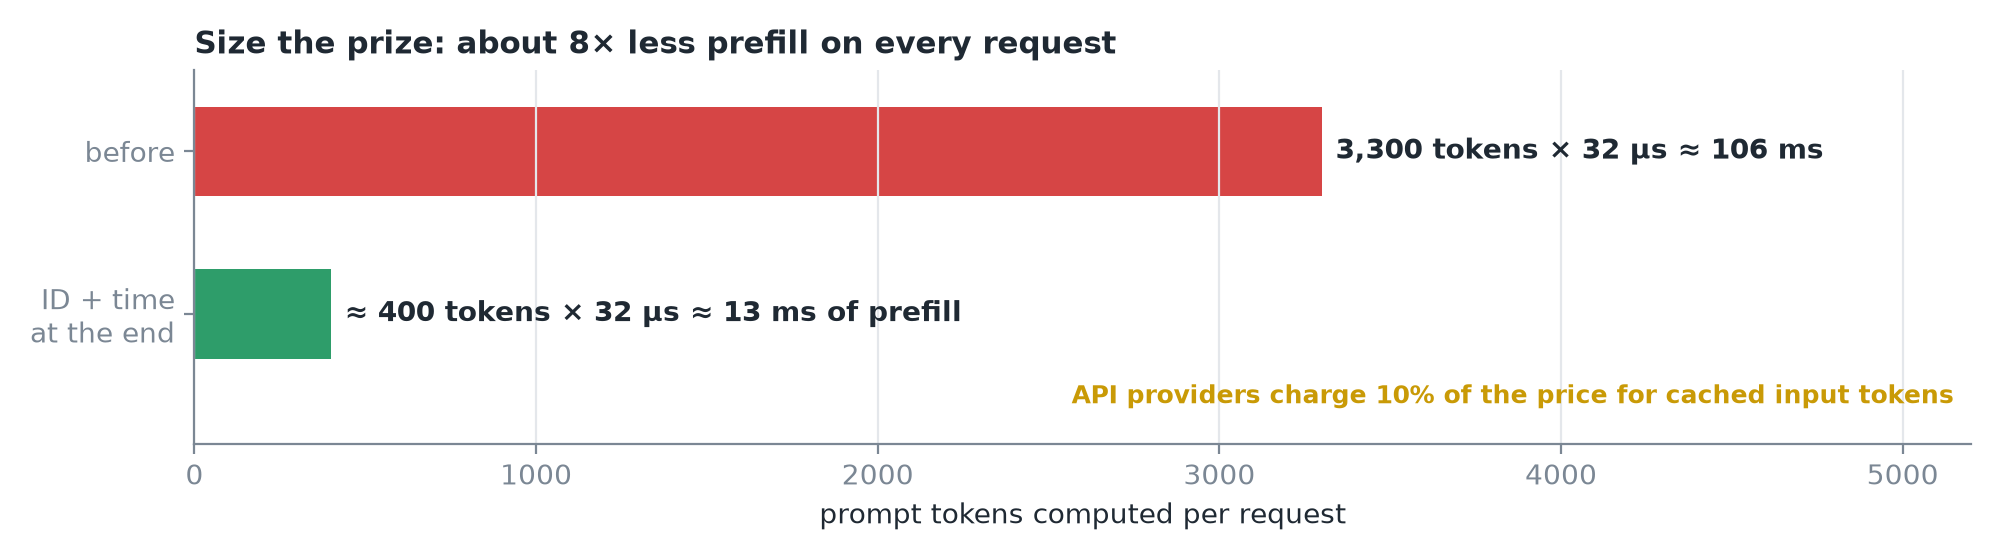 Chuyển request ID và thời gian xuống cuối prompt; lý tưởng và đo được gặp nhau (80% và 78%).
- Mỗi request giờ chỉ tính khoảng 400 token mới thay vì 3.300: ≈ 105 → 13 ms prefill, cho mọi request.
- Các nhà cung cấp API tính một phần mười giá cho token đầu vào đã cache. Đó là mức độ thật của khoản tiết kiệm.
Mẹo
◆ 32 µs mỗi token prompt gấp khoảng 2 lần 16 µs mà 16 GFLOP cần ở mức đỉnh H100, nghĩa là trên thực tế đạt khoảng 50% FLOPs đỉnh.
7. Tóm tắt