59 · Profile prefill so với decode
Nguồn: fanout.sh / inference-eng / 12-05 · ~9 phút
Ghi chú
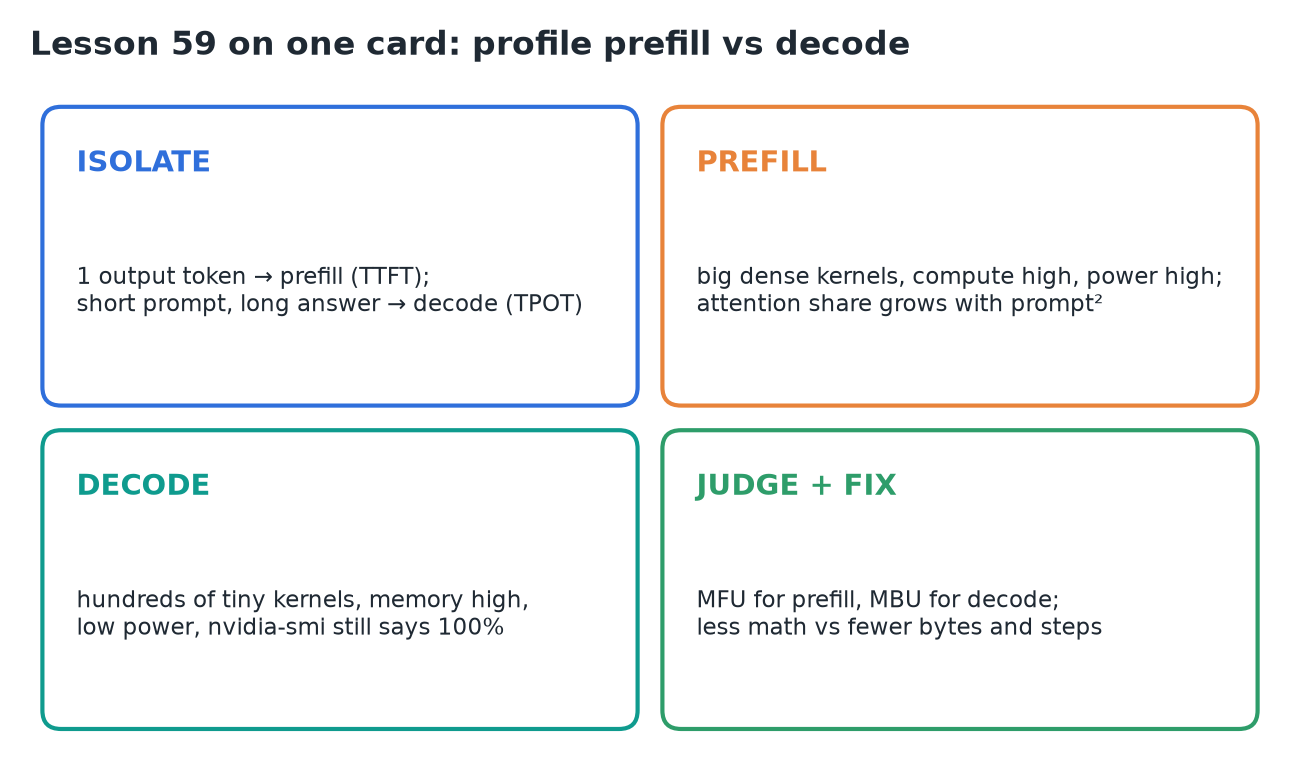
Prefill và decode chạy cùng một bộ trọng số nhưng là hai chương trình khác nhau trên GPU. Prefill đẩy hàng nghìn token qua các phép nhân ma trận lớn và bị giới hạn bởi tính toán; decode đẩy một token mỗi request qua hàng trăm kernel tí hon và bị giới hạn bởi bộ nhớ. Vì vậy hãy profile chúng riêng biệt, dự đoán từng cái bằng phép tính nhanh trước, đánh giá prefill bằng MFU và decode bằng MBU, và chọn cách sửa phù hợp: ít phép tính hơn cho prefill, ít byte hơn và ít bước hơn cho decode.
1. Lấy hai profile sạch
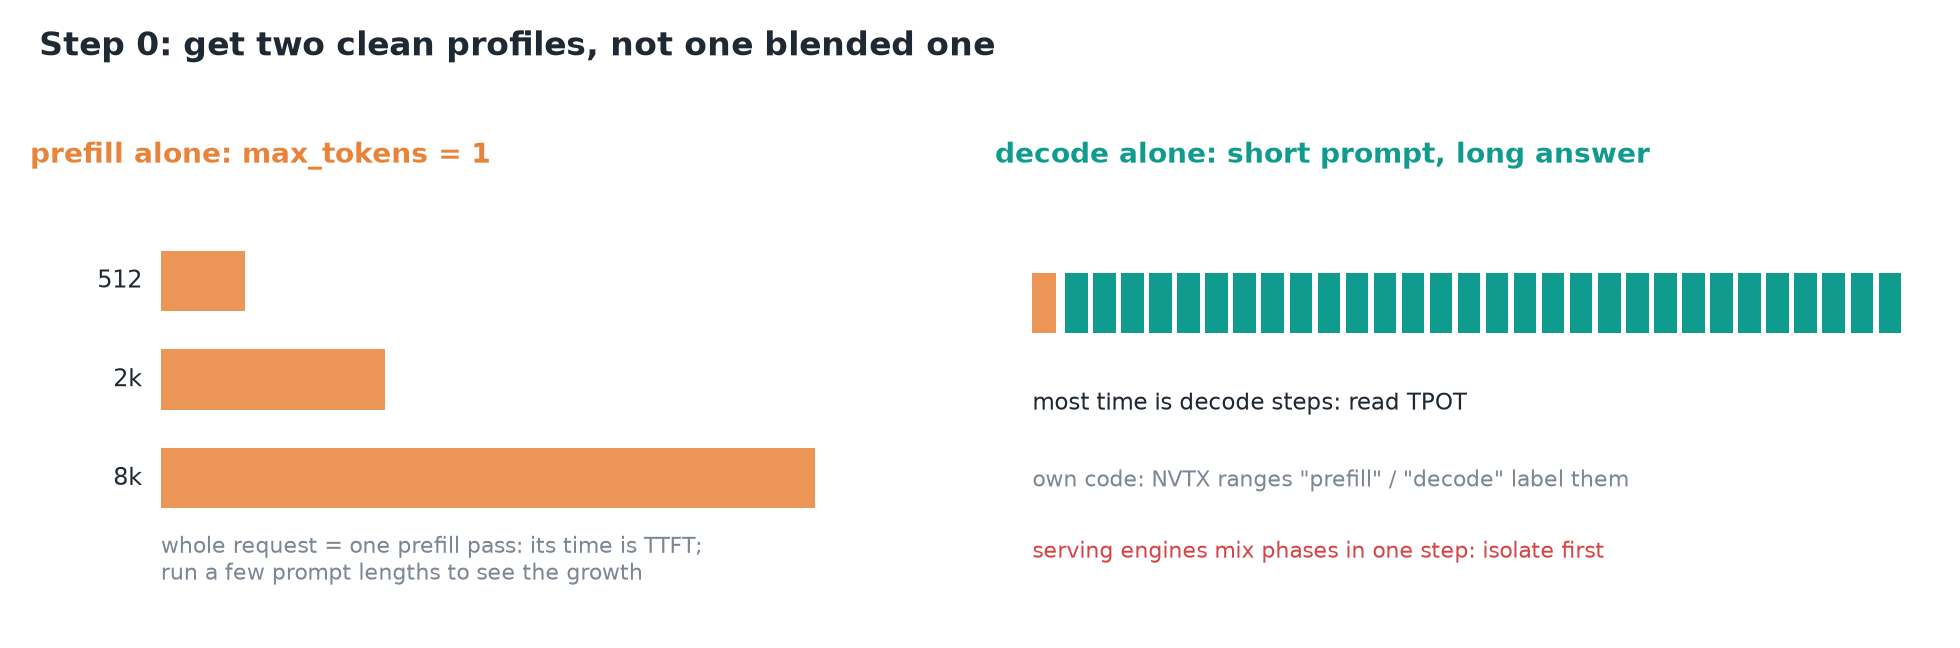 Mỗi pha một profile, đừng bao giờ trộn lẫn.
- Riêng prefill: gửi một prompt với
max_tokens = 1. Cả request là một lượt prefill, nên thời gian của nó là TTFT. Lặp lại ở vài độ dài prompt để thấy nó tăng thế nào. - Riêng decode: prompt ngắn và câu trả lời dài, để gần như toàn bộ thời gian là các bước decode; đọc TPOT.
- Trong code của bạn, bọc mỗi pha trong range NVTX ("prefill", "decode") để chúng hiện thành các dải có nhãn trên timeline của Nsight Systems.
- Serving engine trộn cả hai pha trong một bước (chunked prefill, continuous batching), nên trace production là một hỗn hợp. Tách riêng trước, rồi mới nhìn vào hỗn hợp.
2. Phép tính nhanh trước
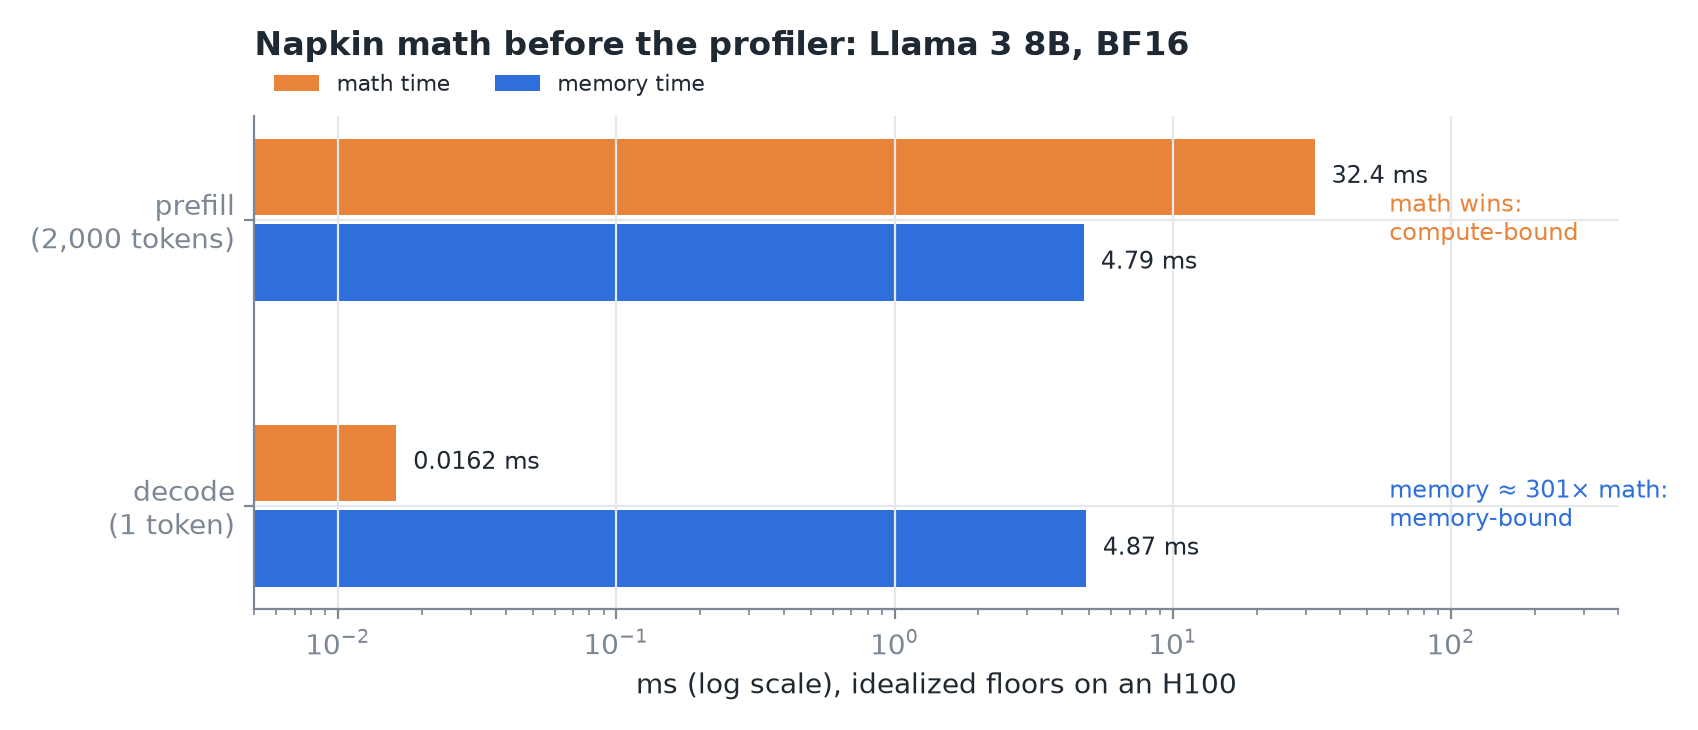 Llama 3 8B ở BF16 trên H100 (989 TFLOPS, 3,35 TB/s).
- Prefill đọc trọng số một lần và làm phép tính cho mọi token prompt: phép tính ≈ 32 ms so với < 5 ms đọc. Compute-bound.
- Decode đọc mọi trọng số cộng cache để sinh một token: ≈ 4,9 ms đọc so với 0,016 ms phép tính, ≈ 300 lần. Memory-bound tới hàng trăm lần.
- Bài làm tròn đỉnh thành khoảng 1.000 TFLOPS (≈ 33 ms) và decode thành ≈ 5 ms. Cả hai đều khớp.
- ◆ 0,26 GB KV là cache 2.000 token với 128 KB mỗi token (32 layer × 8 KV head × 128 chiều × 2 cho K và V × 2 byte).
3. Profile của prefill
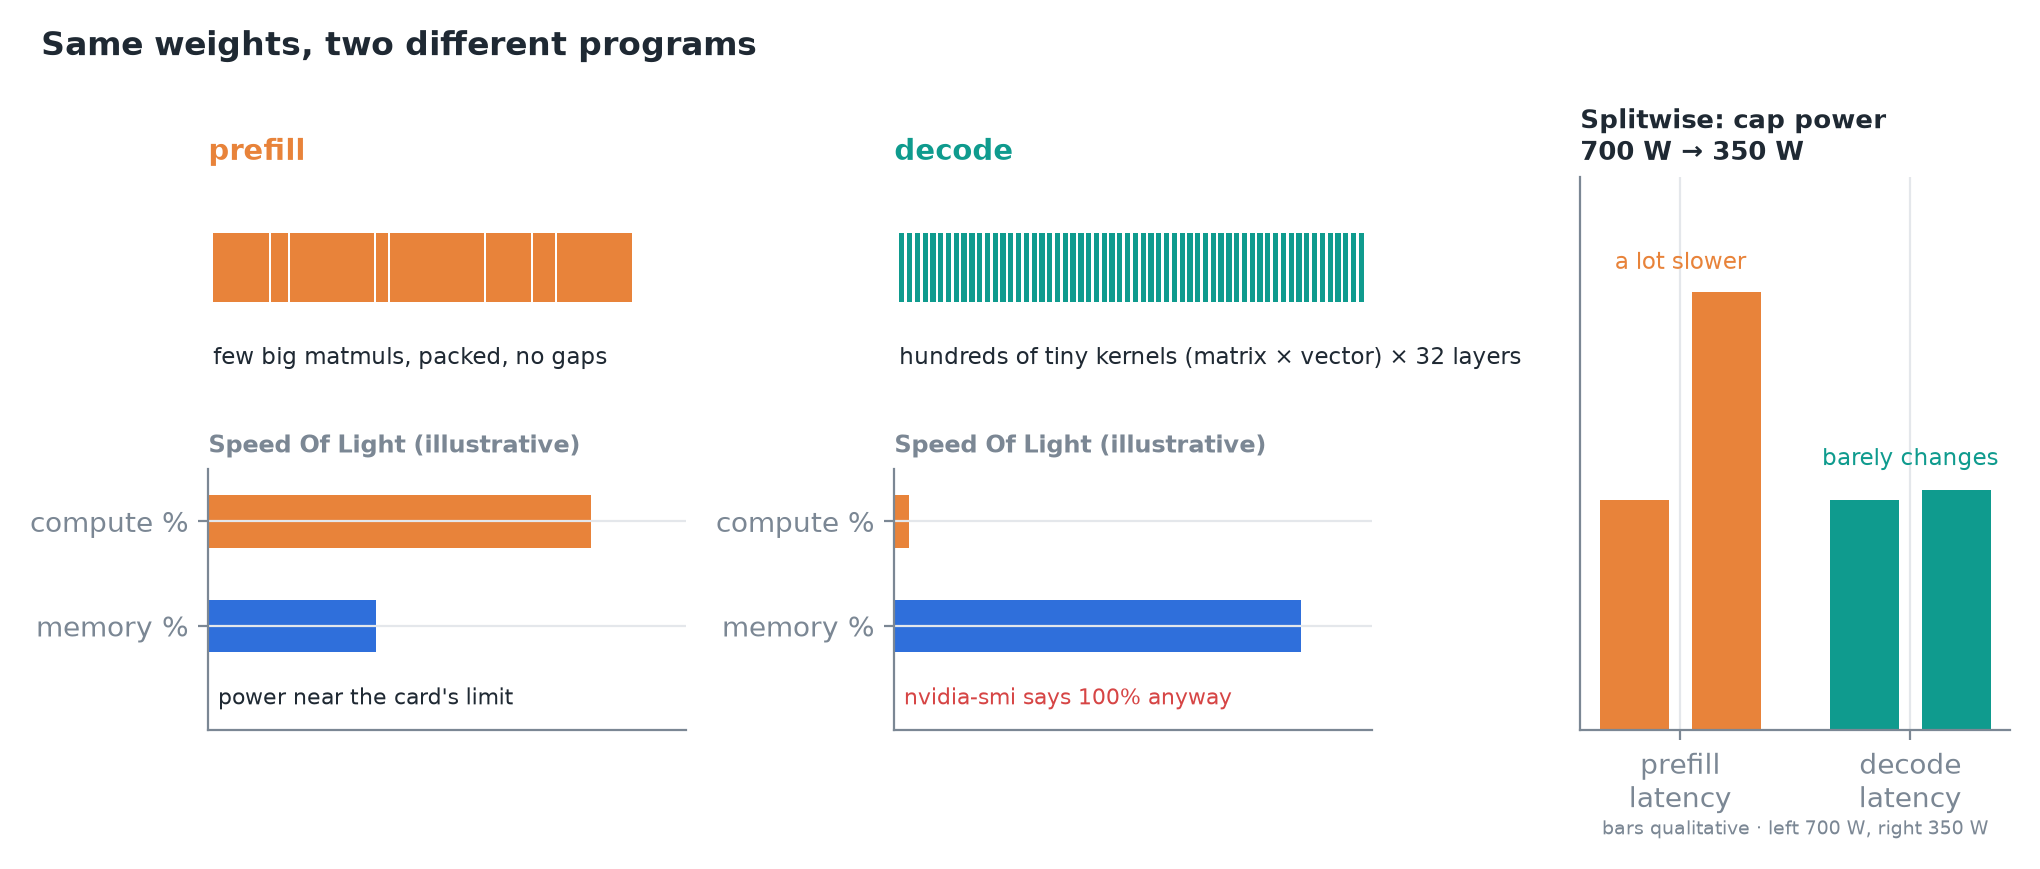 Cùng model, hai trace. Các thanh Speed Of Light mang tính minh hoạ.
- Timeline: vài kernel matmul lớn, dày đặc, nối liền nhau, không có khoảng trống.
- Speed Of Light của Nsight Compute: compute % cao, memory % thấp hơn.
- Công suất nằm gần giới hạn của card: tensor core đang thực sự làm việc.
- Splitwise (giới hạn công suất từ 700 W xuống 350 W): latency prefill chậm đi nhiều, decode gần như không đổi. Ngốn điện nghĩa là compute-bound.
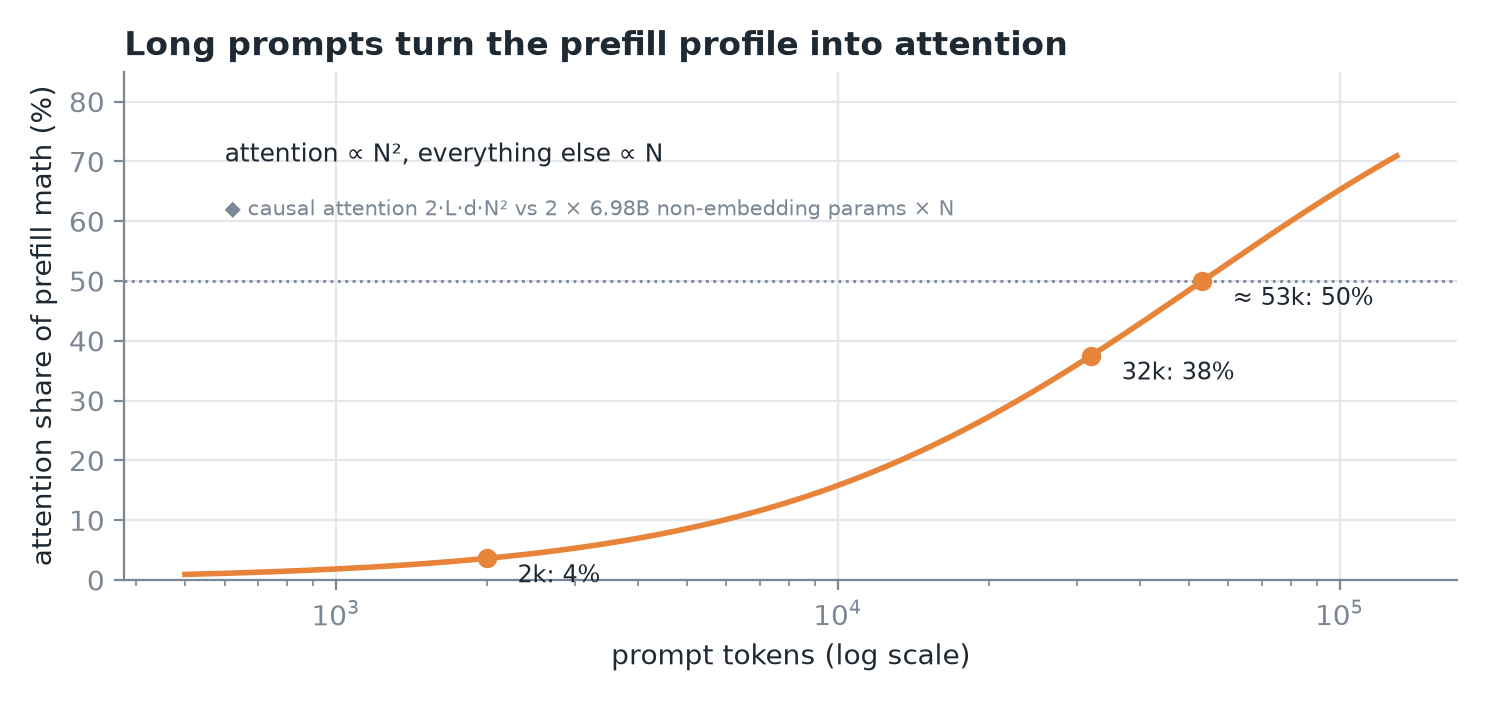 Tính cho Llama 3 8B.
- Phép tính attention tăng theo N², mọi thứ khác tăng theo N. Vì vậy profile dịch chuyển theo độ dài prompt:
- 2k token: attention ≈ 4% phép tính prefill; profile là các matmul.
- 32k token: ≈ 38%.
- ≈ 53k token: 50%; attention chiếm nửa hoá đơn.
- ◆ Đã kiểm tra: causal attention tốn 2·L·d·N² FLOP (QKᵀ và AV, nửa ma trận), phần còn lại 2 × 6,98 tỷ tham số không phải embedding × N. Kết quả là 3,6%, 37,5% và điểm cắt ở ≈ 53.250 token.
4. Profile của decode
- Timeline: hàng trăm kernel tí hon mỗi bước (norm, QKV, RoPE, attention, output projection, norm, MLP, lặp lại cho 32 layer). Mỗi cái là một ma trận nhân một vector.
- Speed Of Light: memory % cao, compute % rất nhỏ.
- nvidia-smi báo utilization 100%. Nó chỉ có nghĩa là có kernel nào đó đang chạy, không phải tensor core đang bận.
- Không có CUDA graph thì có khoảng trống giữa các kernel nhỏ đó (overhead launch của CPU). Engine capture graph thì hiện thành một lần launch graph mỗi bước.
Cảnh báo
"GPU utilization 100%" với một workload decode không nói lên gì. Hãy đọc memory % và MBU thay vào đó.
5. Wall time đi đâu
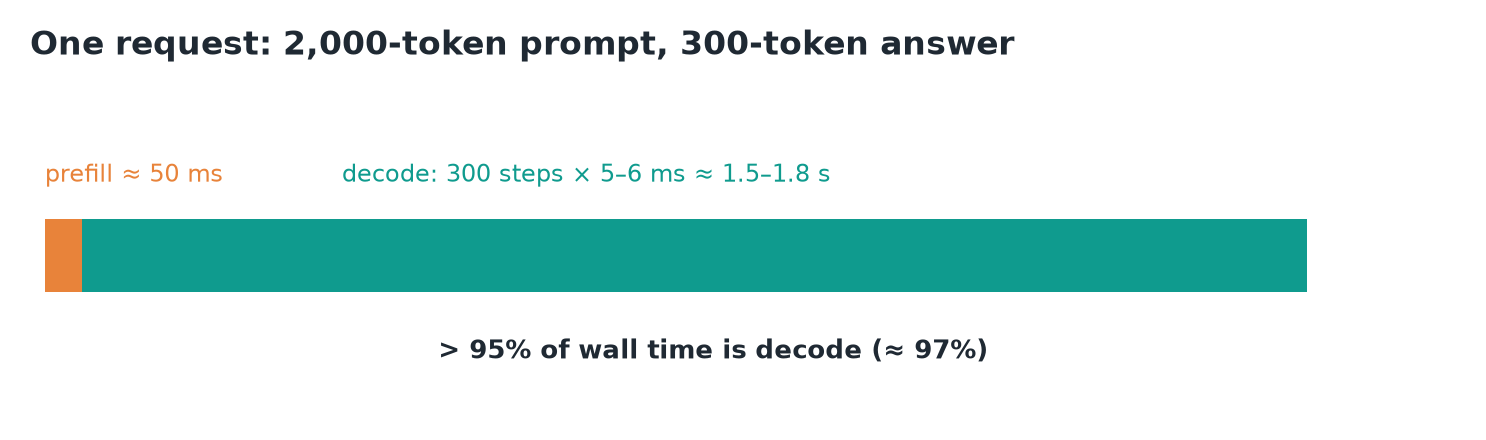 Prompt 2.000 token, câu trả lời 300 token.
- Prefill ≈ 50 ms; decode 300 bước × 5–6 ms ≈ 1,6 s. Decode chiếm > 95% request (≈ 97%).
- Splitwise báo điều tương tự ở quy mô fleet: phần lớn thời gian end-to-end là sinh token.
- Prefill vẫn quan trọng: nó quyết định TTFT, và trong một bước trộn, nó làm chậm các decode dùng chung bước đó.
6. Thêm tải
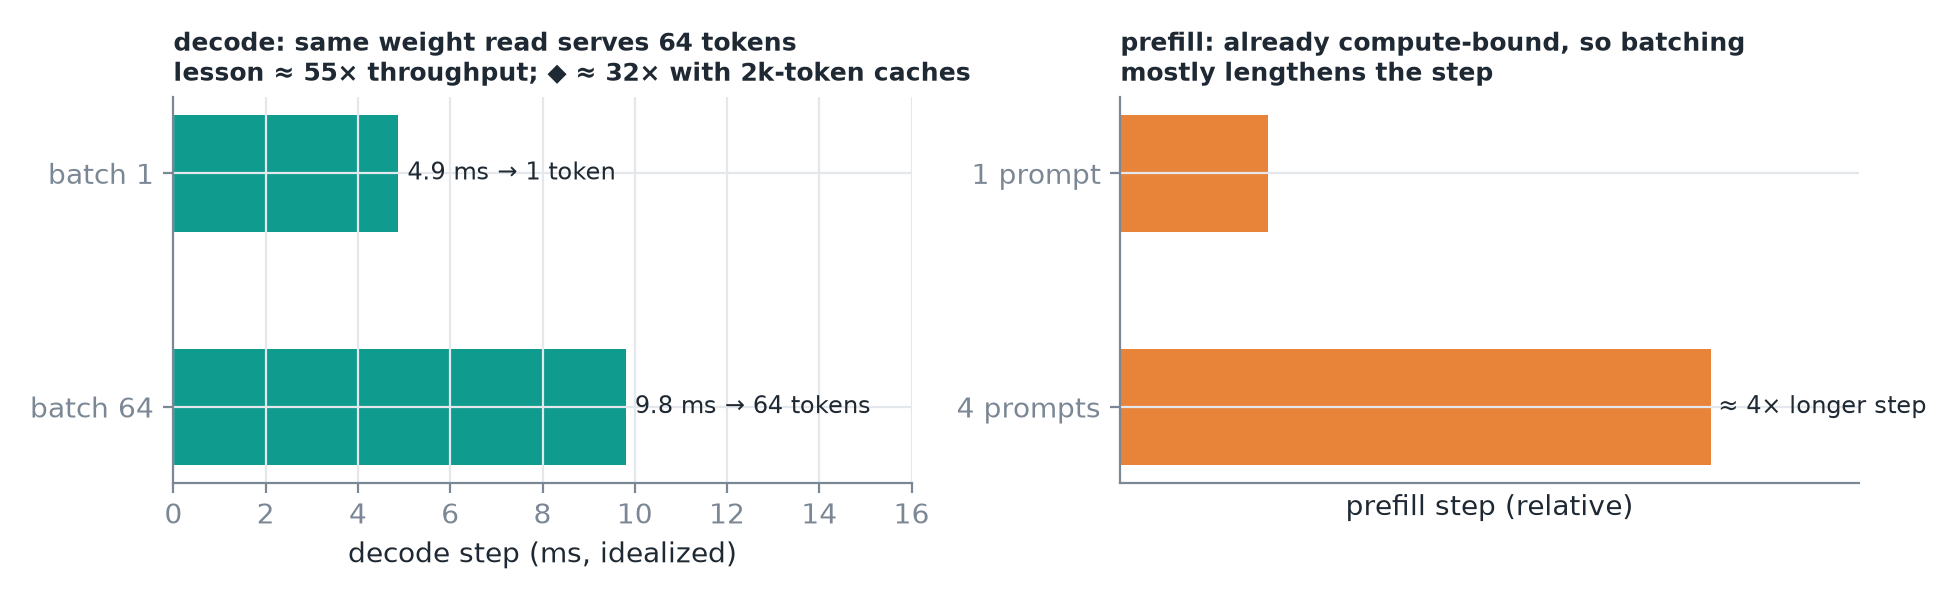 Batching giúp pha nào đang phải chờ bộ nhớ.
- Decode, batch 1 → 64: bước chỉ dài thêm một chút, vì lần đọc trọng số được 64 token chia nhau. Throughput tăng ≈ 55 lần trong ví dụ của bài.
- ◆ Lợi ích giữ được tới đâu phụ thuộc vào độ dài context: với cache 2.000 token mỗi request, 64 cache thêm 16,8 GB, bước tăng từ ≈ 4,9 lên ≈ 9,8 ms và lợi ích là ≈ 32 lần. Context ngắn thì gần 64 lần hơn.
- Prefill, 1 → 4 prompt: vốn đã compute-bound, nên bước dài ra ≈ 4 lần. Throughput gần như không tăng.
7. Đánh giá và sửa theo từng pha
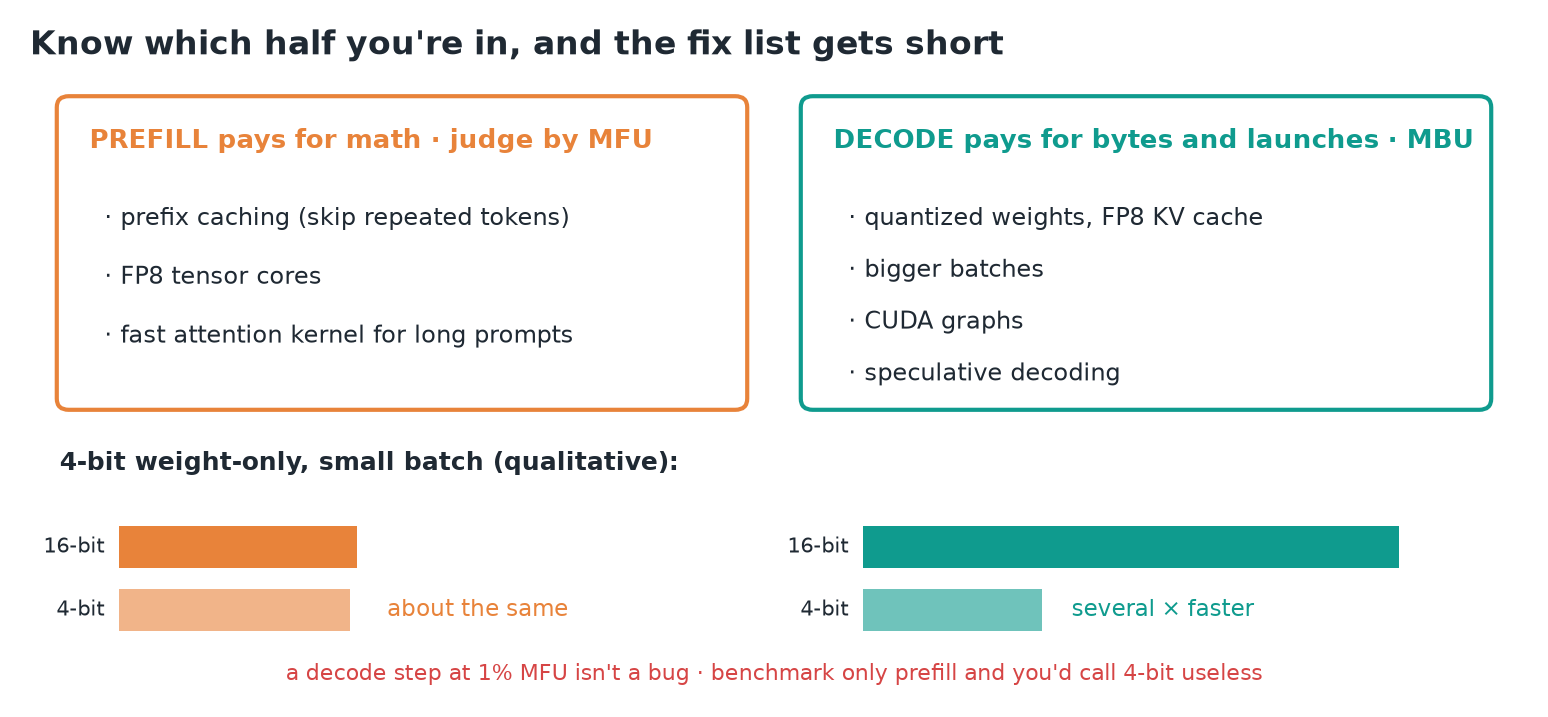 Các thanh 4-bit mang tính định tính.
- Thước đo: MFU cho prefill, MBU cho decode. Một bước decode ở 1% MFU là bình thường, không phải lỗi.
- Prefill trả giá cho phép tính:
- prefix caching (bỏ qua token đã tính);
- tensor core FP8;
- kernel attention nhanh cho prompt dài.
- Decode trả giá cho byte và các lần launch:
- trọng số lượng tử hoá, KV cache FP8;
- batch lớn hơn;
- CUDA graph;
- speculative decoding (nhiều token hơn mỗi lần đọc trọng số).
- Ví dụ 4-bit chỉ trọng số: prefill gần như không đổi (nó không phải chờ byte); decode nhanh lên vài lần. Chỉ benchmark prefill thì bạn sẽ gọi 4-bit là vô dụng.
Quan trọng
Trước hết hỏi pha nào chiếm thời gian, rồi hỏi pha đó bị giới hạn bởi tài nguyên nào. Danh sách cách sửa suy ra từ hai câu trả lời đó.
8. Tóm tắt