11 · Q, K, V và causal attention trong inference
Nguồn: fanout.sh / inference-eng / 02-02 · ~7 phút
Ghi chú
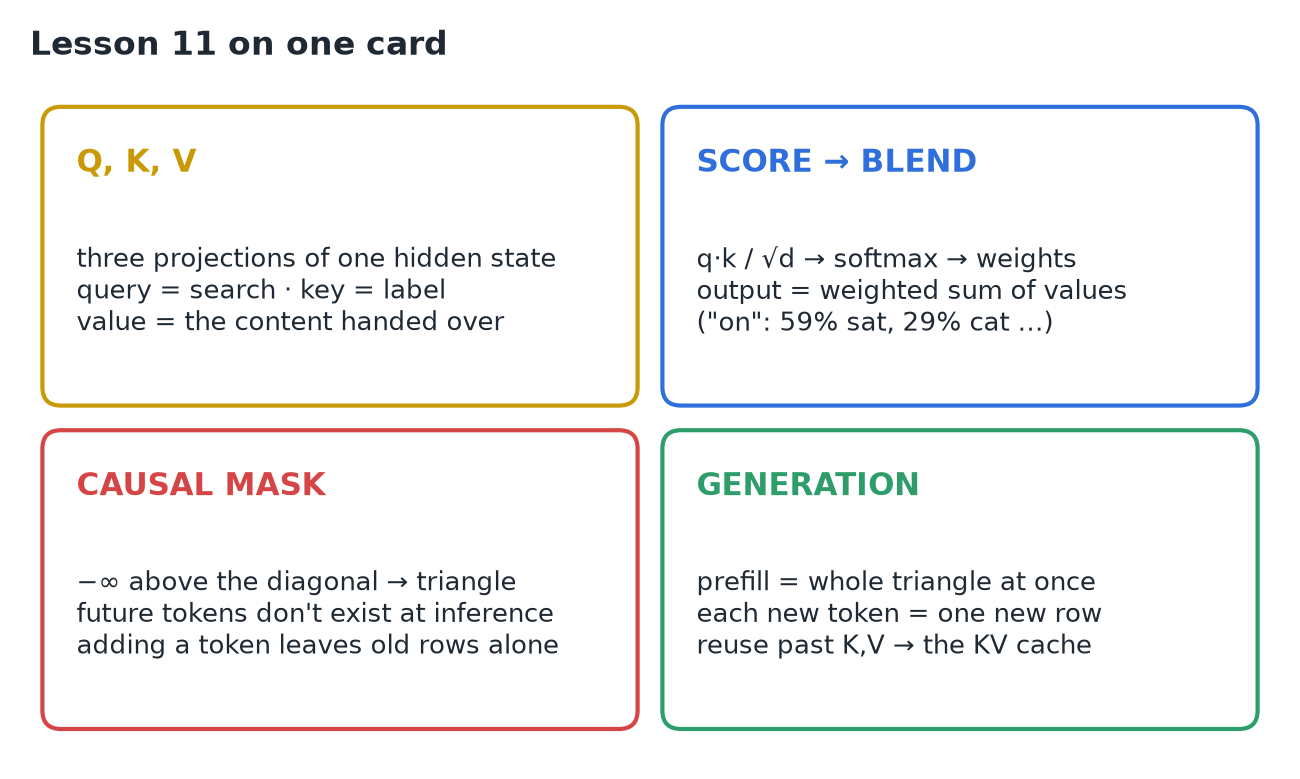
Attention cho mỗi token kéo thông tin từ các token trước nó. Hidden state của mỗi token được chiếu theo ba cách: một query (tôi đang tìm gì), một key (tôi đưa ra gì để so khớp) và một value (tôi trao lại gì). Điểm là q·k, được chia tỷ lệ rồi softmax thành trọng số, và đầu ra là tổ hợp có trọng số của các value. Một causal mask chặn tương lai, nên lưới điểm là một tam giác. Trong quá trình sinh, mỗi token mới thêm một hàng mới. Query của nó chỉ dùng một lần, nhưng mọi key và value trong quá khứ đều được đọc lại bởi mọi token sau đó. Đó là lý do KV cache tồn tại, và vì sao decode bị giới hạn bởi bộ nhớ.
1. Vì sao token cần nhìn lại phía sau
Trong câu "the animal didn't cross the street because it was too tired", từ "it" tự nó không có nghĩa. Để hiểu được, nó phải nhìn lại và tìm ra "animal". Attention là cơ chế cho mỗi vị trí gom những gì nó cần từ các vị trí trước.
2. Query, key, value
Hidden state của mỗi token (4.096 số) được nhân với ba ma trận học được, W_Q, W_K và W_V, cho ra ba vector mới.
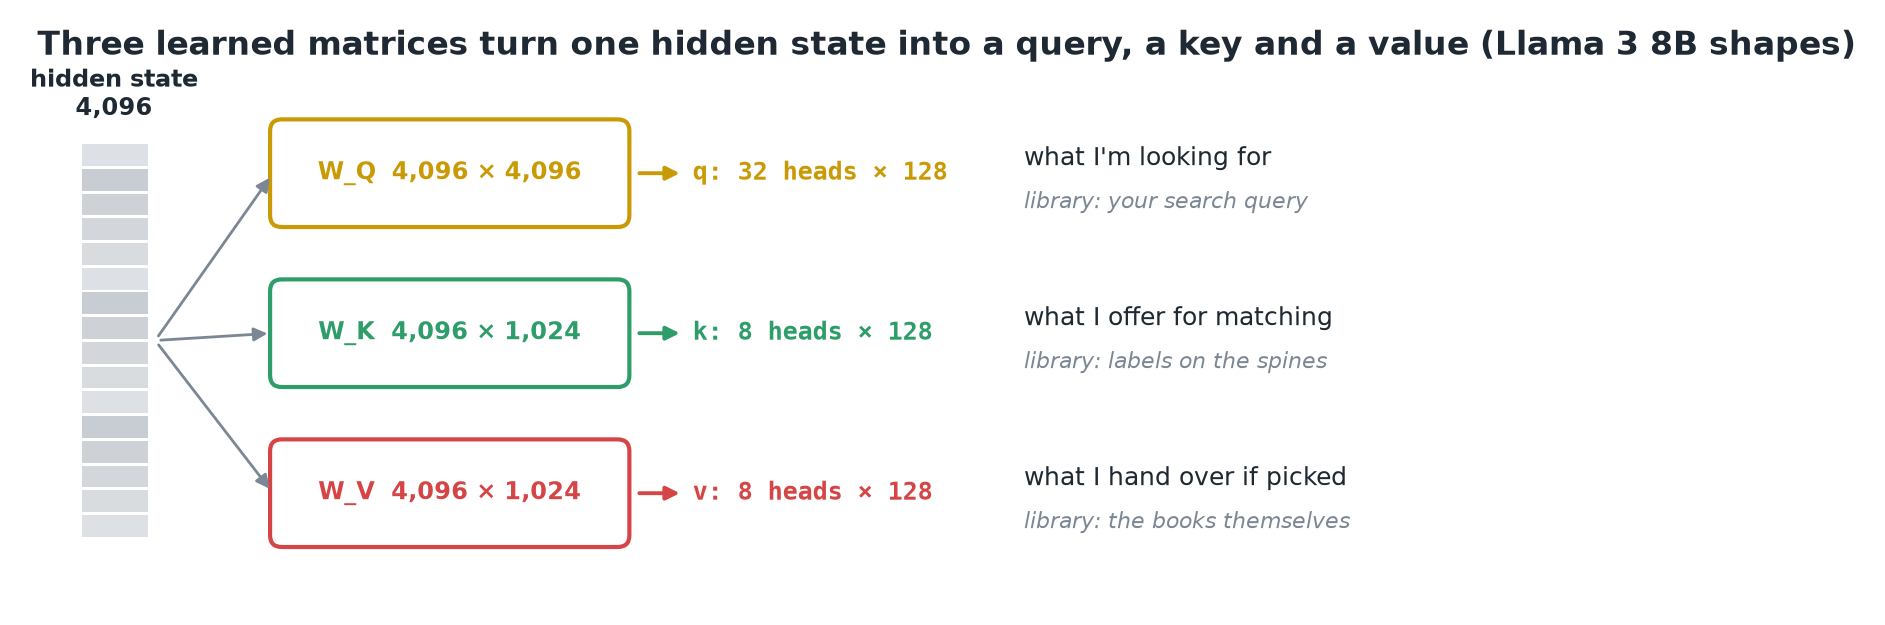 Ví von thư viện: query là thứ bạn tìm, key là nhãn trên gáy sách, value là cuốn sách bạn mang về. ◆ W_K và W_V là 4.096 × 1.024 vì Llama 3 8B chỉ giữ 8 KV head × 128.
Mẹo
Key quyết định ai được chú ý; value quyết định cái gì được chuyển đi. Chúng tách riêng để một token có thể dễ được tìm thấy vì một lý do mà lại đóng góp một thứ khác.
3. Tính attention bằng tay
Các token the, cat, sat, on, với vector 2 chiều. Token hiện tại là "on", query q = (1, 2).
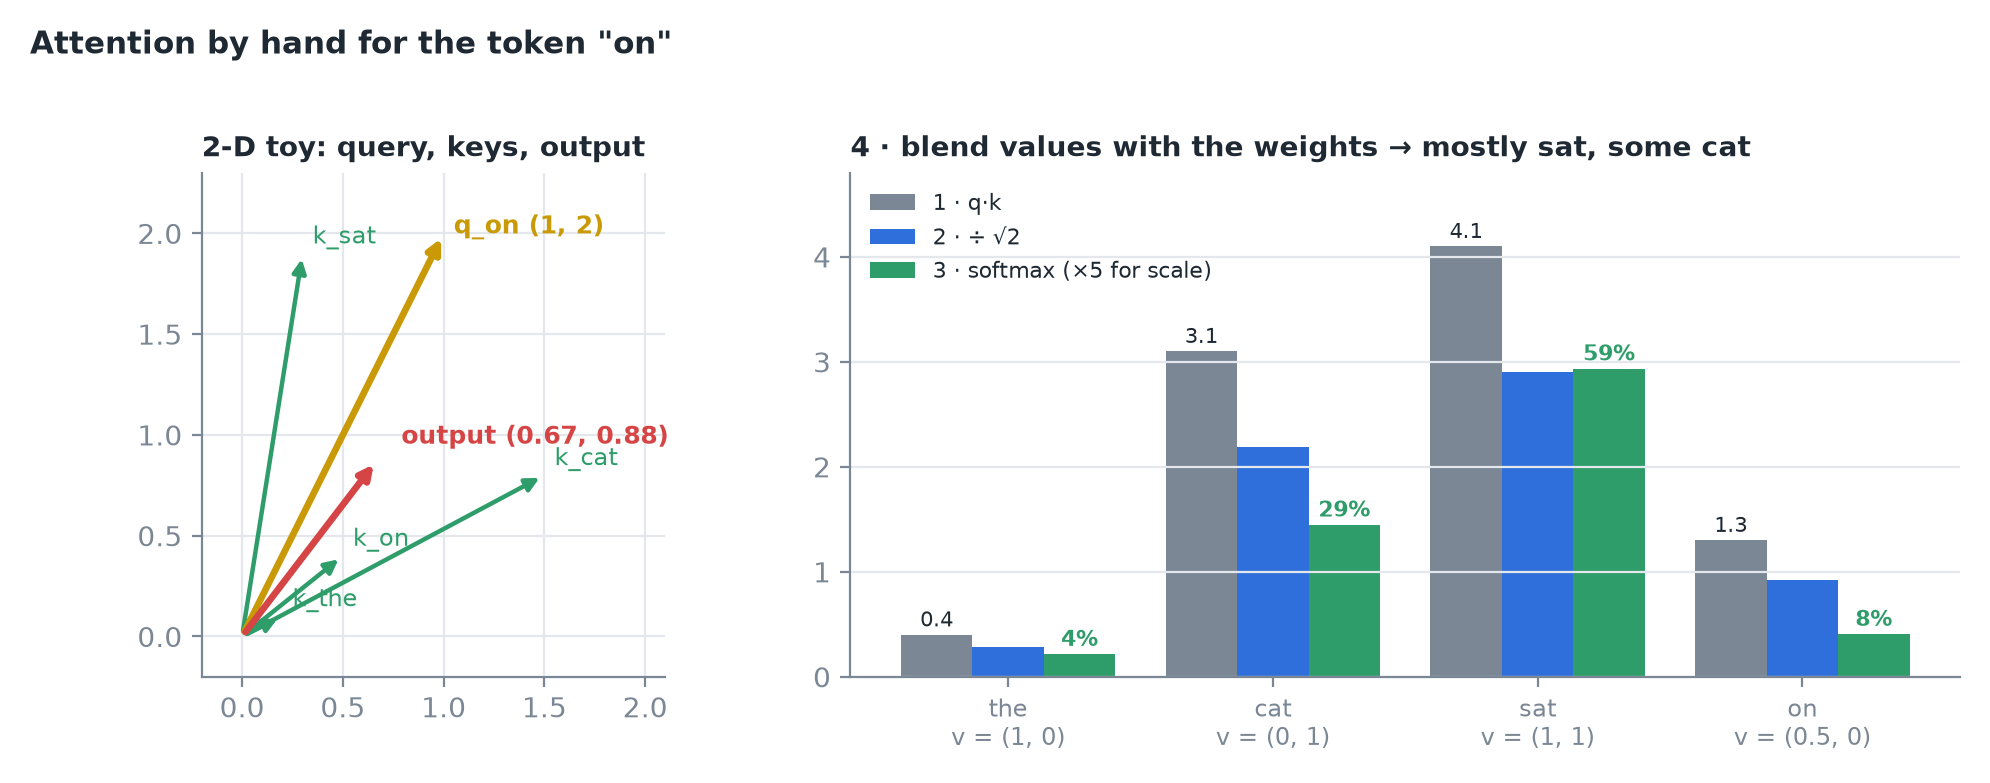 Điểm được chia cho √2 (ở đây head size là 2) trước softmax.
| Token | Key | q·k | Trọng số | Value |
|---|---|---|---|---|
| the | (0,2; 0,1) | 0,4 | 4% | (1, 0) |
| cat | (1,5; 0,8) | 3,1 | 29% | (0, 1) |
| sat | (0,3; 1,9) | 4,1 | 59% | (1, 1) |
| on | (0,5; 0,4) | 1,3 | 8% | (0,5; 0) |
Đầu ra = 0,04·(1, 0) + 0,29·(0, 1) + 0,59·(1, 1) + 0,08·(0,5; 0) ≈ (0,67; 0,88): phần lớn là value của sat, cùng một ít của cat.
4. Lưới điểm và causal mask
Làm như vậy cho mọi token là được một lưới điểm: hàng là query, cột là key. Một token không bao giờ được thấy tương lai, nên mọi ô phía trên đường chéo bị đặt −∞ trước softmax. Vì exp(−∞) = 0, các ô đó nhận trọng số đúng bằng 0, và mỗi hàng vẫn có tổng bằng 1.
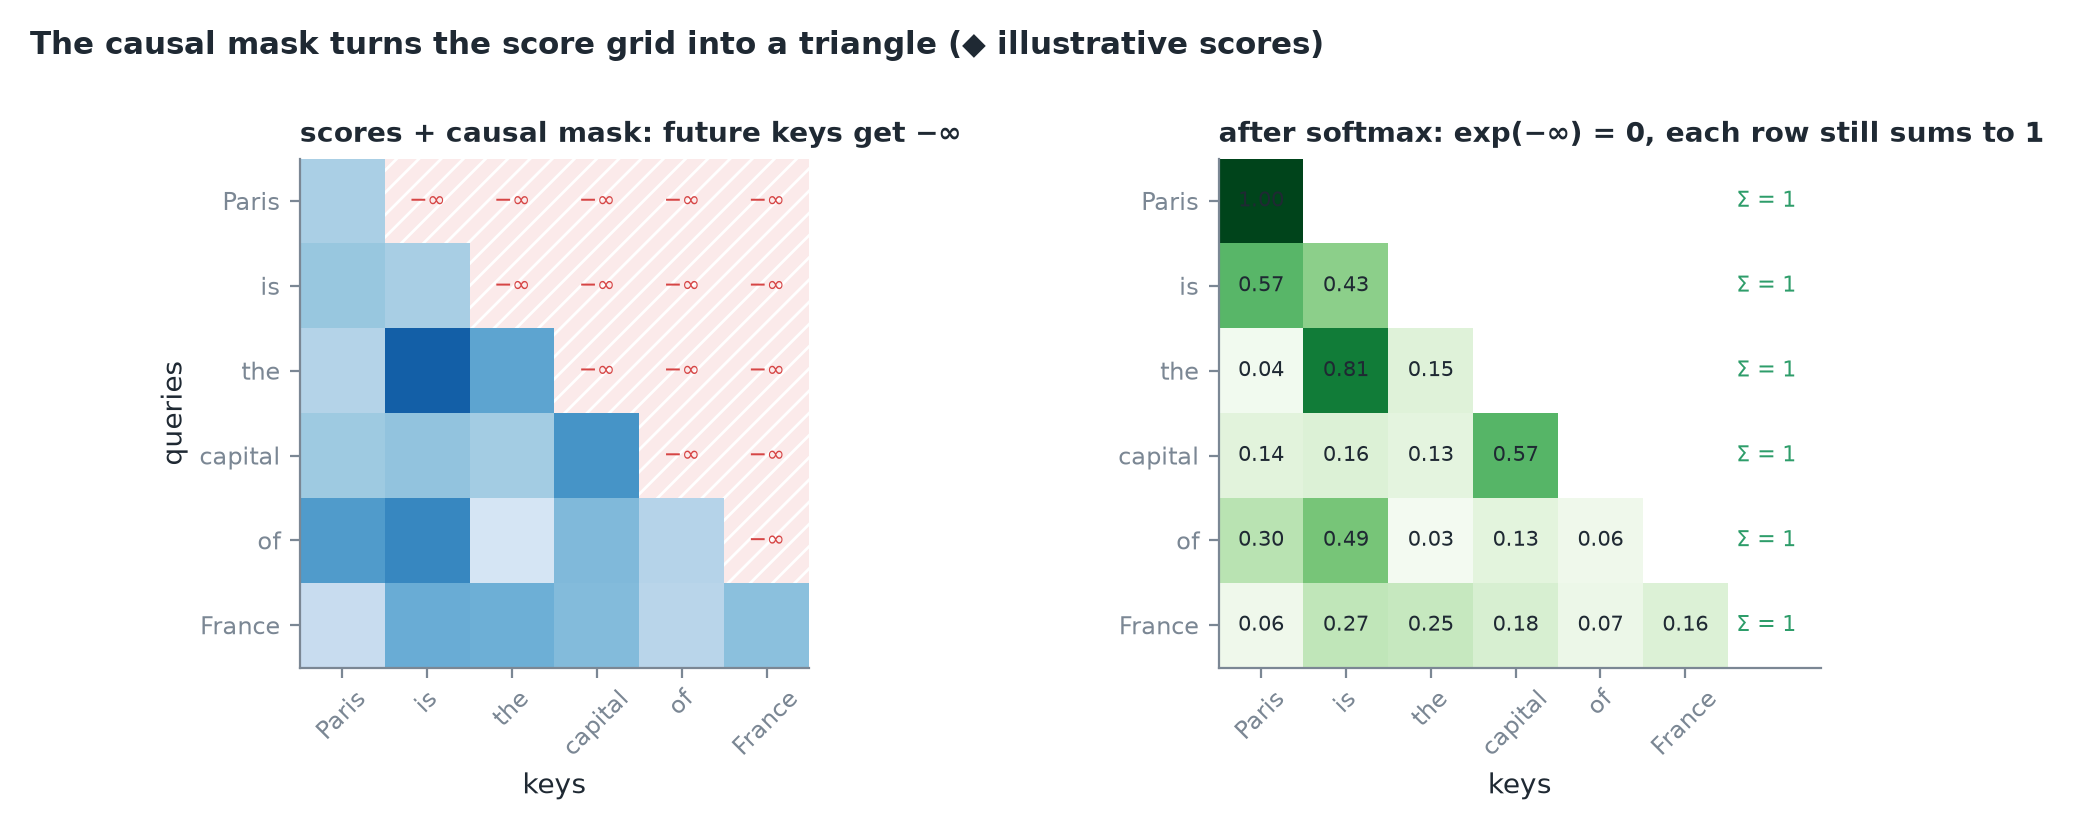 Lưới trở thành tam giác: hàng i chỉ trộn các token 1 … i.
- Khi huấn luyện, mask ngăn model gian lận bằng cách nhìn trộm đáp án.
- Khi inference, đằng nào tương lai cũng chưa tồn tại.
- Hệ quả: nối thêm một token không bao giờ làm thay đổi các hàng trước. Mask của chúng vốn đã loại nó ra.
5. Nhiều head, nhiều layer
Một bộ Q/K/V là một head. Model chạy nhiều head song song, và mỗi head học một kiểu riêng: một head có thể theo dõi từ liền trước, head khác có thể tìm một cái tên khớp ở rất xa phía trước.
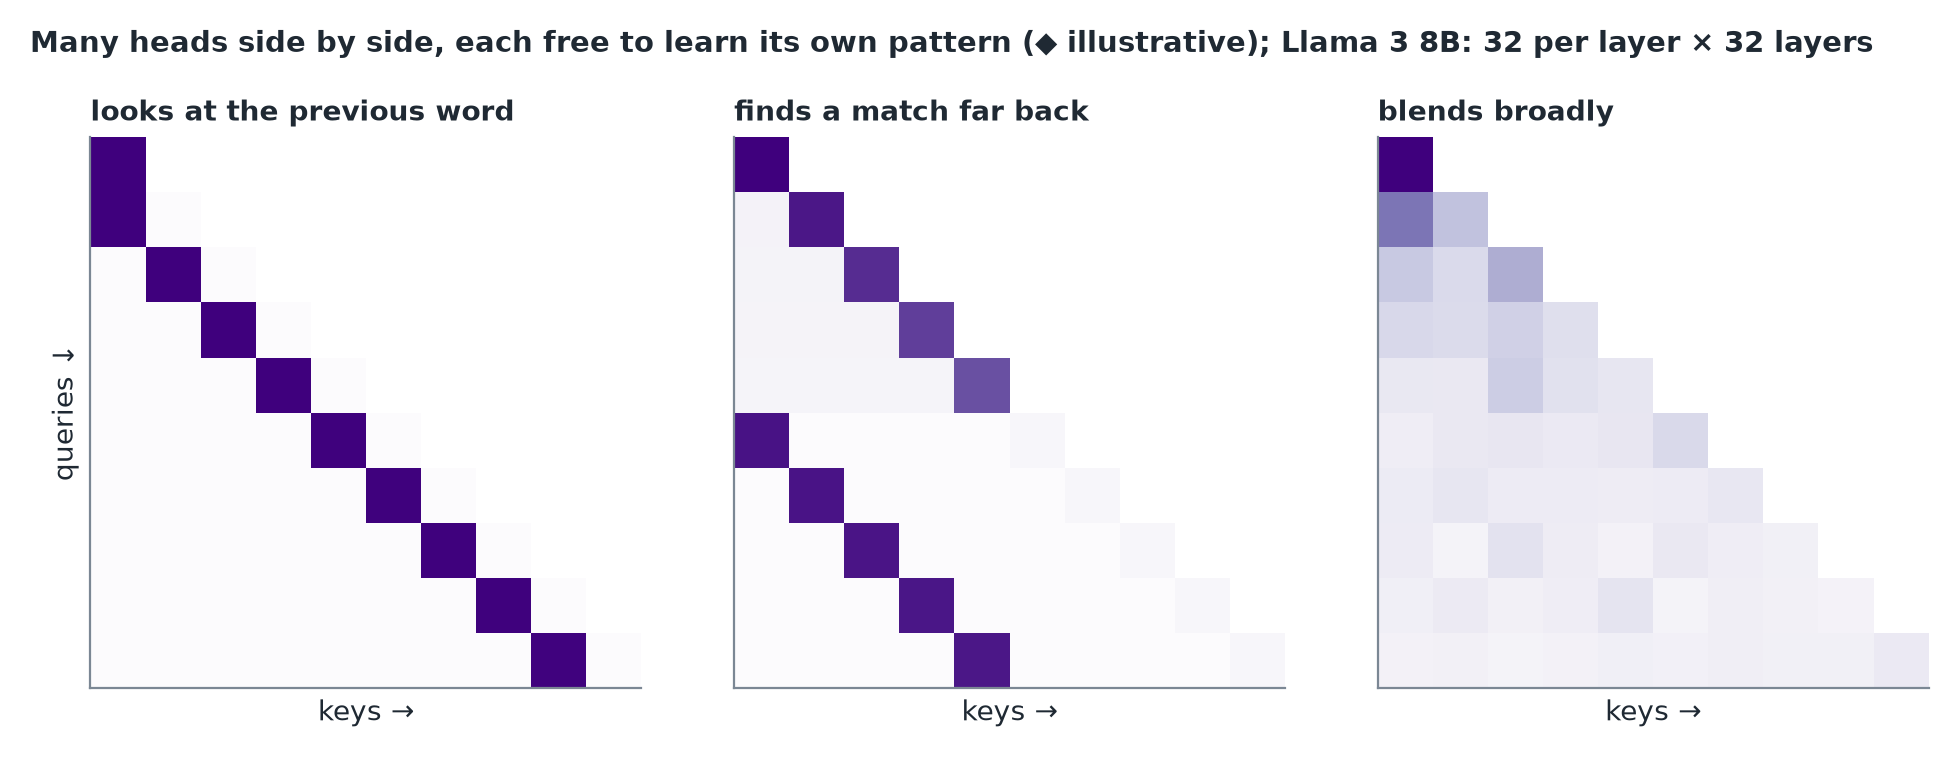 ◆ Các kiểu mang tính minh hoạ. Đầu ra của mỗi head được nối lại thành 4.096.
Llama 3 8B: 32 query head kích thước 128, nhưng chỉ 8 KV head, mỗi cái được một nhóm 4 query head dùng chung (grouped-query attention, GQA). K/V lưu trữ nhỏ hơn 4 lần. Toàn bộ lặp lại trong 32 layer (chi tiết GQA ở bài 05 và 07).
6. Điều gì xảy ra khi sinh token
- Prefill: mọi token của prompt đã biết, nên cả tam giác được tính một lần trong các phép nhân ma trận lớn.
- Decode: mỗi token mới thêm một hàng: 1 query đối với mọi key tới thời điểm đó. Các hàng trước không bị đụng tới (mục 4).
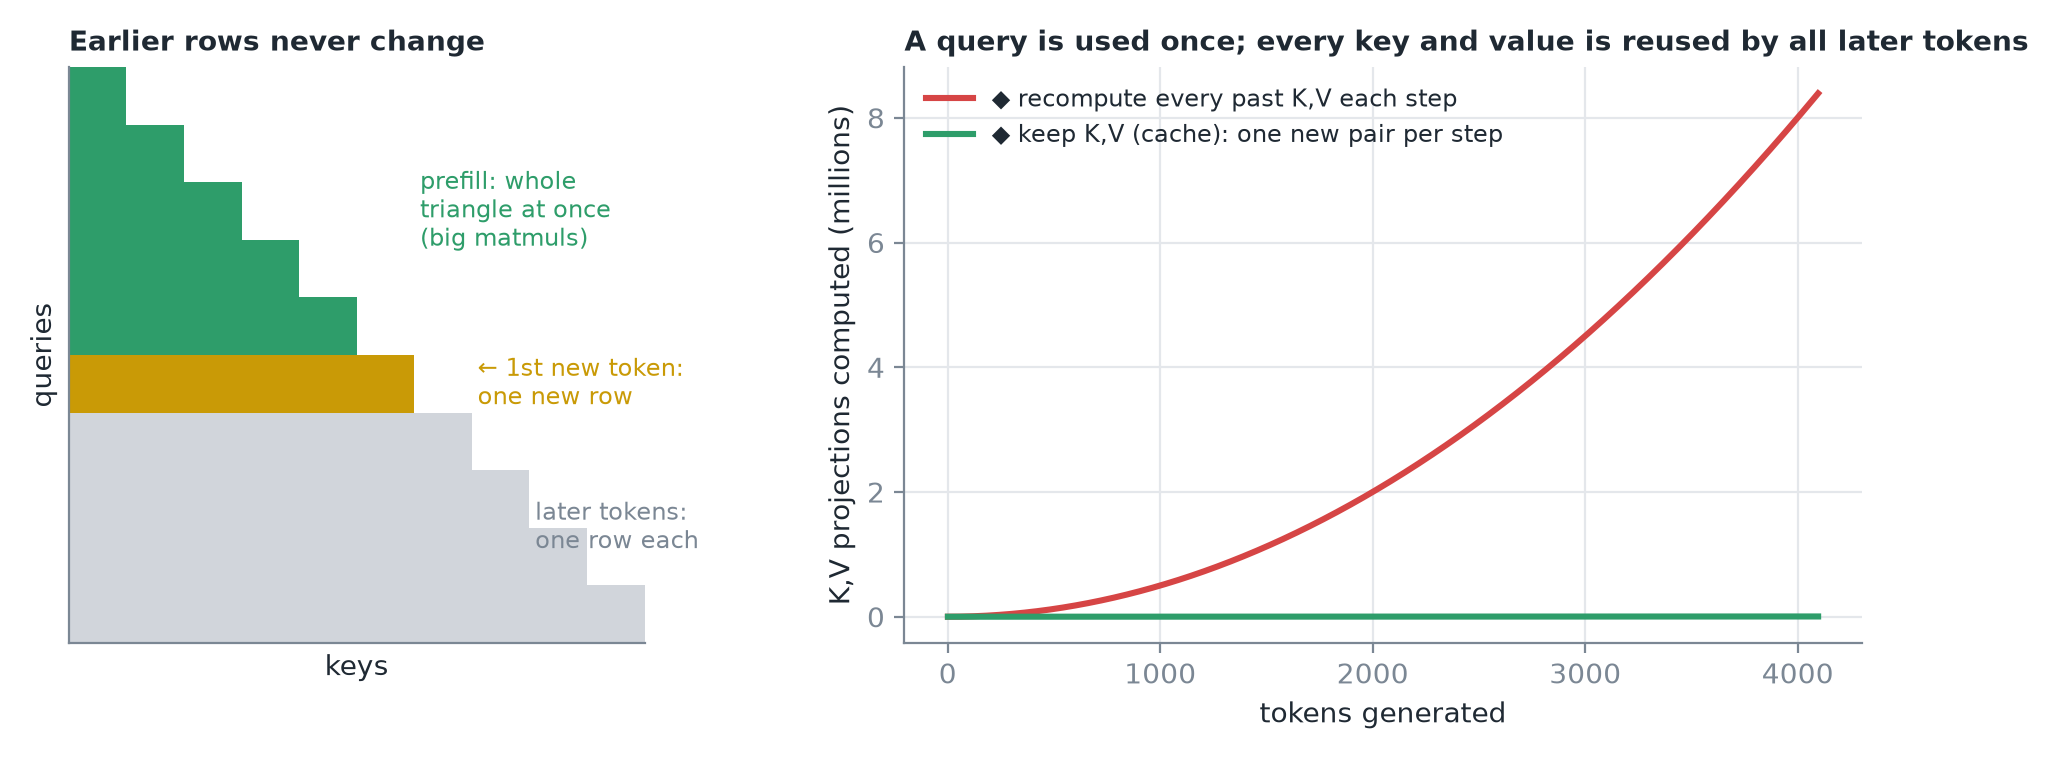 Phải (◆): chiếu lại mọi K và V quá khứ ở mỗi bước tăng như N²/2; giữ chúng lại thì chỉ tăng như N.
Quan trọng
Query của một token chỉ dùng một lần, ở chính bước của nó. Key và value của nó thì mọi token sau đều cần. Vì vậy engine lưu K và V thay vì tính lại: đó là KV cache. Ở 4.000 token × 128 KB ≈ 500 MB K/V phải đọc cho mỗi token được sinh, nên decode bị giới hạn bởi bộ nhớ.
7. Tóm tắt