33 · Lập lịch theo từng vòng lặp (iteration-level scheduling)
Nguồn: fanout.sh / inference-eng / 07-02 · ~5,5 phút
Ghi chú
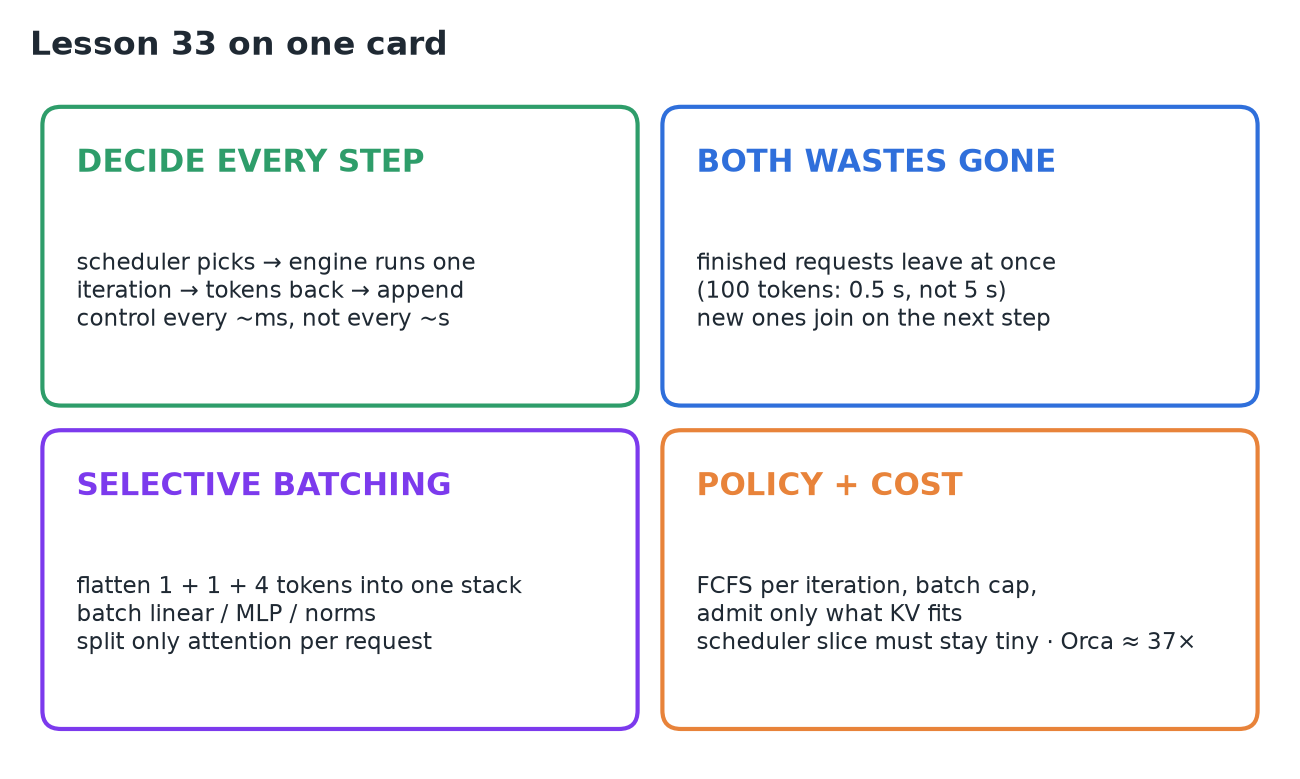
Sự lãng phí của batch tĩnh đến từ ai quyết định thành phần batch, và quyết định bao lâu một lần: mỗi batch một lần. Iteration-level scheduling (Orca, 2022) đổi thành mỗi bước một lần: scheduler chọn request, engine chạy một vòng lặp (mỗi request một token mới), trả token về, và vòng lặp quay tiếp. Request đã xong rời đi ngay và request mới vào ở bước tiếp theo. Selective batching trộn decode với prefill mà không cần padding bằng cách batch mọi layer trừ attention, vốn chạy theo từng request. Một chính sách (FCFS theo từng vòng lặp, giới hạn kích thước batch, chỉ nhận những gì vừa trong KV) quyết định ai được chạy. Orca báo throughput ~37 lần so với FasterTransformer trên GPT-3 175B ở cùng latency.
1. Ai quyết định, và bao lâu một lần
Tách server thành một scheduler (chọn việc) và một engine (chạy model trên GPU).
| Theo request (cũ) | Theo vòng lặp (Orca) | |
|---|---|---|
| Scheduler giao | Một batch: "chạy tới khi mọi người xong" | "Chạy một vòng lặp cho A, B, C" |
| Engine trả về | Mọi câu trả lời, khi request cuối cùng xong | Một token mới cho mỗi request được chọn |
| Scheduler lấy lại quyền điều khiển | Mỗi vài giây | Mỗi vài mili giây |
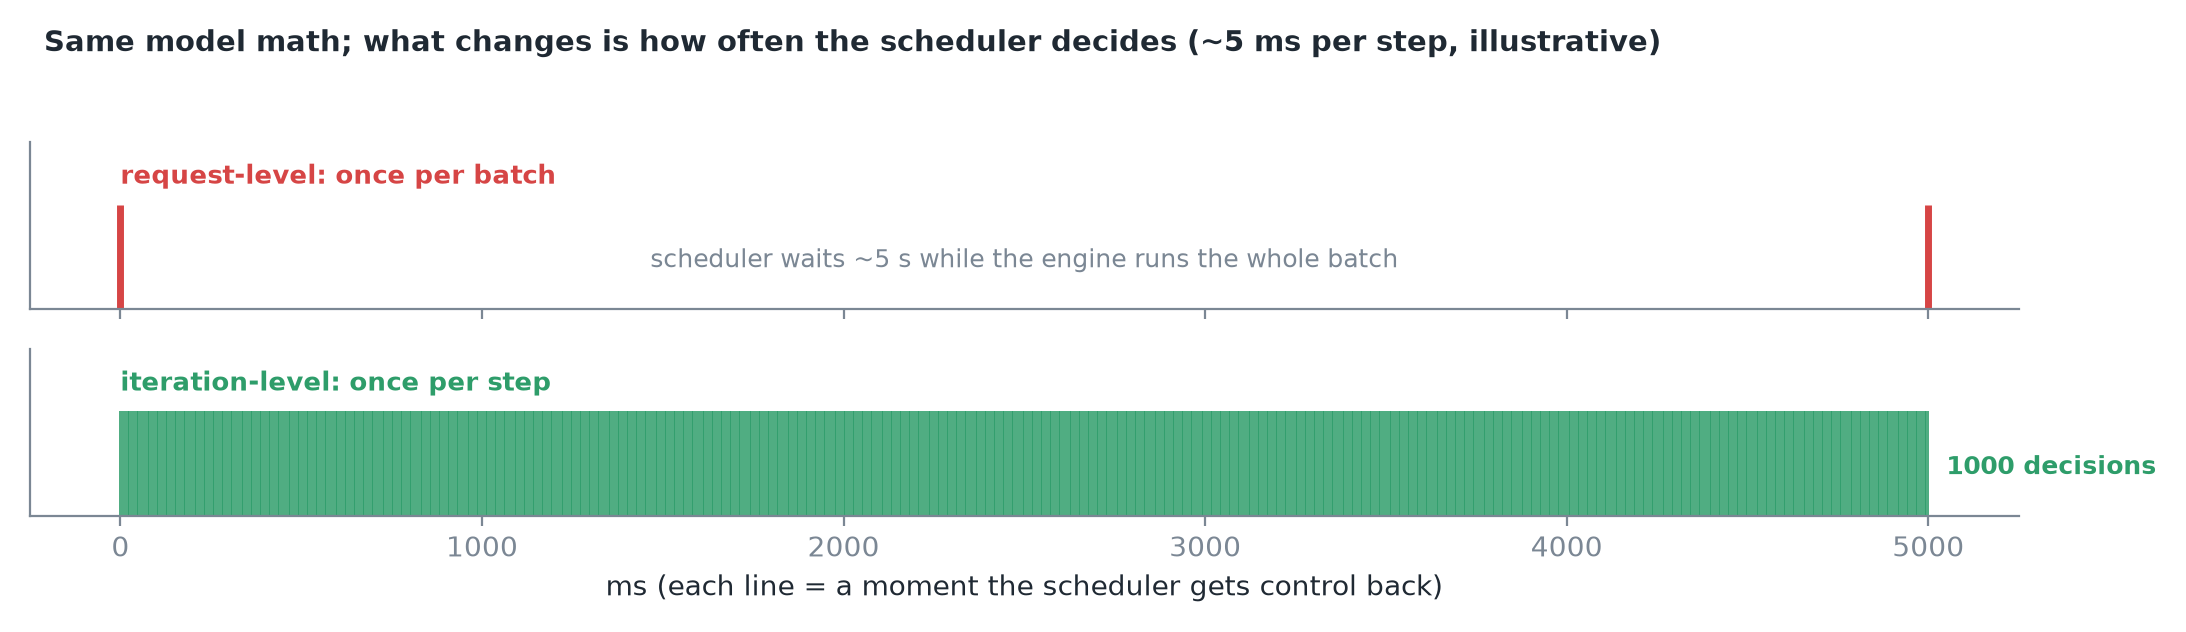 Phép toán của model giữ nguyên; cái thay đổi là scheduler lấy lại quyền điều khiển sau mỗi bước.
2. Một thay đổi đó sửa được cả hai vấn đề
Vẫn bốn request cần 100, 200, 300 và 1.000 token:
- Ở bước 100, request đầu tiên phát ra token cuối; scheduler thấy ngay lập tức và gửi câu trả lời về: ở ~5 ms mỗi bước là 0,5 s, không phải 5 s.
- Slot của nó trống, nên một request vừa đến bắt đầu ngay ở bước kế tiếp thay vì chờ cả batch xả xong.
- Batch không còn là một nhóm cố định: nó là bất kỳ ai đang chạy ở bước này.
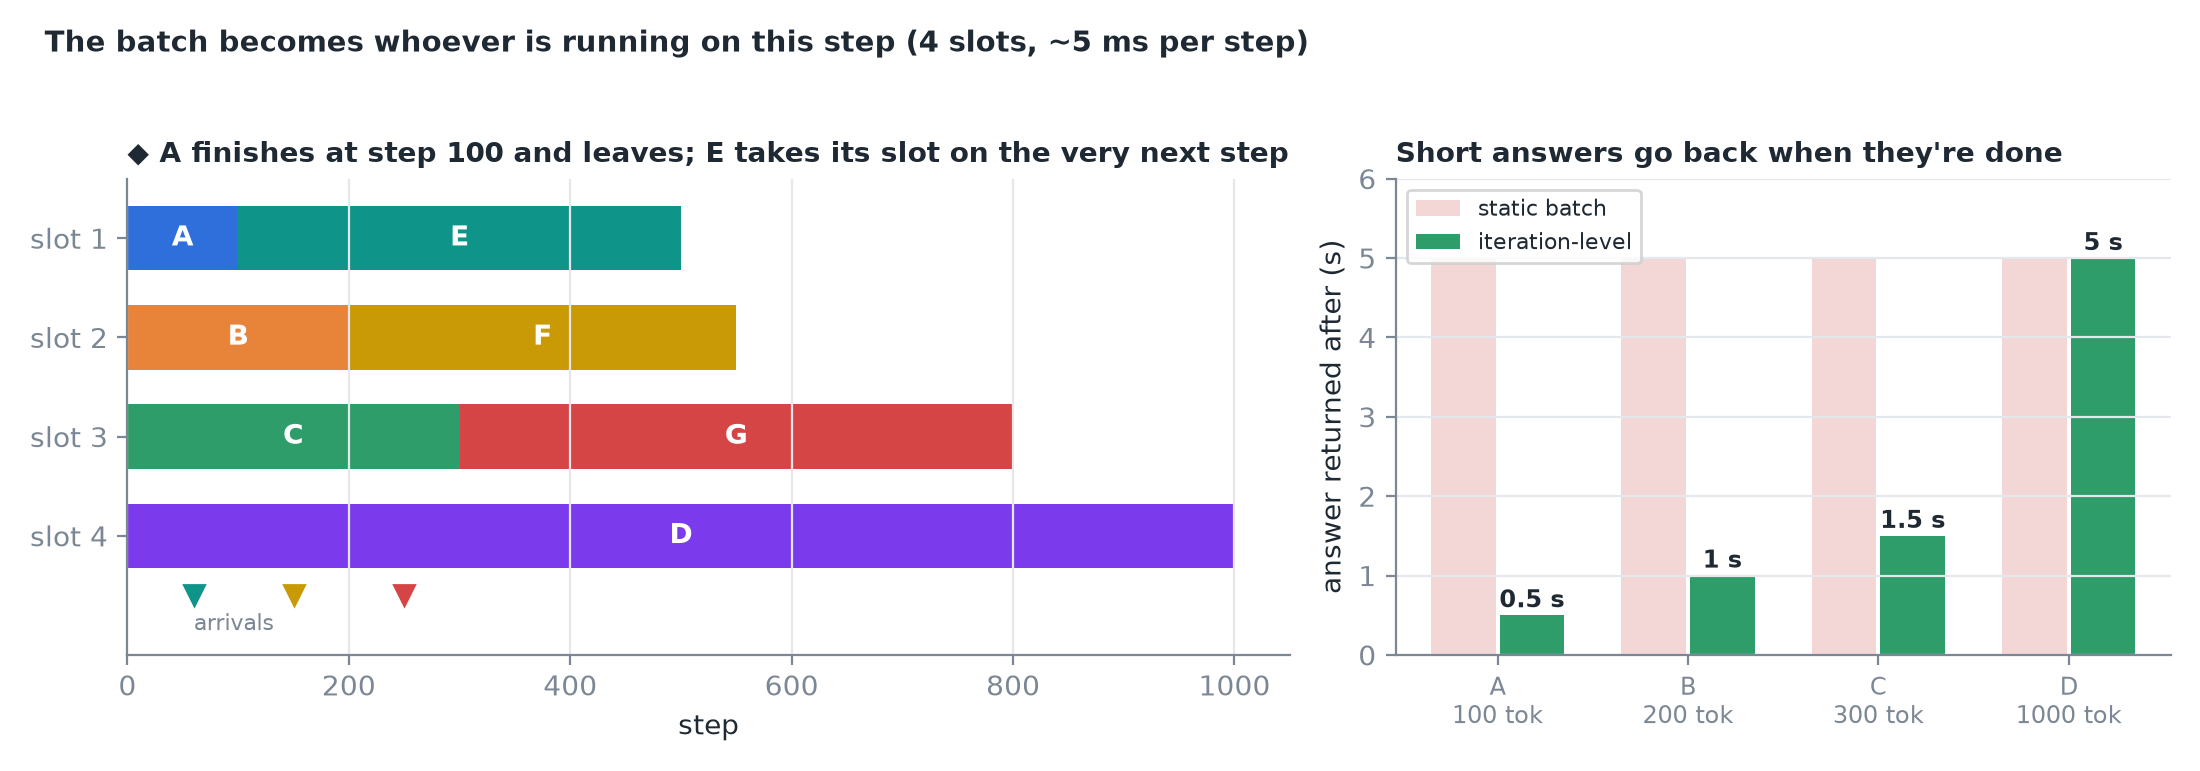 ◆ Trái: một lần chạy minh hoạ với ba request đến sau (E, F, G) lấp các slot khi A, B và C xong. Phải: mỗi câu trả lời được gửi về ngay khi xong.
3. Cái khó: các bước không còn là hình chữ nhật nữa
Ở một bước, hai request có thể đang decode (mỗi cái một token) trong khi một request mới xử lý cả prompt (giả sử bốn token). Batching thông thường muốn mọi request có cùng số token; 1, 1 và 4 không tạo thành hình chữ nhật.
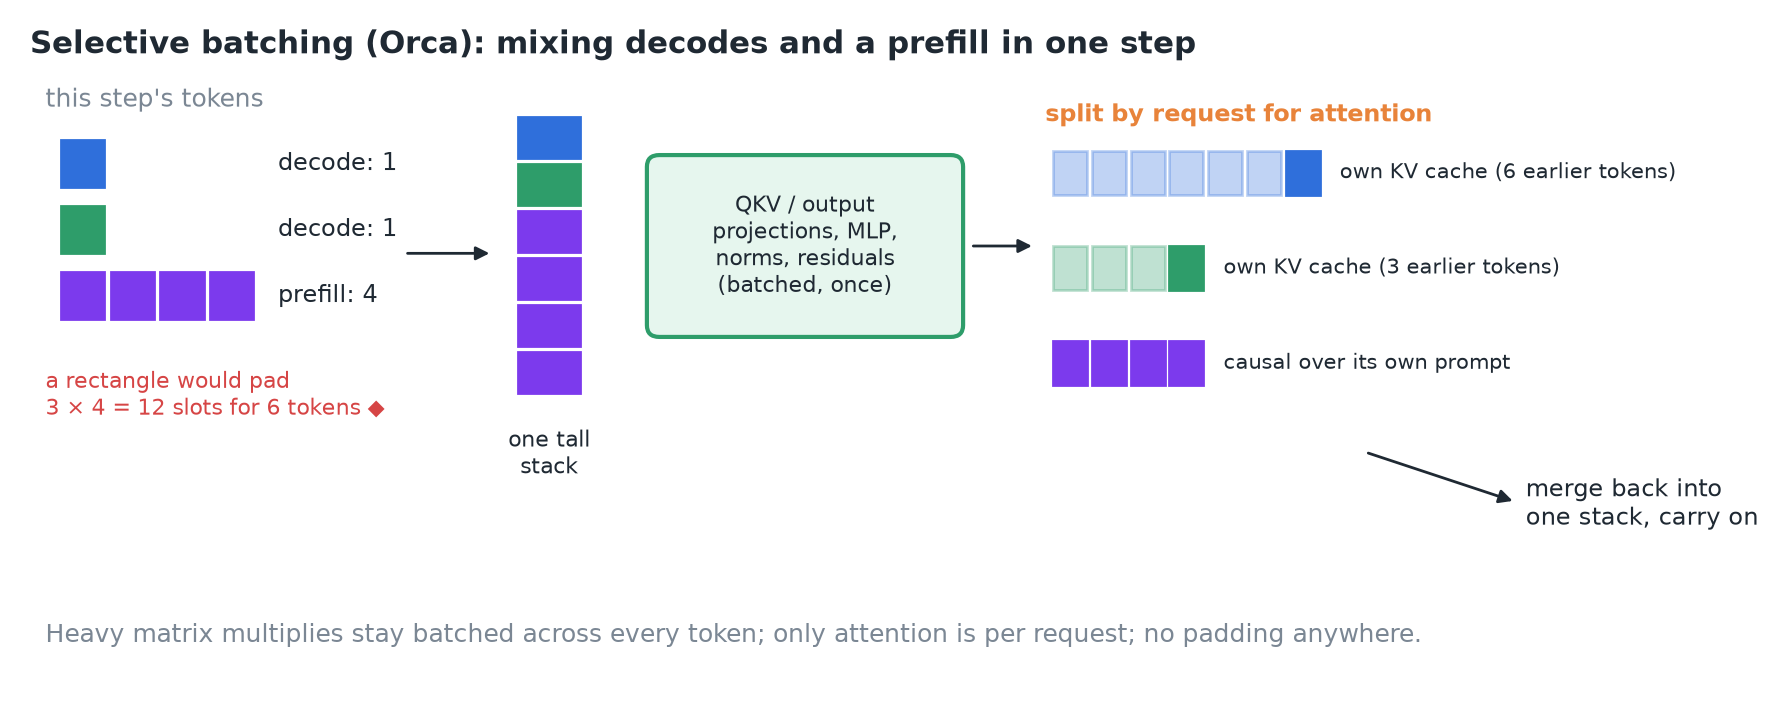 Selective batching của Orca: trải phẳng cả sáu token thành một chồng cho các layer xử lý theo token; tách theo request chỉ ở attention; rồi gộp lại.
- Phần lớn các layer không quan tâm token thuộc request nào: linear layer, MLP, norm và phép cộng residual đối xử với mọi token như nhau. Trải phẳng sáu token thành một chồng cao và chạy các layer đó một lần, trên tất cả.
- Attention là ngoại lệ: mỗi token chỉ được nhìn các token trước thuộc chính request của nó, trong KV cache của request đó. Vì vậy tách chồng ra ngay trước attention, chạy attention theo từng request với lịch sử riêng của nó, rồi gộp lại.
- Các phép nhân ma trận nặng vẫn được batch, và không ai cần padding.
4. Ai được chọn, và cái giá là gì
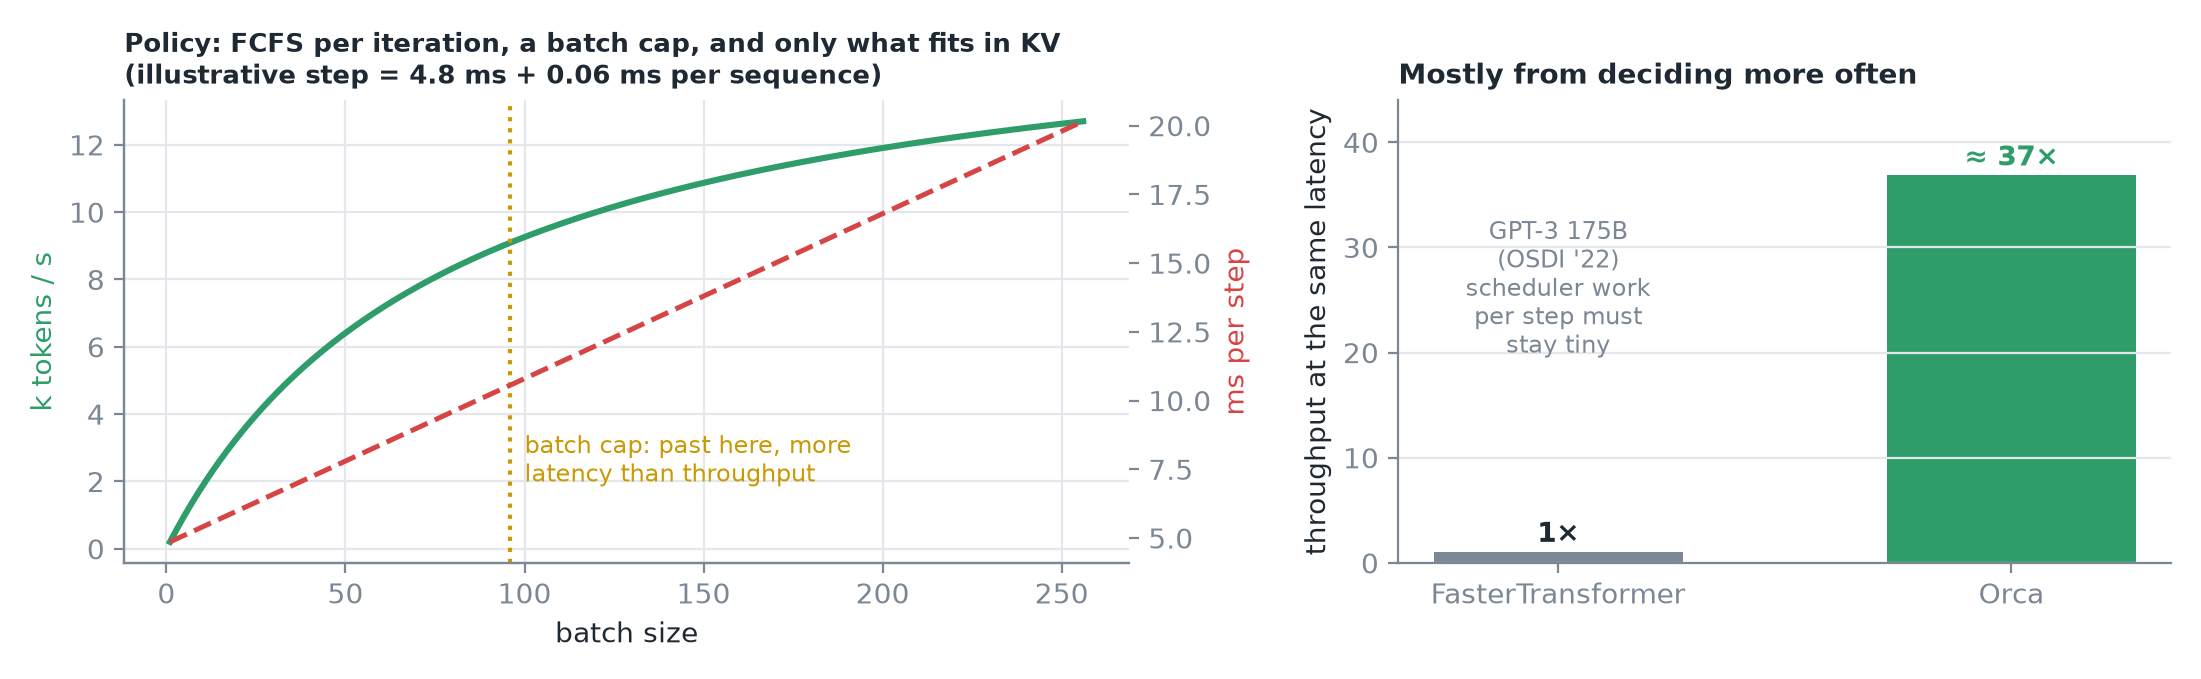 Trái: mô hình thời gian bước mang tính minh hoạ; qua một kích thước batch nào đó, request thêm vào làm tăng latency nhiều hơn throughput, nên người vận hành đặt giới hạn. Phải: Orca so với FasterTransformer trên GPT-3 175B (OSDI '22).
- Đến trước phục vụ trước, theo từng vòng lặp: request đến sớm hơn luôn đã chạy ít nhất bằng số bước của request đến sau.
- Một giới hạn kích thước batch: qua một mức nào đó, batch lớn hơn thêm latency nhiều hơn throughput, nên người vận hành tinh chỉnh núm này.
- Bộ nhớ KV: mọi request đang chạy cần chỗ cho cache của nó, nên scheduler chỉ nhận được những gì vừa.
- Giờ scheduler chạy ở mọi bước, nên phần việc của chính nó chỉ được chiếm một lát rất nhỏ trong vài mili giây đó.
Quan trọng
Con số ~37 lần của Orca phần lớn đến từ việc đơn giản là quyết định thường xuyên hơn.
5. Tóm tắt