36 · Xếp hàng, công bằng, huỷ request và preemption
Nguồn: fanout.sh / inference-eng / 07-05 · ~6 phút
Ghi chú
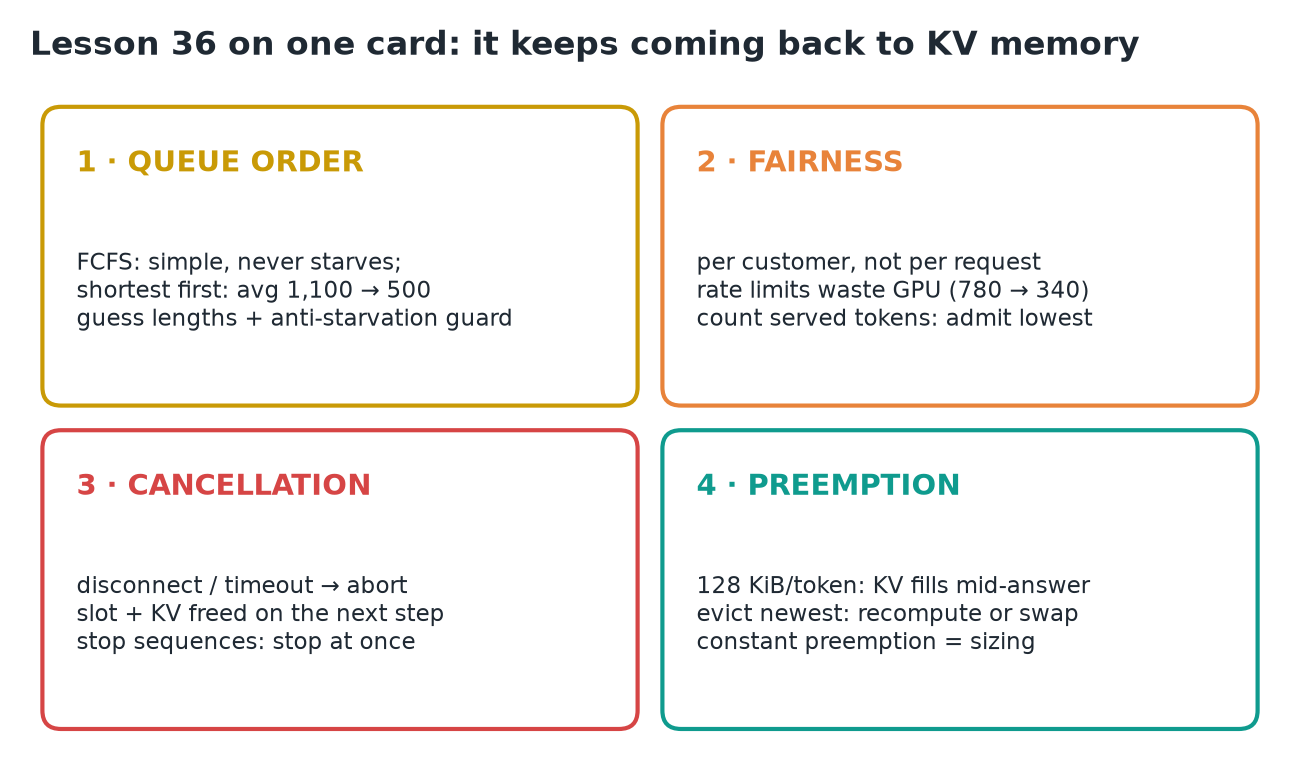
Dưới tải thật, không đủ chỗ cho tất cả mọi người, nên scheduler phải trả lời bốn câu hỏi. Thứ tự hàng đợi quyết định latency trung bình: FCFS không bao giờ bỏ đói ai, nhưng ngắn nhất trước giảm thời điểm xong trung bình trong ví dụ từ 1.100 xuống 500 bước, nếu bạn đoán được độ dài và có cơ chế bảo vệ request dài. Công bằng là theo khách hàng: đếm token đã phục vụ của từng client (Virtual Token Counter) tốt hơn rate limit thô, vốn làm throughput tụt từ ~780 xuống ~340 token/s. Việc bị huỷ nên được dừng ngay để giải phóng slot và KV. Khi bộ nhớ KV cạn (128 KiB mỗi token trên Llama 3.1 8B), engine preempt một request bằng cách tính lại hoặc swap nó ra.
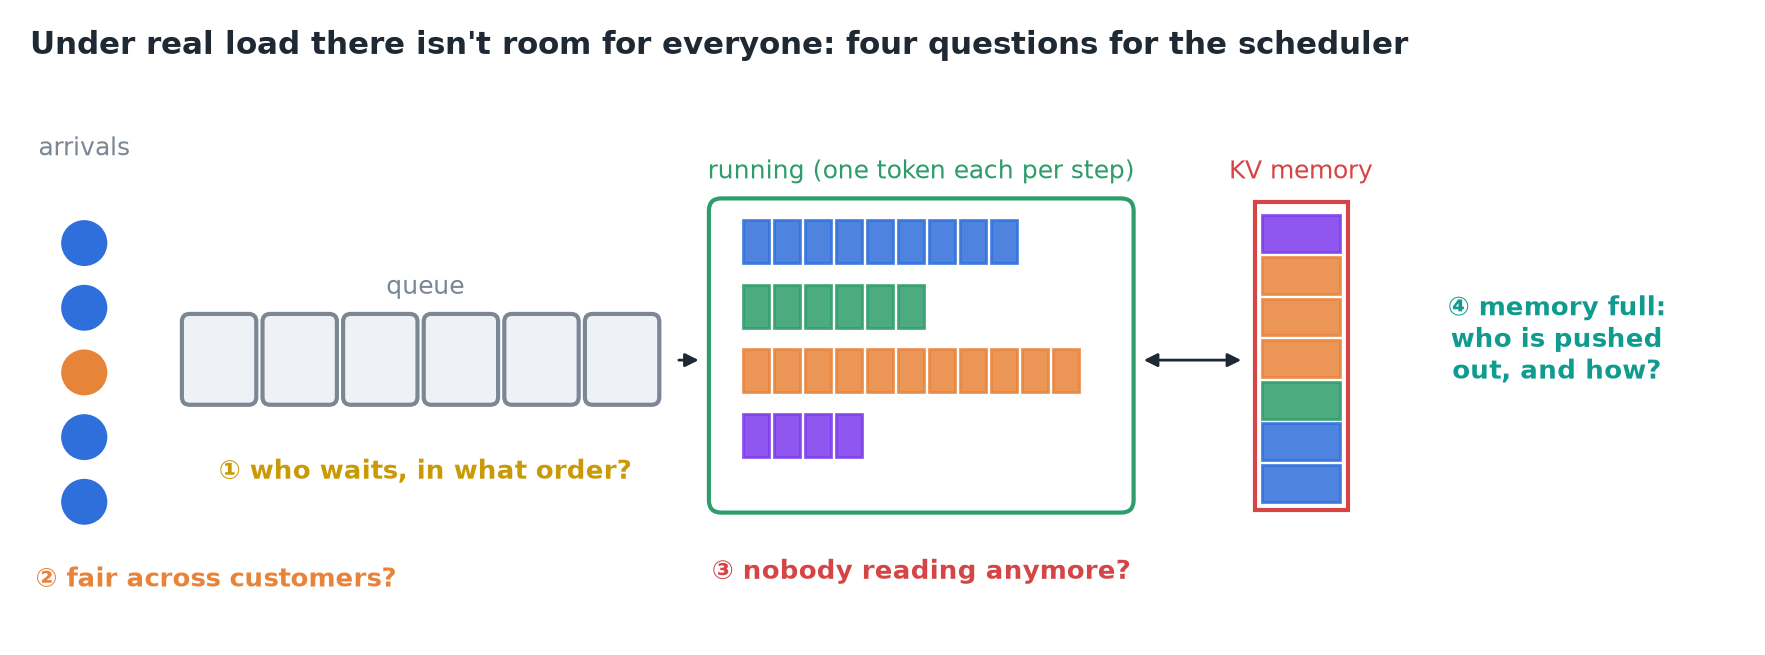 Request xếp hàng, khách hàng tranh nhau, người dùng bỏ đi, và request đang chạy lớn vượt quá bộ nhớ.
1. Hàng đợi: ai phải chờ, và theo thứ tự nào?
- Phần lớn engine, kể cả vLLM, mặc định là đến trước phục vụ trước (FCFS): đơn giản, và không request nào bị bỏ đói.
- Khi một request dài đứng đầu hàng, mọi người phía sau phải chờ: head-of-line blocking. Việc ngắn nhất trước (SJF) là cách chữa kinh điển.
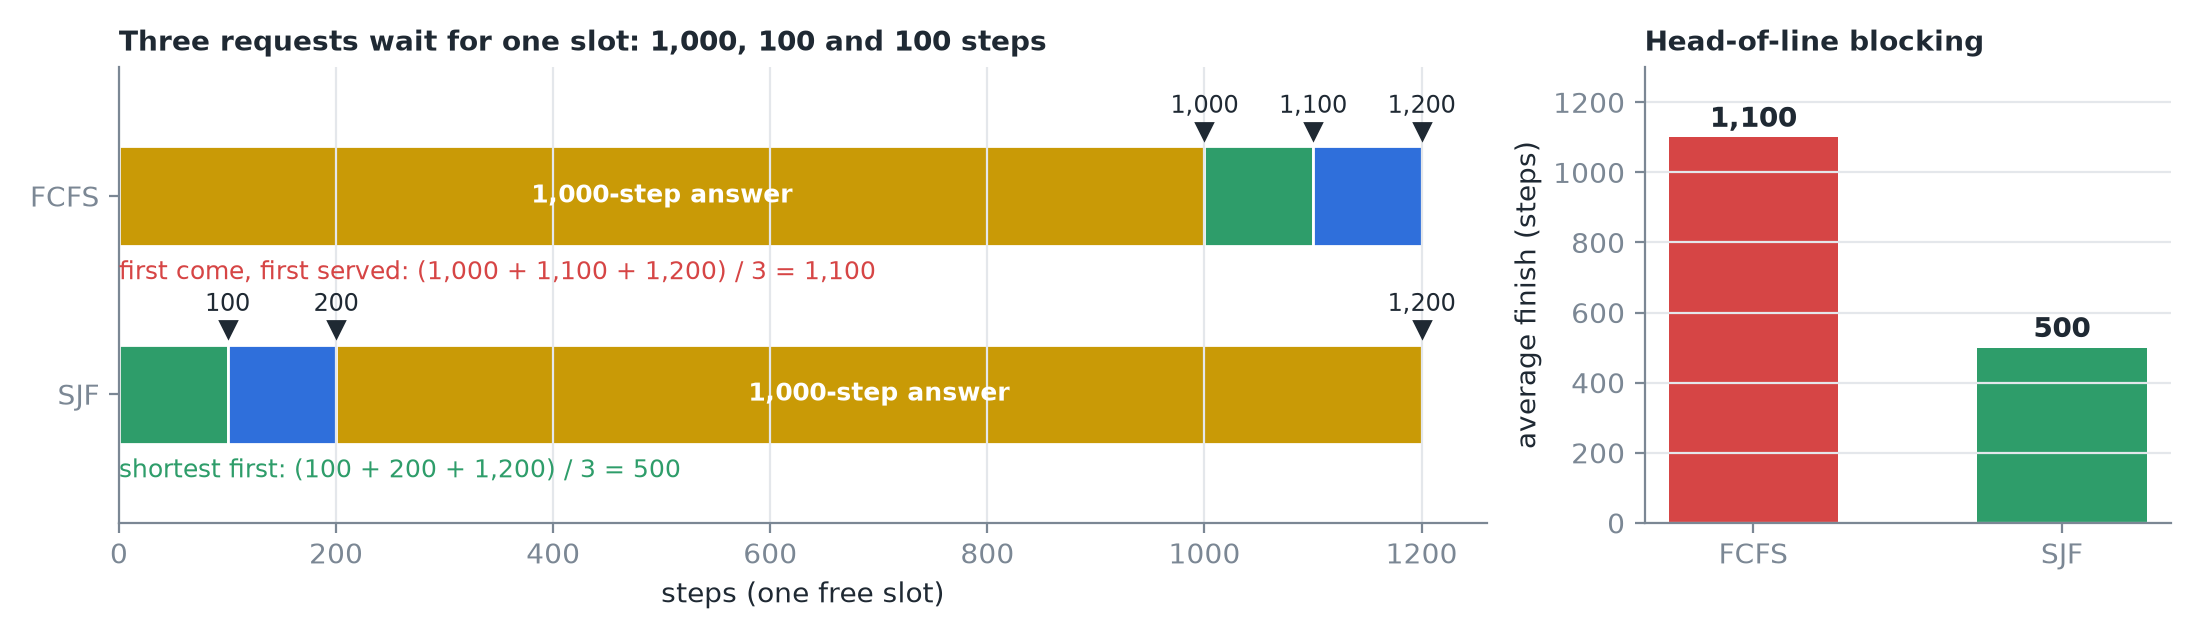 Một slot trống, ba request đang chờ. Request dài xong ở 1.200 dù thế nào; chạy các request ngắn trước làm giảm trung bình hơn một nửa.
Thận trọng
Không ai biết độ dài câu trả lời trước khi nó được sinh ra. Các scheduler trong nghiên cứu dự đoán độ dài, hoặc chỉ dự đoán request nào ngắn hơn (một scheduler learning-to-rank báo latency chatbot thấp hơn 2,8 lần, 2024). Chúng cũng cần một cơ chế bảo vệ để request dài không phải chờ mãi mãi.
- ◆ vLLM còn có
--scheduling-policy priority, sắp xếp hàng đợi theo trườngprioritycủa từng request thay vì thời điểm đến.
2. Công bằng: theo khách hàng, không theo request
Client A gửi 90% lưu lượng, client B chỉ lác đác. Với FCFS, vài request của B nằm sau một bức tường request của A.
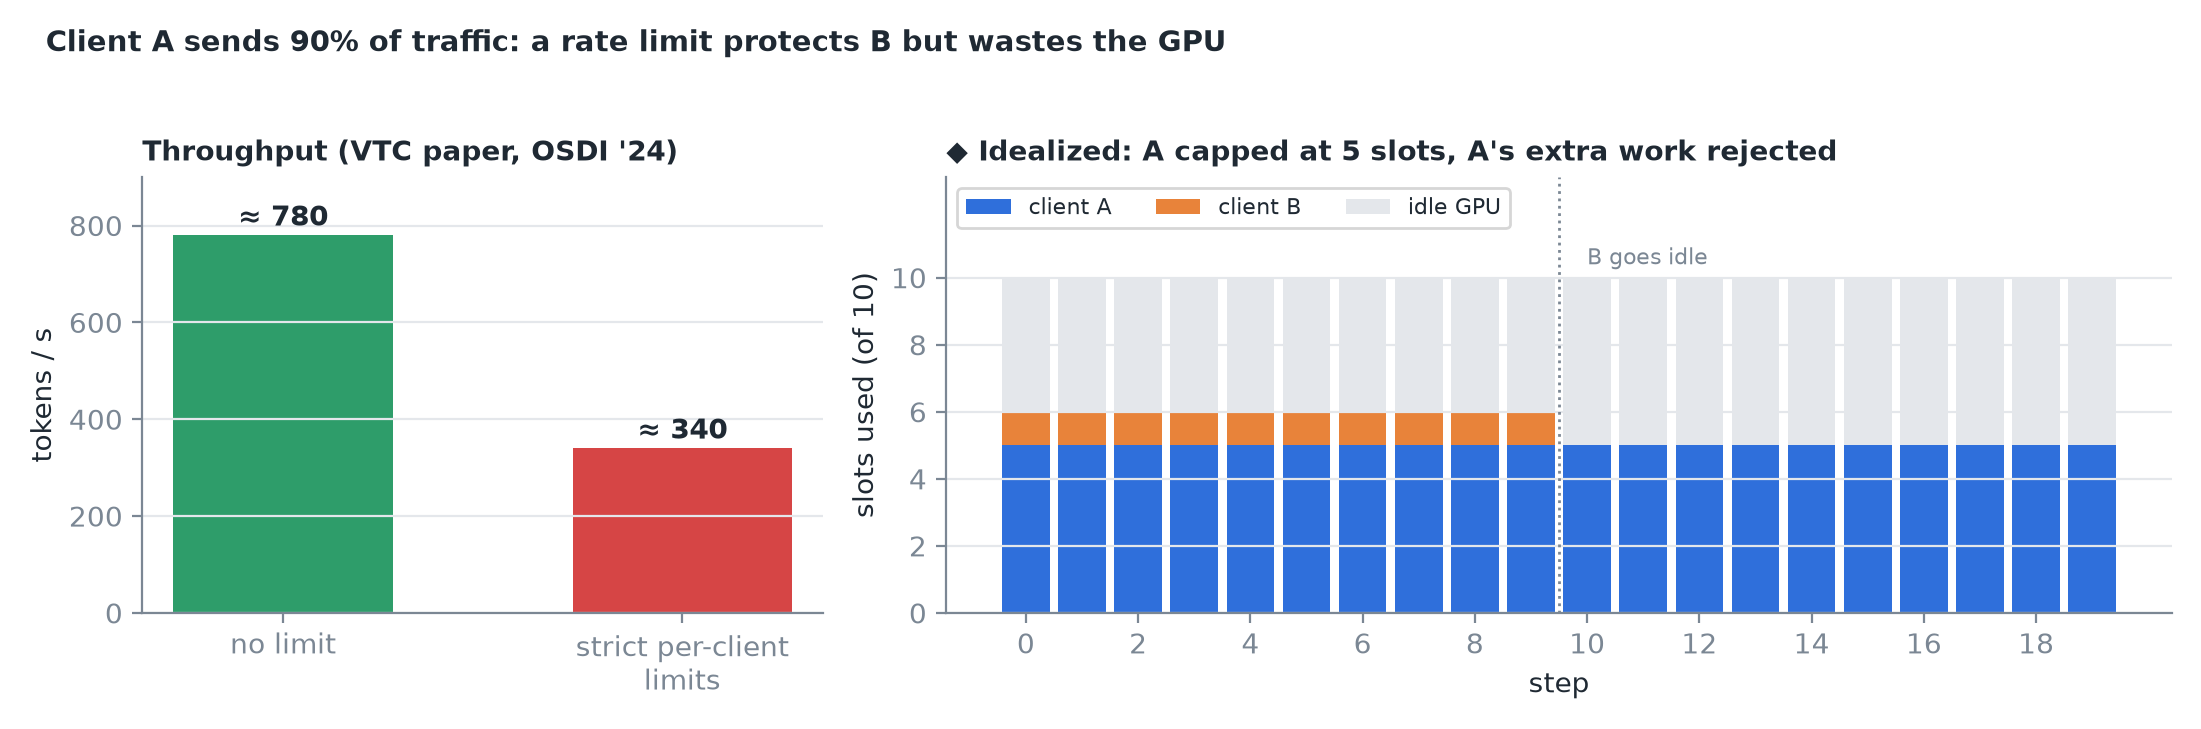 Cách sửa thô bạo là rate limit theo client (N request/phút). Nó từ chối việc của A ngay cả khi GPU còn dư chỗ: trong paper VTC (OSDI '24), giới hạn chặt làm throughput giảm từ ~780 xuống ~340 token/s.
Virtual Token Counter (VTC) mượn ý tưởng từ fair queueing trong mạng:
- Giữ một bộ đếm cho mỗi client về số token nó đã được phục vụ, đầu vào và đầu ra được đánh trọng số riêng.
- Mỗi khi có chỗ, nhận request kế tiếp từ client có bộ đếm thấp nhất.
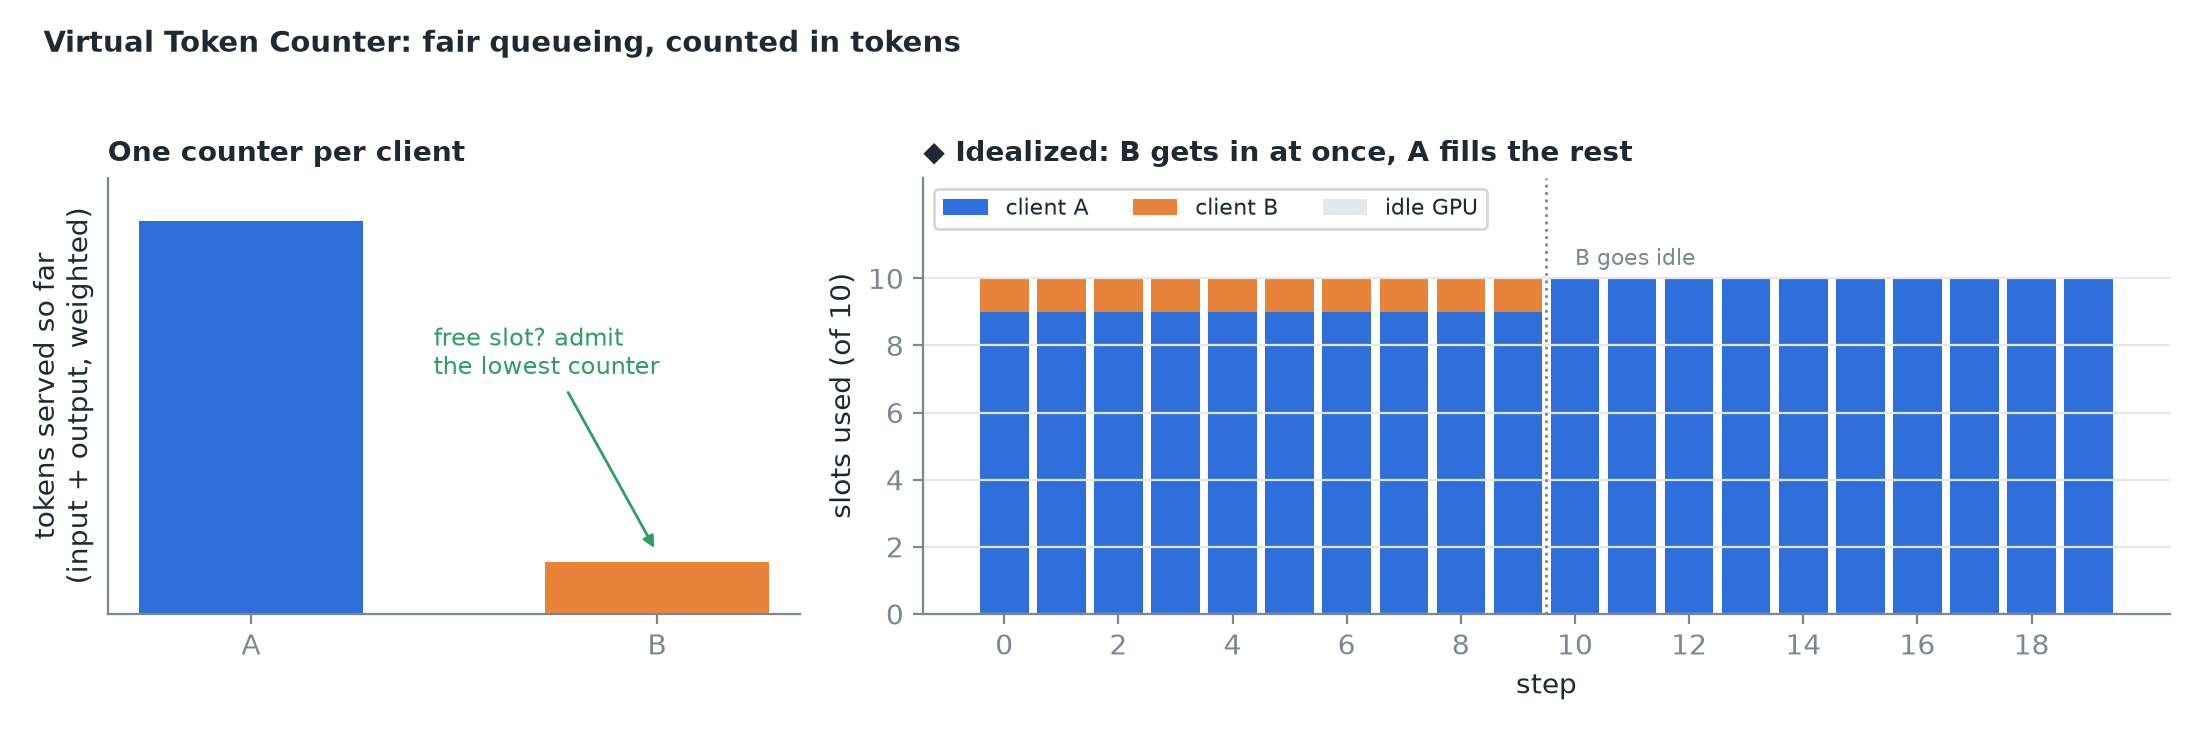 Bộ đếm của B luôn thấp, nên B được vào ngay; khi B rảnh, A có thể dùng cả GPU. Không có gì bị bỏ không khi còn người có việc.
- ◆ Trong paper, một client quay lại sau thời gian rảnh được nâng bộ đếm lên bằng bộ đếm thấp nhất đang hoạt động, để thời gian rảnh không thể tích luỹ thành tín dụng rồi dùng để bỏ đói người khác về sau.
3. Huỷ request: dừng phần việc không ai đọc
- Người dùng đóng tab giữa chừng câu trả lời. Nếu engine không nhận ra, nó tiếp tục sinh cho không ai cả: thời gian GPU thật, và request vẫn giữ KV cache của nó.
- Một server tốt theo dõi kết nối. Khi mất kết nối hoặc timeout, nó huỷ (abort) request, và ngay ở bước kế tiếp slot cùng bộ nhớ của nó chuyển cho các request vẫn còn được cần.
- Tương tự với stop sequence và giới hạn độ dài: dừng ngay khi biết, không phải đợi tới cuối.
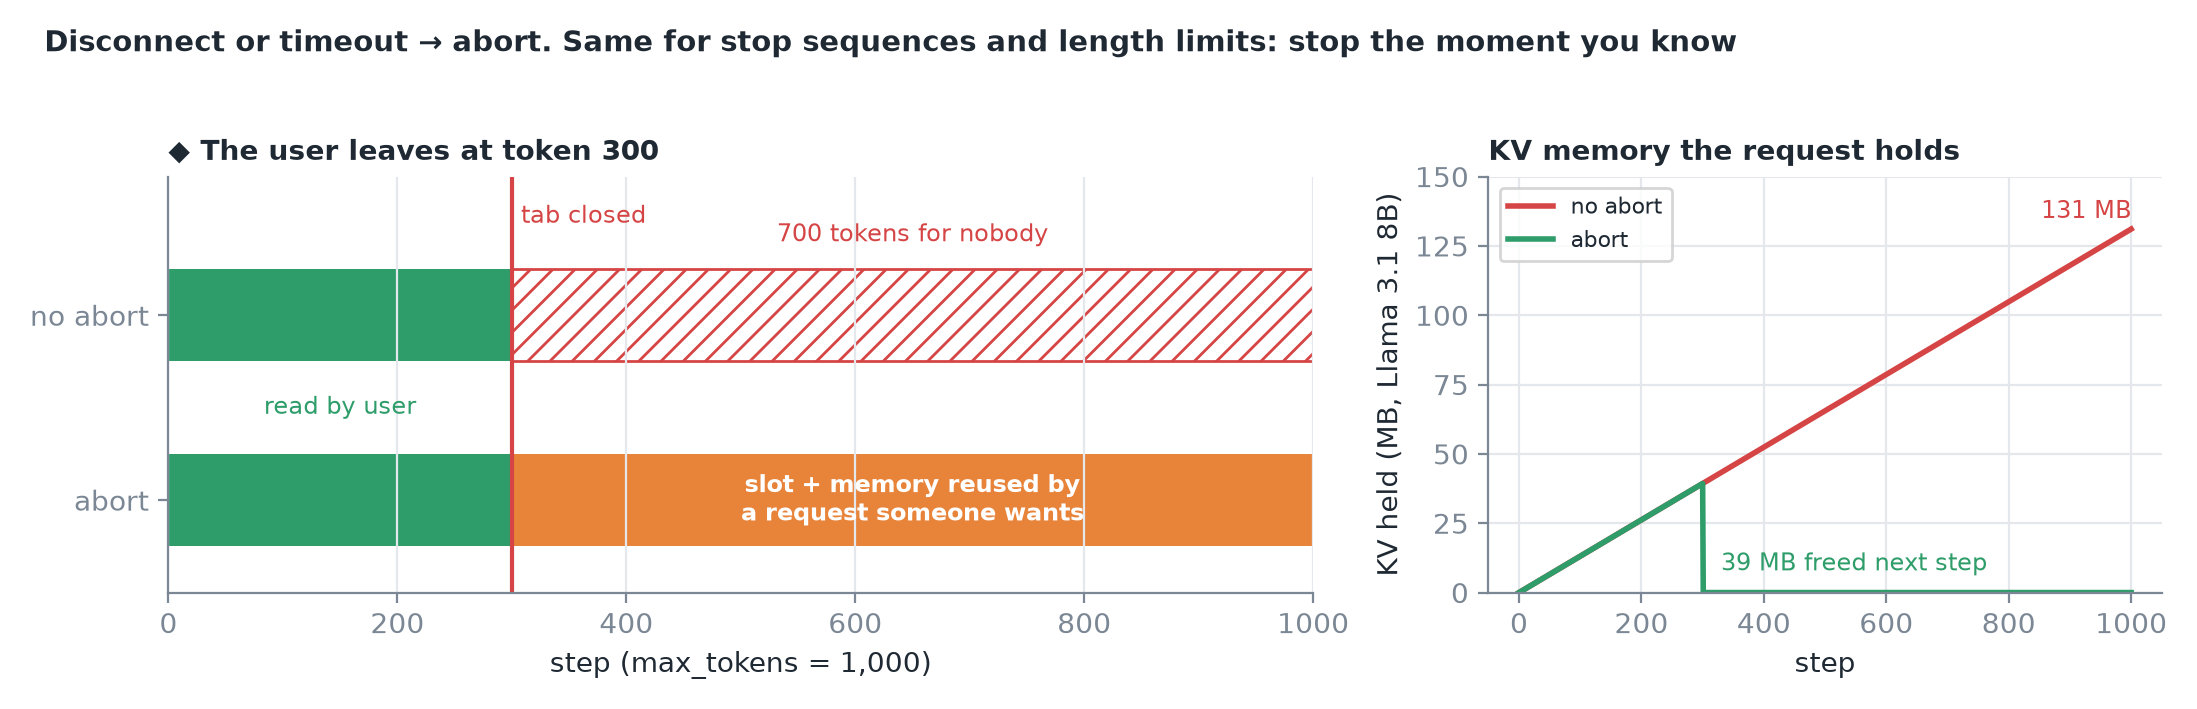 ◆ Số ví dụ: một câu trả lời 1.000 token bị bỏ dở ở token 300. Không abort thì 700 token bị lãng phí và KV lớn tới 131 MB; có abort thì 39 MB được giải phóng ở bước kế tiếp.
4. Preemption: hết bộ nhớ giữa chừng câu trả lời
Request đang chạy cứ lớn dần. Llama 3.1 8B (K và V × 32 layer × 8 KV head × 128 chiều × 2 byte):
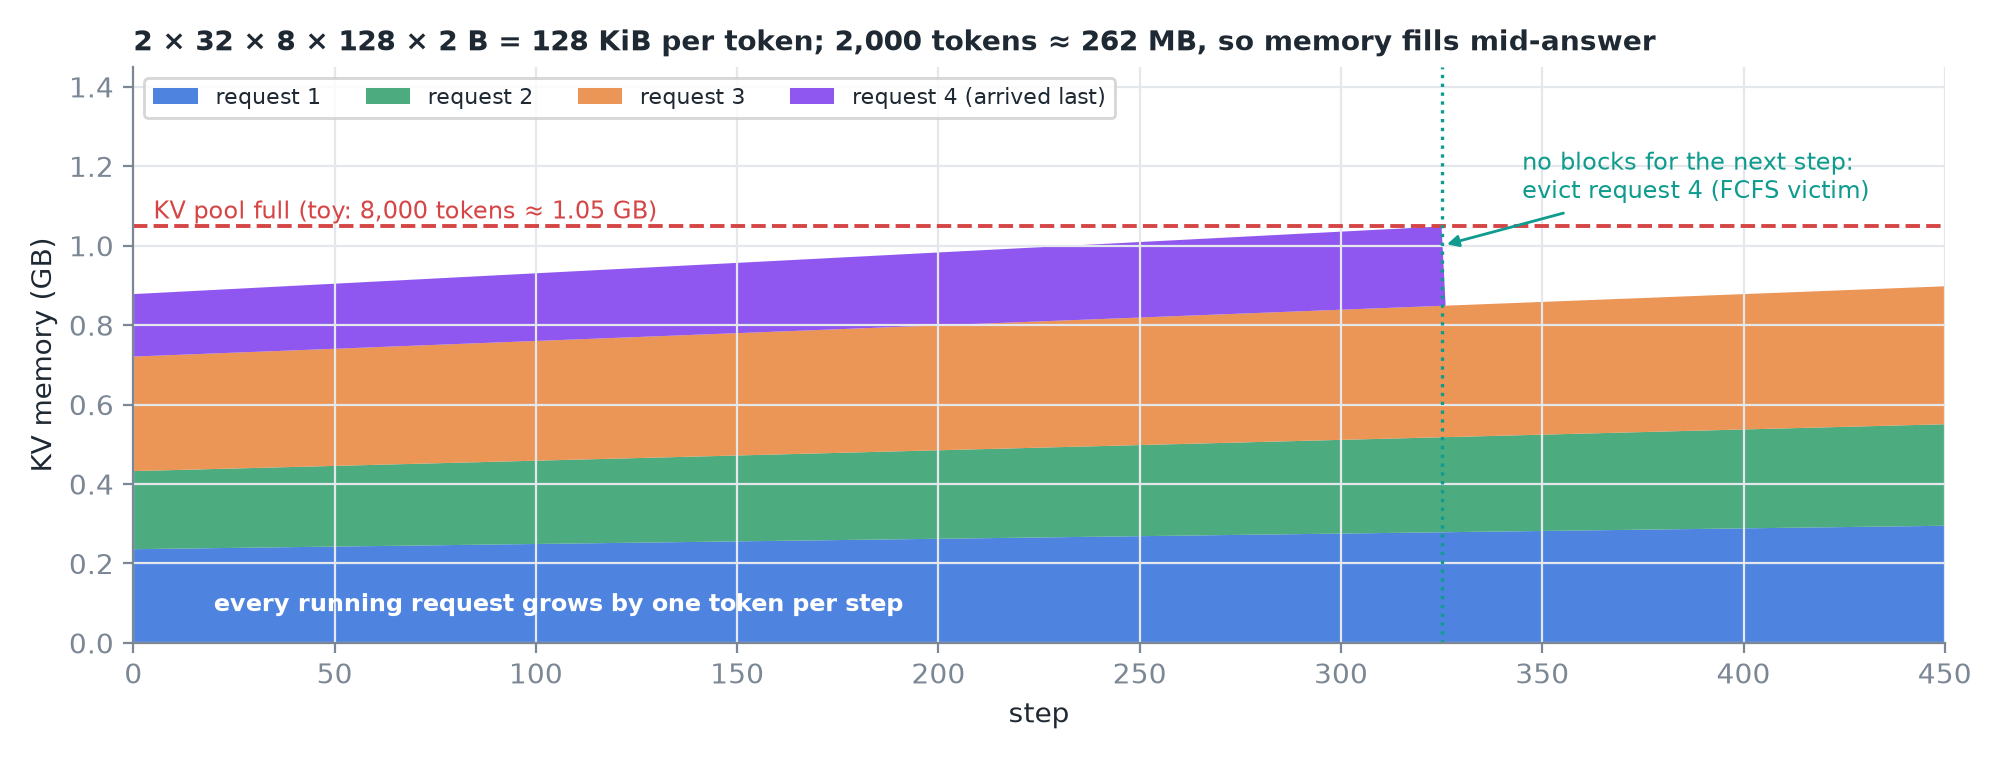 Pool đồ chơi. Bộ nhớ đầy dần trong khi mọi người đều đang giữa câu trả lời; khi bước tiếp theo không xin được block cho tất cả, scheduler đẩy ai đó ra. Với FCFS, nạn nhân thường là request đến sau cùng.
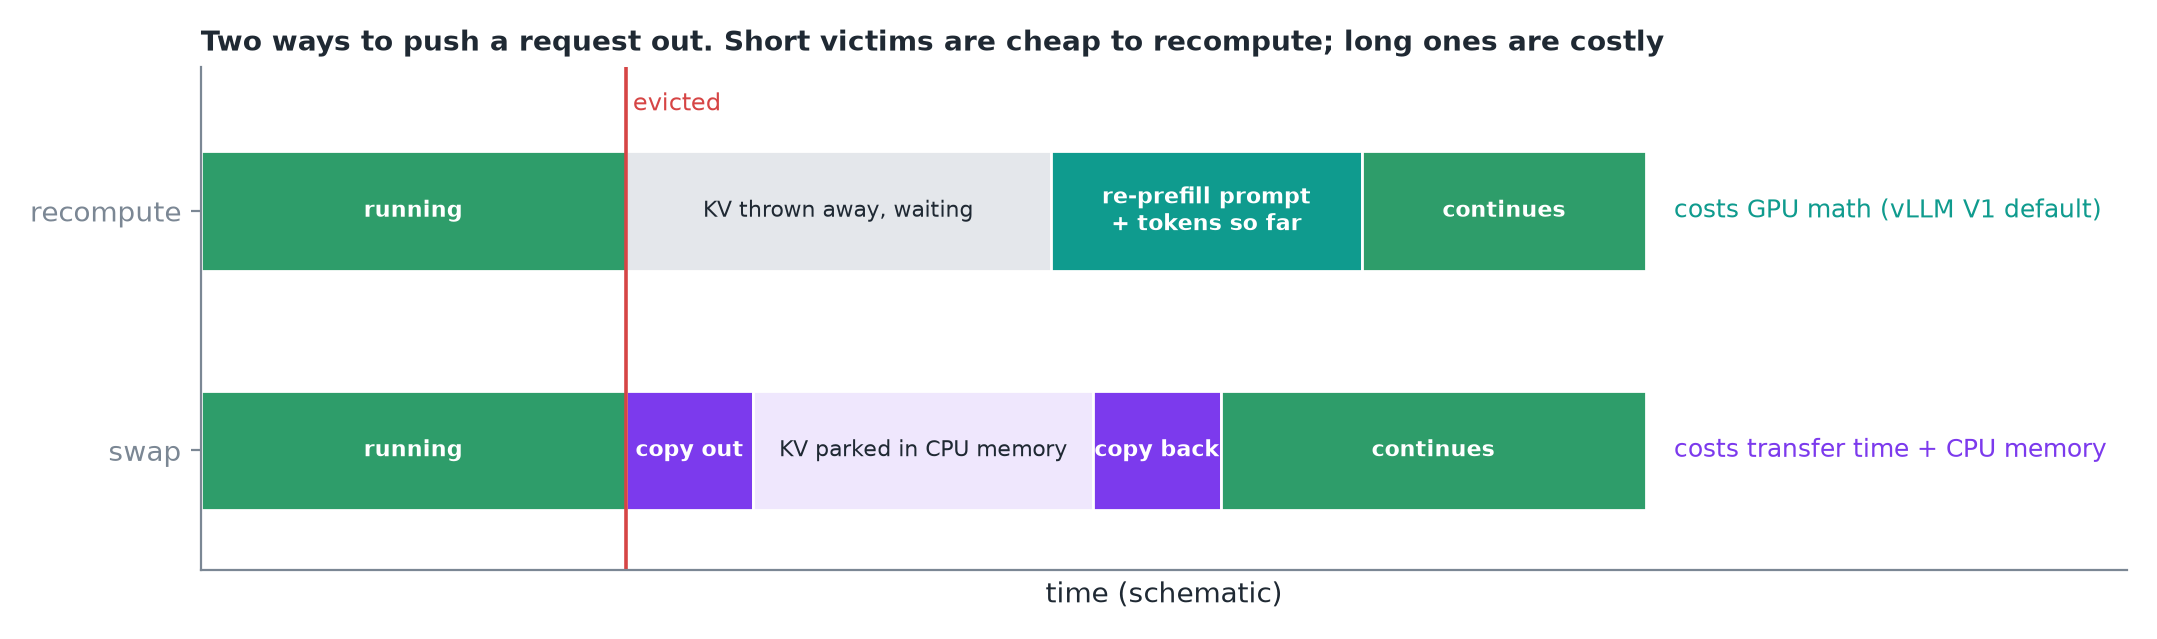 Tính lại (recompute) vứt bỏ KV rồi sau đó chạy lại prompt + các token đã sinh như một lượt prefill mới. Swap chép KV sang bộ nhớ CPU và chép ngược lại khi có chỗ.
| Tính lại | Swap | |
|---|---|---|
| Tốn | Phép tính GPU | Thời gian truyền + bộ nhớ CPU |
- Engine hiện tại của vLLM (V1) mặc định là tính lại.
- Một nghiên cứu thấy tính lại request ngắn thậm chí có thể có lợi, trong khi đuổi request dài thì rất tốn kém.
- ◆ Chi phí lý tưởng hoá cho một nạn nhân 2.000 token: tính lại ≈ 2.000 × 16 µs ≈ 32 ms phép tính GPU (phần attention thêm vào làm nó tệ hơn khi request dài ra); swap chuyển 262 MB mỗi chiều, ≈ 5 ms ở ~50 GB/s PCIe, và gửi 262 MB vào RAM của CPU. Swap thật phải chép nhiều block nhỏ, nên chạy dưới băng thông đỉnh.
- ◆ Khi có prefix caching, các block được giải phóng của request bị tính lại vẫn nằm trong cache tới khi bị dùng lại, nên một phần lượt prefill lại có thể là cache hit.
Cảnh báo
Preemption xảy ra liên tục là vấn đề định cỡ. Hãy cho KV cache nhiều bộ nhớ hơn, hoặc nhận ít request cùng lúc hơn (giảm max_num_seqs).
5. Tóm tắt